
2026-08-26 · 会议总览
8 月 23 到 25 日,斯坦福,Hot Chips 2026。会场里没有一颗公认的明星芯片,主角是共识本身:每 token 的经济学,正在把整个行业的赌注从算力密度搬到数据搬运。本篇先把两天议程收进一张地图,再按四个方向逐个清点公司与产品,最后收拢为四条判断和可检验的跟踪点。
AgentX 基准与 Vera Rubin 实测、Groq 3 LPU 量产、Jalapeño 首份成绩单,三项权重最高的信号已有专文拆解,本篇只在脉络处取用其结论;正文数字均经官方材料与一线报道交叉核实,仅见单源转述的一律未进正文。
一、议程地图:四个方向,两条主线
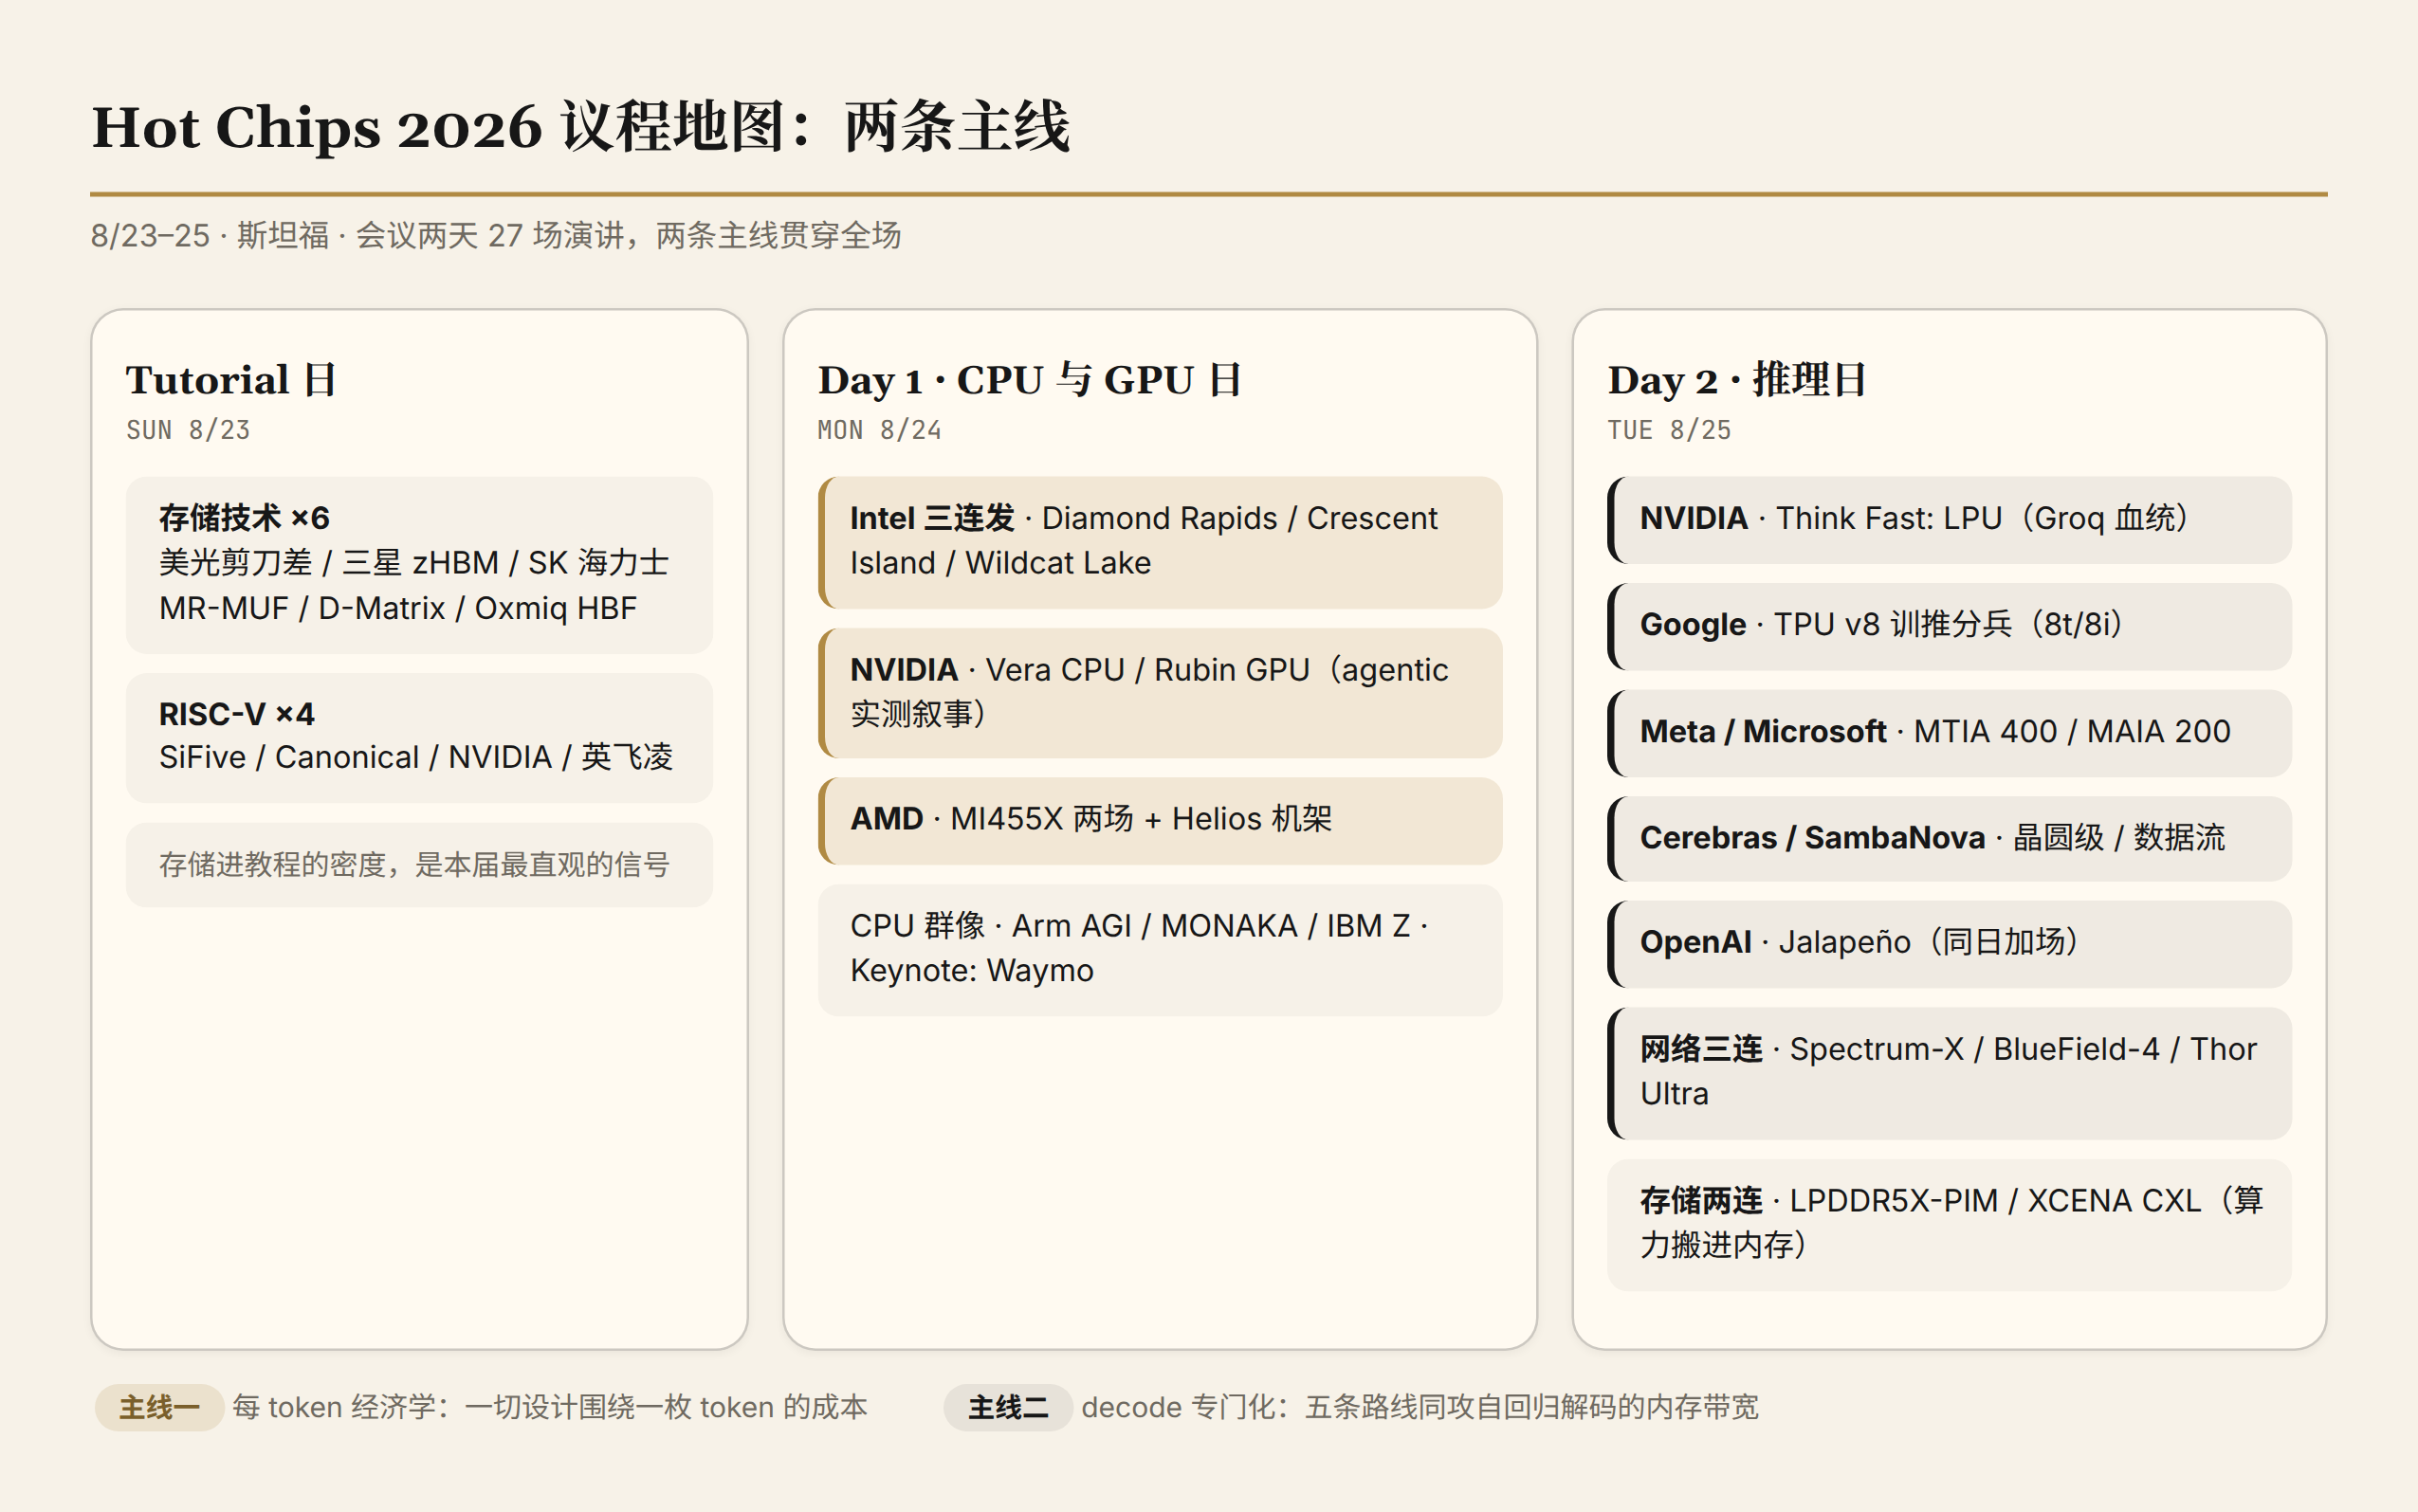
Tutorial 日给全场定了调:十场教程里六场存储连讲,美光、三星、SK 海力士三家悉数登场,另有四场 RISC-V。存储进教程的密度,是这届会议最直观的信号:瓶颈已经从计算核心转移到数据搬运。正会两天共 27 场:Day 1 十三场,CPU 六场、GPU 四场,Keynote 留给了 Waymo,芯片会议的头牌话题从数据中心开到了路上;Day 2 十四场,网络三场,AI session 连发七场,OpenAI 的 Jalapeño 压轴。
按内容归拢,议程落进四个方向:CPU 与服务器编排层,谁来做推理时代的控制面;内存墙,存储三厂的三条梯子与近存计算;AI 加速器,decode 专门化下的五条路线与云自研二代;AI 工厂网络,从连接器变成工厂骨架。两天议程贯穿着两条主线:每 token 经济学,Intel、NVIDIA、存储三厂的全部动作围绕一枚 token 的成本展开;decode 专门化,五条不同起点的加速器路线同时攻击自回归解码的内存带宽。两条主线之间有因果:每 token 经济学算到最后,decode 阶段的内存带宽成为主导成本项,专门化由此成为推论。
二、方向一:CPU 回归,谁来做推理时代的编排层
六场 CPU 演讲把「推理时代的服务器长什么样」摆上台面,每一家都在回答同一个问题:一枚 token 的成本怎么降。
Intel:从机架到边缘的两级布局
这届 Intel 存在感最强,三场演讲连发;两场落在本方向,推理主力 Crescent Island 归加速器方向。
Diamond Rapids,编排层。 下一代 Xeon:18A-P 制程自产,Foveros Direct 3D 封装加 UCIe-S 互连,256 核,1.28GB LLC,新 APX 指令集与 AMX 矩阵指令增强。定位是机架级内存与 IO 的编排者,给推理集群当地基。
Wildcat Lake,边缘层。 Core Series 3:低成本有机封装,UCIe chiplet 互联,Intel 第一次把开放封装标准带进客户端 SoC。
三场连发的主线只有一条:18A 全自研加开放封装,用部署成本定价。
NVIDIA:第一颗自研核 CPU
Vera 88 核 Olympus,NVIDIA 第一颗自研核 CPU。 ARM v9.2 自研核(非 Neoverse 公版),176 线程(SMT-X 空间多线程),1.2TB/s SOCAMM2 内存带宽,164MB L3,单片 die。已随 Vera Rubin 系统全面量产,NVIDIA 正借它进入服务器 CPU 市场。官方口径:agentic 任务完成快 1.8 倍、能效 2 倍,对比传统 x86。
CPU 群像:每机架可用线程数成为卖点
Arm 第一次下场做整机芯片:AGI CPU,TSMC 3nm 双 chiplet,136 核 Neoverse V3(140 核硬件、留 4 核冗余),136 核 SKU 最高 3.5GHz(64 核 SKU 3.7GHz),聚合内存吞吐超 800GB/s,约每核 6GB/s,「每机架可用线程数」由此进入官方卖点。富士通 MONAKA 主打 green AI data center。
这个方向怎么走
CPU 不再是会议主角,但每一颗都在回答同一个问题:推理时代的服务器控制面长什么样,卖点从主频换成每机架线程、每核带宽、部署成本。编排层的分工开始成形:Diamond Rapids 管机架内存与 IO,Vera 管异构系统,AGI 管线程密度。变数有两个:Arm 下场做整机芯片,服务器 CPU 从 x86 双寡头走向 x86、NVIDIA、Arm 三角,AGI 的实际部署是第一块验证;Intel 的 18A 产能与良率,决定「部署成本定价」是口号还是报价单。
三、方向二:内存墙,从容量竞赛到搬运竞赛
存储是这届议程密度最高的方向:Tutorial 日六场连讲,Day 2 再加两场近存计算。同一面墙,三家原厂各选一条梯子,没有一家的答案是单纯更大的 HBM。
美光画墙。 AI 加速器算力每两年约 3×,HBM 带宽每两年不到 2×。剪刀差就是内存墙的算术定义,也是全部存储议程的出发点。
三星往上叠。 cHBM、aHBM、zHBM 三步演进:zHBM 抛弃 2.5D interposer,把 DRAM 垂直直叠在 XPU 之上,官方口径 DRAM 功耗降 70%、带宽提升至 2.3 倍。这条梯子的名字叫真 3D 集成。
SK 海力士往里榨。 MR-MUF 封装续命到 16 层 HBM4;铜-铜混合键合明确推迟,SK 海力士现场原话,它不满足 HBM4e 要求,最早 HBM5;JEDEC 把 Z-height 放宽到 775μm,进一步推迟了切换点。真正兑现时的参数:20 层、core die 加厚 24%、热阻再降 35%、凸点间距从约 30μm 压到 18μm 以内。
算力搬进内存:PIM 与 CXL
三星 LPDDR5X-PIM,全球首个 LPDDR 基 PIM,是 2021 年 Aquabolt-XL 的产品化,定位比 HBM 更低成本的推理内存路线。XCENA MX1 三合一:CXL 3.0 内存扩展(4 组 DDR5-8400,最高 2TB)加 SSD 字节寻址,加 3,072 颗 RISC-V 核近存计算。
这个方向怎么走
三条梯子加上 PIM 与 CXL,指向同一个变化:比赛从堆得更厚转向搬得更快。时间表上,MR-MUF 的租约续到 16 层 HBM4,混合键合要等 HBM5;zHBM 的真 3D 集成先在特定负载落地;PIM 与 CXL 如果成本兑现,推理内存会出现 HBM 之外的第二市场。变数在 JEDEC 的 Z-height 定案与三家 2027 路线图更新,哪一家先兑现搬运效率,哪一家就拿到下一轮规格定义权。
四、方向三:AI 加速器,decode 专门化的五条路线
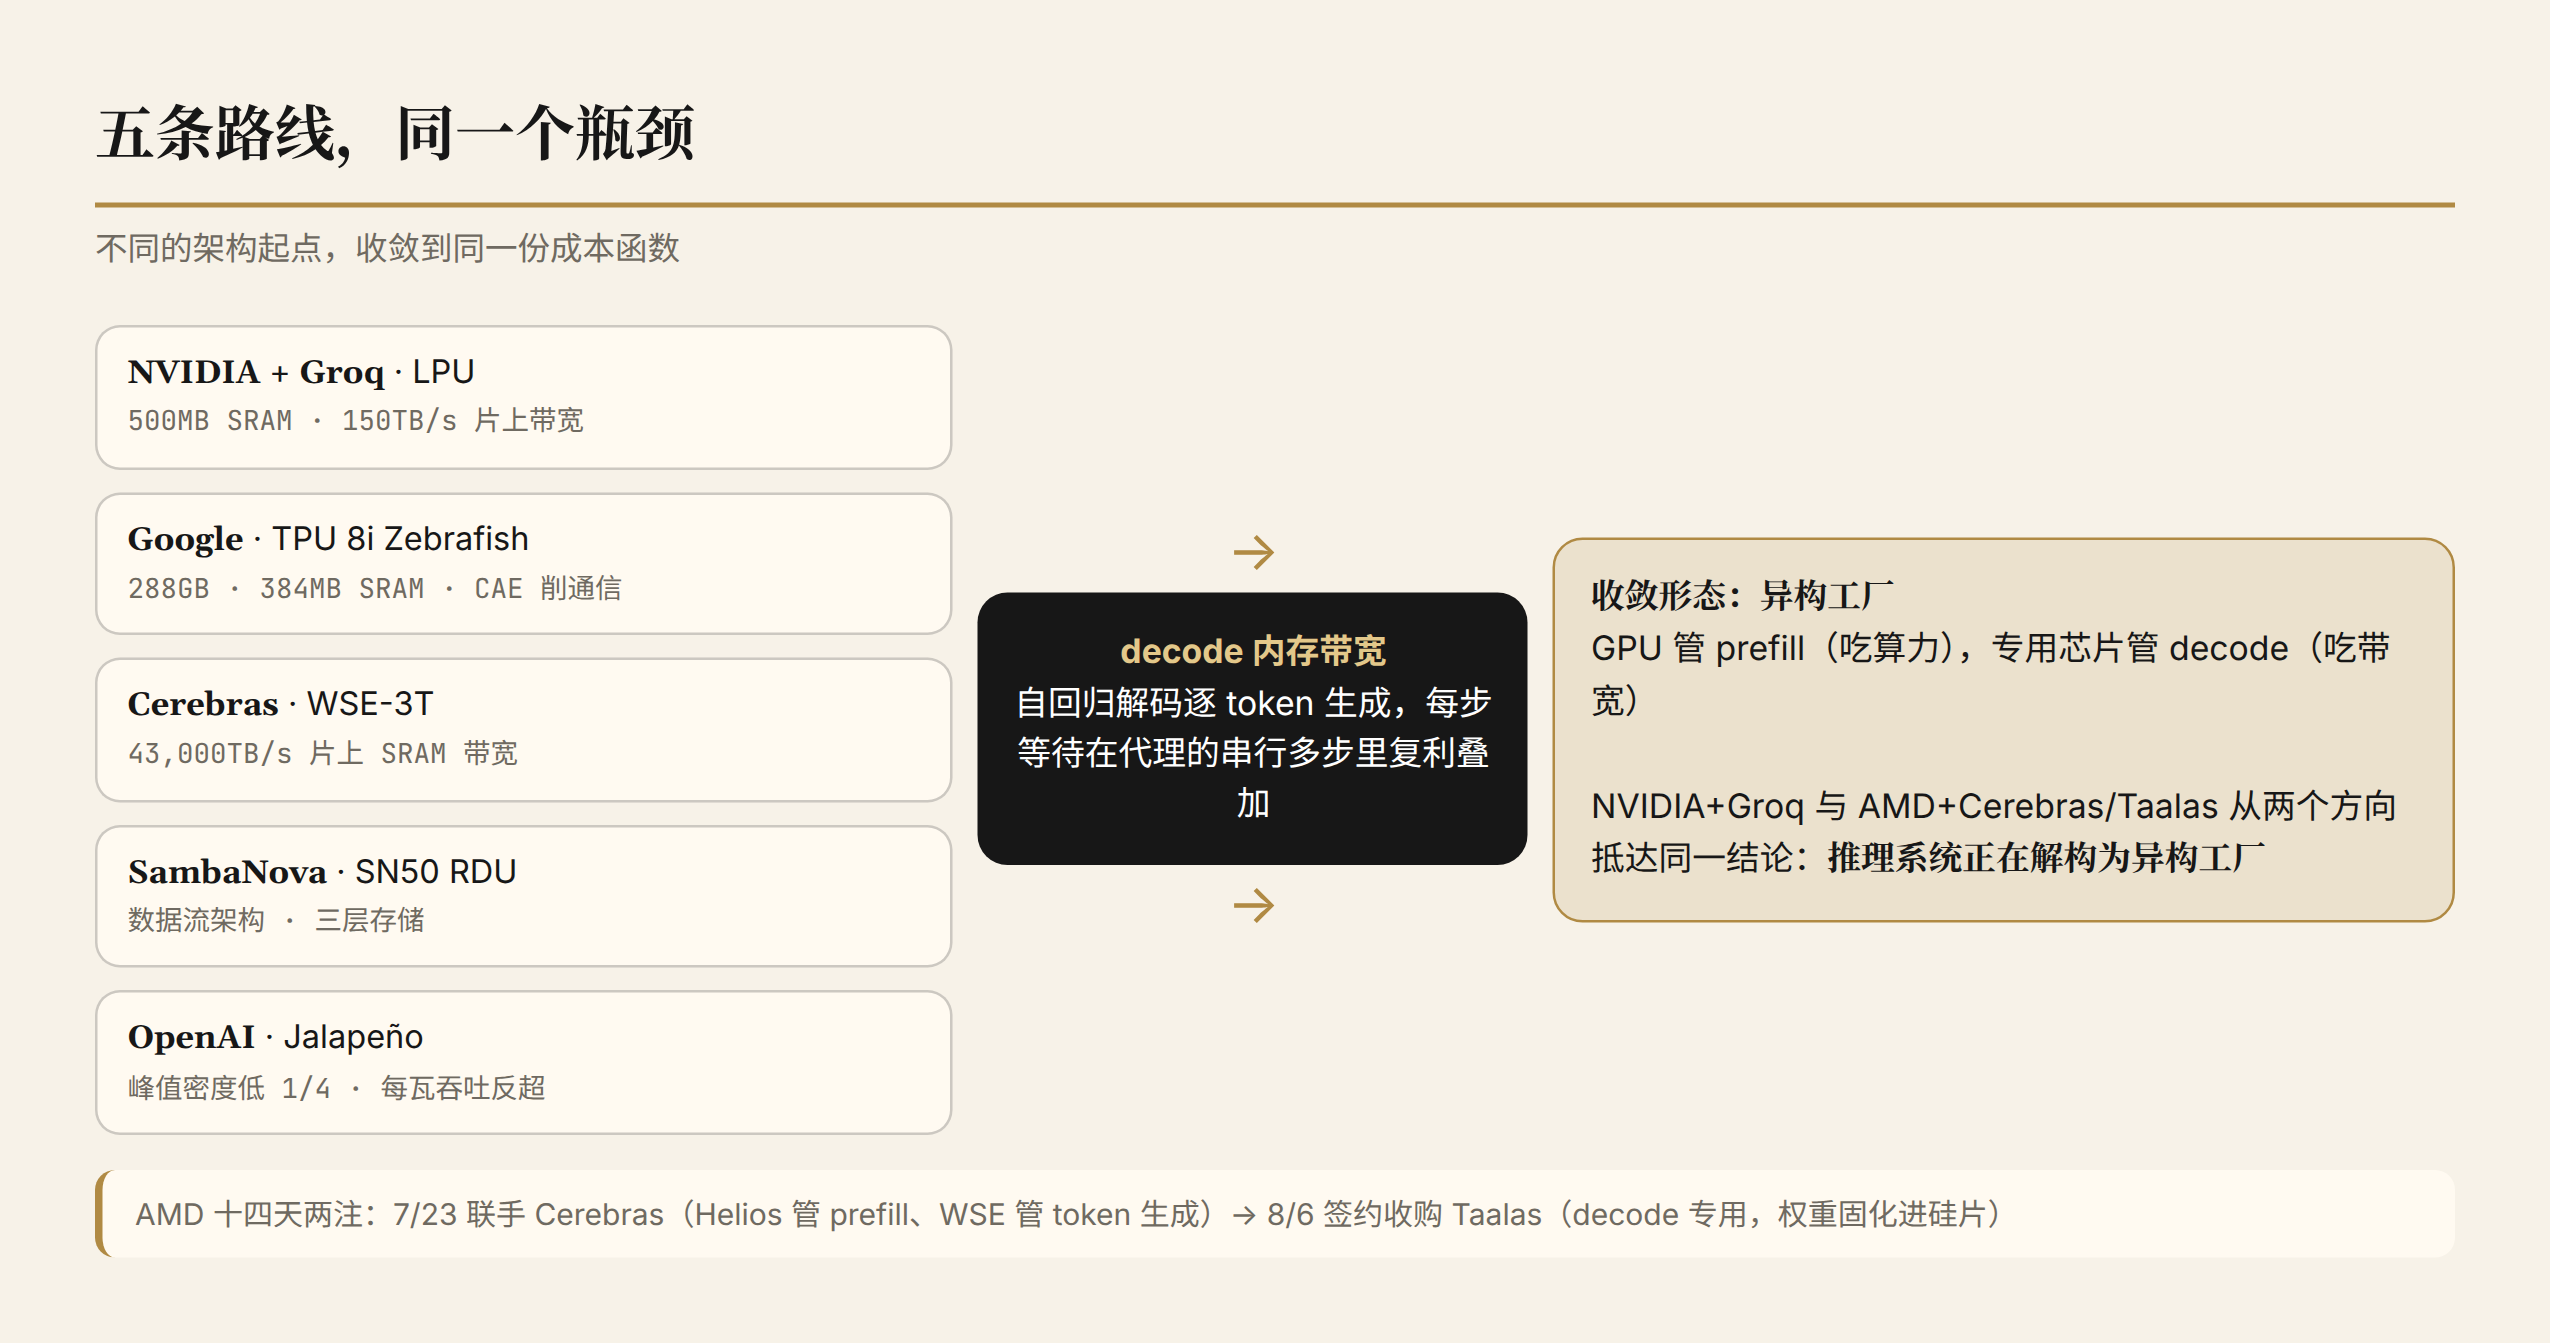
这是这届会议的绝对重心:Day 2 七场 AI session 连发,加上 Day 1 的 GPU 场次,多条路线在同一个瓶颈上汇合:自回归解码的内存带宽。prefill 阶段的瓶颈是算力,decode 逐 token 生成阶段的瓶颈是内存带宽,后者正在成为交互式推理的主导成本。
GPU 三家的解法
NVIDIA:GPU 管 prefill,LPU 管 decode。 Rubin 把叙事从规格切换到实测:GPU 演讲题目就叫 Driving the Era of Agentic AI,官方量纲改为每兆瓦 token 吞吐与 token 成本,Vera Rubin NVL72 跑 DeepSeek-V4-Pro 的 AgentX 基准,每 MW 吞吐最高 30×、token 成本最高降 35×,对比 GB300 NVL72。口径先说清楚:这是 NVIDIA 营销数字,30×/35× 的成色要分层看,Rubin 上 InferenceX 的独立复核仍在日程上。趋势本身没有争议:只发规格的时代过去了,公开基准上见,正在成为新的游戏规则。另一边,收购 Groq 之后的第三代 LPU(Think Fast 演讲)全面量产,与 Vera Rubin 组成异构推理:单 LPU 500MB 片上 SRAM、150TB/s 片上带宽;LPX 机架 256 颗,315 PFLOPS、640TB/s 聚合带宽;Gemma 4 31B 实测单用户 3,431 token/s,DeepSeek V3 级模型约需 5 个机架;FPGA 桥接同步域与异步域,投机解码只换 draft token;Nebius 成为首个 Token Factory 云。NVIDIA 第一次在自家参考架构里给「非 GPU」留出正式位置。
Intel:绕开 HBM 的推理卡。 Crescent Island,Xe3P 架构首颗纯推理 GPU,全场信息量最大的一颗。32 核 Xe3P、256 个 XMX 引擎(脉动阵列加深到十六层),3D 与光线追踪硬件全部砍掉,释放出的面积与功耗换成最多 480GB LPDDR5X;350W 风冷 PCIe 卡,现有机房直接上架。这组规格逐项都在压缩部署成本:绕开供给紧张涨价的 HBM,480GB 纸面超过 Rubin 的 288GB 与 MI455X 的 432GB;风冷免去液冷改造。官方设计目标直说:tokens per watt 与 agentic 负载,vLLM、SGLang、llm-d 原生支持。2026 下半年送样,2027 年上市。
AMD:机架加两注。 MI455X 两场演讲拼出一台完整的 72 GPU 机架:12 组 HBM4 共 432GB、23.3TB/s,UALink 开放互连,EPYC Venice 加 Pensando Vulcano AI NIC 三芯片协设计;首台机架 6 月已在得州装机,Meta 年内部署。紧接着,十四天内两笔交易:7 月 23 日与 Cerebras 合作,Helios 管 prefill、WSE 管 token 生成;8 月 6 日签约收购 Taalas(Q4 交割),权重固化进硅片的 decode 专用芯片,Instinct prefill 加 Taalas decode,ROCm 统一暴露。这里有一处值得辨析:Register 在 Jalapeño 报道里的判词,认为 Taalas 将性能押注在特定模型上并牺牲可编程性,作为对通用加速器的批评成立;作为机架里专管 decode 的那颗芯片,它已被写进 Helios 路线图,两种身份并不冲突。
云自研:训推分兵与旗舰负载
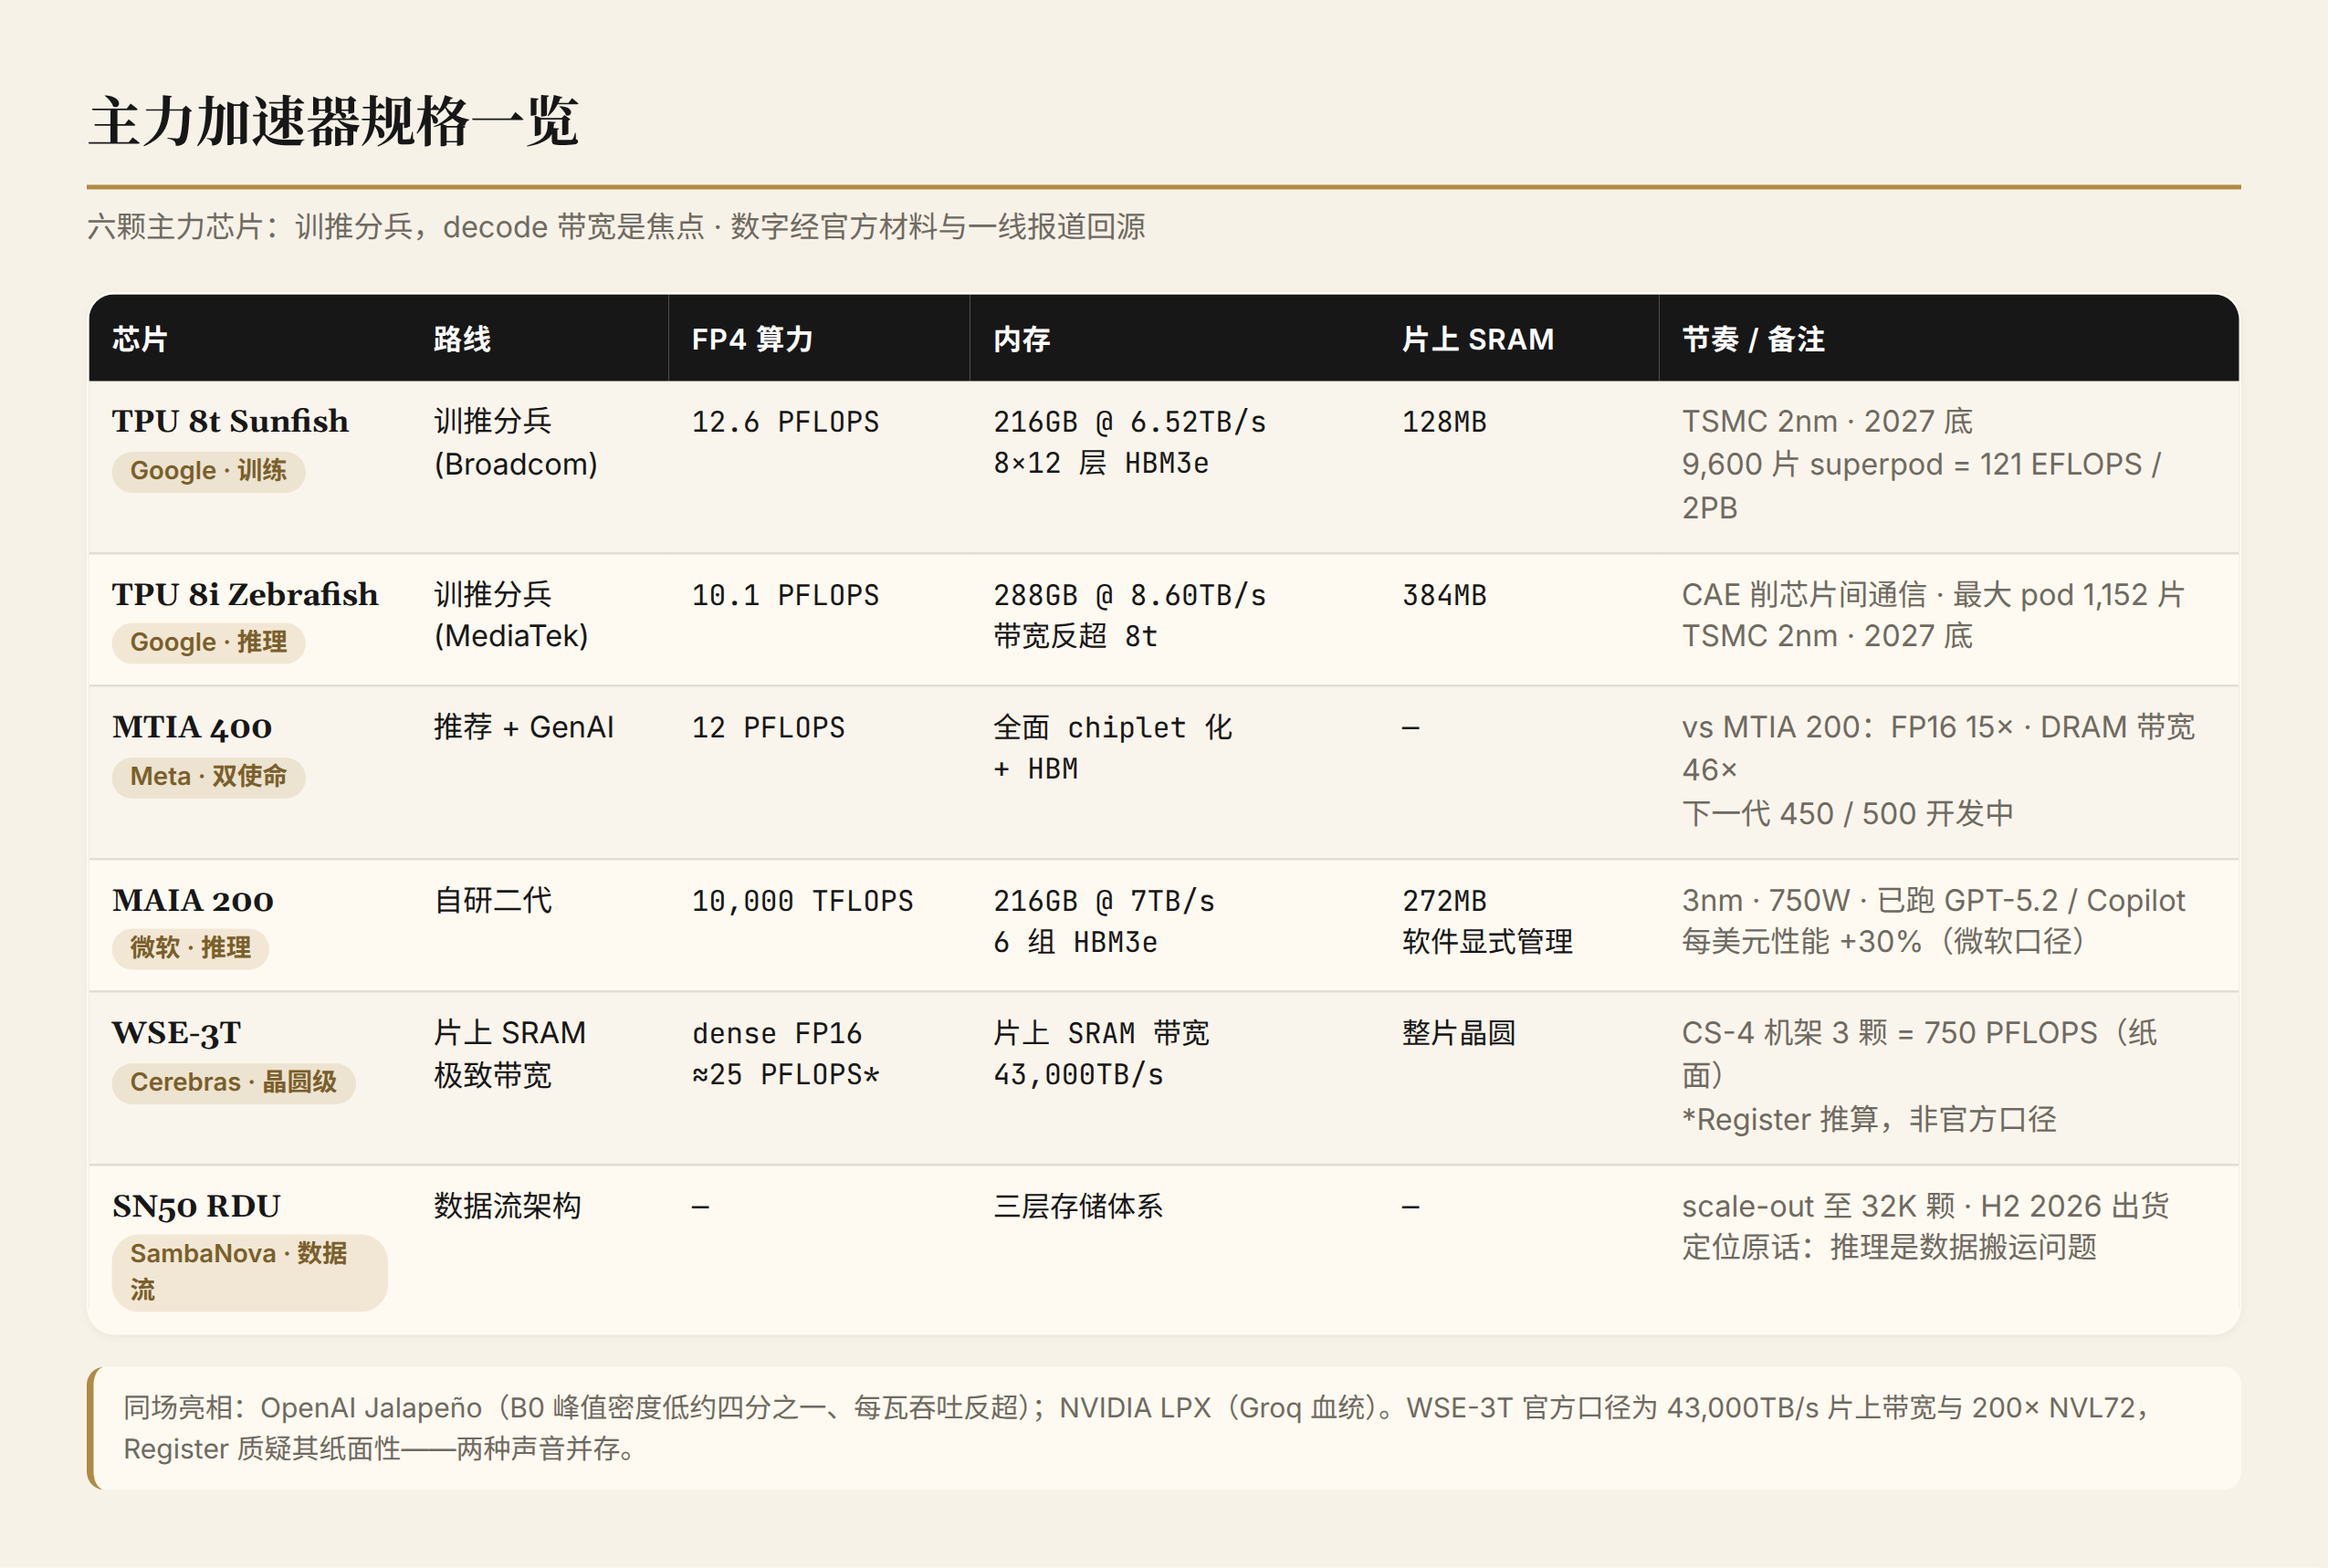
Google TPU 八代首次训推分兵,证据写在规格表里。 8t Sunfish(训练,与 Broadcom 设计):12.6 PFLOPS FP4、216GB HBM、6.52TB/s、128MB 片上 SRAM;9,600 芯片 superpod,121 ExaFLOPS、2PB 共享内存,ICI 互连带宽翻倍,scale-out 可达 13.4 万芯片(Virgo fabric)。8i Zebrafish(推理,与 MediaTek 设计):10.1 PFLOPS FP4、288GB HBM、8.60TB/s、384MB 片上 SRAM,带宽与 SRAM 反超 8t,算力略低,最大 pod 1,152 片;新增 Collectives Acceleration Engine 削减芯片间通信,Boardfly 拓扑替换 3D torus,为 MoE serving 的延迟目标设计。训练堆 pod 规模,推理堆带宽与 SRAM;两颗芯片各按各的优化目标设计,训推分兵第一次落到芯片层面。
Meta MTIA 400,从推荐单一使命扩成推荐加 GenAI 双使命。 12 PFLOPS FP4;较 MTIA 200:FP16 算力 15×、DRAM 带宽 46×、SRAM 带宽 5×;全面 chiplet 化,2 计算die、1 SoC、2 网络,加 HBM,8×6 PE 阵列带冗余行;下一代 450 与 500 已在开发。
微软 MAIA 200,从芯片变成数据中心级系统。 TSMC 3nm、1,400 亿晶体管、SoC die 820mm²,FP4 算力 10,000 TFLOPS;6 组 HBM3e 共 216GB、7TB/s;272MB 片上 SRAM 由软件显式管理;全连接四元拓扑、统一 Ethernet scale-up;750W。已承载 GPT-5.2、Microsoft 365 Copilot 与 Foundry;微软口径:每美元性能较 fleet 中最新一代硬件提升 30%,自报口径,2027 年财报 TCO 待验。自研芯片从降本试水走到承载旗舰负载,位置变化是结构性的。
带宽逻辑的极端样本
Cerebras 晶圆级放大。 CS-4 机架把三颗 WSE-3T 整合进 Nexus:单颗 44GB 片上 SRAM、43,000TB/s 片上带宽;机架合计 750 PFLOPS、129.6PB/s 聚合内存带宽(官方标称),fabric 带宽 53.5PB/s,官方称 scale-up 带宽超 NVL72 两百倍;本季度出货。The Register 给出的是另一组估算:WSE-3T 与 WSE-3 同硅片提速,dense FP16 约 25 PFLOPS,聚合带宽数字存疑。它的价值在对照组:把「内存带宽推到极致」这条逻辑做成物理极限样本。
SambaNova 数据流。 SN50 第五代 RDU,为 agentic 推理设计,三层存储架构,scale-out 可到 32K RDU,2026 下半年出货。官方定位的原话:推理是数据搬运与内存优化问题,需要另一种架构思路。
加上压轴登场的 OpenAI Jalapeño,NVIDIA、Google、Cerebras、SambaNova、OpenAI 五条路线先行,AMD 十四天内两笔交易跟进:decode 专门化从单家公司的选择,变成了行业级迁移。
主力加速器的关键规格,一张表收拢:
这个方向怎么走
五条路线解的是同一个成本函数,分歧只在起点:GPU 阵营在既有架构里做异构拆分,云自研按自家负载定制、TPU 干脆拆成两颗,极端样本把带宽逻辑推到物理极限。分工正在从调度器沉到掩膜:TPU 拆成 8t 与 8i 两颗,LPU 与 GPU 在参考架构里并列,AMD 直接买下 decode 专用芯片公司。往前看的最大变数是实测兑现:各家口径全是自报,独立基准兑现之前一律打折听。次一级的变数是 Intel 的 tokens-per-watt 能否在同代对手中站住,以及云自研二代的 TCO 何时可验。
五、方向四:网络升格为 AI 工厂骨架
网络方向由 Broadcom Thor Ultra 打头阵:800GbE AI/HPC NIC。NVIDIA Spectrum-X 多平面把 AI 工厂拆成五张专用网——scale-across、scale-out、scale-up、AI context,加上本届新发布的 scale-in,官方论点是单一通用 fabric 无法服务全部五类流量;可寻址规模从 8K 扩到 512K GPU,64 倍;CPO 已量产。BlueField-4 协设计进每一台 Vera Rubin,Astra 聚合 7Tb/s,定位 AI 工厂操作系统。
这个方向怎么走
decode 专门化把工厂的尺度问题暴露出来:异构芯片越多,编织它们的网络越值钱,网络从连接器升格为工厂骨架。与之并行的第二条战线是开放互连:UCIe、UALink、统一 Ethernet、NVLink Fusion,除了 NVIDIA 的自有生态,几乎全员在把互连标准化。变数有两个:「单一通用 fabric 不够用」的论断是否遇到反例,以及 CPO 量产的成本曲线能压多快。
六、两条主线是同一件事:四条判断
把四个方向叠起来,因果链是完整的。每 token 成本的分母是电力与数据搬运:算力密度仍在涨,但美光的剪刀差说明多堆的 FLOPS 有越来越多的时间在等数据;decode 逐 token 生成的带宽瓶颈,又被代理的串行多步放大,每一步等待都复利叠加。经济学推到这里,通用 GPU 还有一条标准解法:加大 batch,把带宽成本摊进更多请求。这条路在交互延迟约束下已经到顶,Jalapeño 实测里 matched-TBT 口径的数据就是到顶的注脚。剩下的解只有一条:把 decode 从通用计算里拆出来,交给专门化硬件。五条路线,是同一个成本函数的五组解。
最小样本我们已经有了:Jalapeño B0 与 Rubin 同工艺、近似尺寸,峰值算力密度低约四分之一,每瓦吞吐反超,差距来自数据搬运与相位调度。Hot Chips 两天的议程是这个样本的放大版。在这条因果链上,再加四条产业判断:
判断一:训推分工沉到芯片层。 系统层的 prefill/decode 分离,这届直接变成 silicon:TPU 拆成 8t 与 8i 两颗,NVIDIA 参考架构里 LPU 与 GPU 并列,AMD 两周内买下 decode 专用芯片公司、又拉进晶圆级搭档。prefill 与 decode 的分界,过去由调度器划分,现在直接写进掩膜。
判断二:开放互连成为第二条统一战线。 UCIe 进了 Intel 客户端 SoC,UALink 撑起 Helios 的 72 GPU,MAIA 200 用统一 Ethernet 做 scale-up,NVLink Fusion 向 RISC-V 生态开门。除了 NVIDIA 的自有生态,几乎所有玩家都在把互连标准化;CPO 量产把光进一步压进交换机。第一战线是 decode 专门化,这一条是它的镜像:芯片越异构,互连越要开放。
判断三:内存墙的战场从容量转向搬运。 三厂给的答案没有一个是单纯更大的 HBM:zHBM 砍互连层功耗,MR-MUF 与混合键合在封装里压缩热阻与间距,PIM 与 CXL 则把算力搬到数据旁边。容量竞赛结束了,搬运竞赛开始了。
判断四:基准口径成为新战场。 NVIDIA 改用每 MW token 成本讲故事,Intel 把 tokens per watt 写进产品目标,微软自报每美元性能高 30%,每家都在挑对自己有利的量纲。对这类自报数字,我们统一按七折采信;独立基准落地之前,折扣不撤。Rubin 上 InferenceX 独立复核,是整场共识的第一块试金石。
所以这届 Hot Chips 的共识可以写成一句话:训练堆 FLOPS 的时代结束了,推理时代的架构变量是内存带宽、数据搬运、异构分工。NVIDIA 加 Groq 与 AMD 加 Cerebras 从两个方向收敛到同一个结论:推理系统正在解构为异构工厂。
七、预测与后续重点关注点
把四个方向并置,本届全貌可以一段收拢:27 场正式演讲,Intel 三连发围绕部署成本,NVIDIA 交出第一颗自研核 CPU,AMD 摆出开放机架,Arm 第一次下场做芯片;decode 五条路线同攻一个瓶颈,云自研阵营集体升代,存储三厂从容量转向搬运,网络重排成五张网。四条判断写成可检验的预测,跟踪点到期回来验证:
- decode 专门化的实证基座。 预测:独立实测将支持「decode 带宽主导成本」的量级判断。跟踪点:Rubin 上 InferenceX 独立复核、Nebius Token Factory 上线后的 LPX 实测。若独立口径显著低于自测,或 LPX 异构部署推迟,行业级迁移的判断要重估。
- Intel 的 tokens-per-watt 要等实测兑现。 预测:Crescent Island 的 tokens-per-watt 在同代对手中有竞争力。跟踪点:2026 下半年送样后的第三方实测、2027 上市定价。
- 云自研二代的成色。 预测:MAIA 200 的每美元性能优势在财报口径下会收敛,但方向成立。跟踪点:微软 2027 财报的 TCO 数据。
- 内存墙时间表。 预测:混合键合按 SK 海力士口径推迟到 HBM5,zHBM 先在特定负载落地。跟踪点:三家 2027 路线图更新、JEDEC Z-height 定案。
数据截止 2026-08-29。规格与机制来自 Hot Chips 2026 各厂商演讲材料、官方发布与现场报道(ServeTheHome 等);自报口径与单源转述已在文中标注。
延伸阅读:SemiAnalysis AgentX 实测拆解 · 从独赌到共识:Groq 3 LPX 量产与低延迟推理的八个月 · OpenAI 交卷:自研芯片 Jalapeño 首份实测成绩单分析 · SubQ 三个月对账(内存墙主题前篇)