何时扩容 DRAM,何时增加共享闪存,何时让两者协同
技术观察与选型分析|资料核验截至 2026 年 10 月 26 日
摘要 长上下文推理正把 KV Cache 管理从单机显存问题变成集群容量规划问题。本文以 NVIDIA CMX 共享闪存层与分布式 DRAM 缓存的对比为主线,提出三层判断。第一,恢复能否在剩余时限内快过重算。第二,新增命中能否覆盖搬运与排队成本。第三,省下的算力能否真正兑现,以及 2026 年的内存涨价如何改写这笔容量账。文中四组算例均可复算,引用信源 34 条。
阅读须知 本文使用三类材料:公开的产品与代码事实、他人公布的测试结果、用于推导的假设模型。凡是标注"示意"或"假设"的数值,都不代表 CMX 实测、采购报价或任何产品的性能承诺。下文不再逐处重复这一说明。
长上下文推理正把一个原本属于单机显存管理的问题推向集群资源规划:已经算过的 KV Cache,该留多久、放在哪里、花多大代价取回?NVIDIA CMX 的回答是,在计算节点与传统共享存储之间增加一个专门服务推理上下文的共享闪存层。但对已经采用分布式 DRAM 缓存的系统来说,多加一层存储并不自动等于加速。它同样可能带来新的查找、搬运、排队和运维成本。
这个问题在 2026 年下半年变得紧迫,原因有两个。
第一,CMX 所依托的 STX 参考架构随 Vera Rubin 平台进入 2026 年下半年的交付窗口[1]。伙伴方案正从发布走向验证,但进度不一:Dell 10 月 1 日的技术文稿描述的仍是基于 Grace 的软件路径和面向 Vera ARM64 的验证,并说明专用的 BlueField-4 CMX 硬件当时尚未商用[2]。
第二,服务器 DRAM 正经历多年未见的涨价。2026 年一季度,传统 DRAM 合约价环比上涨约 93%–98%[3]。"多少 DRAM 在经济上可承受"这个前提本身正在改变。
判断 CMX 的价值,需要同时回答三个问题:
- 它能否在请求时限内恢复有用的状态?
- 扩大容量后减少的重算,能否抵消更慢的数据路径?
- 省下的 GPU 工作量,能否真正变成预算节省或可用的服务能力?
本文围绕这三个问题展开,最后讨论多存储 API、接口责任以及 NVIDIA 的生态推进方式。
1 先把比较对象放进同一个坐标系
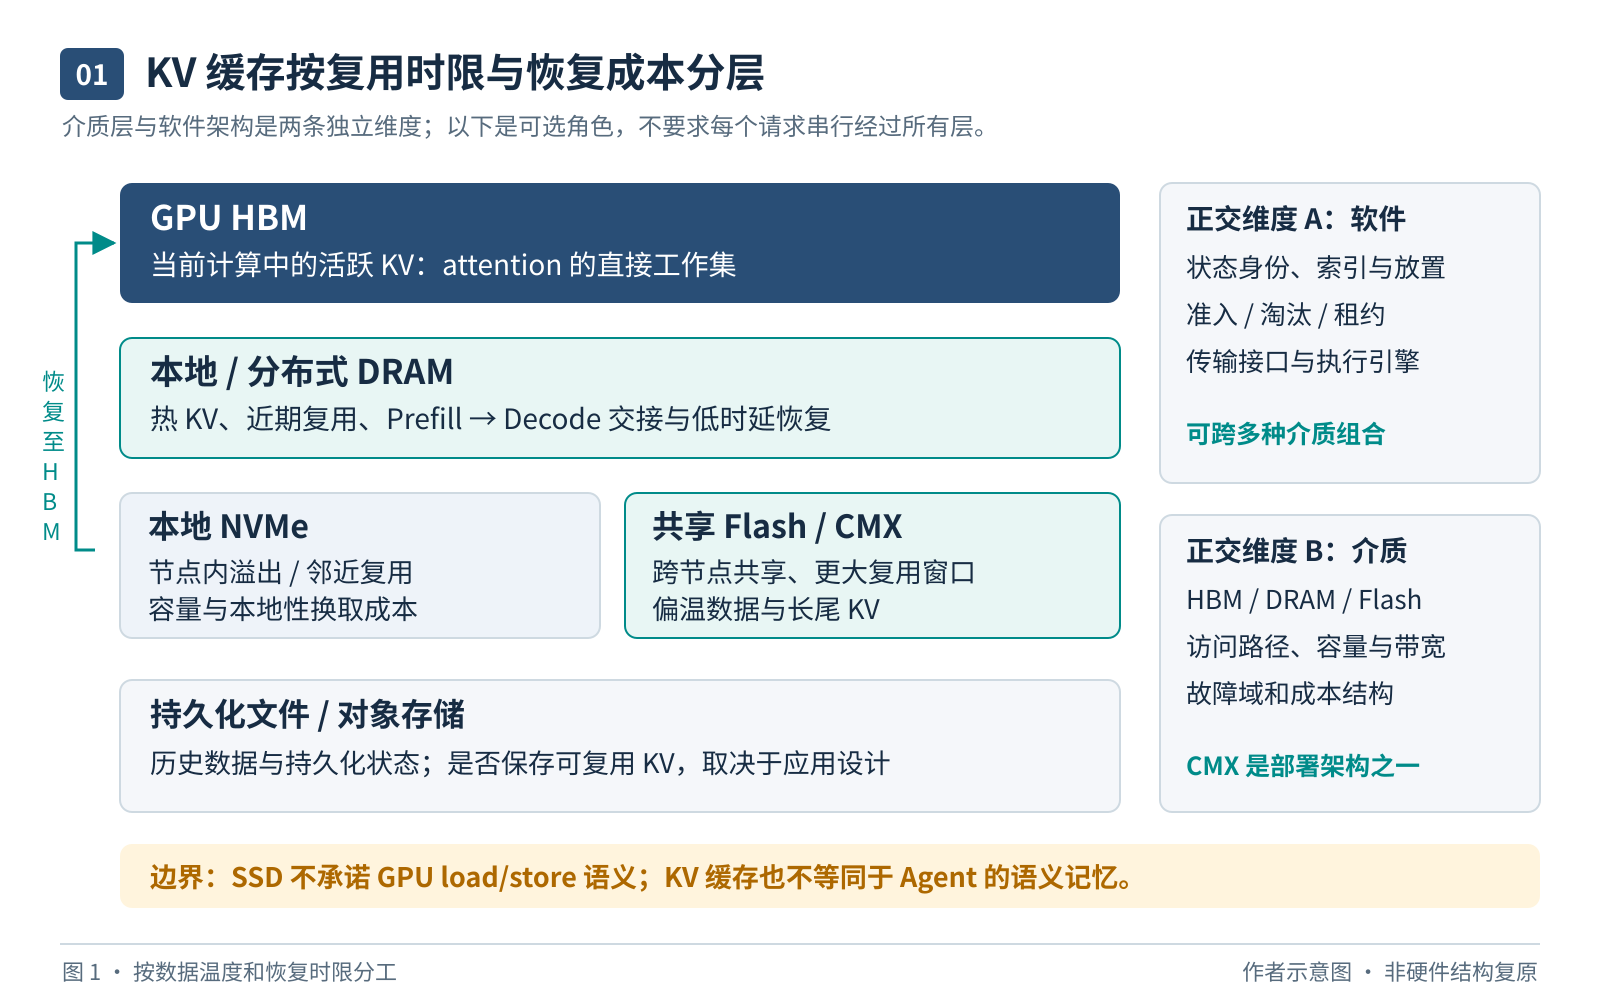
讨论 KV 加速时,"内存方案"和"存储方案"常被说成两条路线,实际部署却更像一个连续的层次:
- GPU 上的活跃状态,必须满足当前计算的访问要求;
- CPU 内存暂存近期状态;
- 分布式内存让可复用状态不再受单台机器生命周期的约束;
- SSD 把保留范围进一步延伸到更大、更冷的工作集。
无论底层介质如何变化,服务端最终需要的,都是与当前模型和请求兼容、可以直接参与计算的状态。
分布式 DRAM 应当作为强基线。 它已经能提供跨节点共享、较低的恢复时延和较高的并发。用"没有缓存、每次从头计算"作基线,只能证明缓存复用有价值,回答不了"CMX 相对于现有内存缓存值不值得买"。
更合理的问题是:保持现有 DRAM 热层不变,再增加一层闪存,能挽回多少原本会发生的昂贵 miss?这与"用闪存替换 DRAM"是两个不同的实验。前者增加的是容量和保留时间,后者改变的是热请求的数据路径,两者的收益和风险都不一样。
分布式内存还要再拆成两种:
- 利用现有服务器的闲置内存:短期增量成本可能很低,但会受推理实例扩缩容影响,还要承担 NUMA 访问、固定内存、网卡功耗以及与其他主机任务争用的机会成本。
- 专门采购的内存节点:更稳定,但要承担服务器、网卡、交换机端口、电力和维护成本。
共享闪存同理。复用现有存储的空闲能力,与新建一套带 DPU、网络和软件服务的专用系统,不能只按 SSD 单价比较。
因此,真正的候选集合至少包括六项:维持现有 DRAM、扩容 DRAM、增加本地 SSD、增加共享闪存、DRAM 与闪存分层,以及重算。当 GPU 空闲、前缀较短或存储拥塞时,直接重算可能比恢复缓存更快,也更便宜。
2 CMX 改变的是上下文的保留半径
NVIDIA 把 CMX 定位为 G3.5 层:位于本地 SSD(G3)与传统共享存储(G4)之间、经以太网连接的闪存层,由 BlueField-4、DOCA Memos、NIXL/Dynamo、Grove 和 Spectrum-X 协同实现。NVIDIA 的说法是"在整个 POD 内无缝扩展 GPU 内存",实现机制是由 KV 管理器在 decode 之前,把 KV 块从 CMX 预置(prestage)到主机内存(G2)或 HBM(G1)[4]。
换言之,CMX 扩展的是可复用上下文的容量与共享范围。GPU 读取的仍是已经搬到近端的数据,而不是以 HBM 的代价直接访问远端闪存。
这里最有价值的变化,是计算资源与上下文资源可以分别扩缩。请求不必总是回到最初生成 KV 的节点,空闲会话也不必为了保留状态而占着昂贵的 GPU。代价是,共享层要承担跨节点元数据查找、网络争用、租户隔离和故障恢复。这些成本在单节点的峰值带宽测试中不会完整出现。
CMX 能否带来收益,首先取决于保留半径是否真的覆盖到有价值的状态:
- 如果缓存几乎都在短时间内被重用,现有 DRAM 已经覆盖工作集,新增的闪存大部分时间只是在接收不会再被读取的数据。
- 如果大量会话在几十分钟甚至数小时后才恢复,而内存容量不足导致反复重算,那么增加一个更慢但足够大的层次,就可能改善平均响应。
真实负载确实呈现这种长尾。Mooncake 团队分析了阿里云百炼的生产轨迹[5]:
| 场景 | 10 分钟内被再次访问的复用块 | 超过 30 分钟后的冷复用 |
|---|---|---|
| 代码生成 | 69.2% | 10.3% |
| 推理型对话 | 83.0%(短周期复用) | 5.0% |
热簇与冷尾并存。LRU 或固定 TTL 策略容易把"冷但仍有价值"的块提前淘汰。
至于 NVIDIA 公布的"最高 5 倍",指的是 TPS 与能效两项,参照对象都是传统存储[4],不能解读为比优化过的分布式 DRAM 快五倍。对采购决策而言,更应关注同一条请求轨迹下收益的来源:多少来自容量,多少来自网络和数据路径,多少来自预取或路由改进。即使整机方案有效,也要知道具体是哪一部分在创造价值。
3 KV 容量必须从模型和状态结构推导
"百万 token 需要多少 KV"没有通用答案。对普通的多层注意力模型,未压缩 KV 可以这样估算:
token 数 × 层数 × KV 头数 × 每头维度 × 每元素字节数 × 2
最后的 2 对应 K 和 V。这个公式有几处常见偏差:
- GQA 的 KV 头数少于 query 头数,直接套用隐藏维度会高估;
- MLA、跨层共享、滑动窗口和量化都会改变状态结构;
- 公式不包含页管理、对齐、副本和其他运行时状态。
从服务系统的角度,还要区分三个量:"逻辑上下文长度""物理保留的 KV 字节数""恢复一次请求实际要搬运的字节数"。共享前缀可以去重,块可以按层或按 rank 分片;但恢复时可能需要布局转换,也可能不得不把只用到一部分的大对象整体读出。三类规划各看一个量:
- 容量规划看物理占用;
- 网络规划看实际传输;
- 延迟评估看关键路径上的可用状态。
工程估算可以分两步:
- 对去重后的逻辑状态,用 token 数乘以实际的每 token 字节数;
- 再加上 TP 切分或复制、块填充、存储副本、容量余量、staging 和元数据。
TP 并不总是把所有状态均分到每张卡上,复制项要按具体实现核对。把所有会话的上下文长度直接求和而不扣除共享前缀,也会高估总容量。
DeepSeek-V4.1-Flash 是一个具体例子。论文区分了两种占用[6]:
- global KV cache:常驻 HBM。借助 CSA2 的跨层 KV 复用与 FP4 KV 缓存,降到 890 字节/token,约为 V4-Flash 的 1/4。
- 持久 KV cache:常驻 SSD 或主机内存。借助一项名为 SWA Bounded Replay 的部署优化,降到 V4-Flash 的约 1/8。
据论文第 3.2 节,持久缓存至少保留 72 小时;SWA 相关状态进入由每台机器约 10% 主机 DRAM 组成的分布式池,TTL 为分钟级,未命中时通过有界重放重建——官方说明其结果是一份近似的 SWA KV Cache,不能当作任意场景下的精确缓存替代[6]。
这说明分层决策可以发生在同一个请求内部:长期有价值、重建昂贵的状态进入大容量层;短期热状态留在 DRAM;可以有界重放的部分按需重建。模型算法的变化也会移动存储投资的边界:
- KV 压缩让更多工作集能留在 DRAM,减轻扩容压力;
- KV 压缩也减少了从闪存取回的字节数,让共享层更容易满足时限。
两种作用方向相反。"KV 变小了"不能直接推出"存储不再重要",需要重新测量。
4 公开实测揭示了容量拐点,也划出了比较边界
Mooncake 的 SSD offload 实验很好地展示了容量拐点。在按轮次拆解的测试中,为隔离 prefill 时延,输出长度固定为 1 个 token:
- 前六轮:内存池够用,两种配置的命中率都在 80% 以上。
- 第七轮起:不带 SSD 的配置开始淘汰 KV,命中率从 83% 跌到 36%,TTFT 从约 6 秒升到约 16 秒。
- 启用 SSD 后:被淘汰的块仍留在 NVMe 上,命中率直到第八轮都保持在 84% 以上,TTFT 被控制在 9.4 秒[5]。
可见,工作集越过内存容量之后,更慢的层次仍可能通过减少 miss 改善整体响应。
但这不是"等内存、只换介质"的严格对照。测试在单台 DGX(8×A100-SXM4-40GB、双 RDMA 网卡)上完成,共对比四种配置(含 HiCache L1+L2、Mooncake DRAM 池与再加 SSD 等组合),按轮次拆解的对照集中在带与不带 SSD 两种[5]。因此不宜把差值全部归因于 SSD,也不宜把这一 TTFT 结果外推到长输出服务。
LMCache Raw Block 的 TP=4 验证则提供了相反方向的证据[7][8]:
| 后端 | 吞吐 | 平均 TTFT |
|---|---|---|
| 本地 CPU 内存 | 10.82 req/s | 723 ms |
| buffered 本地文件 | 8.55 req/s | 931 ms |
| Raw Block | 7.17 req/s | 1,110 ms |
| O_DIRECT 本地文件 | 1.95 req/s | 4,096 ms |
这既不是 CMX 测试,也不是与远端分布式 DRAM 的对照,适合用来观察不同介质与实现路径的边界。原作者给出的解释是:主机内存充足、工作集有利时,页缓存可以非常有效[7]。这一行结果也说明,同样是"直接 I/O",Raw Block 与一种 O_DIRECT 文件配置之间的差距可达数倍,实现细节的影响不亚于介质本身。
生产侧的证据更硬。 vLLM 团队 2026 年 5 月报告了将 Mooncake 分布式 KV 池接入 vLLM 后的实测[9]。在 12 张 GB200(1P1D)上回放真实的 Codex 智能体轨迹:
- 缓存命中率由 1.7%(仅命中系统提示词)升至 92.2%;
- 单 GPU 吞吐由 2,012 提高到 7,669 token/s(3.8 倍);
- P50 TTFT 由 82.93 秒降到 1.80 秒(46 倍);
- 端到端延迟降低 8.6 倍。
另一组扩展实验采用参数对齐 Codex 的合成负载和轮询路由,从 12 卡扩到 60 卡,吞吐近线性增长,命中率始终高于 95%[9]。
Mooncake 论文的结论方向一致。arXiv 版称,该架构使 Kimi 在真实负载下多处理约 75% 的请求[10]。FAST '25 版报告,在满足 SLO 的前提下,有效请求容量比基线方法提升 59%–498%;实际部署在 A800、H800 集群上分别多处理 115% 和 107% 的请求;系统运行在数千个节点上,每天处理超过 1,000 亿 token[11]。
需要强调口径:这些数字证明的是"池化与复用避免重算"的价值,对照基线是"没有分布式缓存",仍然不是闪存与分布式 DRAM 的受控比较。本次核验的公开材料中,我们没有找到足以完成这种受控比较的 CMX 数据集。这只说明公开资料的范围,不代表此类测试不存在。
几组实验并不矛盾:一组揭示容量不足时 miss 的代价,另一组揭示不同数据路径的服务成本。它们共同提示,性能报告必须同时给出以下信息:
- 工作集与容量的关系;
- 主机内存的实际占用;
- 缓存的冷热状态;
- 输出长度和并发度。
缺了这些,"闪存胜过内存"或"闪存没有价值"都可能只是实验条件造成的假象。
5 把一次恢复拆成真实的关键路径
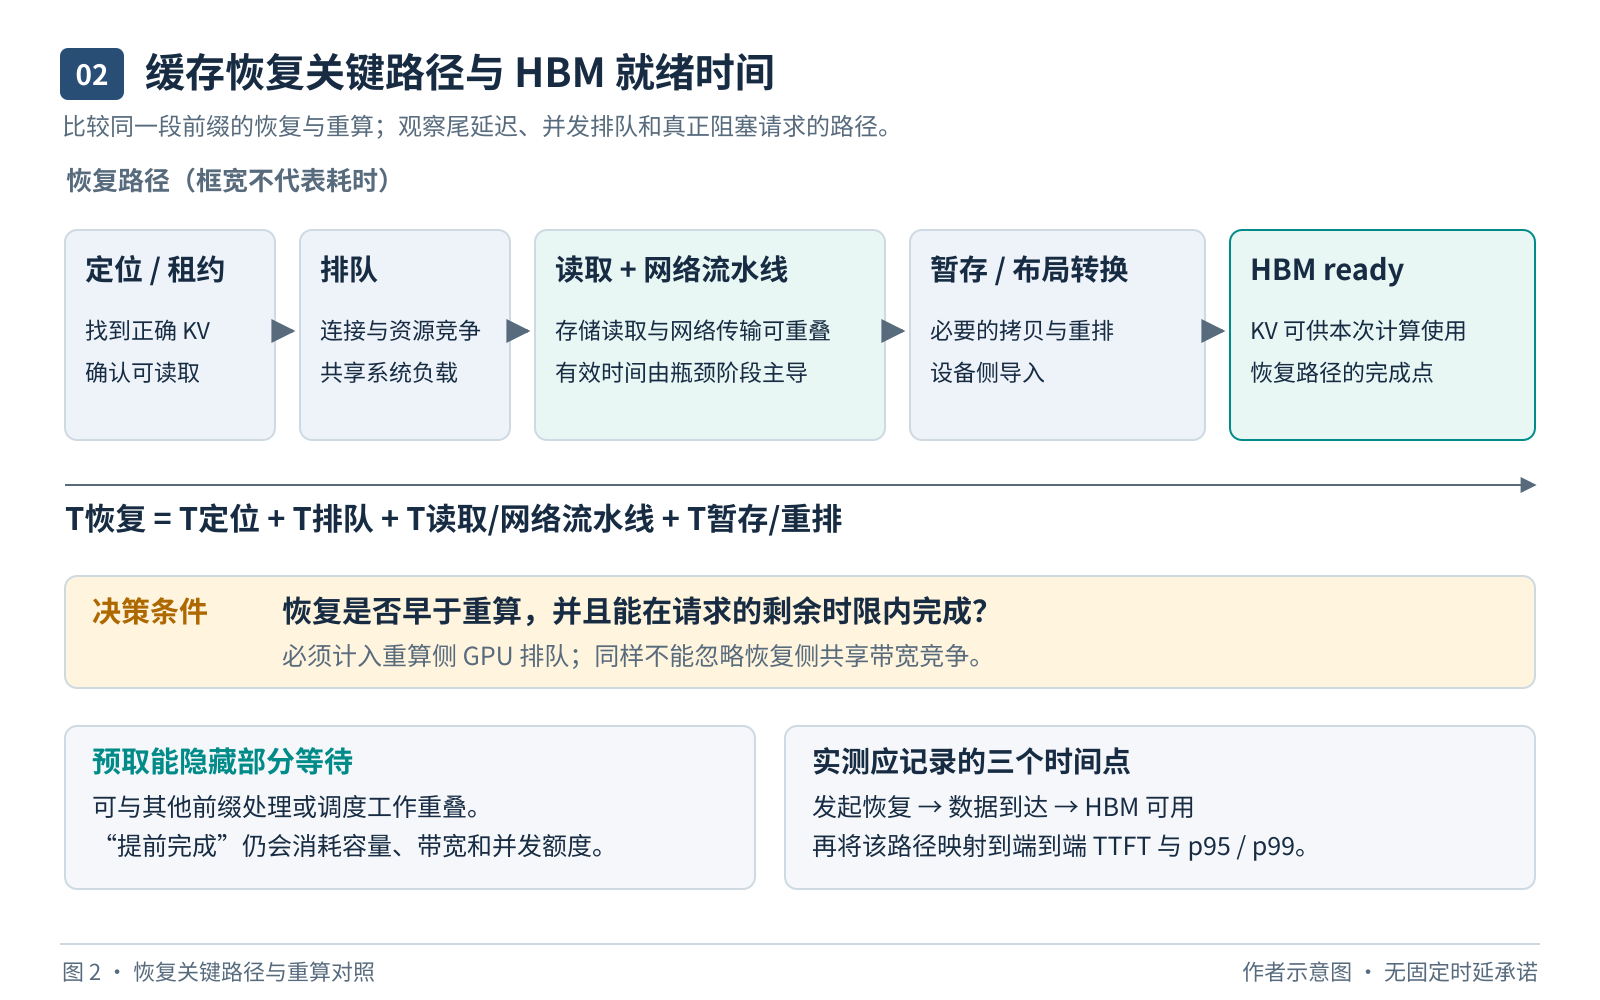
从缓存命中到首个 token,并不是一次读取就结束。一次恢复通常要经过这些步骤:
- 完成身份校验与前缀匹配;
- 取得位置元数据;
- 预留目标缓冲区,发起远端读取,等待数据到达;
- 完成解压、校验或布局转换;
- 把状态放到执行所需的位置;
- 计算尚未缓存的新后缀;
- 进入 decode。
任何一步阻塞,都可能抵消底层介质的优势。
一个有用的分解是:
TTFT = 路由与排队 + 前缀恢复或重算 + 新后缀 prefill + 首步 decode + 返回开销
这个式子表达的是依赖关系,不是说每一项都必须串行相加。流式分块、逐层加载和预取可以让部分工作重叠,但能重叠多少取决于推理引擎和模型布局。"API 是异步的"并不能自动抵消传输时间。
示意算例。 假设一次恢复有 8 GiB 数据要经过同一个瓶颈,可分配的有效聚合吞吐为 32 GiB/s,那么单纯传输的下限就是 250 ms。这里的字节数与带宽已在同一统计范围内,不能再因为 TP 而重复除以卡数。这个下限还没算元数据、排队、存储读延迟和 GPU 侧处理。
两类常见的失真对比要避免:
- 用"几十微秒延迟"代表这种大对象恢复。这个数字通常只指小 I/O 或设备访问。
- 用芯片级 DRAM 的纳秒访问去对比端到端的 SSD 恢复。远端 DRAM 同样要经过网络、注册缓冲区和 rank 汇聚。
如果存储读取、网络发送和拷贝能稳定地流水化,大对象的稳态耗时更接近"数据量 ÷ 最慢阶段的吞吐",再加上启动开销和无法重叠的处理;如果存在严格的串行依赖,就必须把相应阶段累加。真实的关键路径要用 trace 验证。不能一边把各段的带宽时间全部相加,一边又在结尾笼统扣掉一笔"异步收益"。
预取提供了另一条路径。 智能体调用外部工具期间,服务端可能已经知道下一轮会用哪个前缀,于是提前把 KV 从闪存搬到 DRAM。用户感受到的是"工具一结束就很快继续",而不是完整的存储读取时间。但预取也可能读错、读得太早,或者因为占用过久而挤掉真正的热对象。必须同时统计以下四项:
- 预取覆盖率;
- 有效使用率;
- 额外流量;
- 占用时长。
写入应与读取分开评估。 如果每轮生成都要等远端持久化确认,存储就进入了用户的响应路径。对于可以重算的缓存,常见做法是先保证内存中可见,再异步降级到闪存,故障时接受部分状态丢失。是否允许这样做属于服务契约,必须写明;缓存不能作为业务事实的唯一存储。
6 一个可以复算的响应模型
先用一个刻意简化的模型说明条件。定义如下:
- hD:所有请求中 DRAM 命中的比例;
- hF:DRAM 未命中但闪存命中的比例(无条件比例),其余请求重算;
- D、F:分别为 DRAM、闪存的恢复时间;
- R:miss 后的重算时间;
- O:新增层次带来的平均边际开销。
D、F、R 分别代表互相替代的完整前缀路径。前序的查找与等待必须计入相应路径或 O,不能漏算。假设每个分支内部成本相同,则:
E前缀 = hD × D + hF × F + (1 − hD − hF) × R + O
这个量是"可复用前缀的平均服务时间",不是完整的 TTFT,也不是 GPU 忙碌时间。它暂时排除了公共的新后缀、decode、网络返回以及负载变化引起的排队,并且按请求等权。真实系统应按前缀长度和分支分布分别建模。
示意假设:
- 现有 DRAM 命中率 80%,DRAM 恢复 20 ms,miss 重算 2 秒;
- 新增闪存再挽回 15% 的请求,总命中率达到 95%;
- 闪存恢复 300 ms,平均额外开销 O 为 20 ms;
- O 只计入混合方案的每个请求,其他方案不计。
| 示意方案 | DRAM 命中 | 闪存命中 | 重算 | 平均前缀服务时间 |
|---|---|---|---|---|
| 现有 DRAM | 80% | 0 | 20% | 416 ms |
| DRAM + 共享闪存 | 80% | 15% | 5% | 181 ms |
| 扩容 DRAM | 95% | 0 | 5% | 119 ms |
| 闪存恢复退化到 2.2 秒 | 80% | 15% | 5% | 466 ms |
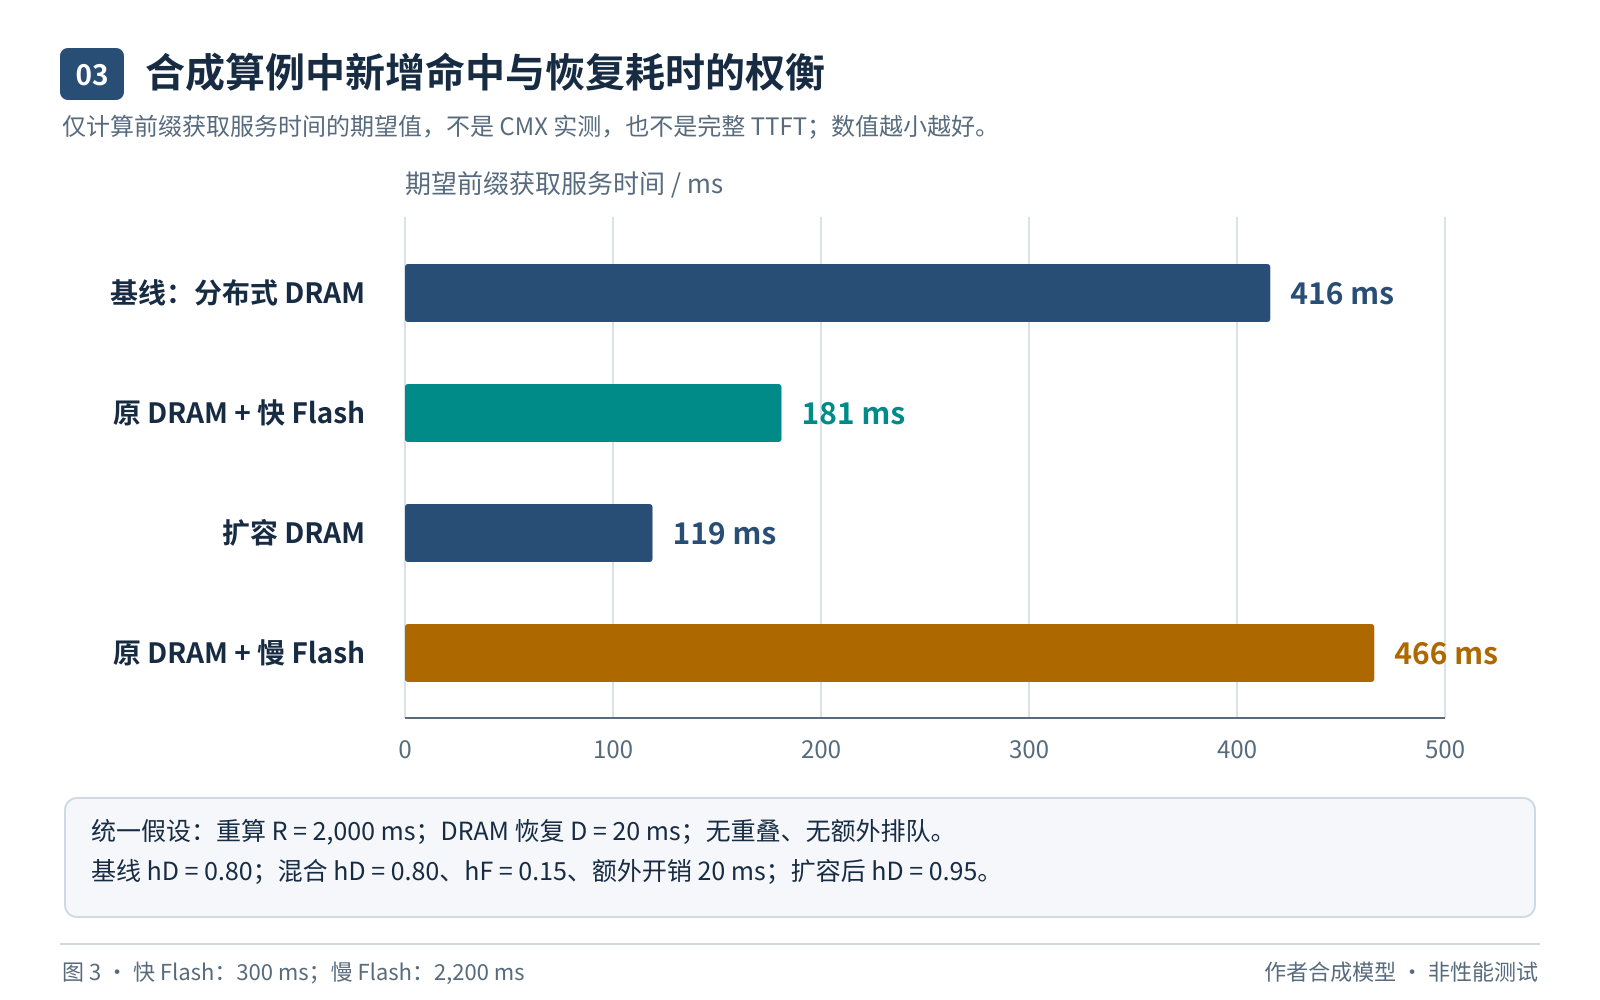
从这张表可以读出三点:
- 416 → 181 ms:分层方案可以明显胜过容量不足的内存方案。
- 181 vs 119 ms:只要预算够把同样的有效工作集留在 DRAM,扩容 DRAM 在这个模型里依然更快。这一比较的前提是两者总可用容量相同、保留的可缓存工作集相同。
- 466 ms:存储命中不一定比 miss 好,恢复太慢甚至会拖累整体。
盈亏条件。 在 DRAM 命中率不变的前提下,加入闪存的平均收益为:
hF × (R − F) − O
代入本例,F 低于 2 秒还不够,必须满足:
F < 2 − 0.02 / 0.15 ≈ 1.867 秒
才能覆盖平均额外开销。如果分层缓冲挤占了原有内存,还要计入 DRAM 命中率下降带来的损失:原本 20 ms 的热命中被挤到慢层,可能很快吃掉新增容量的收益。
hF 也不能直接照抄"第二层命中率"。如果第二层在 DRAM miss 中命中 75%,而 DRAM miss 占 20%,那么无条件的 hF 才是 15%。
模型还有一个容易被忽视的选择偏差:进入闪存的往往不是随机请求,而是重用间隔更长、前缀更大的那一组,它们的 R 和 F 都可能高于平均值。实践中应按请求类别分别计算条件收益,并为闪存 miss 单独计入查找与等待成本。只给闪存命中计时,会系统性高估分层效果。
7 平均值之外,带宽和 P99 决定能否部署
平均前缀服务时间下降,P99 不一定改善。上面的示意分布里仍有 5% 的请求落入 2 秒的重算分支,181 ms 的均值推不出"P99 小于 200 ms"。
分位数不能按命中率加权平均,必须从完整的请求分布计算。如果所有命中分支都比 miss 快,5% 的 miss 会让整体 P99 落在 miss 分支内部约 P80 的位置,因为 95% + 5% × 80% = 99%。
如果把本例各分支都当作固定延迟、完全忽略排队,混合方案的前缀 P99 是 2.02 秒,反而高于原方案的 2 秒。这只是一个玩具模型,但足以说明:均值改善不保证尾部改善。
排队更麻烦。 闪存读取、网络传输和 GPU prefill 都是共享资源。某一层容量增加后,可能把原本分散的重算变成集中的恢复流量。单个请求变快,不代表持续压力下依然快。命中率描述的是"数据在不在",带宽与队列描述的是"能不能及时取到",两者缺一不可。
稳态带宽检查:
闪存读取带宽需求 ≈ 请求到达率 q × 需要从闪存读数据的请求比例 pF × 这类请求的平均读取字节数
假设 100 req/s,其中 20% 的请求各需读取 8 GiB,就需要约 160 GiB/s 的有效读取能力。这个示意值还不包括预取、重复读、复制、写入和故障重建。如果网络无法长期提供这样的吞吐,单请求 250 ms 的展示就没有意义。
带宽还要按拓扑检查。 集群总带宽够用,但某个机架上联、某个存储目标或热门前缀的副本不够,也会出现局部排队。多个请求共享同一前缀时,合并恢复或热点复制可以减少重复 I/O;反之,如果每个请求都先读同一个大对象再各自裁剪,就会出现"逻辑上去重了,网络上没有去重"的浪费。
批处理对三类方案的影响各不相同:
- 重算可以利用大批次提高 GPU 吞吐,但可能拉长排队;
- 存储可以通过批量请求摊薄元数据成本,却要为凑批而等待;
- DRAM 能更快服务小批量,但同样受网卡、注册内存和调度线程的限制。
因此比较时应同时给出低负载响应和逐步增压下的容量曲线,标出哪个资源先饱和,而不是各自挑最有利的并发点。多 rank 恢复要等最慢的分片,批处理要等最后一个必需的块。局部的平均读延迟再好,也描述不了这些汇聚点的尾部。
恢复策略必须有截止时间。 当预测的恢复完成时间晚于请求的剩余预算,或晚于直接重算,就应跳过、缩短或取消读取。必要时可以让读取与重算赛跑,但"谁先完成用谁"会消耗双份资源,必须设限额。在已经过载的系统里,不加约束的对冲请求(hedging)往往会进一步放大尾延迟。
8 成本要比三次,不能只比每 TB 价格
同有效容量。 三套系统保留同样的可用状态,扣除副本、预留空间、元数据、对齐浪费和不可用容量后,再比较恢复时延、服务能力与成本。这个口径适合评价介质与架构的效率,但不一定反映真实的采购选择,因为同等容量的全 DRAM 方案可能超出预算。
同预算。 给定相同的年度成本,分别采购纯 DRAM 或 DRAM 加闪存,再用同一条轨迹测量命中分布、SLO 达成率和可承载的到达率。这个口径最能反映容量与速度之间的取舍。两套系统的逻辑容量、可靠性和运维边界仍需公开;如果用更弱的数据保护换来价格优势,必须写明。
同 SLO。 固定模型、请求轨迹、峰值到达率和 P99 目标,找出每种架构能稳定达标的最小配置,再比较完整的 TCO。这个口径通常最接近生产决策。如果闪存方案需要额外的 DRAM、更多网络端口或更多 GPU 并发来掩盖读取延迟,这些成本都应计回闪存方案。
TCO 的边界。 完整 TCO 包括设备年化成本、服务器与 DPU、网络、软件支持、电力与制冷、机架、运维、备件、容量冗余和故障影响。增量 TCO 只比较当前决策真正增加或避免的费用。两条原则:
- 现有内存不能在一个方案里按零成本计,在另一个方案里按全新采购价计;
- 新系统也不能只报裸盘价格,而把客户端内存和网络当作免费。
2026 年的内存价格让扩容 DRAM 这笔账更难算。 据 TrendForce:
- 传统 DRAM 合约价 2025 年四季度环比上涨 45%–50%,含 HBM 的混合口径为 50%–55%[12];
- 2026 年一季度实际涨幅约 93%–98%,高于 2 月上修后的 90%–95% 预测[13][3];
- 二季度预计再涨 58%–63%[3]。
闪存同样在涨:2 月的预测是一季度 NAND 合约价上涨 55%–60%[13]。但它的每 GB 基数远低于 DRAM,两者每 GB 的绝对价差仍在扩大。供给侧的主因之一是 HBM 挤占了晶圆产能。据渠道商 Fusion Worldwide 的分析,HBM 已占全球 DRAM 晶圆产能约 23%(2024 年约为 8%),一片 HBM 晶圆消耗的产能相当于 3–4 片 DDR5 晶圆[14]。
示意算例:缓存层成本
以下数字均为教学假设,不与第 6 节构成实测上的对应关系。三种方案都提供 10 TiB 可用逻辑 KV 容量,跨层重复的块只计一次,副本、预留与必要的 staging 已计入硬件预算。按 36 个月直线摊销、零残值,每月 730 小时,电价 0.12 美元/kWh。
| 方案 | 服务器与介质 | 网络分摊 | DPU | 软件支持 | 分摊功耗 | 额外换盘准备金 |
|---|---|---|---|---|---|---|
| DRAM 容量层 | 12 万美元 | 1.2 万美元 | — | 200 美元/月 | 3.0 kW | — |
| 闪存容量层 | 1.8 万美元 | 1.2 万美元 | — | 200 美元/月 | 1.1 kW | 150 美元/月 |
| 混合(2 TiB DRAM + 8 TiB 闪存) | 5 万美元 | 1.2 万美元 | 0.8 万美元 | 400 美元/月 | 1.8 kW | 120 美元/月 |
给混合方案配 DPU 只是一项成本假设,并不暗示真实 CMX 的配置或价格。
| 假设方案 | 可用容量 | 硬件预算 | 月缓存成本 | 每百万请求的缓存成本 |
|---|---|---|---|---|
| DRAM 容量层 | 10 TiB | 132,000 美元 | 4,129.47 美元 | 412.95 美元 |
| 闪存容量层 | 10 TiB | 30,000 美元 | 1,279.69 美元 | 127.97 美元 |
| DRAM + 闪存 | 10 TiB | 70,000 美元 | 2,622.12 美元 | 262.21 美元 |
月缓存成本 = 硬件预算 / 36 + 软件支持 + 分摊功耗 × 730 × 0.12 + 额外换盘准备金
表格的读法:
- 请求量假设。 最后一列假设每月 1,000 万请求,只是成本分摊,不说明各方案能达到相同的峰值吞吐或 SLO。
- "闪存容量层"的含义。 指专门承担缓存容量的介质;系统仍需要主机内存、staging 和 GPU HBM。
- 价格时点。 表中价格是静态假设,没有反映上文的涨幅。若把 DRAM 容量层的服务器与介质预算上浮 50%,其月成本将升至约 5,796 美元。
- 统计范围。 这只是缓存层的成本小计,不是推理平台的完整 TCO。共用的 GPU、基础主机内存,以及机房 PUE 增量、人力、融资、税费和其他维修都未计入。初始 SSD 已在折旧中,换盘准备金只覆盖额外更换,不能对同一批盘重复计费。
- 同 SLO 验收。 还要把恢复所需的额外 GPU、失败重试和支持开销计回全系统的成本,并以满足全部服务约束的有效请求数作为分母。
示意算例:增量投资
假设现有 2 TiB DRAM 的硬件预算为 5.2 万美元,软件支持每月 200 美元,功耗 1.2 kW,则月成本为 1,749.56 美元。它的单 TiB 成本高于 10 TiB 方案,原因假设为:小规模配置分摊了更多服务器固定成本。
升级到上述混合方案,每月多花 872.56 美元。这里按两套完整配置的摊销差额计算,相当于把现有 DRAM 按重置成本计价。如果把它视为沉没成本,增量只需计入新增的闪存、DPU 与网络,结论会更有利于混合方案。读者应按自己的资产状况选择口径。
收益一侧的推算:
- 假设每月 1,000 万请求中新增 15% 的有效闪存命中,每次避免 1.6 GPU·秒的 prefill,但恢复本身消耗 0.1 GPU·秒。
- 理论上释放的算力为 10,000,000 × 15% × (1.6 − 0.1) / 3,600 = 625 GPU·小时。这与前缀的墙钟时延是两种度量。
- 按 2 美元/GPU·小时,理论价值为每月 1,250 美元。
- 但已购买或已预留的集群不会因为空出一点算力就自动退款。假设只有 60% 能真正减少计费或推迟计划中的采购,兑现价值为 750 美元。
- 750 美元低于新增成本,净收益为每月 −122.56 美元。
这个模型需要约 69.8% 的兑现比例才能收支平衡。如果既不缩容,也没有新增需求,现金节省可能为零。
这个结果比"闪存每 TB 更便宜"更贴近真实决策。释放出的能力可能体现为峰值余量、更好的 SLA 或推迟扩容,但在到达率不变时,不能直接记成新卖出的 token。同一笔算力节省,也不能既用来抵扣 GPU 账单,又按新增收入再算一遍。应先确认全系统在目标负载下达标,再讨论哪一笔费用可以真正取消。
9 命中率要按价值加权,闪存写入要设准入
请求命中率最直观,却未必反映缓存的价值。一个请求命中的是短短的系统提示词,另一个命中的是几十万 token 的会话前缀,在"命中请求数"里各算一次,节省的算力却可能相差几个数量级。至少要同时观察:
- 请求命中率;
- token 命中率;
- 字节命中率;
- 避免的 GPU 工作量。
对于分块复用,应记录最长的可用连续前缀,而不是把任意一个块命中都算成整个请求命中。
按 token 加权也不是终点。不同模型、长度和批次下,每个 token 的 prefill 成本并不相同;相同的 token 数经过不同的压缩和布局,恢复字节数也不同。更实用的缓存价值是:
预期的未来复用次数 × 每次可避免的计算成本 − 写入、读取、占用与维护成本
此外还要考虑过期和模型切换的概率。
并非所有被 DRAM 淘汰的块都值得写入 SSD。 一次性的长请求可能占用大量容量却从不回访;高频复用的中等前缀,价值密度反而可能更高。分层系统需要准入策略,把"淘汰到哪里"和"值不值得保存"分开处理。对已经结束、回访概率低的状态直接丢弃,往往比一律降级更经济。
闪存还要评估写放大与寿命。 每轮都覆盖整个会话,与只追加新完成的不可变块,写入量可以相差很大。设备层的垃圾回收、系统级副本、对象重打包和故障重建都会增加物理写入。应把主机写入、实际 NAND 写入、峰值写带宽和预期更换周期放在同一本账上,而不是只看顺序读带宽。
冷热也应随负载动态调整。 同一个会话,用户连续交互时很热,调用长时间运行的工具时暂时变冷,工具返回前又高度可预测。统一的固定 TTL 会把这三个阶段混为一谈。更合理的做法是,根据重用间隔、恢复成本、业务优先级和预测可信度来调整保留层次,同时设置可解释的限额,防止少数超长会话吞掉全部资源。
容量规模可以从轨迹中的复用距离推导。 对某个块,统计它两次访问之间出现的不同有效块的累计字节数,就能近似得到按字节 LRU 重新命中它所需的容量。把这些距离汇总成"命中率随容量变化"的曲线,就能看出继续扩容 DRAM 的边际价值,以及闪存能覆盖的长尾。
实际策略还有 TTL、预取、租户配额和变长块,需要用仿真或回放校正。先画曲线、再定容量,比先买若干 TB、再期待高命中率要可控得多。
10 更稳妥的共存架构:热层稳定,温层可退化
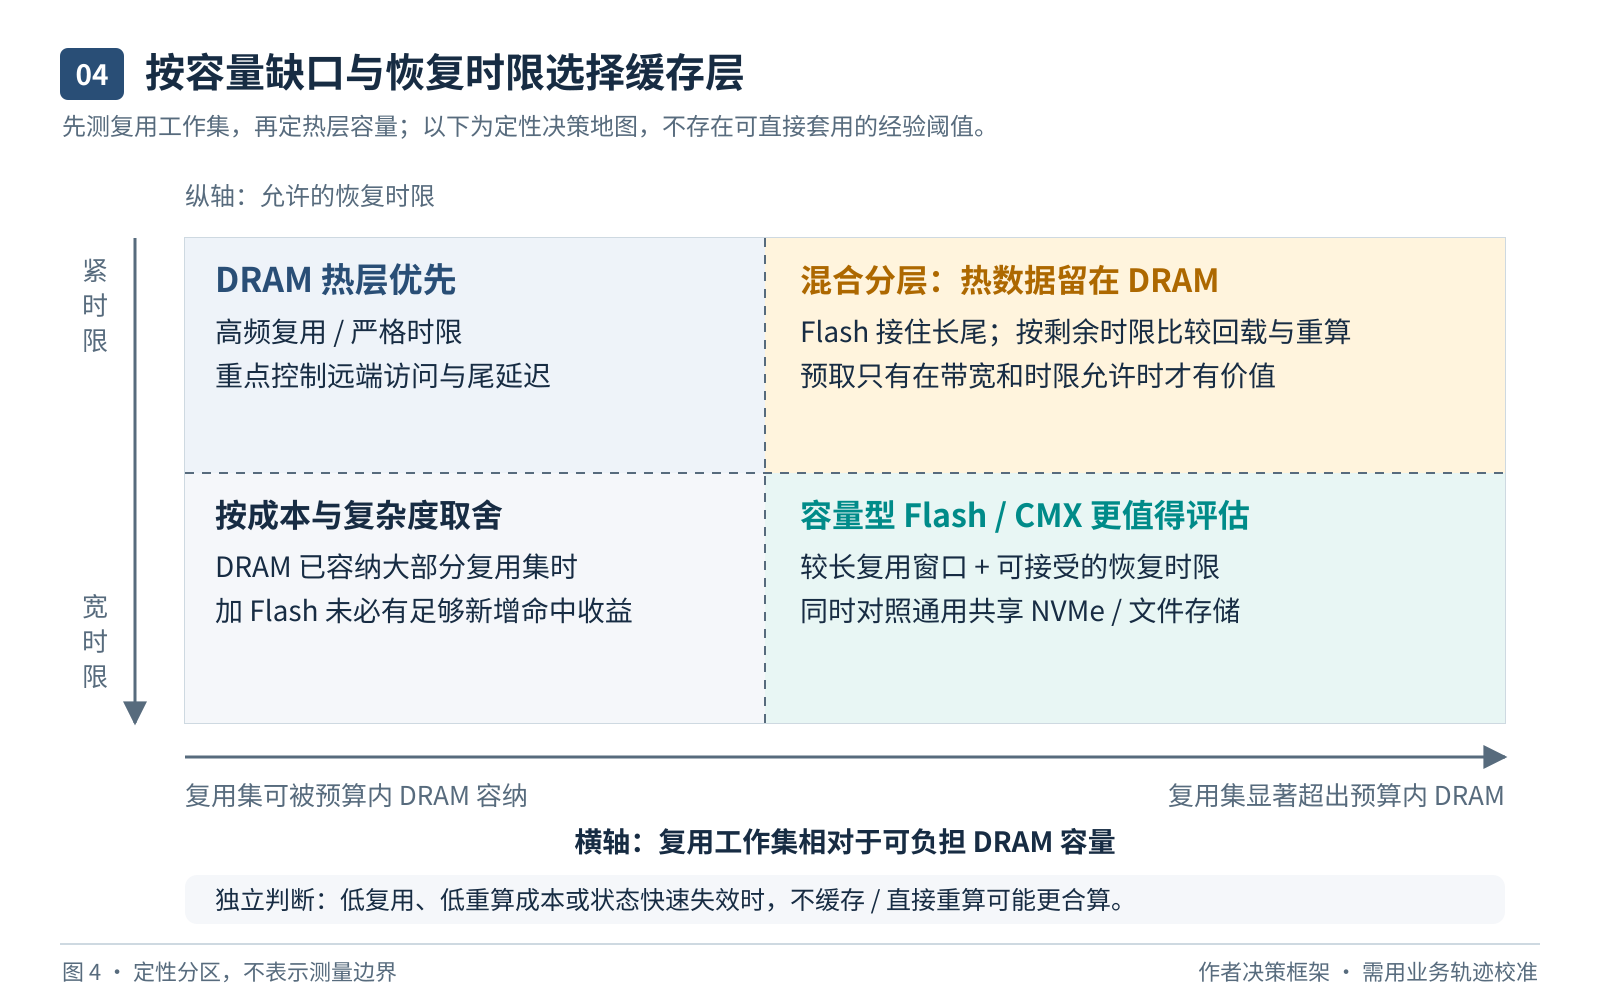
多数已经使用分布式内存的系统,不必从替换开始。风险更低的做法是:保留 DRAM 热层,把 CMX 或其他共享闪存作为可旁路的温层。
读路径。 请求先判断本地与远端 DRAM 中的有效前缀,再根据时限、对象大小和队列状态决定是否读取闪存;如果没有收益,就直接重算。元数据可以并行查询,但不能让所有 DRAM 热命中都额外等待闪存的确认。
写路径。 按已完成的块组织:
- 新 KV 先在热层可见;
- 稳定且值得保留的块在后台写入闪存;
- 对象写完并验证之后,再发布可读的位置。
读取期间用租约、引用计数或等价机制保护,防止块被淘汰后复用。读回后是否提升到 DRAM,取决于后续重用的概率,而不是每次闪存读取都无条件写入热层、挤占热数据。
路由。 跨节点路由可以参考缓存位置,但必须同时考虑计算排队。把请求发到"缓存都在"但很忙的节点,不一定比发到空闲节点、再从共享层读取更快。调度目标应是预测的完成时间,而不是最高命中率。共享闪存的意义之一,恰恰是降低对单节点亲和性的依赖,让计算池更容易均衡负载。
故障处理尤其关键。 缓存丢失通常可以重算,但状态损坏或租户混用绝不能当作可接受的退化。大规模同时丢失会引发 prefill 风暴;存储恢复后,又可能出现预热风暴,与前台读取争抢同一条链路。应为前台请求、后台写入、预热与重建分别设置预算,并优先恢复高价值热点,而不是全量扫描后一次性搬回。
版本发布也有类似效应。 模型权重、tokenizer 或 KV 布局变化后,旧状态即使字节完整也可能无法复用。滚动发布期间可以按版本保留多个命名空间,逐步预热新版本,并限制旧版本状态的回收速度。把升级当作一次受控的缓存冷启动,比上线后才发现全部 miss 要可靠得多。
11 多存储接入:NIXL 统一的是数据搬运接口
理解 CMX 的 API,先要把三层责任分开:
- 推理框架:了解 token、模型、KV 布局和执行依赖;
- 缓存控制层:了解键、位置、副本、保留策略和命中价值;
- 传输与存储插件:负责把指定的字节安全地搬到指定的位置。
NIXL 处在数据移动的关键位置,但它不是一个已经替所有后端实现了缓存生命周期的通用数据库[15]。
北向接口。 使用者围绕 agent、已注册内存和传输描述符工作:准备源端与目标端的描述,创建请求,发起 READ 或 WRITE,查询完成状态,最后释放请求与内存资源。涉及远端 agent 的路径还需要交换元数据。异步设计允许计算与传输重叠,但缓冲区的生命周期和依赖关系仍要由上层正确管理[16]。
南向插件。 插件需要声明名称、版本、支持的内存类型和配置参数,并提供创建、销毁后端实例的入口。NIXL v1.5.0 的插件头文件明确要求,插件与核心使用相同的 C++ 标准(目前为 C++20)和兼容的 libstdc++ ABI[17]。后端引擎接口包括 registerMem、prepXfer、postXfer、checkXfer、releaseReqH 等职责;queryMem、estimateXferCost 等可选方法,默认返回"不支持"[18]。一个方法存在,不代表每个后端的语义都相同。
插件接入还有几条硬约束:
- 插件 API 版本按严格相等校验,核心版本号一旦提升,树外插件就必须重新编译[15];
- 声明支持远端传输的后端,必须同时支持通知,否则无法创建[19];
- GDS 与 GDS_MT 不能在同一个 agent 中并存[19];
- 同一类型的后端只能创建一个实例,每种内存类型的后端偏好顺序由创建顺序决定[19];
- 自动选择后端时,源码按"第一个匹配的候选"处理[19];
- 传输请求之间没有排序保证,也没有针对内存区域的锁,避免并发写同一位置是使用者的责任[15]。
对存储厂商而言,实现几个虚函数只是开始,长期维护还包括打包、版本矩阵、驱动依赖、诊断和升级兼容。对用户而言,"自动选择最优后端"在当前实现里还远不是跨多个存储集群、实时比较成本与队列的联邦调度。多家存储并存时,目录、路由、故障域和能力选择仍需要更高层的设计。
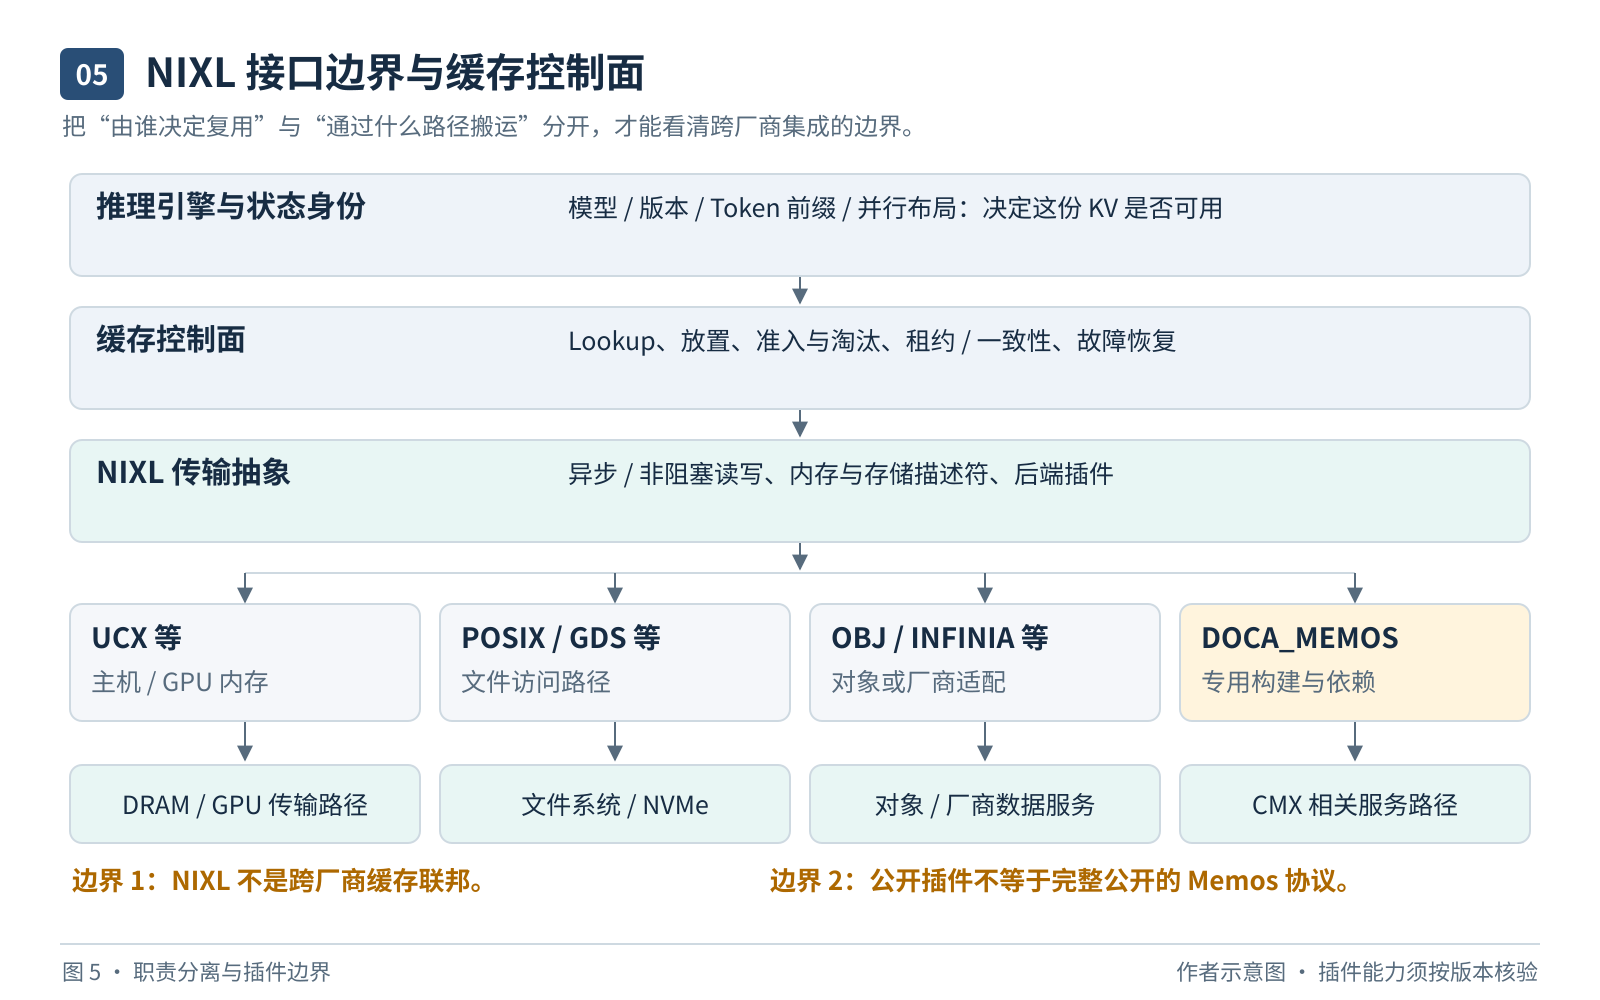
| 接口层次 | 应承担的责任 | 仅靠这一层无法保证的事 |
|---|---|---|
| 推理引擎与连接器 | KV 格式、执行依赖、可用前缀 | 全局放置与存储故障恢复 |
| 缓存控制层 | 身份、目录、租约、准入与淘汰 | 不同介质具有相同性能 |
| NIXL 与插件 | 能力声明、注册、异步数据移动 | 跨厂商统一的 TTL、删除与一致性 |
| 存储服务 | 实际对象、容量、隔离、数据保护 | 自动理解模型状态的复用条件 |
不同插件的数据路径并不相同。 按各插件的说明,POSIX 支持 DRAM 与文件,OBJ 支持 DRAM 与对象,INFINIA 还列出 VRAM 与对象[20]。NIXL 的总体设计文档至今仍写着"目前支持 UCX 与 GDS,其余文件、块和对象存储在开发中"[21],官方概览已经落后于插件的实际进度,选型时应以插件自身的文档和源码为准。
OBJ 插件新增的 S3 加速引擎(基于 cuObject 的 S3-over-RDMA 数据通路)在快速路径就绪时声明支持 VRAM 段,而默认的 S3/CRT 引擎仍只支持 CPU[22]。LMCache 的 Raw Block 后端也明确写着,其 I/O 路径是"CPU 缓冲区到存储",不是 NVMe 到 GPU 的 GPUDirect Storage[7]。由此可见,"用了 NIXL"推不出"绕过了主机内存",更推不出"已经部署了 CMX"。是否零拷贝,要沿完整的数据路径逐段检查。
12 API 接通之后,还需要一份完整的状态契约
一个能长期运行的多存储系统,首先要精确定义"同一个 KV 块"。键至少要绑定以下内容:
- 模型权重或不可变版本号;
- tokenizer 与预处理规则;
- token 前缀;
- 位置编码设置;
- 适配器;
- KV 精度与布局版本。
多模态状态还可能依赖图像或音频的预处理。租户隔离也必须进入命名空间或访问控制,防止因为提示词相同而发生未经授权的跨租户共享。S3、GDS、NVMe-oF 这些访问或传输机制,并不自动提供模型状态的互换能力:字节能传过去,与目标推理引擎能正确使用,是两份不同的契约。
块最好设计为不可变。 新数据写到新的身份下,完成后再发布;同一个键始终对应相同语义,重复写入可以幂等处理。内容散列有助于定位,但不能替代版本描述、校验和访问权限。如果因为接口限制而截短键,还要定义碰撞处理和完整身份验证,不能把短键本身当作正确性的证明。
读取契约要区分错误类型。 miss、过期、写入中、损坏、权限拒绝、后端超时和拥塞,对应的后续动作各不相同:
- miss 可以重算;
- 损坏需要隔离对象并告警;
- 权限错误不能简单地换一个后端重试。
批量读取还要定义部分成功,避免一个失败块迫使已经传完的数据全部重传。
生命周期要解决一个经典竞态。 控制层查到对象存在,到真正发起读取之前,存储层可能已经把它淘汰了。可选的方案有短租约、pin/unpin、带版本的读取令牌,或者允许失败并安全回退。无论选哪种,都要讲清楚传输过程中谁拥有源数据和目标缓冲区,以及超时后何时可以复用。只有 contains 加 get,消除不了这个时间窗口。
LMCache 的 CMX 接入提供了具体的观察点。 DOCA_MEMOS 作为对象式后端接入,键需要适配 128 位的约束,相关 PR 已于 2026 年 6 月 2 日合并[23]。但在现有的 NIXL 存储代码中,有几处语义需要逐项核实[24]:
- 静态路径的 contains 依赖本地映射;
- 动态路径可以在本地元数据未命中后调用 query_memory,具体行为受配置影响;
- 对象 remove 的本地记账不能直接等同于远端的物理删除;
- 动态 pin/unpin 等语义仍需逐项核实。
该 legacy 接入还要求 DOCA_MEMOS 使用 CPU 缓冲区,因此不能据此宣称它在这条路径上已经直接读写 GPU。对应的进程内官方文档已标注为 deprecated;新多进程(MP)路径的插件支持、测试覆盖与部署方式需要单独确认,不能从旧连接器的合并状态外推[24]。
这些细节并不否定接入的进展,而是说明"连接器支持"与"完整的生命周期兼容"是两个不同的完成标准。采购或集成时,应拿到一份能力矩阵,至少覆盖:
- 对象大小与对齐要求;
- CPU/GPU 缓冲区限制;
- 完成可见性;
- 取消与超时;
- 租约;
- 删除、TTL 与配额;
- 重启恢复;
- 统计与错误语义。
这是本文建议的接入契约,并不是说 CMX 已经公开实现了全部项目。开源侧正在逐项补齐:LMCache 的新多进程架构已经把 supports_query、supports_delete 和原子发布(atomic_publication)实现为后端能力位。配置了淘汰策略的后端如果不支持删除,会直接报错,而不是静默失败[25]。控制面能力正在从论文中的要求,变成可以检查的配置项。
在 NIXL v1.5.0 公开的插件构建清单中,我们没有看到 DOCA_MEMOS 与常规后端并列[20]。这只说明该版本公开清单的范围,不能据此推断插件不存在。SGLang 的相关 PR 在核验时仍未合并,并明确涉及大页、布局和缓冲区对齐等要求[26]。实际部署前,必须确认框架版本、插件的获取方式和硬件组合,不能把开发分支的代码当作开箱即用的产品保证。
13 NVIDIA 如何推进生态:把接入、分发和验收串起来
从现有材料看,NVIDIA 的推进方式层次清晰:
- 底层:用 STX 参考架构和 BlueField 确立硬件与数据路径方向;
- 中层:用 NIXL 等软件接口降低推理框架接入不同后端的成本;
- 上层:用框架连接器、官方软件包和合作伙伴组成可部署的组合;
- 验收:用认证与生产验证降低采购风险。
STX 发布时公布了广泛的合作阵容[1],但合作名单本身不能证明每个产品的实现或交付状态都相同。
软件分发尤其重要。 DDN 的 INFINIA 插件 PR 已于 2026 年 6 月 5 日合并[27]。DDN 随后说明,该插件已进入官方 NIXL 发行版与 Dynamo 容器,用户仍需另装 DDN 客户端包[28]。这降低了独立维护连接器的成本,但不意味着整套存储服务端因此开源。对厂商而言,进入默认分发渠道往往比一次联合演示更接近持续采用。
分发渠道也在接纳开源的事实标准。 TensorRT-LLM 于 10 月 10 日合入了原生的 Mooncake Store 连接器(KVCMv2)。在此之前,vLLM、SGLang、LMDeploy 已先后内置 Mooncake 接入;腾讯与 NVIDIA 及社区合作的 FlexKV 也基于 Mooncake Transfer Engine 实现分布式 KV 复用[29]。也就是说,NVIDIA 在自建 CMX/Dynamo 数据路径的同时,自家的推理栈也在兼容开源的分布式内存池。两条路线在软件层共存,而不是二选一。
各伙伴的进度要分开看:
- Dell:10 月 1 日的材料描述了基于 Grace 的 CMX 模拟与面向 Vera ARM64 的软件验证,并说明文中所述的 BlueField-4 CMX 硬件当时尚未商用[2]。
- WEKA:区分了三种状态:已商用的 Augmented Memory Grid、在 Grace/BlueField-3 上的验证,以及面向 BlueField-4 STX 的后续集成[30]。
- VAST:公开的 HiCache 指南走的是另一条路径:经主机 DRAM 中转,用 NIXL POSIX 插件和 NFS over RDMA 对接存储[31]。这证明常规存储可以通过共享接口参与 KV 分层,但不等于用上了 CMX 专用硬件或 DOCA Memos。
这些都是特定时间、特定产品范围内的陈述,既推不出"CMX 生态已经全部交付",也推不出"全部仍不可用"。生态在扩展,但产品标签替代不了对实际数据路径的核验。
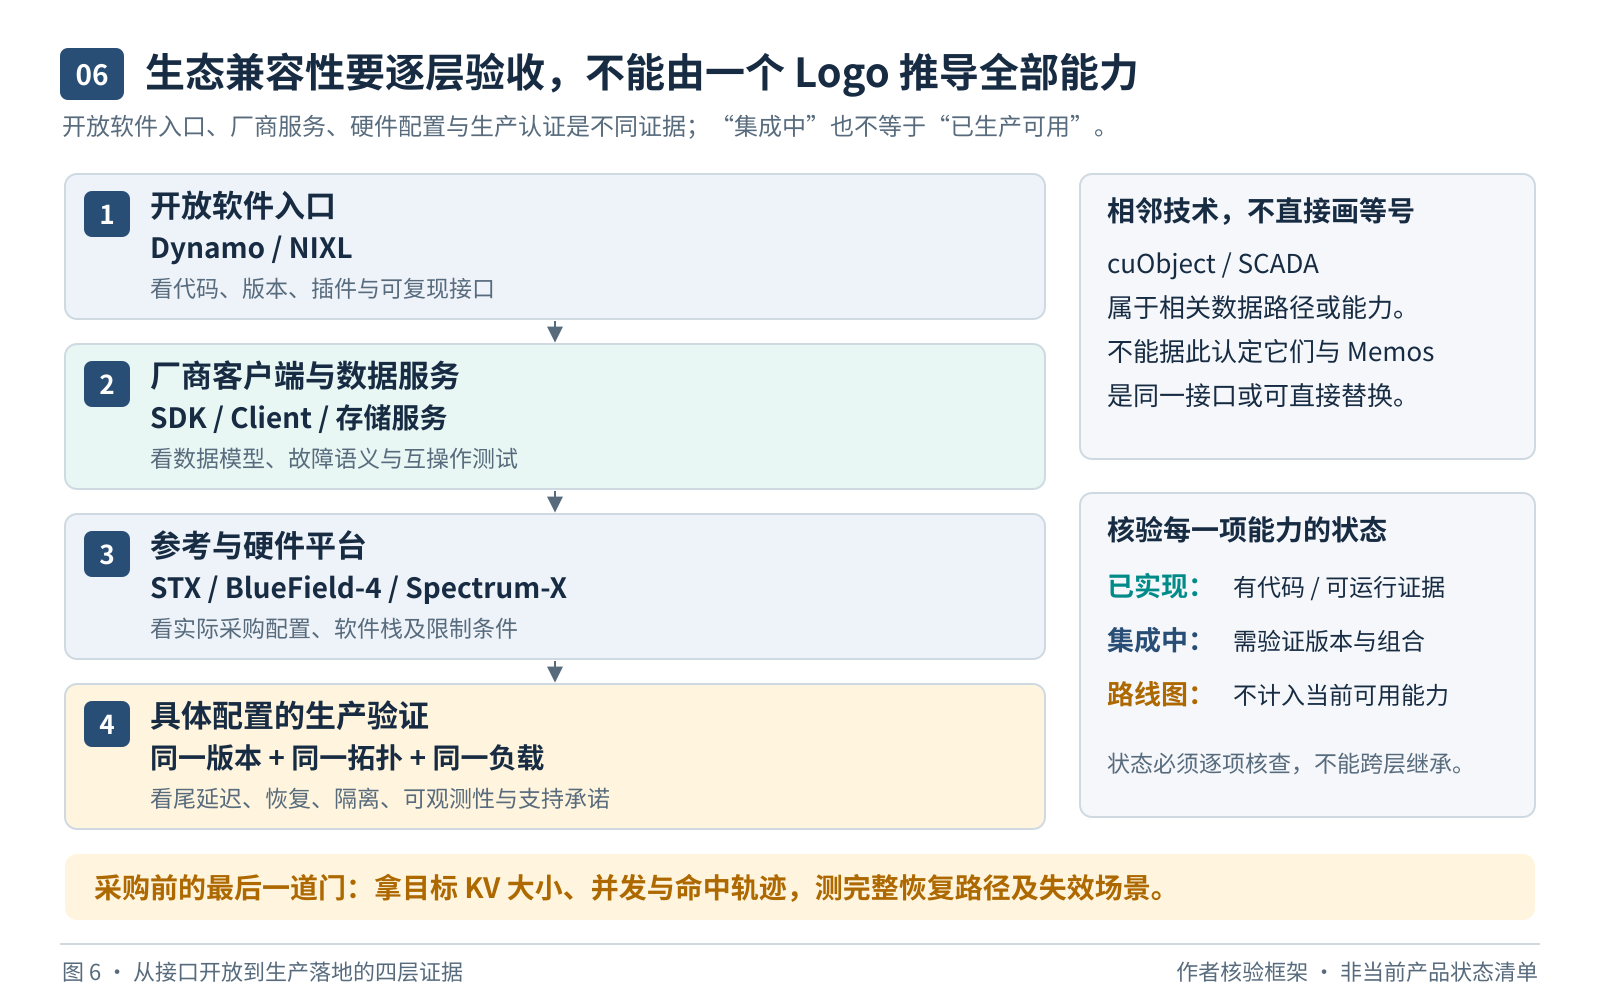
在更广的加速存储接口上,NVIDIA 于 9 月宣布 cuObject 客户端与服务端库正式可用(GA),并在推进 xio-sig 与 SCADA Server SDK。其中 SCADA 的合作示例包含原型,协议互操作工作也有自己的演进阶段[32]。这说明 NVIDIA 希望把各厂商的专用接口收敛到更稳定的生态入口。但 cuObject、SCADA 与 DOCA Memos 不能混为一谈,支持其中一个,并不自动获得另一个的全部能力。
认证的价值在于把讨论从峰值数字推向持续运行。NVIDIA-Certified Storage 文档强调真实工作负载、p50 至 p99 的分布、故障恢复和支持响应,并明确认证只适用于被测试的具体产品与配置[33]。因此,通用的存储认证不是对所有 CMX API 的一致性证明,也不能在产品系列之间直接继承。
对用户来说,最值得索要的是可迁移性证据:
- 能否导出目录与对象?
- 状态格式由谁控制?
- 更换后端时要重新预热多少数据?
- 出了故障,由框架方还是存储方负责?
统一接口可以减少适配的数量,却不能自动消除这些切换成本。成熟的生态,应当让性能竞争发生在可比较的契约之上。
14 验收应从一条请求轨迹开始
最有价值的测试输入,不是一组手工重复的提示词,而是一条保留了到达时间、会话间隔、前缀重用和长度分布的生产轨迹。脱敏时要保留重用关系,否则真实的缓存问题会退化成毫无意义的随机 I/O。模型版本、输入输出长度、TP 配置、精度和服务目标也要固定,否则差异无从解释。
第一轮:给现有分布式 DRAM 画曲线。 让容量从小到大变化,观察字节命中率、避免的计算量、TTFT 分布和 GPU 利用率如何变化。重点找两处:边际收益开始下降的位置,以及工作集越界后是否出现明显拐点。没有这条曲线,就无法判断新增的闪存究竟是填补了容量缺口,还是掩盖了热层策略的问题。
第二轮:保持热层不变,加入共享闪存。 把缓冲区、页缓存和预取占用全部计入,分别报告四种场景:
- 真正的冷启动;
- 元数据已恢复但数据仍冷;
- 预热后的稳态;
- 跨节点迁移。
然后在同容量、同预算、同 SLO 三种口径下复测,逐步提高到达率,并保留流量突发和大对象混入的情形。
指标不能只看 TTFT。 还应包括:
- token 间延迟与总完成时间;
- SLO 内完成的有效请求量;
- 各层命中率与实际读取字节;
- 预取浪费与写放大;
- 取消比例与重算量;
- 每条链路的队列。
把控制层、传输层和 GPU 执行时间串成一次请求的完整 trace,才能知道该在哪里优化。
故障演练。 停关一个存储目标、重启目录服务、制造网络拥塞、让部分对象过期、切换模型版本,观察三件事:
- 服务是否有界地退化;
- 是否触发全局重算或预热风暴;
- 恢复后能否回到稳定状态。
缓存可以丢,但丢失并非没有服务成本。
上线宜从旁路开始。 先只记录"如果读闪存,是否可能有收益";再对少量收益明确的请求启用,逐步扩大范围;始终保留一键回退到"DRAM + 重算"的能力。LMCache 论文讨论过存储恢复与重算的交叉点会随带宽变化[34],但其特定配置下的长上下文阈值不应当作通用规则。阈值应来自当前的模型、网络和负载,而不是某个固定的 token 数。
15 选型结论:按工作集和时限分工
- 热工作集可以经济地放进 DRAM,且交互式 P99 要求严格:优先优化或扩容分布式内存,通常更直接。
- 容量不足已造成大量昂贵的重算,且重用分布有明显长尾:DRAM 加共享闪存更值得验证。
- 请求几乎不复用、重算便宜,或者数据恢复长期受限于网络:继续依赖重算反而可能更合理。
| 工作负载特征 | 首先验证 | 优先考虑 | 应避免的做法 |
|---|---|---|---|
| 热集能放进内存,P99 严格 | DRAM 容量曲线与尾部 | 优化或扩容 DRAM | 让热命中绕道闪存 |
| 容量不足,长期复用明显 | 新增有效命中与恢复时限 | DRAM 热层 + 共享闪存 | 把所有淘汰块一律写盘 |
| 低复用,重算较便宜 | 复用价值与实际 GPU 成本 | 重算,少量热点缓存 | 为无效保留购买容量 |
| PD 分离,网络已接近瓶颈 | 迁移与恢复的合计流量 | 本地化、合并传输、选择性分层 | 只加 SSD 而不治理网络 |
| 已有大量闲置主机内存 | 可用性、争用与增量成本 | 先用分布式 DRAM | 把闲置内存当作永久免费的资源 |
CMX 的意义,在于把上下文容量、网络数据路径和推理调度纳入同一套基础设施设计。它的价值不能靠"闪存取代内存"来证明,也不该靠与无缓存基线之间的倍数差来证明。真正需要证明的是:在守住热层响应的同时,新增的容量能够按时挽回有价值的 miss,并以可兑现的成本优势承载更多真实需求。
对已经在运行分布式 KV 内存池的团队来说,最值得追求的终点往往是一套可退化的组合:
- DRAM 承接热状态;
- 共享闪存保存值得保留的温状态;
- 重算负责便宜或无法恢复的部分。
三者之间由状态契约、截止时间和成本模型连接起来。做到这一步,存储层次才真正服务于推理系统,而不只是采购清单上多出的一项。
参考资料
[1] NVIDIA. NVIDIA Launches BlueField-4 STX Storage Architecture With Broad Industry Adoption, 2026-03-16. https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-Launches-BlueField-4-STX-Storage-Architecture-With-Broad-Industry-Adoption/default.aspx [2] Dell. Breaking the AI Inference Context Memory Barrier with Dell Storage, 2026-10-01. https://www.dell.com/en-us/infohub/articles/breaking-the-ai-inference-context-memory-barrier-with-dell-storage [3] TrendForce. Rapid Contract Price Surge Drives 1Q26 DRAM Industry Up 81% QoQ(传统 DRAM 实际环比约 +93–98%;2Q26 预计 +58–63%), 2026-06-01. https://www.trendforce.com/presscenter/news/20260601-13070.html [4] NVIDIA. Introducing NVIDIA BlueField-4-Powered CMX Context Memory Storage Platform for the Next Frontier of AI, 2026-03-16. https://developer.nvidia.com/blog/introducing-nvidia-bluefield-4-powered-inference-context-memory-storage-platform-for-the-next-frontier-of-ai [5] Mooncake Community. Scaling KV Cache Beyond Memory with Mooncake SSD Offloading(SSD offload 实验配置与逐轮结果见文内及配图), 2026-07-15. https://kvcache.ai/blog/scaling-kv-cache-beyond-memory [6] DeepSeek-AI. DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression(§3.2), arXiv:2609.19969, 2026-09-17. https://arxiv.org/abs/2609.19969 [7] LMCache / Samsung. Raw Block in LMCache: Building a Fast, Recoverable NVMe Tier for KV Cache, 2026-09-22. https://blog.lmcache.ai/en/2026/09/22/raw-block-in-lmcache-building-a-fast-recoverable-nvme-tier-for-kv-cache [8] LMCache. PR #2948: [Feat][RawBlock] Add TP>1 support and compact batched retrieval path(TP4 端到端验证). https://github.com/LMCache/LMCache/pull/2948 [9] vLLM Team. Serving Agentic Workloads at Scale with vLLM x Mooncake, 2026-05-06. https://vllm.ai/blog/2026-05-06-mooncake-store [10] Qin et al. Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving, arXiv:2407.00079(v5, 2026-10-08 修订, 摘要). https://arxiv.org/abs/2407.00079 [11] Qin et al. Mooncake: Trading More Storage for Less Computation(FAST '25). https://www.usenix.org/system/files/fast25-qin.pdf [12] TrendForce. Price Rally Drives 4Q25 DRAM Revenue Up 29.4%; Samsung Regains No. 1 Market Share, 2026-02-26. https://www.trendforce.com/presscenter/news/20260226-12937.html [13] TrendForce. Memory Price Outlook for 1Q26 Sharply Upgraded; QoQ Increases of All Product Categories to Hit Record Highs, 2026-02-02. https://www.trendforce.com/presscenter/news/20260202-12911.html [14] Fusion Worldwide (Czuczwa, A.). Why DDR5 Prices Have Nearly Quadrupled in 2026(分销商研究), 2026-07-23. https://info.fusionww.com/blog/why-ddr5-prices-have-nearly-quadrupled-in-2026 [15] NVIDIA NIXL. Backend Plugin Interface Overview(BackendGuide.md). https://github.com/ai-dynamo/nixl/blob/main/docs/BackendGuide.md [16] NVIDIA NIXL v1.5.0. Northbound C++ API(src/api/cpp). https://github.com/ai-dynamo/nixl/tree/v1.5.0/src/api/cpp [17] NVIDIA NIXL v1.5.0. backend_plugin.h. https://github.com/ai-dynamo/nixl/blob/v1.5.0/src/api/cpp/backend/backend_plugin.h [18] NVIDIA NIXL v1.5.0. backend_engine.h. https://github.com/ai-dynamo/nixl/blob/v1.5.0/src/api/cpp/backend/backend_engine.h [19] NVIDIA NIXL v1.5.0. nixl_agent.cpp(后端创建与匹配逻辑). https://github.com/ai-dynamo/nixl/blob/v1.5.0/src/core/nixl_agent.cpp [20] NVIDIA NIXL v1.5.0. 插件目录与构建清单(src/plugins,含各插件 README). https://github.com/ai-dynamo/nixl/tree/v1.5.0/src/plugins [21] NVIDIA NIXL. NVIDIA Inference Xfer Library(nixl.md). https://github.com/ai-dynamo/nixl/blob/main/docs/nixl.md [22] NVIDIA NIXL. OBJ 插件 README(S3 加速引擎与内存类型表). https://github.com/ai-dynamo/nixl/blob/main/src/plugins/obj/README.md [23] LMCache. PR #3486: DOCA_MEMOS Storage Backend, 2026-06-02 合并. https://github.com/LMCache/LMCache/pull/3486 [24] LMCache. NIXL Storage Backend 实现(dev 分支)及 Legacy NIXL Backend 文档, 2026-10-25 核验. https://github.com/LMCache/LMCache/blob/dev/lmcache/v1/storage_backend/nixl_storage_backend.py [25] LMCache. 多进程架构后端能力位(nixl_native_l2_adapter.py, dev 分支). https://github.com/LMCache/LMCache/blob/dev/lmcache/v1/distributed/l2_adapters/nixl_native_l2_adapter.py [26] SGLang. PR #26073: DOCA Memos Support, 2026-10-25 核验时未合并. https://github.com/sgl-project/sglang/pull/26073 [27] NVIDIA NIXL. PR #1569: DDN Infinia Plugin, 2026-06-05 合并. https://github.com/ai-dynamo/nixl/pull/1569 [28] DDN. DDN Becomes the First Storage Vendor Natively Integrated into NVIDIA KV Cache Management. https://www.ddn.com/blog/ddn-becomes-the-first-storage-vendor-natively-integrated-into-nvidia-kv-cache-management [29] kvcache-ai. Mooncake GitHub 项目动态(TensorRT-LLM KVCMv2 2026-10-10;FlexKV 2026-01-28). https://github.com/kvcache-ai/Mooncake [30] WEKA. WEKA Maximizes Token Output With Lower Cost Per Token on NVIDIA BlueField-4 STX, 2026-03-16. https://www.weka.io/news/neuralmesh-nvidia-stx [31] VAST Data. SGLang HiCache Using NIXL, 2026-10-22 更新. https://kb.vastdata.com/docs/sglang-hicache-using-nixl-nvidia [32] NVIDIA. Expanding AI Storage Access with NVIDIA cuObject and the NVIDIA SCADA Server SDK, 2026-09-30. https://developer.nvidia.com/blog/expanding-ai-storage-access-with-nvidia-cuobject-and-the-nvidia-scada-server-sdk [33] NVIDIA. NVIDIA-Certified Storage. https://docs.nvidia.com/certification-programs/certified-storage/latest/nvidia-certified-storage.html [34] Cheng et al. LMCache: An Efficient KV Cache Layer for Enterprise-Scale LLM Inference, arXiv:2510.09665, 2025-10-08. https://arxiv.org/abs/2510.09665