
引子
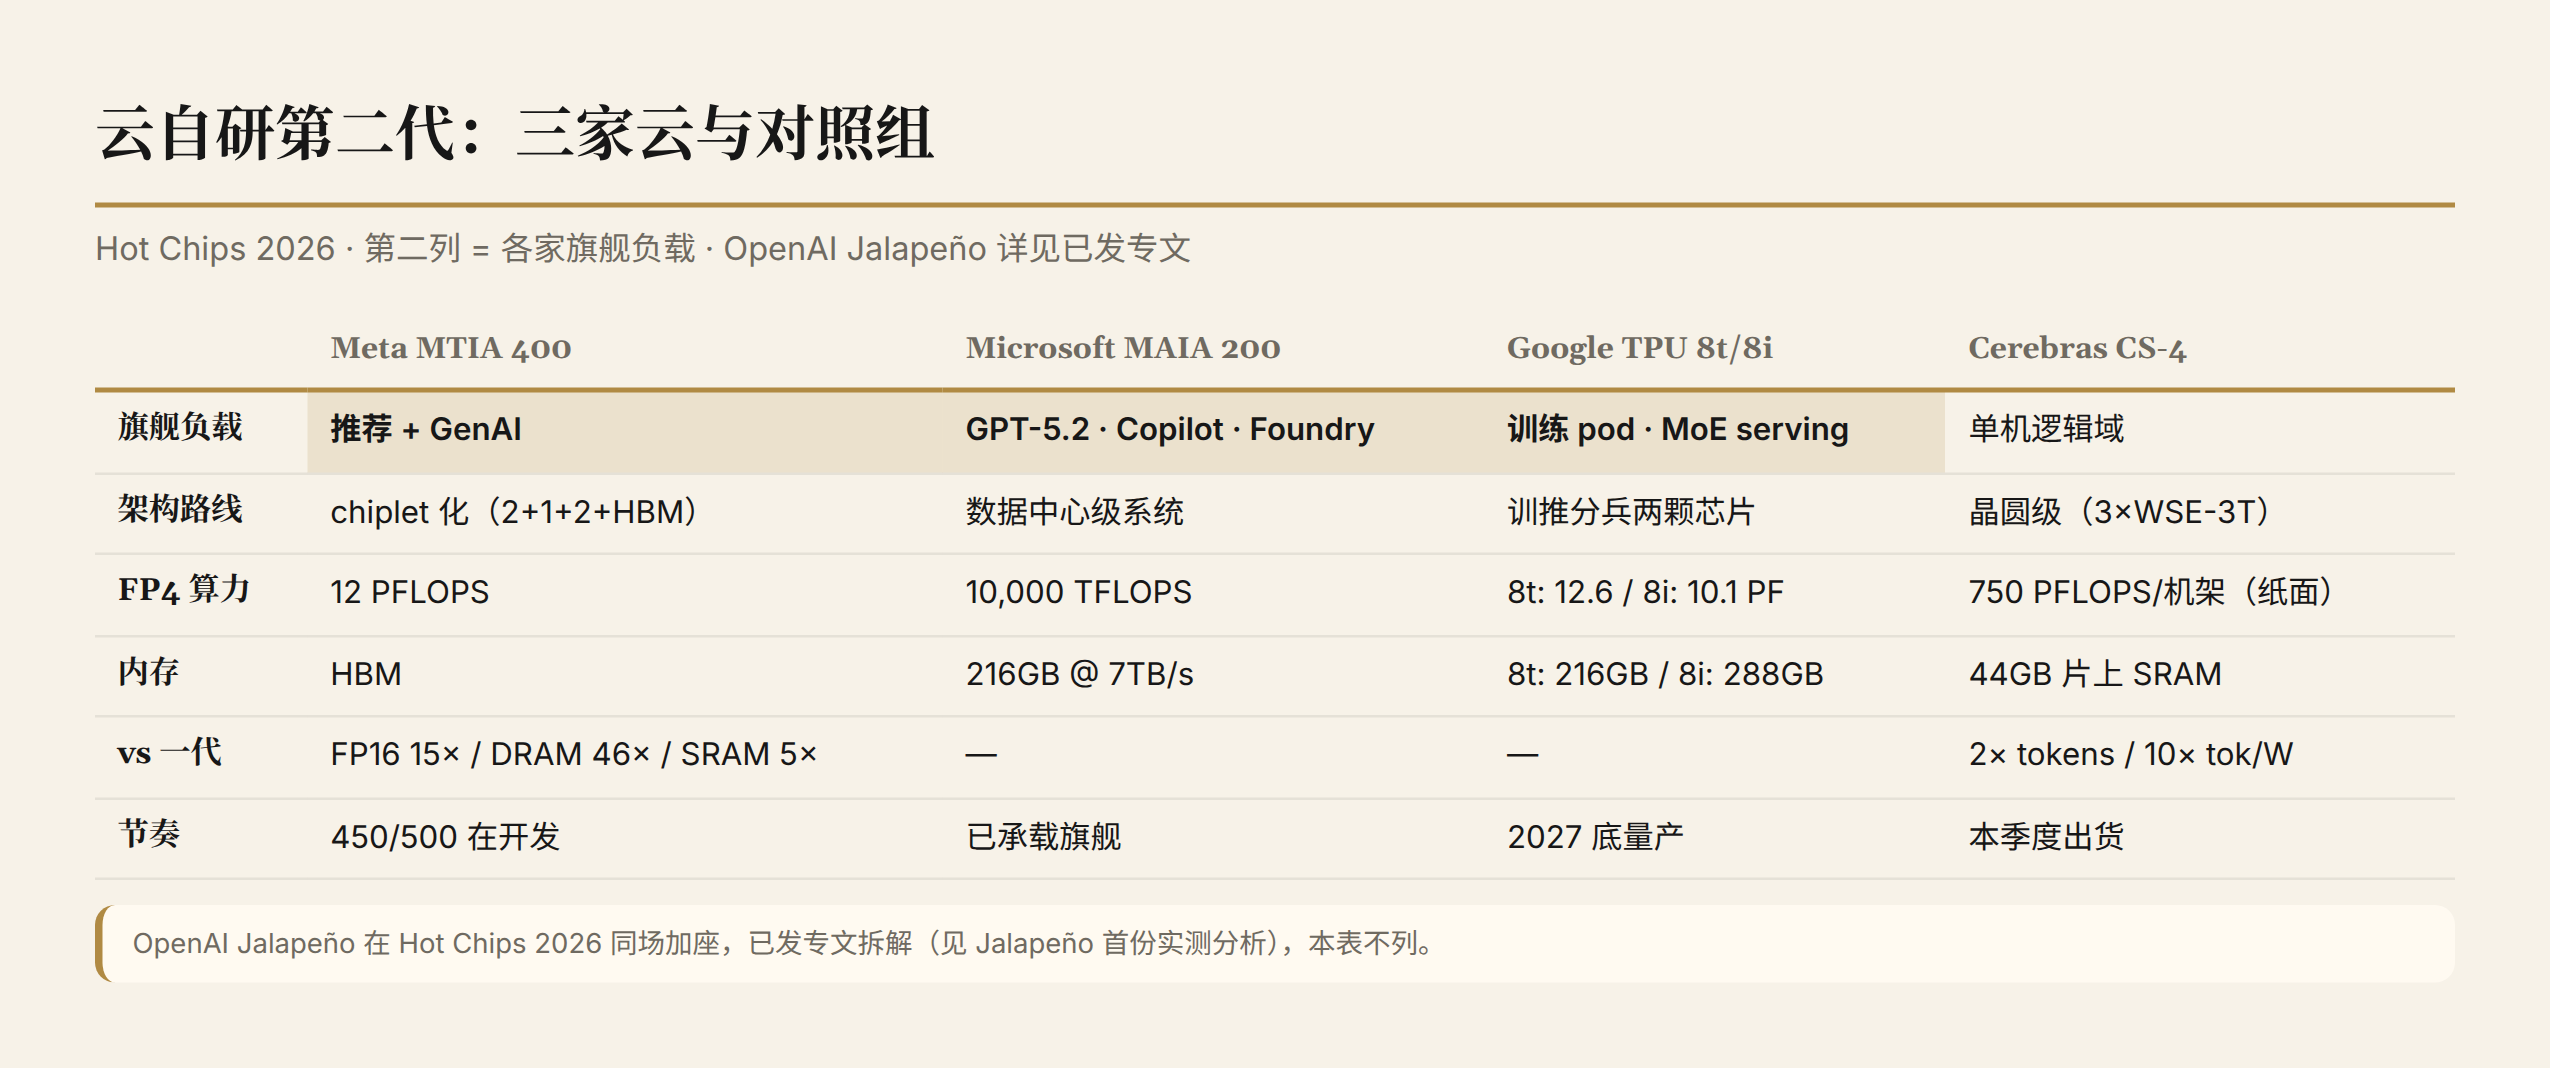
GPT-5.2 的服务负载里有一颗微软自研芯片:MAIA 200 已承载 GPT-5.2、M365 Copilot 与 Foundry。本届 Hot Chips,三家云都拿出了第二代自研芯片,而训练与推理的分工第一次体现在芯片形态上:Meta 把推荐与 GenAI 装进同一颗,微软为推理造了一颗系统级芯片,谷歌拆成两颗。第一代自研证明的是敢不敢做,第二代要回答的是架构怎么定。AWS Trainium 缺席——四强中唯一没有第二代到场的云,这个缺席本身说明了问题。
一、Meta:一颗芯片装下两种负载
先看代际。MTIA 的路线图在本届补全:200(2024,推理,5nm,0.354 PFLOPS)→ 300(2025,第一颗 DLRM 训练芯片,3nm 加 HBM3E,1.112 PFLOPS)→ 400(2026+,DLRM 推理加 GenAI 训练)。300 公布了实测:150B 参数的 DLRM 上与领先 GPU 平价且 TCO 具备竞争力,embedding 算子前向/反向 1.87×/1.88×,scale-up 带宽 2.2×,全精度通信免 FP8 量化。400 的双使命因此有了一颗证明过训练能力的芯片做基础。
架构上,400 用五颗 die 以 2.5D 封装合成一颗芯片:两颗计算 die(3nm、1.7GHz)承载 PE 阵列与片上存储,一颗 SoC(3nm、1.5GHz)承担主机桥与控制,两颗 I/O die 承担 RoCE 网络;八栈 HBM3E 提供 288GB 容量与 9.4TB/s 带宽,计算 die 之间 13TB/s,scale-up 域以 12TB/s 的 RDMA 组织。官方对 chiplet 化的动机说得很直接:良率与成本。先进制程的风险被拆到小 die 上,控制与 IO 不必与计算共同承受大 die 的良率。
计算主体是每颗计算 die 里 8×6 的 PE 阵列,带一行冗余:出厂时带缺陷的行被屏蔽替换,大阵列的良率风险被压到行级。GPU 行业用 harvesting 屏蔽计算单元,Meta 把同一方法推进到 PE 粒度。算力的代际提升有官方数据:400 的 FP16 算力 3 PFLOPS,是 300 的 5×、200 的 15.4×;GEMM 硬件密度对 300 直接 4×,配合原生 MX 微缩放格式(16 个元素共享一个指数,粒度比 OCP 标准的 32 更细,MX4 吞吐是 FP8 的 2×)。
双使命的专用件说明了两种负载怎么共存:12 个 ME 集合引擎(每颗计算 die 六个)承接 GenAI 训练的集合通信,流式 reduction 加硬件信号量做到零 CPU 同步;HEC 与 PEC 嵌入缓存把推荐的热表钉在 PE 近旁;LLC 支持内存内 read-reduce-write。系统形态上,每个计算托盘 4 颗,scale-up 域 72 颗 ASIC 加 8 台交换。
两类负载的规格权重有官方数据:相对 MTIA 200,46× 的 DRAM 带宽与 16× 的主机 PCIe 带宽压在推荐侧,SRAM 带宽 5× 与 FP16 15.4× 压在 GenAI 侧。代价也明确:推荐要带宽,GenAI 要算力与 SRAM,一颗芯片同时服务两种负载,两头都拿不到单独为其优化的极限性能。这正是谷歌路线的反面(§三)。路线图的下一步官方已经写明:450 与 500,定位均为 GenAI 推理,Meta 的下一代重心回到推理侧。
二、微软:为推理造一颗系统级芯片
Maia 200 的官方自我定义是「用软件定义数据流做大规模推理」,架构名 SDLA(Software Defined Local Access Dataflow)。这个命名不是修饰:通用加速器的缓存由硬件一致性协议自动管理,Maia 把这条管理层整个交给软件。控制处理器跑控制面,DMA 与处理单元跑数据面,数据流指令带前后置信号量;从 Tile 内的 L1、cluster 级的 L2 到 HBM,数据的移动与放置全部显式编排,272MB 片上 SRAM 的软件管理只是这个体系最容易被看到的部分。省掉的是硬件缓存一致性的面积与功耗,代价是软件栈必须承担这份复杂度。芯片设计预设了一个深度介入的软件层,「从芯片到系统」在这里有微观证据。
这颗 TSMC 3nm、CoWoS-S 封装、约 820mm² 的芯片,FP4 密集算力 10,145 TOPS(FP8 5,072、BF16 1,268),配 216GB HBM(6 栈、7TB/s)、80TB/s 的片上 SRAM、1,400GB/s 后端网络(28×400G)与 PCIe Gen6 x8 主机接口,TDP 预算 750W。750W 与 Intel 篇 Crescent 的 350W 风冷构成一组对照:系统级整合路线接受更高的单卡功耗预算,部署成本路线把功耗压在卡级可承受范围。
组网是第二个系统设计。scale-up 域历来由私有互连占据(NVLink、ICI),微软的路径是以太网为基、自研传输层 ATL:端点控制多路径(packet spray)、乱序接收、硬件级故障检测与恢复、端到端加密,能耗 <8pJ/b、单向时延 <1μs。微软同时声明 ATL 影响了 Ultra Ethernet 的 UET 与 MRC 规范。开放标准的格局在这里反转:微软以自研实现反向推动了标准本身。拓扑分两级:托盘内 4 颗加速器以固定以太网链路全连接(FCQ,无交换机),向上以统一以太网两层 Clos 扩到 6,000 颗加速器。
每美元性能的官方数字是较 fleet 最新一代硬件提升 30%。分母是微软 fleet 的混装基线,芯片对芯片的同代对比尚未公布;方向可用,量级要等 2027 财报的 TCO 拆分。本届的基准段只到 kernel 级:GEMM 实测 FP8 4.5 PFLOP/s、FP4 8.6,对应规格的 89% 与 85%;TP8 AllReduce 1,298GB/s。系统级 $/token 的数据仍缺。部署节奏上,微软先在 Des Moines 数据中心落地 MAIA 200,Phoenix 园区为第二站。
三、谷歌:干脆拆成两颗
谷歌的答案最彻底:训练一颗,推理一颗,8t 与 8i 同时发布。两颗芯片的规格差本身就是论点:训练要规模,推理要响应速度。
8t 的机制是规模经济。训练依赖大 pod:9,600 颗芯片的 superpod 聚合 121 FP4 EFLOPS(3× Ironwood),8×12 层 HBM3e 较 Ironwood 的 8 层堆叠带宽高出约 30%(官方口径),共享 2PB HBM;每颗芯片 2.4Tbps 的 I/O 做无胶水 scale-up,原生 FP4,每瓦性能对 Ironwood 翻倍。pod 越大,集合通信的开销越重,ICI 带宽翻倍(每芯片 6 条、每向 1.6T/s)对冲的正是这部分。跨 pod 的 Virgo fabric 把规模推到 134,400 颗:两层交换全无阻塞,峰值 1.6 YottaFlops、47 Pb/s,可扩多数据中心;OCS 光交换让 1,000 颗芯片共享内存、任意切片(受池容量限制)。10 万颗 TPU 级系统的近 100% goodput 靠可靠性工程支撑:HBM 链路 CRC 与重试之外,失效随温度每 10-15°C 翻倍的 Arrhenius 定律直接成为水冷的依据,光模块水冷在 ML 系统中属首次。制程目标是 TSMC 2nm、2027 年底(Cloud Next 口径)。
8i 的机制是时延经济,两处新设计都为 MoE serving。CAE(Collectives Acceleration Engine)把集合通信从通用核卸载到 ICI I/O die 内的专用引擎,片上延迟降 5×:MoE 推理的专家分发是高密度 all-to-all,通用核执行集合通信既慢又占用算力,专用引擎直接对延迟目标负责。Boardfly 拓扑取代 3D torus:每托盘 4 颗全连接、8 托盘成组、36 组全互连,单 pod 1,152 颗、任意两芯最多 7 跳,3D torus 同规模要 16 跳。拓扑随负载特征更换,「为负载造芯片」从计算单元延伸到网络层;XLA 在软件层自动管理 Boardfly 拓扑与 CAE 同步,用户无感。
8i 的规格直接体现了响应优先:288GB HBM、384MB SRAM、8.60TB/s 三项反超 8t 而算力略低。官方口径补齐了细节:HBM 为 12-Hi 堆叠,SRAM 较上代 2.4×,ICI 19.2Tb/s 较上代 2×。SRAM 对 HBM 的优势官方给了三轴:带宽 15-20×,延迟约 100×,能效 10-20×。另一组数字值得记录——AI 参与设计本身。8t TensorCore 经 AI 优化省 6% 功耗与 5.8% 面积、换来 6% 算力;SparseCore 省 13% 面积、换来 10%;8i 同热预算多 5% 算力。AI 参与设计的效果在谷歌侧有了量化数据,延续了 Jalapeño 文的追踪。背景数字(官方口径):TPU 出货 2026 年 430 万颗,2027 年 1,000 万、2028 年 3,500 万+;Google 2026 capex $175-185B。代际总结同样直白:没有摩尔定律与丹纳德缩放加持,代际 perf/TCO 与 perf/W 仍 >2×。
四、对照组:Cerebras 与 SN50
Cerebras 的 Nexus 机架把三颗 WSE-3T(单颗 250 PFLOPS、44GB 片上 SRAM、43.2PB/s)整合进一个机架域:供电、散热、维护按三晶圆一组重构,晶圆到晶圆 2μs、每 wafer 2.4Tb/s 的互连把三颗合成 750 PFLOPS、129.6PB/s 的逻辑单机。750=3×250、129.6=3×43.2,两个总量与三颗晶圆规格之和吻合,官方口径内部一致。Register 的质疑值得完整引用:WSE-3T 与 WSE-3 同硅片提速,dense FP16 估算约 25 PFLOPS(10× sparsity 假设),带宽指标的纸面成分存疑。它在这组对照中的价值,是给前三节一个极限参照:Meta 用 chiplet 分摊成本,微软用系统级整合,谷歌按负载拆分,Cerebras 把内存带宽与计算的物理距离压缩至零,是带宽逻辑的物理极限样本。CS-4 vs CS-3 官方口径 2× tokens、10× tokens/watt,CS-5、CS-6(3D wafer-scale DRAM 堆叠)已列入路线图,本季度出货是判断三的跟踪点之一。SambaNova SN50 是另一个方向的例子:第五代 RDU 为 agentic 推理设计,三层存储架构,scale-out 至 32K RDU,2026 年 2 月发布、下半年出货,官方对它的定位是「推理是数据搬运与内存优化问题」。
五、总结与判断
三家云的做法从合并到拆分恰好连成一条线:Meta 一颗装两种,微软推理专用但做成系统,谷歌按负载拆两颗。芯片形态差异的来源是各家负载的确定性:谁的负载特征最清楚,谁的芯片就分得最开。
判断一:云自研第二代是产业转折,机制是三层成本结构。 「从降本试水走到承载旗舰负载」是总览篇的位置判断;本篇补充的是时间点上的经济解释。其一,摊销:第一代的流片、验证、生态成本缺摊薄对象,第二代复用 IP 与软件栈,单代成本曲线第一次向下。其二,软件栈成熟:一代生产环境的磨合是定制芯片承载旗舰的前提,三家云全部跨过门槛。其三,负载确定性:GPT-5.2、Copilot、推荐加 GenAI 给了按负载定制芯片架构的确定性,谷歌敢拆两颗正基于此。三个条件同时成立,是「现在」区别于过去五年任何时点的地方。
判断二(主判断):双供应商是第二代最值得关注的新变量。 事实基础:8t 与 Broadcom 设计,8i 与 MediaTek 设计。为什么推理芯片交给 MediaTek?三个候选解释:成本结构(第二供应商改变对单一设计伙伴的议价位置)、制程容忍度(推理芯片带宽导向,对制程窗口的要求与训练的算力导向不同,待证)、Tensor 合作史(MediaTek 与谷歌在端侧芯片已有多年协作,信任与接口磨合都已在前期合作中完成)。若 8i 给 MediaTek 被后续部署验证,云自研的供应链格局将被改变。
判断三:TCO 待验是最大变数。 MAIA 的 +30% 是自报口径(分母为 fleet 混装基线),2027 财报 TCO 是总览跟踪点③的到期日。本篇补充三个跟踪点:MTIA 450/500 的节点动向(官方定位为 GenAI 推理)、CS-4 本季度出货兑现(对照组的商业成色)、MAIA fleet 占比信号(承载旗舰的实证)。
后续关注点:① 微软 2027 财报 TCO 拆分;② CS-4 本季度出货;③ MTIA 450/500 节点动向;④ MAIA fleet 占比;⑤ TPU 专文(CAE 与 SparseCore 并存口径、8i 微架构细节)。
前瞻承诺:CS-4 出货、微软 2027 财报 TCO、TPU 专文三个节点,我们回来验证。
数据截止 2026-08-28。规格与机制来自 Hot Chips 2026 各厂商演讲材料、官方发布与现场报道(ServeTheHome 等);自报口径与单源转述已在文中标注。
延伸阅读:Hot Chips 2026 总览 · 内存墙四路进攻 · Intel 三连发 · AI 工厂五张网