
引子
Intel 在本届连发三场:Diamond Rapids 面向机架,Crescent Island 面向推理,Wildcat Lake 面向边缘,官方叙事称之为 rack-to-edge。单看是三场产品发布,合起来是一条完整的部署成本逻辑链:制程自己造,封装标准开放,推理卡绕开 HBM——每一环都在压缩把算力装进现有机房的成本。我们称之为部署成本主线,逐节检验它在哪里成立、在哪里受阻。
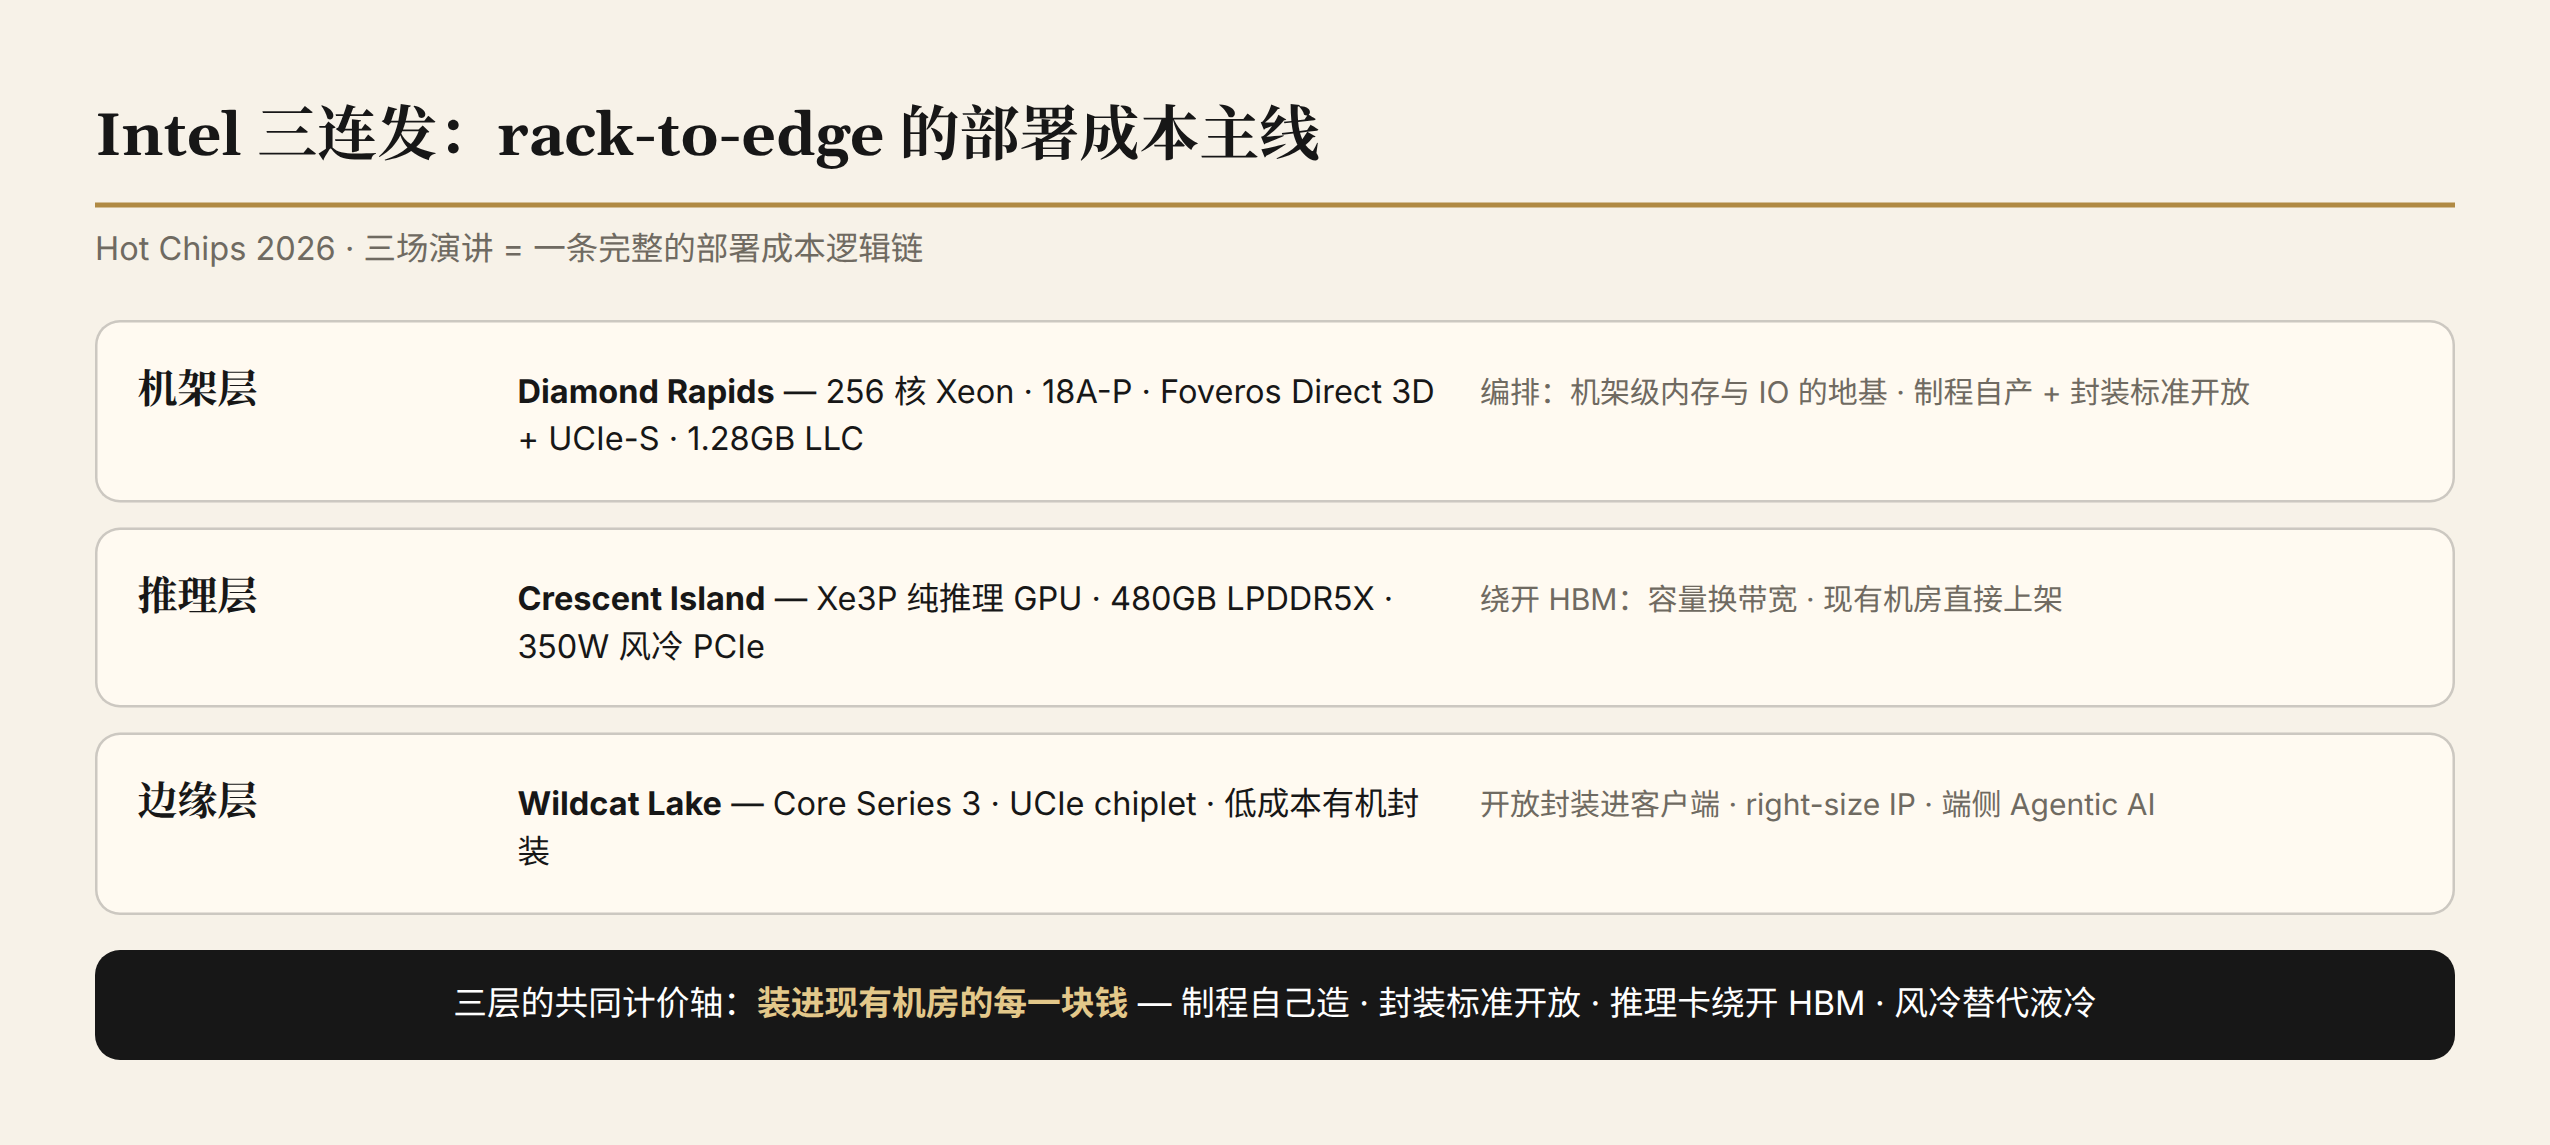
一、Diamond Rapids:机架编排层的封装工程
这颗机架级 Xeon 的工程重心在封装。Foveros Direct 3D 把 die 间互连推进到直接键合:凸块换成亚微米级键合 pad,单位面积的 die-to-die 带宽提高一个数量级。Diamond Rapids 用它做物理分区,计算 die 与缓存/IO die 分别按合适的工艺制造,再垂直合成 256 核、1.28GB LLC 的一颗处理器。
UCIe-S 是分量更重的一步。UCIe 标准体系里面向先进封装内高密度互连的规格层,此前主要随加速器芯粒生态推进;进入 Xeon 主线,意味着 Intel 开始把主 CPU 的 die 间接口从私有协议转向开放标准。两个后果:第三方芯粒理论上获得进入 Intel 主 CPU 封装的接口通路(愿景层);Intel 自身的组合变成先进封装工艺私有、互连协议开放,与 §三 客户端一节构成互证。
控制面的增强服务于机架编排。APX 把通用寄存器数量翻倍,面向高核密度服务器的指令吞吐;AMX 增强让张量计算直接在 CPU 上完成。256 核、大 LLC 与 16 内存通道服务的负载是 agent runtime 编排、批处理与 tokenizer、KV-cache 调度的前置逻辑,这类负载以核数与内存容量为主要消耗,AMX 免去其中张量部分跨 PCIe 的往返。
18A-P 自产是主线的前置变量:官方口径低压频率 +~30%(futurumgroup 转述),已进入量产。Diamond 的成本优势全部系于 18A 产能与良率,这是部署成本主线从口号变报价单的第一道闸门。
二、Crescent Island:一张推理卡的面积与功耗取舍
面积经济学的核心是 XMX 阵列的深度。阵列加深到十六层,权重在阵列内逐拍流动、逐级复用,阵列越深,每字节搬运服务越多次乘加,单位算力的能耗与面积越低;代价是填充与排空周期占比上升,批次不足时效率塌陷。十六层这个数字本身就在声明负载假设:高批次、规律的自回归解码流。只有以推理为唯一使命的 GPU,才承受得起这样的阵列深度。
功能的删减同样指向推理。3D 图形与光线追踪硬件全部删除,释放的晶体管转投 XMX 密度与 LPDDR5X 容量(32MB 统一 L2 为单源;品牌卡 160GB、ODM 最多 480GB),数值格式从 FP4/MXFP4 覆盖到 FP64。这组交换成立的前提,是推理市场不再要求这颗芯片承担图形渲染职能。
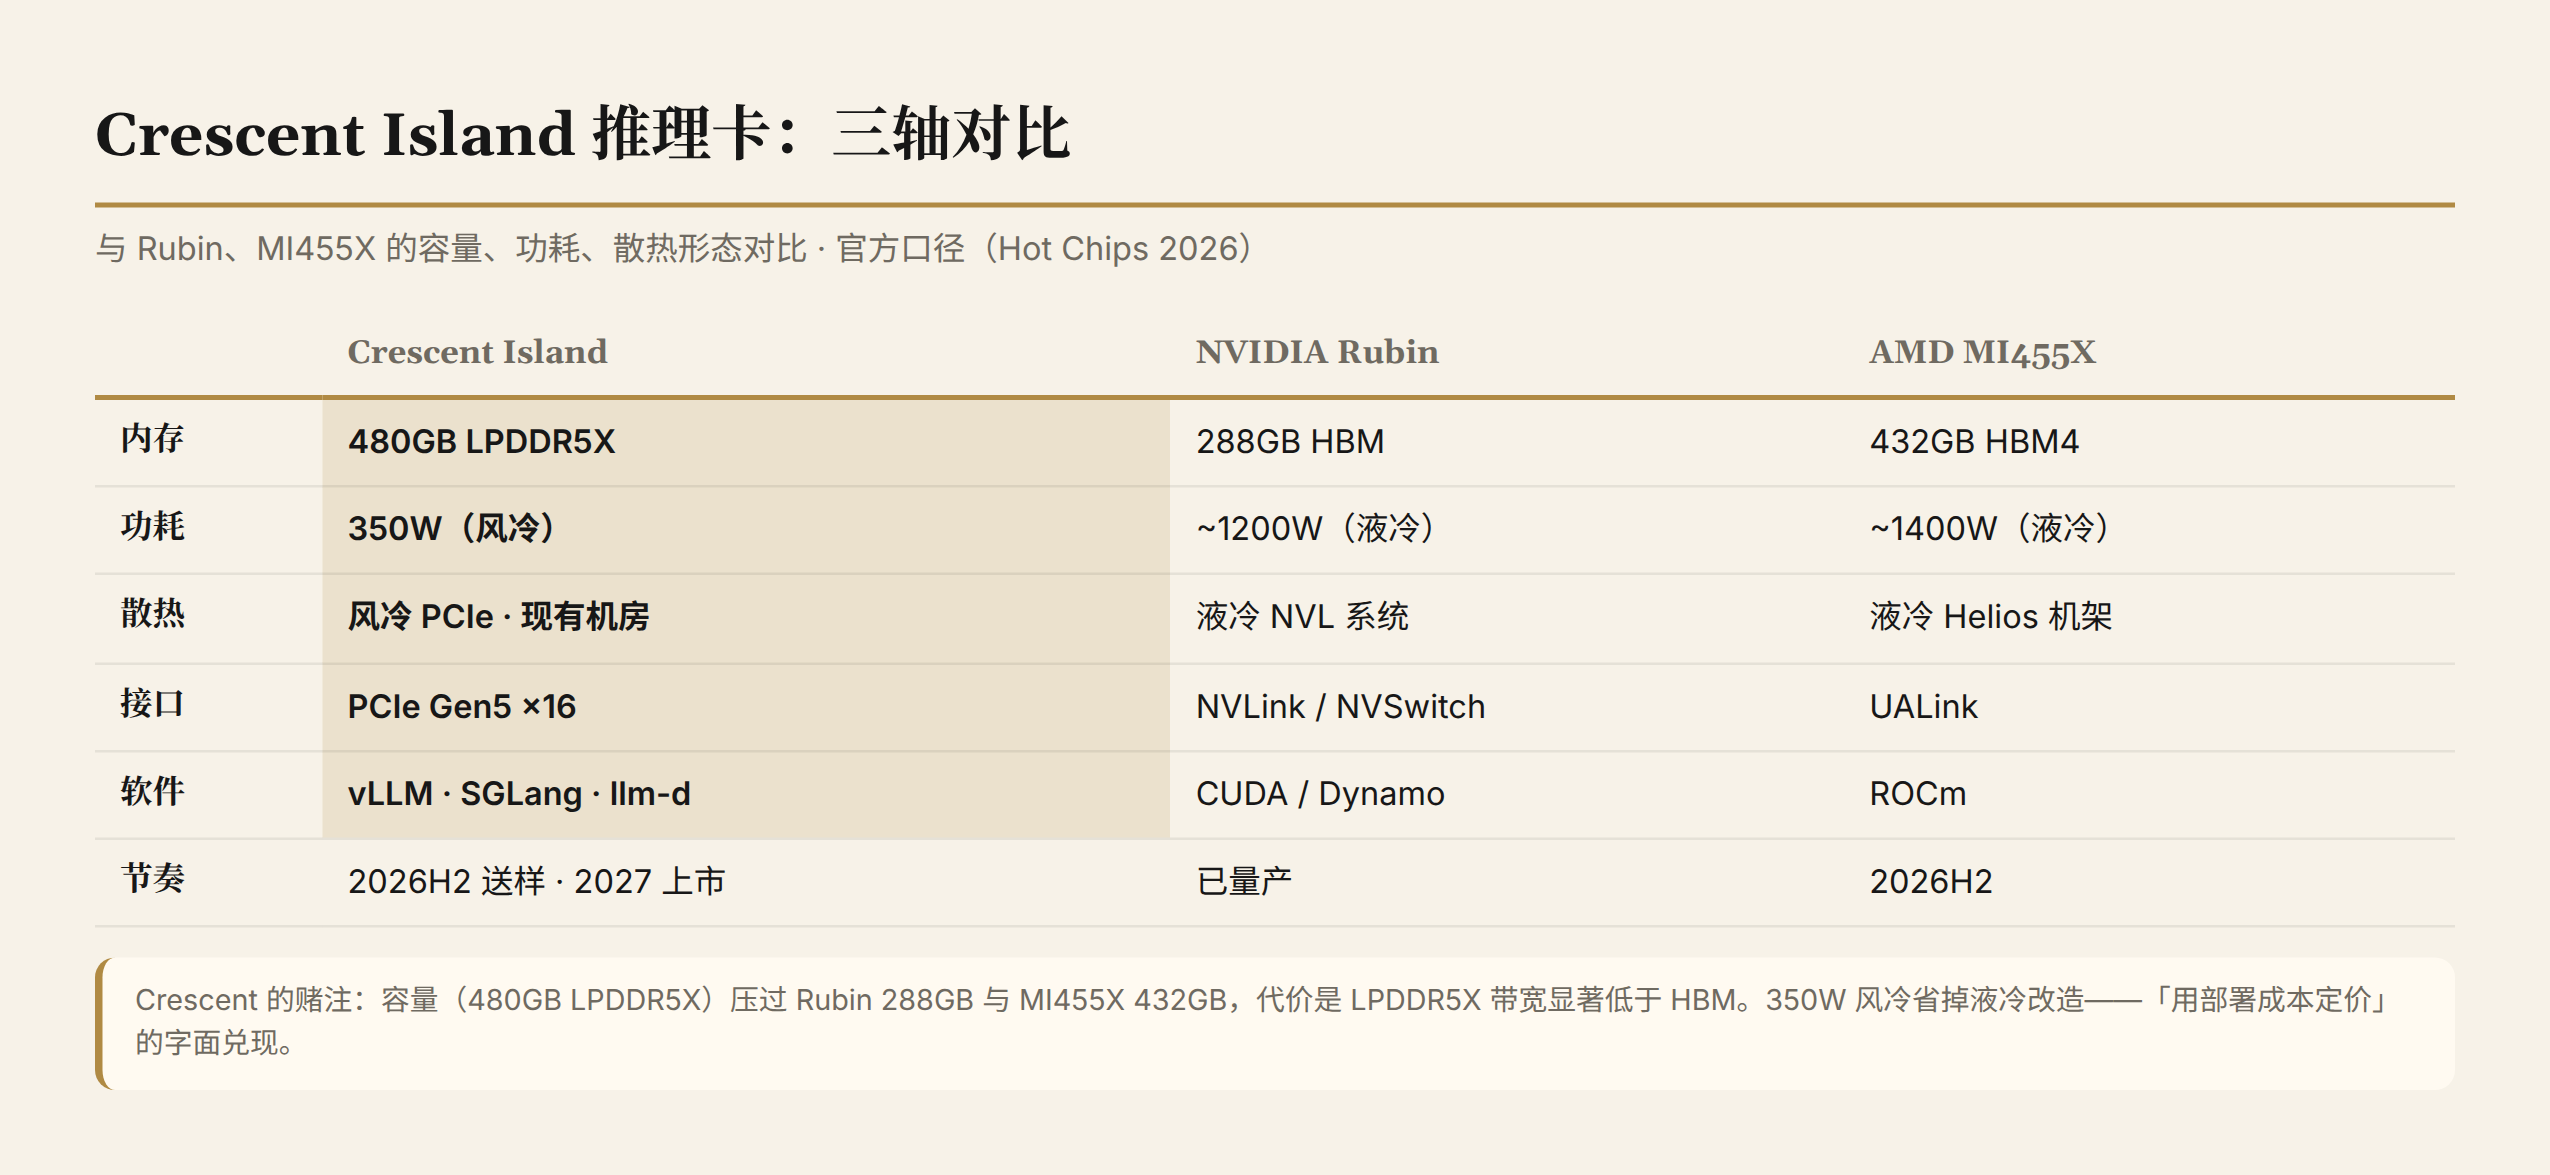
内存介质是这张卡的全部赌注。HBM 供给紧张、价格上行(内存墙篇对此有详细拆解),Crescent 用 LPDDR5X 绕开:容量纸面 480GB,高于 Rubin 的 288GB 与 MI455X 的 432GB(见 fig2);代价是 LPDDR5X 带宽显著低于 HBM。官方设计目标明确指向 tokens per watt 与 agentic 负载。agentic 负载 KV 足迹大、重算成本高,容量在这里换吞吐;decode 阶段带宽受限的部分,则依靠 KV-cache-aware routing 与 prefill 优化在软件层弥补。
部署侧的改动最平淡,却是「用部署成本定价」最直接的字面兑现。350W 风冷 PCIe Gen5 x16,标准机架直接上架,液冷改造零开销;vLLM、SGLang、llm-d 原生支持外加 NVIDIA Dynamo 路径,接入现役推理栈的工程成本与卡一起计价。对照组就在本届:MAIA 200 的 TDP 预算写到 750W(云自研篇),把供电与散热压力留给系统层;Crescent 把它们约束在卡级可承受范围内,两条路线在功耗数字上分野。
与云自研篇对照:谷歌用训推分兵为负载形状造芯片(8i 堆带宽与 SRAM),Intel 用内存经济学造芯片(LPDDR5X 堆容量)。两条路线的分歧在 decode 到底缺带宽还是缺容量,答案很可能因负载而异。
三、Wildcat Lake:开放封装进客户端
Wildcat Lake 是一颗客户端 SoC,看点在基板:低成本有机封装,未采用 Foveros 类堆叠,die 间走 UCIe chiplet。UCIe 的适用范围由此拓宽,开放芯粒互连既能在先进封装内提供高带宽(§一 的 UCIe-S),也能在低成本的传统基板上服务成本敏感设计。标准覆盖封装成本谱系的两端,第三方芯粒生态才有存在的物理基础。
首个落点选客户端,理由在出货量:客户端是开放标准最快的规模化验证场。right-size IP(ServeTheHome 现场口径)是同一逻辑的体现,按负载裁剪 IP 规模,以标准互连连回主 die,成本低于整颗单 die 重新设计。负载侧,端侧 Agentic AI 的本地小模型加云端大模型路由对成本极度敏感,正好需要这样的芯片。核心配置 2P+4E、NPU 17 TOPS(单源转述口径)。
UCIe 由此同时贯穿数据中心与客户端,Intel 手中这把差异化武器越过了单点试点的量级。
四、CPU 群像:AGI、Vera、MONAKA
Arm AGI 最值得分析的是良率设计:140 核硬件、按 die harvesting 预留 4 核、交付 136 核;TSMC 3nm 双 chiplet 将单片大 die 的良率风险分散,冗余核吸收切割损耗。这套设计方法来自 GPU 与移动 SoC,第一次出现在通用服务器 CPU 上。聚合内存吞吐 >800GB/s、约每核 6GB/s(6×136≈816,与聚合吞吐口径吻合),「每机架可用线程数」进入官方卖点。TDP 300W;官方机架参考为 8,160 核(36kW 机架,1U 双节点/2U 双路两种机型)。
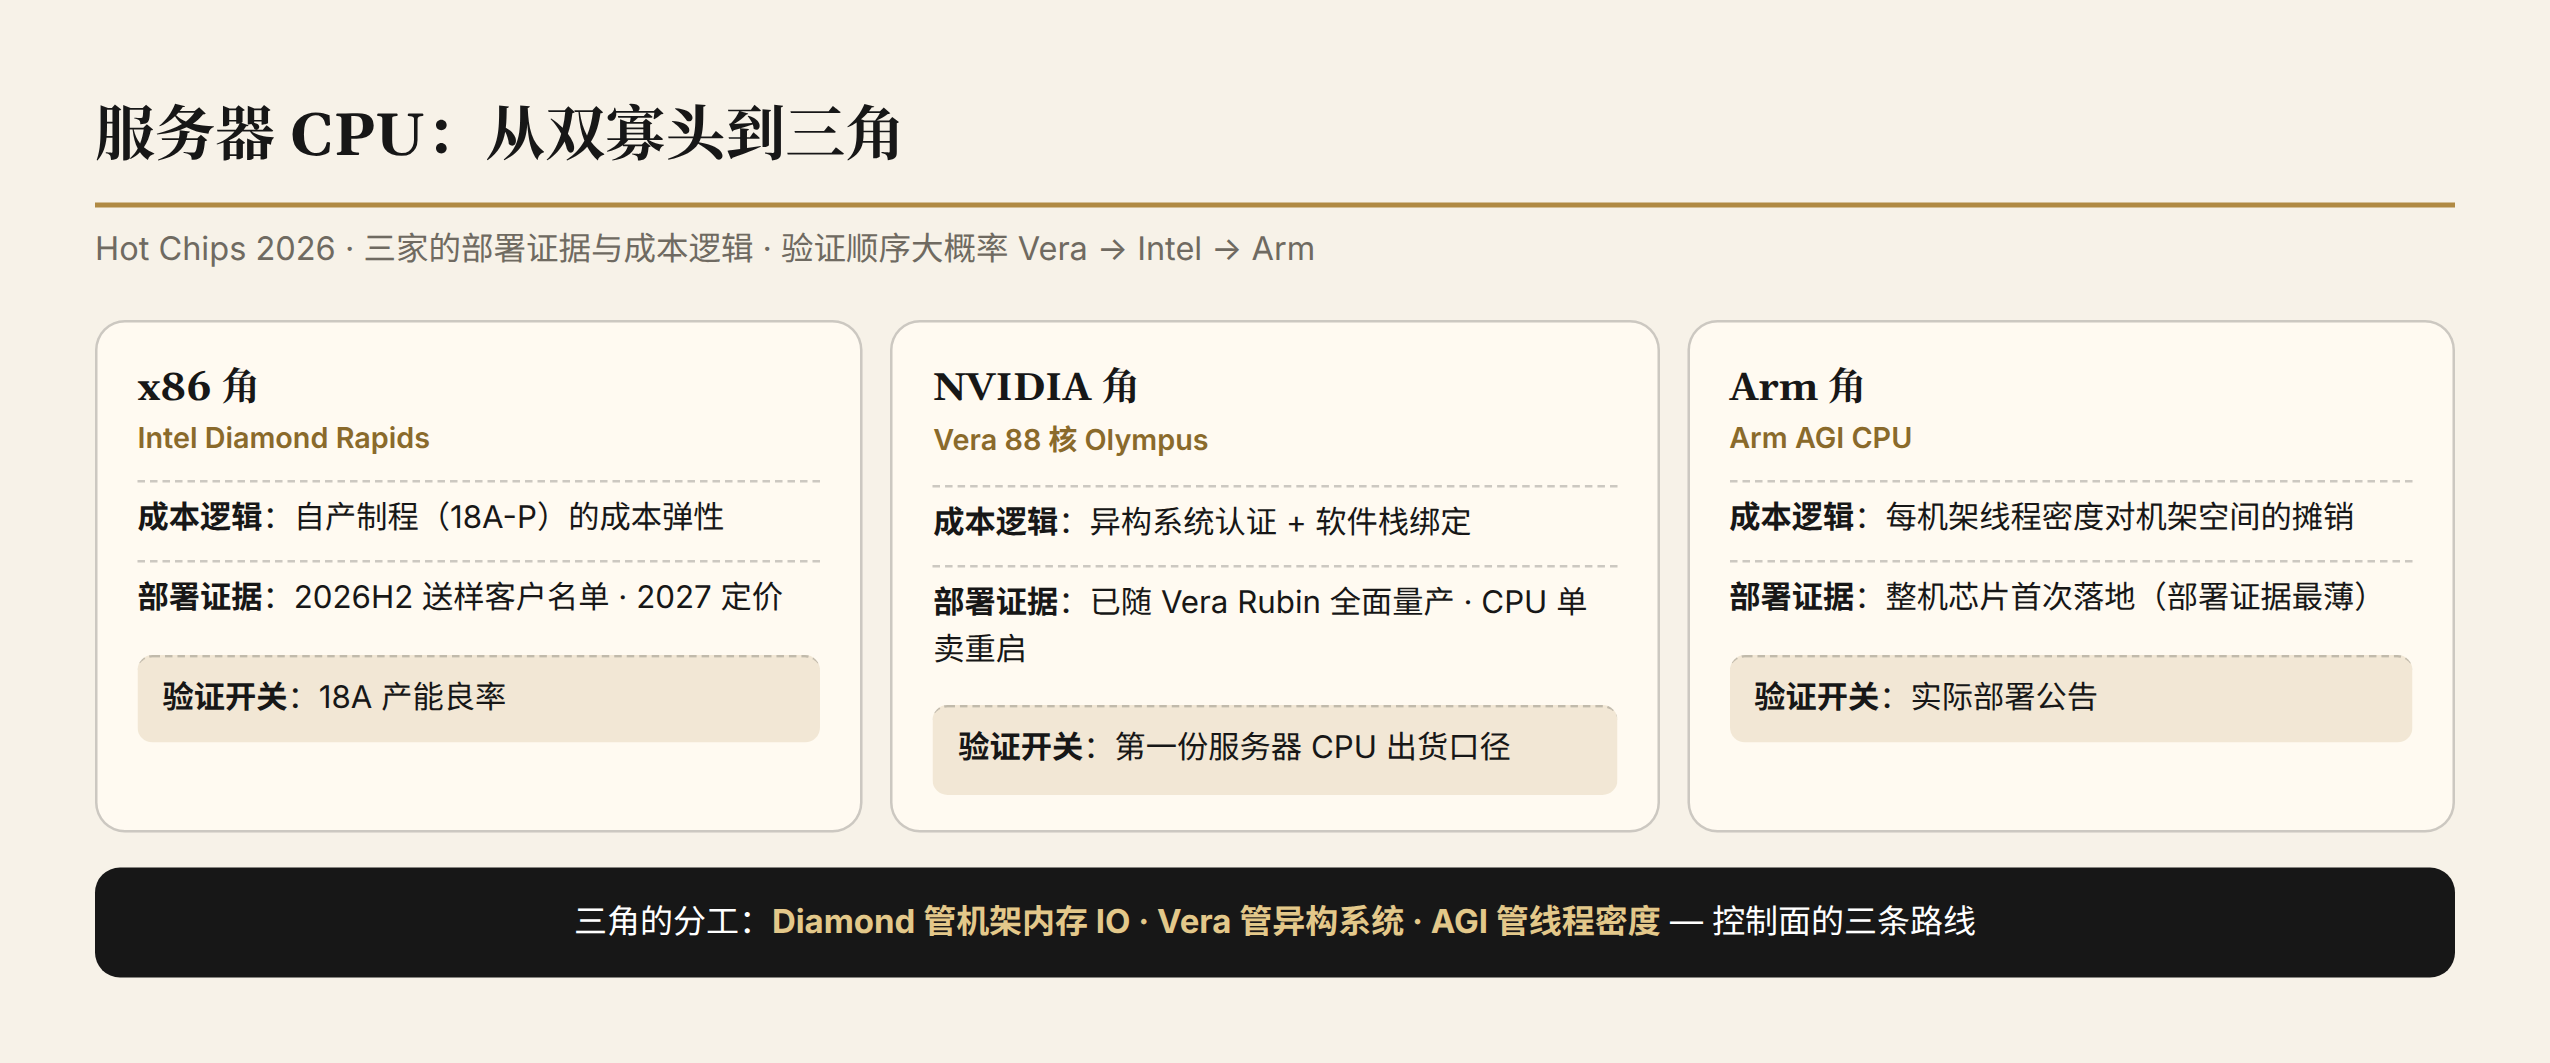
Vera 的增量只在节奏:已随 Vera Rubin 全面量产,CPU 单卖重启(GTC Taipei 5/31 发布语境)把 NVIDIA 变成同时销售 CPU 的系统公司,这正是 cpu-comes-back 一文的主论点。MONAKA 以 green AI data center 为主题,现场未公布超出既有规格的新信息。
一处概念边界需要说明:Intel 侧的「编排层」指控制面,agent runtime 与负载调度落在 CPU;数据面与 IO 编排(网络篇 BlueField 的「工厂 OS」)属于另一条线。NVIDIA 对 agentic 负载的官方分解给了一手印证:Prompt 与编排落在 CPU,记忆跨 CPU/DPU/CUDA/LLM/网络,安全落在 CPU/DPU。两条线在机架层交汇,概念上各守一侧。
五、RISC-V 侧记
Tutorial 日四场 RISC-V 演讲,三项进展值得记录:CUDA on RISC-V 首次公开演示,NVIDIA 将自身软件栈的边界延伸到开放指令集;RVA23 profile 收敛 scalar 扩展的碎片化;NVLink Fusion 已有 ≥3 款第三方处理器在实验室。相对 x86 与 Arm 两条既成路线,开放生态的第三条路在本届有了首批工程坐标。
六、总结与判断
三场加一组群像,合起来是一份部署成本路线图:制程、封装、内存介质、散热形态,Intel 对每一层的成本结构做了重新组合。
判断一:部署成本是 Intel 三件产品的共同计价轴。 350W 风冷省去液冷改造,LPDDR5X 绕开 HBM 涨价,UCIe 开放降低芯粒互连生态成本,18A 自产锁定制程成本,四个动作对准同一个变量:把算力装进现有机房的单位成本。三场演讲的官方设计目标都指向 tokens per watt;目标函数改变,算力军备原有的计分方式随之失效。
判断二:UCIe 开放封装是 Intel 手里最特殊的差异化武器。 工艺层(Foveros Direct 3D)保持私有,互连层(UCIe/UCIe-S)开放:这个组合既守住制造端利润层,又把生态拉到 Intel 参与定义的接口标准上。Xeon 主线与客户端首落是两端证据;第三方芯粒是否出现,是这条判断的验证条件。
判断三:服务器 CPU 从 x86 双寡头走向三角,三家各有验证条件。 x86 角,成本弹性来自自产制程,验证看 2026H2 送样客户名单与 2027 定价,18A 产能良率是闸门。NVIDIA 角,部署证据最扎实,已随 Vera Rubin 全面量产,竞争力来自异构系统认证与软件栈绑定,单卖重启后第一份服务器 CPU 出货口径是观察点。Arm 角,部署证据最薄弱,整机芯片首次落地,机会在每机架线程密度对机架空间的摊销,第一个验证节点是实际部署公告。最可能的验证顺序:Vera(已量产)→ Intel(2027 定价)→ Arm(部署公告)。
后续关注点:① 2026H2 Crescent 送样后第三方 tokens-per-watt 实测;② 2027 Crescent 上市定价;③ Intel 季报的 18A 产能良率口径;④ Wildcat 上市后第三方 UCIe 芯粒出现与否;⑤ AGI 部署公告与 Vera 单卖出货口径。
前瞻承诺:Crescent 送样实测与 2027 定价两个节点,我们回来验证。
数据截止 2026-08-29。技术参数来自 Intel 官方新闻稿、Hot Chips 2026 现场报道与各厂商演讲材料(ServeTheHome 等);单源与转述口径已在文中标注。
延伸阅读:Hot Chips 2026 总览 · 内存墙四路进攻 · 云自研芯片第二代 · AI 工厂五张网 · 当 CPU 超级周期遇上 Agent