
引子
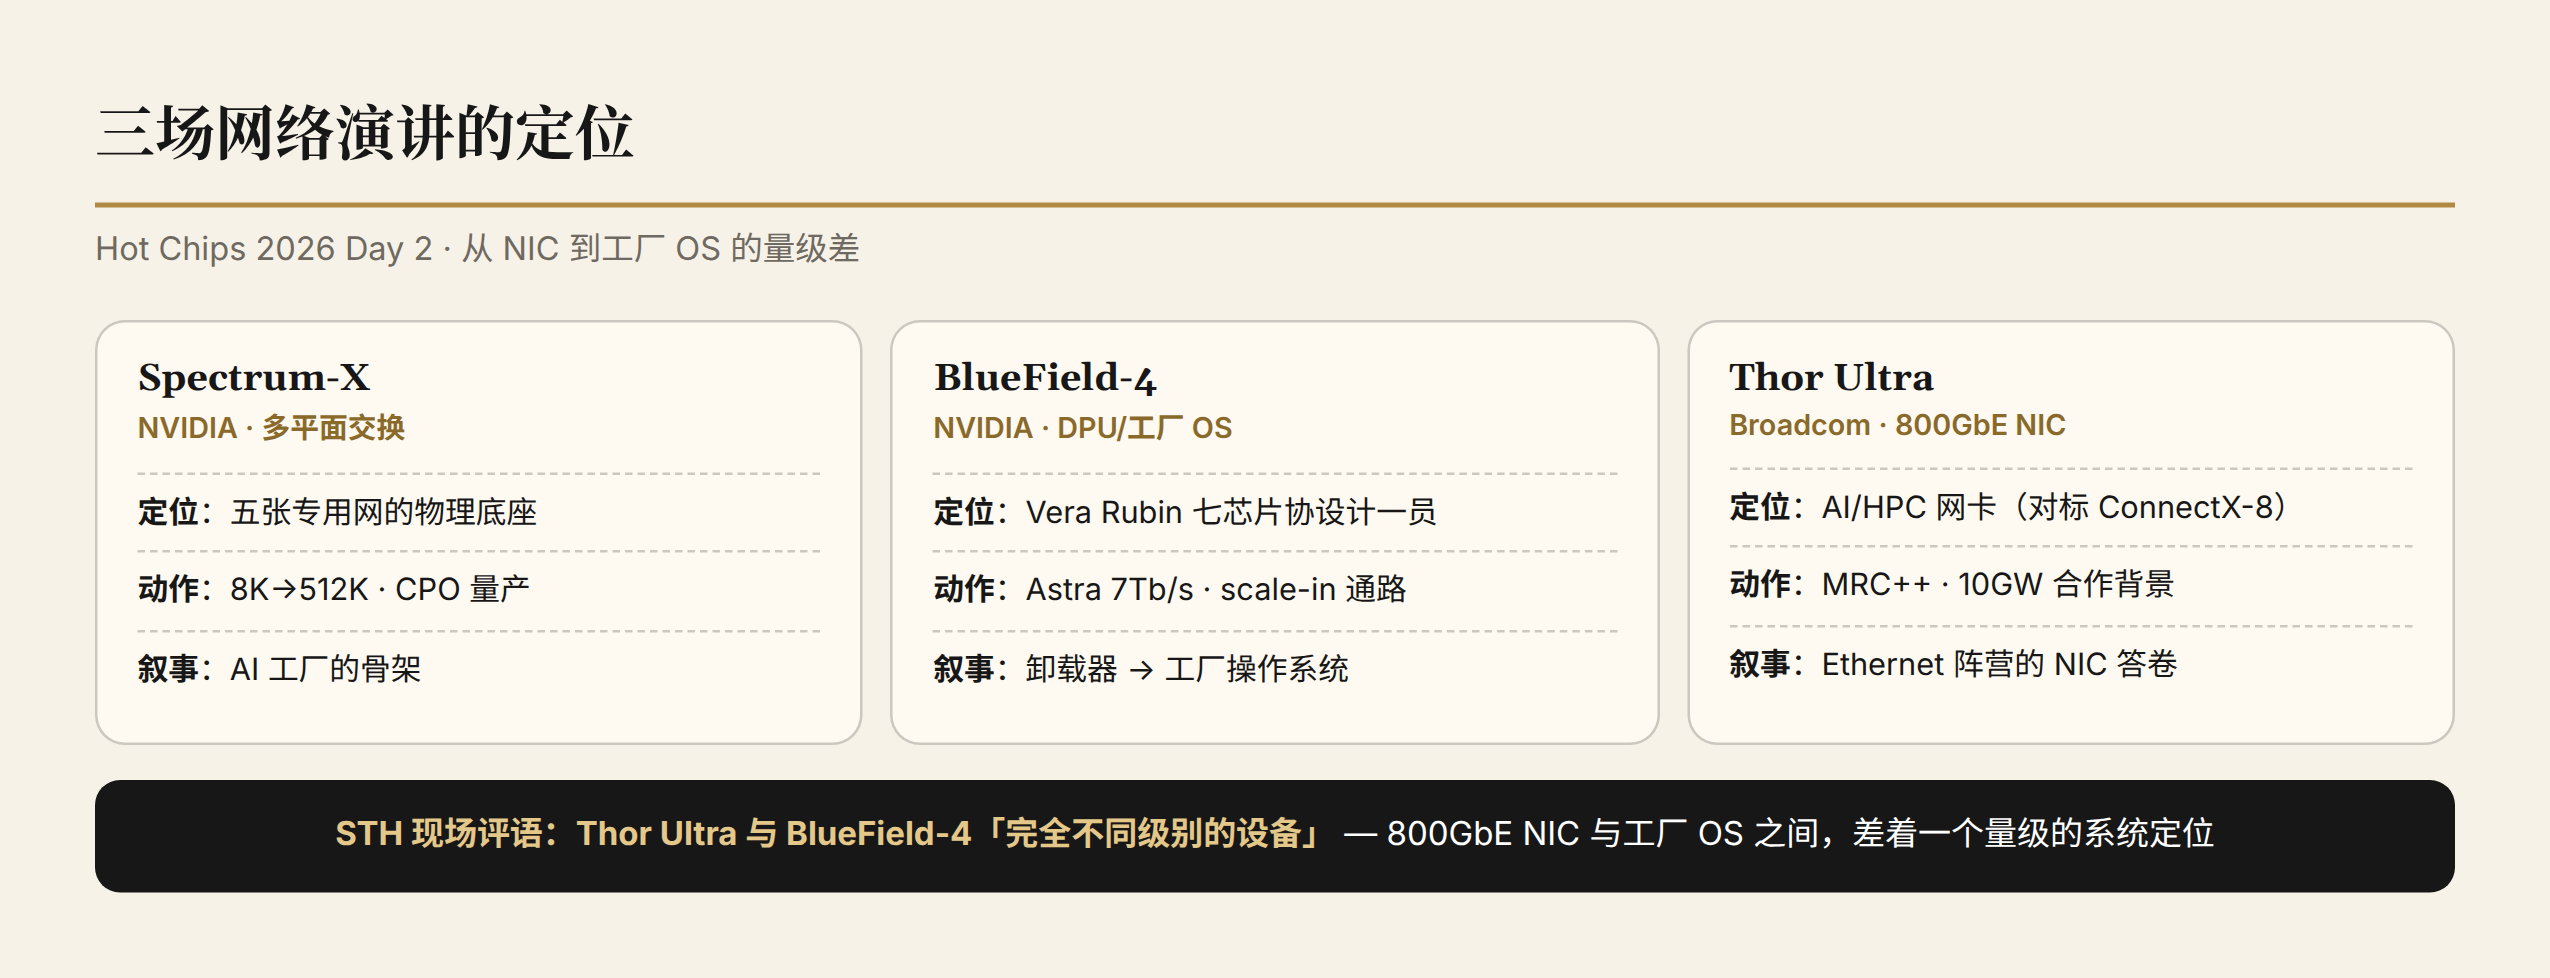
Day 2 的网络议程只有三场演讲:NVIDIA 的 Spectrum-X 多平面、BlueField-4,与 Broadcom 的 Thor Ultra。单看是两家公司的产品发布;放进同一时间轴,性质变了:网络从连接计算的工具,变成 AI 工厂的核心基础设施与操作系统。开放互连是 Hot Chips 2026 的第二条统一战线。本篇以五张网为组织框架:先讲清 NVIDIA 的答案,再把本届其他网络发布按位置归位——光层在 scale-out,工厂操作系统在 scale-in,Broadcom 的网卡在开放一侧。
一、Spectrum-X 多平面:五张专用网
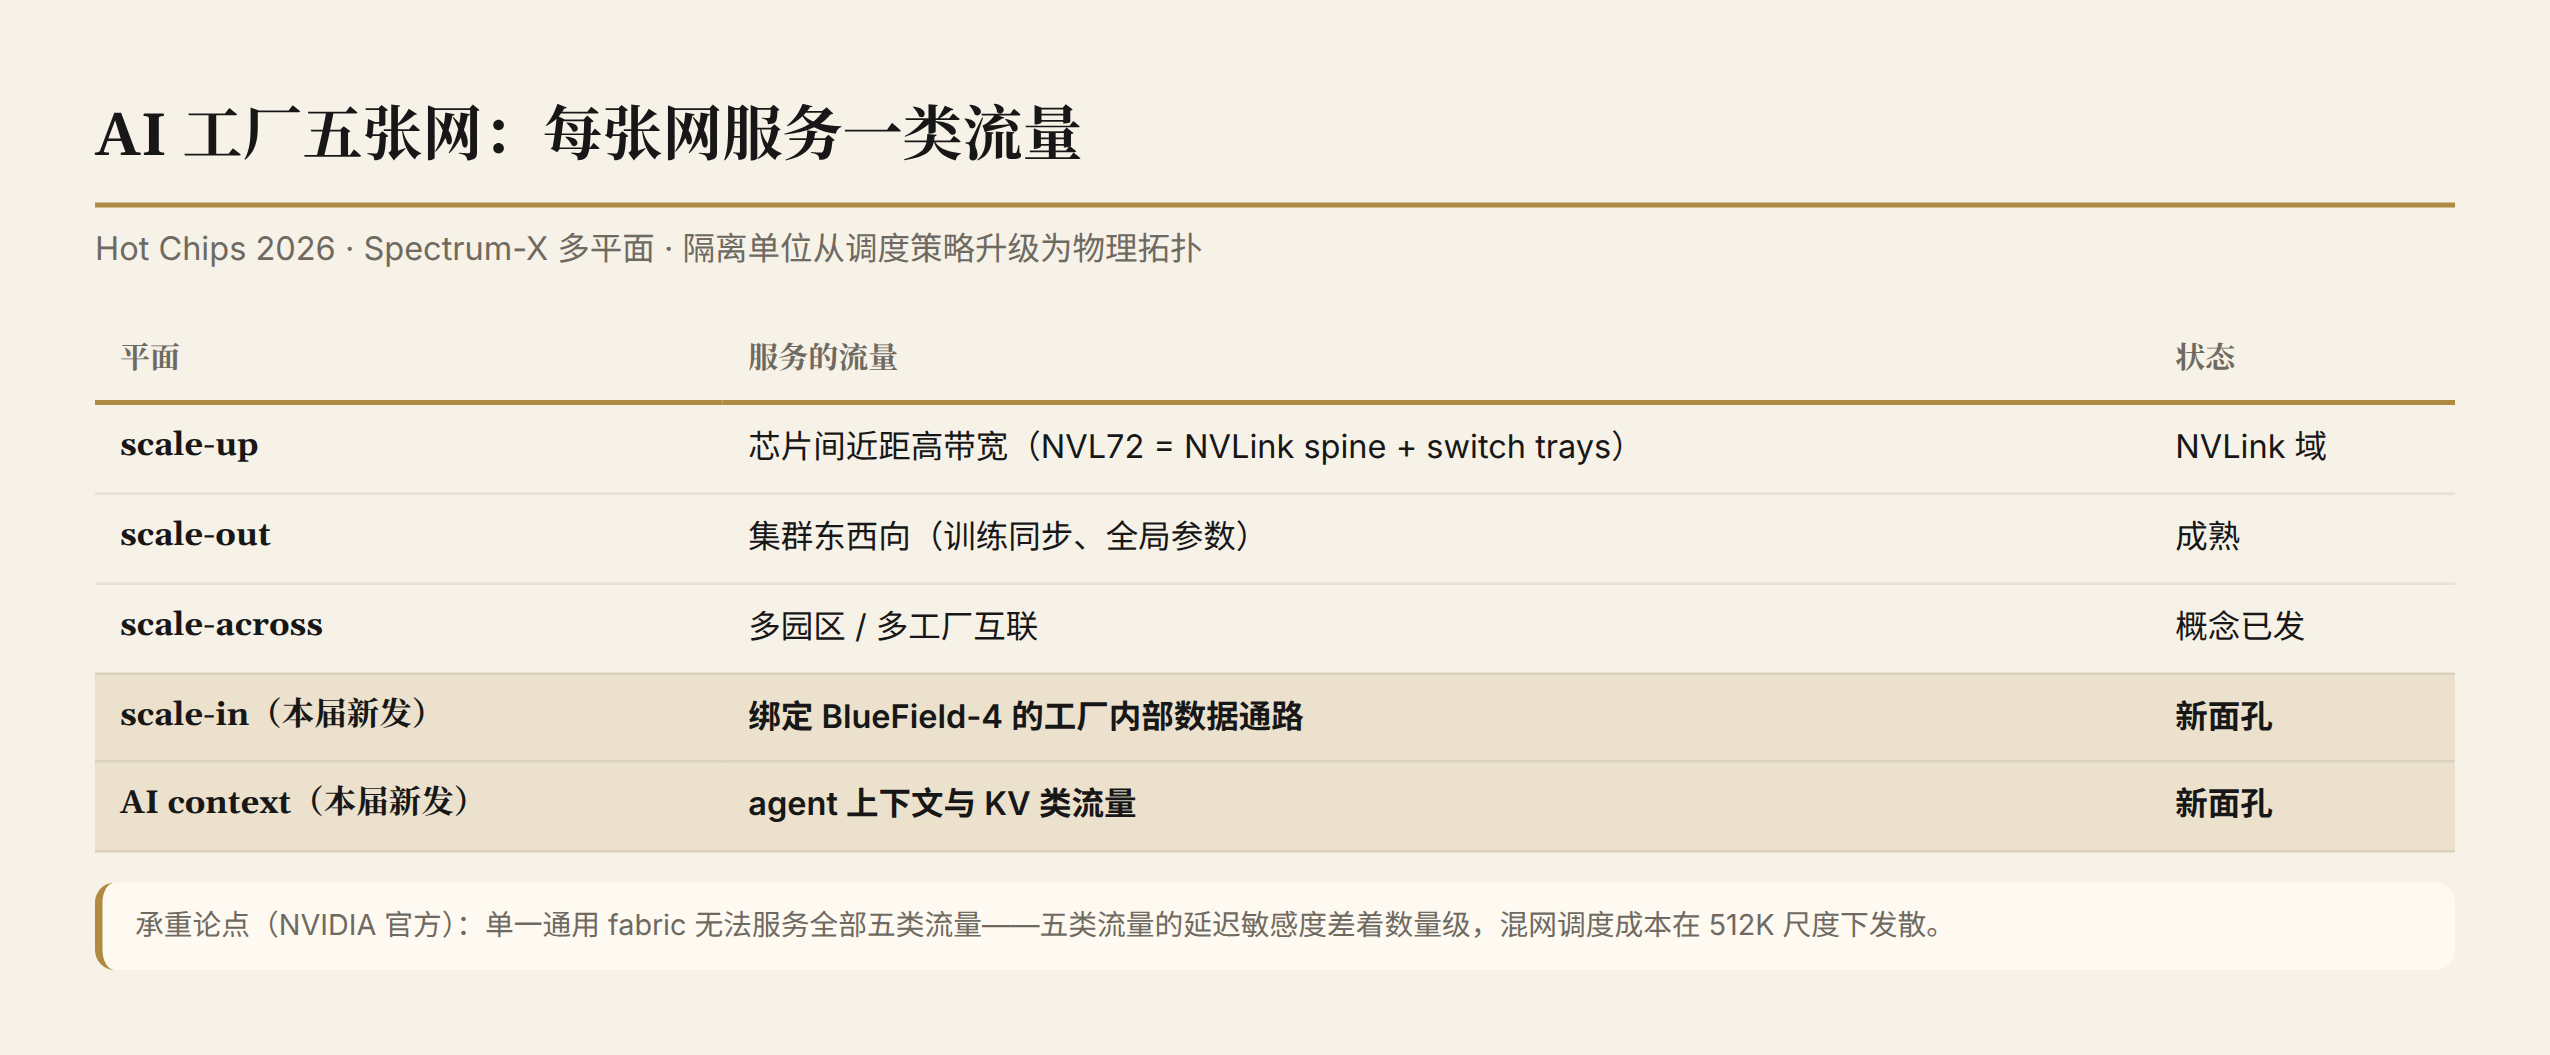
NVIDIA 给 AI 工厂的网络设计是五张专用网。为什么是五张?AI 工厂里的流量至少有五类——芯片间的张量并行通信、跨机架的训练同步、跨园区的数据与模型流动、节点进出工厂的 IO、agent 的上下文与 KV 访问。它们的延迟敏感度相差数量级,带宽特征各异,故障隔离要求互相冲突。一张通用 fabric 想同时服务五类流量,只能靠调度器做优先级仲裁,而仲裁成本随规模发散。五张网的做法是把仲裁换成拓扑:每类流量有自己的平面、自己的硬件、自己的故障域。
Scale-up(芯片间):NVLink。 张量并行与流水线并行要求 TB 级带宽、微秒级时延,这一层用以太网今天给不起,仍由 NVLink 承担:NVL72 机架由 spine 与 switch trays 构成 72 GPU 的单一域。开放性上,NVLink Fusion 把第三方 XPU 接入同一域,每颗 XPU 3.6Tb/s、72 颗一个域。这一层的要求最极端:带宽优先,其他指标让位。
Scale-out(集群东西向):Spectrum-X 以太网。 训练梯度与数据管道在机架间流动,承载它的是专用以太网:102.4T 交换机与 1.6T SuperNIC,自适应路由与拥塞控制针对 AI 流量重新设计,官方标称 1.6× RDMA 带宽、3× 低抖动;多平面在这一层落地,8 个平面×4 条 rail。实测数据:多 job 环境下 DeepSeek V3 训练比 OTS 以太网快 1.9×,Nemotron Ultra 的 NCCL 操作最高快 14×。
Scale-across(园区间):Spectrum-XGS。 多工厂、多园区互联要求距离感知:负载均衡与拥塞控制按链路长度调参,跨城市、跨州、跨大洲扩展,目标是压低跨数据中心时延。产品名 Spectrum-XGS,配套 ConnectX-9 800G,官方口径 1.9× 多园区性能。
Scale-in(节点侧):BlueField-4 DPU。 本届新发布的平面,回答的问题是节点如何进入工厂:scale-in 的数据通路直接落在 BlueField-4 上,节点内的 IO 编排、安全与遥测由 DPU 承担,官方给的量化位置是 18× AI 工厂服务带宽、10× 包处理率、3× 低延迟。它是五张网里与计算最近的一张,主机的第一跳。
AI context(上下文):Vera BlueField-4 存储处理器。 本届另一张新平面,服务的是 agent 负载的记忆与上下文访问:KV 体积大、读密集、跨节点共享、与存储系统天然耦合。NVIDIA 的选择是让存储侧的 BlueField-4 就近服务这类流量,独立成面,官方口径 2× 存储加速。agent 负载第一次被写进了网络拓扑的命名。
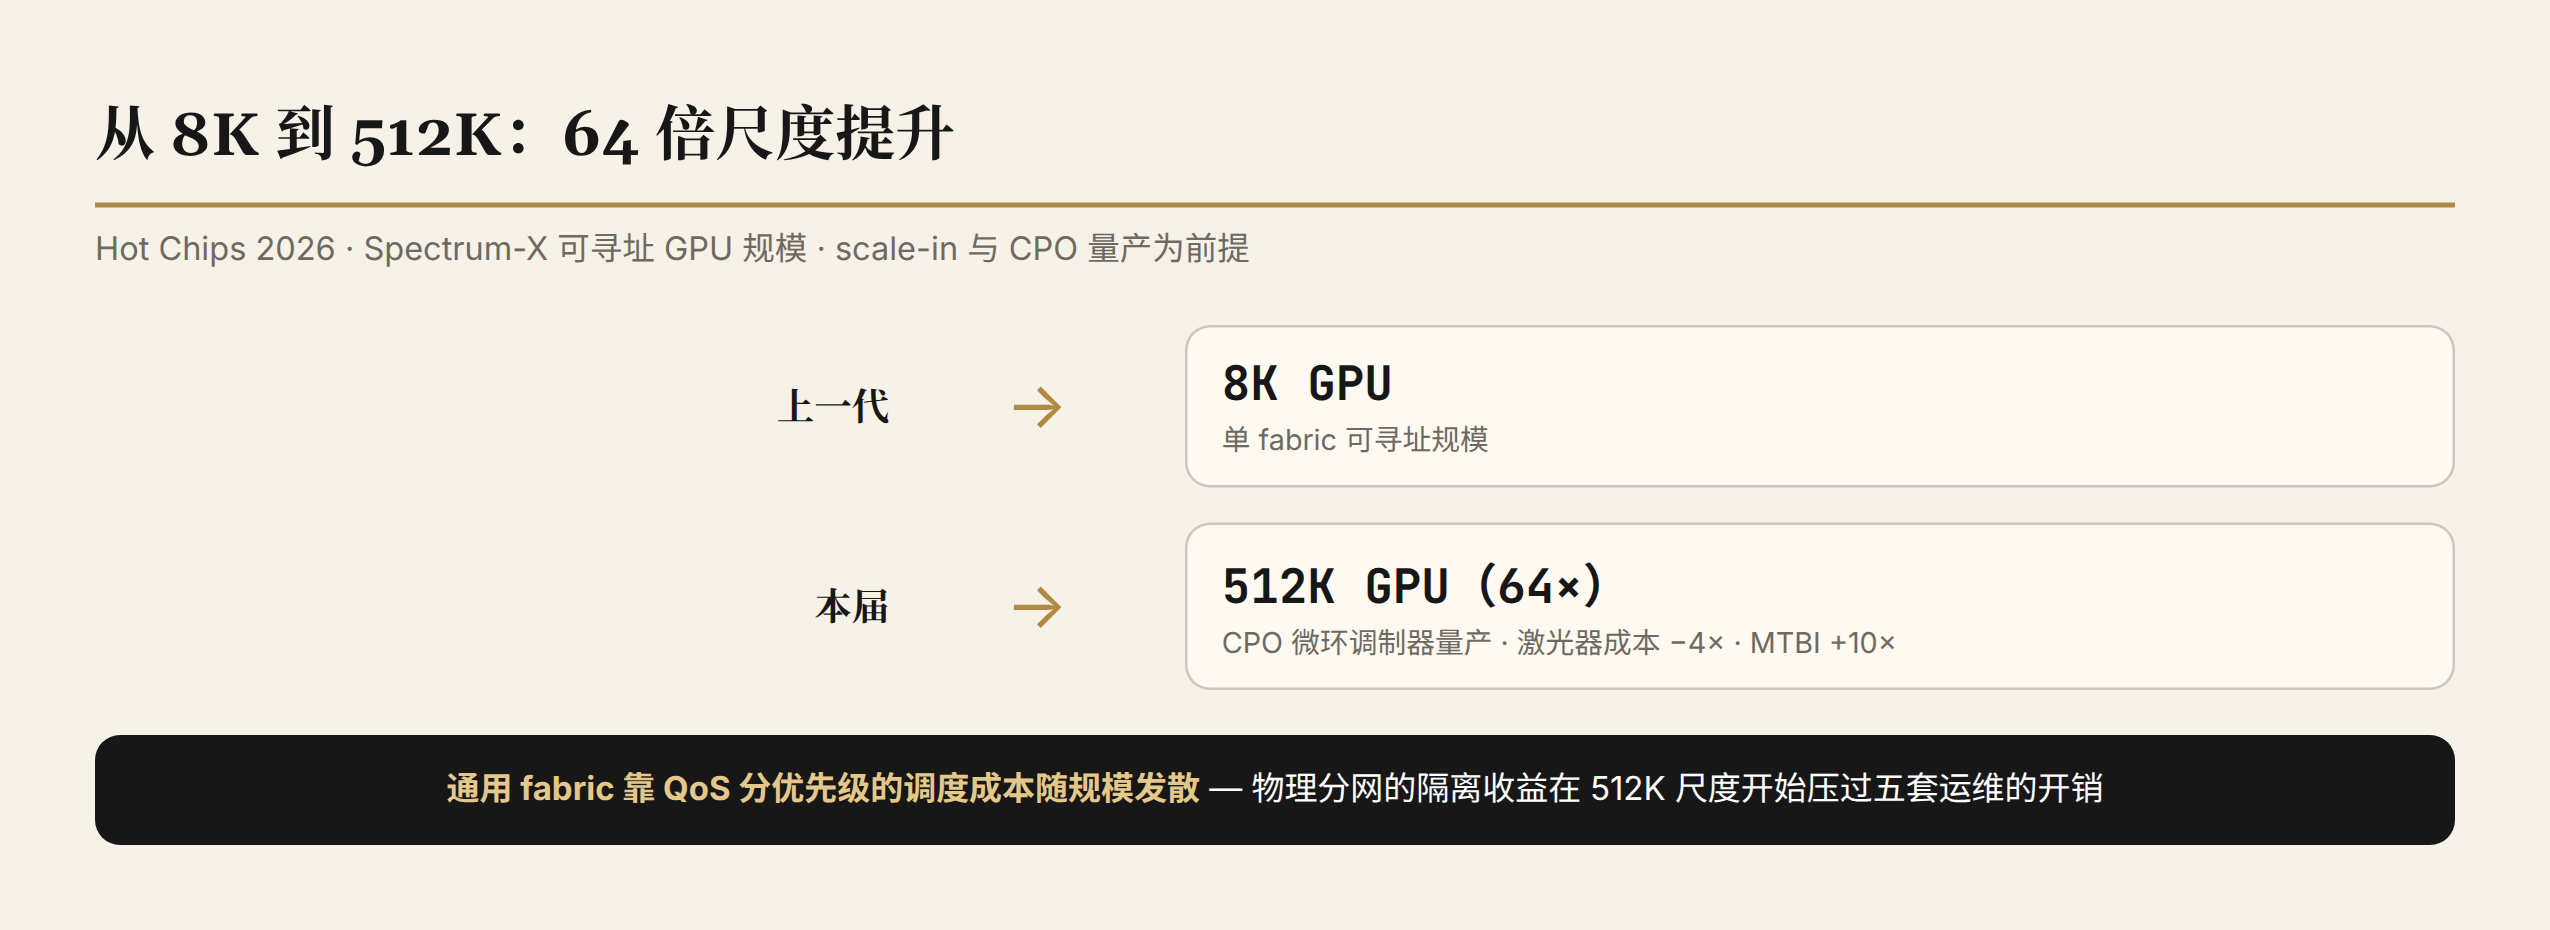
五张网的分工见图 1。代价同样明确:五套运维、五套采购、五套故障域。收益要在 512K GPU 的尺度上看:通用 fabric 的调度成本随规模上升,物理分网的隔离收益在同一方向增长。官方经济性数据给了三个数:对比多层单轨省 1.7× scale-out 交换机;单平面失效时其余平面维持 90% 带宽,故障检测 2.68ms、恢复 100ms,整机 goodput 1.6×。64× 的尺度提升是这一切的结果:512K Rubin GPU 以 8 平面、4 rail 组织,每 GPU 1.6T scale-out,100T 交换机用 512×200G 端口构成平面,可寻址规模从 8K 推到 512K(见图 2)。物理分网带来的不只是隔离,还有可收敛的故障域。
二、scale-out 的光层:CPO 量产
光互联在 scale-out 平面的交换层,这是第一处归位。AI 工厂的规模越大,光模块越多,光层的经济性直接决定 scale-out 的成本曲线。CPO 在本届从演示变成了量产:微环调制器量产,基于 TSMC COUPE 工艺的 3D 堆叠硅光引擎,可拆卸光纤连接器进入产品形态。我们此前在 corning-glassbridge 与 cpo-vs-npo 两篇里比较的是路线,玻璃桥与硅光 NPO 的耦合之争;本届给出的是量产数据:微环量产解决良率与成本曲线,激光器数量减 4×、功耗降 5×、MTBI 升 10×,直接改变部署经济性。
量产落到产品上的位置,是 Spectrum-X 的 CPO 交换模块,部署经济性的改善直接发生在交换层。生产链条上有四家:TSMC、SPIL、Lumentum 与 Foxconn。演讲本身给了规模参照:AI 工厂中光互联的功耗约为计算功耗的 10%,CPO 每省一瓦,都会在工厂总功耗上放大。
三、scale-in 的载体:BlueField-4 与工厂 OS
第二处归位是 scale-in 平面。BlueField-4 承载这张网,但这颗芯片的角色不止数据通路。它的发布名说明它的位置:「BlueField-4 Spectrum-X scale-in 网络」,网卡与网络平面一起发布,scale-in 的数据通路就落在这颗芯片上。它是 Vera Rubin 七芯片系统的一员,聚合 7Tb/s 的 Astra 承担它的吞吐。ServeTheHome 的现场评语值得整句引用:「与 Thor Ultra 完全不同级别的设备」。800GbE 网卡与工厂操作系统之间,相差一个量级的系统定位。
定位的变化有一条我们熟悉的线索:六月的 MRC 分析立过命题,把智能从交换机推到网卡,本届沿这条线走了两级。协议层,MRC 演进到 MRC++,数据通路已经公布。定位层,DPU 的定位从「替 CPU 承担辅助任务的卸载器」换成「AI 工厂操作系统」,获得工厂的数据面与 IO 编排权。
编排权归哪一侧,NVIDIA 对 agentic 负载的官方分解给了一手答案:Prompt 与编排落在 CPU,上下文、观察、推理、行动落在 LLM,记忆跨 CPU、DPU、CUDA、LLM 与网络,安全落在 CPU 与 DPU。控制面的编排权留在主机,数据面与 IO 编排交给网卡。这与 Intel 篇对 Diamond Rapids 的分界互为印证:网络侧的「工厂 OS」指数据面,Intel 侧的「编排层」指控制面,两条线在机架交汇,各管一侧。
四、开放一侧:Thor Ultra 落在 scale-out 的 NIC 侧
唯一的非 NVIDIA 发布来自 Broadcom。Thor Ultra 定位在 scale-out 平面的网卡侧:同一个平面、开放生态的另一端。它的背景是 Broadcom-OpenAI 的 10GW 合作:自研加速器加以太网组网,2026 下半年起爬坡至 2029,单集群 100,000+ 芯片的宣称出自这个语境。产品谱系上,它把 Tomahawk Ultra(2025-07,片内互连)开创的路线从交换芯片延伸到了网卡。
本届真正的新东西是 MRC++ 的数据通路,官方定义即增强型 RoCE(eRoCE)。四组能力各自回应上一代的痛点。上一代没有多路径,eRoCE 用逐 QP/逐包的 header entropy 做分流,交换侧 ECMP/E-ECMP/DLB 配合,网卡侧 packet spray 跨最多 8 个平面。上一代 Go-Back-N 重传浪费带宽,eRoCE 改 SACK/NACK 选择重传,配路径质量探针。RDMA 响应允许乱序放置,Send 与 Atomic 保序投递,接收端用位图重排。拥塞控制以接收端信用制(RCCC)为基线,P4-like 引擎承载可编程算法,把难调参变成可编程。两个「8」值得放在一起看:MRC++ 最多 spray 到 8 个平面,Spectrum-X 多平面恰好也是 8 个平面。NIC 与交换两侧对同一拓扑的对齐,是多平面从 NVIDIA 自有生态进入开放生态最直接的证据。
这颗 5nm、24 亿晶体管的网卡芯片功耗 40-42W(整板不含光 50-55W),提供 PCIe Gen6 x16、8×100G SerDes 与 64K+ 队列对。初测在 Gen5 GPU 平台上进行(2 节点、每节点 8 GPU、16×400G):all_gather 381.9 GB/s、all_reduce 383.9、reduce_scatter 380.2,三项都超过 96% 线速;TCP 单向 791 Gbps,RDMA 写 781 Gbps。与 ConnectX-8 的直接对比仍然缺席,但数据通路从「未公布」变成了「已公布」。Broadcom 给产品的定位是「QoS 与虚拟化支撑 XPU/CPU as a service」:网卡层的终点,是服务化算力。
五、总结与判断
把三场演讲放回五张网的框架,格局就清楚了。NVIDIA 发布的是整套框架:交换层做多平面,光层做量产,节点侧做工厂 OS;Broadcom 的 Thor Ultra 落在 scale-out 的 NIC 侧,用 MRC++ 对齐了 8 平面拓扑。五张网里唯一没有开放阵营发布的一张是 scale-up:本届网络议程里它仍是 NVLink 的自有域,但挑战者已经在别处出现:微软在云自研篇里用以太网加自研传输层 ATL 对准的就是这一层。512K GPU 尺度的工厂怎么连,答案正在一块一块补齐。
判断一:负载分层决定网络分层,五张网的代价与收益在尺度上翻转。 五张网意味着五套运维、五套采购、五套故障域,碎片化的质疑有分量。但通用 fabric 的调度成本随规模上升,到 512K GPU 的尺度,物理分网的隔离收益开始超过五套运维的开销;省 1.7× 交换机、故障时保住 90% 带宽,都是这个翻转的量化证据。
判断二:CPO 量产是光互联的分水岭。 从演示到部署的分界线是量产指标。光互联功耗已约占计算功耗的 10%,功耗曲线与成本曲线共同决定光互联从交换侧向主机侧渗透的速度。
判断三:网络 OS 化,BlueField-4 的定位变化是系统级信号。 一部分编排权正从主机 CPU 与交换机转移到网卡侧,网络设备开始定义工厂的运行方式。网络从连接工具变成基础设施,最终形态是一套操作系统。
后续关注点:① Thor Ultra 与 ConnectX-8 的直接对比;② MRC++ 多平面在超大规模集群的实测;③ CPO 成本与功耗曲线;④ scale-in 与 AI context plane 的部署材料;⑤ 10GW 合作 2026H2 爬坡节奏。
前瞻承诺:MRC++ 超大规模实测、CPO 成本曲线两个节点,我们回来验证。
数据截止 2026-08-28。事实来自 Hot Chips 2026 各厂商演讲材料与现场报道(ServeTheHome 等);单源与转述口径已在文中标注。
延伸阅读:Hot Chips 2026 总览 · 内存墙四路进攻 · Intel 三连发 · 云自研第二代