
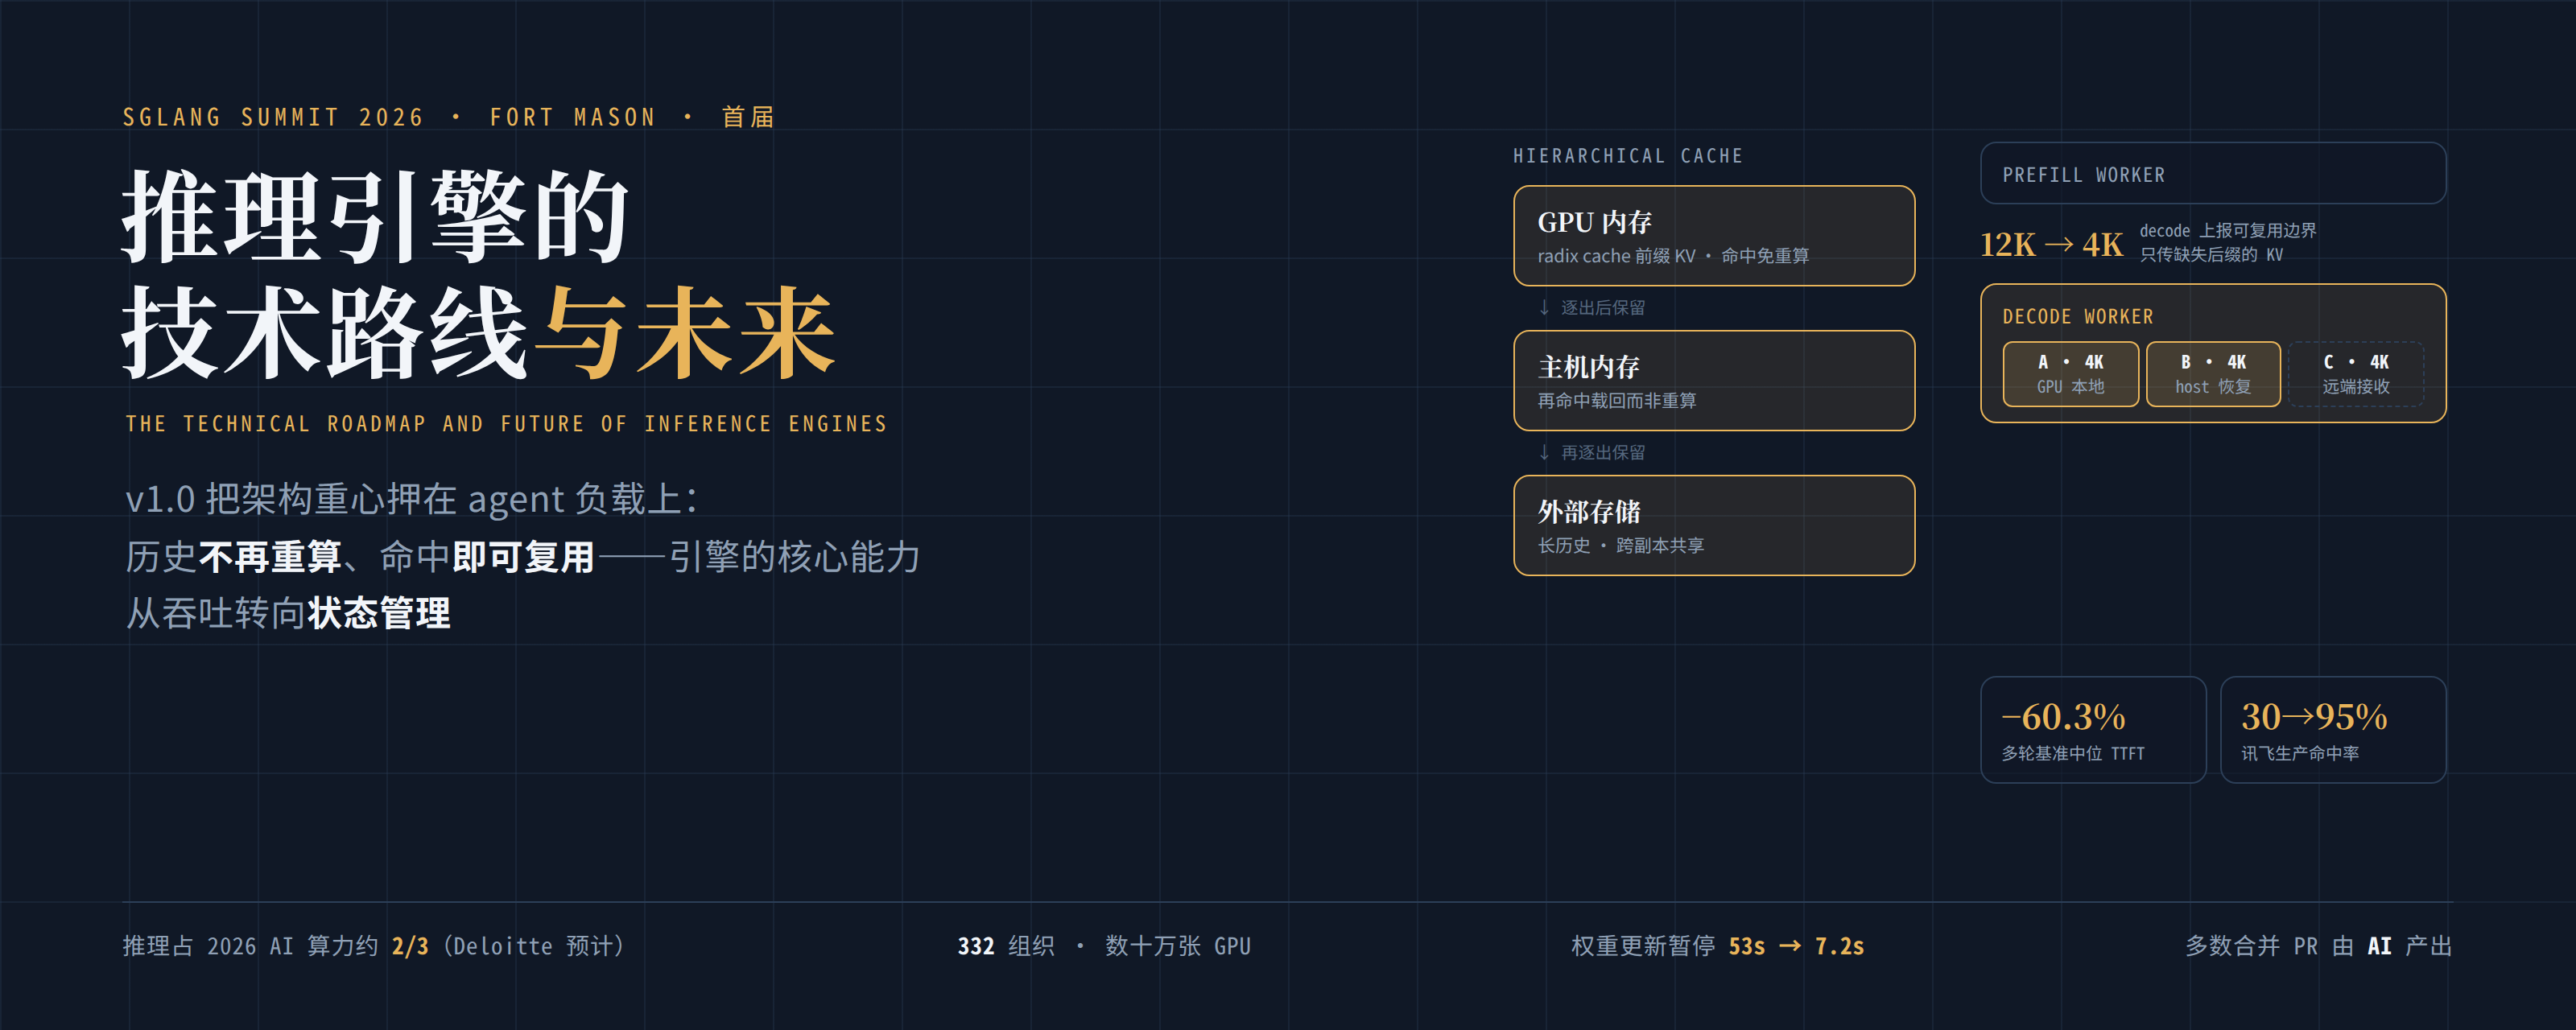
推理正在吃掉 AI 算力的大头。Deloitte 的预计是:2026 年推理约占全部 AI 算力的三分之二,一年前这个比例约为二分之一。决定这部分算力跑多快、多便宜的,是推理引擎。
11 月 12 日到 13 日,旧金山 Fort Mason,两千多人参加了第一届 SGLang Summit。开幕主台上站着 NVIDIA、AMD、Intel、Google、Meta,AMD CEO Lisa Su 录像致辞,AWS 在同期发布了 Trainium 后端,九十多场技术分会排满两天。一家开源推理引擎的首届峰会,把几乎所有计算平台的阵营拉到了同一张桌子上。
押注的深度并不相同:NVIDIA、AMD、Google、Meta 是生产或 day-0 级的投入,Intel 是合作公告,Trainium 后端还在公开预览阶段。但方向一致:没有哪家再把自研闭源引擎当壁垒,各家都在往同一个公共栈上加码。按主办方的口径,这套引擎如今跑在数十万张 GPU 上,部署方包括 Meta、Microsoft、Google、Amazon、Thinking Machines Lab、Cloudflare、Reflection 和 Modal。
同台是表象,这场峰会真正的信息量在披露的技术路线本身:v1.0 把引擎的架构重心押在 agent 负载上,RL 后训练框架 Miles 与 serving 栈在引擎层汇合,而引擎的多数合并 PR 已经由 AI 产出。本文先盘峰会披露了什么,再逐层拆技术细节,最后给推理引擎的未来四条推演。
一 峰会披露了什么:四条产品线,一条路线
第一天的公告排成一串,其实是同一个路线的四个面。
SGLang v1.0。官方的表述是一个中心加三项工作:中心是效率与生产可扩展性;三项工作是强化既有功能、把配置问题显式暴露、建立兼容性预期。这不是一次功能大跃进。release tracker 写明,发布分支切出之前,调度、KV 缓存管理、并行、prefill 与 decode 分离(P/D 解耦)、投机解码、server API 这些核心特性只修缺陷、不做大重构。它更像一份生产化承诺:不支持的配置在启动时或请求时报错并指明原因,而不是静默降级。已知问题清单上列着九个静默覆盖用户设置的历史案例,正在逐个修复。
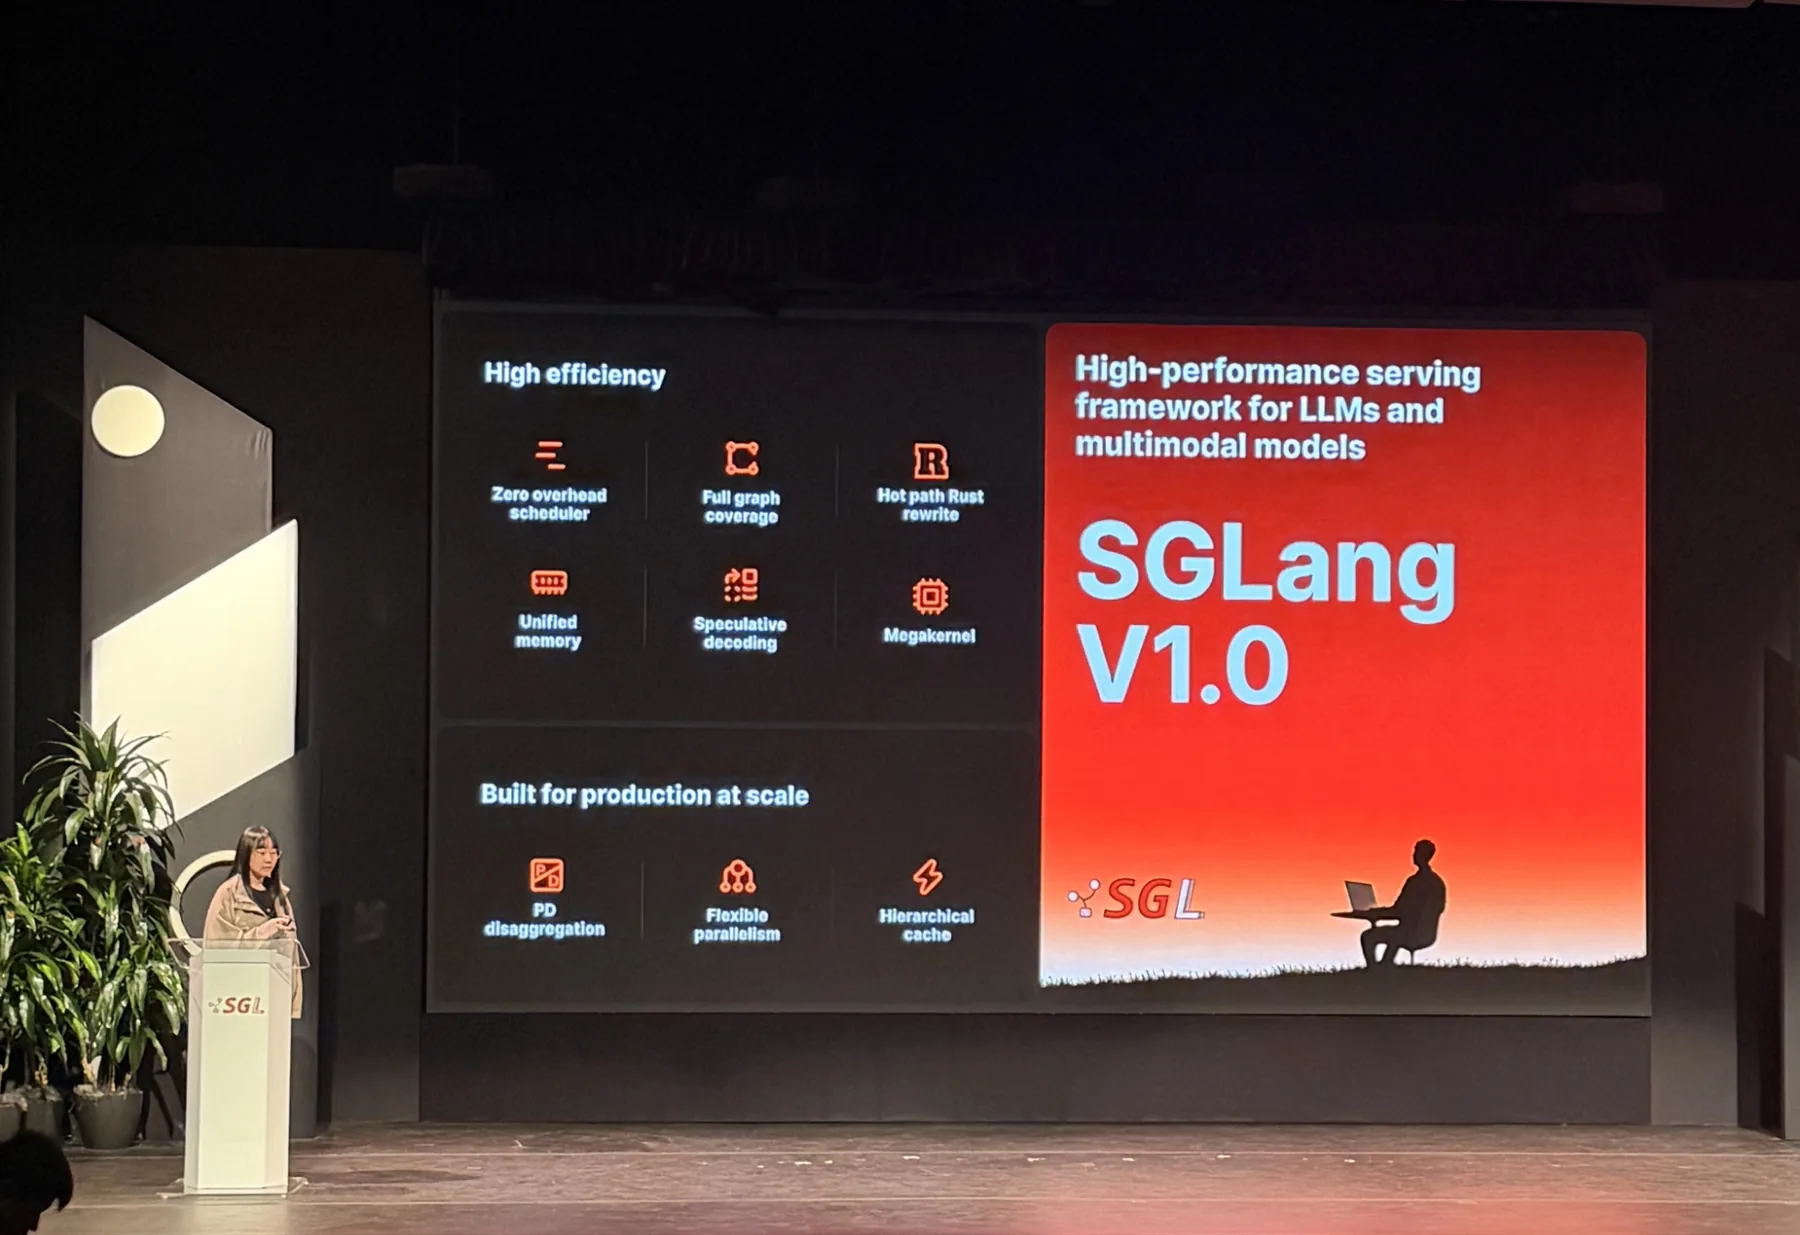
v1.0 发布的那页 keynote slide 把 1.0 周期的 serving 特性列在一起(图 1,现场照片)。
Miles v0.2。RL 后训练框架跨硬件、跨负载:训练跑在 NVIDIA GPU、AMD GPU、Google TPU 上(Trainium 在路上),训练后端 Megatron-LM、FSDP、TorchTitan 三选一;负载从文本扩展到图像、视频、音频 RL,Miles-Diffusion 覆盖扩散模型,Multi-LoRA 支持一个底座同时定制多个任务。这个版本合入了 400 个 PR,来自 20 位贡献者。
SGLang-Neuron v0.1.0。与 AWS Annapurna Labs 共研的 Trainium 后端开源,PyTorch 原生插件形态,公开预览限定在支持的语言与扩散模型上。预览版的功能清单比「移植」两个字重。引擎核心侧,全异步 runtime 让 Trainium 芯片的 decode 步背靠背执行、步间零空闲,NKI megakernel 把一步的全部解码层合成单次 kernel 调用。负载侧,Kimi-K3 跨三个 Trainium3 节点做 P/D 解耦、KV 经 NIXL 走 EFA 传输,GLM-5.2(MXFP4)以 100 万 token 上下文服务 agent 编程负载。
NIM Certified。NVIDIA 把 SGLang 收进企业分发线:验证容器、按模型与 GPU 优化的配置、持续安全维护,可选的企业支持随有效的 NVIDIA AI Enterprise 订阅提供。NIM 的验证是策展式的:覆盖 30 多种 NVIDIA 硬件 SKU 和 37 个以上流行模型,性能目标写得很具体,就是用户实际部署的那些配置上的每 GPU 每秒 token 数。
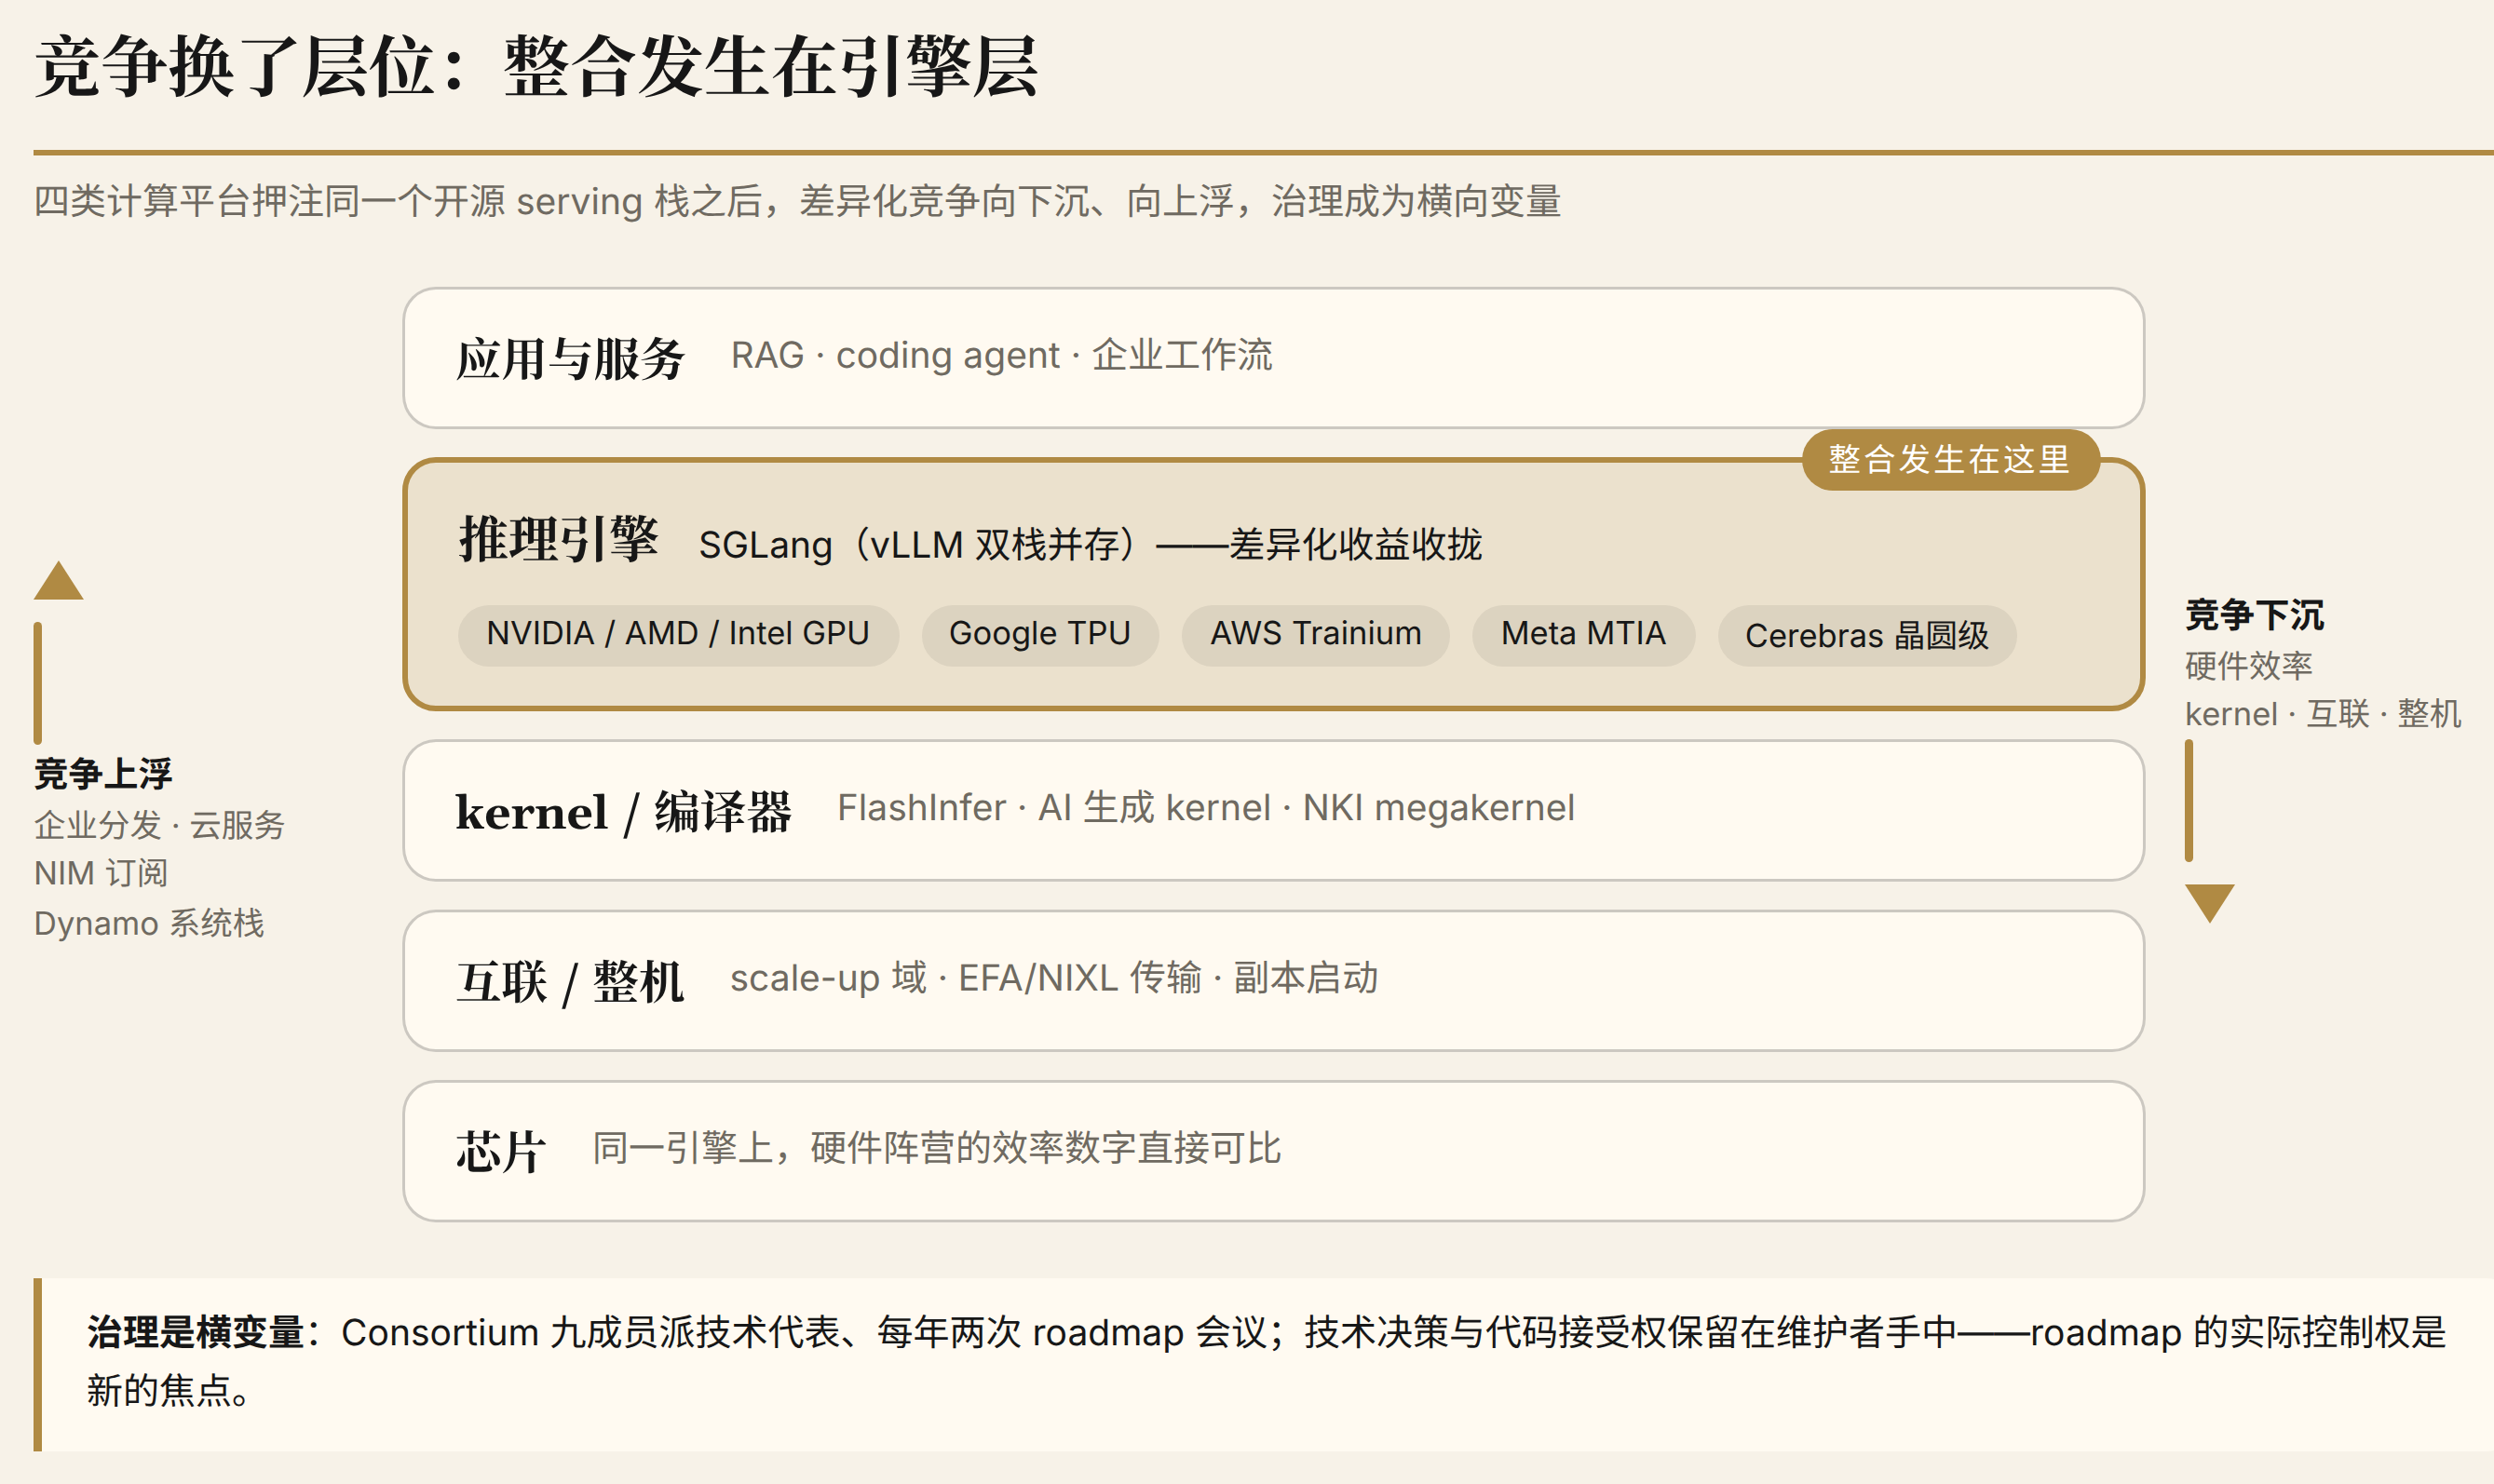
治理结构跟上了:九家创始成员(NVIDIA、AMD、Intel、Google、Meta、Thinking Machines Lab、Cloudflare、Modal、RadixArk,其中 Thinking Machines Lab 是公告四天后更新补入的)组成 Consortium,每家派技术代表、每年参加两次 roadmap 会议,会间工作组可以协作,roadmap 方向与进展公开更新;技术决策和代码接受的权力保留在维护者手里。这是有赞助人层的开放治理,而不是一次向基金会的移交。安全线也在同一场 keynote 里:Cloudflare 与 NEAR AI 报告的漏洞已经修复,进行中的工作是请求间隔离与管理面保护,社区公开征集安全合作方。
serving 主线按 agent 负载重构,硬件覆盖横向铺开,后训练栈与 serving 在引擎层汇合,开发方式本身 AI 化。四个面拆开看,后面四节分别讲。
图 2 把这个结构画在一起:整合发生在引擎层,竞争向下沉到硬件效率、向上浮到分发与服务,治理贯穿各层。
二 v1.0 的重心:把 agent 的状态管起来
v1.0 公告里对 agent 负载的技术判断只有两句,但每句都指着一个具体约束:混合架构模型要求不同类型的状态被一起管理;长跑 agent 累积的历史会超出 GPU 显存。
第一句说的是模型侧。注意力层与线性或稀疏层的混合布线,意味着要保存的状态不止 KV 张量一种。上一篇《Agent 写的推理引擎打赢了 SGLang》写过,GLM 这类混合注意力模型的前缀缓存必须同时保存稀疏注意力的分页状态和线性注意力的循环状态快照,只存 KV 复现不了完整模型状态。第二句说的是负载侧。AI 从回答问题转向完成任务,agent 每一步都要把不断增长的历史重新发给模型,这段历史迟早超过单机能装的显存。
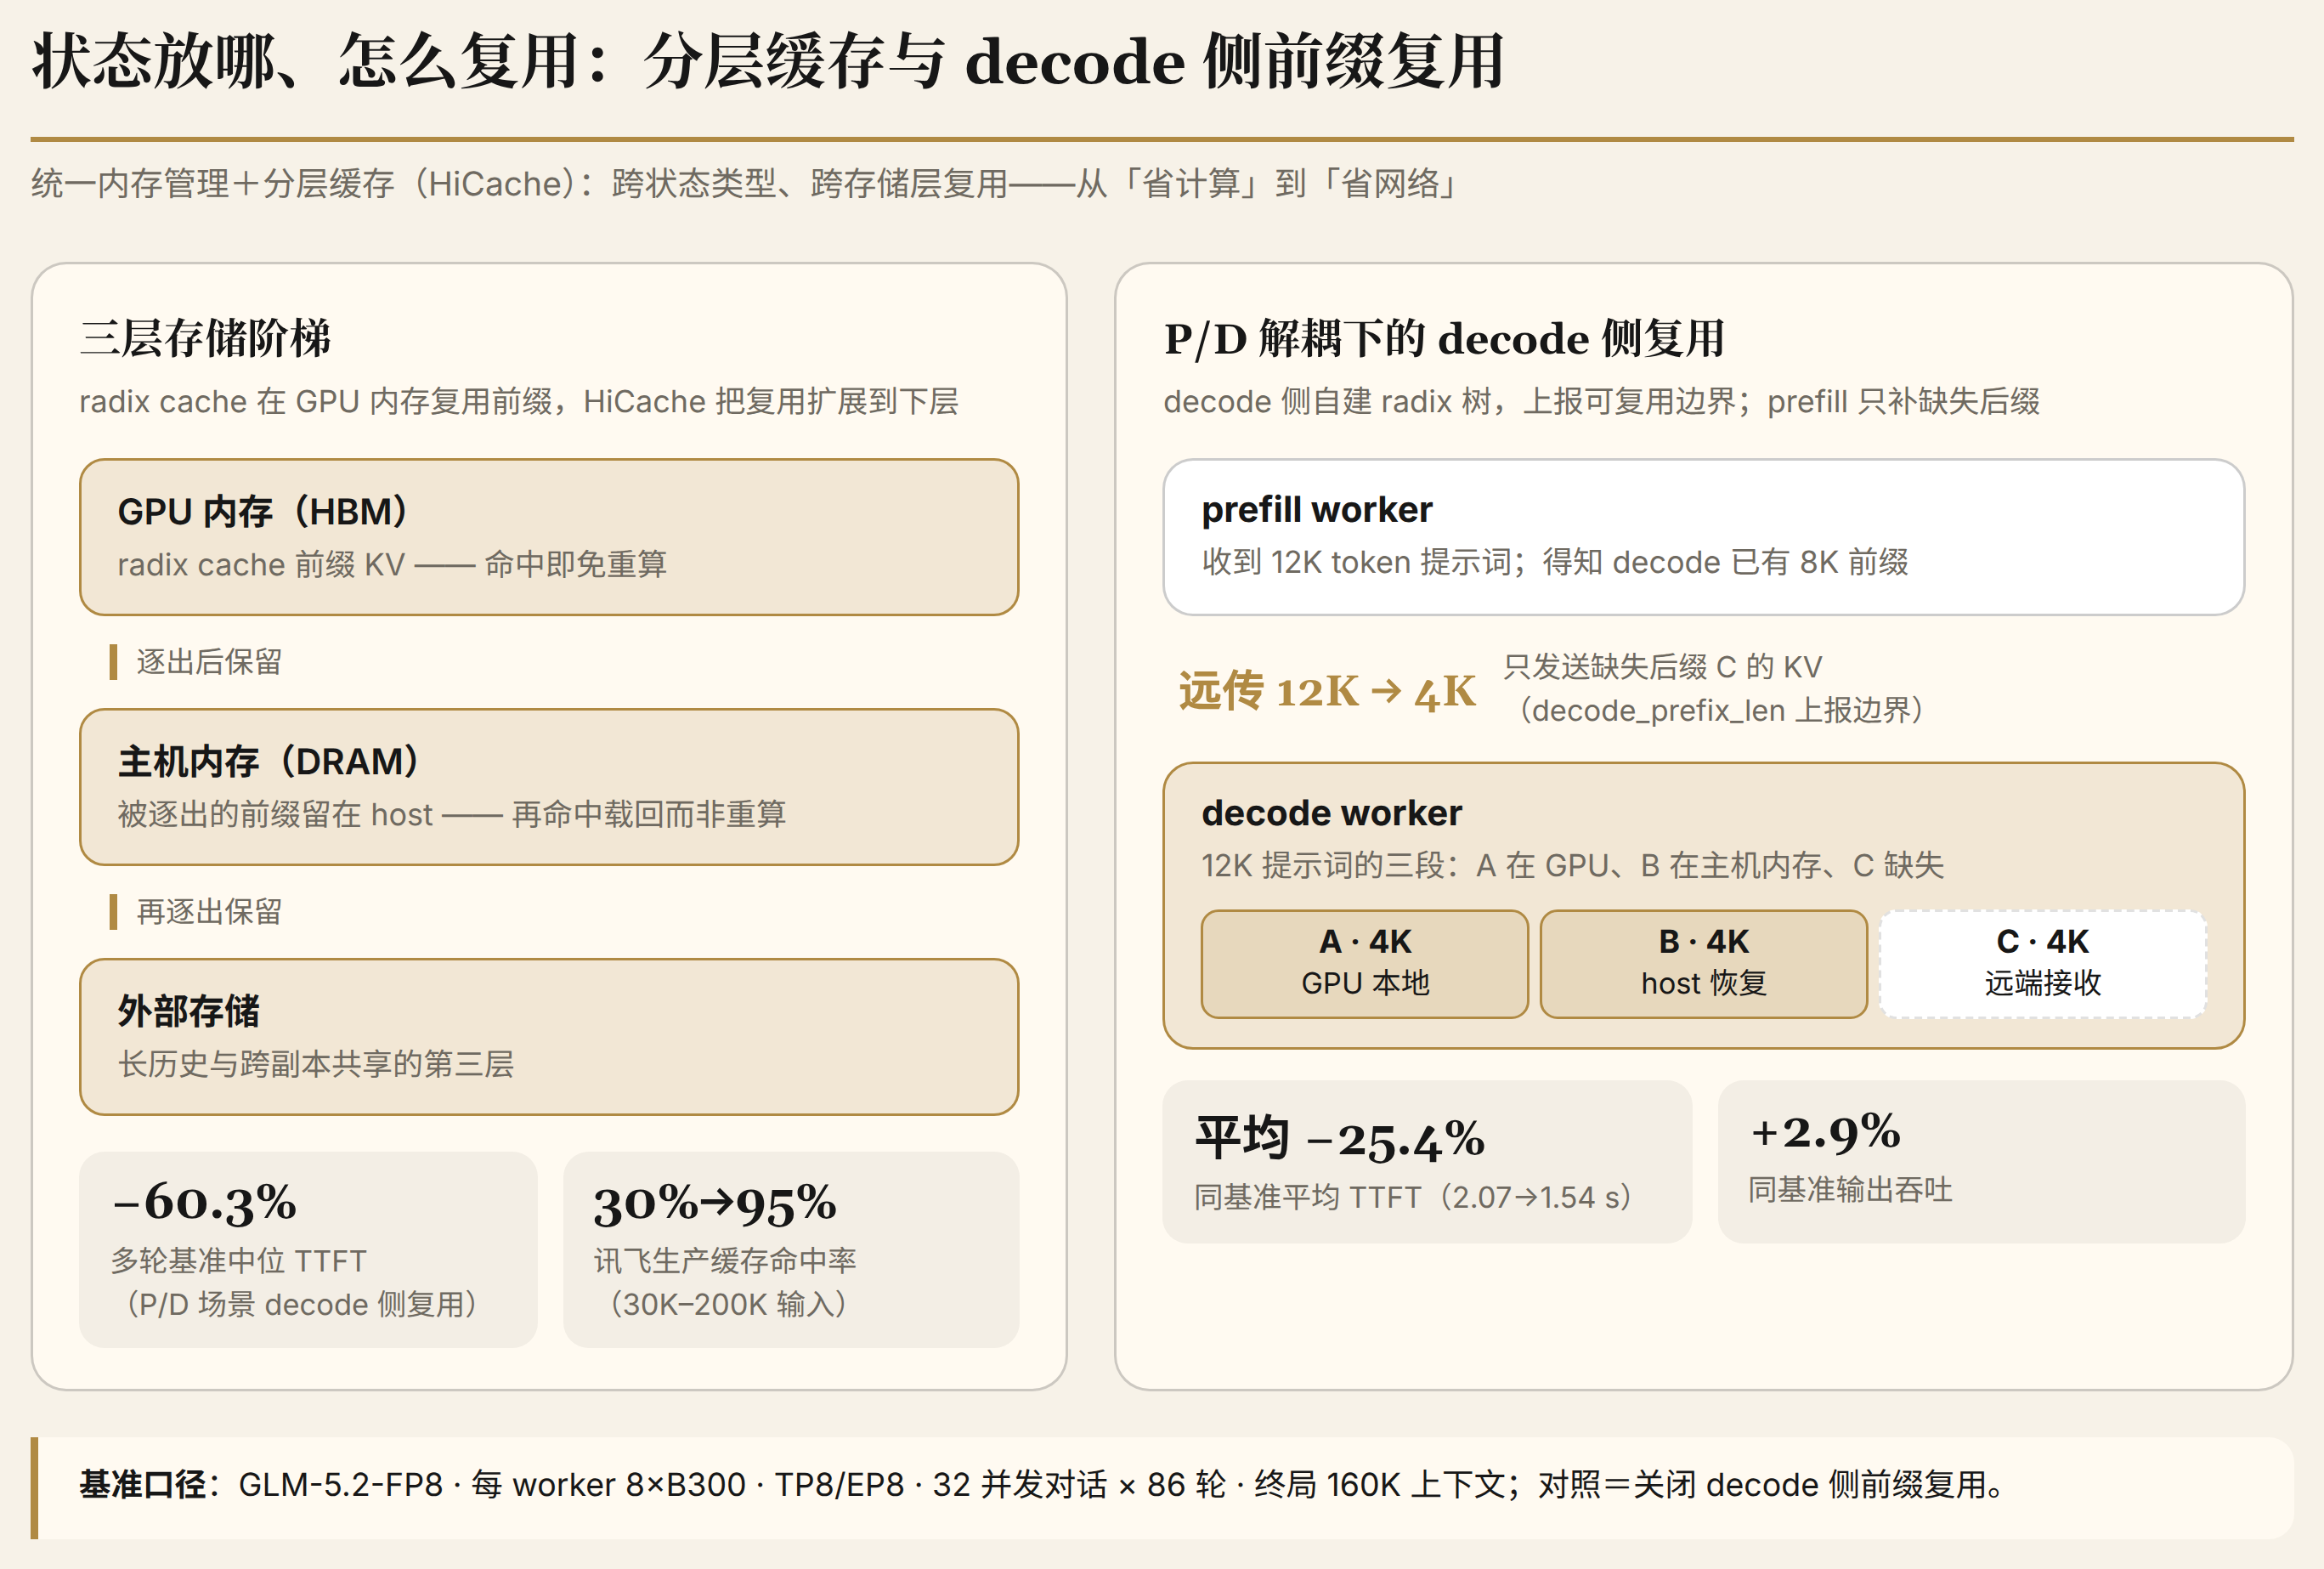
解法是统一内存管理加分层缓存,官方表述是支持跨状态类型、跨存储层的复用。分层缓存的层次结构直接来自官方博客的表述:radix cache 在 GPU 内存里复用前缀 KV,HiCache 把复用扩展到主机内存和外部存储。那条被广泛引用的「TTFT 降 60%」需要配上完整的测量条件。基准配置是 GLM-5.2-FP8,每个 worker 八张 B300,TP8/EP8,prefill 与 decode 同配;32 个并发对话跑 86 轮,四个组各八个对话共享 32K token 的初始前缀,每轮新增 1K 输入、生成 512 输出,终局每个对话 160K 上下文。与关闭 decode 侧前缀复用的基线相比,开启 GPU 与主机两级复用把平均首个 token 等待时间(TTFT)压低 25.4%(2.07 秒到 1.54 秒),中位数压低 60.3%(0.681 秒到 0.271 秒),输出吞吐还提高了 2.9%。注意这是 P/D 解耦场景下 decode 侧前缀复用的收益,不能当作 HiCache 的泛化数字。
生产环境里有对应的案例:科大讯飞 Astron MaaS 团队用流水线并行加 P/D 解耦加 MTP 服务 GLM-5.1/5.2 CodingPlan 负载,请求典型输入 3 万到 20 万 token,部分到 100 万;接入 HiCache 与外部存储之前缓存命中率约 30%,接入后到 95%,中位 TTFT 压到 3 秒以内。这不是基准,是团队自报的生产读数,但方向与机制和上面的基准一致:历史不再重算,命中即可复用。
最能说明缓存与调度如何配合的是一条机制细节:P/D 解耦下,decode 侧也维护自己的 radix 树,把可复用边界上报给 prefill(decode_prefix_len),prefill 只发送缺失的后缀。一个 12K token 的提示词,8K 前缀在 decode 侧本地恢复,远端传输从 12K 降到 4K。缓存复用从「省计算」变成了「省网络」——这是 agent 负载下缓存与调度配合的形态,与我们上一场比赛的观察同向:那次赢的引擎也写了 kernel,但把赢家与基线分开的是调度与缓存的配合,而不是 kernel 吞吐本身。图 3 把三层存储阶梯与这股复用流画在一起。
配置显式化与兼容性预期是这条路线的另一半。tracker 里列着九个已知静默覆盖案例,比如请求 seed 在未开确定性推理时被忽略、max_new_tokens 被 KV 缓存容量静默截断、投机解码步数被悄悄替换成 1;每一个都要么照用户设置执行、要么报错指明原因。兼容性政策把命令行参数、环境变量、HTTP 路由、Python Engine API 列为 1.x 稳定接口,写明弃用窗口。这些不性感,但它把「引擎能不能进生产」从口碑问题变成了合同问题。Rust 写的 sgl-router 0.1.0 已随 1.0 周期发布,取代旧的 sgl-model-gateway。
引擎竞争力的构成正在变化。Meta 讲选型理由时说引擎核心就是调度、缓存和 kernel,v1.0 的重心压在前两件上。推理引擎的下一个竞争轴是状态管理:状态放在哪一层、怎么复用、怎么跨层移动。
三 同一个栈上,硬件怎么拉开差距
引擎层收拢之后,硬件阵营的数字第一次可以直接对着读。但要先分清两类对比。
跨厂商的可比性来自公共负载。Kimi K3.1 Pro 发布当天,AMD 与 AWS 给出 day-0 支持,NVIDIA 给出 Vera Rubin 上的性能口径。同一个开源模型、同一个引擎栈,构成的是可比条件本身。开源模型成了硬件阵营的公共测试负载,这件事的分量在于:过去每家自研栈各测各的,现在对照条件是现成的。
代际对比则出现在 NVIDIA 自己的数字里:Kimi K3.1 Pro 在 Vera Rubin(Dynamo 加 SGLang)上每 GPU 总 token 吞吐最高 6 倍,对照的是 GB300 NVL72 上跑 AgentX,同等交互性。三个口径要素缺一不可。这是 NVIDIA 两代平台的对比,Vera Rubin 对 GB300,同厂商的代际比较。「总吞吐含缓存输入 token」是 agent 负载的计分方式:缓存命中的输入按近零计算成本计入产出,与裸解码吞吐不可换算。对照负载 AgentX 正是我们上一场比赛用的语料,从 opt-in 的 Claude Code 会话录制、去掉原始内容后用合成 token 重建,保留长度、时序与前缀共享结构,会话结构真实、内容合成。厂商自报,演讲场合,照例标注。
这组数字出自 Kapasi 演讲的 keynote slide(图 4)。
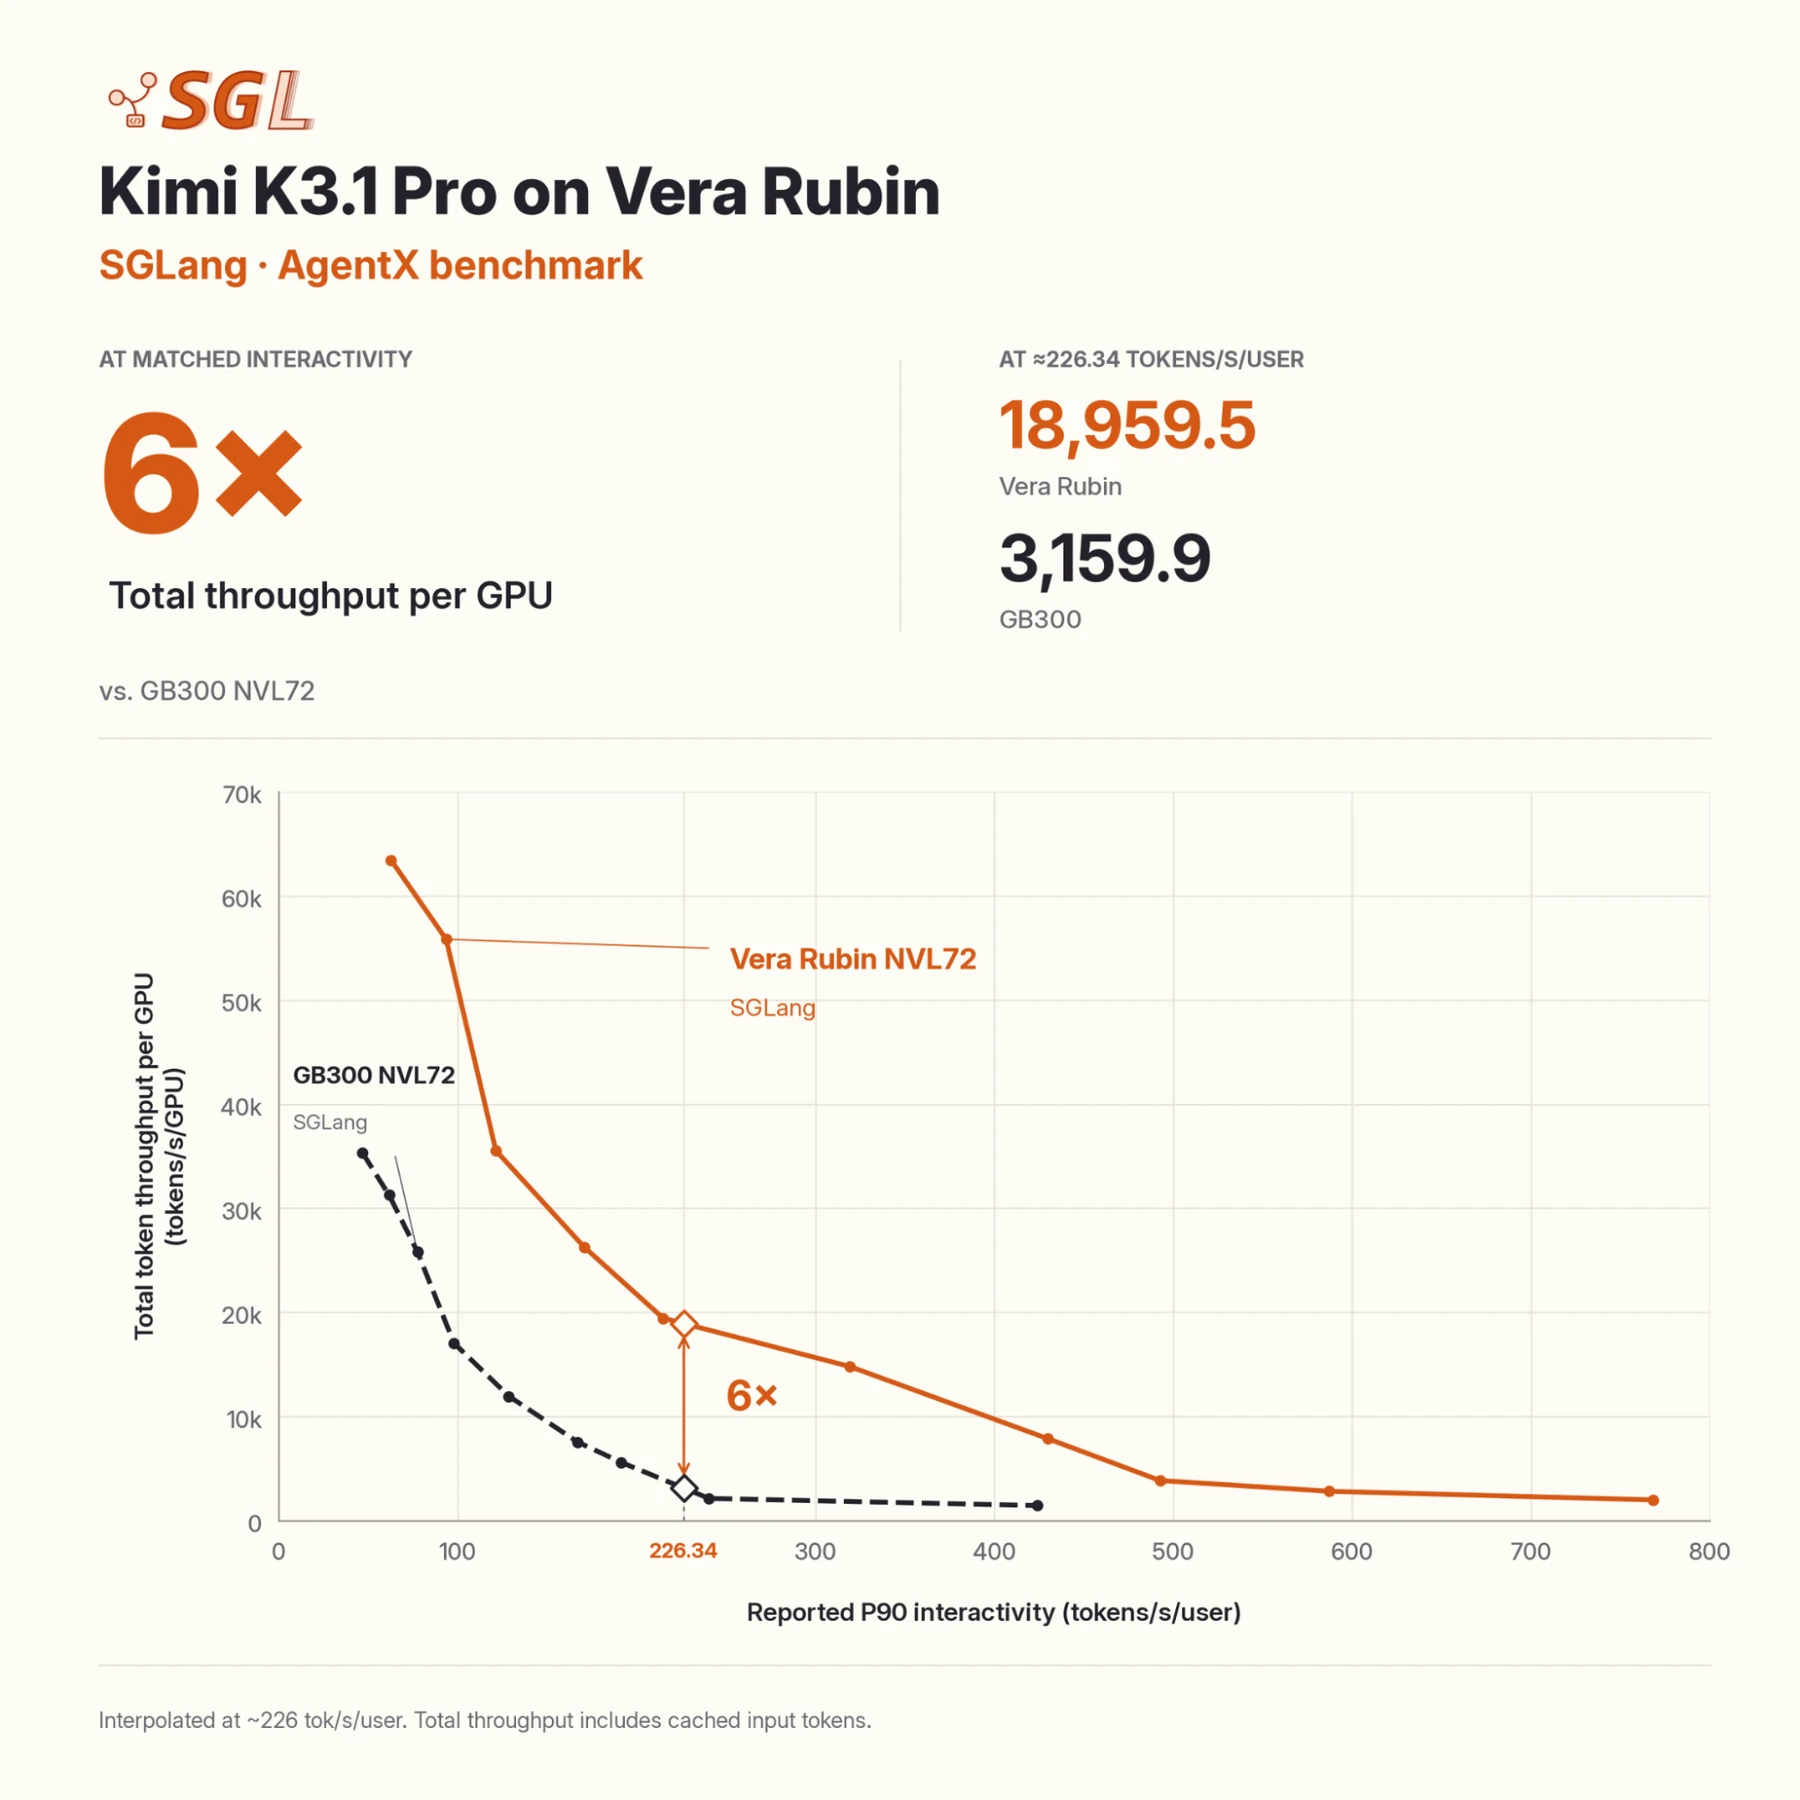
NVIDIA 还披露了系统侧的三项工作。Dynamo 集成做缓存感知路由,请求跟着缓存位置走,配合分布式 serving;Snapshot 与 Model Express 加快副本启动,压的是冷启动与弹性伸缩的时间;Vera CPU 被定位为 agent 沙箱与 RL 负载的承载,CPU 算力进入推理拓扑,agent 的执行环境与模型服务放到同一平台上。
AWS 的 Trainium 栈在预览里已经露出深度:除了第一节讲过的异步 runtime 与 NKI megakernel,SGLang Diffusion 已经跑上 Trainium2,覆盖 FLUX.1-dev、FLUX.3-Action、MiniMax-H3、Wan2.2 A14B、LingBot-World-V2 五个模型。这里要区分两个 megakernel:Neuron 的 NKI megakernel 是 kernel 融合技术,一步一核;峰会技术分会上「AI 写的 GPU megakernel 让解码最快提升 2 倍」是 agent 产物。这两个词说的不是一回事,后一种放到第五节讲。AMD 侧,MI355X 上对 agentic RL 做时间去向分析再逐项优化,吞吐提升 3.5 倍(workshop 数字);MI455 与 Miles 的协同在推进。Google 的 TorchTPU 与 SGLang、Miles 协同,方向是按负载定制 TPU。
Cerebras 的配对把 P/D 解耦推到了器件类别层面:GPU 做 prefill、晶圆级系统做 decode。prefill 偏计算,decode 偏内存带宽,按硬件特性切负载的逻辑不变,但解耦不再要求两端是同类硬件。kernel 层,FlashInfer 持续把改进的 kernel 供给 SGLang。NVIDIA 的 Luis Ceze 讲了 AI 辅助 kernel 优化的验收方式,靠编译器反馈加独立正确性检查,细节在第五节展开。
Meta 的生产证据给这场竞争提供了体量参照:SGLang 支撑着 Muse App、Muse Code、Model API、Meta 全家系应用与图像视频负载,基础设施横跨 NVIDIA GPU、AMD GPU、TPU、MTIA 四种硬件;从原有推理方案迁移过来,GPU 节省超过 2 倍,在大规模、多硬件上验证。这个数字是 Meta 自报的,基准与验证细节没有披露,但这是目前公开口径里最大规模的多硬件生产迁移读数。
本节所有效率数字都是各阵营在公共栈上的自报,口径逐个标注过。整合时代的横向比较,靠的就是口径纪律。
四 后训练的接口在引擎层汇合
RL 后训练与 serving 的关系,通常被讲成两个栈。Miles 把接口收到了引擎层:rollout 用 SGLang 跑,训练侧 Megatron-LM、FSDP、TorchTitan 三选一,中间的同步开销是硬问题。
万亿参数的 Kimi-K2(FP8,权重约 1TB)把这个开销讲得最具体:它的权重更新暂停从 53 秒降到 7.2 秒,规模是 32 个训练节点加 32 个 rollout 节点。这个数字重要,是因为权重传输期间整个 RL 训练停摆,trainer 和推理引擎都在等,权重同步是关键路径上的操作。NCCL 广播在这个场景下暴露三个问题:同一份数据沿网络多次发送的冗余;广播期间大多数 rank 干等;通信组一旦建好就固定下来,动态扩推理实例要重建组。lock-step 语义下,一个接收方慢启动就能挂住全组。
新方案的机制是:源侧每个训练 rank 在 CPU 内存里放一个引擎副本(约 32G 的代价),通过 Mooncake TransferEngine 走 RDMA 点对点直传,按正确的 shape 发给各个 SGLang rank,推理侧显著更快恢复 rollout。四个方案放在一起看得更清楚:磁盘加载要花几分钟,NCCL 广播约 50 秒,Perplexity 的 fabric-lib 能到 1.2 秒但不开源、只支持 FSDP2 DTensor,这个方案 7.2 秒而且全开源。这仍是工程取舍,代价与收益都摆在明面上。
Miles 这条线上,对 RL 工程师最有感的三处变化是:多模态 RL 走 token 空间,单一 media processor 让 rollout 与 trainer 看到同样的 token;score centering(v0.1.2 起)消除陈旧样本给梯度带来的漂移;容错进入实验阶段,单个 cell 失败不再终结整个 run。NIXL 成为 P2P 权重传输的第二通道,与 Trainium 侧 KV 经 NIXL 走 EFA 同源。传输层的抽象在收敛,这是接下来可以持续观察的信号。
还有一条旁证回到第二节的主线:Miles v0.2 修了 Nemotron-H / Nemotron 3(hybrid Mamba 架构)在打包样本边界处的 Mamba 状态重置。混合架构的状态管理问题不只出现在 serving 栈,后训练栈同样真实存在。RL rollout 本身就是长上下文、多状态的 agent 形态负载,统一内存管理与分层缓存对它同样是效率来源。
五 AI 开始写引擎本身
峰会上最不寻常的一句官方表述藏在 v1.0 公告里:agents 已经产出项目多数合并 PR;下一步的工具链要做写码、审 PR、建测试、管兼容、提 roadmap。
技术分会的数字把这句话落到实处。AI 写的 GPU megakernel 让解码最快提升 2 倍,输出对照原 kernel 验证。两名工程师带着 AI agent,不到一周把 SGLang 移植到另一款 AI 加速器(未具名),原文说结果 "within 1% of production performance"(达到生产性能的 1% 以内),生产性能的参照系没有展开。kernel 优化的验收模式是编译器反馈加独立正确性检查。workshop 里还有个象征性场面:一台单卡 RTX PRO 6000 跑 Qwen3.8-27B 的全本地 coding agent,修 Mini-SGLang 的优化——本地推理修引擎本身。
上一场比赛的结论在这里接上了。那次 Singularity-Bench 推理引擎层的比试里,完整可用的引擎只是头部模型拿得到的入场券:能力决定能不能入场、入场后站在哪一档;而在最高那一档的两个赢家内部,收入不再跟着模型档位走,只跟着工时和分工方式走,赢家的增量来自调度与缓存的配合。现在开源主栈自己成了量产现场:AI 产出进主线,人类维护者保留验收权。这个结构与 Consortium 的治理同构:技术决策与代码接受都在人手里,产能来自机器。
验收模式是这件事能成立的关键。AI 产出的质检不靠人逐行审,靠机器闭环:编译器反馈告诉它哪里错、独立正确性检查告诉它对不对。这是 AI 工程能规模化的前提,也是「AI 写引擎」可信的机制所在。没有这一层,多数 merged PR 只会是质量事故的委婉说法。
飞轮的表述要克制:AI 写引擎,引擎跑 AI,更多 AI 产出。这不是愿景修辞,而是已经发生在合并记录里的现状外推。瓶颈也在这里:峰会在公开征集安全合作方,这件事本身说明安全审查的节奏还没跟上产出的节奏。
六 推理引擎的未来:四条推演
下面每条推演都标注证据强度和观察点,说明哪些是已发生事实的直接外推,哪些是判断。
**第一,状态管理成为引擎竞争的核心轴。**负载从问答转向做事,agent 每步重读历史;引擎的差异化压在缓存、内存、调度的一体化上。证据强度:v1.0 官方路线、HiCache 基准数字与讯飞生产案例的直接外推。观察点:v1.0 tracker 的兼容性政策与静默降级清理的落地节奏,分层缓存出现在更多生产案例里的数字,以及混合架构模型普及后状态管理复杂度的变化。
**第二,引擎选型权重下降,硬件效率与服务分发权重上升。**同一引擎加同一公共负载,就构成可比条件。跨厂商的证据是 K3.1 Pro:AMD 与 AWS 给出 day-0 支持,NVIDIA 给出 Rubin 性能口径,用的是同一个模型、同一个引擎栈。同一栈上的代际对比,实例就是 Rubin 6×。企业侧选「哪个引擎」的风险,让位给「谁的硬件跑得好、谁的服务接得住」:NIM 订阅、Dynamo 系统栈是现成的商品形态。证据强度:整合事实加 NIM 商业动作,方向明确,幅度待观察。观察点:Consortium 首批 roadmap 决策,第三方复测的同栈硬件对比,以及 vLLM 与 SGLang 双栈格局的演变。
**第三,异构算力成为推理常态。**一个栈覆盖 NVIDIA、AMD、Intel 的 GPU,TPU、Trainium、MTIA、晶圆级系统,CPU 进拓扑做 agent 沙箱;Cerebras 式跨器件 P/D 配对把「按负载特性分配硬件」推到器件类别层面。证据强度要打折:多数后端处于公开预览、day-0 支持或合作公告级别,方向已定,生产规模未证。观察点:Trainium 与 MTIA 后端的生产规模落地,晶圆级 decode 配对的实际部署,以及 tracker 上 K3.1 对 AMD MI35x 支持范围的最终决定。
**第四,AI 写引擎的飞轮开始转。**多数合并 PR 已是 AI 产出、AI kernel 进主线、一周级移植,引擎自身的进化速度成为新变量。OpenAI 的 Lilian Weng 说研究者正在变成团队负责人,指挥 agent 做实现;这句话在基础设施项目上的对应物已经出现。证据强度:现状事实,外推幅度有不确定性,验收与安全审查是瓶颈。观察点:合并 PR 中 AI 产出的占比走势,AI kernel 进入主线的频率,以及安全审计节奏能否匹配产出节奏。
治理与所有权是这四条背后的横变量:维护者控制 roadmap 的开放治理、芯片厂深度介入开源栈,在监管视角下已经是市场结构问题。NVIDIA 收购 Hugging Face 一案(129.3 亿美元)据报道正受司法部反垄断问询,监管问的恰恰是芯片厂会不会借此控制 AI 模型的关键分发渠道。接下来两年,Consortium 的治理细则公开节奏、这桩收购的审查结果,比任何一次基准跑分都更需要盯。
七 边界与读数方法
这篇文章的判断有三条例外。整合的是 serving 栈,训练与后训练栈没有整合:Megatron、FSDP、TorchTitan 并存,Miles 是引擎侧的延伸,不是统一训练栈。双栈并存:vLLM 与 SGLang 都活着,两个项目各自走向商业化(vLLM 团队成立 Inferact,SGLang 背后是 RadixArk),Consortium 只覆盖其一。闭源栈没死:TensorRT-LLM 在 NVIDIA 生态内仍是编译型高吞吐选项,企业端的闭源部署仍普遍。
所有数字的读法集中在这张表里:
| 数字 | 口径 | 归属 |
|---|---|---|
| Rubin 6× | 每 GPU 总吞吐含缓存输入 token,AgentX 负载,同等交互性;NVIDIA 代际对比(Vera Rubin 对 GB300) | Kapasi 演讲自报 |
| Meta >2× GPU 节省 | 大规模、多硬件验证 | Meta 自报,基准与验证细节未披露 |
| TTFT 中位 -60.3% | 多轮基准,P/D 场景 decode 侧复用;GLM-5.2-FP8,8×B300,32 对话×86 轮,160K 终局 | SGLang 官方博客基准 |
| 命中率 30%→95% | 生产案例,30K–200K 输入,PP+P/D+MTP | 讯飞团队自报 |
| 1,800 tok/s 单用户 | 1.8× stock 配方,推理精度不变 | S1 转述,报告方与模型均未具名 |
| 权重更新 53s→7.2s | 1T Kimi-K2 FP8,32+32 节点,CPU 副本约 32G/rank | SGLang 官方博客工程报告 |
| megakernel 2× | 解码,对照原 kernel 验证 | 技术分会披露 |
| 一周移植 | 两名工程师+AI,另一加速器,"within 1% of production performance"(参照系未展开) | 技术分会披露 |
| 500 天零回退 | 8 次大版本升级 | 单一生产团队经验 |
| MI355X 3.5× | agentic RL 优化序列后的吞吐 | workshop 演示,AMD 自报 |
| 332 组织 | 一年内从早期采用者增长 | 主办方自报 |
整合时代的效率数字,都是各阵营在公共栈上的自报或未具名转述。横向可比性不是自动来的,是口径纪律换来的。这张表就是本文的读数方式。
结语
最后收束成三条判断。
引擎从竞争壁垒变成公共设施。选「哪个引擎」的风险在下降,选「谁的硬件跑得好、谁的服务接得住」的权重在上升;竞争没有消失,下沉到了 kernel、互联与整机,上浮到了分发与企业服务。
agent 负载正在重写引擎架构。混合架构的多类状态、超出显存的长历史,把引擎的核心能力从单位时间吞吐扩展到状态管理:状态放哪、怎么复用、怎么跨层移动。这是 v1.0 押注的方向,也是接下来各家引擎真正比拼的地方。
AI 写引擎的飞轮已经开始转。多数合并 PR 由 agent 产出、AI kernel 进主线、一周级移植,这些是现状而不是预测;开源栈的进化速度本身,正在成为新的变量。
成立条件与观察点在第六节都给过了,包括 tracker 的落地节奏、第三方复测、各后端的生产规模,以及 AI 产出占比与安全审计节奏的匹配。两三年后回看,这场峰会大概率不是被记住为「两千人的首届大会」,而是被记住为引擎竞争换轴的起点——从吞吐到状态,从栈到硬件,从人写引擎到引擎自己参与写自己。