一、万亿参数与一台机器的落差
把 DeepSeek V4-Pro 装进一台机器,第一件事是一道算术题。这个模型总参数 1.6 万亿,每个 token 只激活 490 亿,但推理要读的是整个权重文件:按华为论文给出的量化方案,权重占用 865 GB。一张 H200 的显存是 141 GB,865 除以 141 约等于 6.1,单卡连六分之一的权重都放不下;八张拼成 1.13 TB,也只比需求多出三成余量,前提还是这 1.13 TB 一个字节都不挪作他用,KV 缓存和激活值都另算。换 Kimi K3 更局促:2.8 万亿参数、激活 1040 亿、权重 1560 GB,一台八卡机直接出局。连顶配 Mac Studio 的 512 GB 统一内存,都装不下 DSV4-Pro 权重的六成。
这道算术题在 2026 年越来越躲不开,因为开源模型的尺寸已经集体越过万亿线。DSV4-Pro、Kimi K3、Qwen3.8-2.4T,榜上前排清一色是稀疏激活的 MoE(Mixture of Experts,混合专家)架构:模型由许多个「专家」子网络组成,每个 token 经路由器只送往其中一小撮。于是三个数字解耦了:总参数量决定模型「知道多少」,激活参数量决定每个 token 的计算成本,权重文件的体积跟着总参数走。模型可以在知识量上继续变大,每个 token 的计算成本却不必等比例上涨。斜率还在变陡:Kimi K3 用原生 MXFP4(4 比特微缩浮点)量化感知训练,做到官方所说的「首个开放 3T 级模型」;Qwen3.8 的激活参数约 95B,对 2.4T 总参的比值按官方数字推算已掉到 4% 一线。算力需求和内存需求的差距逐年拉开,内存先成为瓶颈。
业界的主流答案是拆,把模型拆到集群上。专家并行(Expert Parallelism)把不同专家放到不同 GPU;预填充(一次读入整段提示)与解码(逐 token 生成)分离,把两个阶段放到各自适合的机器上;再用足够大的请求池,摊薄「整个模型常驻内存」的成本。这条路有一个不太被明说的前提:并发请求足够多,多到值得用一整个集群的内存带宽去换吞吐。
但有一类负载天然不符合这个前提。企业内部的 agent 工作台,同时活跃的会话常常只有个位数;主权推理部署要的是模型留在自己的机房里;本地评测场景要的是随取随用。这三类场景的共同点是并发低、轮次多、上下文长。为一到八个并发去搭一个集群,成本账算不过来——机器绝大多数时间在为不存在的并发付电费和折旧。
于是问题具体起来:如果就是要把万亿参数模型塞进一台机器,这台机器的内存应该怎么配?
华为 9 月 14 日提交到 arXiv 的论文《Trillion-Parameter MoE in a Box: Decoupling Memory Provisioning with High-Bandwidth Flash》回答的就是这个配置问题。先把论文做的事交代清楚,再看结论:
- 研究对象:DSV4-Pro 与 Kimi K3 两个开源万亿参数 MoE;负载画像来自算子分析、实测专家路由 trace(每个 token 实际访问了哪些专家的记录),以及三条多轮 agent 服务 trace;
- 实验方法:在 LLMServingSim 2.0 仿真器上回放负载,扫描内存配置的两个关键维度:状态层带宽与 HBF 对主机的开放带宽,达标线是完成时间不超过参考配置的 1.10 倍;
- 产出:两个可以直接写进采购清单的结论。状态层用商用内存条就够;HBF 对主机只需开放约四分之一的内部带宽;
- 适用范围:这是一项设计空间探索研究,回答的是「2027 年的设备应该怎么配」,实测表现要等真机。
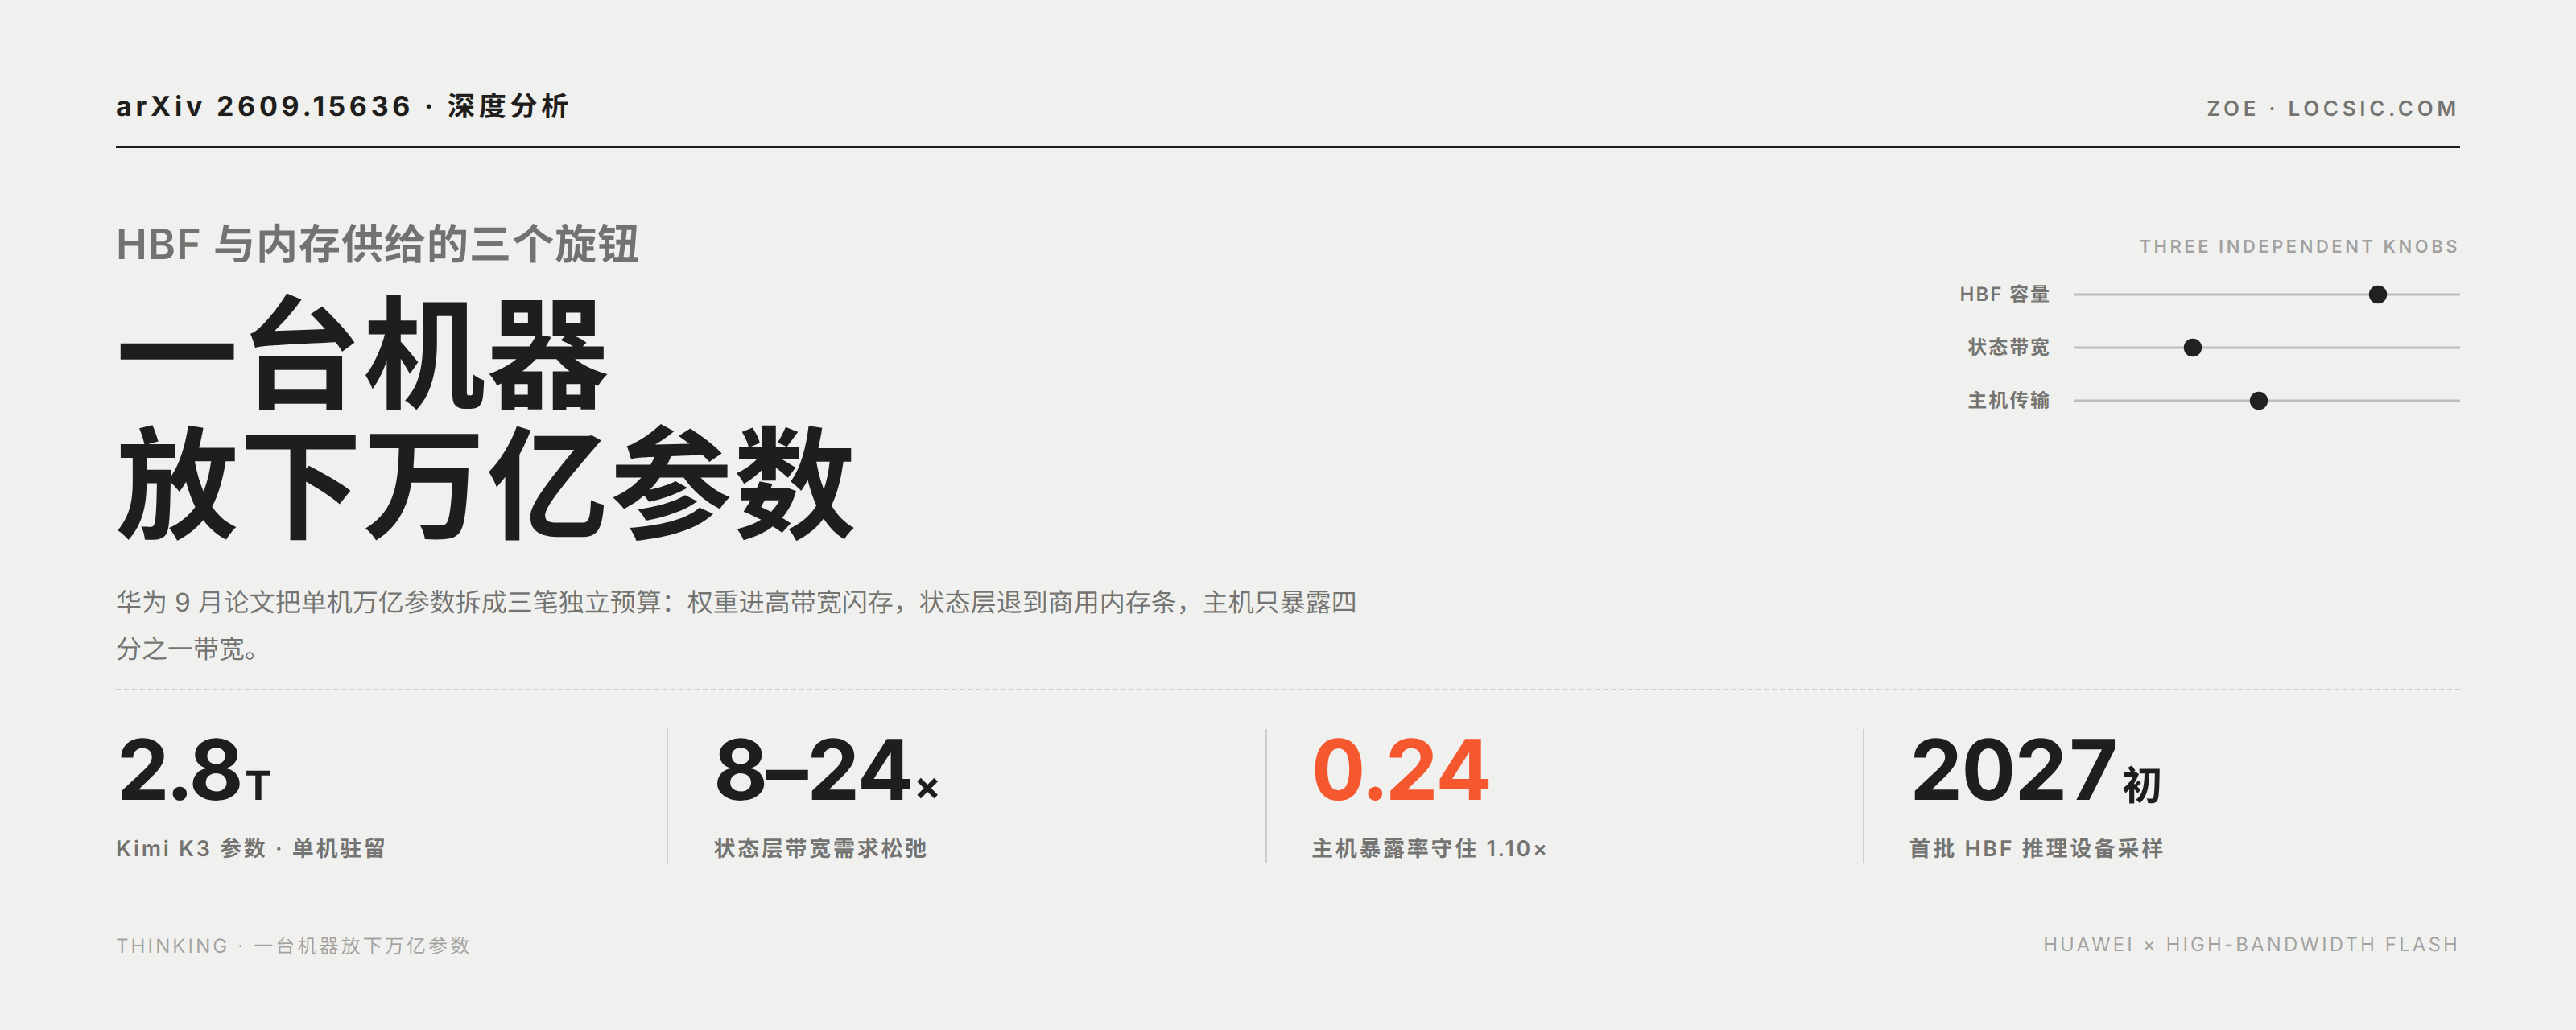
论文的核心结论可以先一句话说完:一旦权重搬进高带宽闪存(High-Bandwidth Flash,HBF),「内存」这个词就分裂成三笔互相独立的预算,每一笔都可以单独配到最便宜的位置上。单机万亿参数,剩下的是配置算术。
二、HBF:把 NAND 装进处理器封装
要理解三个旋钮为什么拆得开,得先认识 HBF 这个新介质。
HBF 的想法一句话能说清:把 NAND 闪存按 HBM 的方式堆叠,装进处理器封装。这里有两个词要拆开。NAND 闪存是 SSD 和手机存储的基本介质,密度高、掉电不丢数据,但访问延迟也高。HBM(High Bandwidth Memory,高带宽内存)是今天 GPU 旁边带宽最高的内存:多层 DRAM 裸片与逻辑层堆叠在一起,通过硅中介层(一块替多颗芯片承载互连走线的硅基板)与计算芯片并排封装,带宽以 TB/s 计。传统 SSD 的瓶颈出在通道上:颗粒要隔着 PCIe 总线和主控芯片才能到 CPU,跑出十几 GB/s 已经是极限,NAND 本身的潜力被这条路卡住了。HBF 把这条通道拆掉了:多层 NAND 裸片叠在一个逻辑基底裸片上,通过 UCIe(Universal Chiplet Interconnect Express,通用芯粒互联标准)接口直连处理器,靠裸片内和裸片间的海量并行,把读带宽顶到 TB/s 量级。
Sandisk 的第一代产品按官方数字是每裸片 256 Gb、16 裸片单栈 512 GB、读带宽 1.6 TB/s,物理占位与功率曲线紧贴 HBM4;路线图上第二代奔 1 TB 栈和 2 TB/s,第三代 1.5 TB 和 3.2 TB/s。这些数字目前全部来自厂商内部测试与仿真,没有第三方验证;这个限定后文还会反复出现。
这个介质有一个天然的分工特征:读快写慢。写入不仅慢,还消耗闪存寿命,SK hynix 论文给出的量级是约十万次写入循环。它适合装「写一次、读很多次」的数据,而推理负载里恰好有一块巨大的只读数据:模型权重。Hot Chips 2026 的一场报告给出过比例(HBFSim 论文转述):一个万亿参数模型大约 93% 的字节是 MoE 专家权重。介质特征与负载特征在这里对上了:HBF 像是为权重这类数据定制的仓库。
标准化推进得出奇地快。Sandisk 在 2025 年 7 月发布第一份技术简介;2026 年 2 月 25 日与 SK hynix 在 Open Compute Project(OCP,开放计算项目,数据中心硬件开放标准组织)内启动专项工作组;半年不到的 8 月 3 日,第一版 HBF 高层基底裸片规范 v0.7.0 挂上 OCP 文档库。规范定了两件事:堆叠规格为 8-high 与 16-high 两种,容量上限 512 GB;带宽分 Grade1 到 Grade3 三档,从约 0.4 到 3.0 TB/s。互连采用 UCIe,规范另附电气特性、堆叠封装可靠性和软件读写指南。这是存储行业第一次把 NAND 以封装内标准接口的形式接进处理器。按厂商路线图,HBF 内存样品 2026 年下半年出,第一批使用 HBF 的推理设备 2027 年初采样。
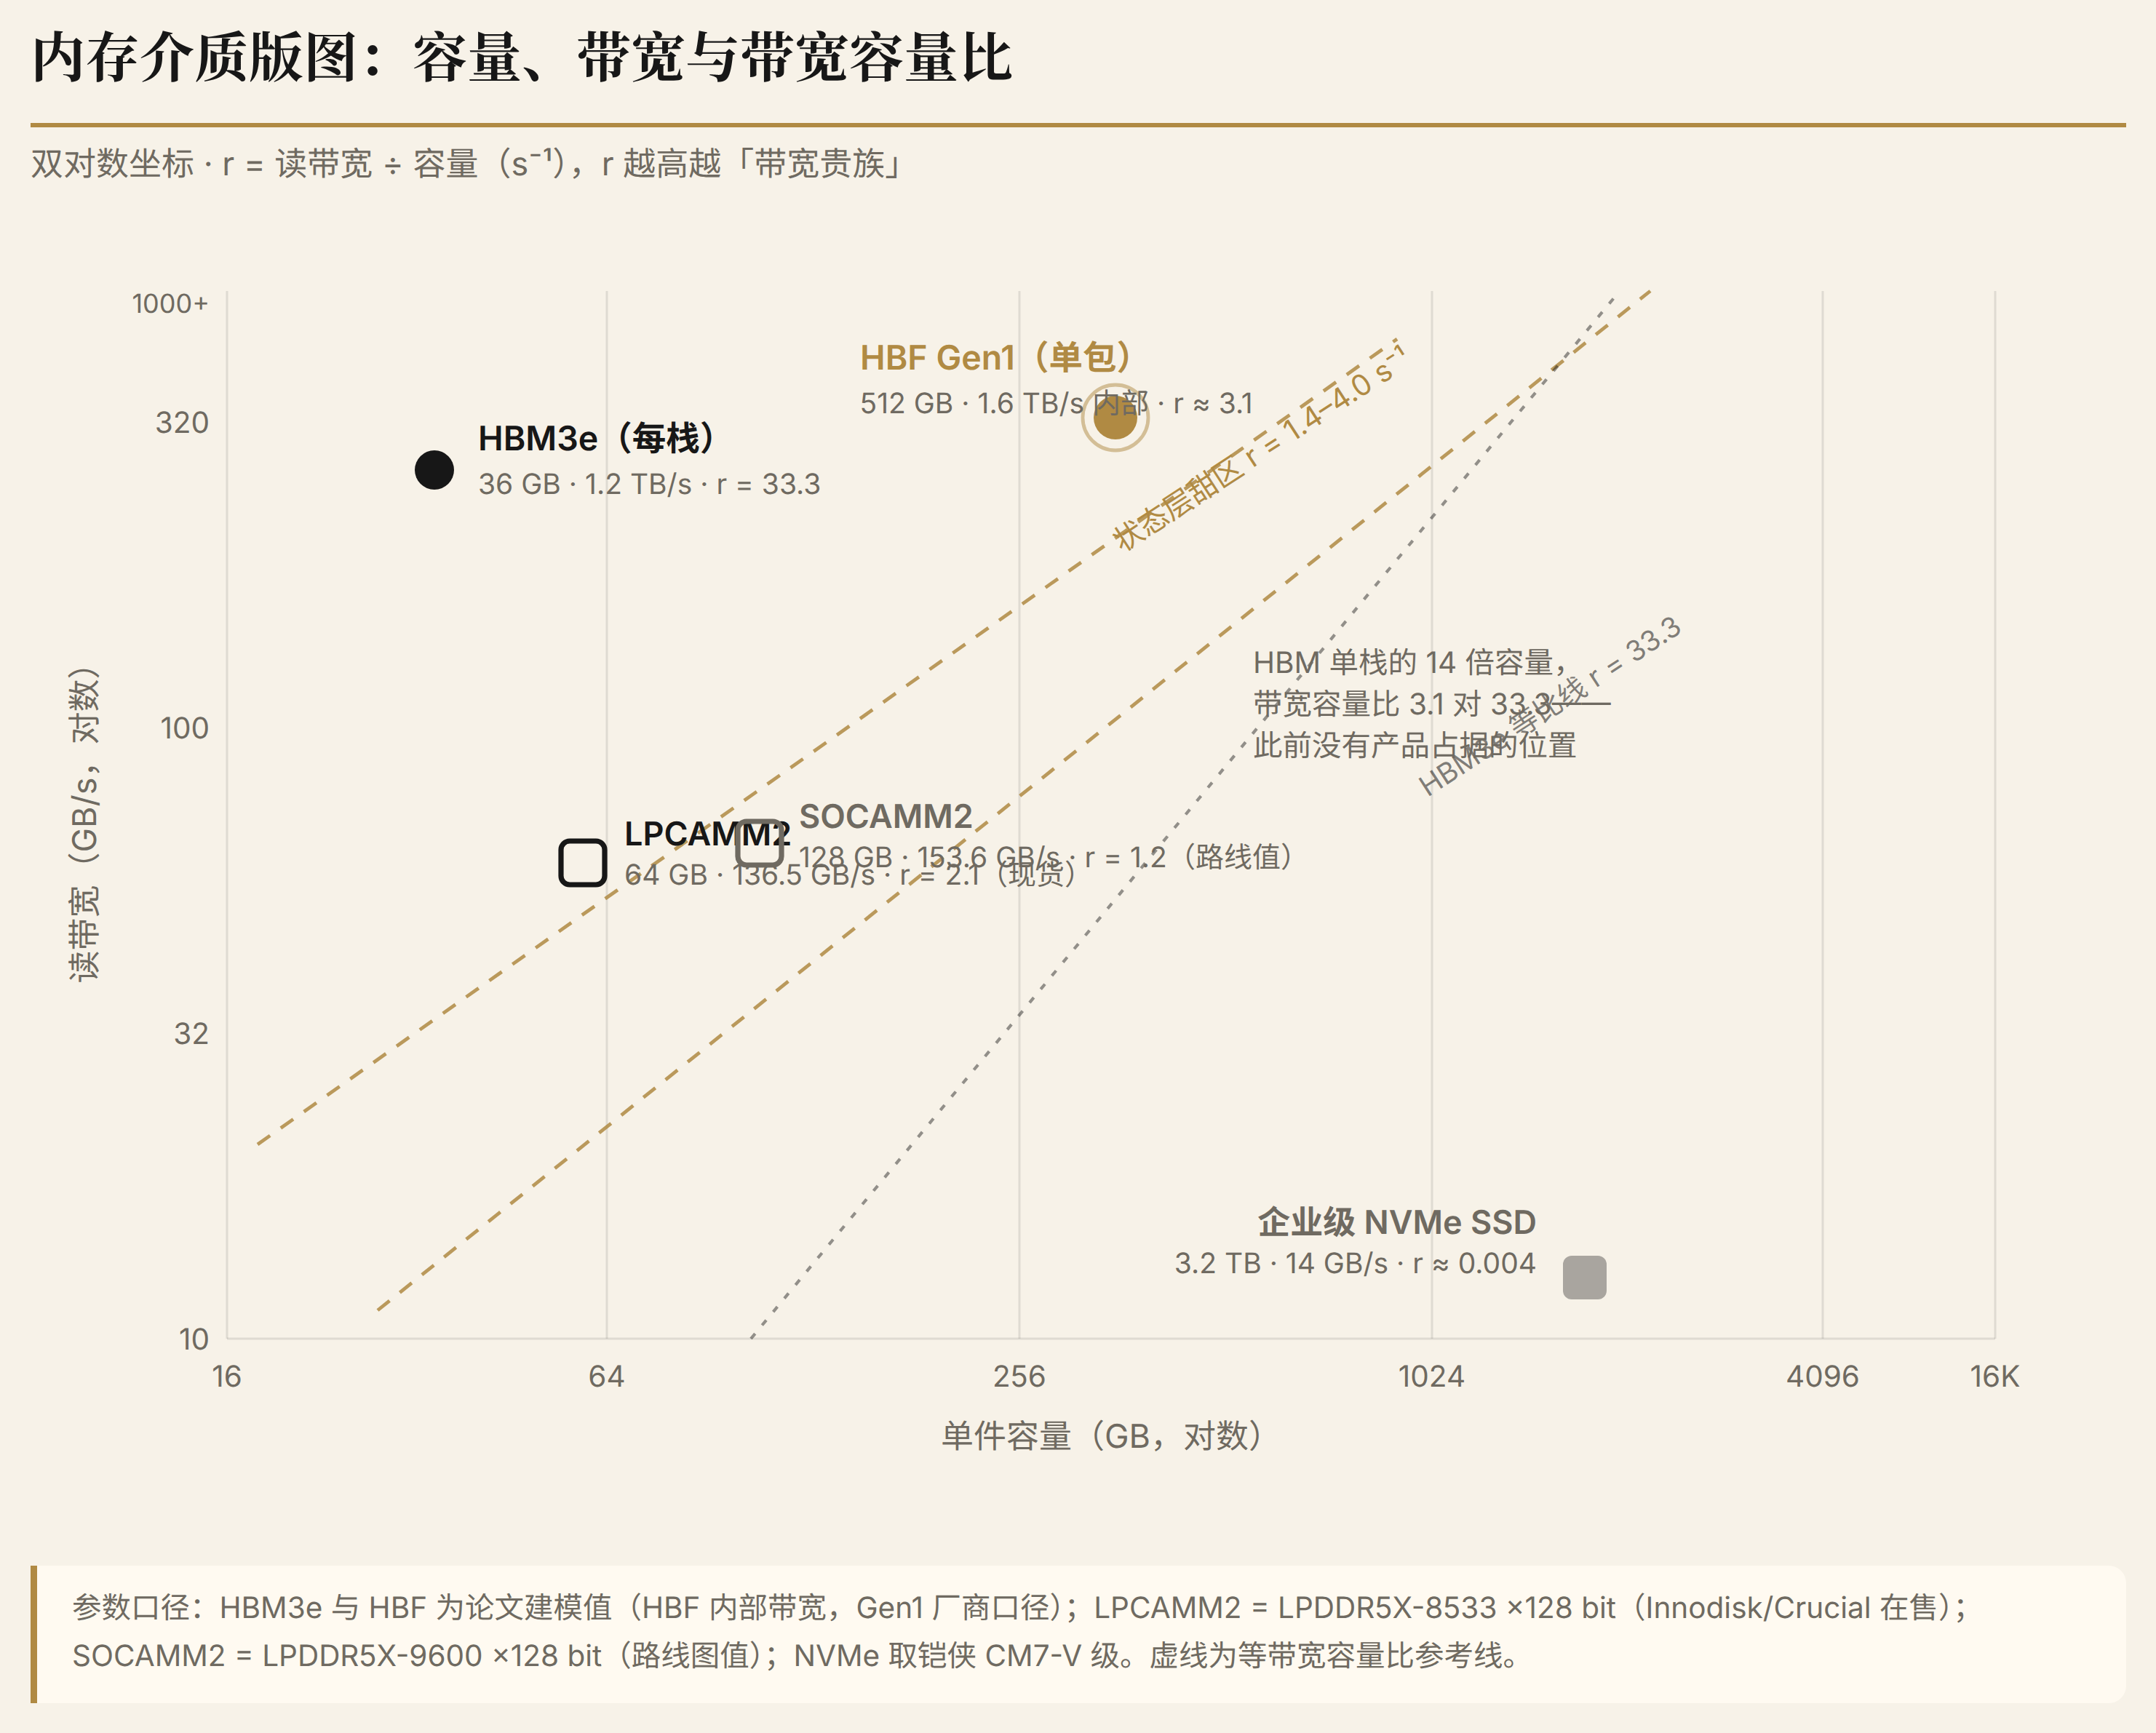
把几种内存介质放到同一张坐标图上,位置关系一目了然。HBM3e 每栈 36 GB、1.2 TB/s,带宽容量比(带宽除以容量,衡量每一 GB 容量配了多少带宽)是 33.3 s⁻¹;HBF 单包 512 GB、内部读带宽 1.6 TB/s,容量是 HBM 单栈的 14 倍(512 对 36),带宽容量比掉到十分之一以下,约 3.1 对 33.3 s⁻¹;LPCAMM2 是已经上市的商用内存条形态,64 GB、136.5 GB/s,这个数字恰好等于 LPDDR5X-8533 乘 128 位总线(8533 MT/s × 16 字节;MT/s 即每秒百万次传输);SOCAMM2 是同族里面向服务器的内存条形态,单条容量更大,按 9600 MT/s 的路线值折算 153.6 GB/s。最右边是 NVMe SSD,容量随便堆,带宽停留在十几 GB/s。HBF 填的是一个此前没有产品占据的位置:接近 HBM 的读带宽,加上 NAND 的容量和成本结构。
三、把「内存」拆成三个旋钮
传统推理节点把所有东西装进一种介质:权重、KV 缓存、激活值、运行时状态,全在 HBM 里。KV(key-value,键值)缓存是模型为已处理 token 保存的中间结果,长对话靠它避免重复计算,代价是体积随上下文长度持续增长。这种单一介质的配置只有一个旋钮:容量和带宽被同一种介质的物理特性绑死。模型变大就要更多 HBM;更多 HBM 顺带带来更多带宽,但带宽未必用得上;HBM 堆到单卡上限,就得加卡、加机器、加网络。每一步都在为用不上的带宽付钱。产业侧对此早有判断:「内存与互连已经取代算力,成为推理硬件的主要矛盾」。这个判断有权威背书:David Patterson 与 Xiaoyu Ma 今年 5 月在 IEEE Computer 上为推理硬件的研究方向排序,四个方向里 HBF 排在第一位,定位一句话:10 倍容量、HBM 级带宽。华为论文在这个共识之上往前走了一步,重新描述问题本身。
论文的负载分析说明这个耦合可以拆开,因为三类数据在机器里的伸缩行为完全不同。
第一类是权重。它的规模跟着模型走,与并发数几乎无关:论文测算,并发 8 的时候权重占总驻留数据的 95.9%(DSV4-Pro)和 87.1%(Kimi K3)。TB 级的容量需求几乎全部由权重贡献,这正是 HBF 的用武之地:要容量、读得多、写得少。
第二类是运行时状态,主体是 KV 缓存,它跟着上下文长度和并发数走。一条 100 万 token 的序列,DSV4-Pro 占 4.66 GB,Kimi K3 因为注意力组织方式不同占 28.99 GB;按更重的那个数算,Kimi K3 的八个并发合计约 232 GB,加上服务开销,256 GB 是状态层容量的合理下限。跟权重比这是一个小数字,而且它住 DRAM 就够。为什么够,第四节用数字回答。
第三类是激活专家流量,它跟着路由行为走。论文用 SPEED-Bench 代码会话的实测路由 trace 给了一个关键数字:16 个有效 token 平均激活 51.6 个专家,其中 57.8% 的被激活专家只收到 1 个 token。这个数字解释了 MoE 解码的带宽困境:一次路由把某个专家的权重从存储里读出来,往往只为一两个 token 服务,复用率极低,解码阶段因此对权重供给的延迟高度敏感。HBF 内部带宽有多少要对主机开放、封装引脚要铺多宽,都由这条流量决定。
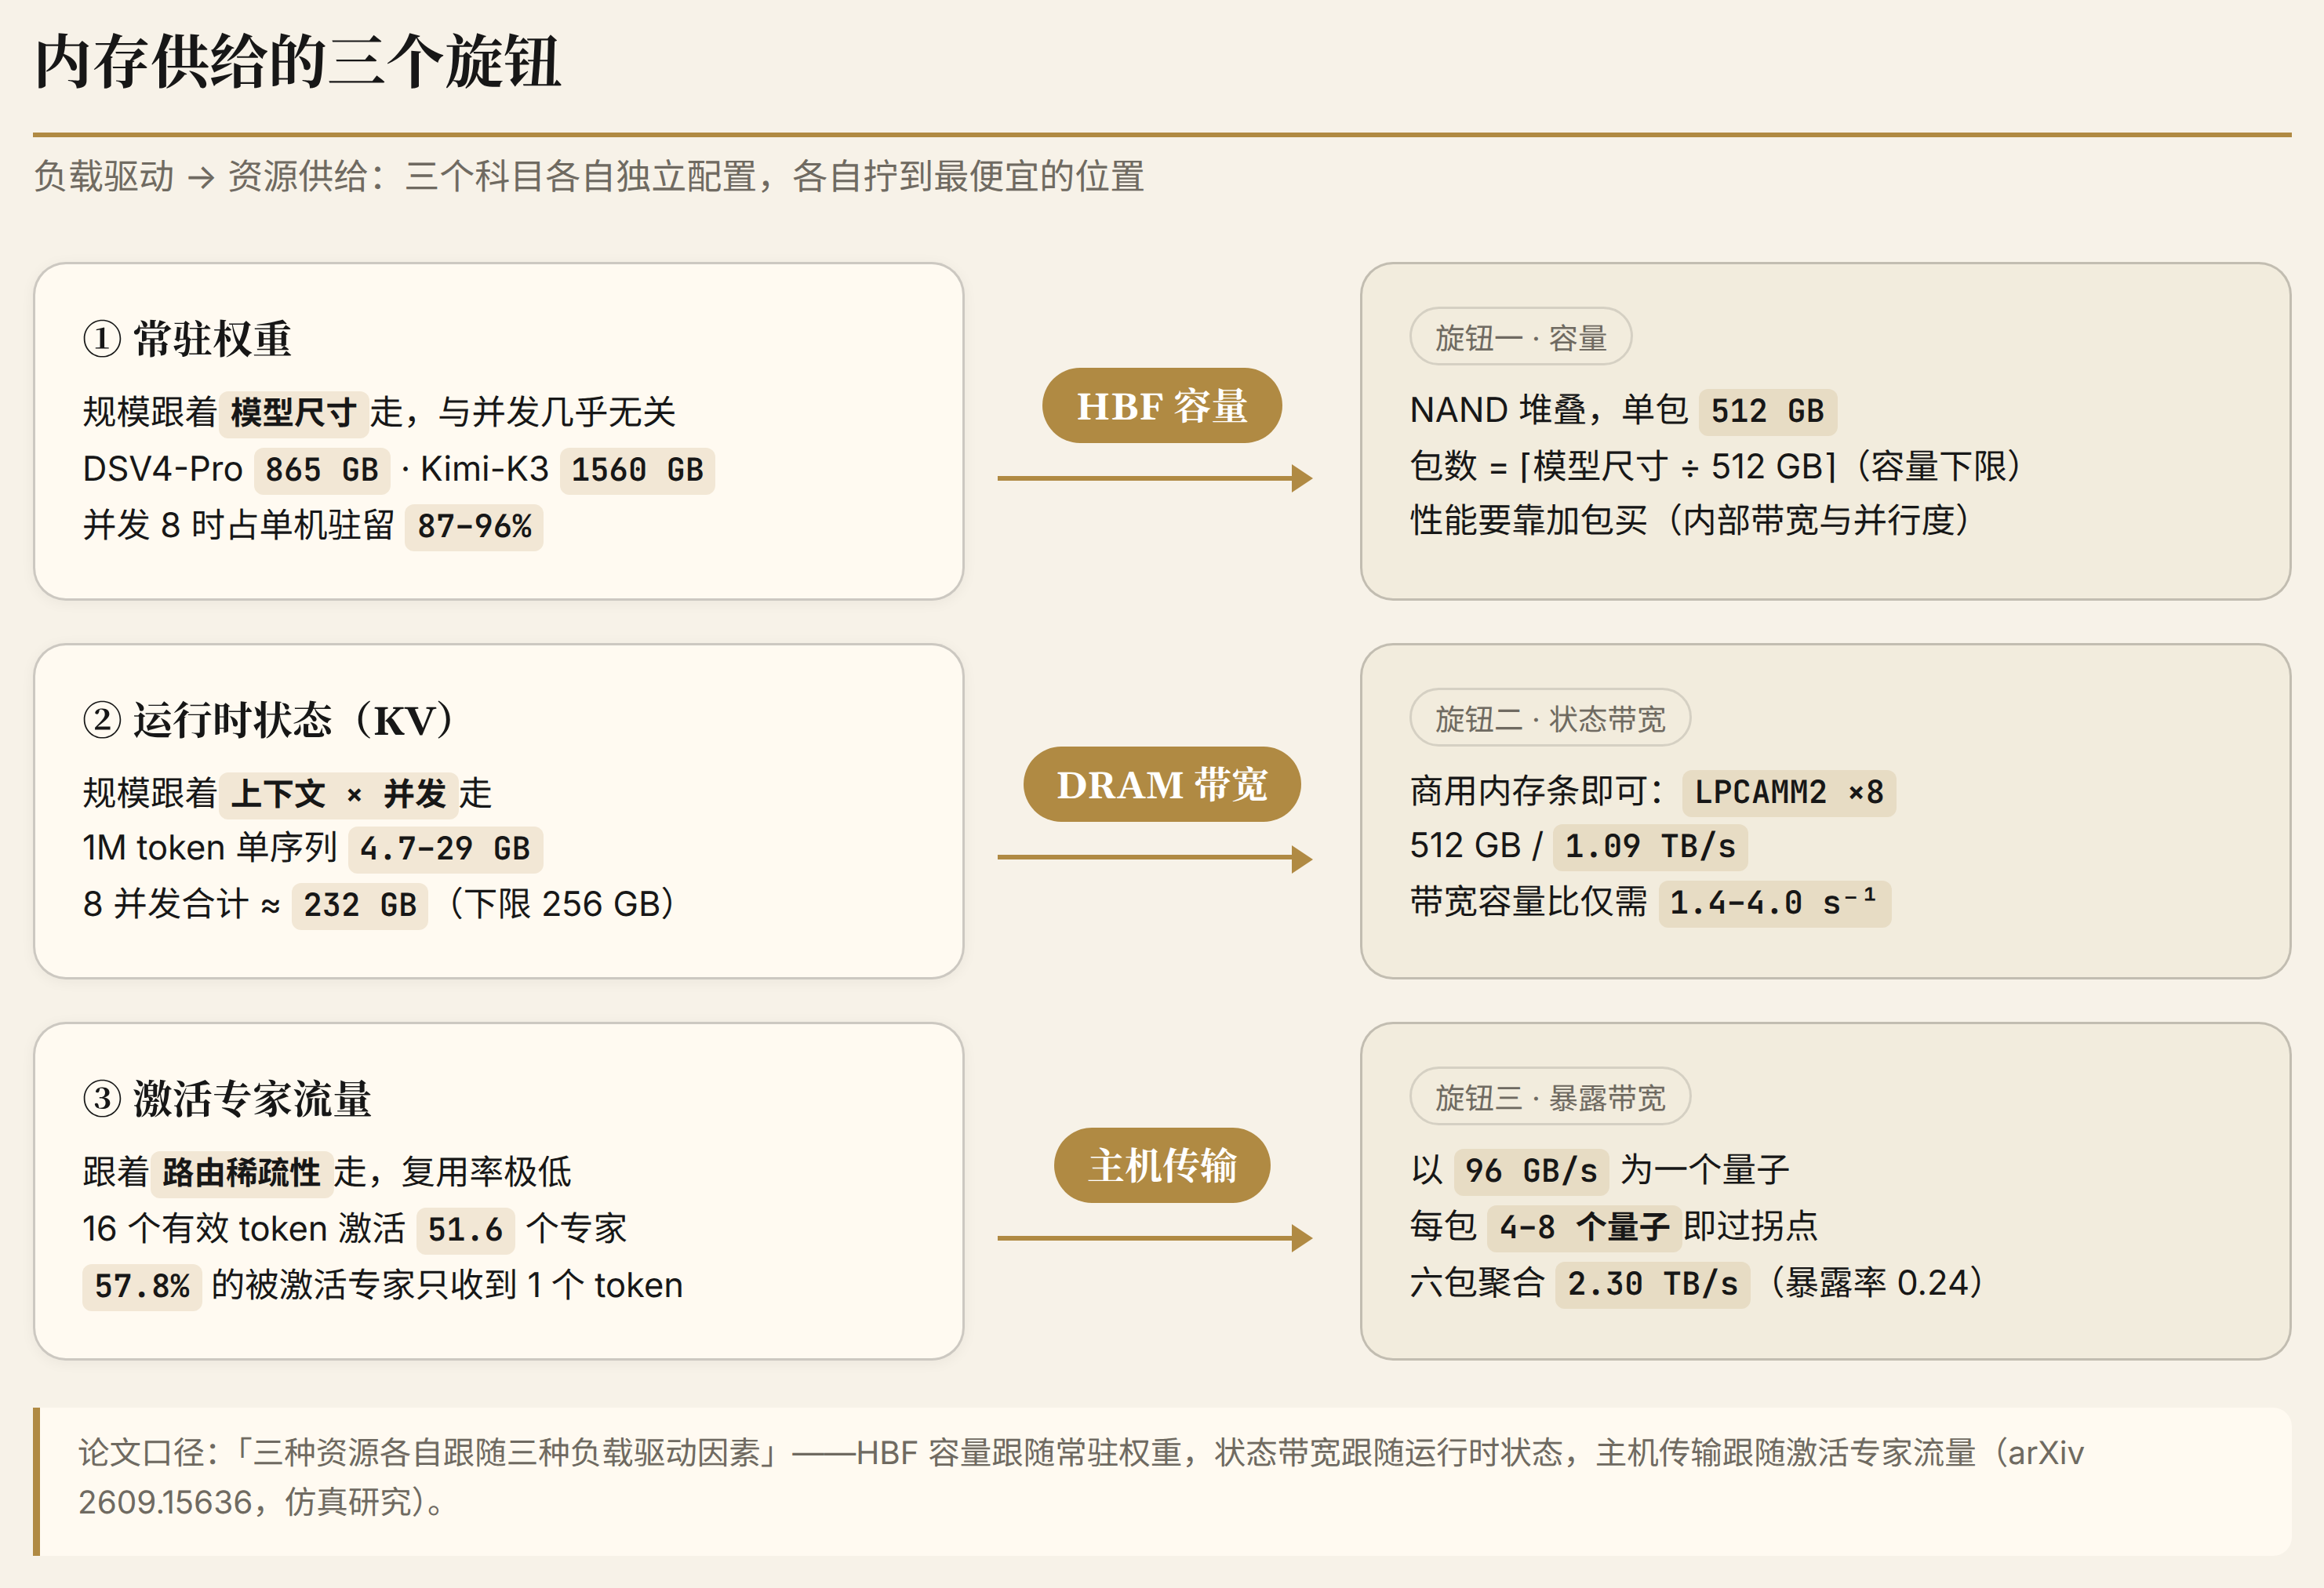
于是内存供给从一个旋钮变成三个:HBF 容量跟着常驻权重走,DRAM 带宽跟着运行时状态走,主机传输跟着激活专家流量走。论文结论部分的原话是,三种资源各自跟随三种负载驱动因素。把内存拆开本身不算新想法,新的是接下来的量化:三个旋钮各自需要拧到多大,以及它们之间到底有多独立。
进入数字之前,把实验设置交代清楚。负载在 LLMServingSim 2.0 仿真器上回放,这是一个用真实 trace 驱动内存系统模型的事件驱动仿真器,全程没有真机参与;计算能力固定为每裸片 450 TFLOP/s 的 FP8(8 比特浮点,当前推理加速的常用精度)吞吐;HBF 的器件参数取自 OCP 规范和 FlashAccel 论文的建模;三条 agent trace 的具体来源论文没有说明。换句话说,下文所有拐点都是仿真结果,可信度取决于这三层建模离真实有多近,最终裁决权在真机。
四、两个答案:商用内存条,和四分之一的暴露带宽
论文的评价框架以完成时间为纲,做法分三步。第一步,让一整段多轮对话在给定内存配置下跑完,记录完成时间。第二步,与一个状态层带宽打满的参考配置对比,允许 10% 的退化,也就是完成时间不超过参考配置的 1.10 倍,这条线后文称 1.10× 等值线。第三步,在达标线下扫描两个维度:DRAM 带宽,与每包 HBF 对主机的暴露带宽,找出资源最省的组合。
结果呈现为一个 L 形:完成时间只在两个资源各自进入严重饥饿区时才急剧恶化。把 DRAM 带宽堆到 9.6 TB/s,救不了只开一档传输的 HBF;把 HBF 主机接口开满,也救不了 0.14 TB/s 的状态层。论文自己的措辞是 largely orthogonal(基本正交):一旦某个资源离开饥饿区,继续加码对另一个拐点几乎没有影响。配置的目标就是找到 L 形拐角的左下角,用最少的资源站进 1.10× 线内。
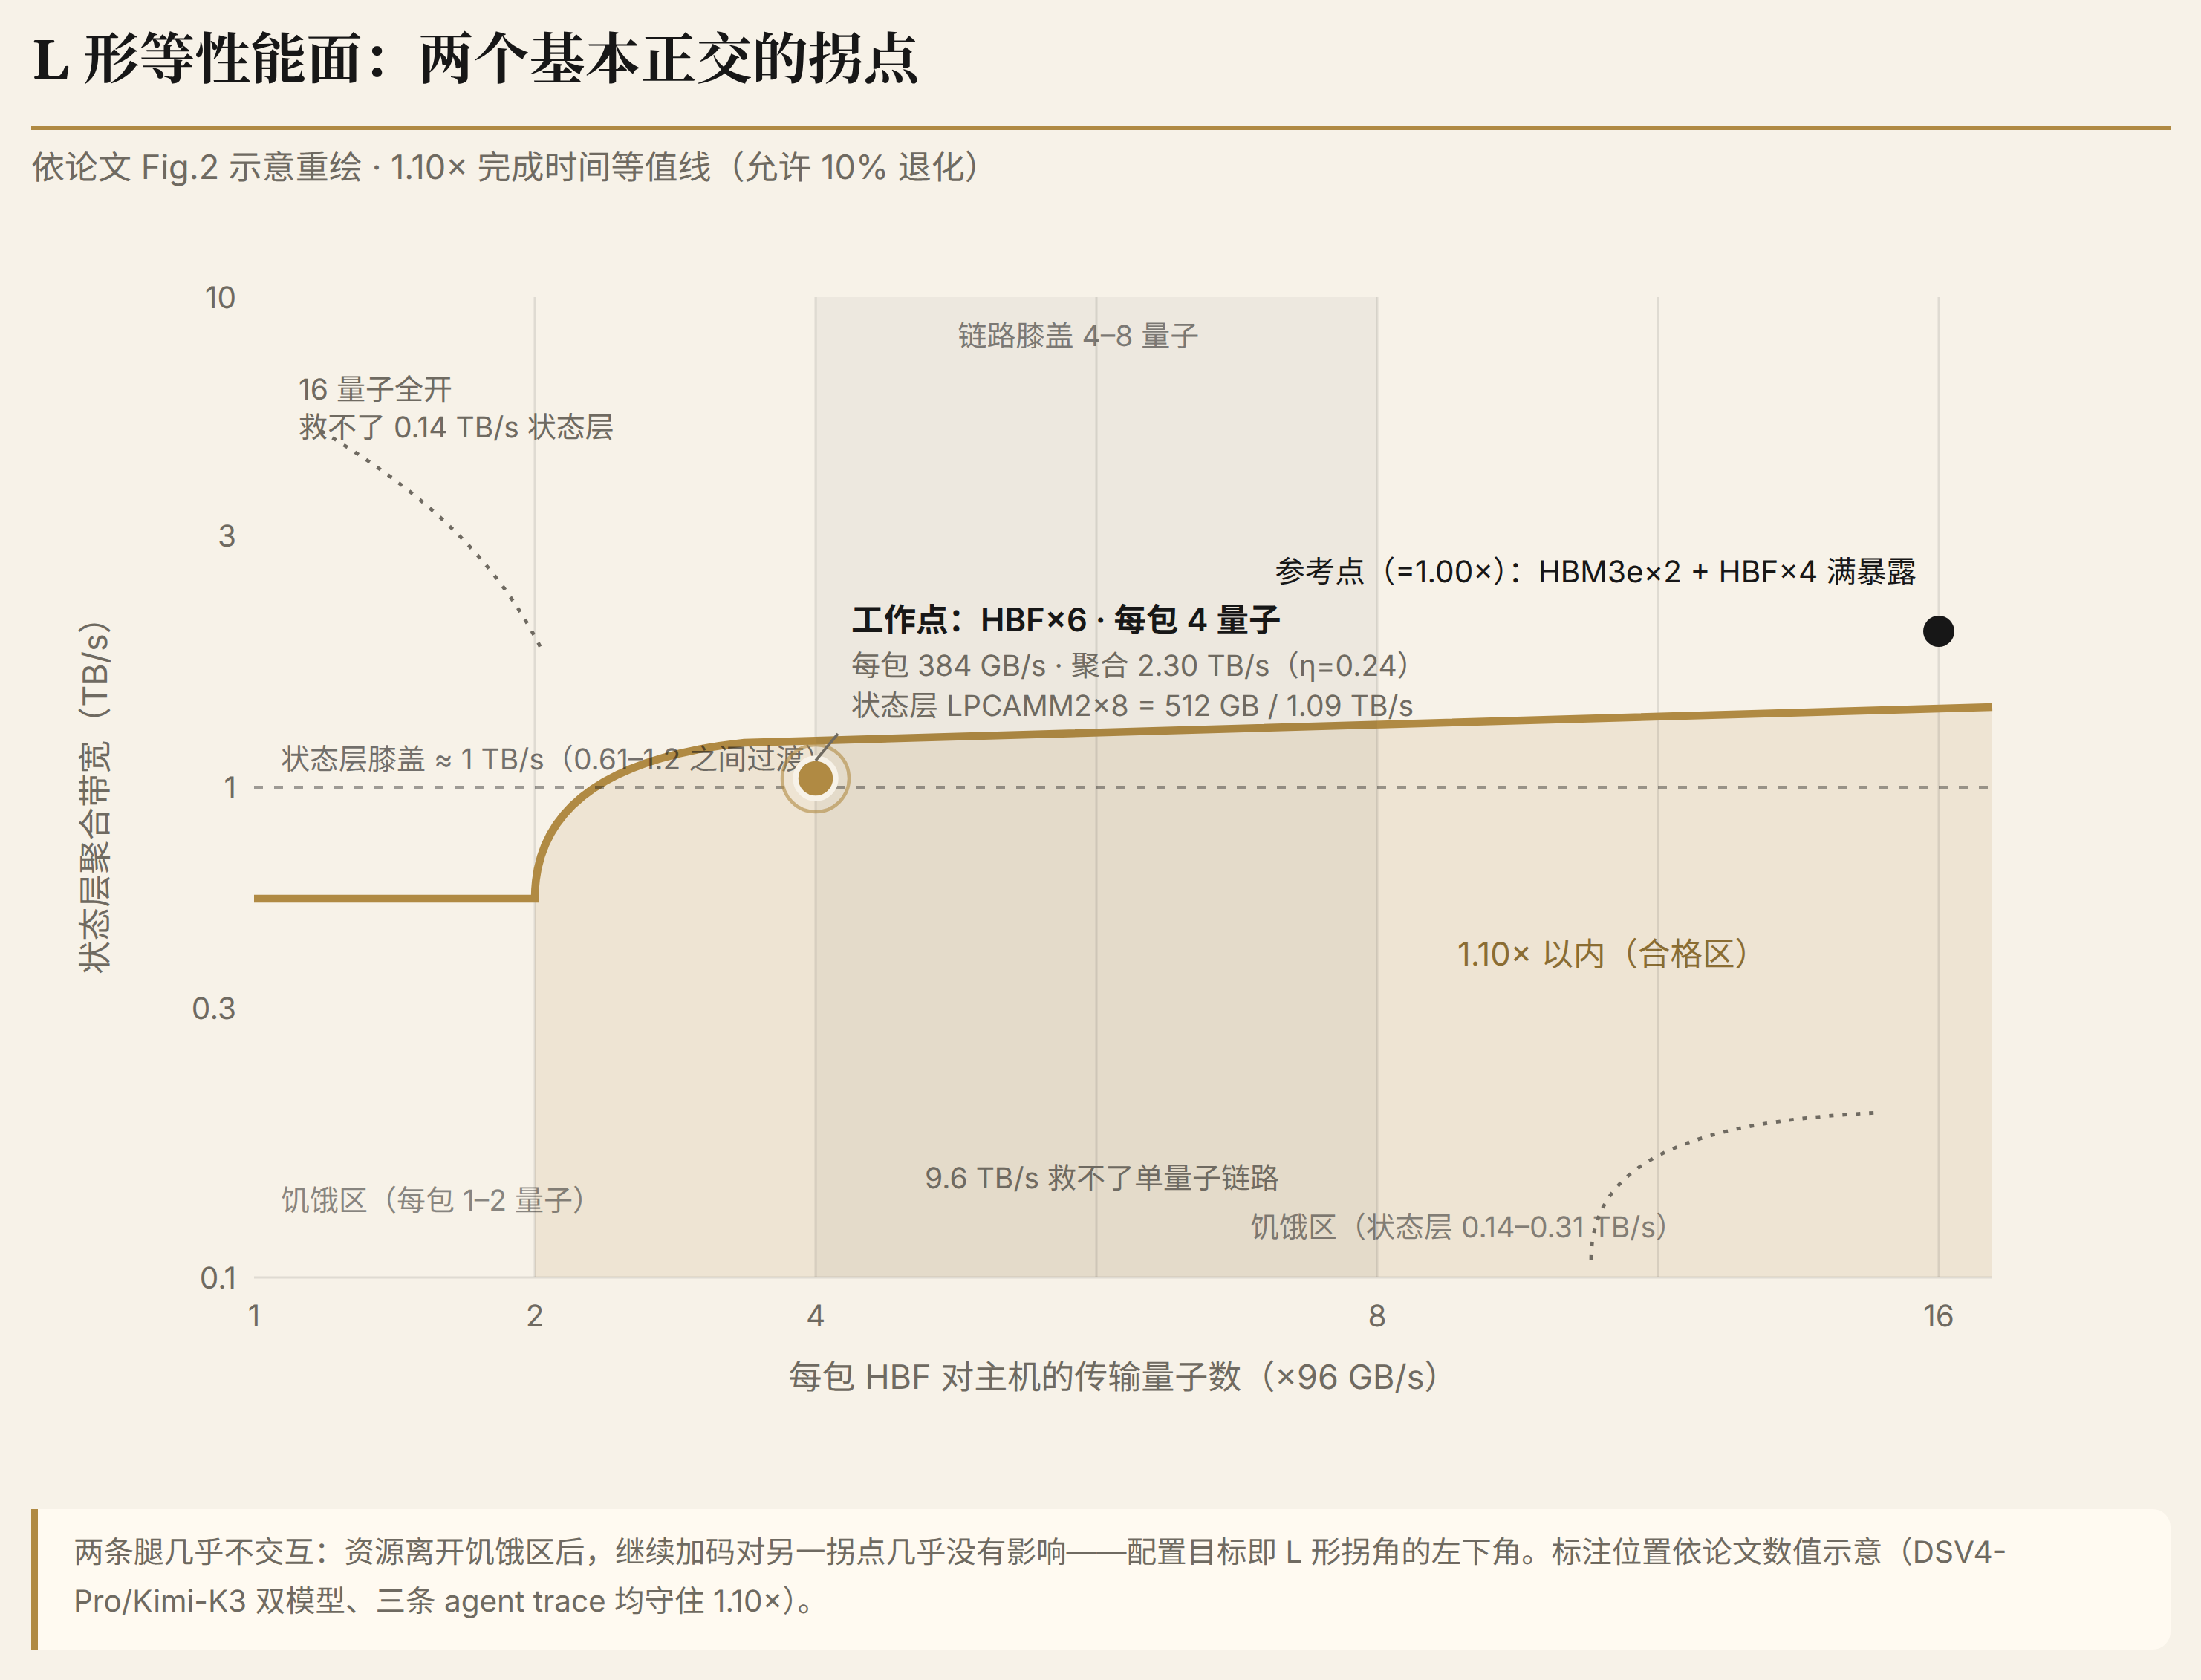
第一个答案关于状态层:权重搬走之后,商用内存条就够了。 在 256 GB 容量下限上,守住 1.10× 目标需要的 DRAM 带宽容量比只有 4.0 s⁻¹(DSV4-Pro)和 1.4 s⁻¹(Kimi K3),而 HBM3e 的这个比值是 33.3 s⁻¹——松弛了 8 到 24 倍。把 4.0 s⁻¹ 乘回 256 GB 的容量下限,DSV4-Pro 需要的状态层带宽约 1.02 TB/s;落到采购上,论文的配置是八根 LPCAMM2,512 GB、合计 1.09 TB/s,刚好越过这条线。Kimi K3 的要求更低,四根 LPCAMM2 就已达到。同场竞技的 SOCAMM2 反而出局:它的带宽容量比只有 1.20 s⁻¹,撑不起 DSV4-Pro 的 4.0,论文仿真里两根 128 GB 的配置完成时间约为参考配置的 1.5 倍,明显越出 1.10× 达标线。状态层从此退出先进封装的竞争,从计算裸片的封装内资源变成板级资源。这是一次身份降级,也是一次降价。
第二个答案关于 HBF 对主机的暴露:四分之一就够了。 HBF 单包内部读带宽 1.6 TB/s,直觉上应该尽量多开放给主机,既然内部有这个带宽,为什么不通出来?论文的数字说不用。主机链路以 96 GB/s 为一档,这是每包暴露带宽的最小步进;拐点落在每包 4 到 8 档:六个 HBF 包各暴露 4 档,每包 384 GB/s(4 × 96)、聚合 2.30 TB/s(6 × 384)。作对比的满暴露参考是 6.14 TB/s,即 64 档 × 96 GB/s 的满链路聚合;2.30 对 6.14,低 62.5%,两个模型在全部三条 trace 上仍守住 1.10×。这个配置的暴露率是 0.24,算的是每包 384 GB/s 对 1.6 TB/s 内部带宽,四分之一多一点;它与 62.5% 是两个层次的比,一个对单包内部带宽,一个对满链路聚合。
第三个旋钮(容量)不在扫描之列,它由模型尺寸直接锁定;但包数怎么花有讲究。同样是用满 64 档主机链路,有两条路:HBF×4 每包开满 16 档,或 HBF×8 每包开 8 档(4×16×96 与 8×8×96 都等于 6,144 GB/s)。在解码最重的 trace 上,后者比前者快一成。差别在包内:包更多,裸片与 plane(闪存内可并行读写的单元)的并行度就更高,内部带宽池更大,还可选配近数据计算,这些是链路加宽换不来的。容量按模型尺寸配是下限,性能要靠包数买。
HBF 到宿主的带宽怎么配,正在成为 HBF 系统设计里的一等问题,学术侧有独立旁证:KAIST 的 DASH 架构为 HBF 权重开两条投递路径,直连 GPU 与经 HBM 基底裸片中转,按专家粒度分配路由,代表性负载的吞吐 1.94 倍于纯中转设计。华为调暴露度,KAIST 开双路径,调节的是同一个变量:权重从存储到计算的路怎么走最划算。
两个答案合起来,指向一个工程上很值钱的结论。状态层走板级 LPCAMM2,HBF 只需部分暴露,每包链路宽度随包数增加继续下降,于是主机接口的带宽密度不必随 HBF 容量等比扩张。论文据此指出,UCIe-S 标准封装路径(有机基板)成为可行选项,不再必须依赖 UCIe-A 级先进封装(两者都是 UCIe 的物理实现档次,S 走传统有机基板,A 要上硅中介层或再分布层)。这台机器最贵的三样东西就此各自落位:NAND 容量按闪存的价、状态带宽按商用内存条的价、封装按有机基板的价。
五、反方划出的是同一块地
HBF 有认真的反对者,而且功课做得相当扎实。
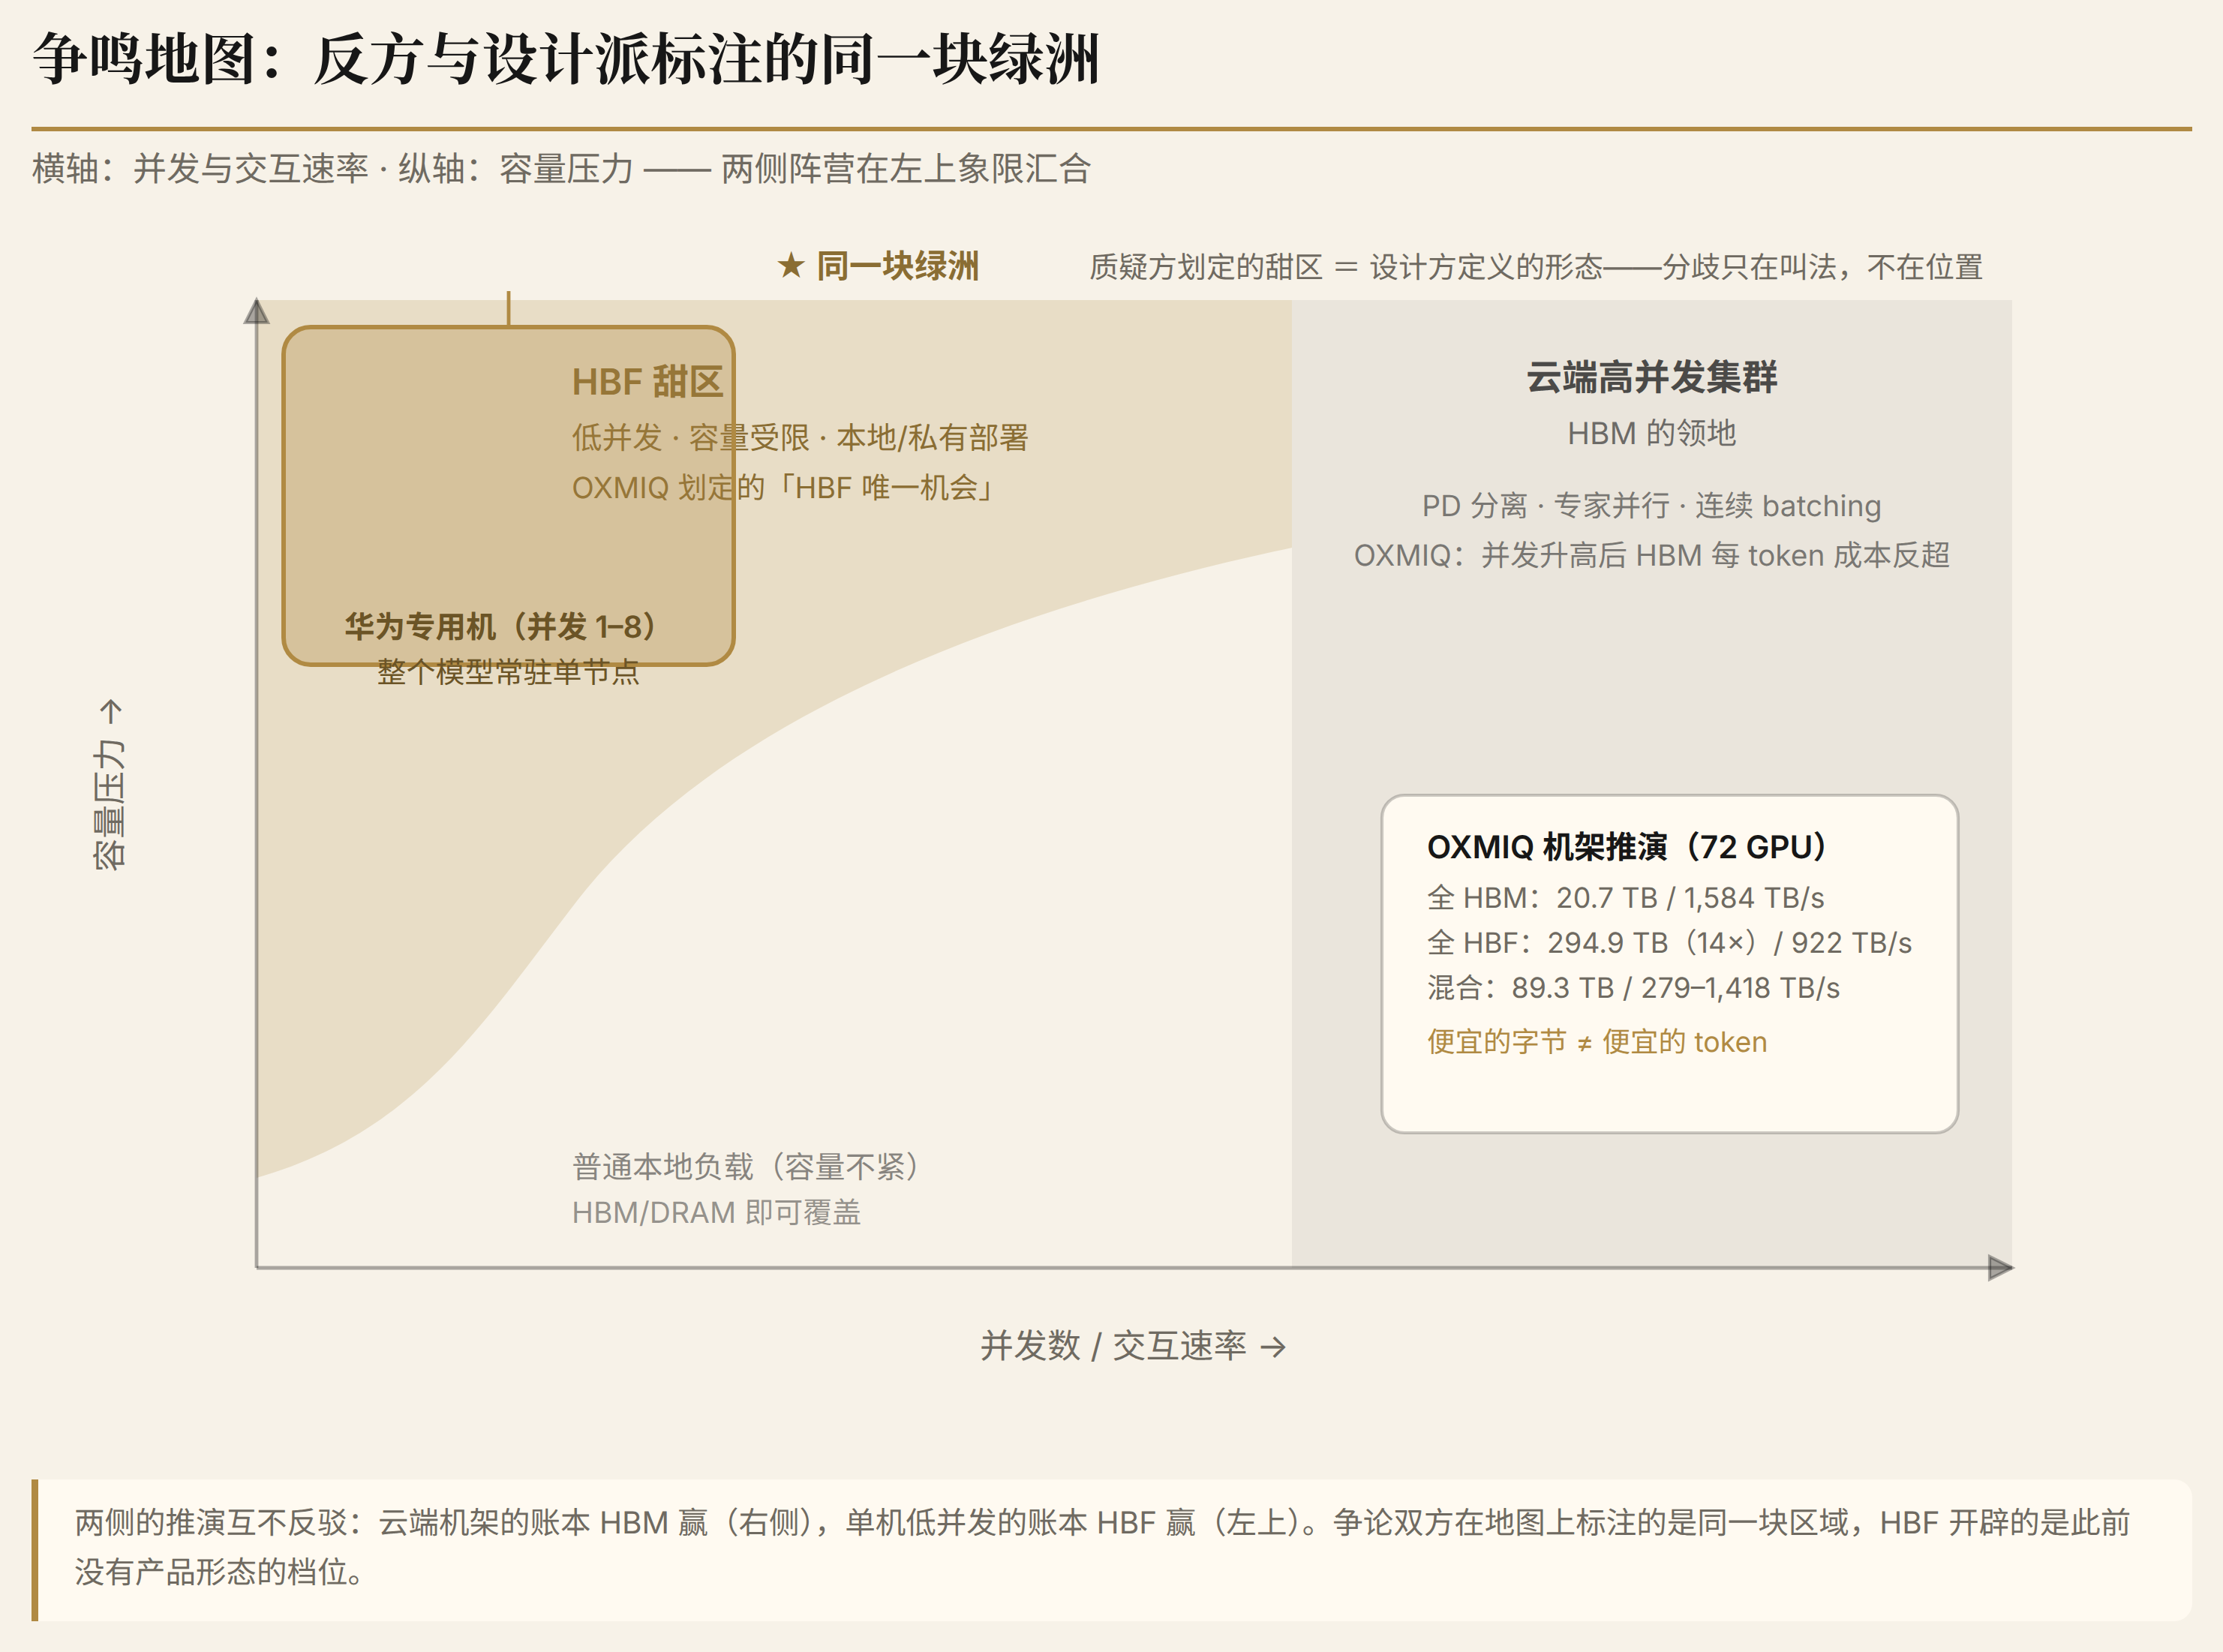
GPU IP 公司 OXMIQ 在 Hot Chips 2026 上做了一场专门的 HBF 适用性分析,结论被媒体概括成一句扫兴的判断:HBF 无法在绝大多数负载里替代 HBM。它的算账方式是拿一个 72 GPU 机架跑万亿参数模型(FP4,4 比特浮点量化),在成本与功耗相同的基准下对比三种配置:全 HBM 提供 20.7 TB 内存和 1,584 TB/s 聚合带宽;全 HBF 容量暴涨 14 倍到 294.9 TB,带宽掉到 922 TB/s;混合配置居中,带宽随负载在 279 到 1,418 TB/s 间浮动。OXMIQ 的推演显示,并发用户一多、交互速度一快,HBM 机架的单位 token 成本优势就开始反超,因为那时系统卡在带宽上,而 HBF 的容量大量闲置。便宜的字节不等于便宜的 token。
单看这场分析,HBF 的处境很尴尬。但把 OXMIQ 划出的甜区放到地图上看,事情变得有意思:它给 HBF 划出的适用场景,是并发低、容量受限、小规模的本地或企业私有部署,大机架被明确排除在外。而华为论文定义的专用机形态,并发 1 到 8。
这是同一块地。质疑方和设计方在地图上标注的是同一片区域,分歧只在叫法:一边叫「HBF 唯一的机会」,一边叫「HBF 边界之外的广阔天地」。
产业分析之外,学术侧的争鸣更细,五篇论文各有各的批评轴,逐条看过去。
火力最猛的是标题就带问号的《HBF Sucks?》。作者拿四条两小时的阿里云百炼生产 trace 驱动扩展版 TokenSim,把 HBF 当 SSD 塞进 Mooncake 式 KV 卸载栈(热数据留内存、冷数据下沉到便宜存储层的分层方案)做全栈表征,结论是负优化:更快的设备做出了更慢的系统,平均端到端延迟升 2 到 5.5 倍,SLO(服务水平目标,系统承诺满足的性能下限)意义下的最大 goodput(有效吞吐,即满足 SLO 的请求速率)掉 1.1 到 2.7 倍,H100 与 B200 双平台一致。论文给出三条件框架:远层加速只在「读 I/O 是瓶颈、读多于写、带宽可持续」同时成立时才赚,而瞬时 KV 三条全部违反,所有 trace 上写请求都多于读,两层层级把复用留在近层,持续写重的流被甩给远层。它还补了三个佐证:介质读延迟缩放 3.75 倍,端到端延迟变化不到 1%,说明问题出在系统结构,不出在介质本身;3D-ICE 热模型显示堆栈在远低于峰值带宽时就触热限;TLC(三层单元闪存)比它替换掉的 SSD 池更早耗尽写入寿命。结论也留了门:有选择地使用、配合重用感知的数据放置、写预算与热协同,HBF 在推理系统里挣得自己的席位。
牛津团队的 HMA 论文从 GPU 微结构侧补了另一条批评轴:HBF 继承 3D NAND 的读延迟,page open time(页打开时间,读一个页之前的准备动作)约为 DRAM 的 1000 倍,直接把 GPU 调度器饿死,调度器发出读请求后要等相当于平时一千倍的时间,流水线空转。全 HBF 配置的几何均值性能甚至输给 CPU 卸载方案 2.05 倍。他们的解法是预测式迁移:HBM 与 HBF 并排贴着 GPU 集成在同一封装里,用硬件迁移策略把高延迟访问挡在关键路径之外,几何均值比全 HBF 快 2.79 倍,并在架构模拟中把单 GPU 可部署容量推到 739 GiB,是 80 GB A100 的 9.2 倍。
系统研究《Exploring HBF》则从写路径下手。十个观察、五条结论,最重的一条:往 HBF 写中间数据,每个解码迭代的写流量最多涨 100 倍;KV 缓存的写入带来非平凡的性能开销和耐久挑战。容量红利要兑现,读带宽必须维持 HBM 级,SLO 约束下尤其如此。
正方也有硬结果。中科院计算所的 FlashAccel 做 HBF 集成进 GPU 的全套协设计,在 100ms 延迟约束、6 栈配置下做到每 GPU 吞吐 2.49 倍、能效 1.93 倍(对比纯 HBM 的 GPU)。注意它的条件:权重和 KV 都进 HBF,靠专用数据布局、延迟隐藏架构和存储管理层整套协设计撑住。加上前述 KAIST 的 DASH,正方的共同姿态是:收益存在,但要用架构手段去买。
五篇论文的批评轴各不相同,有一件事全场一致:模型权重是写一次读多次的数据,属于 HBF——连标题最凶的那篇也不例外,它攻击的一直是瞬时 KV,也就是写入后很快作废、几乎不会再读的那部分缓存。另一个一致点同样重要:截至 2026 年 9 月,整个 HBF 生态没有公开的第三方硅上实测,上面所有数字都出自仿真器。这场争论还要在真机上重新打一遍。
这场争论的实质是内存层级的分工,两边都可以成立。云端高并发集群仍是 HBM 的天下,预填充与解码分离、专家并行的整套体系继续有效。HBF 开辟的是一个此前没有产品形态的档位:一台机器、整个模型、低并发、长上下文。这个档位以前不存在,是因为没有任何介质能同时给出 TB 级容量和 TB/s 级读带宽。
六、谁需要这台机器:负载画像与经济账
回到那个具体的问题:谁买。
论文评价用的三条 agent trace 描绘了一幅相当典型的画像:29 到 52 轮的多轮对话,输入上下文 1.8 万到 26.1 万 token,缓存命中率 94% 到 96.6%,纯解码阶段占整体耗时的份额从 11% 到 50% 不等。这正是 agent 工作负载的形态:长系统提示反复命中缓存,每一轮只在对话尾部继续生成,会话数少而单会话纵深大。论文还量化了负载形态对配置的影响:纯解码份额越高,主机传输拐点越往右移、曲线越陡;预填重的负载则对状态层带宽更宽容。配置方案跟着负载画像走,没有静态的查表解。
存储原厂在数据中心侧给出了对应方案。SK hynix 的 H³ 架构把 HBM 与 HBF 放上同一 interposer(硅中介层)接 GPU,只读数据进 HBF、可写数据留 HBM,瞄准的场景是共享预计算 KV,即缓存增强生成:把系统提示和知识库预计算成只读缓存,天然适合闪存的耐久特性。单机侧放权重、数据中心侧放共享缓存,同一套「不可变数据归 HBF」的约束,在两种部署形态里长出两种实例化。
经济账要诚实地算。单位 token 成本是云端集群的主场,低并发下专用机的吞吐劣势既定,这一项不进场比试。它真正算的是三样:单实例的总拥有成本(一台整机对一套节点加网络加机房)、数据不出域的主权与合规溢价、负载形态与介质甜区的匹配度。需求侧的斜率也在帮忙:内存占 AI 服务器系统价值的比例已接近一半(我们在 FMS 2026 现场报道里记过 Micron 的这个数字),凡是能把内存成本降一档的架构,采购名单上都会多一行。量级参照可以用厂商数字:Sandisk 宣称同成本下 HBF 容量是 HBM 的 8 到 16 倍。Patterson 与 Ma 的综述给了另一面的权威背书:HBF 带来的 10 倍容量可以直接收缩系统尺寸,功率、总拥有成本、碳排放与网络开销同步下降。两边的限定要看清:厂商数字全部来自内部仿真,综述给的是方向,论文本身没有给出任何 BOM(物料清单)或售价测算。它划定的是性能边界,也就是性能在哪里开始塌;成本边界要留给真机回答。这篇论文的贡献,是提前标好了等真机时该验证哪一格。
七、为什么是华为:产业周期与研究布局
最后一层背景:为什么这篇论文来自华为。
先说有证据的部分。论文八位作者全部署名华为,投稿计算机体系结构方向,负载选择直接用了两个中国开源旗舰模型。研究图谱里还有第二个中国机构的身影:FlashAccel 来自中科院计算所。系统厂商与科学院所在同一年分别从整机配置与加速器协设计两端切入 HBF,加上 SK hynix 与 Sandisk 主导的规范和器件,这条链路的参与者画像已经清晰。
产业背景方面,存储行业正处于 NAND 供给宽松而 HBM 产能被战略客户锁定的周期。我们在 FMS 2026 的报道里记过这组数字:三大原厂 2027 年的 DRAM 与 HBM 产能已基本订完,NAND 的明年配额当时还在谈判。HBM 是卖方市场,NAND 是买方市场,把富余介质的密度优势转换成稀缺介质的带宽替代,这个方向对任何 NAND 产能大国的系统厂商都有吸引力。华为自身的推理路线(昇腾系列)目前公开信息里没有 HBF 产品计划,这篇论文属于设计先于硅的研究布局,与 2027 年初的设备采样窗口正好衔接。
需要标注推测的部分:华为是否在内部推进 HBF 相关的专用机产品、是否与昇腾路线绑定,论文没有说,业界也没有可靠信息。能说的是,在 HBM 获取受约束的处境下,率先把「NAND 承载万亿权重」的系统配置答案写出来的,是一家系统厂商。
八、总结与判断
华为 9 月论文对「单机万亿参数专用机」给出的配置答案可以压成一行:权重进 HBF,状态层退到商用 LPCAMM2 内存条,主机传输只暴露四分之一的内部带宽,整机落在有机基板的封装等级上。答案背后是两个万亿参数模型的算子分析、实测路由 trace 与三条 agent 负载回放;对面是 OXMIQ 与五篇学术论文构成的争鸣版图,批评轴各不相同,在「权重属于 HBF」上全场一致。
三个判断:
其一,HBF 的地盘在 2026 年已经划清。低并发、容量受限、本地与私有部署是它的甜区,云端高并发集群仍是 HBM 的领地。「HBF 替代 HBM」是伪命题,「HBF 开辟单机形态」是真命题,争论双方在地图上标注的其实是同一块区域。
其二,单机万亿参数的钥匙在系统层设计。三个旋钮的解耦让整机躲开了三个昂贵选项:HBM 的容量价、先进封装的带宽价、集群形态的网络与运维价。把问题拆到各自最便宜的解法上,这类胜利在内存墙的故事里会反复出现。
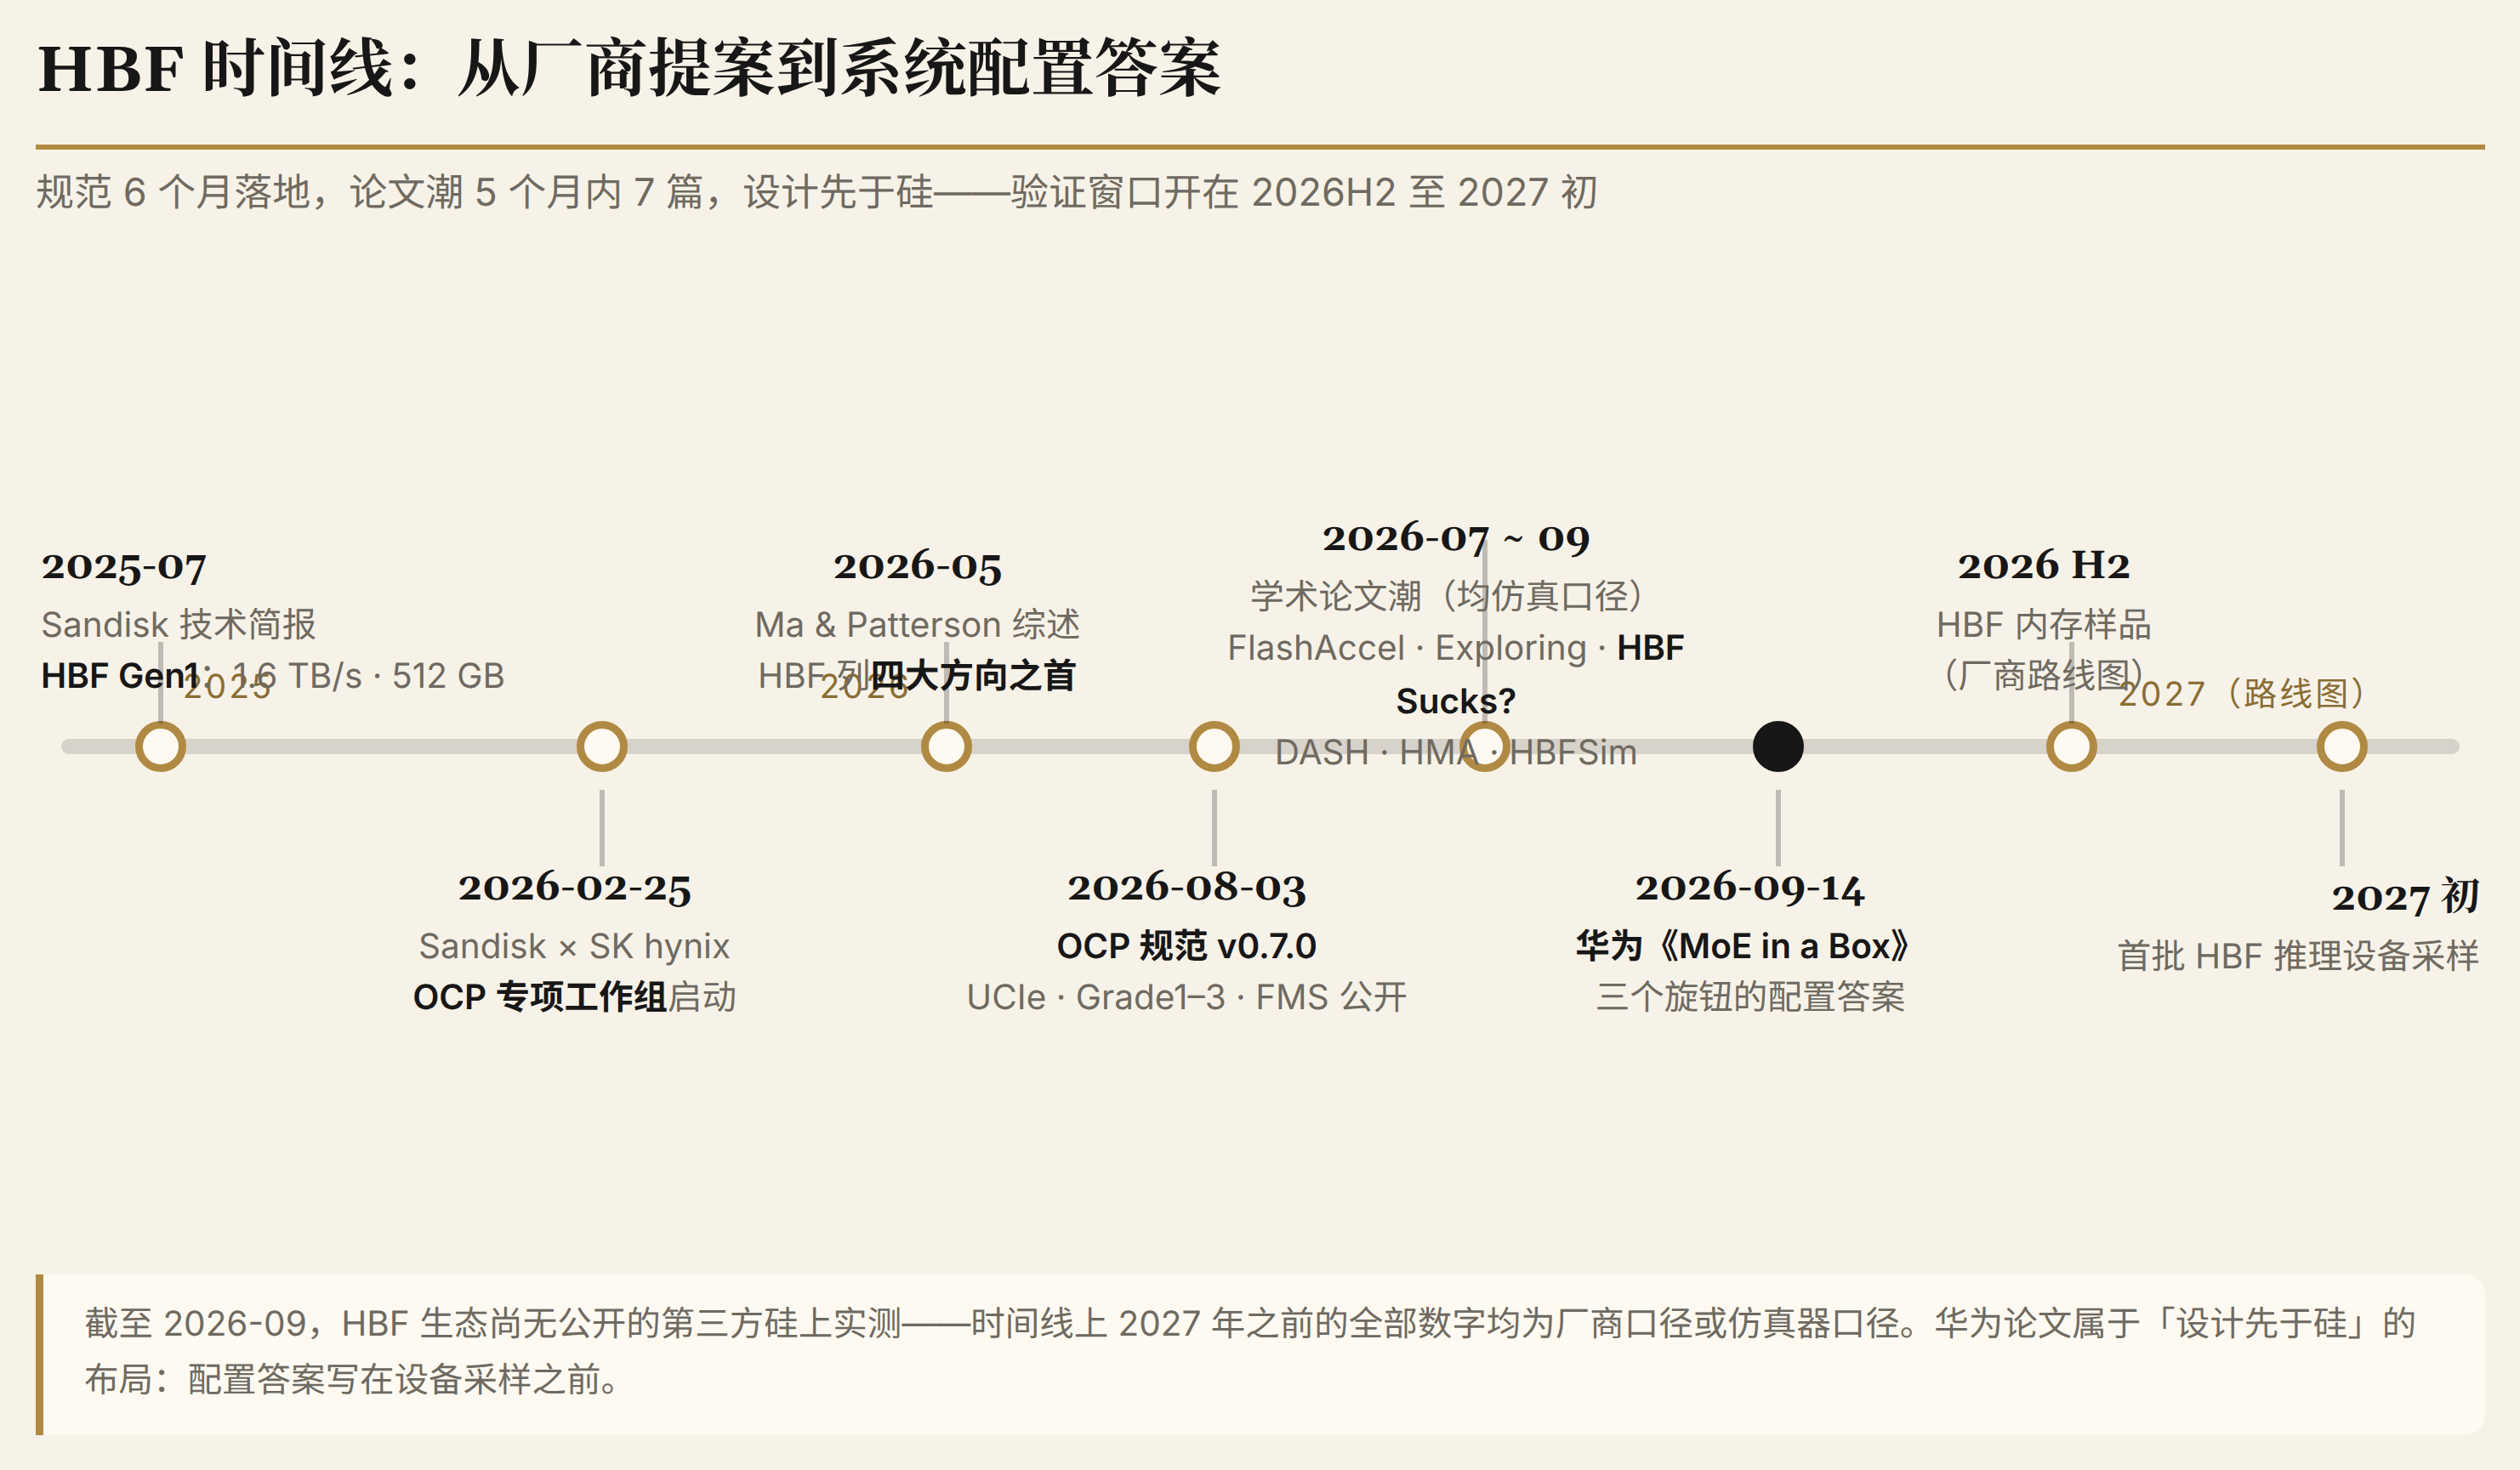
其三,验证点在 18 个月内密集到期,而且有一个现成的评分表。Patterson 与 Ma 的综述留了一个开放问题:一个系统里传统内存与 HBF 的比例应该是多少。华为论文的 4.0 与 1.4 s⁻¹,是这个问题收到的第一个定量答案。接下来盯三件事:Sandisk 的 HBF 样品是否如约在 2026 年下半年交付;2027 年初的推理设备实测带宽与暴露率,是否支持部分暴露的配置结论;华为或其他系统厂商是否把专用机做成产品。三条里兑现任何一条,论文里的等值线就会变成货架上的机器;任何一条被推翻,这场争鸣也就有了硅上的数据。
声明: 本文基于华为 2026 年 9 月 14 日提交至 arXiv 的论文《Trillion-Parameter MoE in a Box: Decoupling Memory Provisioning with High-Bandwidth Flash》(arXiv:2609.15636),结合 OCP《HBF 高层基底裸片规范 v0.7.0》、Sandisk 与 SK hynix 官方资料、五篇 HBF 学术论文及 Hot Chips 2026、FMS 2026 公开报道交叉验证后撰写。不构成投资建议。文中数据截至 2026 年 9 月 16 日。
参考文献
- Pengfei Xia et al., "Trillion-Parameter MoE in a Box: Decoupling Memory Provisioning with High-Bandwidth Flash," arXiv:2609.15636, 2026-09-14(华为,主论文)
- Open Compute Project, "High Bandwidth Flash (HBF) High-Level Base Die Specification v0.7.0," 2026-08-03(Sandisk×SK hynix)
- Sandisk, "HBF Fact Sheet," 2025-07;官方博客 "Scaling Beyond the Wall"
- SK hynix Newsroom, "HBF at FMS 2026," 2026-08
- Minho Ha, Euiseok Kim, Hoshik Kim (SK hynix), "H³: Hybrid Architecture Using HBM and HBF for Cost-Efficient LLM Inference," IEEE CAL, DOI: 10.1109/LCA.2026.3660969
- Seeyeon Kim et al. (KAIST), "Beyond Capacity: Scalable MoE LLM Inference via HBF with Direct GPU and HBM Paths," arXiv:2608.14333
- FlashAccel (中科院计算所), "Leveraging High-Bandwidth Flash for High-Throughput LLM Inference," arXiv:2607.10186(引 v2, 2026-08-22)
- Dowon Son et al., "Exploring High-Bandwidth Flash for Modern LLM Inference," IEEE CAL, DOI: 10.1109/LCA.2026.3705817 / arXiv:2608.13868
- "HBF Sucks? A Full-Stack Characterization of High-Bandwidth Flash for KV-Centric LLM Serving," arXiv:2608.11668(引 v4, 2026-09-14)
- Hakam Atassi, Noa Zilberman, Amro Awad (University of Oxford), "Hardware-Managed Heterogeneous HBM and Flash in LLM Inference Systems," IEEE CAL, 2026-08
- Xiaoyu Ma, David Patterson (Google DeepMind), "Challenges and Research Directions for LLM Inference Hardware," IEEE Computer 59(5), 2026-05, DOI: 10.1109/MC.2026.3652916
- Tom's Hardware / ServeTheHome 对 OXMIQ Labs Hot Chips 2026 报告的报道
- HuggingFace 官方模型卡:deepseek-ai/DeepSeek-V4-Pro(MIT);moonshotai/Kimi-K3(Kimi K3 License,原生 MXFP4);Qwen/Qwen3.8-2.4T-A95B(Qwen3.8-Max License)
注:文中 865 GB / 1560 GB 权重体积为论文给出的数字;Kimi K3 官方模型卡未标体积,按 2.8T 参数 4-bit 推算下限约 1.4 TB,两者相容。除注明外,性能数字均为仿真或厂商内部数据,HBF 生态截至 2026-09 尚无公开第三方硅上实测。