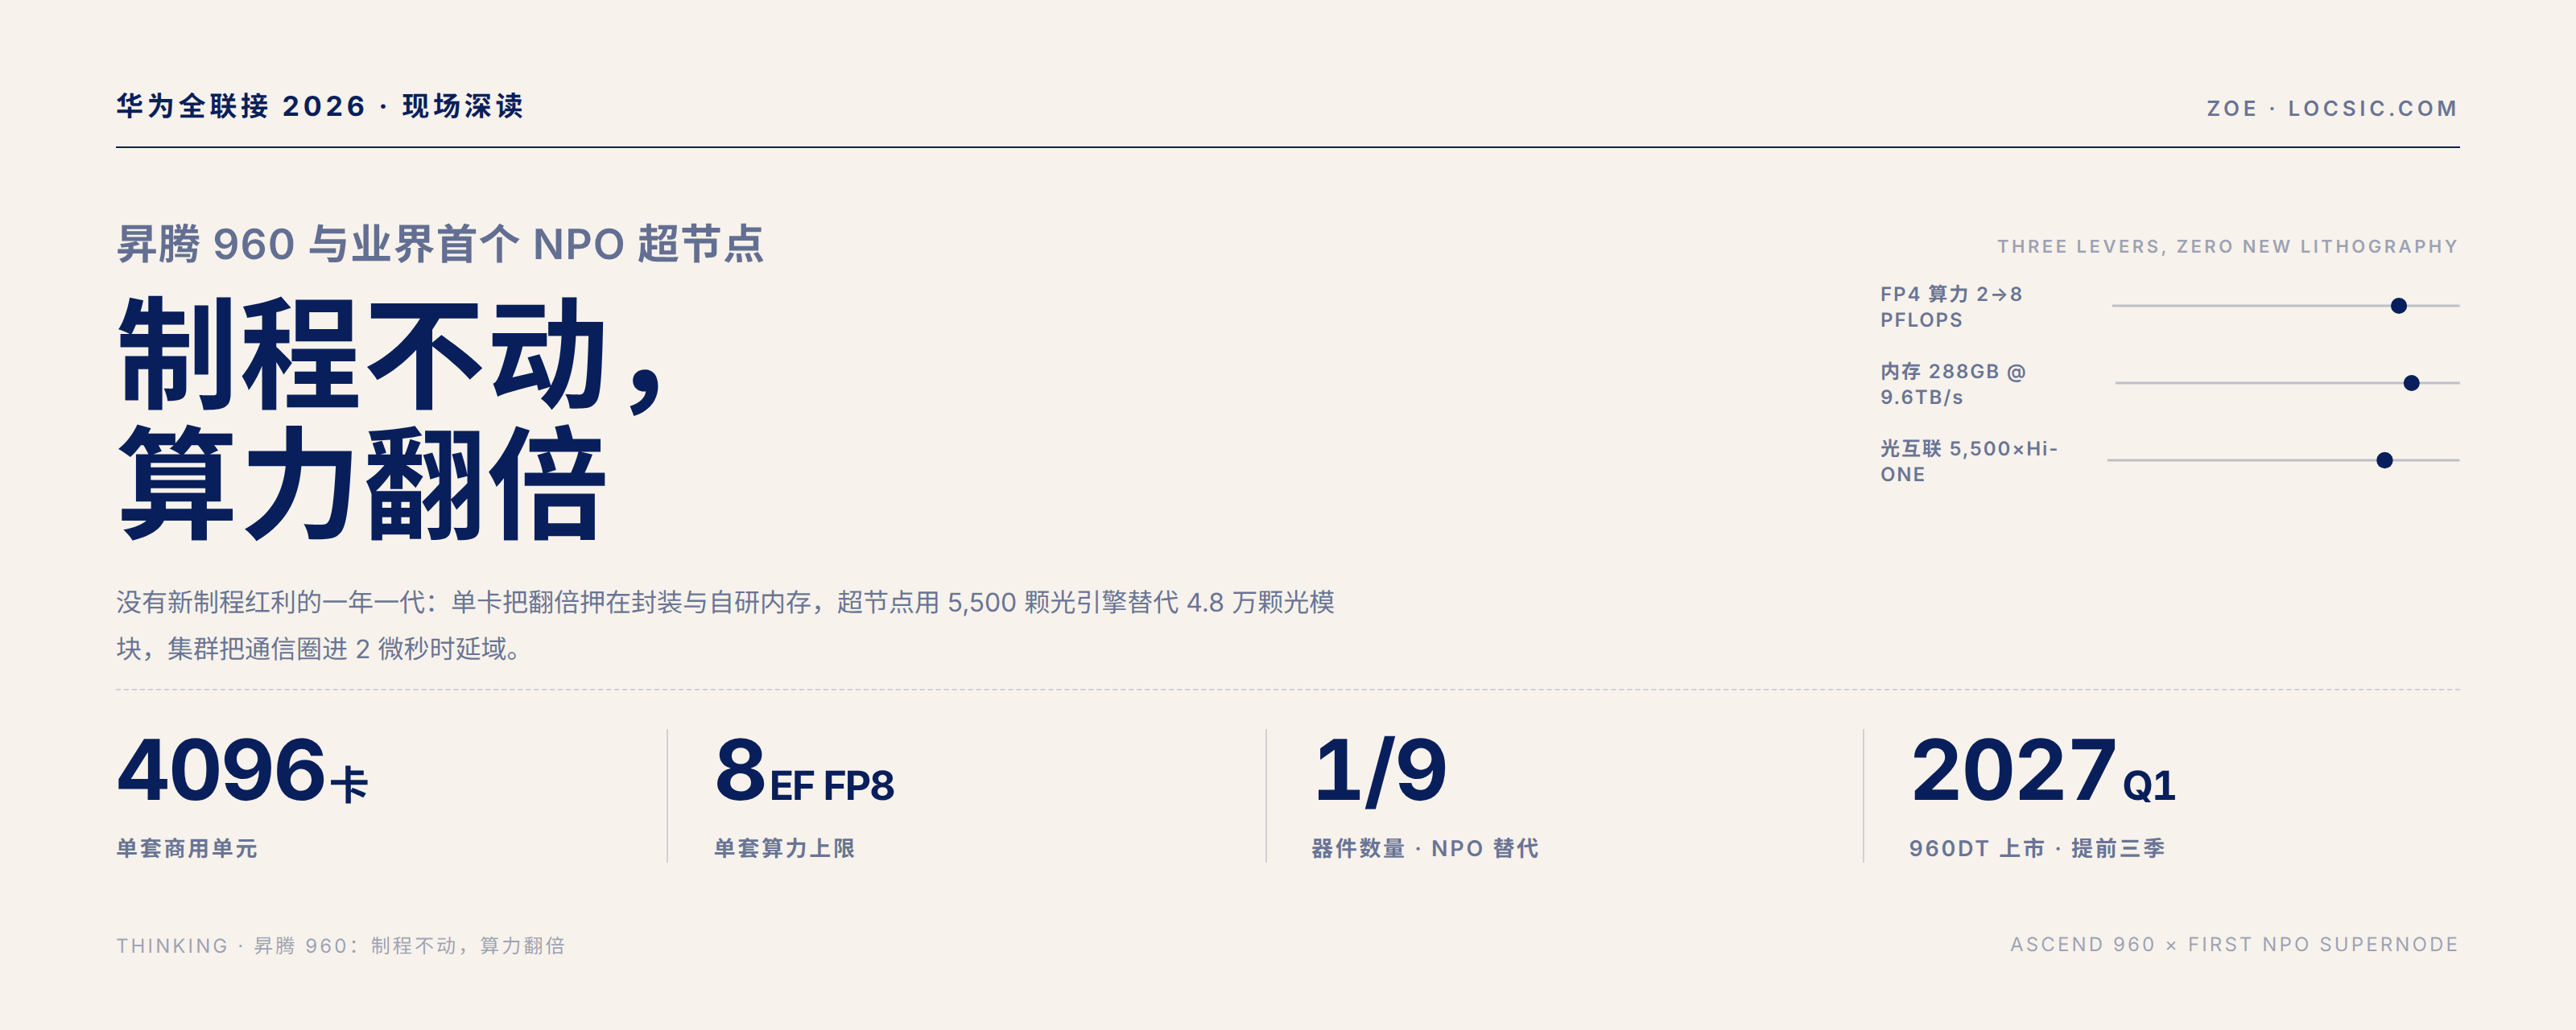
9 月 17 日上午,上海,第十一届华为全联接大会开幕。轮值董事长汪涛在主题演讲里交出了三层数字:昇腾 960 芯片研发进度超出预期,960DT 将于 2027 年第一季度推出,比一年前公布的路线图提前三个季度;昇腾 960 超节点单套 4096 卡,是业界第一个把近封装光学(NPO)引入超节点的系统;每套系统用 5500 颗自研 Hi-ONE 光引擎,替代原本需要的 4.8 万颗 800G 可插拔光模块。
制程没有变化。徐直军去年在同一个场合说过前提:基于中国可获得的芯片制造工艺。华为没有新的光刻机红利,一年一代、每代算力翻倍的承诺,靠的不是制程推进。芯片内部的折叠堆叠(韬定律)与系统侧的三层杠杆,构成同一个前提下的两条路线。这篇文章拆解的是翻倍的杠杆究竟放在哪里。答案分三层:单卡把封装和内存换成自研的,超节点把互联换成光引擎,集群把通信开销从时间表里挤出去。
单卡 960:翻倍第一次来自封装,不是制程
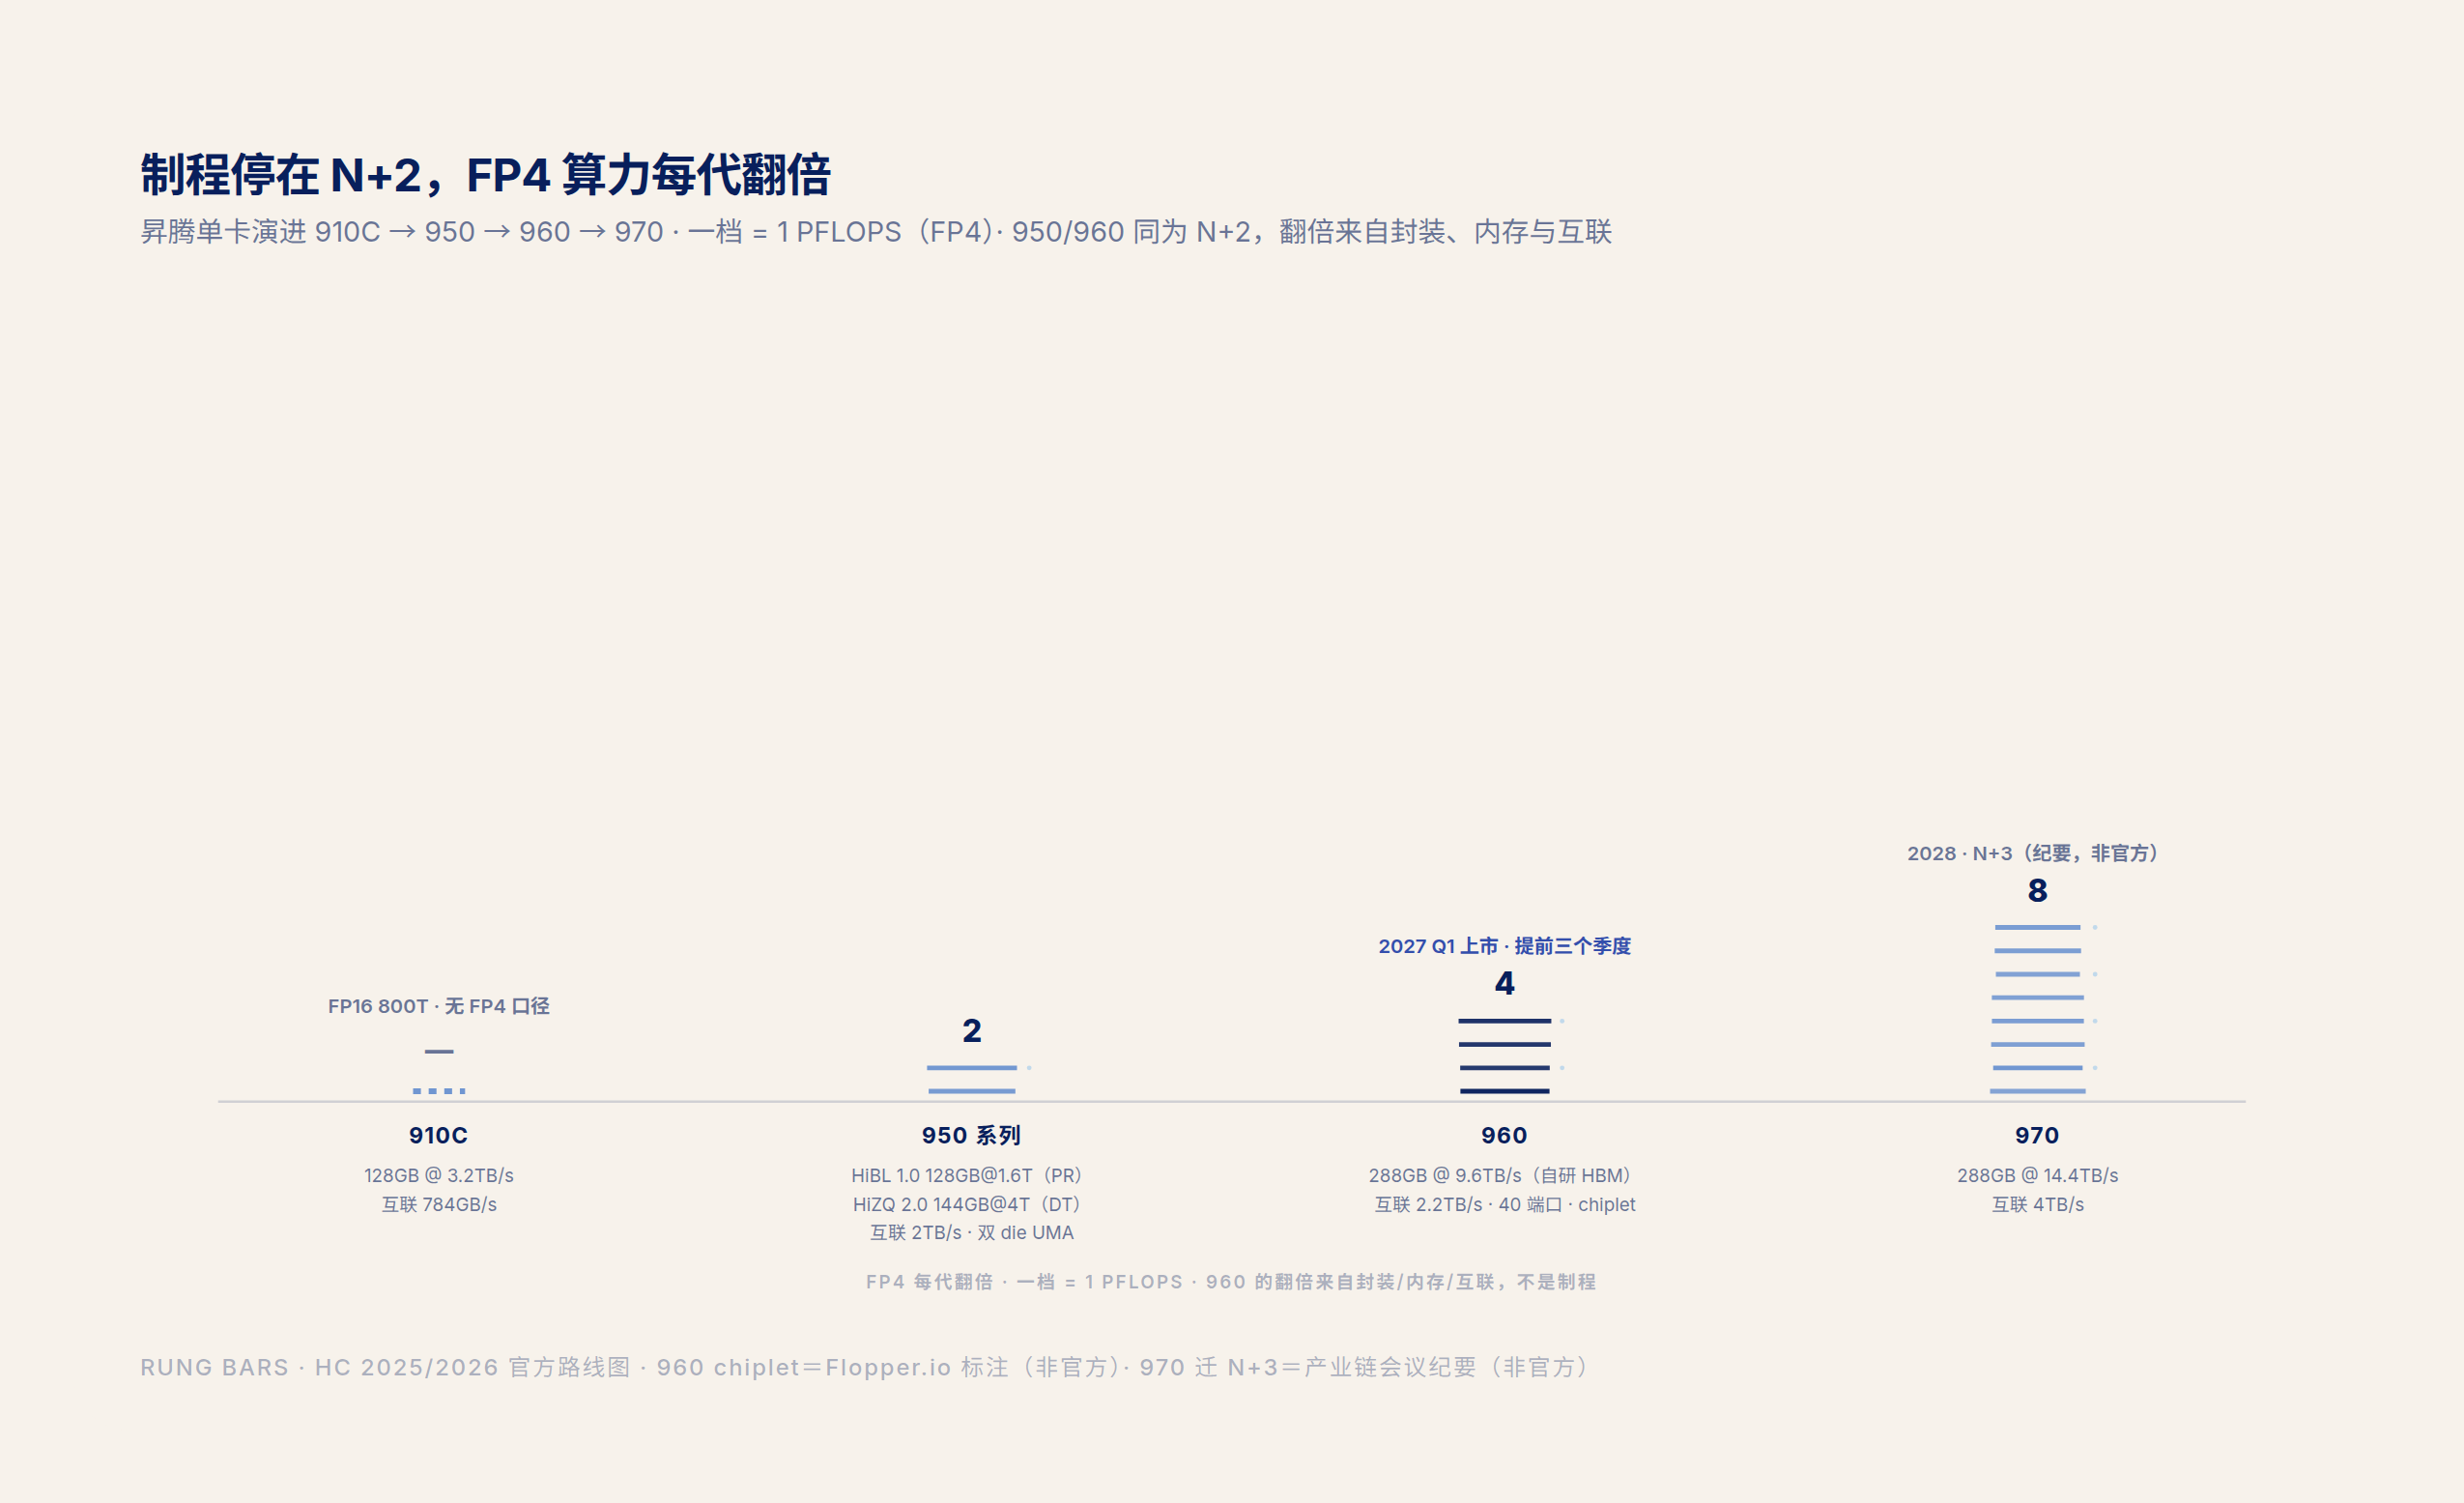
先看官方路线图给出的数字。相对 950 系列,昇腾 960 在算力、内存容量、内存访问带宽、互联端口数上全面翻倍:FP8 算力 2 PFLOPS,FP4 算力 4 PFLOPS;内存 288GB,访问带宽 9.6TB/s;互联带宽 2.2TB/s,40 个互联端口。同时新增自研的 HiF4 四位精度格式,华为称之为业界最优的 4bit 推理精度实现(尚无第三方复现)。
实现方式的变化最大:950 系列是两颗 die 通过高带宽总线直连、操作系统层面呈现为单一设备的双 die UMA(统一内存访问)架构。960 则走向 chiplet 化的多 die 封装,第三方规格库 Flopper.io 将其标注为达芬奇 v4(华为自研 NPU 架构的第四代)的首次 chiplet 设计,该标注非官方。芯片级算力翻倍不再依赖晶体管密度,而是依赖封装内 die 数量的增加。这与 NVIDIA 从 Hopper 单片转向 Blackwell 双 reticle die(两枚接近光罩尺寸上限的芯片)的路径同构,只是华为晚了一代,且受制于中国大陆可获得的工艺节点(产业链专家会议纪要称 950 与 960 停留在 N+2 节点,970 代才迁移 N+3,非官方信息)。
内存是单卡层面更大的动作。从 950PR 的 HiBL 1.0(128GB、1.6TB/s)和 950DT 的 HiZQ 2.0(144GB、4TB/s)起步,华为自研 HBM 已经完成两代迭代;960 的 288GB、9.6TB/s,容量与带宽同时翻倍,自研内存栈承担了算力翻倍的内存侧压力。在美光预计存储供需失衡要延续到 2028 年之后、HBM 供应紧张的市场环境下,这条自研路线同时解决供给与成本两个问题。
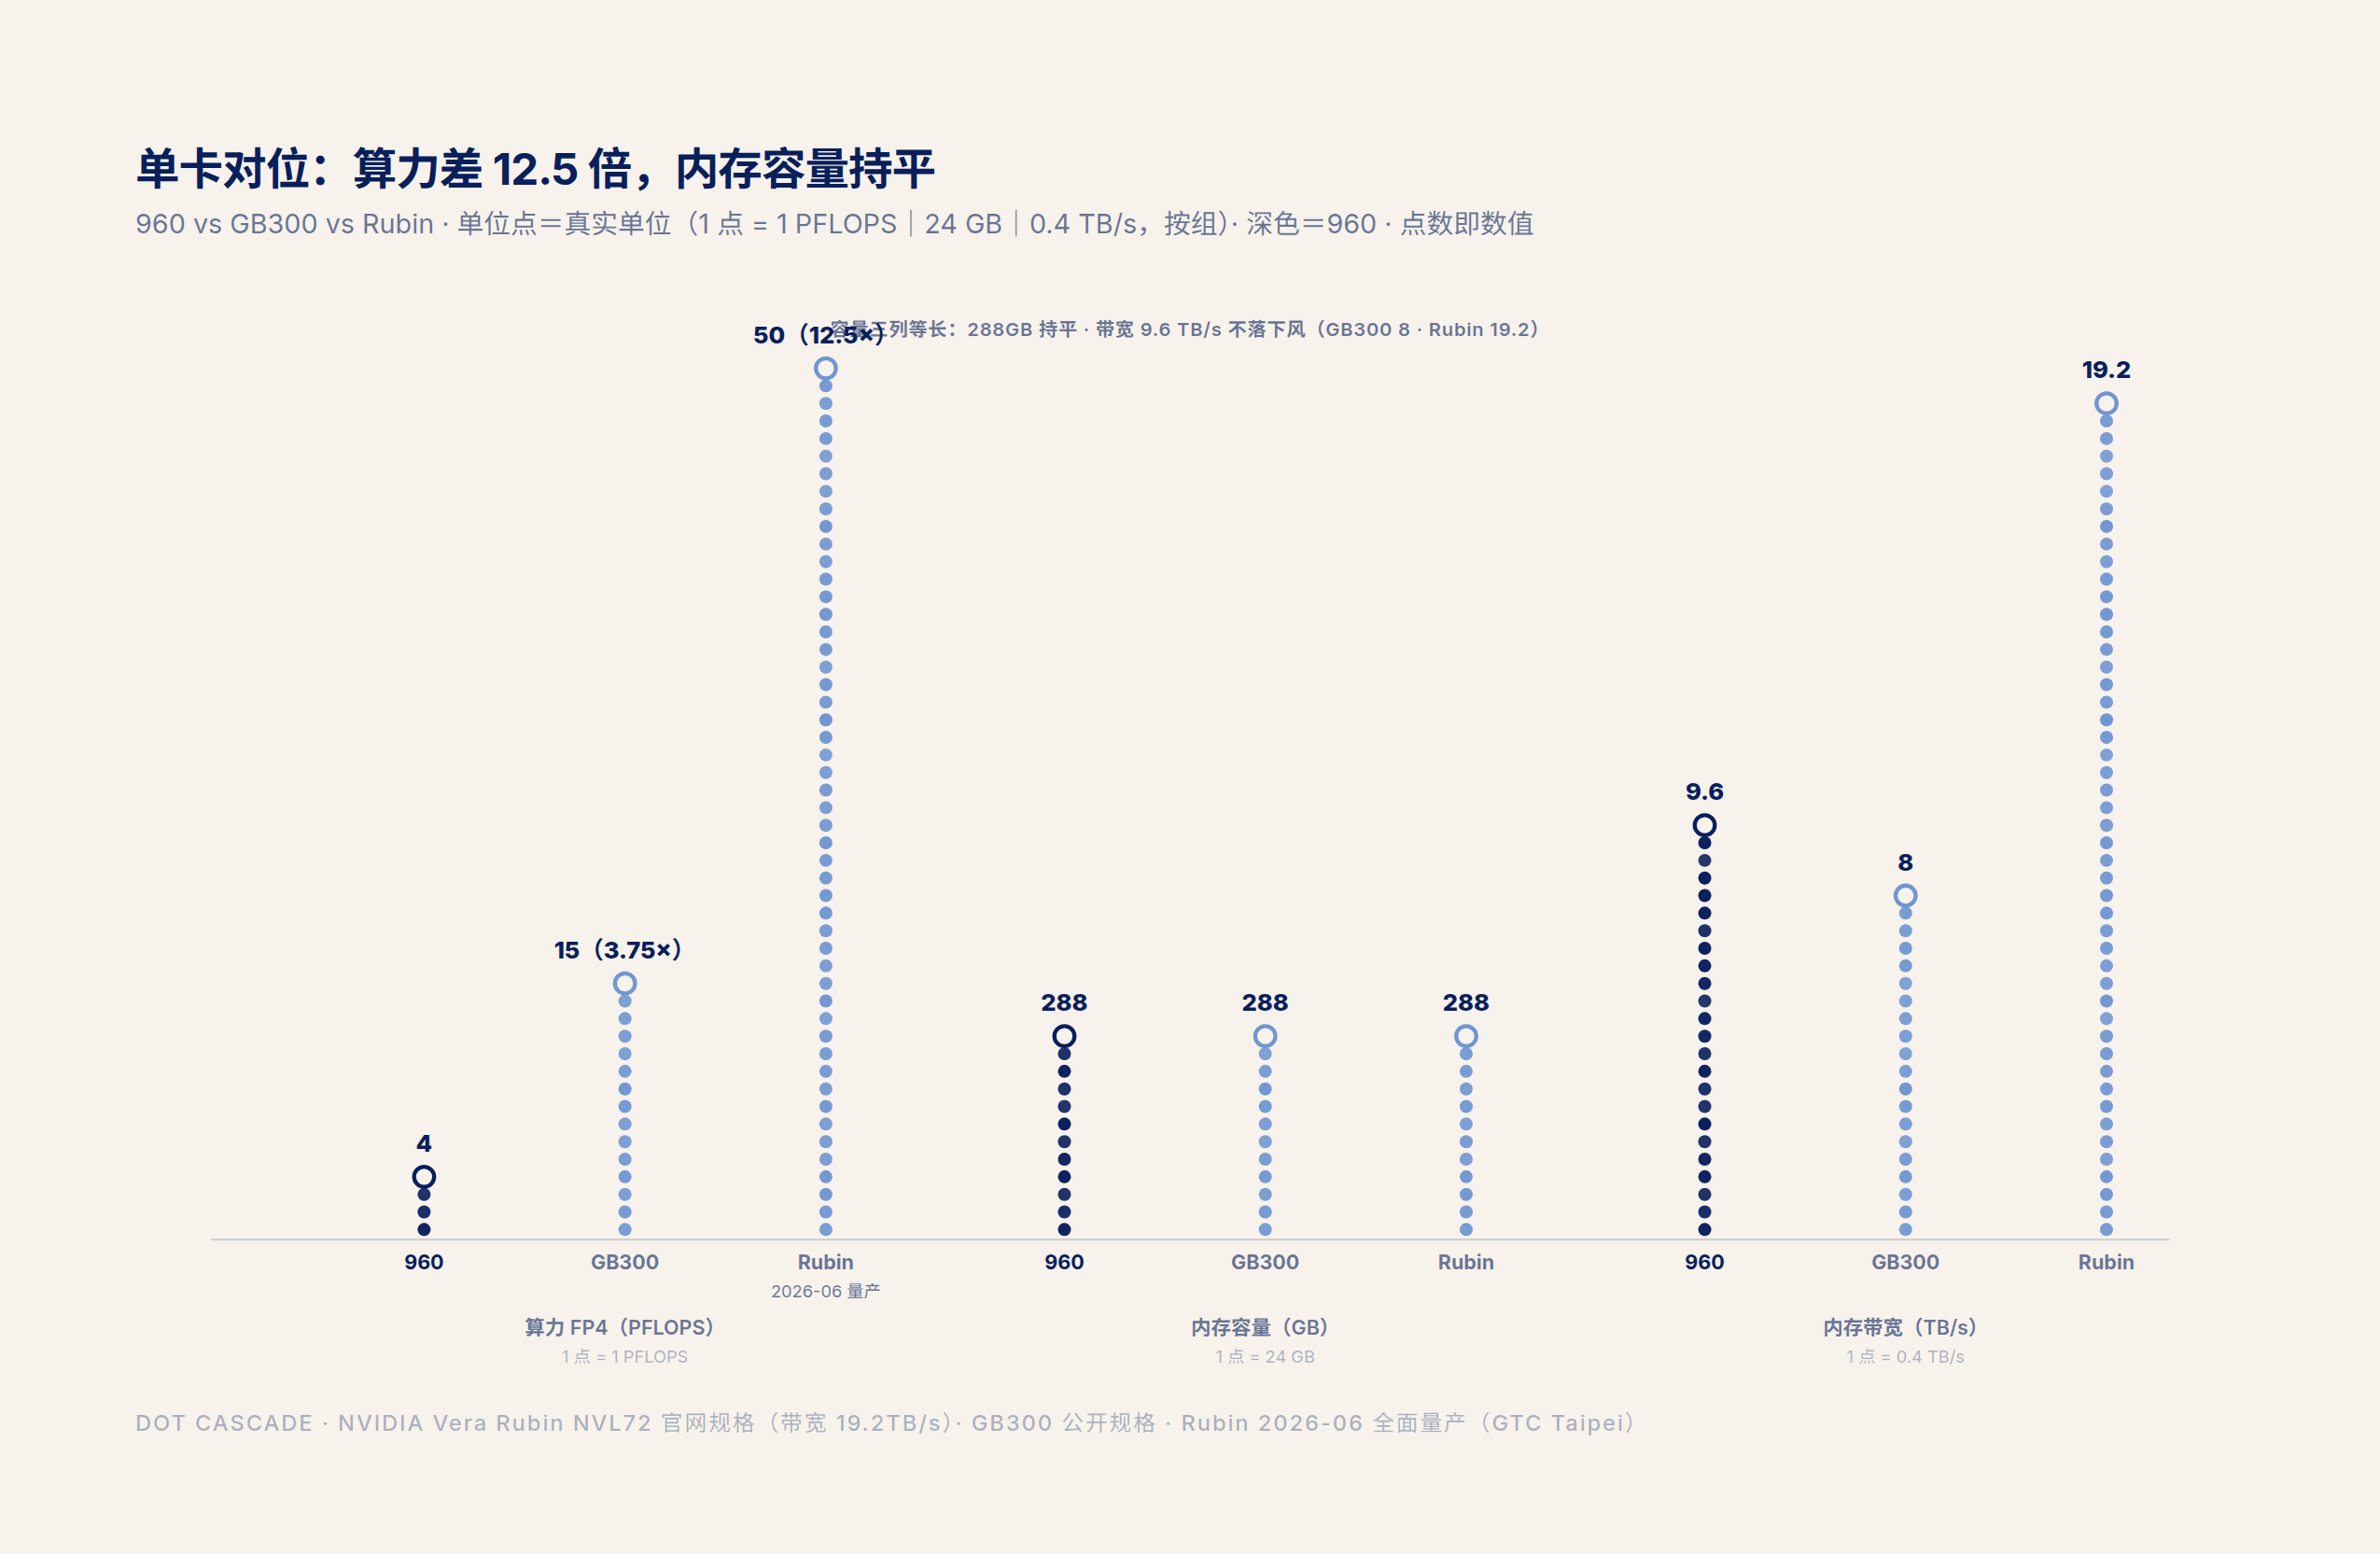
与同期 NVIDIA 产品对照,差距依然清晰。GB300 的 FP4 算力是 15 PFLOPS,960 是 4 PFLOPS,前者是后者的 3.75 倍;已经于 2026 年 6 月进入全面量产的 Rubin 单封装 50 PFLOPS FP4,差距扩大到 12.5 倍。但内存一项是另一幅图景:960 的 288GB 容量与 GB300、Rubin 持平,9.6TB/s 的带宽超过 GB300 的 8TB/s,落后 Rubin 的 19.2TB/s。华为单卡不追平算力,用容量与带宽把模型装进来、喂得动,把算力差距交给系统层去补。这是 950 一代已经验证过的取舍,960 延续并加倍。
4096 卡一台计算机:光互联搬进机箱的三笔账
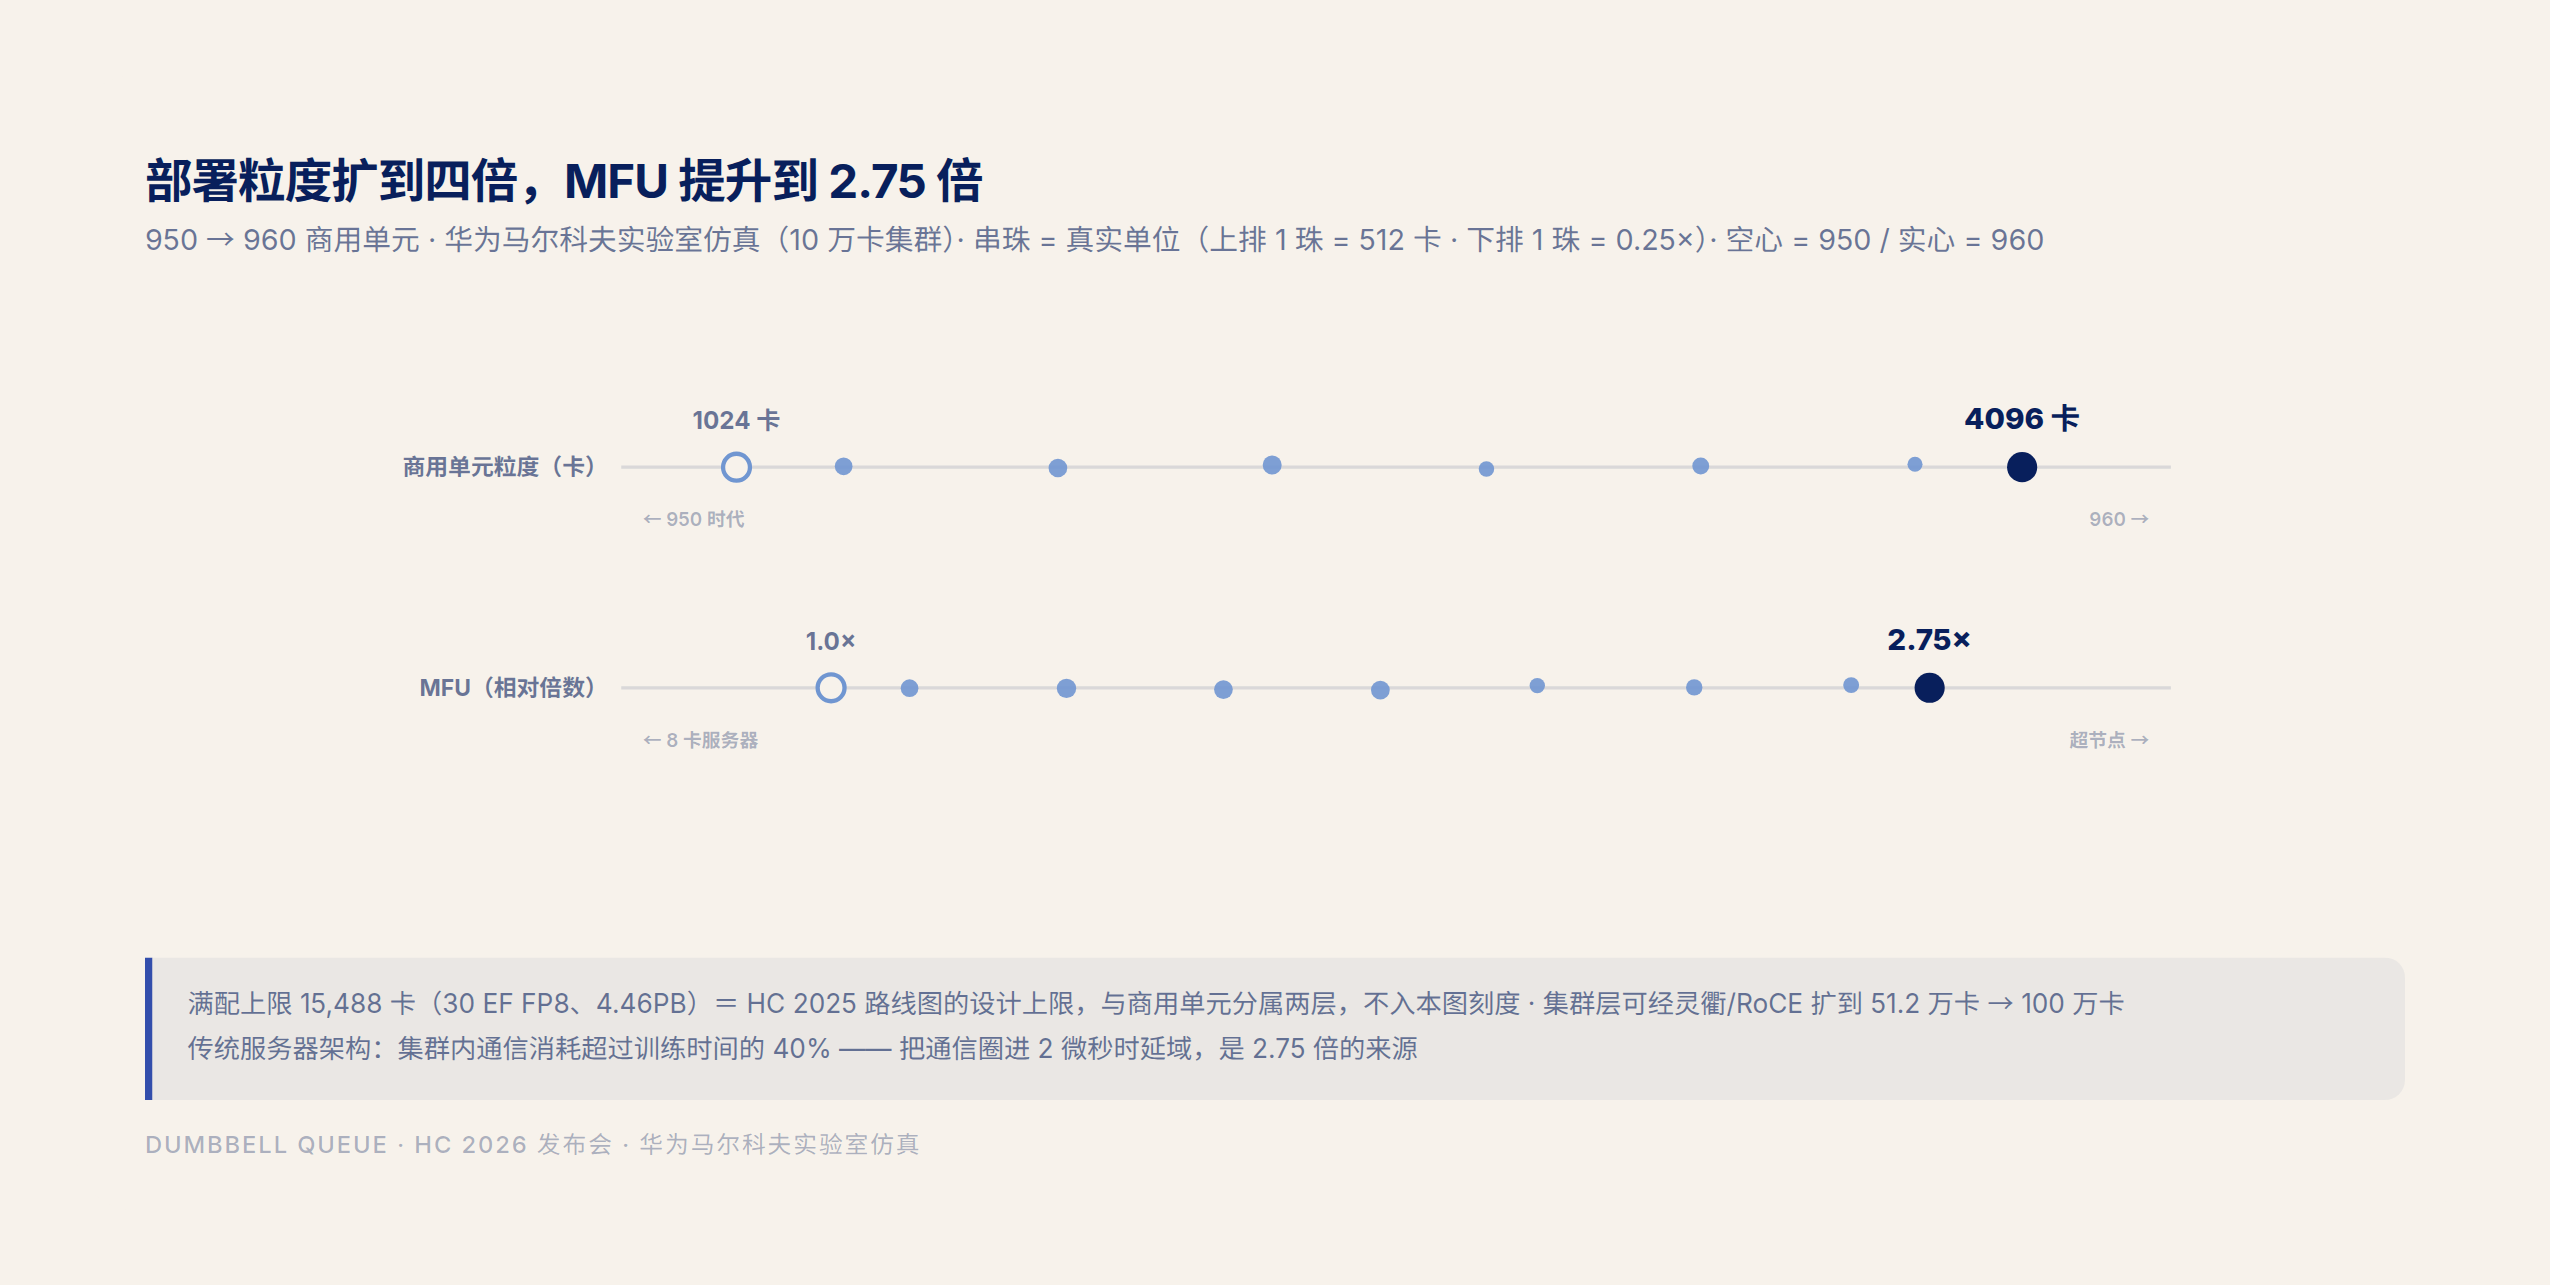
昇腾 960 超节点的商用单元是 4096 卡,最大提供 8 EFLOPS FP8 算力与 1PB HBM,往返时延最低 2 微秒,官方定位是支撑 10 万亿参数模型的训练与推理。作为对照,950 超节点的商用单元是 1024 卡。一年时间里,商用粒度涨到四倍。HC 2025 路线图上的 15,488 卡满配形态(30 EF FP8、4.46PB 内存)仍是设计上限;两组数字并存,讨论的层级不同。
粒度涨到四倍后的第一约束是互联。铜互联在 950 的 1024 卡规模已接近工程极限,SerDes(串行器/解串器)速率继续提升时电传输距离缩短、线缆体积膨胀,4096 卡需要把光引擎推进到封装近旁;华为把这一代的互连取向概括为「近铜远光」。这就是 Hi-ONE 的位置:海思光电的高密光引擎平台,单通道 200G、单引擎传输容量 7.2T;华为称其为业界首个量产的 NPO 产品,也是唯一实现内置光源的方案。
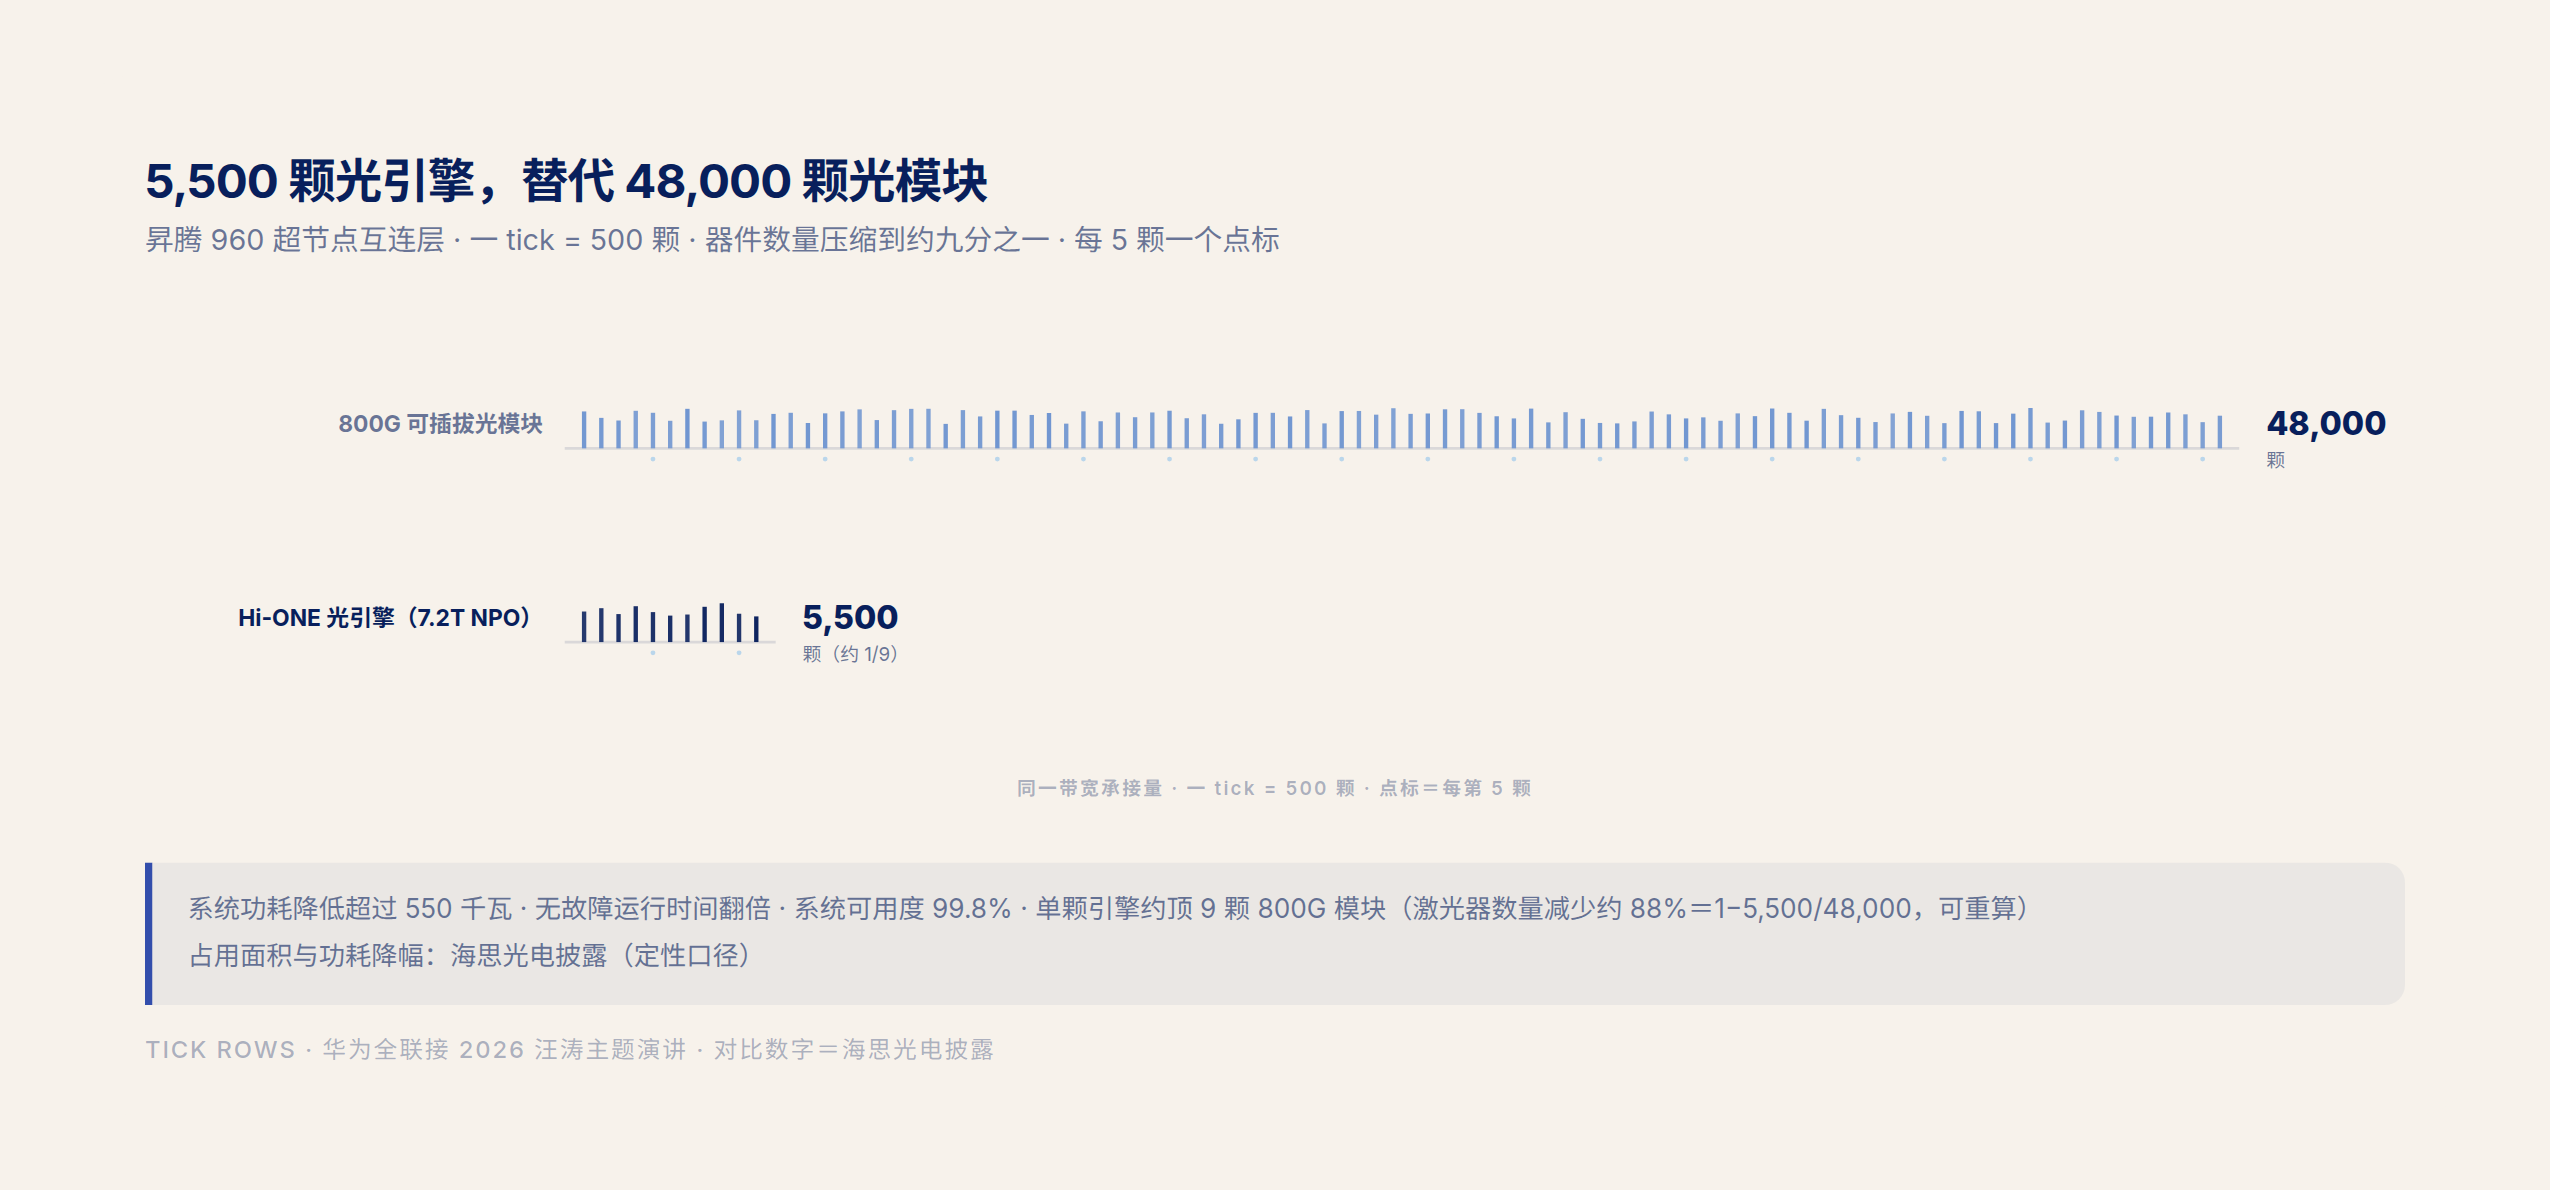
第一笔账是数量与功耗。5500 颗 7.2T 引擎承接的带宽,原本需要 4.8 万颗 800G 可插拔光模块,器件数量压缩到约九分之一,系统功耗降低超过 550 千瓦,无故障运行时间翻倍,系统可用度 99.8%。按单颗引擎算,Hi-ONE 一颗约顶九颗 800G 模块,激光器数量减少约 88%,占用面积与功耗也大幅下降(海思光电披露)。
第二笔账是技术路线的取舍。业界主流光互联把大功率光源外置,用保偏光纤耦合进硅光引擎,理由是光源高温衰减与可靠性难控。海思把 InP(磷化铟)高功率光源直接做进引擎,选用铝量子阱材料改善高温载流子限制,实测 10000 小时功率变化控制在正负 10% 以内,优于行业正负 20% 的通行要求。配合 WDM(波分复用)架构,36 发 36 收压缩为 18 加 18 根光纤。去 DSP(数字信号处理)的线性驱动方案让传输时延从 110 纳秒降到 10 纳秒量级(海思光电披露)。集成 StarSensor 星云智检,把光链路故障定位做到分钟级检测、厘米级精度,针对的正是智算集群里光链路故障引发的业务闪断。
第三笔账是 NPO 对 CPO(共封装光学)的替换逻辑。业界此前多把 NPO 视为通往 CPO 的过渡形态。CPO 把光学器件与交换芯片封在同一基板,集成度最高,但光引擎故障后无法单独更换。NPO 将光引擎独立封装部署在芯片附近,保留可插拔、可维护的特性。华为选 NPO,是在良率、功耗与运维成本之间取平衡。对一套 4096 卡、含 5500 颗光引擎的系统,可维护性直接决定规模能否成立。
集群经济学:通信超四成训练时间,用拓扑圈进超节点
单卡与超节点之上,960 这一代把集群层面的账也算清楚了。华为马尔科夫实验室的仿真显示:由 4K 卡超节点组成的 10 万卡集群,相比 8 卡服务器组成的 10 万卡集群,模型浮点算力利用率(MFU)提升到 2.75 倍。传统服务器架构下,集群内通信消耗超过训练时间的 40%。2.75 倍来自拓扑:MoE 模型的专家并行通信全部被圈进超节点的 2 微秒时延域内。再往上,多个超节点还能通过灵衢或 RoCE 组网:华为给出的最大集群规模是 51.2 万卡,结合多轨道拓扑可扩展到 100 万卡。需求侧的锚同场给出:汪涛判断到 2030 年大模型参数规模或达 100 万亿以上——960 按支撑 10 万亿参数训练与推理设计,等于超前一个量级备货。
这套经济学的配套件在同一场发布里就位。鲲鹏超节点升级到最大 4096 节点、256TB 统一内存池,与智算超节点构成免协议转换的平等互联;OceanStor M900 以灵衢(华为自研的互联协议)直连的方式提供 PB 级 KV 缓存层,用混合介质与优化 Retention 算法把 SSD 读写寿命提升到 16 倍,面向 Agent 长序列推理的多层 KV 缓存架构。权重在超节点内存里,KV 状态下沉到存储层,通信留在光域内,三种介质各司其职。
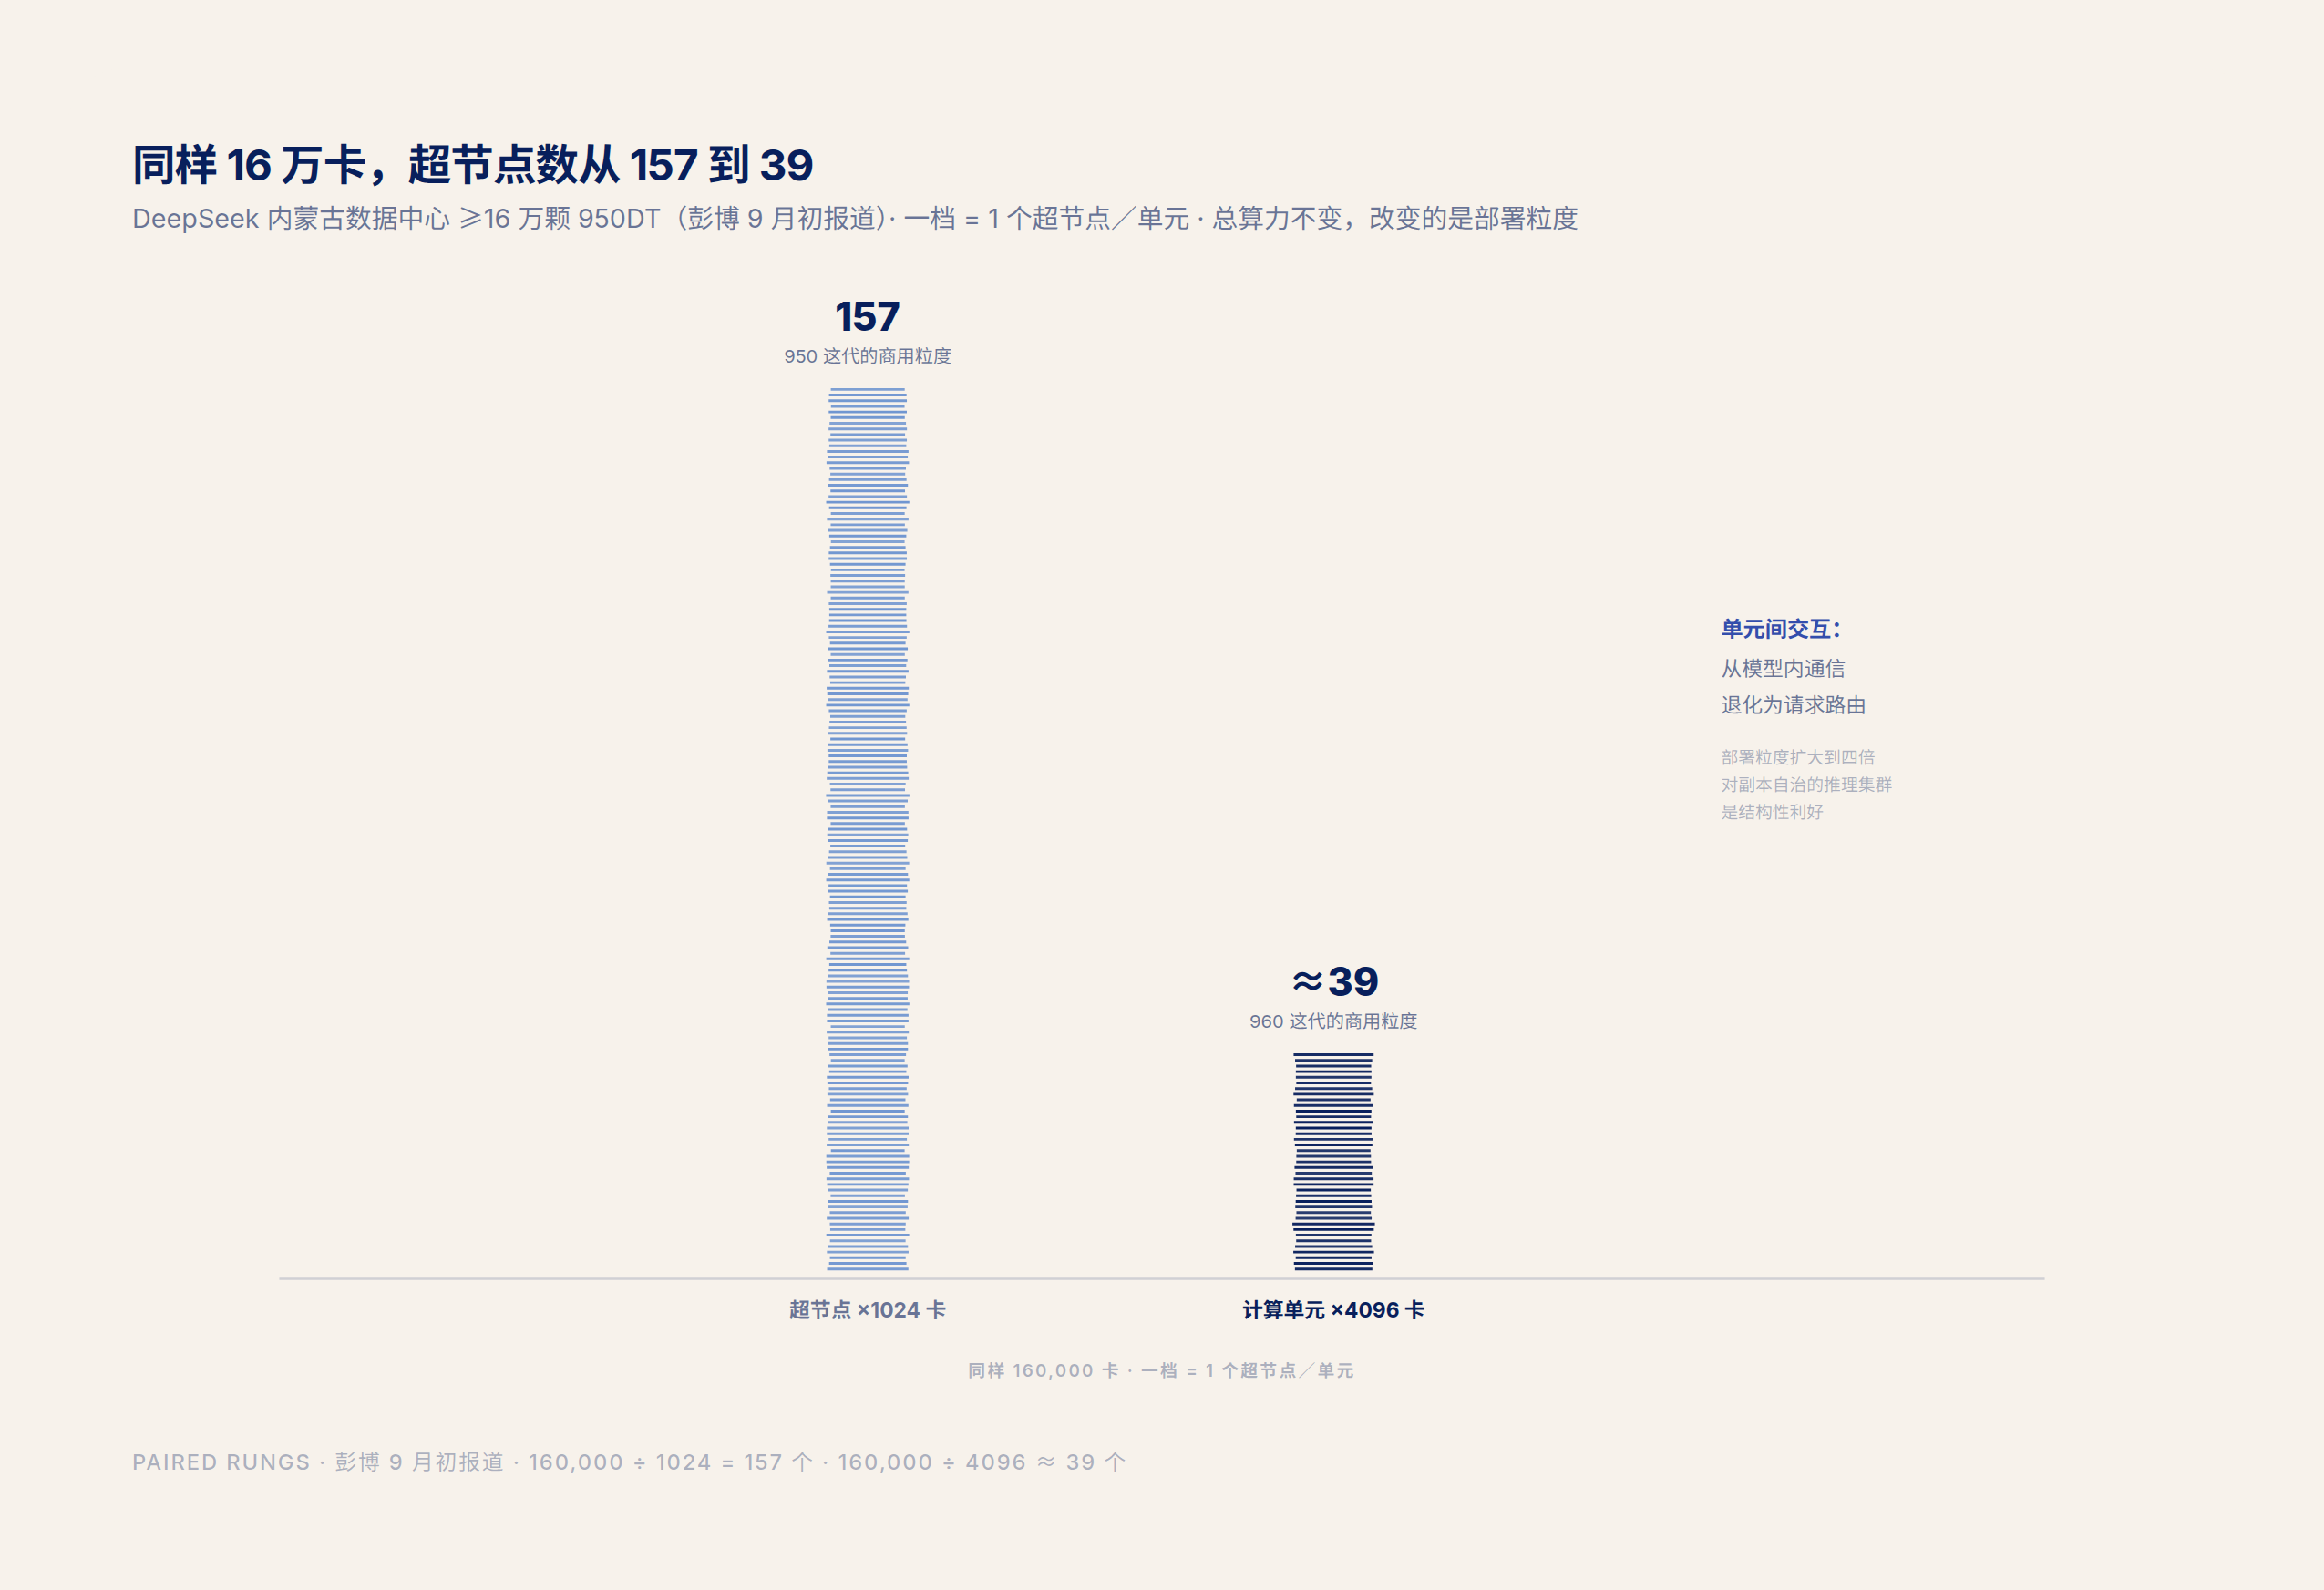
落一个具体例子。彭博 9 月初报道,DeepSeek 计划在内蒙古建设的数据中心部署至少 16 万颗昇腾 950DT。按 1024 卡商用单元计算是 157 个超节点;若按 960 这代的 4096 卡粒度,同等规模对应约 39 个单元。部署粒度扩大到四倍,单元间交互从模型内通信退化为请求路由,每个单元都是一台完整承载模型的计算机。这对以副本自治为设计原则的推理集群是结构性利好。
软件栈不是从 960 开始的:950 交出的成绩单
判断 960 的生态起点,要看 950 这一年发生了什么。
DeepSeek V4 是分水岭。发布当天实现 Day 0 完整推理支持的软件栈有两个:CUDA 和华为 CANN。SemiAnalysis 对 950DT 运行 DeepSeek V4-Flash 的 trace 级拆解(经媒体转述)显示,CANN 在 16 路专家并行部署中做到了三层执行重叠:计算与集合通信重叠、共享专家计算隐藏在路由专家之下、索引与压缩操作相互重叠。这是指令调度层面的工程能力,已经超出"能跑"层面的适配。V4 从架构设计阶段就与昇腾协同:注意力机制、MoE 量化方案、专家并行通信设计都考虑了昇腾硬件的执行路径。模型与芯片的联合定义,首次在国产体系中形成大规模实例。
存量的底数同日更新:汪涛披露昇腾 910C 超节点已部署超 1000 套——上一代超节点跑出的装机存量,是 960 商用粒度再扩四倍的现实起点。市场给出的信号更直接:字节锁定约一半 950 系列产能,阿里、腾讯跟进数十万颗。中国移动启动超节点设备集采,规模 6208 卡(776 套计算节点)。9 月 10 日,彭博商业周刊援引知情人士报道称,受 HBM 成本推动,昇腾 950DT 的价格在过去三个月上涨约六成,至 25 万元人民币。涨价是供给瓶颈的证据,也是需求过热的证据。DeepSeek 官方在 V4-Pro 降价至四分之一时预告:昇腾 950 超节点下半年批量上市后,Pro 价格还将大幅下调。推理成本与国产芯片供给挂钩的链条,已经可以在公开报价里直接观察。供给的交付形态也给出了日期:华为云 CEO 周跃峰 9 月 18 日在大会现场宣布,灵衢昇腾 950 智算集群服务 9 月 30 日国内商用、11 月 30 日面向海外。
960 继承的就是这个起点:CANN 月活开发者 5200 以上,昇腾原生训练模型超过 40 个,openEuler 装机量超过 2000 万套。华为官方称之为国内唯一支持预训练的技术路线。
2027 年的对位:错开半代的竞争
时间线上,960DT 的 2027 年第一季度,对位的不是 Rubin。同一场主题演讲把芯片节奏补齐到后三年:960PR 计划 2027 年三季度上市,比原计划提前一个季度;此后一年一代,昇腾 970、980 分别排到 2028、2029 年。整机是另一条时间线:Atlas 860 风冷、Atlas 960 液冷超节点分别计划在 2027 年二季度和三季度推出。Rubin 已于 2026 年 6 月进入全面量产,下半年开始在主要云厂商上柜。960 真正同场竞技的对象是 2027 年下半年的 Rubin Ultra NVL576(单封装四 die、约 100 PFLOPS FP4、1TB HBM4e、Kyber 机柜 600kW)。
竞争结构是错位的。单卡层面,960 的 4 PFLOPS 对 Rubin Ultra 的约 100 PFLOPS,差距约 25 倍;系统层面,960 超节点的 4096 卡 scale-up 域对 NVL576 的 576 die,规模反过来约为其七倍。华为用系统域的规模换单卡的密度,两个数字都真实,取决于把哪一层当作比较的基准。这本质上是两种资源组织方式的竞争:一种把算力密度推到封装极限,一种把协同规模推到光互联极限。
地缘边界给这场错位竞争划出了市场。国内市场因出口管制天然属于昇腾体系。海外,华为正探索马来西亚、埃及等市场,韩国渠道计划 2026 年四季度引入 950DT、950PR 与 Atlas 950 超节点(ETNews 报道)。摩根士丹利研报(经媒体转述)测算,中国 AI 芯片市场 2030 年将达 6460 亿元人民币。960 的主战场是推理需求暴增而 NVIDIA 供给受限的市场。
风险清单:产能、良率与未证明的训练
第一是自研 HBM 产能。950DT 三个月涨价约六成,说明瓶颈已经在供给端。自研 HBM 的产能爬坡决定 960 是纸面翻倍还是交付翻倍,这是整个路线图最硬的约束。
第二是 NPO 良率与规模化的工程验证。硅光高通道引擎的制造公差敏感,Hi-ONE 现阶段以 MZ 调制器(马赫-曾德尔调制器)方案为主,微环等更高密度方案在路线图后段。5500 颗引擎的系统里,良率、耦合、维护任何一个环节的缺陷都会被乘以 5500。首个量产 NPO 的标签目前来自厂商自述,大规模现场数据尚未公开。
第三是训练能力仍未证明。950 一代验证的是推理与 Decode 场景。国内前沿模型的训练仍高度依赖 NVIDIA 高端芯片(彭博等媒体报道)。960DT 的名字里有 Training,2027 年它能否在一个前沿级训练集群里承担主要训练负载,是这代芯片真正的考试。
第四是两组互不一致的数字。960 超节点对 950 的性能提升,HC 2026 公布的是 10 万亿参数模型训练 2.3 倍、推理 2.5 倍。HC 2025 公布的是训练 3 倍、推理 4 倍以上。两组数字参照系不同,推测与「商用单元、满配」两种对比基准的差异有关,本文均予保留,待华为澄清。
总结与判断
本文拆解了昇腾 960 的三层结构:单卡靠 chiplet 封装与自研 HBM 完成翻倍,超节点靠 NPO 光引擎把商用粒度推到 4096 卡,集群靠拓扑设计把通信开销挤出训练时间。三层都不依赖制程推进,这是制程受限环境下算力增长方式的一次完整换轨。
三个判断:
第一,960 是系统定义芯片路线的第一次完整兑现。所谓系统定义芯片,指芯片的规格与取舍从整机和集群的需求反推:先有系统需求,后有芯片规格。950 验证了软件栈与模型联合定义,960 把互联也纳入自研产品线(Hi-ONE、灵衢、M900);这一代围绕超节点共开发 11 颗关键芯片,覆盖计算、互联与存储。芯片设计从系统拓扑反推。这个模式的上限落在自研 HBM 的产能曲线上。
第二,NPO 正在从过渡方案变成主路径。华为用首个量产 NPO 超节点表明,光进机箱在功耗、密度、运维三笔账上可以同时成立。NVIDIA 押注集成度更高的 CPO。2027 到 2028 年,超节点互联会分化成可维护与极限密度两条路线,选择哪条本质是运维经济学之争,而运维是华为三十多年联接生意的主场。
第三,中国推理算力的成本曲线开始独立于 NVIDIA 定价体系。950 已给出苗头:V4-Pro 降价至四分之一;在 Vercel AI Gateway 统计中,DeepSeek 的 token 份额从不足 1% 升至 17%(5 月),超过 OpenAI。960 超节点定型后,国产推理成本将与自研 HBM、NPO 光互联和电力成本挂钩,与 GPU 市价脱钩。这条曲线的斜率,2027 年由 950 超节点批量上市后的 DeepSeek Pro 定价直接给出。
后续关注点:一,960DT 是否如期在 2027 年第一季度推出,960PR 三季度接续,提前后存在执行风险。二,950 超节点下半年批量上市后 DeepSeek Pro 的实际降价幅度,官方已预告。三,Hi-ONE 的代际演进与 NPO 标准化的产业扩散(OPEN NPO 多源协议、OIF 标准立项)。四,韩国市场 2026 年四季度首个海外超节点落地情况。五,15,488 卡满配形态的正式亮相时点。
信源
- 华为全联接大会 2025 徐直军主题演讲全文(华为官网,2025-09);华为发布昇腾 960 超节点(华为官网,2026-09-17)及汪涛主题演讲现场报道(科创板日报、每日经济新闻、观察者网、中国科技网、东方财富网,2026-09-17)
- 昇腾路线图补全与部署量(960PR 2027 年三季度、970/980 于 2028/2029 年一年一代、910C 超节点超 1000 套):汪涛主题演讲报道(新京报贝壳财经、解放日报,2026-09-17/18);2030 年大模型参数或达 100 万亿以上:汪涛主题演讲(通信世界,经百家号,2026-09-17);灵衢昇腾 950 智算集群服务 9 月 30 日国内商用、11 月 30 日海外(华为云 CEO 周跃峰,新浪科技,2026-09-18)
- Reuters:Huawei to launch two new AI chips in 2027(2026-09-17);昇腾 950DT 涨价报道(2026-09-10)
- 彭博商业周刊:华为上调最先进 AI 芯片价格(昇腾 950DT 三个月约涨六成、至 25 万元)(2026-09-10,经新浪财经、微博转载)
- SCMP:Huawei unveils latest tech to boost AI power(2026-09-17)
- 彭博(经 Newtalk、观察者网转述):昇腾 960 展示预告、马来西亚与埃及市场、DeepSeek 内蒙古 16 万卡(2026-09)
- SemiAnalysis 昇腾 950DT 推理架构 trace 拆解(经 InfoQ、网易科技全文转述,2026)
- 海思光电 Hi-ONE:IFOC 2025 发布(C114、讯石光通信网)、CIOE 2026 芯光论坛解读(simpletechtrend)、NPO 行业深度(慧博、同花顺财经)
- 韬定律 V2 论文(何庭波,ChinaXiv:202605.00224v2)及本站解读《韬定律 V2:从理论框架到生产级验证》、《折叠之后,芯片反而更冷》
- NVIDIA:Vera Rubin 全面量产(GTC Taipei at COMPUTEX,2026-06-01,黄仁勋宣布;https://baijiahao.baidu.com/s?id=1866887647149058135 );官网标注「正全面投入生產」(https://www.nvidia.com/zh-tw/data-center/vera-rubin-nvl72/ )
- NVIDIA Rubin 规格:NVIDIA 官网 Vera Rubin NVL72 规格页;CES 2026 公开信息(36氪、wccftech、vrlatech 等);Rubin Ultra:雪球、百度百科(2026)
- Convequity、Flopper.io、ETNews、摩根士丹利研报(经媒体转述)