9 月 4 日,何庭波在 ChinaXiv 更新了韬定律系列第三篇论文,标题直白得近乎挑衅:《华为的 τ 芯片本该熔化吗?》。论文开篇的设问是:如果问一百位芯片工程师什么技术对行业未来最重要,很多人会回答三维集成;如果再问任何一位经验丰富的芯片工程师什么会扼杀三维集成,几乎总会听到同一个词:热。这个判断直指 5 月 25 日 ISCAS(IEEE 国际电路与系统研讨会)演讲之后业内最集中的质疑:逻辑折叠把晶体管密度在一个世代里提高了 55%,单位面积的功率密度理应飙升,三维堆叠又让底层硅片的散热路径变长,芯片应该更热、更耗电才对。这确实是懂行的第一反应:折叠让功耗更大、散热更难。
三天后,采用这颗芯片的 Mate XT2 发布。再过六天,极客湾发布了完整的能效实测。两边数据一对照,结果是反转的:晶体管密度提高 55% 的芯片,在同等性能下功耗大幅下降,Mate XT2 上实测《原神》高分辨率满帧运行,整机功耗只有 5.4 瓦。直觉错在哪里,论文用了整整一篇来回答。三个问题随之浮出:反直觉的结果在理论上如何成立,实测对上了什么、证明了什么是对的,以及从测试数据还能读出这颗芯片多少潜力。
一、反直觉的结果如何在理论上成立:论文的论证链
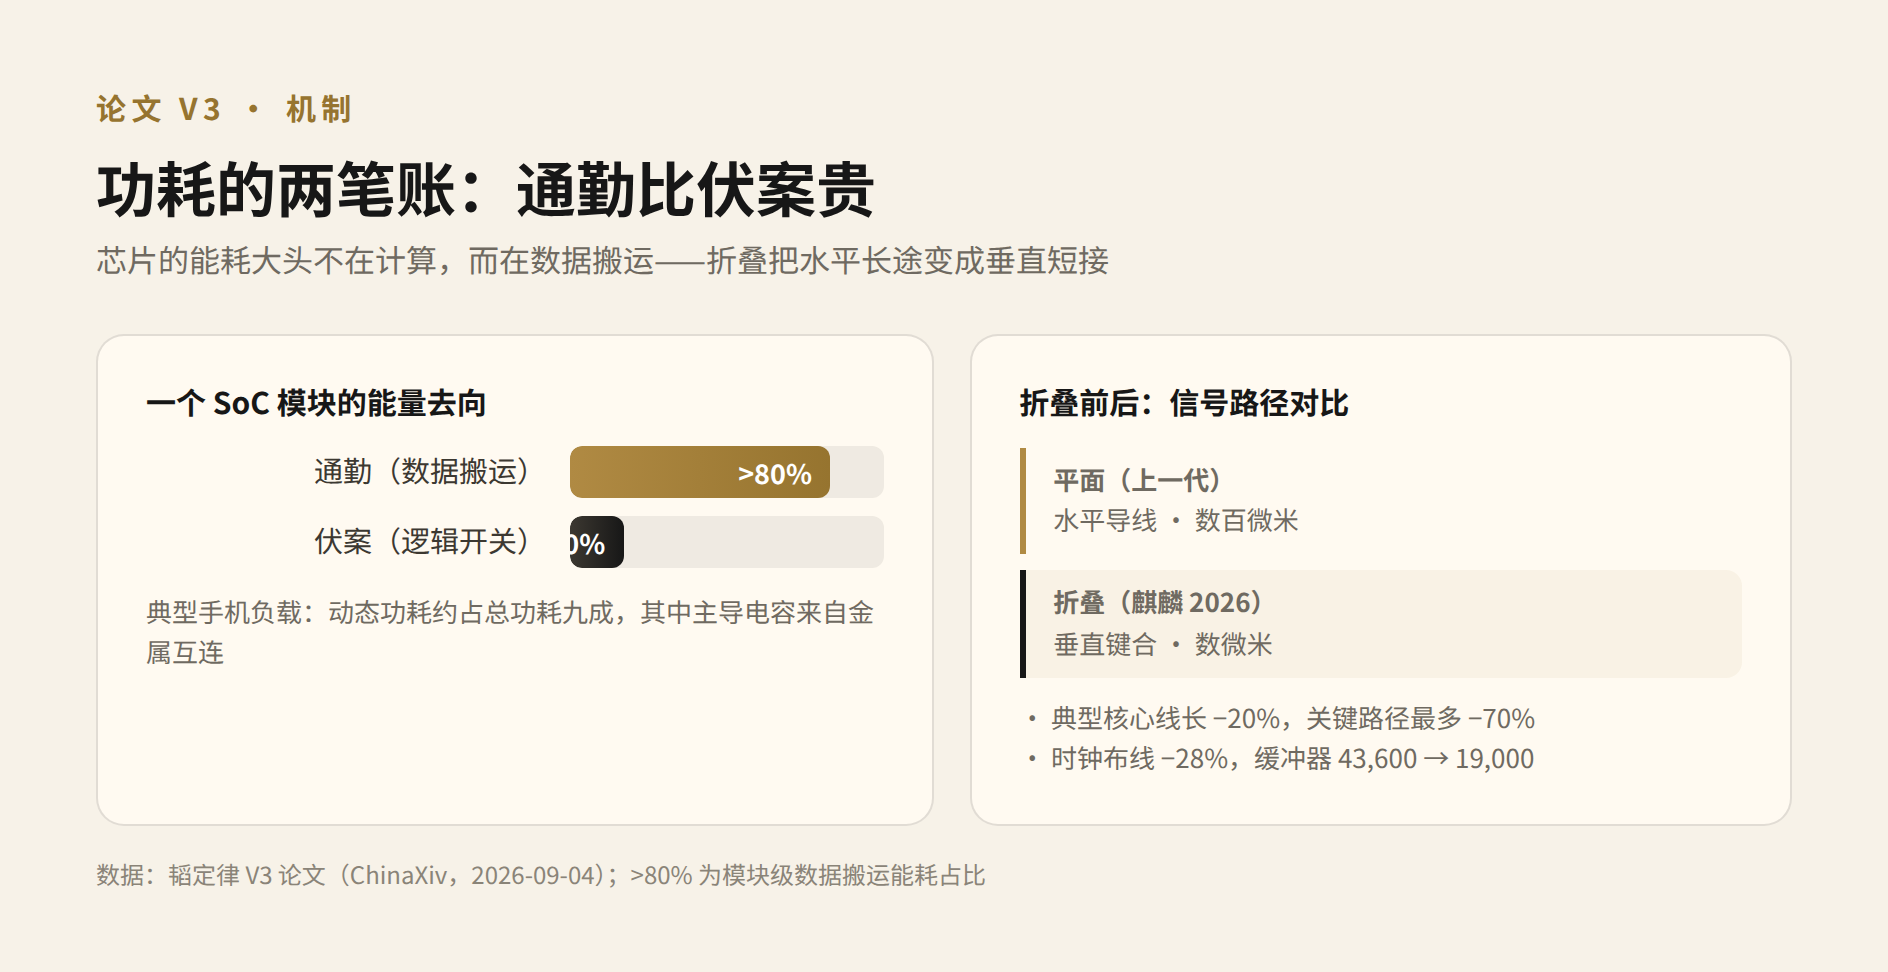
论证从功耗的构成开始。大多数人把芯片功耗理解为晶体管开关的功耗:逻辑门打开一次、关闭一次,消耗一次能量。论文把这叫「伏案工作」,即真正执行计算的部分。占主导的其实是另一部分:数据在存储器、缓冲区和运算单元之间搬运所消耗的能量,论文称之为「通勤」。论文给出的量化判断是,在大型 AI 集群中,超过 80% 的能耗花在数据搬运上,手机系统级芯片也有同样的不平衡,只是程度稍轻。典型手机负载中,动态功耗约占总功耗的九成,而动态功耗公式里占主导的电容项,主要来自金属互连,并非晶体管本身。
互连为什么这么贵,值得展开。在先进工艺节点上,晶体管本身的开关能耗已经压得很低,主导项变成给导线充放电的能量:导线越长,累积的寄生电容越大,信号每翻转一次,就要把这个电容充一次电、放一次电,能耗与电容成正比。导线长度与电容的这种关系,在几何微缩放缓之后被反复观测到,业界却很少把它当作核心变量。论文据此把缩短信号传输距离列为降低功耗的首要优化目标。
逻辑折叠直接降低的就是这笔搬运能耗。它把原本铺在平面上的电路折成垂直的两层硅,两层之间用混合键合连接。混合键合是在晶圆级把两层硅片的铜焊盘直接熔合的工艺,键合间距决定垂直互连的密度;麒麟 2026 达到 1.5 微米间距,垂直连接点之间的平均距离只有几微米。过去信号要沿几百微米长的水平导线穿行,现在通过键合盘垂直下落就能到达目的地。论文给出三组工程数据:典型处理器核心的导线总长缩短约 20%,关键路径最多缩短 70%;一个处理模块的时钟布线缩短 28%,时钟缓冲器从 43,600 个减少到 19,000 个。时钟网络是全芯片最繁忙、最耗电的信号网络之一,缓冲器数量减少一半以上,节省的正是驱动长导线所需的能耗。
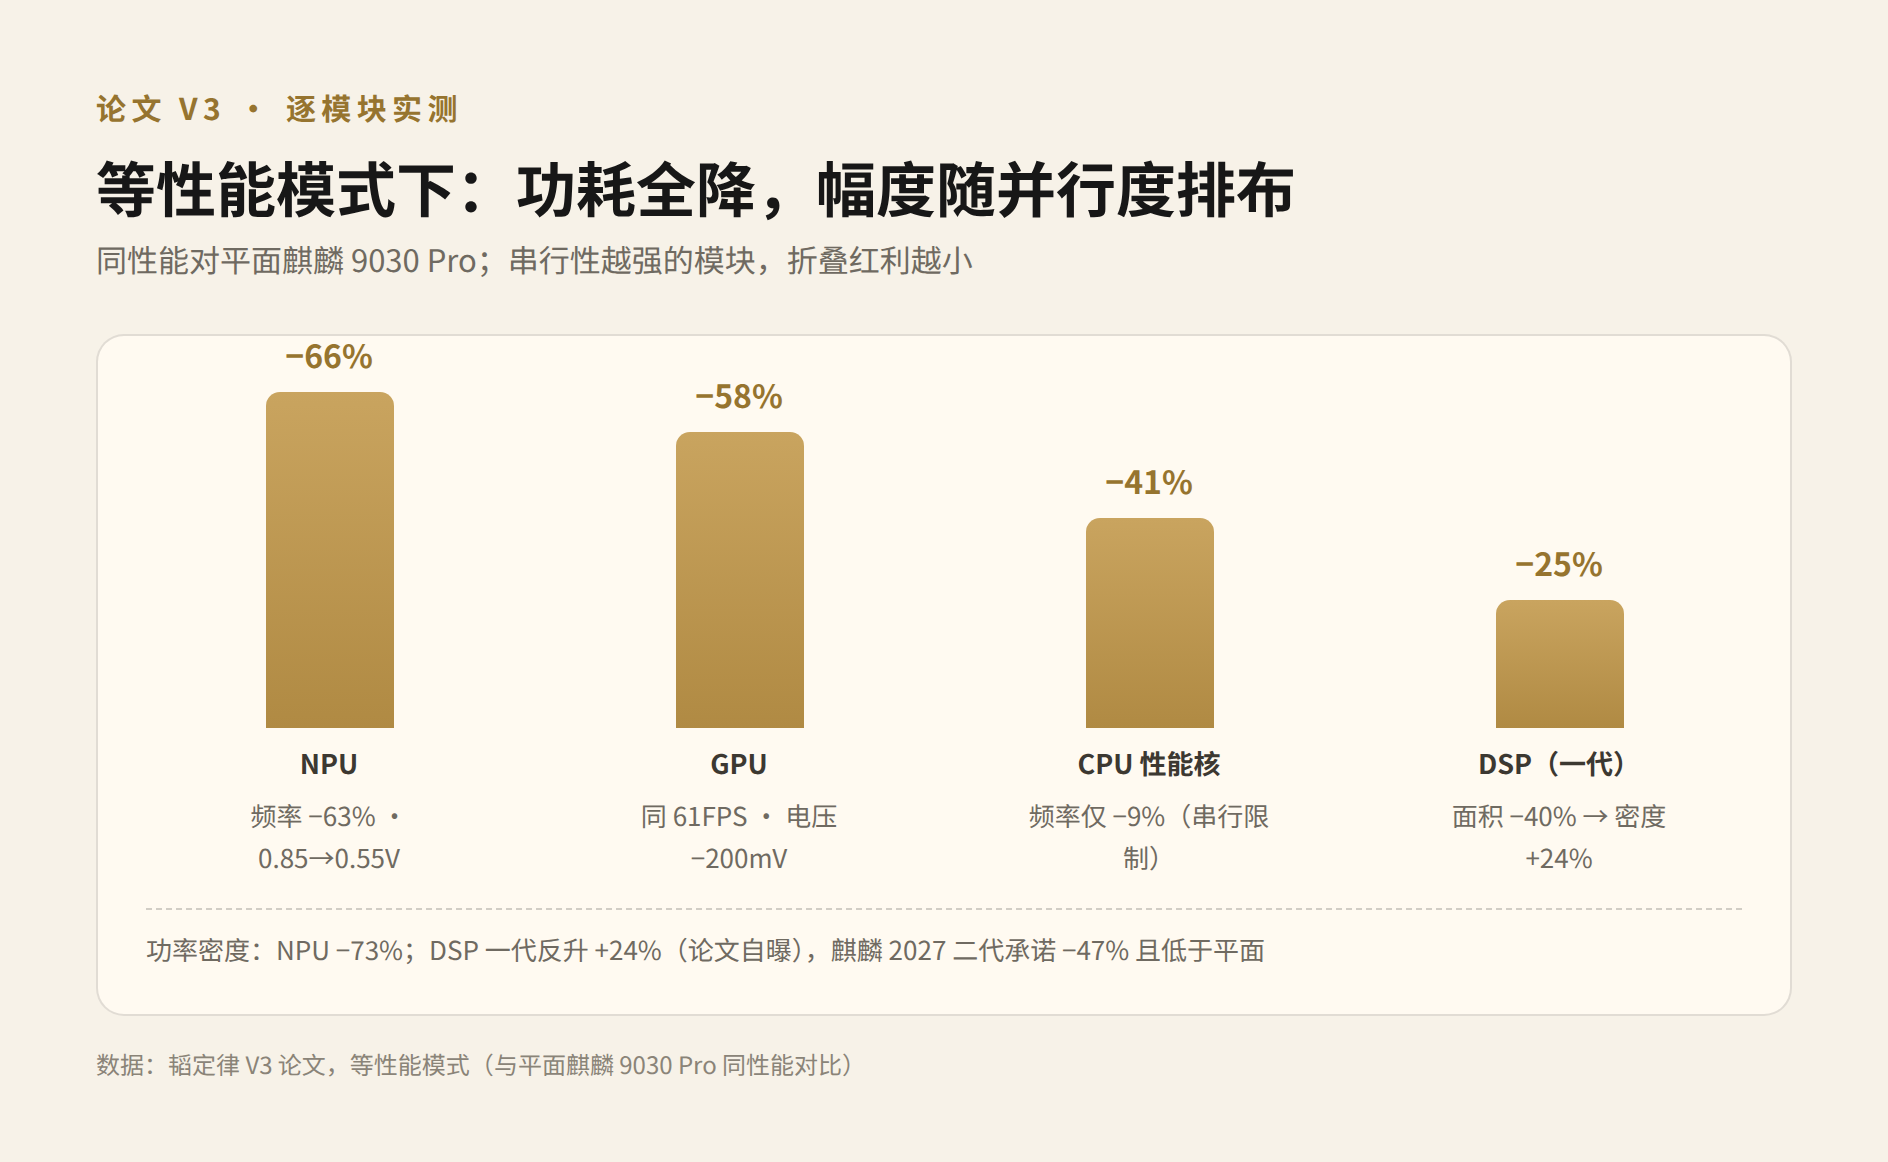
缩短导线之后,节省的余量还要经过一道平方级的放大。折叠腾出的面积装进了更多晶体管,对 NPU(神经网络处理器)、GPU(图形处理器)这类可以直接扩充规模的模块,双倍的晶体管密度意味着同等性能可以用双倍的电路规模、一半的工作频率来实现。频率降低之后,电路在每个时钟周期内拥有更充裕的时间完成信号传播,时序裕量允许供电电压同步下降。动态功耗与电压的平方成正比,因此电压每下降一个比例,功耗的降幅按平方关系放大。论文的旗舰例子:上一代 NPU 配置 1 个大核加 2 个能效核,折叠释放的晶体管余量让新一代放下 4 个大核,这个更宽的阵列在 0.7 伏电压下输出 70 TOPS(每秒 70 万亿次运算)。上一代全速运行也只有 29 TOPS,不到这个数字的一半,而且必须工作在 0.85 伏。论文用一句话概括这个机制:「更多硬件,以更温和的方式运行,完成更多工作。」
收益的边界由负载的串行性决定。论文引用阿姆达尔定律的硬件对应版本:程序中的串行部分决定并行化收益的上限,硅片中的串行关键路径同样决定哪些电路可以用并行度换电压。NPU、GPU 的负载高度并行、数据密集,折叠红利可以全额兑现;CPU(中央处理器)性能核的负载串行性强,收益受结构性限制,论文自己给出的数字是同等性能下频率只降低 9%、功耗降低 41%;DSP(数字信号处理器)的第一代折叠功耗降低 25%。四个模块的收益梯度:NPU 66%、GPU 58%、CPU 41%、DSP 25%,与各模块负载的并行程度整齐对应。这个梯度本身就是数据内部自洽的证据。
最后一环是热学论证的指标转换。论文认为批评者瞄准了错误的指标:总热量并不直接决定芯片的命运,起作用的是热密度;更准确地说,真正决定速度、漏电与可靠性的变量是晶体管结温。热量从晶体管结流经芯片各层再流向散热器,每一段路径都有热阻,结温近似等于功耗乘以热阻加上环境温度;芯片不会因为耗散了某个瓦数就失效,只会在结温越过工艺允许的上限时失效。折叠在这条物理链上有三重作用:同等性能下总功耗先降下来,热量从源头减少;功耗分布到两层有源硅上,单位体积的热流密度随之下降;热感知布局把发热模块与低功耗模块交错安排,避免热点在垂直方向直接叠加。论文的原话是:「真正的敌人不是平均温度,而是结温远高于邻近区域的局部热点。」麒麟 2026 只对收益最大的关键路径做选择性折叠,论文明确把这个设计定性为保守方案。
论证里还保留着两处刻意的诚实。DSP 的第一代折叠功耗降 25%、面积缩 40%,面积缩得比功耗快,功率密度反而上升 24%,论文没有回避这个数字,同时给出修复承诺:麒麟 2027 的第二代折叠将重新设计 DSP,功耗降 47%,功率密度低于平面版本。另一处是边界声明:τ 是时间缩放定律,不是能量缩放定律。低功耗来自一个主动的选择:把折叠赢得的时间余量投在降低电压上;如果把余量全部拿去提高频率,芯片照样会更耗电。论文的原话是:「一个折叠系统即使运行更快却消耗更多功率,也没有违反时间缩放原理——但它可能在午餐前就耗尽你的电池。」
直觉错在哪里,至此清楚了,一共三处:数的是逻辑门的数量,没有数导线的长度;算的是每平方毫米的功率,没有算每立方毫米的热流;看的是总发热量,没有看晶体管结温。论文用「西西弗斯,但这座山通向某个地方」作为技术章节的标题,承认这场工程攀登没有终点,同时指明方向。
二、关键结论与芯片指标检测点
论文的可贵之处在于大部分结论可检验。把论文主张整理成检测点清单,实测对照才有依据:
- NPU:同样达到 29 TOPS 时,频率降低 63%、电压从 0.85 伏降至 0.55 伏、功耗降低 66%、功率密度降低 73%。全速模式输出 70 TOPS,运行电压 0.7 伏
- GPU:同样达到每秒 61 帧时,电压降低 200 毫伏、功耗降低 58%。全速口径的性能提升约 42%
- CPU 性能核:同等性能下频率仅降低 9%、功耗降低 41%。峰值频率 3.1GHz(对上代 2.75GHz 推算提升约 13%),处理器架构未做改动
- DSP:第一代折叠在同等性能下功耗降低 25%、占用面积缩小 40%,功率密度上升 24%。2027 年第二代承诺功耗降低 47%、功率密度低于平面设计
- 晶体管密度:每平方毫米约 1.55 亿颗提高到 2.38 亿颗,增幅 55%
- 键合工艺:1.5 微米混合键合间距、全芯片 5,000 万个垂直互连,其中约 10% 到 15% 用于传输信号。麒麟 2027 的硅片已达到 1 微米间距、超过 1 亿个互连
- 时钟网络:布线长度缩短 28%,缓冲器从 43,600 个降至 19,000 个
- 路线图:三年内推进到 720 纳米间距、超过 2 亿个互连,之后指向 480 纳米。CPU 峰值频率从 3.1GHz 向 5GHz 以上推进
前四项的功耗与性能结果可以通过设备级基准测试近似验证,其中的电压、功率密度等硅片级子项除外。后四项依赖拆解分析或厂商内部数据,第三方暂时无法核验。
三、实测对照:哪里对上了,证明了什么是对的
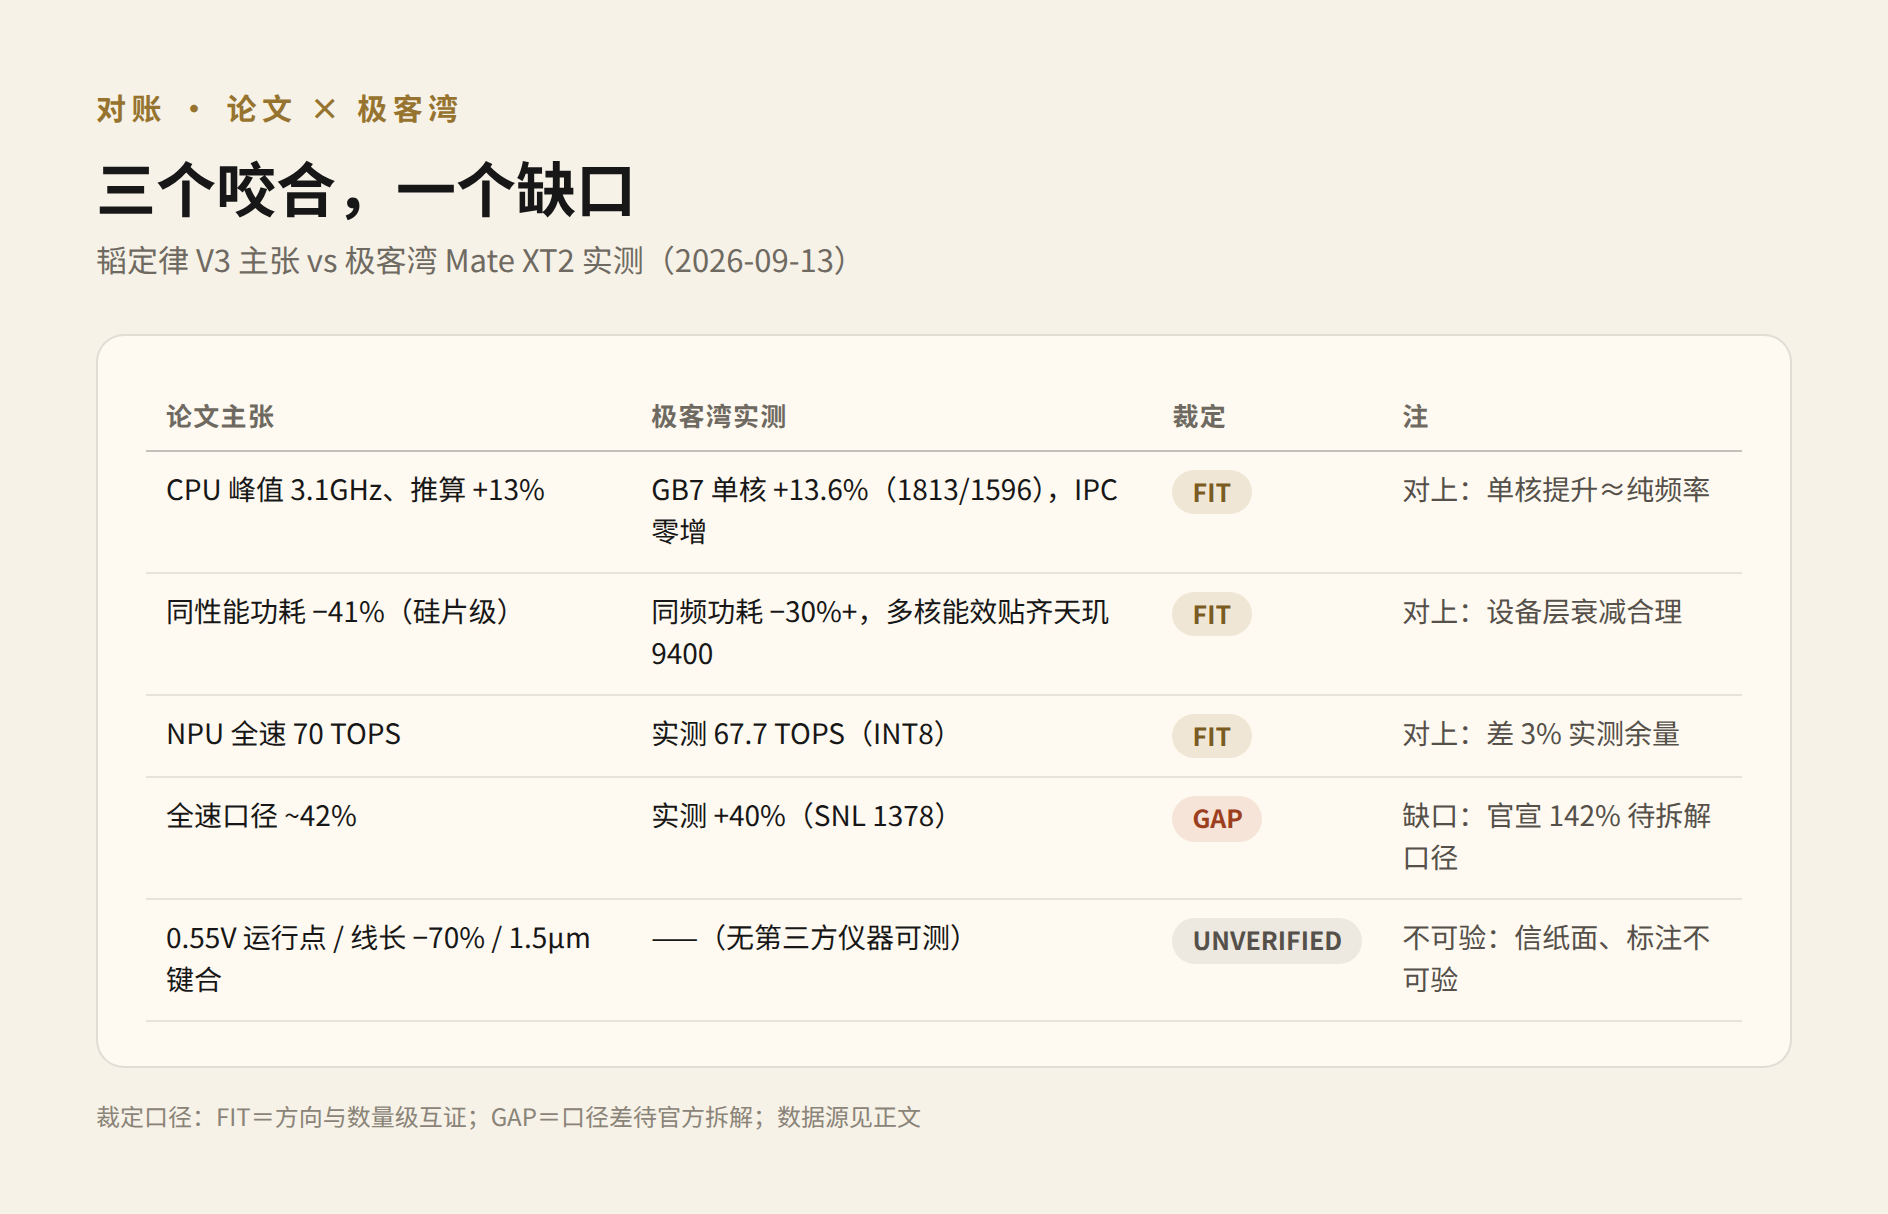
极客湾 9 月 13 日发布的完整能效实测(测试机型 Mate XT2)在方法上下了功夫:为鸿蒙系统移植了原生 SPEC CPU 2026 与 GeekBench 7 两套基准,能效曲线按频率逐点测出。对照之前先说明论文的取证口径,它决定对照的读法:每个模块报告两种模式,与上一代同等性能的模式和全速运行的模式,每种模式配五组数据(性能、频率、电压、归一化功耗、归一化功率密度),基线是平面结构的麒麟 9030 Pro。同等性能模式回答折叠让什么变便宜了,全速模式回答余量花在性能上能换到什么。发布会宣称的 142% 与论文的 42% 之所以相差三倍多,最自然的解释是两者分属不同的模式与基线,这一层看清楚,对照才能继续。
单核提升几乎等于频率提升:架构未动得到直接证明,串行限制得到印证。 GeekBench 7 单核 1813 分对 9030 Pro 的 1596 分,提升 13.6%;论文记载 CPU 峰值频率恢复到 3.1GHz,对 9030 Pro 的 2.75GHz 推算提升约 13%。每时钟周期指令数(IPC)零增长、单核成绩提升 13.6%,两组数字几乎严丝合缝。这组数据同时吻合两个预测:论文「架构不变」的声明被直接证明属实,每时钟周期指令数零增长正是这项声明的直接读数;理论预测的收益梯度里,CPU 受串行负载限制、拿不到规模红利,这一条在设备上得到印证。这是全部对照中说服力最强的一组数据。
同频功耗下降三成以上、能效跨越三个梯队,证明等性能下的功耗下降不是纸面数字。 极客湾实测同频功耗较 9030 Pro 下降超过 30%,多核能效曲线与联发科天玑 9400 处于同一梯队,即当前手机处理器的能效第一梯队;论文硅片级的数字是 CPU 性能核在同等性能下功耗降低 41%。设备级的 30% 对硅片级的 41%,中间隔着供电转换、外围电路与整机开销,衰减幅度合理。两代之间从能效落后三个梯队到进入第一梯队,与论文「相当于三年几何微缩」的自我标定在量级上对得上。
NPU 实测 67.7 TOPS 对论文 70,证明全速模式规格真实落地。 差距 3% 属于实测对理论的正常余量(INT8 量化口径,即 8 位整数精度);同一能力还有应用侧的佐证:300 亿参数的混合专家架构全模态模型就在这颗芯片上运行。GPU 的规模路线同样得到印证:FP32(32 位浮点精度)吞吐从 1.4 提高到 2.2 TFLOPS(每秒万亿次浮点运算),3DMark Steel Nomad Light 得分 1378,较上一代提升约 40%。
一个缺口:发布会与论文的统计口径差。 发布会宣称 GPU 渲染性能提升 142%,论文全速口径约 42%,极客湾实测 +40% 与论文吻合、与发布会相差三倍多。142% 的基线里大概率同时叠加了 GPU 架构升级的贡献,逻辑折叠本身只对应其中一部分;这笔账怎么拆,要等华为自己给出统计口径。这是整场对照中唯一悬而未决的数字。
另有一批数据第三方无法核验:NPU 的 0.55 伏运行点、关键路径导线缩短 70%、1.5 微米键合与 5,000 万垂直互连。密度口径也需要单独标注:238 MTr/mm²(每平方毫米百万颗晶体管)是华为口径,第三方按行业通行的 Bohr 口径换算约 175,台积电 N2 工艺为 313,横向比较之前先对齐口径。这些内部硅片数据只能按论文记载采信并标注不可验证。实测数据同样需要折价看待:GeekBench 7 虽经极客湾移植,运行时超大核与中核仍被系统调度策略限制频率,三折叠形态的散热结构也制约性能释放,极客湾测得的曲线大概率是保守配置的下限,第三方后台数据显示实际性能高出测得值 10% 到 15%。
四、从测试数据读芯片的潜力
对照完成之后,测试数据里还能读出这颗芯片的余量,共五处。
频率有余量。极客湾观察到 3.1GHz 频点没有带来显著功耗增加,仍处于能效曲线的有效区间,提高频率仍能换来足够的性能增长。这说明处理器的频率上限尚未触及,论文路线图把 CPU 峰值频率指向 5GHz 以上,当前 3.1GHz 的落点给这条路留出了物理空间。
能效有余量。一代之间从落后三个梯队进入第一梯队,而这还是保守配置的成绩:麒麟 2026 只对收益最大的关键路径做选择性折叠,论文明确将其定性为保守方案。全速规格的 9050 Pro Max 尚未发布,Mate 90 系列直板形态的散热条件,才是这颗芯片完整释放的前提。
测量有余量。GeekBench 7 未适配鸿蒙带来的频率限制,加上三折叠形态的散热约束,两项合计压低测得值 10% 到 15%。当前看到的成绩仍是被测量环境压制后的结果,并不代表芯片的实际上限。
跨代有余量。2027 年的 1 微米键合第二代折叠已经流片,垂直互连数量从 5,000 万跨过 1 亿;DSP 功率密度上升 24% 的修复,取决于这一代能否兑现承诺。键合间距向 720 纳米和 480 纳米推进的路线已经写进论文,密度提升的路径还很长。
芯片之外还有系统因素。极客湾的结论强调,麒麟 9050 Pro 与鸿蒙 7 软硬协同后,游戏体验已经达到骁龙 8 至尊版的水平,其中系统调度的贡献不小于芯片本身。芯片的最终潜力,等于芯片能力乘以系统把它释放出来的能力。
总结与判断
事实链:韬定律 5 月 25 日在 ISCAS 提出,以六年 381 款芯片的设计量产实践为基础。第三篇论文 9 月 4 日以散热质疑为题,用麒麟 2026 的逐模块实测作答。9 月 7 日芯片随 Mate XT2 上市,9 月 13 日极客湾完成第三方实测。三个判断:
一、反直觉的结果有真实机制,机制的名字叫规模换电压。 逻辑折叠带来的收益并非来自单晶体管层面的改良——单核提升 13.6% 全部来自频率,这个数据点恰恰证明了这一点:应该不变的地方(每时钟周期指令数)确实没变,应该变化的地方(能效)确实变了。同等性能下 NPU 功耗降 66%、GPU 降 58%、CPU 降 41%,是电压平方算术在起作用,而这笔算术对任何拿到双倍密度的设计都成立。折叠还有另一半收益,是单纯的密度翻倍拿不到的:它同时降低了数据搬运能耗本身,导线长度与时钟网络的缩短直接来自折叠的三维几何。两条收益叠加,折叠的价值才算完整:这是华为手里不依赖新一代光刻设备的可行路径,既拿到双倍密度,又缩短了导线。
二、论文的写法本身是产业信号。 公开 DSP 功率密度反升 24%,承认 CPU 串行负载的局限,为定律划定边界(时间缩放不等于能量缩放),把下一代的修复承诺写进论文正文。这是路线论证的写法,宣传稿不会这么写。发布会 142% 与论文 42% 的口径差,反而衬出论文数字的可信度。
三、最终检验在 Mate 90,判据有两个。 三折叠上的全部印证来自保守配置与较大的散热面积,全速规格的 9050 Pro Max 在直板手机上的能效曲线才是真正的压力测试。2027 年 1 微米键合的第二代折叠能否兑现 DSP 密度修复,是这条路线能否像摩尔定律那样一代代复制进步的最直接判据。
后继关注点,按可验证程度排序:Mate 90 系列上 9050 Pro Max 的全速能效曲线。麒麟 2027(1 微米键合、第二代折叠)的实测数据。发布会 142% 的口径拆解。GeekBench 7 适配鸿蒙后的复测。
(本文事实与数字截至 2026 年 9 月 14 日,均出自文中引用的论文与公开报道;文中判断为社论观点,不构成投资建议。)