9 月 22 日上午,杭州云栖大会主论坛。阿里巴巴 CEO 吴泳铭给了两个判断、一个比喻。
判断一:机器的思考总量,将达到人类的 1000 倍以上,今天这个比例还不到 3%。他的参照是动力革命:机器动力已承担 99.9% 的物理工作,思考预计也将承担 99.9%;从现在到人类的 1000 倍,中间还有数万倍的增长空间。判断二:机器智能时代的代表性产品,还没有出现。比喻是:今天的 AI 编程,只相当于 1882 年的电灯。爱迪生在珍珠街点亮第一座商用电站时,人们用它替代煤油灯;空调、冰箱、洗衣机的登场,是几十年后的事。
三个说法指向同一件事:思考正在变成可以规模化生产的商品,而行业还处在「电站刚建成」的阶段。对全栈厂商来说,接下来的问题很具体:电站怎么建、电网怎么铺、电用什么发。
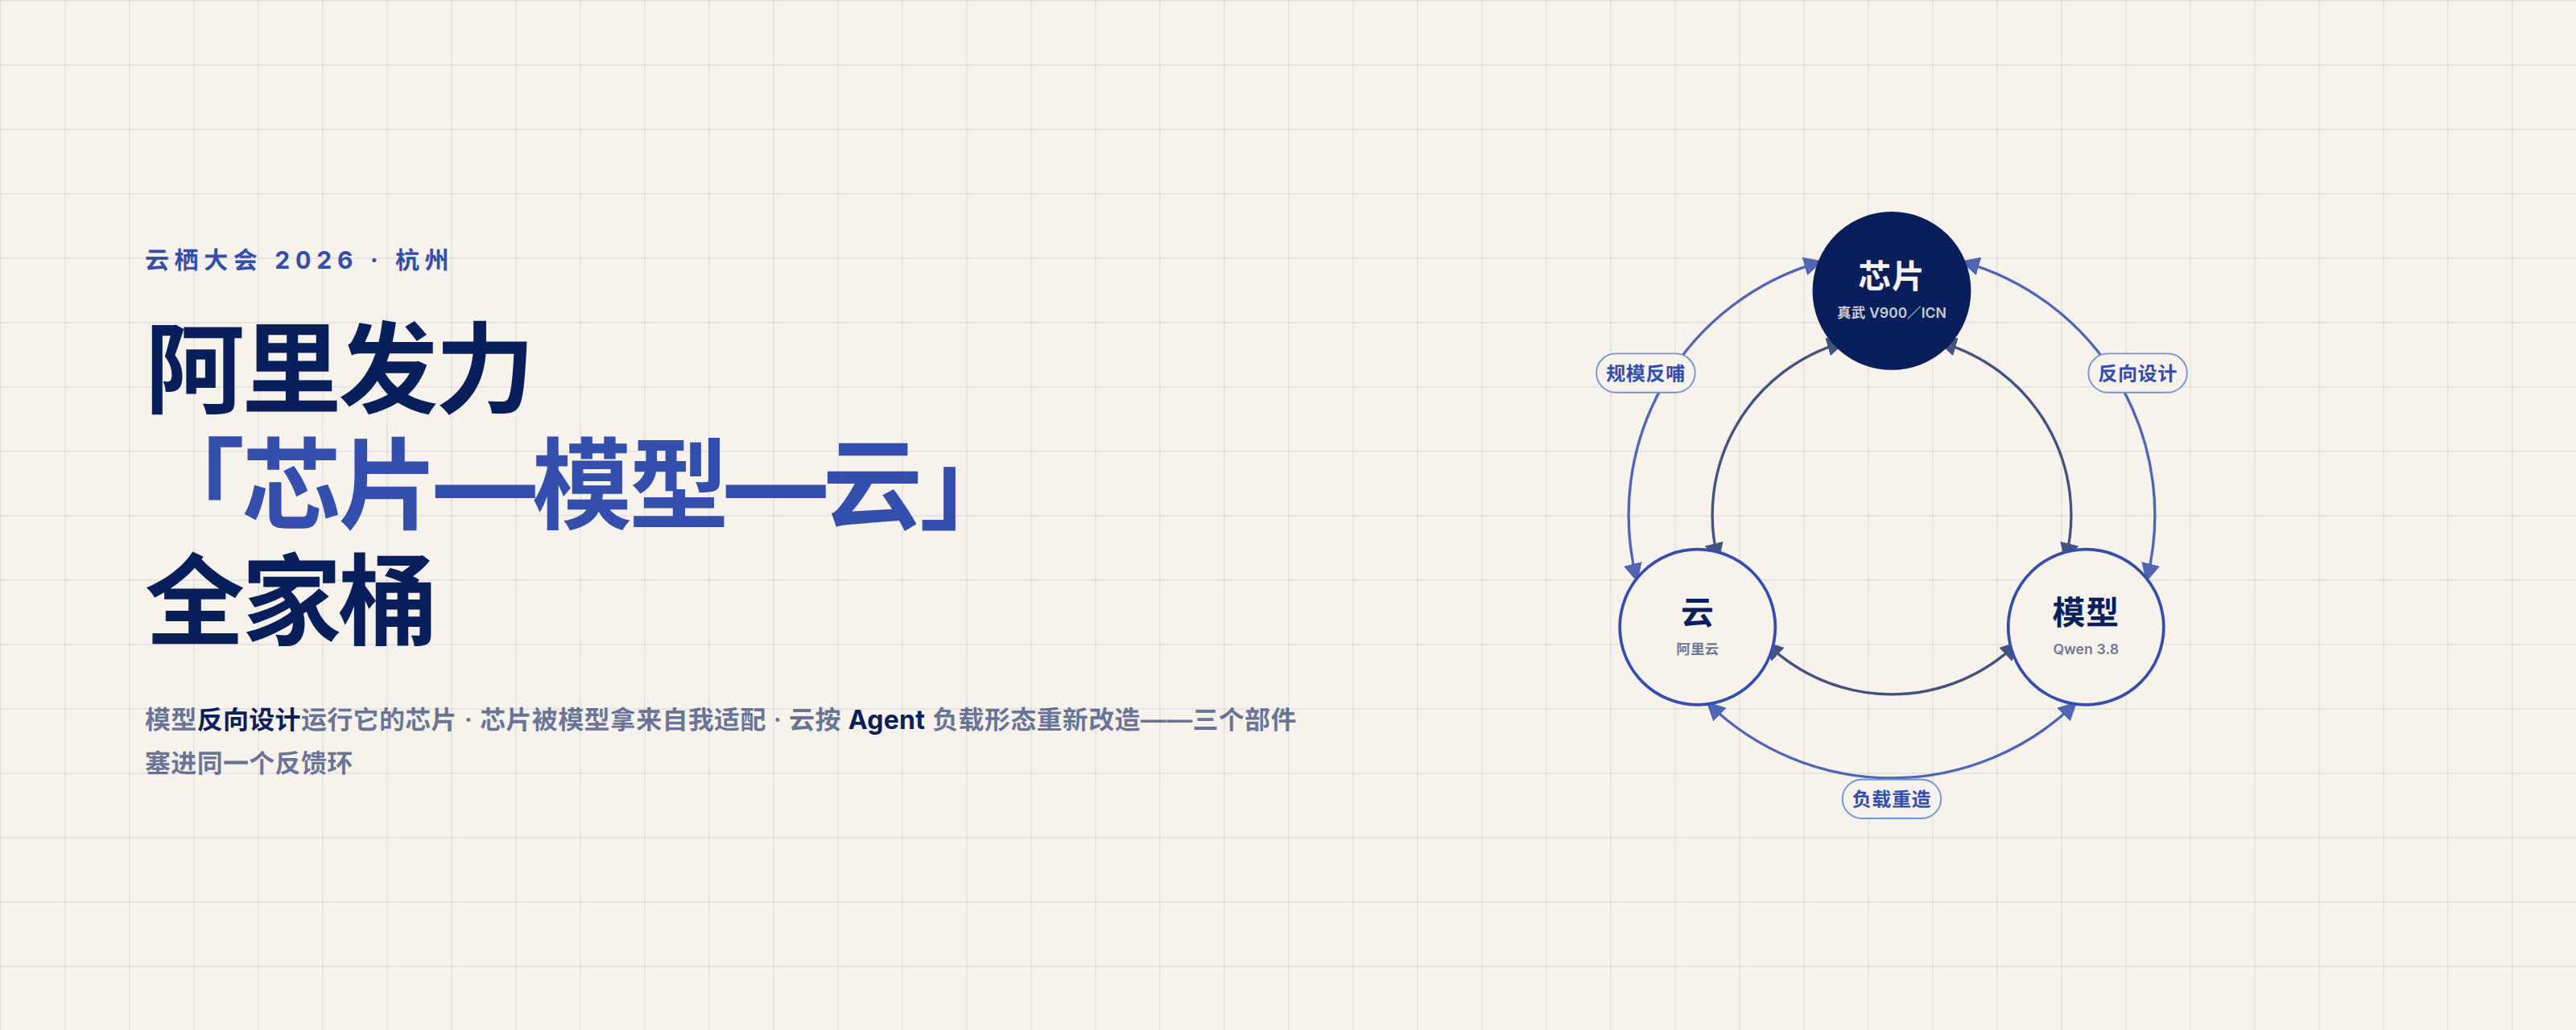
阿里给出的回答,是一条环环相扣的链条:模型在变强,并开始反向设计运行它的芯片;芯片与系统在变强,又被模型拿来自我适配;云则按照智能体(Agent)的负载形态重新改造自己。本届大会上,这条链条第一次被拆成一串具体数字:芯片代际性能 ×3、AI 存储成本 -69%、模型零人工干预迭代 33 轮、单一集群 50 万卡。
作为国内少数同时在自研 AI 芯片、大模型和 AI 云上重注的厂商,阿里如何组织这三块,对国产算力生态有参照意义。本文按芯片、模型、云三块展开,回答四个问题:真武 V900 的「3 倍」成色如何?把它与华为昇腾 960、NVIDIA B300 放在一起,三条路线各选了什么?Qwen 的「自我迭代」改了什么、可信度如何?一朵「为 Agent 重造」的云,真正改变的是什么?
芯片:3 倍性能、216GB,和一张没有绝对值的规格表
真武 V900 是平头哥第三代的训推一体 AI 芯片。按官方说法,它单芯片性能是上一代真武 M890 的 3 倍,搭载 216GB 显存,片间互联带宽 1200GB/s,原生支持 FP8、FP4 低精度计算,可同时覆盖高精度训练和低精度、超低精度推理。量产时间定在 2027 年第一季度,比原计划提前约两个季度;官方称它是目前算力性能最强的中国自研 AI 芯片。
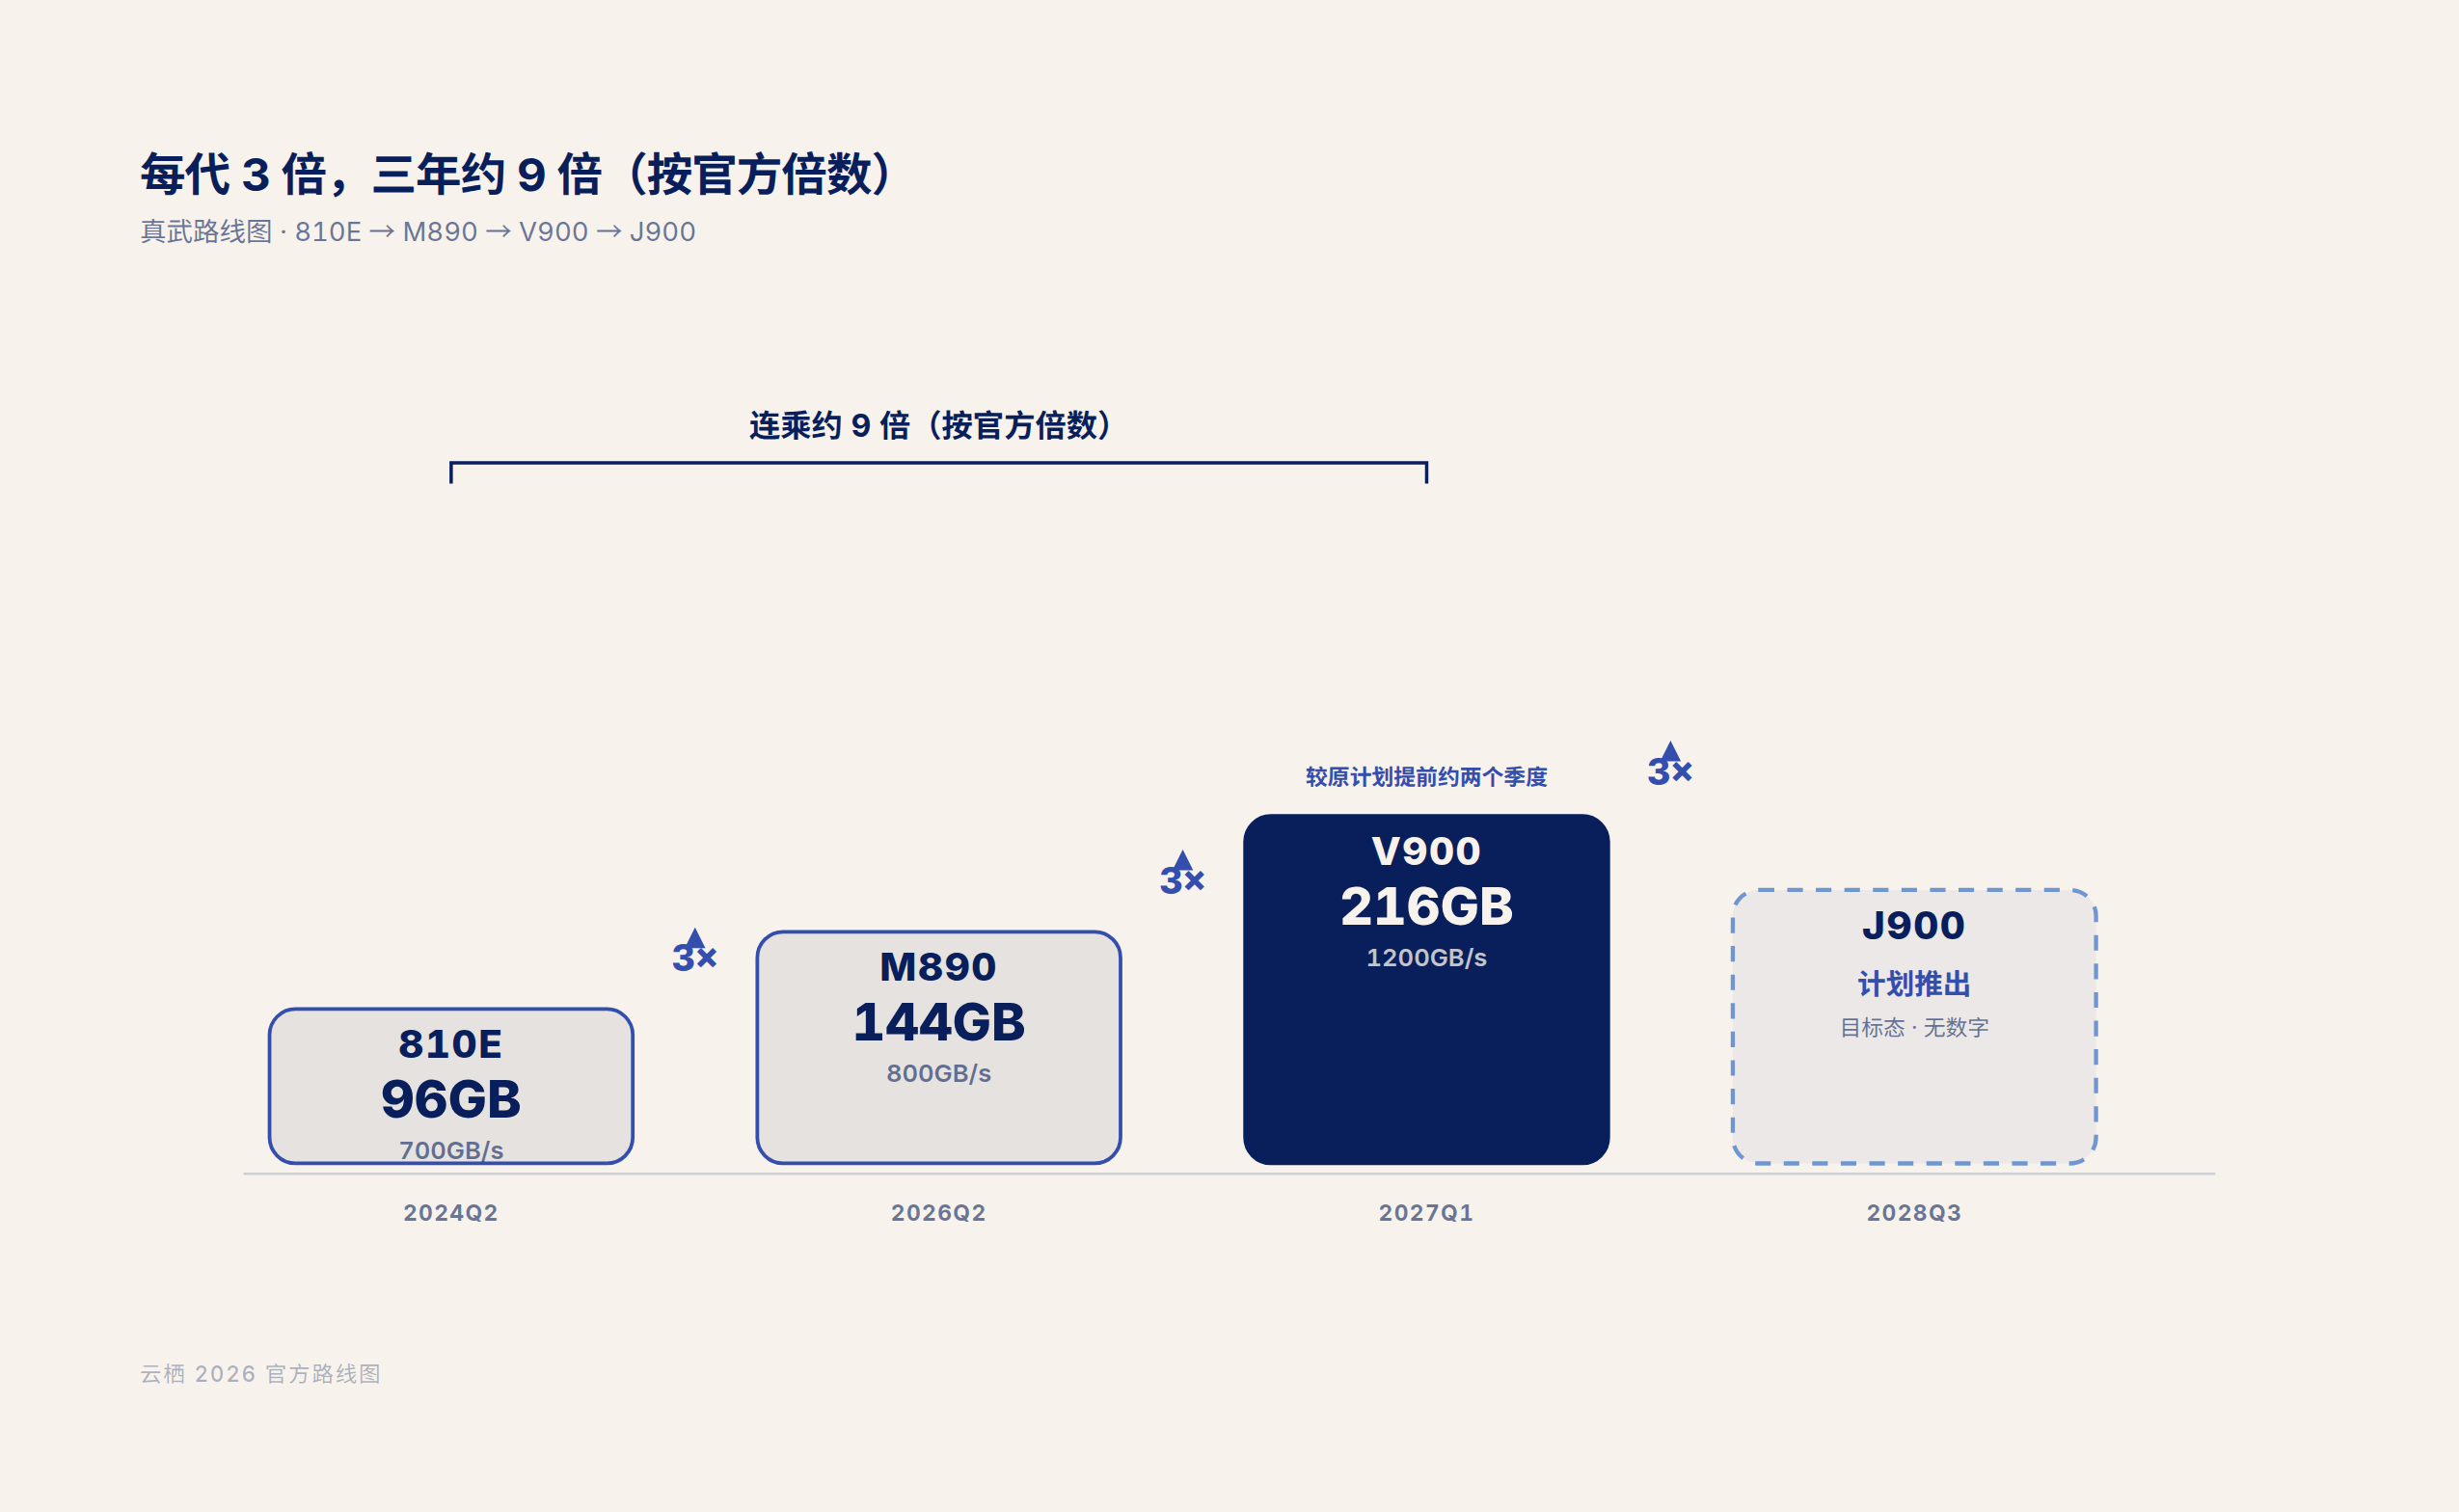
把路线图连起来看,迭代节奏比单点参数更有信息量:2024 年的 810E(96GB 显存、700GB/s 互联)→ 2026 年二季度的 M890(144GB、800GB/s,性能 3 倍于 810E)→ 2027 年一季度的 V900(216GB、1200GB/s,再翻 3 倍)→ 2028 年三季度计划推出的 J900。一年一代、每代翻三倍,按官方倍数连乘,从 810E 到 V900 约 9 倍。这个节奏已经跑了三代。商业面上,截至 4 月,真武系列累计出货 56 万片;截至 6 月,服务客户超过 650 家。按 IDC 统计的 2025 年数据,平头哥在国产云端 AI 加速器厂商中位列第二,份额约为 16%。
但整场发布留了一个空白:从头到尾没有给出绝对算力数字。单卡多少 TFLOPS、什么精度下的多少 PFLOPS,这些常规披露一律缺席。「3 倍」也没有限定条件:什么精度、稠密还是稀疏、按单芯还是整机。对习惯看算力表的读者来说,这张规格表是缺了一列的。
缺列可以有另一种读法:等 V900 和昇腾 960 在同一个交付窗口里碰面,外界自然会用同一张表把它们补齐。目前能做的横向锚定是容量与互联:216GB 显存加 1200GB/s 片间带宽,大致是谷歌上一代 TPU v7 的量级,略有超出(据未尽研究整理)。
50 万卡:把跨服务器的通信,做进内存语义
单卡数字之外,V900 发布真正的主角是系统。当集群规模上万卡,芯片之间的通信会吃掉大量训练时间,华为公开的估算是四成以上;单卡再快,系统跟不上也是空转。平头哥给出的解法是 ICN Switch 互联芯片:在超节点(把上千张卡用高速互联搭成的一台逻辑计算机)里,让卡与卡之间具备原生内存语义和内存统一编址能力,实现千卡全带宽高速互联,统一显存规模达到百 TB 级。用大白话说,上层软件不必再关心数据放在哪台服务器上,上千颗 V900 更像一颗「超级芯片」。配合新一代超节点服务器(内含 V900、ICN Switch、磐脉 920 智能网卡、镇岳 510 存储主控),单一集群可扩展到 50 万卡。
同一天下午,阿里云还发布了磐久 AL64,全球首个把 SNPO(Scale-Up NPO,面向多卡紧耦合互联域的近封装光学)做进产品的超节点服务器:单机 64 卡、无收敛扩展至 1024 卡,把光模块从机柜面板搬到计算芯片旁边。动因是铜的传输距离在超大规模 Scale-Up 域里已经不够用;而 SNPO 由阿里云与开放数据中心委员会(ODCC)牵头开放,不绑定任何一家的计算芯片与交换体系。开放的另一面是等待:规范给多厂商留了接口,落地速度要看生态里有多少人真的跟进。曦智科技同场首发了 3.2T/6.4T 的 SNPO 硅光芯片。
在售的这一代没有闲着:基于 M890 的灵骏超节点已在乌兰察布首批开服,将扩容到宁夏中卫,跑通了 Qwen3.8-Max、Kimi K3 等超过 2 万亿参数的模型,今年第四季度还会新增服务节点。
三种拼法:V900、昇腾 960 与 B300
过去一个月,三家公司先后交代了 AI 基础设施的下一步:华为在 9 月 17 日的全联接大会上发布昇腾 960 超节点,NVIDIA 的 B300 已量产出货,阿里在本届云栖亮出 V900。把三家的牌摆上同一张桌,最先撞进视线的是趋同:华为说「把竞争单位从单颗芯片扩大到整个系统」,阿里说「像一颗超级芯片」,NVIDIA 的机柜级方案叫 NVL72。三家都在把「一台计算机」往前推。
先看单卡:
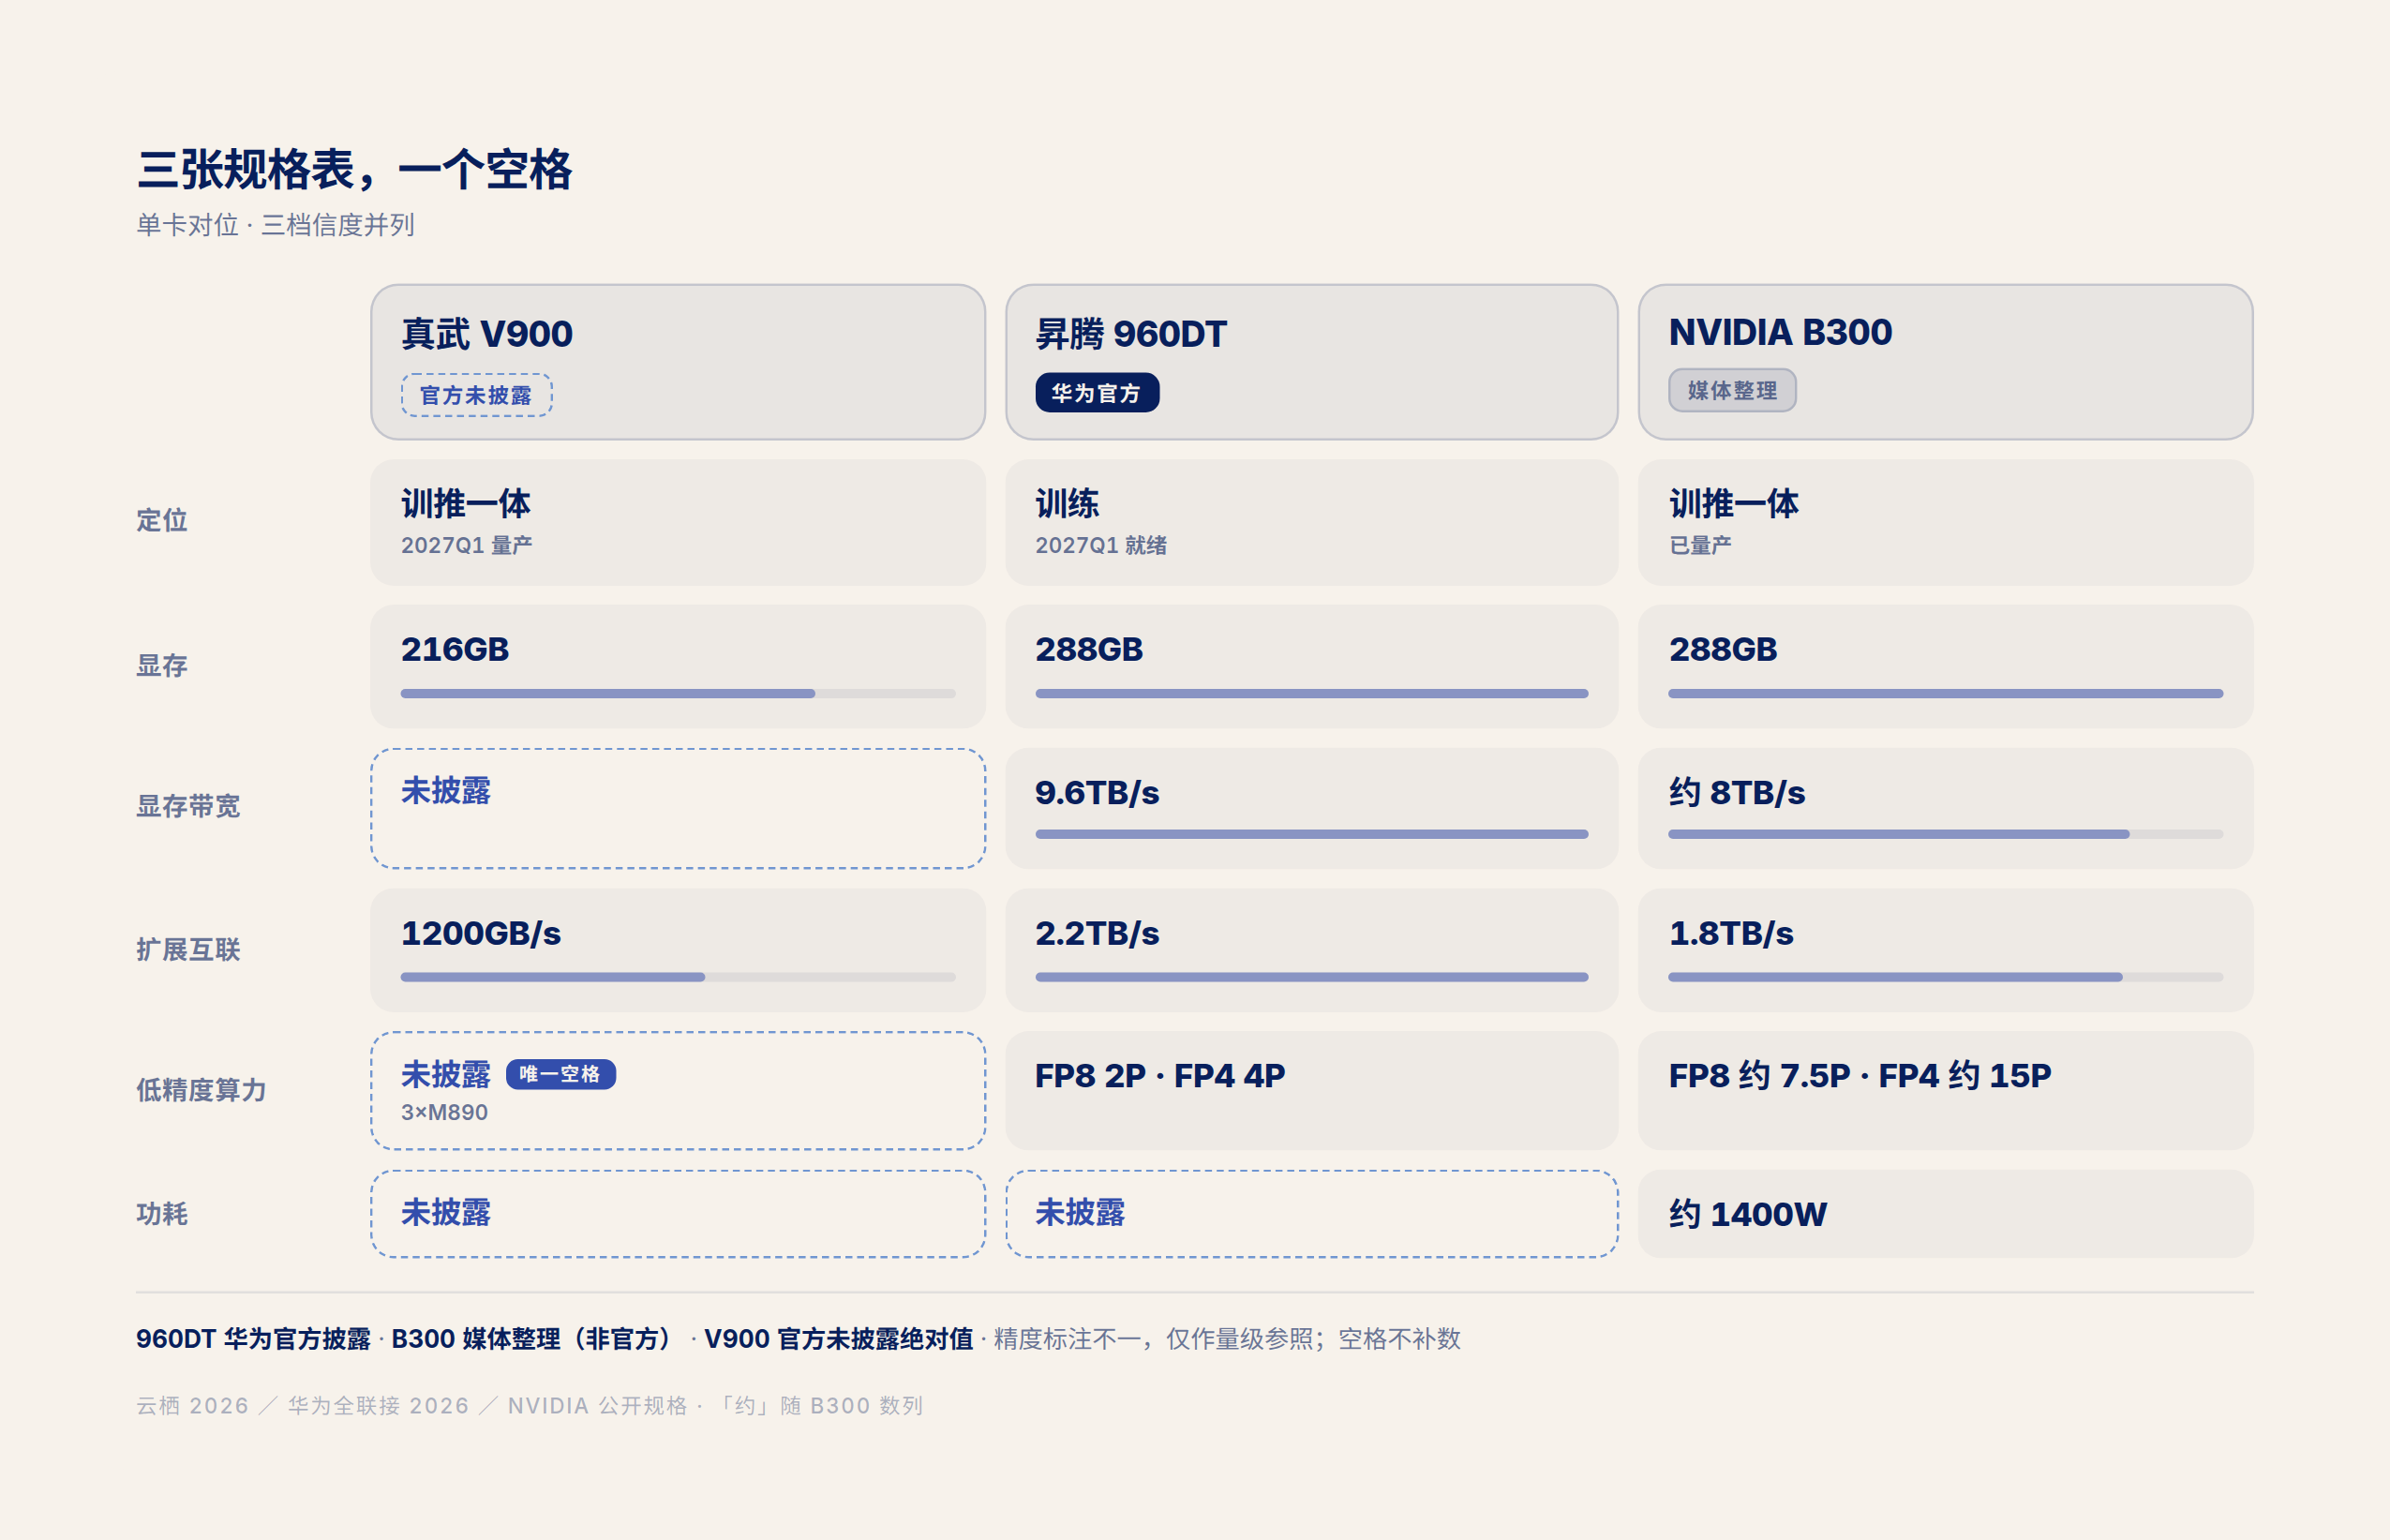
| 真武 V900 | 昇腾 960DT | NVIDIA B300 | |
|---|---|---|---|
| 定位 | 训推一体,2027Q1 量产 | 训练,2027Q1 就绪 | 训推一体,已量产 |
| 显存 | 216GB | 288GB HBM | 288GB HBM3e |
| 显存带宽 | 未披露 | 9.6TB/s | 约 8TB/s |
| 扩展互联 | 1200GB/s(片间) | 2.2TB/s | 1.8TB/s(NVLink) |
| 低精度算力 | 未披露(3×M890) | FP8 2P/FP4 4P | FP8 约 7.5P/FP4 约 15P |
| 功耗 | 未披露 | 未披露 | 约 1400W |
三点值得细读。容量上,216GB 对 288GB,V900 小一档,而单卡容量直接决定万亿级参数模型的切分策略;互联带宽上,昇腾 960 的 2.2TB/s 是三者最高,超过了 B300 的 NVLink,这背后是华为对联接的押注:用 5500 颗 Hi-ONE 近封装光引擎替换 4.8 万颗可插拔光模块,功耗降低超过 550 千瓦;而算力一栏,只有 V900 是空的。
再看系统。华为昇腾 960 超节点单域 4096 卡,提供 8 EFLOPS FP8 算力与 1PB 内存,域内往返时延最低 2 微秒;多个超节点组网后,最大集群规模 51.2 万卡,配合多轨道拓扑可望向 100 万卡扩展。阿里这边,V900 超节点以「千卡全带宽 + 统一编址」为特征,集群上限 50 万卡,并用 SNPO 把光接进 Scale-Up 域。NVIDIA 的策略仍是机柜优先:NVL72 一台机柜 72 颗 GPU、铜缆全互联,机柜之间用 InfiniBand/Spectrum-X 组网。
两条中国路线的相似度值得单独标注:都把光互连推进到近封装,都把集群上限公开翻过 50 万卡,也都选择了「统一内存编址」这个说法。按《超节点定义与实践白皮书》(鹏城实验室与全球计算联盟牵头、38 家单位参与,2026 年 7 月发布),这正是超节点区别于传统集群的核心特征:让几千张卡在软件眼里像一台机器。区别在于光的用法:华为用自研 NPO 光引擎替代可插拔模块、追求低功耗;阿里用开放 SNPO 规范解耦供应链、给多厂商留接口。NVIDIA 的答案暂时是「把机柜做小、把机柜内带宽做大」,光留在机柜之间。
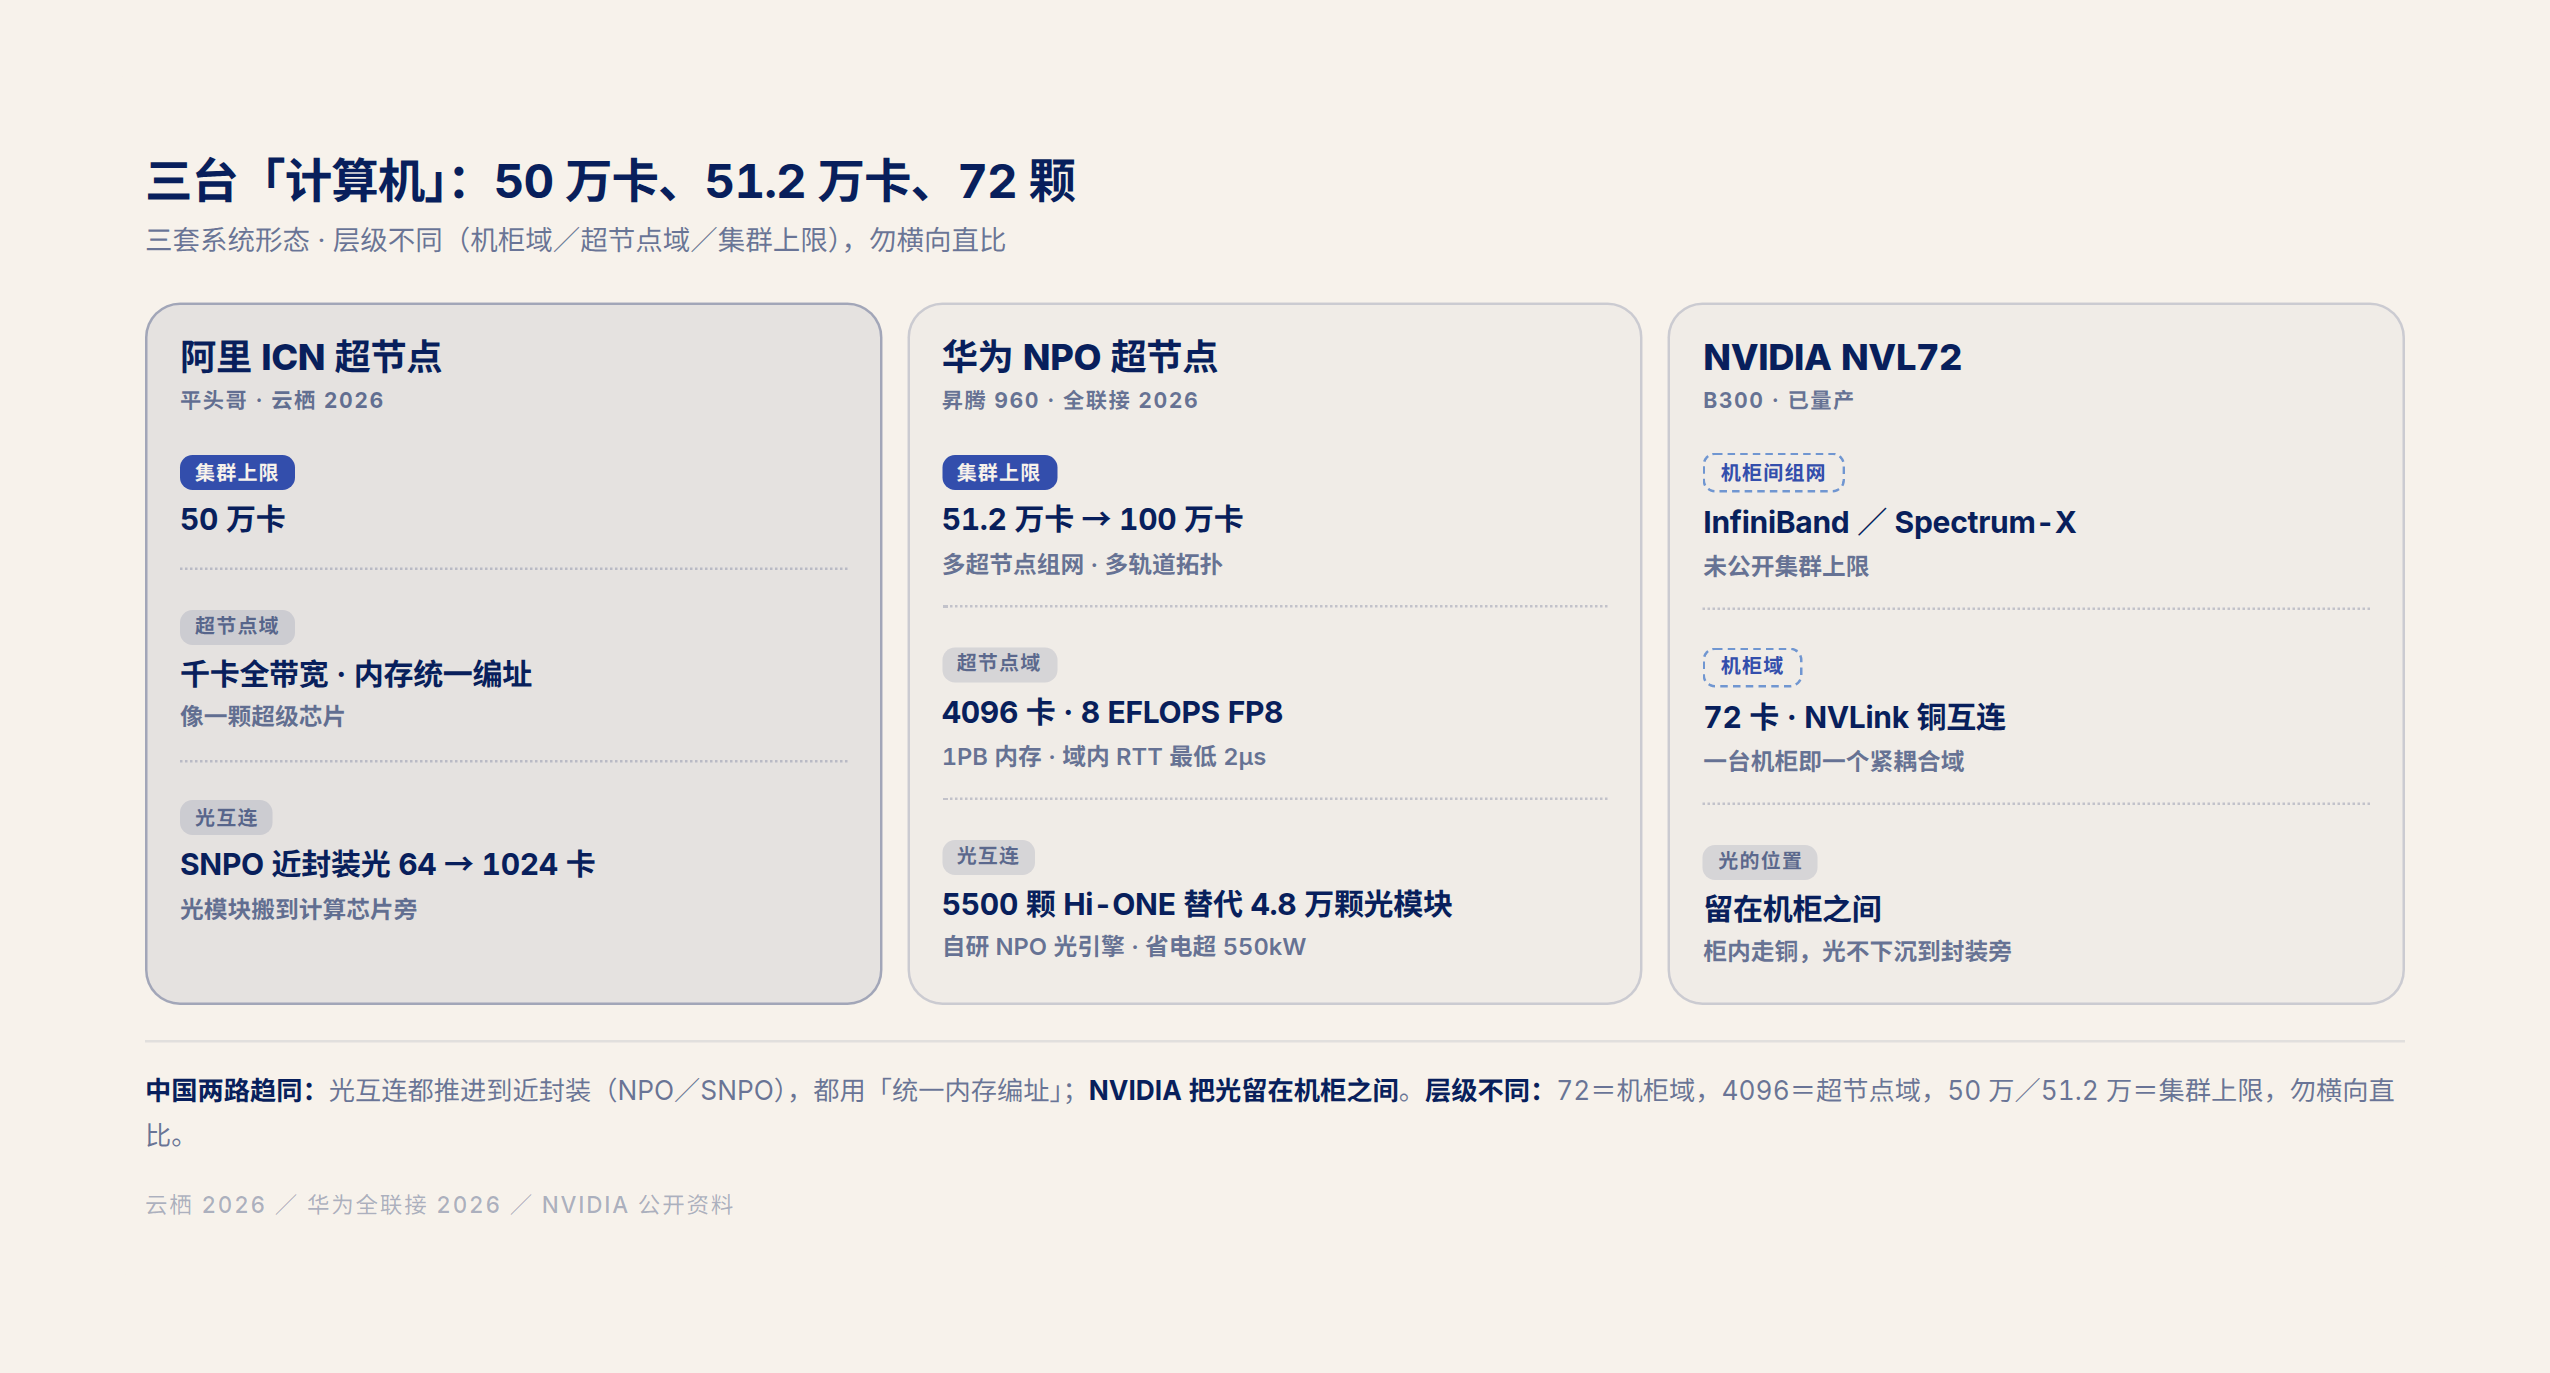
最后是时间表,它把三家拉到了同一个考场:960DT 与 V900 都指向 2027 年第一季度,B300 已量产在售、下一代产品爬坡中。那是第一次可以用同一批公开数据做三方实测的窗口:能不能准时交付、软件栈是否就绪、超节点在真实训练任务里能否兑现理论算力,都会在那时见分晓。需要说明的是,上表三种信度并存:昇腾 960DT 为华为官方数字,B300 为媒体整理数字(非官方披露),V900 无绝对值披露。几家在稠密或稀疏等精度细节上的标注也不一致,同表并置只作量级参照。
补位的芯片们:CPU、网卡与存储主控
芯片故事还有第二层:V900 只是平头哥全栈矩阵中的一块。同场首次公布路线图的倚天服务器 CPU,指向一个判断:Agent 时代,CPU 回到了关键路径。任务规划、工具调用、代码沙箱、检索编排都依赖单核性能与内存带宽。为此,2027 年的倚天 730 采用全自研微架构、单核性能最高提升到倚天 710 的 1.4 倍,倚天 720 则以 192 核支撑大规模并发;再往后的倚天 750 会通过 ICN 总线与真武芯片直接互联。加上磐脉 920 网卡、镇岳 510 存储主控与 ICN 互联芯片,平头哥已把数据中心的核心芯片补齐。软件侧,2026 年 7 月开源的底层软件栈覆盖率超过 96%,主流框架上游版本到完成适配平均不超过一周,这是国产芯片过去最容易被卡住的环节。
模型:自我迭代,开始改到硬件头上
RSI:把实验循环交给模型自己
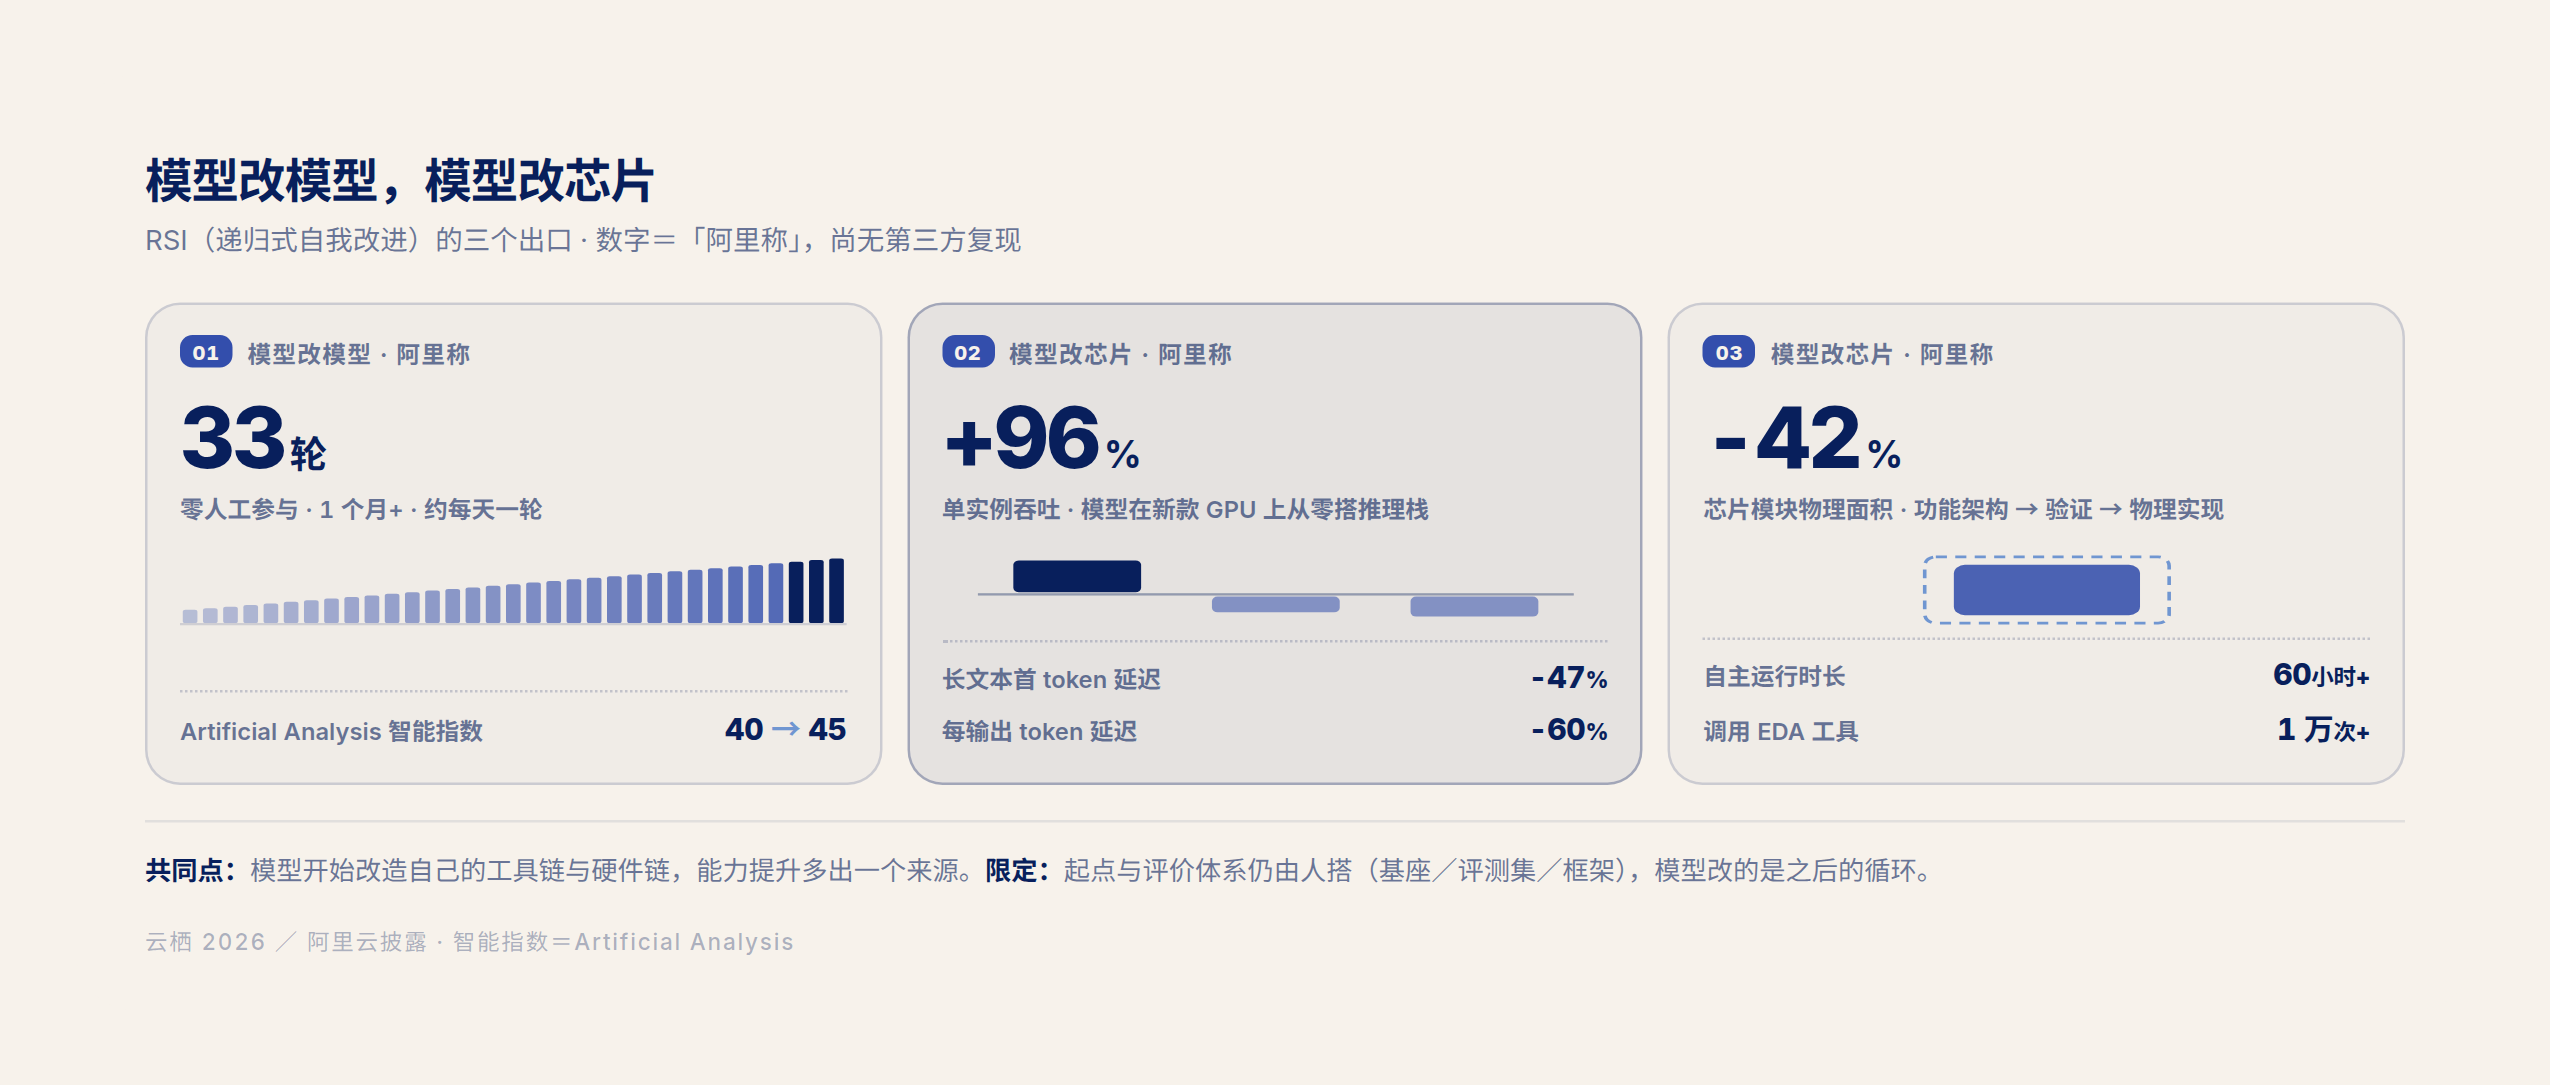
递归式自我改进(Recursive Self-Improvement,RSI)的核心动作,是让模型自己发现问题、设计实验、改进自己。在吴泳铭的表述里,这是通往超级智能(ASI)的具体技术路径;一年前阿里的判断是「AGI 只是起点」。云栖大会上,阿里第一次给出了工程化细节:Qwen3.8-Max 在人类完全零参与的情况下,自主搭建训练流程、构造训练数据、设计实验、定位缺陷,持续迭代超过 1 个月,完成 33 轮有效迭代(平均约每天一轮);结果是 Artificial Analysis 智能指数从 40 分升到 45 分,跨进海外顶级模型所在的分数区间,官方称其领先当前所有国产模型。
拆开看,被自动化的是研究循环本身:假设、实验、定位、修正。过去这是研究员的工作节奏,现在模型自己跑完 33 圈。这比单点提分更值得记录,因为它改变的是能力增长的方式:迭代速度不再受人类工作时长的限制。
值得问一句:为什么是现在?至少三件事凑齐了:模型跨过了一道能力门槛,能长时程执行、能调用工具、能从失败反馈里修正。支撑工具链已经就位,模型不必自己发明实验基建。度量也已就位,每一轮改动的效果都能被立刻读出来,不必等人来判断。三样缺一,自主迭代都只能停留在演示阶段。
也正因如此,读的时候要带两个限定。起点与评价体系仍然是人搭的:预训练基座、评测集、训练框架的初始版本都是人类资产,模型改的是之后的循环。45 分本身也不是代差,它的意义在于把「自主研究」第一次做成了可以按月观测的过程。这些数字还全部来自阿里自述,尚无第三方复现。
模型开始改自己的供给链
RSI 的外溢,比分数更具体。大会披露的工程结果里,模型同时在供给链的两端动手。
软件侧,它先完成了此前从未接触过的平头哥新款 GPU 的适配:从零搭起下一代模型 Qwen3.8-Flash-Next 的推理框架,长文本首 token 延迟下降 47%,每输出 token 延迟下降 60%,日常对话场景单实例吞吐提升 96%。新一代模型上自家新芯片的适配,大半由模型自己完成。硬件侧,它拿一份真实的芯片模块规范,自主运行超过 60 小时、调用 EDA 工具超过一万次,完成了从功能架构、验证到物理实现的完整流程,把模块物理面积减少 42%。在「AI 参与设计芯片」的各种说法里,这是一个相对硬的工程结果:约束来自真实规范,输出是可落地的物理实现。
训练流水线也没落下:云侧用 PAI 异步 Agentic RL 框架,把轨迹采样、回报累计、模型训练、参数更新串成一条流水线,存储侧由 CPFS 保证数据供给。三件事的共同点:模型开始改造自己的工具链与硬件链,下一轮能力提升由此多出一个来源。提升一旦开始叠加,曲线会比单纯的规模扩张更陡。
5–10 万亿参数,和一条一毛钱成本线
规模这条线没有停。Qwen4 正在以全新架构训练中,后续的 Qwen4.5、Qwen5 计划把总参数扩展到 5 万亿至 10 万亿。按业内整理出的竞争坐标,前沿模型的门槛目前在 3 万亿左右,10 万亿是国内厂商里第一个被公开喊出的目标。多模态也在同步推进:全模态的 Qwen3.8-Omni、图像 3.1、语音 3.1、视频生成 Wan3.0(Artificial Analysis 文生视频与视频编辑双榜第一),以及一批世界模型新品,下一代视频生成模型将在 11 月发布。
另一条线是成本。Qwen3.8-Flash 提前开源了下一代架构:通过注意力机制与模型内部信息传递机制的改造,训练成本下降约 90%,推理时几十亿级激活参数就能达到前沿性能,缓存价格压到每百万 tokens 一毛钱。开源盘子继续扩大:460 多个开源模型、累计下载超过 30 亿次、衍生模型超过 30 万个。
两条线放在一起才有意思:一边把参数推向 10 万亿,一边把每百万 token 的价格压到一毛。规模与效率是同一个问题的两面,如果思考要成为「电价」,这两件事必须同时发生。
云:为 Agent 重造的账本
从 AI Native 到 Context Engine
阿里云 CTO 李飞飞给出的框架是:企业级 Agent 大规模落地,短板集中在四样基础设施:全面且持续更新的上下文;支持自主运行与持续进化的执行环境;融入身份、权限与审计的可信协作;以及从静态规则走向实时感知、动态推理与自主行动的能力。对应这套需求,阿里云把技术栈从 AI Native Cloud 推进到 Agent Native Cloud,再到 Context Engine(上下文引擎),核心是三个词:Model、Harness、Context。
这里的代际差有具体所指:AI Native 解决的是「把模型服务化」,请求来、结果回,请求之间彼此无关;Agent 的负载正相反,任务要连续跑几天,中途要断点、要重试、要隔离,上下文要持续更新、跨会话携带。无状态架构对这几种需求都没有现成答案。Context Engine 要收回的,正是这块「有状态执行」的基础设施活。
产品化落在两件东西上。其一是 AgentCore,把运行 Agent 所需的基础设施标准化、托管化:长任务支持、失败重试、断点恢复、异步执行,加上安全隔离、身份权限与全链路审计,官方称可以把任务完成率提升 99%、总拥有成本降低 70%(厂商自述数字,尚无独立验证)。托管化的对价是迁移成本:执行、状态、记忆都标准化在平台里之后,应用与云的绑定会更深一层。其二是 Agent Sandbox 及 Agentic OS、Agentic Computer 等运行环境。这组发布想解决的具体问题是:当 Agent 的任务从「回答一个问题」变成「连续运行几天」,云不能让每个应用自己实现断点、重试和沙箱,就像当年没人应该自己实现数据库事务。
上下文的搬运费:一份新账单
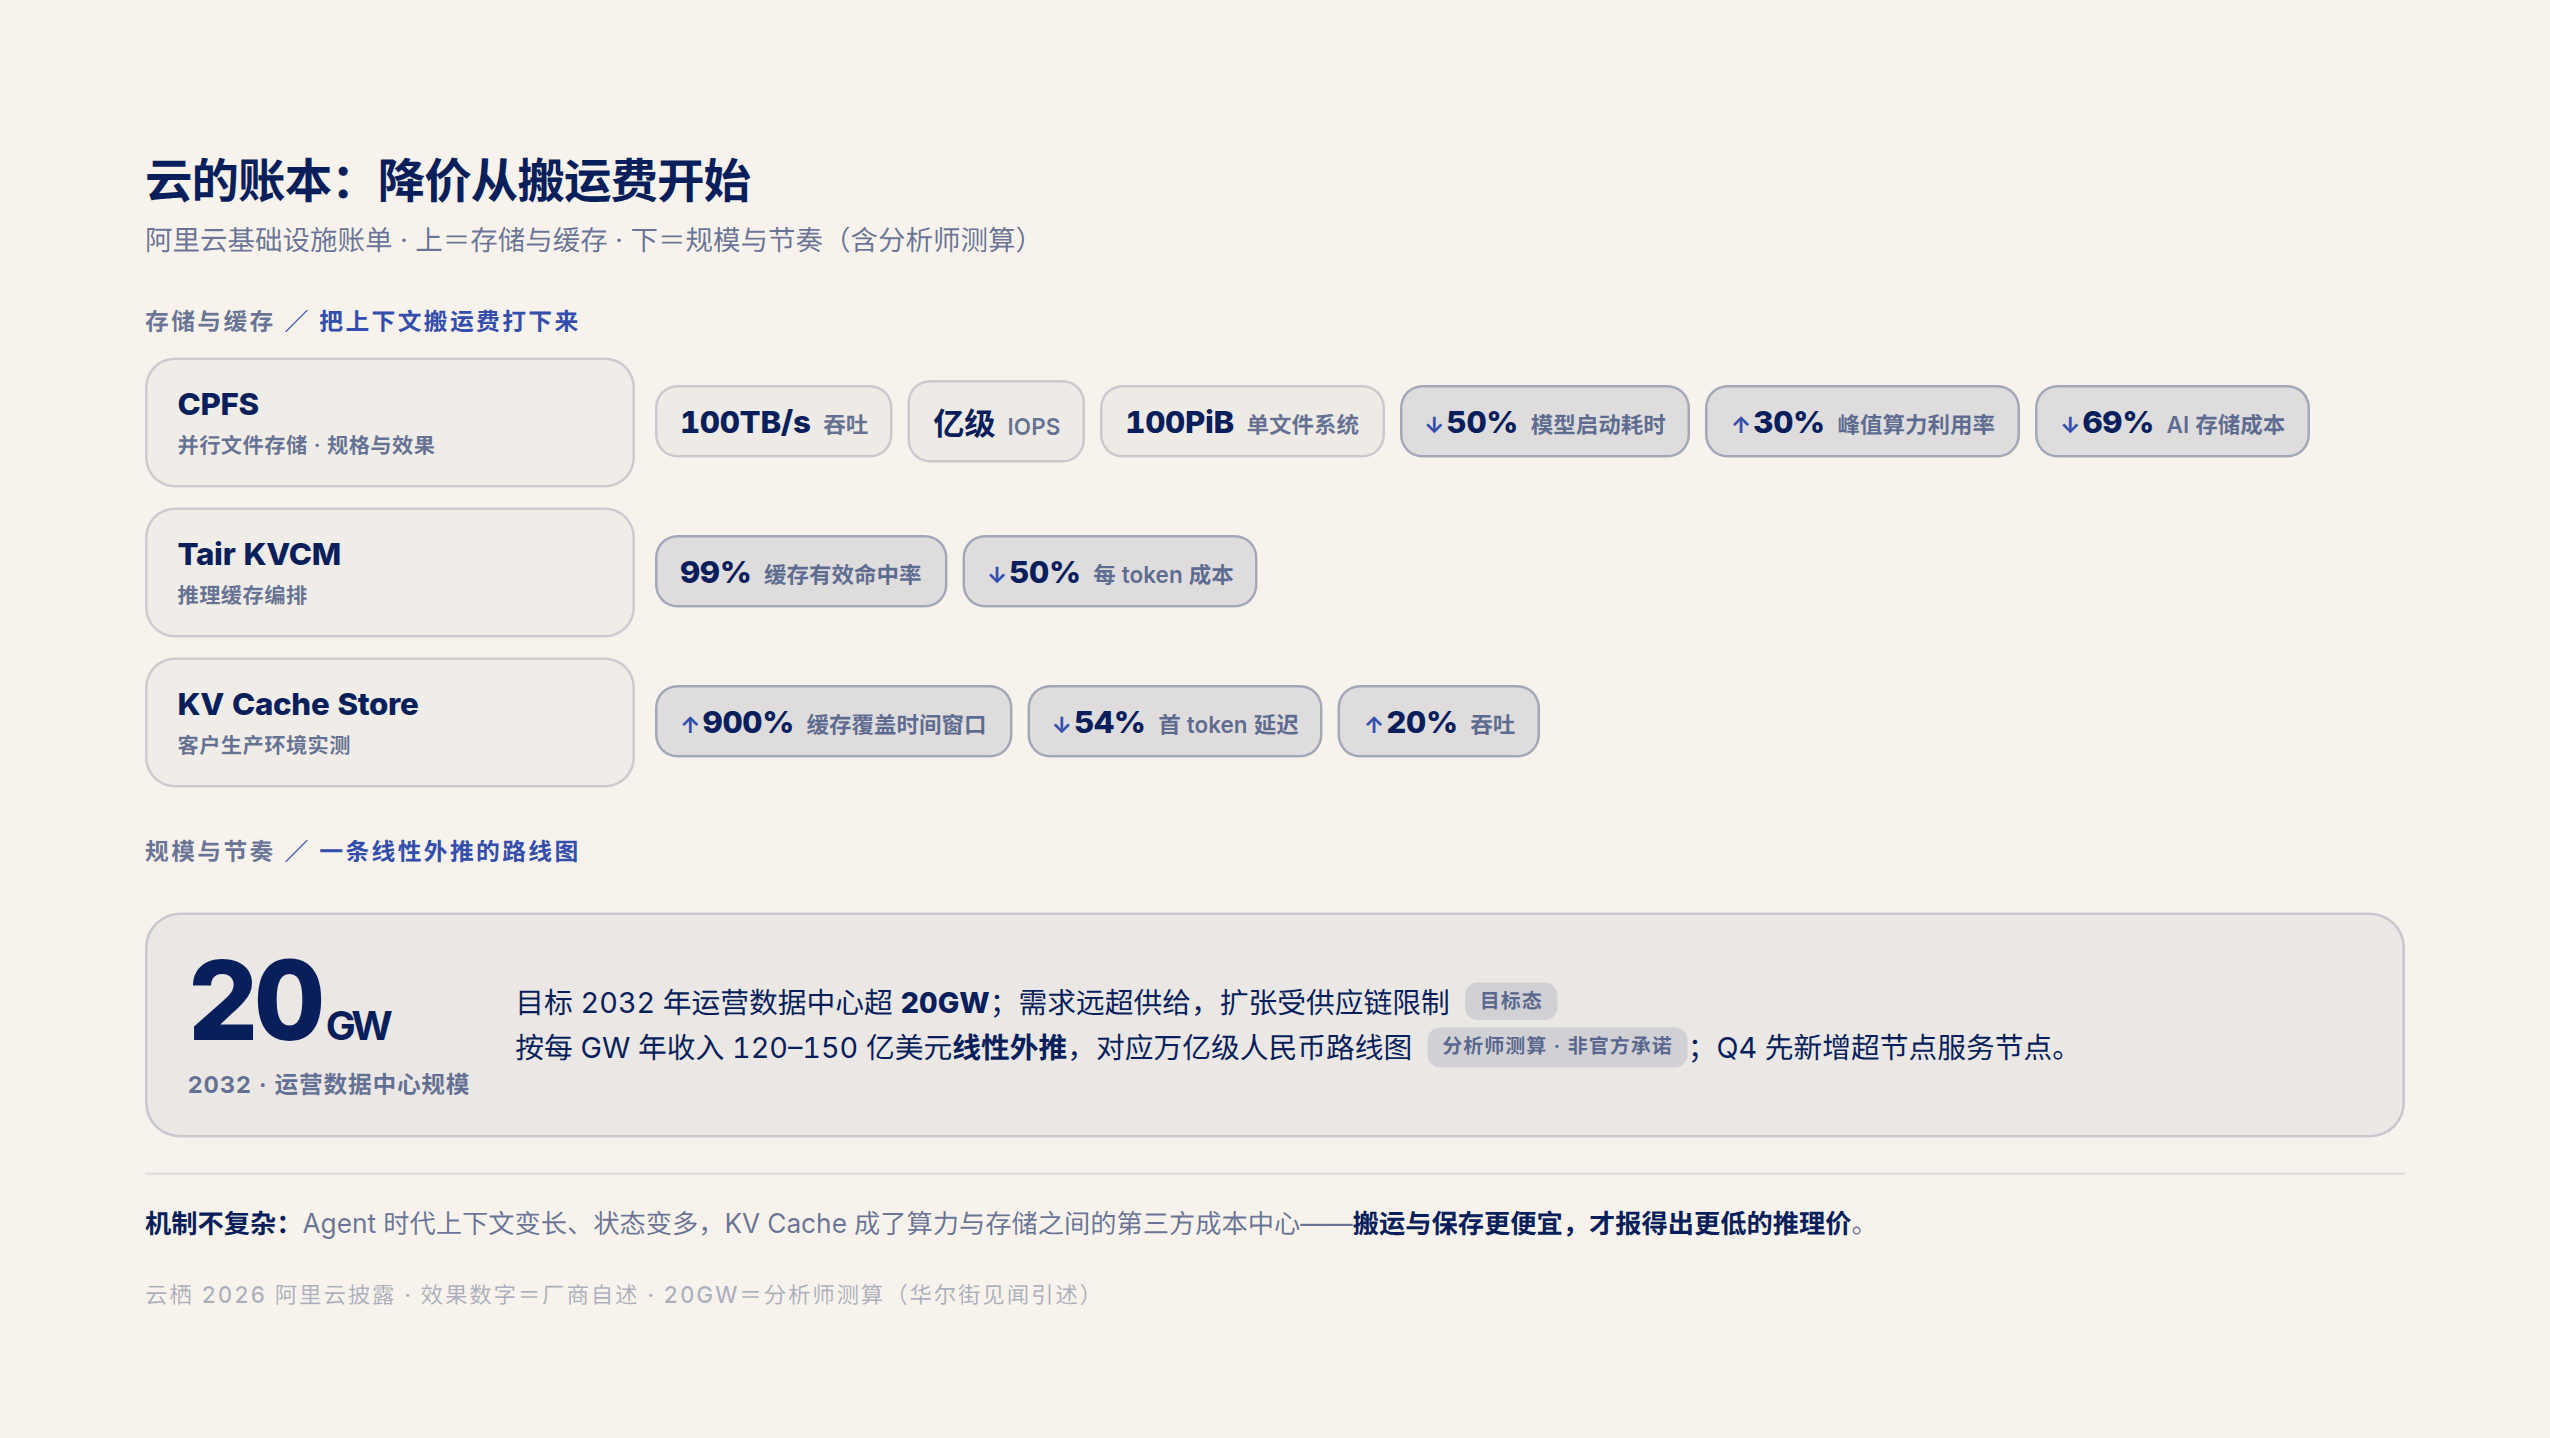
基础设施这边,数字更硬一些。新一代 CPFS 把并行文件存储拉到百 TB/s 级吞吐、亿级 IOPS、单文件系统 100PiB,官方给的三组效果数字是:模型启动平均耗时降低 50%、峰值算力利用率提升 30%、AI 存储成本下降 69%。推理侧,Tair KVCM 统一编排内存池、缓存与远端共享存储,把缓存有效命中率做到 99%、每 token 成本下降 50%;KV CacheStore 在客户生产环境里把缓存覆盖时间窗口扩大 900%、首 token 延迟降低 54%、吞吐提升 20%。
这组数字背后的机制不复杂:Agent 时代的负载,上下文越来越长、状态越来越多,KV Cache 成了介于算力与存储之间的第三方成本中心。谁的搬运与保存更便宜,谁就能报出更低的推理价格。存储、缓存、调度这几个过去在云账单里不起眼的位置,正在变成决定推理经济性的主战场。
把视野再拉远:阿里云把 2032 年的目标定在运营数据中心规模超过 20GW,并明确说客户需求远超当前供给、供应链紧缺限制扩张速度;今年第四季度先新增超节点服务节点。据华尔街见闻引述的分析师测算,按每 GW 年收入 120 亿至 150 亿美元估算,20GW 对应一条万亿级人民币收入的路线图。这只是线性外推;能不能兑现,电力、芯片供给与需求三者缺一不可。
终端:把智能递到手上
终端是另一条路径的触点:千问 AI 硬件一次亮出三件,AI 眼镜 N1 / N1 Pro 与 AI 耳夹式耳机,当日起预约、10 月 13 日发售;办公侧,千问办公发布「企业上下文」与 QwenNote A2 录音卡,上线一个月用户超过 3000 万;移动侧,Qwen Intelligence 面向手机厂商提供全栈 AI 方案。桌面端,开源模型 Qwen-27B 已可本地流畅运行。它们单件都不算重磅,但合起来说明一件事:云端模型能力正在通过硬件与办公软件,渗到具体的用户场景里。这些触点的共同短板也很清楚:硬件刚起步,体验与生态才决定它们能走多远。
总结与判断
把云栖 2026 的发布清单压缩成一句话:阿里把算力的竞争单位,从单颗芯片换成了整套系统,并把系统的三个部件(芯片、模型、云)塞进了同一个反馈环。
竞争单位已经是系统。过去一个月,华为、阿里与 NVIDIA 在同一方向上用了几乎相同的语言:一台计算机、统一内存、超节点。单卡差距不再单独决定胜负,系统设计的自由度(光互连、内存语义、开放标准)成为新变量。中国两家把光送进 Scale-Up 域、把集群上限翻过 50 万卡,NVIDIA 继续机柜优先,三种拼法给的是三份不同的答卷。
比语言更实的是数字。互相改造开始产出可度量的结果:模型把芯片模块面积减了 42%,把自己在新芯片上的推理吞吐提了 96%,云把 AI 存储成本降了 69%。但这些数字全部来自厂商自述,缺少独立复现;而披露策略本身也是竞争的一部分:只给倍数不给绝对值,就保留了「留到交付时再说」的空间。
最硬的一关在时间表上:2027 年第一季度是第一个验证窗口。届时 V900 与昇腾 960DT 同季就绪、B300 在售且下一代爬坡,三家的系统设计将第一次接受同场检验。更近的观察点有三个:今年四季度阿里云超节点扩容的执行情况、RSI 的下一轮迭代数字、Qwen4 的训练进展。
声明: 本文基于 2026 云栖大会(9 月 22–24 日,杭州)公开演讲、官方新闻稿,以及科创板日报、财联社、上海证券报、南方都市报、驱动中国、未尽研究等多家媒体的报道与解读,交叉核对后撰写。部分数据为厂商自述,未经独立验证。不构成投资建议。文中数据截至 2026 年 9 月 23 日。