9 月 17 日,华为全联接大会 2026 在上海开幕,昇腾 960 超节点登台:4096 张卡圈进 2 微秒往返时延域。第二天,同一场大会的灵衢技术论坛上,一件不那么显眼的事发生了:《灵衢基础规范 2.1》正式发布。586 页。
这份文本的时间线值得先看一眼。文档属性显示它创建于 9 月 15 日凌晨,修改定格在同日午后。最迟 16 日,它已出现在灵衢社区官网上,一两天内出现的万字深读文可作旁证。18 日,官方在全联接大会的灵衢技术论坛上正式发布并详细解读。前一天是 960 超节点的主题演讲,后一天是支撑这类超节点长期运行的协议文本。产品与规范进入同周节奏,这不是巧合:960 讲系统,灵衢讲协议,前者是后者目前最大的买家。
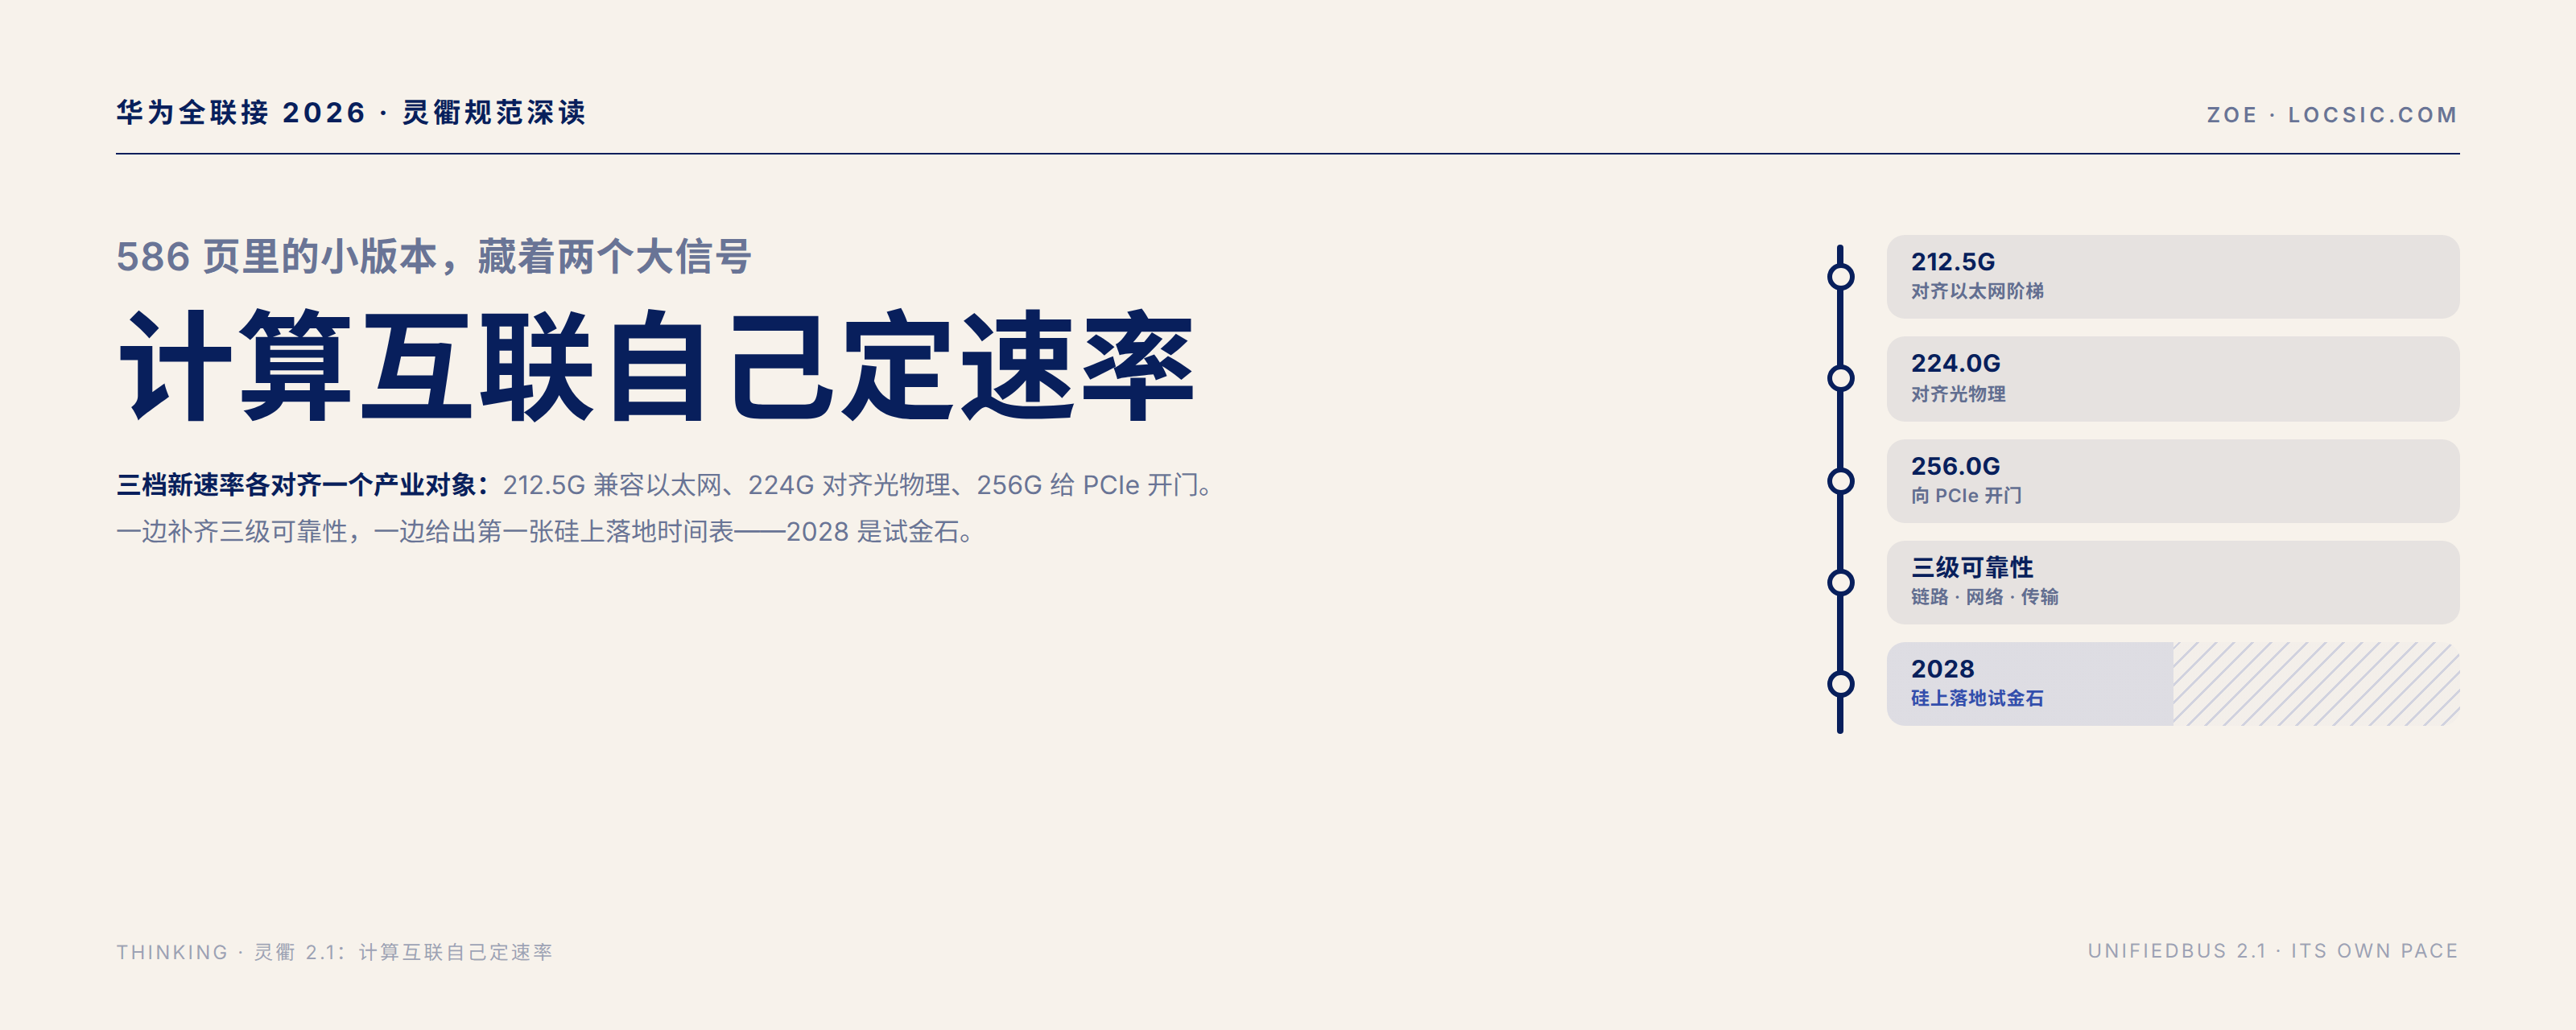
官方对 2.1 的概括是四句话:新增 224G/256G 代际速率,新增可靠重路由机制,提升系统带宽效率,降低多路径下的通信时延。四句话背后,是 2.0.1 之上的十二类修订。本文做一件事:把这 586 页拆开,看清一个小版本里藏着的大信号。一个是技术信号,计算互联开始自己定速率节奏。另一个是产业信号,灵衢生态第一次有了走出华为围墙的时间表。
小版本,大含义
先说清楚 2.1 不是什么。它不动架构。2.0 确立的六层协议栈(物理、数据链路、网络、传输、事务、功能)、Load/Store 语义、信用流控、多路径,全部原样保留。基于 2.0 做研发的厂商不需要推翻任何东西,规范修订记录的基准行写得明白:基于 UB 2.0.1 的更新。架构性的大版本升级不在这一版动,规范文本对未来版本只字未提,业界预期它叫 UB 3.0。
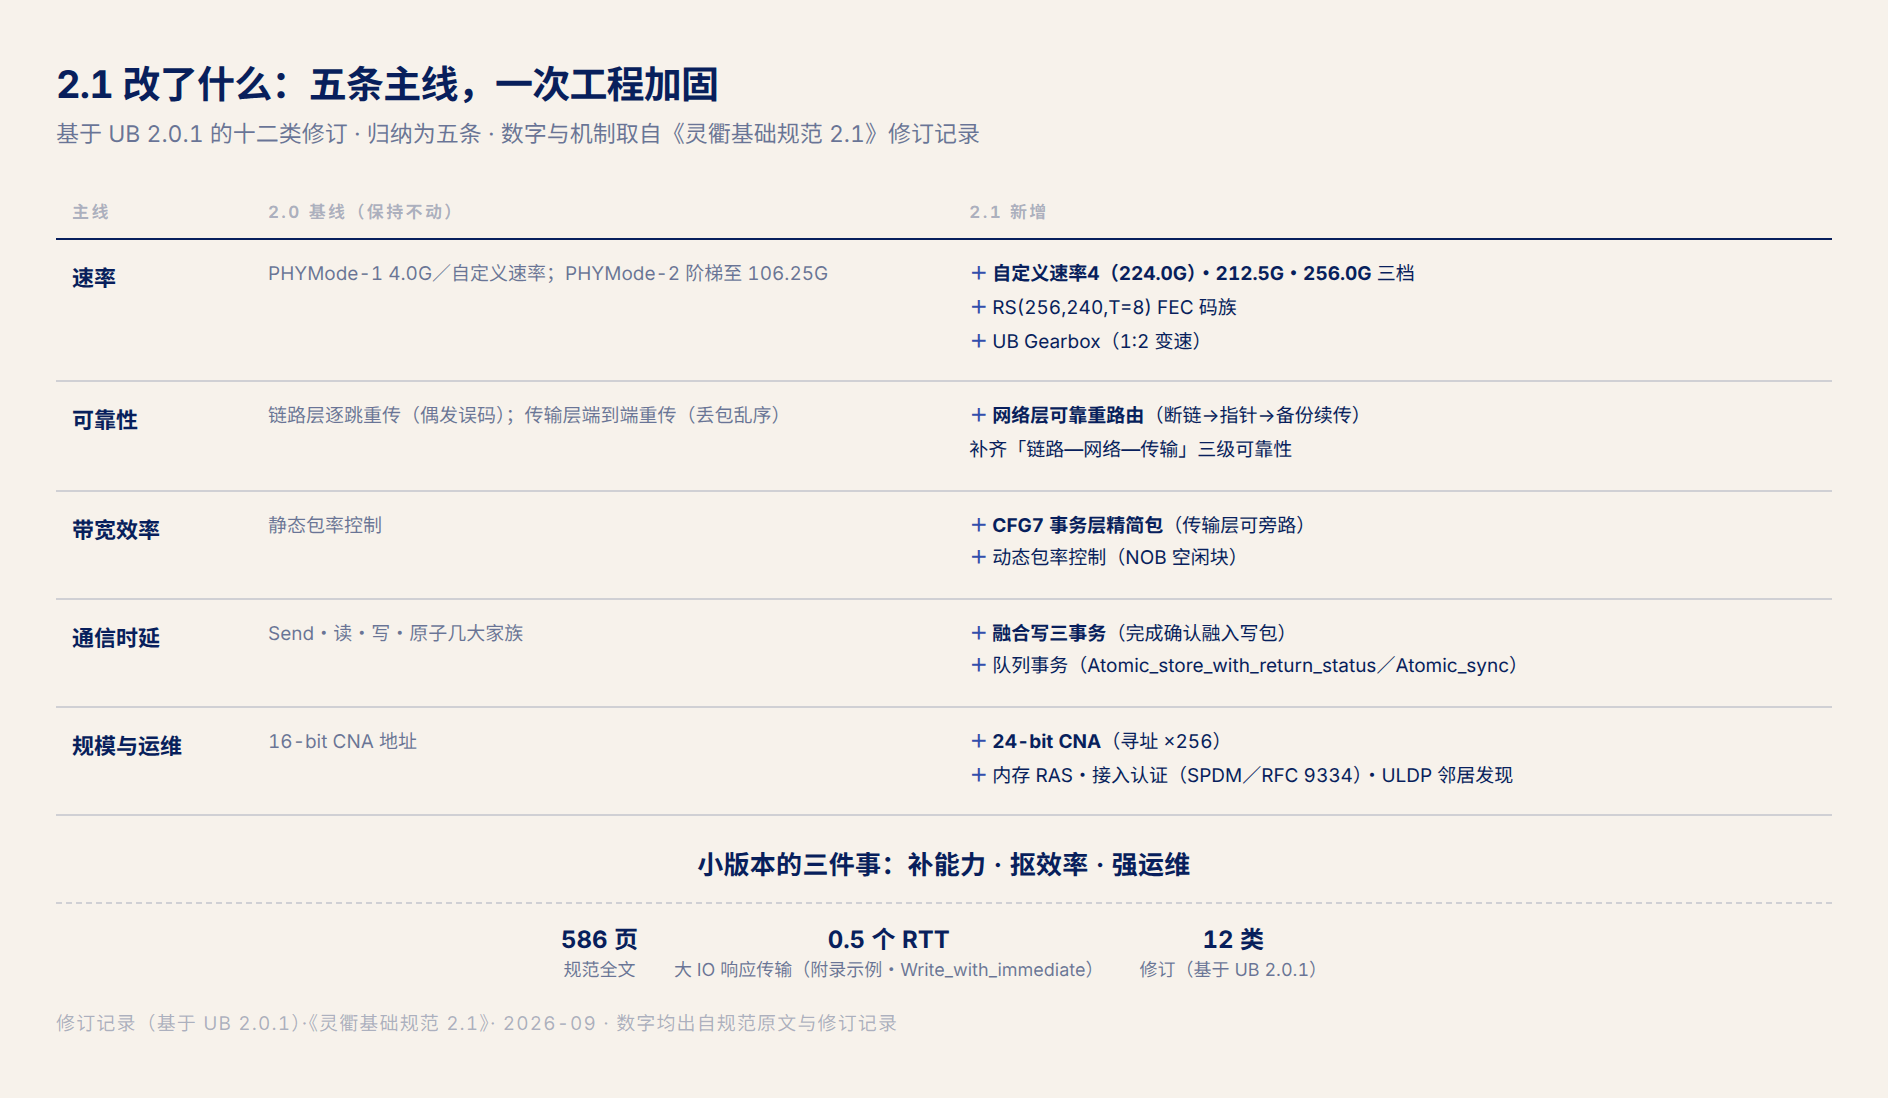
那 2.1 改了什么?修订记录列了十二类:新增三档速率、RS(256,240) FEC 码族、UB Gearbox 模式、动态包率控制、可靠重路由、三个融合写事务、两个队列事务、CFG7 事务层精简包、内存管理 RAS 特性、接入认证与 TEE 优化、UB 邻居发现协议,外加编辑性修正。归纳起来是三件事:补能力,抠效率,强运维。用灵衢协议与芯片架构师程传宁在论坛上的话说,2.1 在 2.0 全面开放的基础上持续演进,可靠性进一步增强,为产业界提供更成熟、更稳定的技术底座。
这句话的分量要看对象。能连起来和能长期跑,是超节点商用化的两个阶段。2025 年 3 月 UB 1.0 随 Atlas 900 超节点交付时,业界验证的是前者:总线语义可以把一柜卡连成一台计算机。到这场论坛时,商用已超过 1000 套(华为计算首席战略官朱照生给出的数字),问题变成后者:大规模、高可靠、高效率地长期跑业务。2.1 的全部修订都对着这个问题。下文按物理层、可靠性、事务层、规模运维四条线拆。
速率三档:节奏是自己定的
物理层是 2.1 改动最集中、也最有信息量的地方。规范把物理层分成两种模式:PHYMode-2 踩以太网速率阶梯,走兼容路线;PHYMode-1 走灵衢自定义速率域,服务高速自定义档。2.1 在两种模式里各补一档,外加一档自定义速率,合起来三档新速率。
第一档,212.5G,走 PHYMode-2 的既有阶梯。这个模式原有的速率序列是 2.578125、25.78125、53.125、106.25 Gbps,全部对齐以太网生态,电气特征参考 IEEE 802.3 系列标准,最新的 212.5G 参考每通道 200G 的 802.3dj。它的含义是兼容:复用以太网世界成熟的 SerDes、电缆和光模块产业链,设备厂商换到灵衢栈上时,物理层不用换供应链。在无重定时的线性光场景,212.5G 的电气特征参考 OIF CEI-224G-LINEAR-PAM4,规范还给 DAC 电缆场景留了可选的高插损指标:最大 42dB(bump 到 bump,奈奎斯特频率),给长距铜互联留了物理余量。
第二档,224.0G,是自定义速率 4,走 PHYMode-1,电气特征参考 OIF-CEI-06,对齐 224G 线性光物理层生态。960 超节点的 Hi-ONE 光互联引擎(单引擎 7.2T)正属于这个世代:规范文本 9 月 15 日定稿,Hi-ONE 9 月 17 日登台,协议给产品铺路的节奏相当直白。
第三档,256.0G,同样走 PHYMode-1。以太网没有这个档位,它的对齐对象不在网络侧:这个速率是给 PCIe 设备接入超节点留的门。灵衢的生态定位是开放接入、多元部件,而 PCIe 是今天存量最大的部件生态。256.0G 不出现在任何以太网路线图上,它是计算互联自己定义的速率。
配套机制有两件。新 FEC 码族 RS(256,240),可纠正 8 个符号(GF(2^8)),与原有的 RS(128,120) 码族并列,高速率档的误码保护跟着速率一起升级。更有意思的是 UB Gearbox:一侧低速链路、一侧高速链路连接两个工作在不同速率的 UBPU(UB 处理单元,总线上处理灵衢协议的设备),速率比 1:2、通道数比 2:1,以比特为粒度做交织和解交织,不感知协议,只要求两侧都跑 PAM4。它解决的是投资保护:100G 时代的设备接进 200G 时代的网络,中间加一个 Gearbox 就能互通,不必推倒重买。这本账的另一面也要看到:Gearbox 是挂在线路上的实器件,时钟恢复和比特交织带来额外的时延、功耗与物料成本,规格也只定义了 1:2 一档速率比、且两侧都必须跑 PAM4。投资保护的弹性有边界,跨两代以上的速率混跑仍要重新规划。
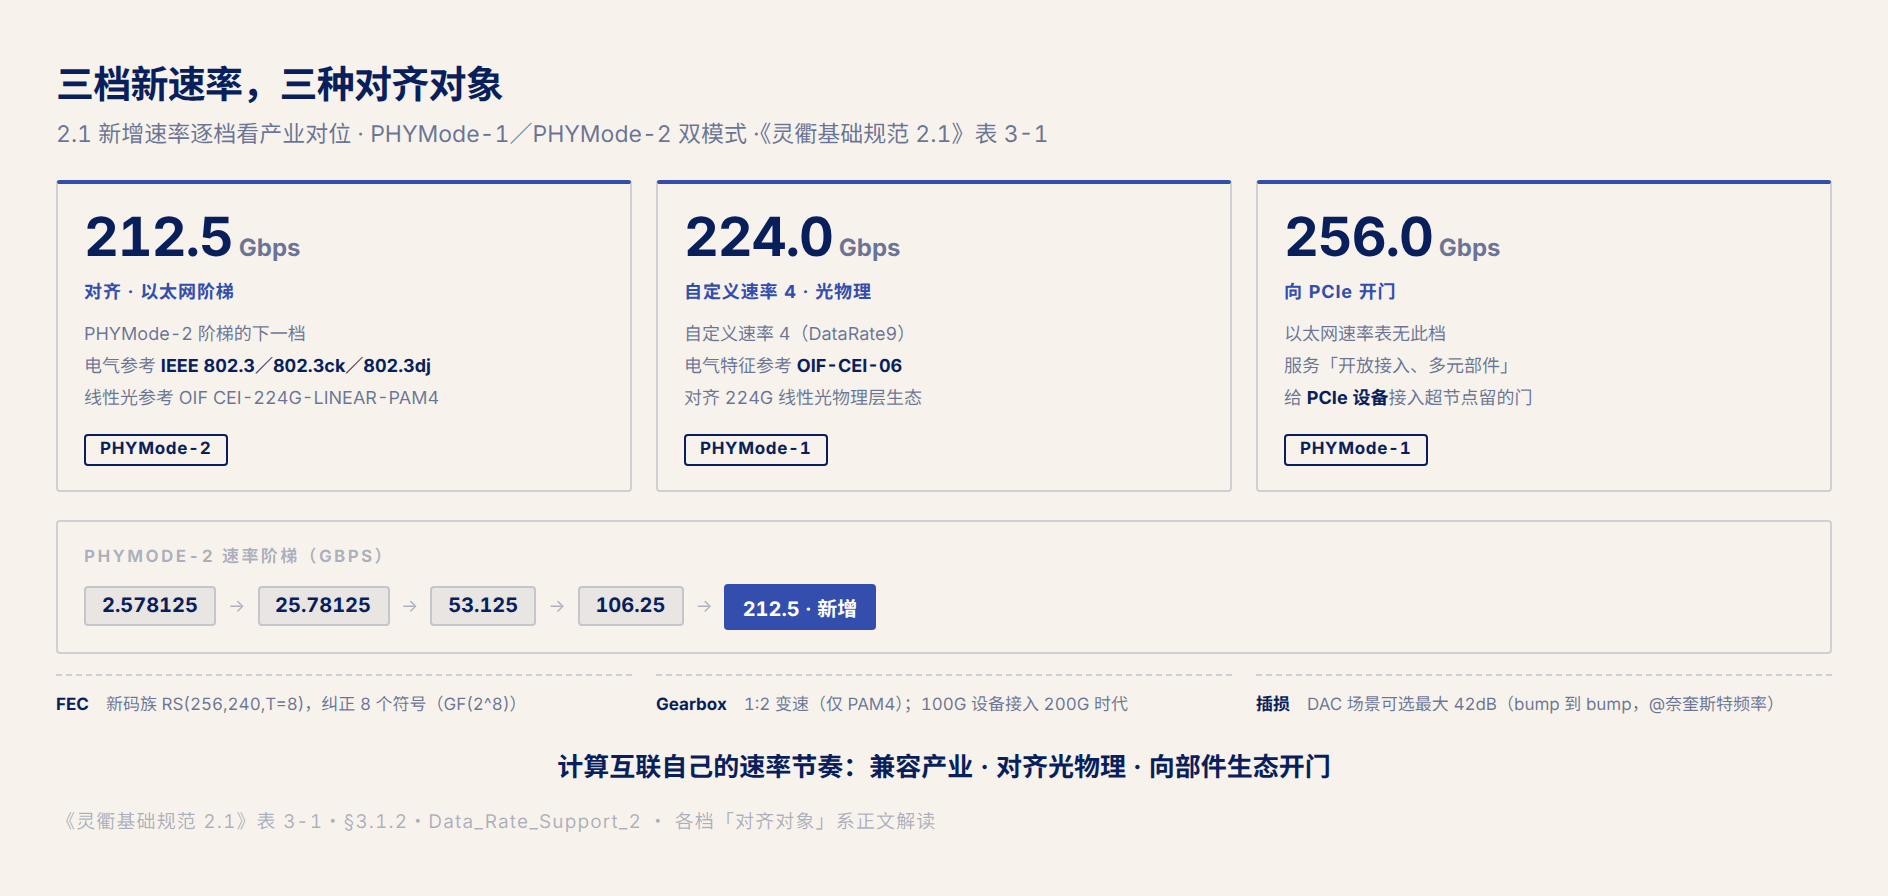
三档速率摆在一起,结论浮出来:计算互联正在形成自己的速率节奏。212.5G 对齐以太网是产业兼容,224G 对齐光物理是产品先行,256G 对齐 PCIe 是生态野心。标准速率上与产业保持兼容,但节奏不再跟随网络互联的世代表。这是 2.1 里最锋利的一个判断,规范文本自己不这么说,三张速率表放在一起就是这个意思。
三级可靠性:断链之后,指针续传
2.0 的可靠性是两级:链路层逐跳重传对付偶发误码,传输层端到端重传对付丢包和乱序。缺的一级是网络层:整条链路断了怎么办。2.1 补上可靠重路由,机制值得细看,因为它是支撑超节点可用度宣称的协议侧地基。
场景设定:两台 UBPU 之间有两条以上可达链路时,上电后由 UBFM(灵衢互连结构管理器,负责拓扑与端口配置的系统管理软件)把 Port1 配置成 Port0 的备份端口。故障发生时,接收侧 Port 检测到 RX 方向断链(物理层信号 LinkUp 归零)。上层处理单元收到上报后查内部表项,拿到故障链路对端的 CNA 地址(简短网络地址,灵衢给每台设备分配的网络层门牌号),并读取断链端口的接收指针(RcvPtr_Packet:接收端逐包维护的指针,指向当前或下一个待收数据包的起点在对端 Retry Buffer 中的位置)。随后经备份路径发出可靠重路由 LastAck 消息。发送侧收到后,从 Retry Buffer 里指针所指的位置开始,经备份端口续传。整个过程规范给了两个时限:LastAck 宜在 500 毫秒内完成,发送侧超过 1 秒未收到则按超时处理。被断链污染的 Retry Buffer 空间在确认续传完成后才释放。
没有直连备份路径的场景也有方案:两台 UBPU 之间只有一条链路,但各自与第三台 UBPU 都有可达链路时,LastAck 和重路由数据可以经第三台转发。规范的示例就是 UBPU0 经 UBPU2 与 UBPU1 通信的三角拓扑。代价是多一跳,换来的是拓扑设计的自由度。
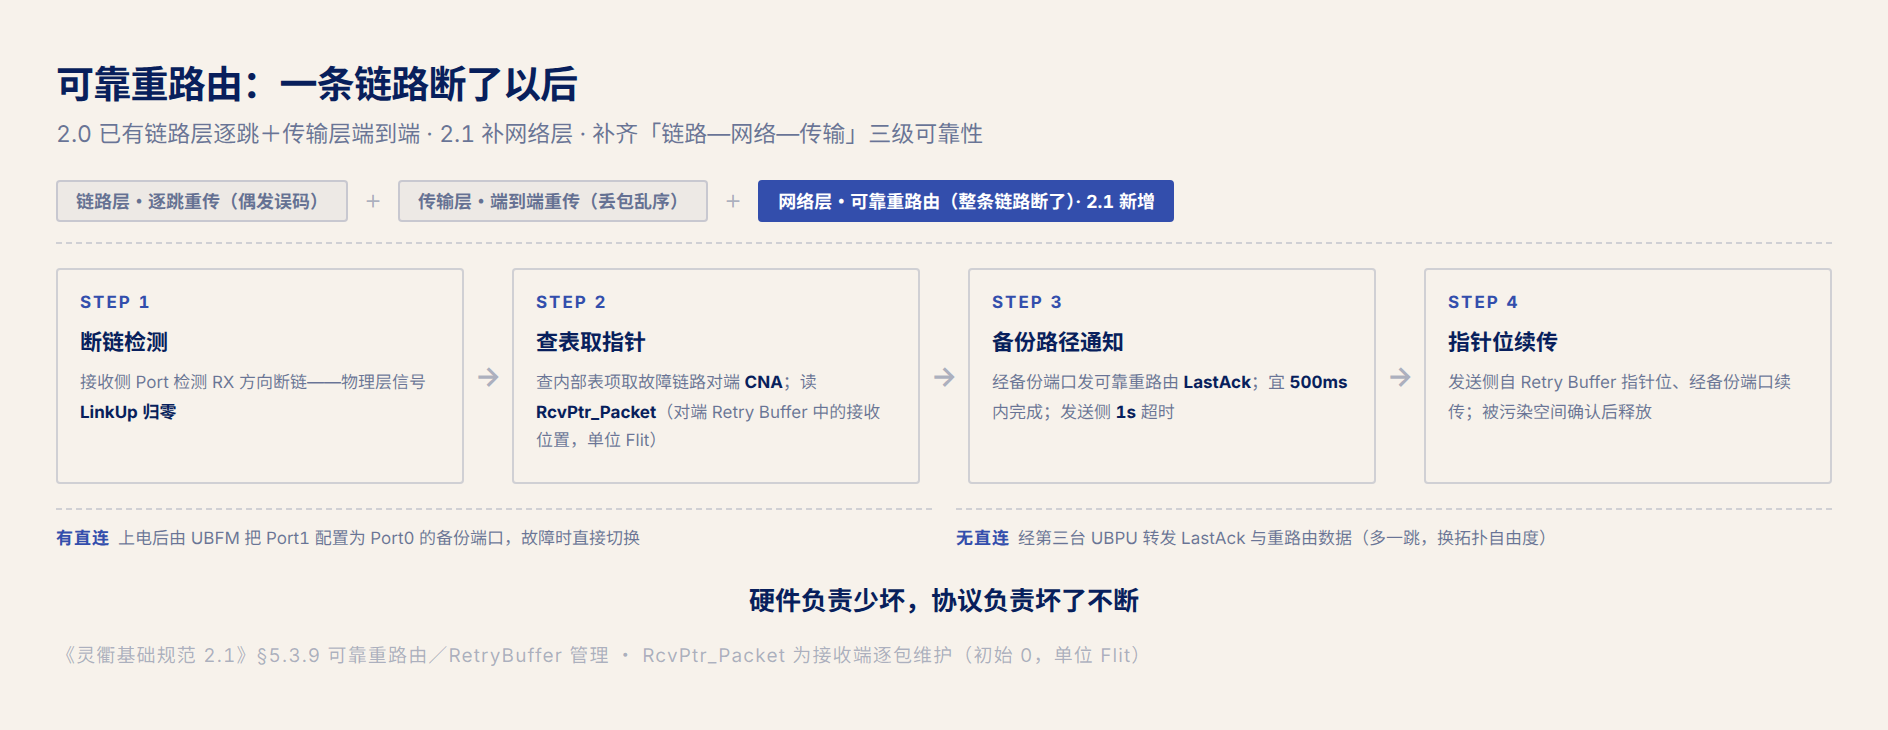
这件事为什么重要,要对着 960 篇读。960 超节点用 5500 颗光引擎替代了 4.8 万颗光模块,集成度上去之后,单颗器件的关键性同步上升:坏一颗,影响的链路更多。华为宣称整机可用度 99.8%、无故障时间翻倍,它的支撑不只在硬件冗余上,协议侧必须有能力在链路失效时把业务流量无损地搬走。网络层重路由加上 2.1 同步引入的内存管理 RAS(后面会讲),就是这套宣称的协议半边。硬件负责少坏,协议负责坏了不断。
效率与时延:把完成确认装进数据包
事务层是 2.1 技术含量最高的部分,官方四句话里的后两句(带宽效率、通信时延)主要落在这里。
第一组改动是融合写事务,规范新增了三个写事务类型:Write_with_atomic_store_add、Write_with_remote_sync、Write_with_remote_sync_with_be。名字很长,机制一句话:把同步语义装进写事务本身。传统做法里,数据写过去,完成确认再跑一个往返;融合写把完成信号、甚至原子累加和回执语义都并入同一个写包,多路径乱序的环境下,数据单向送达,确认同时到达,不需要独立的 ACK 往返。规范附录的应用示例给了量化参照:Push 模式的小 IO 请求传输只需 0.5 个 RTT,Send 加 Write_with_immediate 的大 IO 响应传输同样是 0.5 个 RTT。同一张示例表里还有对照组:同样是大 IO 响应传输,普通 Send 加 Write 的组合要 1.5 个 RTT——换成 Write_with_immediate 的那一档,把整个往返省了下来。这里的 0.5 个 RTT 是协议语义组合的结果,不是物理传输变成了半程。数据还是走完整的路,省掉的是协议行为:确认不再单独占一个往返。融合的账单记在语义侧:数据、同步信号、累加操作装进同一个包,包丢了整组重来,执行异常要靠事务应答(TAACK)回传兜底。复杂度没有消失,从应用层挪进了协议栈。
这个设计还送了一个副产品。Write_with_atomic_store_add 的应用示例里,目标侧收到事务包后把统计数据原子累加到指定的统计地址空间,异常信息随应答带回。任务计数、调度反馈这类控制流量的通信,可以搭数据通信的便车,不用单独建一套。
第二组是队列事务:Atomic_store_with_return_status 和 Atomic_sync。前者投递任务的同时把队列状态带回,队列满不满、深度多少、拥塞与否,发起方投完就知道;后者在 Cache 一致性空间里做高效同步。灵衢既有的事务原语覆盖 Send、读、写、原子几大家族,但队列语义没有独立入口,这两个事务补上这一格,流水化的任务分发有了协议级原语。代价是队列深度、拥塞状态成了目标侧必须实时维护并随投递回传的硬件状态,投递路径上多了一次状态查询。投递自带队列状态,调度器拿到的正是动态决策需要的输入,这一步的方向感很强。
第三组是包头瘦身。新增 CFG7 配置支持事务层精简包格式:基于 24-bit CNA 地址的网络层包头直接衔接事务层,传输层可配置为旁路模式(规范原文:支持事务层直接调用网络层服务,可降低协议开销),逐跳扩展头与校验域段随之省去。配合包率控制的升级,发送端插入空闲块(NOB)降低接收端的包率处理压力,2.1 在 2.0 只有静态模式的基础上新增动态模式:按平均包长、数据单元长度和接收端突发容量动态计算插入率,短包与长包混跑时接收端不再被突发打满。省字段的代价同样明确:传输层被旁路的流不再享受它的端到端重传与校验,检错和恢复责任压回链路层逐跳重传与事务层自身,精简包适合路径确定、上层能兜底可靠性的流量,不是万能格式。空闲块则是一笔明确的带宽税,插入越保守有效带宽越低,动态模式的意义就是把这笔税收到刚好。
四组改动合起来是一个完整的意图:每一比特线上开销都要挣到自己的票钱。超节点内部通信的瓶颈往往不在峰值带宽,而在协议开销吃掉的有效载荷比例。2.1 在事务层做的,是把这个比例往回扳。
规模与运维:24 位地址和一套国际标准清单
地址空间这一项最能看出 2.1 的务实。网络地址 CNA 从 16 位扩到 24 位,寻址空间从 65536 涨到 16777216,乘以 256。驱动力是算术题:4096 卡的超节点单元,每张卡多个端点,再往 SuperCluster 方向扩展,16 位的余量正好在这个世代开始吃紧。规范没有激进切换,16 位格式与 IP 格式都保留,24 位是新增不是强制,存量设计照跑。
运维侧的增强分三块。内存管理 RAS:UMMU(UB 内存管理单元,设备内执行地址映射与访问权限校验的组件)的地址转换、Token 校验、权限校验出现异常时,按 A 类错误经事件队列上报,让内存路径上的故障可观测。接入认证对齐业界标准:采用 DMTF SPDM(DSP0274)加 RFC 9334 远程证明架构,UBPU 作为证明者,验证服务器作为验证者,UBFM 作为依赖方,支持护照模式和背调模式,设备身份与可信状态有了标准化的度量语言。TEE(可信执行环境)扩展则收紧了可信计算基(TCB)的边界:规范把 TCB 定义为 UBPU 硬件可信根、硬件安全模块与 TEE 相关计算单元,通用操作系统不在其列。再加上基于 IEEE 802.1AB LLDP 的邻居发现协议 ULDP,设备上电后自动互相识别。
把规范性引用文件单拿出来看更有意思。2.1 的规范性引用清单里,IEEE 802.3dj、802.1AX-2020、RFC 2131、OIF CEI-224G 等在列,横跨以太网物理层、链路聚合、地址分配、电气接口四类。一份中国厂商主导的计算互联规范,引用清单几乎是一份国际标准文集。这不是姿态,是工程判断:成熟的底层标准能复用就复用,自研的力气花在语义层和事务层这些真正没有现成答案的地方。
生态实态:1000 套、52 条标识和一张 2028 时间表
协议之外,9 月 18 日那场论坛还给出了一组生态数字,值得单独读。
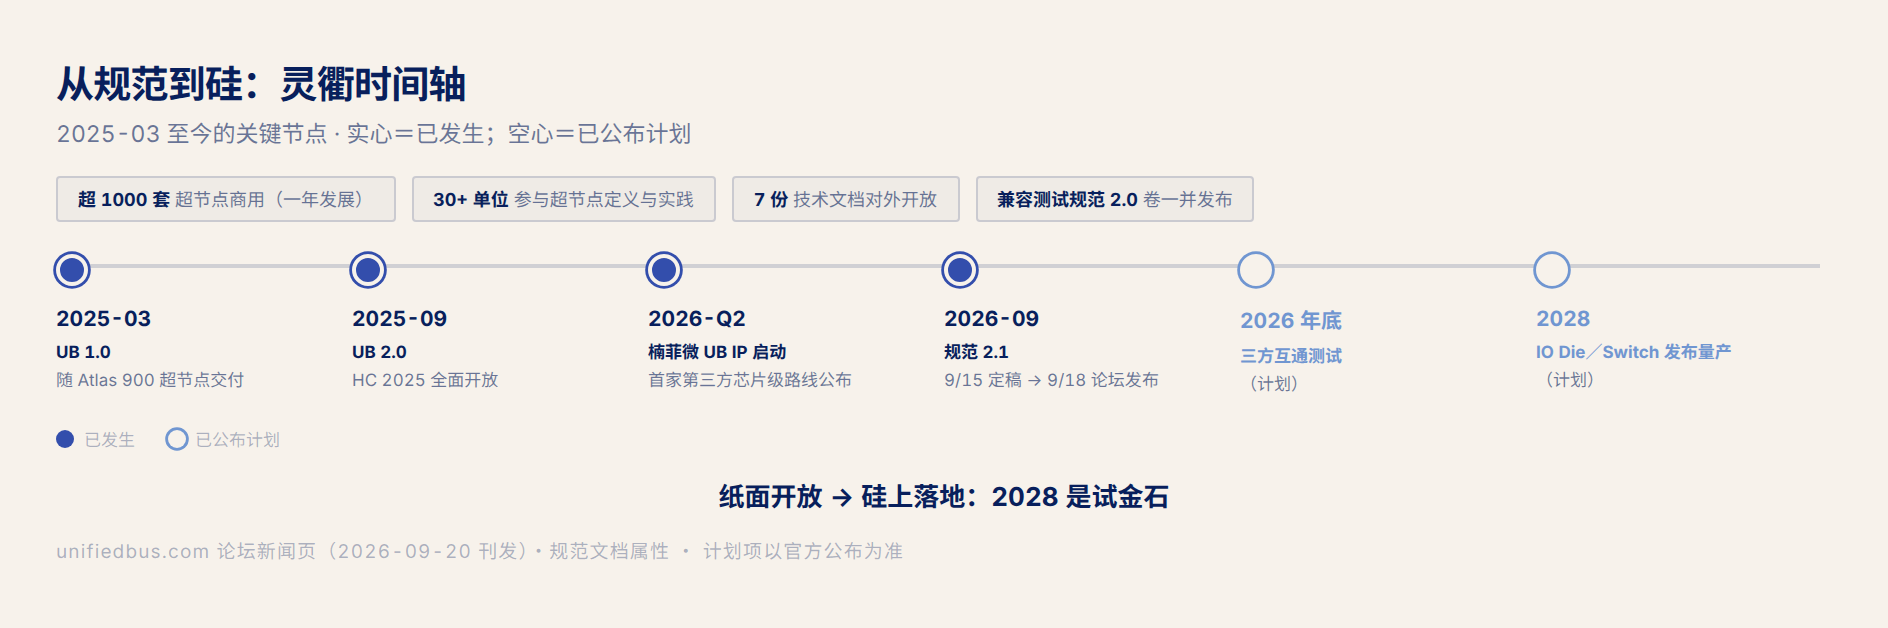
先看官方给出的成绩单。朱照生致辞里说,灵衢经过一年发展,华为超节点商用已超过 1000 套,30 多家单位参与了超节点的定义与实践,基础技术规范、部件参考设计、操作系统管理等 7 份技术文档全面对外开放。他把算力互联通信比作普通话:对整个算力基础设施至关重要,灵衢坚持平等、中立,以完全开放的技术规范支持上下游伙伴。
再看账面。截至 9 月 18 日的快照里,灵衢社区标识库的厂商标识注册表只有华为一家。设备与模组标识 52 条,全部是 Ascend 950 PR 系列,模组标识为零。一边是论坛上的 1000 套与 30 多家单位,一边是注册表里的 1 家厂商、52 条设备记录。这个反差不一定是坏消息,它说明生态还处在伙伴评估、参考设计、IP 立项的阶段,真金白银的芯片注册还没到。但它划出了现实的位置:纸面开放走在前面,硅上落地需要时间表。
时间表来了,这是本次论坛最有分量的一条新闻。深圳楠菲微电子副总经理王震公布了基于灵衢的产品路线:UB IP 项目 2026 年二季度已启动,年底做三方互通测试,IO Die 和 Switch 两类产品预计 2028 年完成发布和量产。这是灵衢开放以来第一家第三方公司给出芯片级的量产时间。同期发布的还有《灵衢兼容性测试规范 2.0》卷一,覆盖物理层、数据链路层、网络层的测试用例,社区官网称灵衢兼容测试能力已就位。协议、测试、第三方硅,三件套在同一个论坛上齐了。
应用侧也有信号。vLLM Ascend 核心开发者宁云潇分享了基于灵衢内存语义的 KV Pool 实践:把不同设备、不同层级的内存资源池化、共享并统一访问,用来扩展 KV Cache 可用容量,减少显式数据搬运与 I/O 开销。这是灵衢 Load/Store 语义第一次在推理侧的关键负载上被第三方开发者公开验证,方向恰好压在长上下文与 Agent 工作负载的增长曲线上。浙江大学团队的 UBSIM 仿真平台则支持从并行方式、网络拓扑到算力配比的跨层级联合仿真,给伙伴提供了不买硬件就能评估灵衢架构的工具。
开放边界:免费、免诉,但是禁分叉
生态的另一半是许可条款。2.1 配套的许可协议升级到 V2.0,条款结构延续:免费的版权许可,非排他、不可分许可、不可转让,仅限为开发符合灵衢规范的产品而实施。禁令部分逐字可查:不得以任何方式修订、更改、修改灵衢规范或制作衍生作品,不得摘录或引用规范的任何内容用于开发其他标准。规范原文写道:华为可能在其认为必要或适当的情况下对本规范进行更新,您同意华为对本规范的更新不需要事先对您进行通知。
把朱照生的平等、中立、完全开放,和这份禁分叉条款放在一起读,才看得清灵衢开放的真实形状。对位三种模式:NVLink 是封闭自营,联盟外的公司拿不到;UALink 和 UEC 是联盟共治,成员坐一桌写规则;灵衢是单方开放,规范随便看、随便实现、免费商用,但规范文本的控制权百分之百在华为手里。生态成员能造芯片(楠菲微)、能做整机(拓维等已按 2.0 自建超节点)、能写上层软件(openEuler 组件已开源),唯独不能改协议本身,也不能把协议内容搬去别的标准。
这是一个理性但不宽松的选择。它的好处是演进速度快,2.0 到 2.1 只用一年,路线不受联盟政治牵制;代价是生态成员的参与深度有天花板,买单者的规模意志无法进入规范层。灵衢生态更可能的形态是国内的深度协作圈,而不是一个国际标准组织。两种生态各挣各的钱,模式不同,无关高下。
总结与判断
本文拆了《灵衢基础规范 2.1》的 586 页:三档速率与 Gearbox 的物理层节奏、网络层重路由补齐的三级可靠性、融合写与队列事务的事务层升级、24 位地址与国际标准引用清单,以及论坛上第一次成形的生态时间表。三个判断收尾。
第一,计算互联的速率节奏开始独立于以太网。212.5G 对齐以太网阶梯是产业兼容的地基,224G 对齐光物理是自家产品的跑道,256G 对齐 PCIe 是生态野心的门。三档各有各的对齐对象,说明速率表是自己排的,不是从网络互联抄的。往后判断计算互联路线图的成熟度,可以看一条:它的速率世代是否继续独立演进。
第二,2.1 是 960 世代可持续运行的协议前提。规范 9 月 15 日定稿、18 日发布,960 超节点 17 日登台,同周节奏说明华为的规范与产品已经咬合联动。重路由与内存 RAS 直接支撑 99.8% 可用度的宣称,24 位地址给 4096 卡之上的扩展留好了寻址余量。看超节点故事时,协议版本线和产品版本线应该并排看。
第三,灵衢生态正在从纸面开放走向硅上落地,但天花板也在明处。1000 套商用、楠菲微的 2026 互通与 2028 量产、兼容测试规范就位,是落地的第一组实证。标识库里至今只有华为一家厂商,是天花板的刻度。禁分叉的许可模式决定了它是国内深度协作型生态而非国际标准型,2028 年楠菲微量产成不成,是这个判断的第一块试金石。
后继重点关注四件事:UB 3.0 的时间表与架构方向,是否触碰 Load/Store 语义;楠菲微年底三方互通测试的结果;标识库出现第二家厂商的时间;KV Pool 是否进入 vLLM 主线。四件事任何一件落地,都值得回来看一次灵衢。
信源
- 《灵衢基础规范 2.1》(UB-Base-Specification-2.1.0-zh-clean.pdf,586 页,2026-09-15 定稿,unifiedbus.com):速率表 3-1、Data_Rate_Support_2、FEC 码族、3.5 UB Gearbox、5.3.9 可靠重路由、7 章事务层 opcode 表、附录 I 表 I-3、修订记录(除标注外,本文机制细节与数字均出自规范原文)
- unifiedbus.com:首页公告卡(官方四句概括)、《灵衢基础规范 2.1》《灵衢兼容性测试规范 2.0》卷一上线公告(2026-09-18)、灵衢技术论坛新闻页(2026-09-20 刊发:1000 套、30+ 单位、楠菲微时间表、KV Pool、UBSIM)、标识库厂商标识与设备标识页
- 华为全联接大会 2026 首日发布素材(昇腾 960 新闻稿、主题演讲与海思光电披露;本站《昇腾 960》篇有逐项核对):4096 卡、Hi-ONE 5500 颗光引擎、2 微秒 RTT、99.8% 可用度、无故障运行时间翻倍
- 公众号「积跬步以集大成」《华为重磅发布:灵衢基础规范 2.1》(2026-09-16/17):对整部规范的万字深读,三档速率产业意图与生态定位的解读参考(42dB 插损、指针字段拼写等与规范原文不一致处,本文已按规范原文订正)
- 站内相关文章:《昇腾 960:制程不动,算力翻倍》、《华为的一张网:HC 2026 网络全景》、《灵衢是什么:华为 UnifiedBus 协议与超节点互联解析》