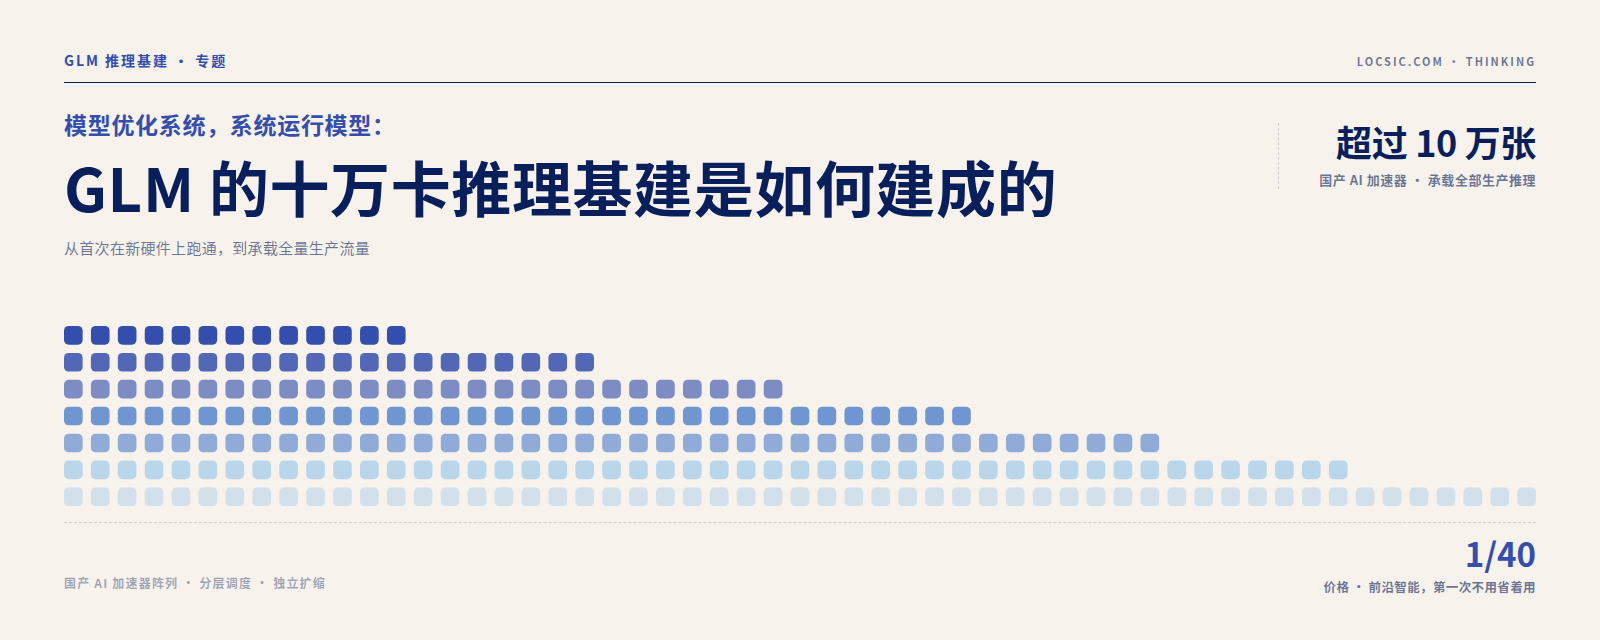
9 月 17 日,智谱 GLM 团队发布了一篇技术博客,标题里有两个词值得停下来看:递归自我改进(Recursive Self-Improvement,RSI),以及「自己建」(How GLM Built Its Own Inference Infrastructure)。概念先搁一边,把数字摆出来:GLM-5.3-Flash 的全部生产推理,跑在超过 10 万张国产 AI 加速器组成的集群上,从首次在新硬件上跑通,到承载全量生产流量,只用不到两周;端到端服务性能提升到初始基线的约 3 倍,硬件效率与单 token 成本达到主流 NVIDIA GPU 相当水平。发布前的匿名测试里,它以 Ox-Alpha(中文社区叫它「牛来」)为名在 OpenCode 与 OpenRouter 上,一周内成为两个平台使用量最高的模型,六天处理超过 62 万亿 token。
这份材料回答的不是「模型有多强」,而是一个更实际的问题:大规模推理基础设施,到底是怎么建成的。本文按三层来拆:地基工程(引擎、架构与内存)、反馈工程(dense feedback 方法论)、工程循环(人与 Agent 怎么分工)。主源是 9 月 17 日的 RSI 博客,辅以 8 月 26 日的 GLM-5.3-Flash 官方推送与技术博客。后训练是这个模型的前一环,我们在《不换发动机的换代:GLM-5.3 与后训练的下半场》里拆过,可对照阅读。
地基工程:把「没人做过」拆成清单
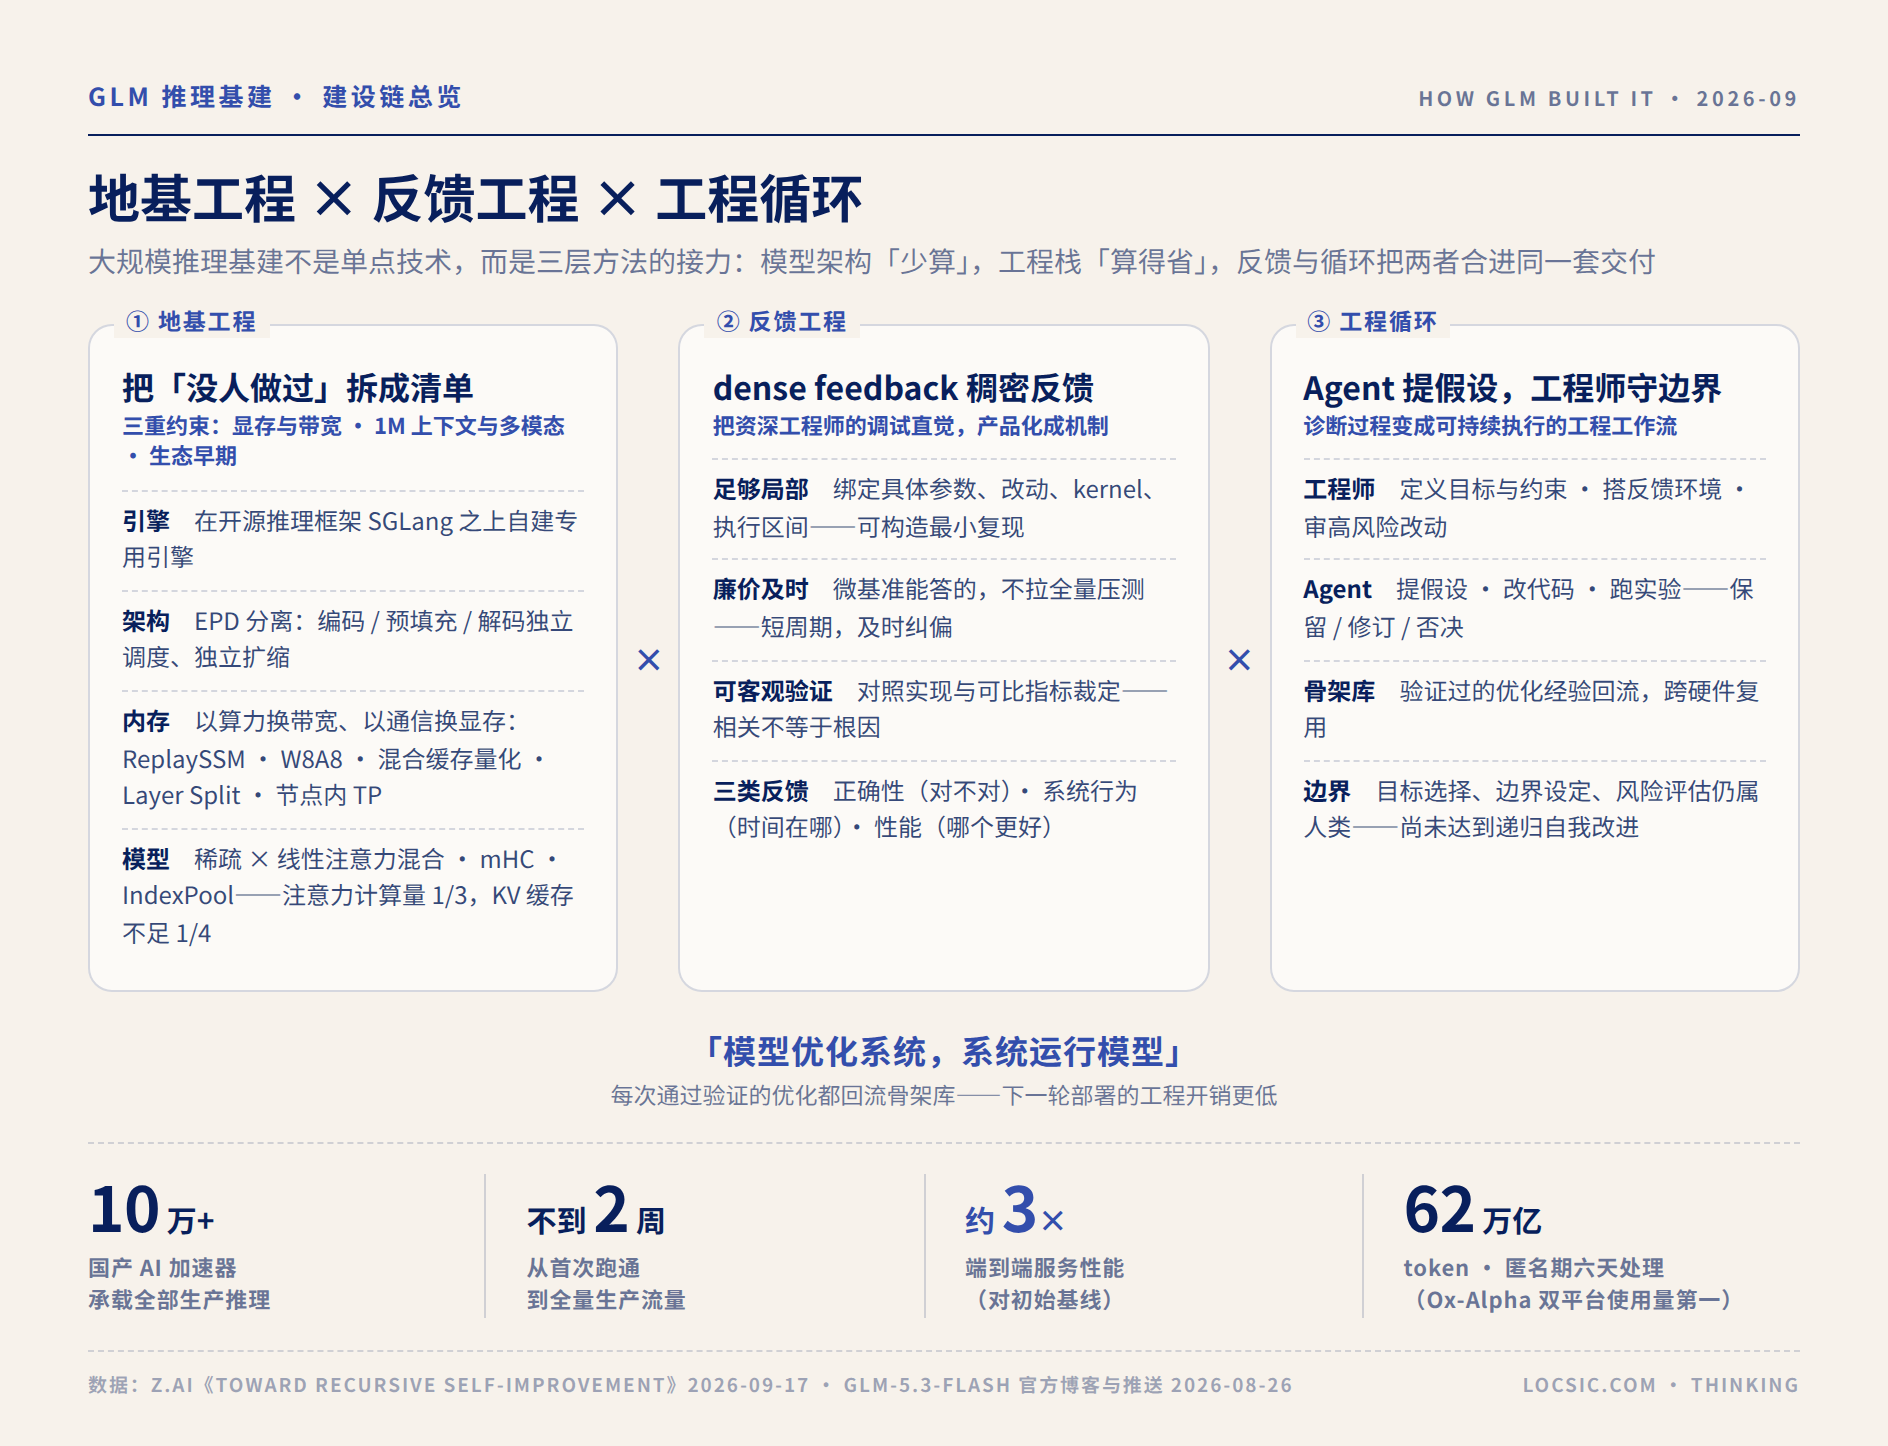
把大模型从「在新硬件上首次跑通」推进到「稳定承载生产请求」,是系统工程的重活。这一次的特殊之处,是三道约束同时在场:国产芯片的显存容量与互联带宽相对有限,模型侧要支持 1M token 上下文与多模态请求,软件生态也还在早期,部分 kernel 支持不足,很多资料要靠团队自己摸索。GLM-5.3-Flash 又是 GLM-5 系列第一个原生多模态模型(320B 总参、18B 激活),可以借鉴的现成经验几乎为零。
团队拆出来的工程动作分四类。引擎:在开源推理框架 SGLang 的基础上,为这套硬件构建专用推理引擎。架构:生产级 Encode-Prefill-Decode(EPD)分离架构,把多模态编码、预填充、逐 token 解码拆成独立调度、独立扩缩容的工作池。
内存:「以算力换带宽、以通信换显存」的组合拳,包括用于线性注意力与 LM Head 的节点内张量并行、ReplaySSM(以重放一段计算换取显存)、W8A8 量化(权重与激活都压到 8 比特)、INT8/FP8/BF16 混合精度缓存量化、Layer Split。模型:架构本身就按极低成本推理设计:稀疏注意力与线性注意力的混合架构(GLM 系列首次)、mHC(流形约束超连接,进一步提升扩展效率)、IndexPool(把索引器的四个键向量加权池化为一个)。相比 GLM-5.3,注意力计算量降为三分之一,KV 缓存缩小到不足四分之一。
这四类不是并列关系,而是接力关系:模型架构负责「少算」,工程栈负责「算得省」,两个方向在同一套交付里合并。最终成绩:端到端服务性能提升到初始基线的约 3 倍,单 token 成本与主流 NVIDIA GPU 相当。官方结论说得克制:国产芯片可以在大规模场景下高效、经济地支撑前沿模型推理。这句话的验证标准比「跑通」严格得多,它要求的是全量生产流量下的成本线。
反馈工程:dense feedback,把调试直觉产品化
如果只说优化结果,这篇文章会和大多数工程复盘一样:堆人力、耗时间、出数字。真正让它不同的是中间的方法——团队把它称为 dense feedback(稠密反馈)。
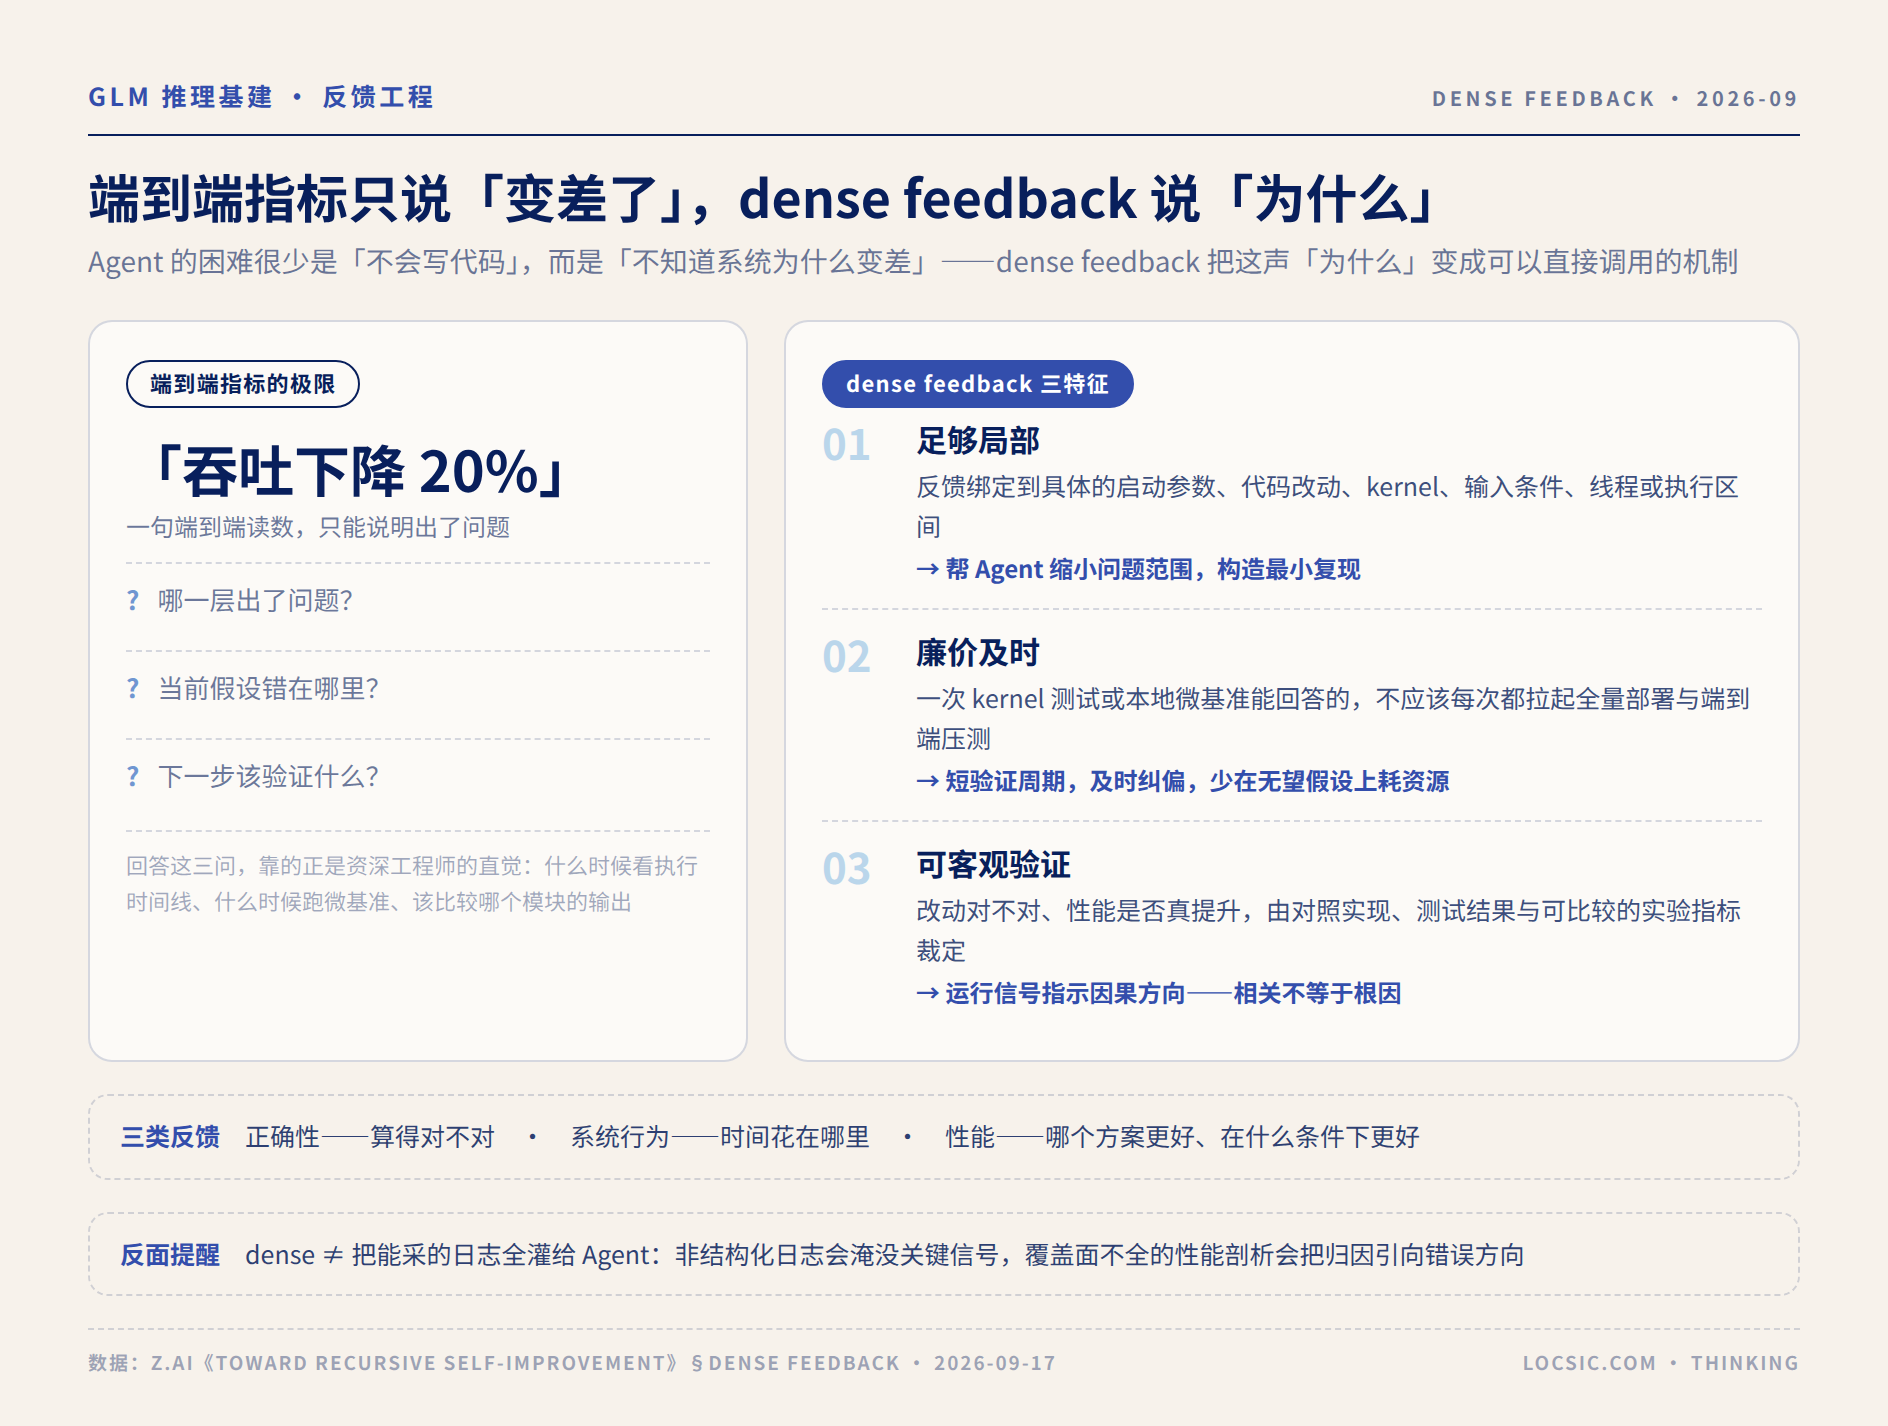
问题定义得很准:在推理系统优化里,Agent 的困难很少是「不会写代码」,而是「不知道系统为什么变差」。端到端指标报一句「吞吐下降 20%」,它只能说明出了问题,不能告诉 Agent 哪一层出了问题、当前假设错在哪里、下一步该验证什么。资深工程师靠的是经验直觉:什么时候看执行时间线、什么时候跑微基准、该比较哪个模块的输出。dense feedback 要做的事,就是把这套直觉变成 Agent 可以直接调用的反馈机制。
它有三个特征。足够局部:反馈要绑定到具体的启动参数、代码改动、kernel、输入条件、线程或执行区间,帮助 Agent 缩小问题范围。与其报「某次融合优化后模型精度下降」,不如给出某个具体请求在改动前后的输出差异,让它能构造最小复现。廉价及时:能用一次 kernel 测试或本地微基准回答的问题,不应该每次都拉起全量部署和端到端压测,短验证周期让 Agent 及时纠偏,少在无望的假设上耗资源。可客观验证:改动是否正确、性能是否真的提升,要由对照实现、测试结果和可比较的实验指标裁定,运行信号能指示因果方向,但相关不等于根因。
三类反馈各回答一个问题:正确性反馈回答「算得对不对」,系统行为反馈回答「时间花在哪里」,性能反馈回答「哪个方案更好、在什么条件下更好」。团队同时提醒了反面:dense 不是「把能采的日志和指标全灌给 Agent」,大量非结构化日志反而会淹没关键信号。覆盖面不全的性能剖析,会把归因引向错误的方向。
三个案例:从「变差了」到「为什么变差了」
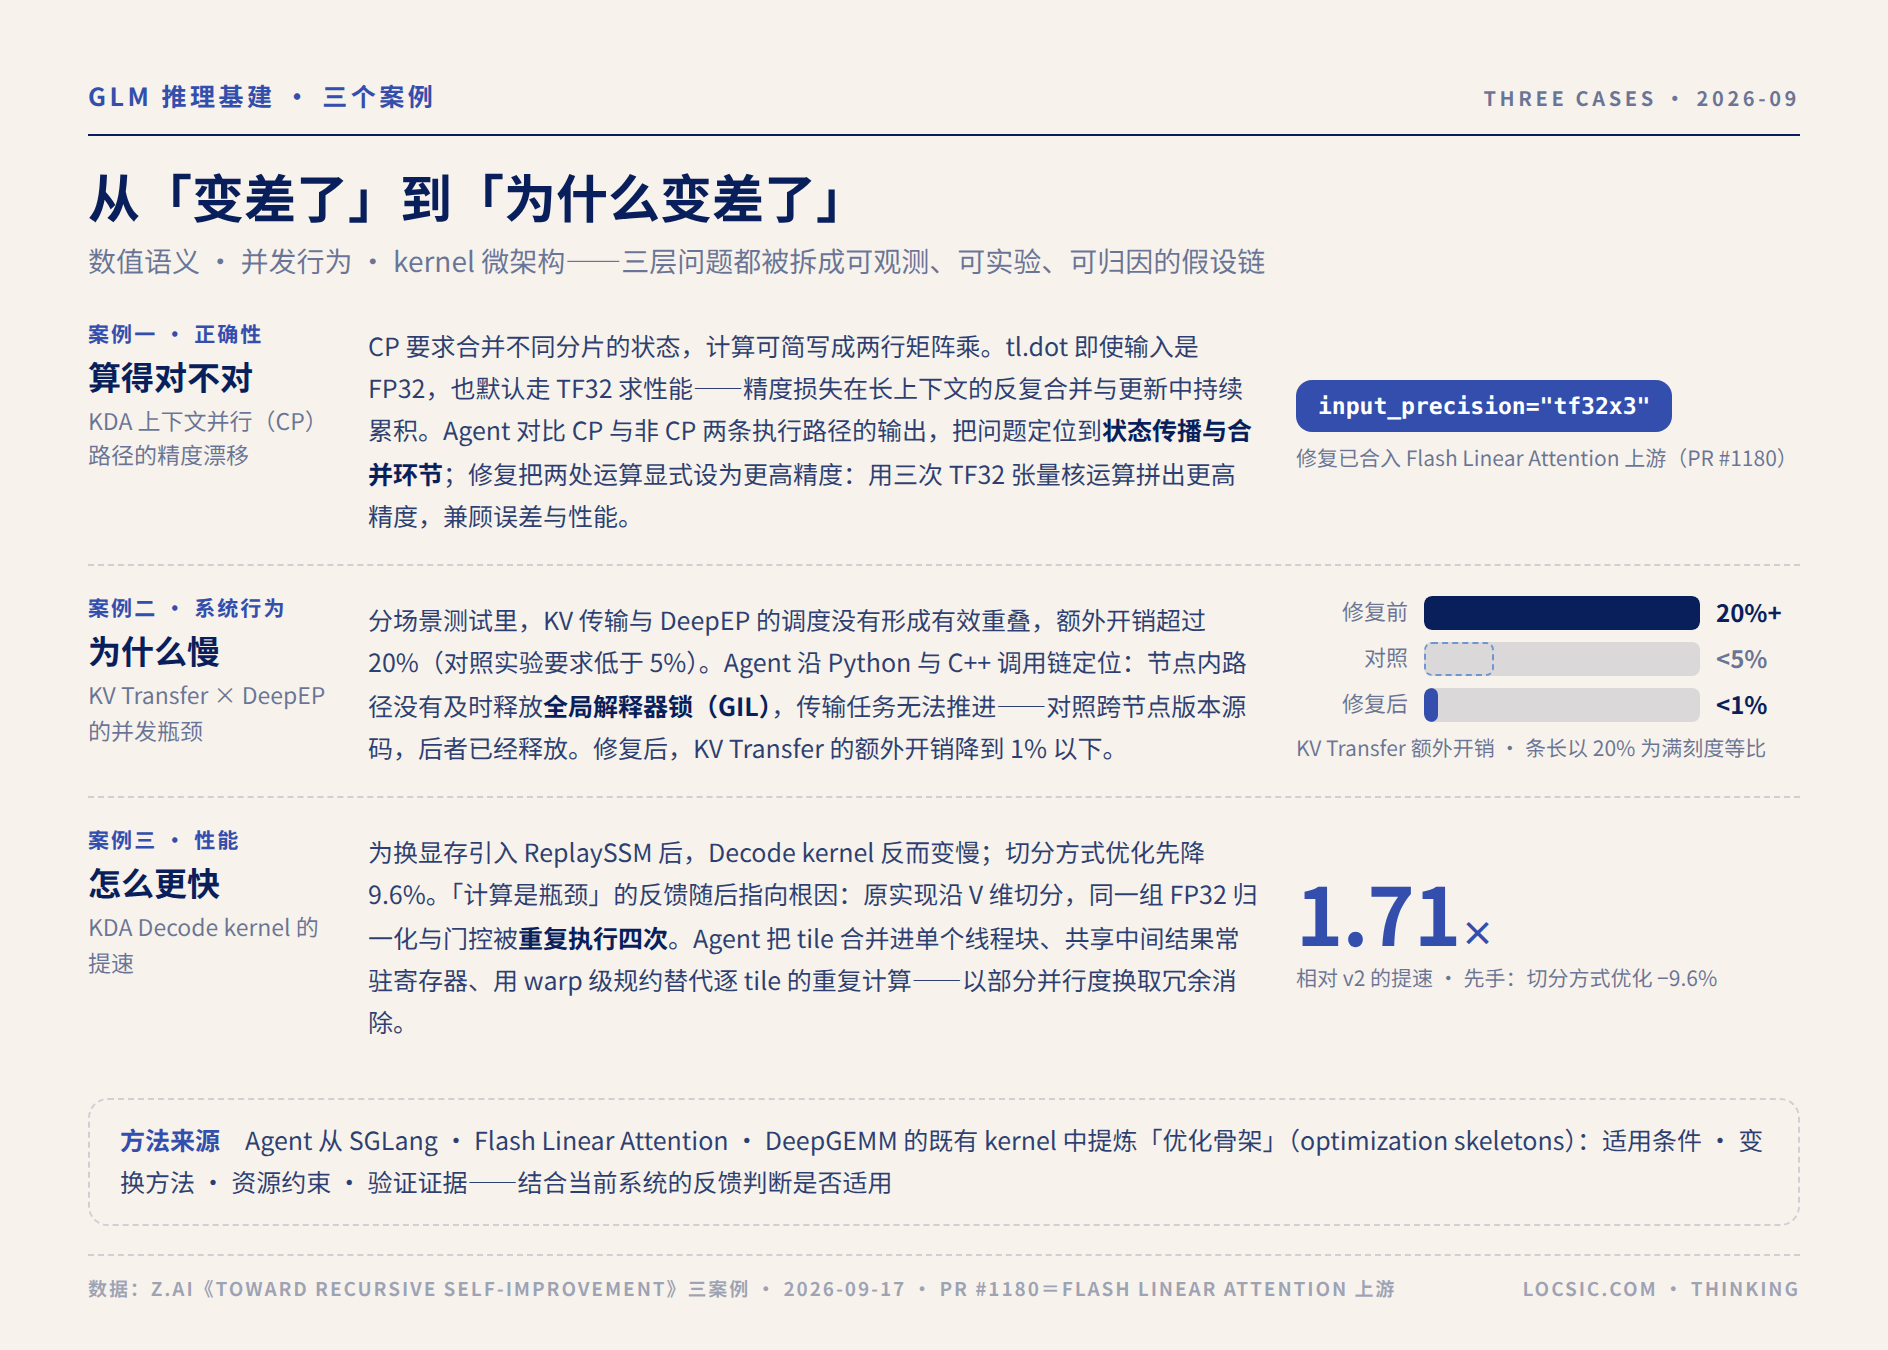
博客用三个案例展示了这套反馈如何工作,分别对应「算得对不对」「为什么不够快」「怎么更快」。
正确性:KDA 上下文并行路径的精度漂移。KDA 是模型里的 kernel 之一。上下文并行(CP)要求把不同分片的状态合并,核心计算可以简写成两行矩阵乘:合并分片间的状态变换,再更新下一分片的初始状态。原始实现里,tl.dot(Triton 里的矩阵乘算子)即使输入是 FP32,也默认走 TF32 计算以求性能(TF32 是英伟达 GPU 上一种精度低于 FP32 的浮点格式)。精度损失在长上下文下的反复合并与更新中累积,误差越来越明显。Agent 通过对比 CP 与非 CP 两条执行路径的结果,把问题定位到状态传播与合并环节。修复方式是把两处运算显式设为 input_precision="tf32x3",用三次 TF32 张量核运算拼出更高精度,兼顾误差与性能。相关修复已合入 Flash Linear Attention 上游(PR #1180)。
系统行为:KV Transfer 与 DeepEP 的并发瓶颈。在工程师定义的分场景测试里,KV 传输与开源专家并行通信库 DeepEP 的调度没有形成有效重叠,额外开销超过 20%,而对照实验要求低于 5%。Agent 沿 Python 与 C++ 调用链继续定位,发现节点内路径没有及时释放 Python 的全局解释器锁(GIL),传输任务无法推进;对照跨节点版本的源码,后者已经释放。修复之后,KV Transfer 的额外开销从 20% 以上降到 1% 以下。
性能:KDA Decode kernel 的 1.71 倍。为换取显存而引入的 ReplaySSM,让 kernel 从 v0 到 v1 反而变慢。除法优化后,v1 再降 9.6%。随后 Agent 收到「计算是瓶颈」的反馈,发现原实现沿 V 维切分,导致同一组 FP32 归一化与门控计算被重复执行四次。它把 tile 合并进单个线程块、让共享中间结果常驻寄存器、用 warp 级规约替代逐 tile 的重复计算,以牺牲部分并行度换取冗余消除,相对 v2 提速 1.71 倍。
这段优化里,方法的来源比数字更值得注意:Agent 从 SGLang、Flash Linear Attention、DeepGEMM 等项目的既有 kernel 中提炼「优化骨架」(optimization skeletons),每套骨架包含适用条件、变换方法、资源约束、验证证据四件套,再结合当前系统的反馈判断是否适用。优化经验第一次从工程师的个人积累,变成了可跨硬件复用的结构化资产。
三个案例的共同点:不同层次的问题(数值语义、并发行为、kernel 微架构),都被拆成了「可观测、可实验、可归因」的假设链。用博客里的一句话收束这一节:反馈的价值不在数量,而在于它能否帮 Agent 回答手头的问题。
工程循环:Agent 提假设,工程师守边界
这套方法运转起来的组织形式,是一个三方循环。工程师负责三件事:定义优化目标与系统约束,搭建 Agent 可直接使用的反馈环境,审核涉及系统架构、异步并发与生产风险的改动。Agent 负责分析、提假设、改代码、跑实验,再根据反馈保留、修订或否决自己的方案。实验环境则提供分层、及时、可验证的反馈。博客里的描述很到位:这把「此前由工程师经验串联起来的诊断过程」,变成了「Agent 可以持续执行的工程工作流」。
两个角色都在变化。模型从「帮写代码」走到「理解系统为什么变化」,工程师从「解决每一个具体问题」转向「设计反馈系统」。而且每一次通过验证的优化,其经验都会回流到骨架库,让下一轮部署的工程开销更低。这就是「模型优化系统,系统运行模型」的循环红利。
边界也划得很清楚:尚未达到递归自我改进;目标选择、边界设定与风险评估,仍然属于人类的职责。RSI 的早期形态已经出现,但它现在的样子不是科幻叙事,而是一套纪律严明的工程流程。
商业飞轮:3 倍效率如何变成四十分之一价格
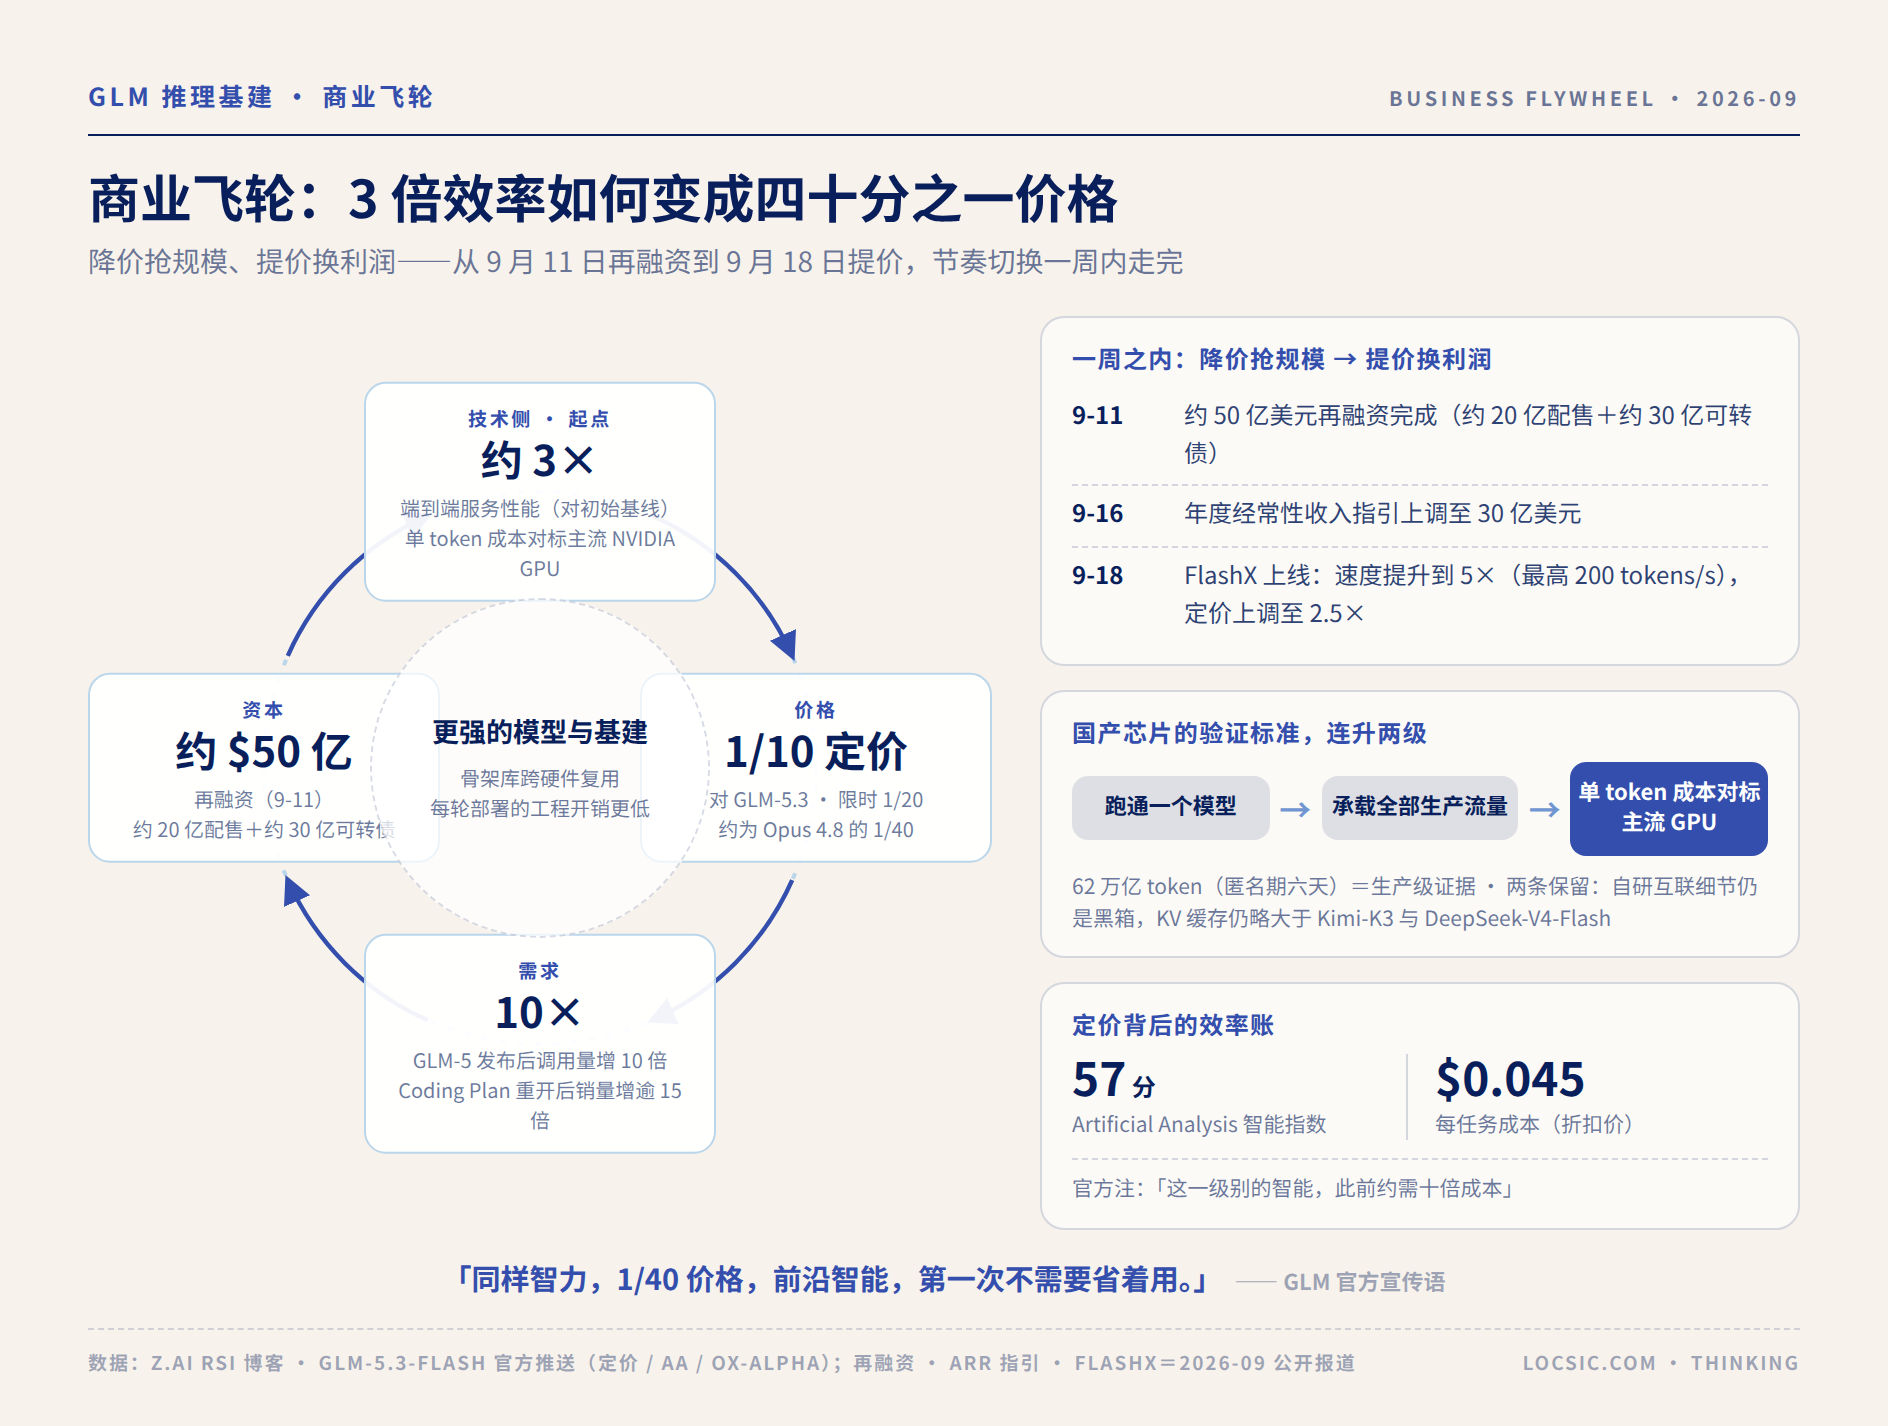
技术侧的 3 倍效率,很快传导到价格。GLM-5.3-Flash 的 API 定价为 GLM-5.3 的十分之一,限时折扣下为二十分之一,约为 Claude Opus 4.8 的四十分之一。官方的宣传语写得很直白:「同样智力,1/40 价格,前沿智能,第一次不需要省着用。」在 Artificial Analysis 智能指数上,它得到 57 分、每任务 0.045 美元(折扣价),官方注释是「这一级别的智能,此前约需十倍成本」。编程与 Agent 基准上,它全面超过 GLM-5.2(DeepSWE v1.1:63.4 对 46.2;AutomationBench:48.8 对 26.2),整体接近 Opus 4.8(Z.ai Code Bench 最高投入级 29.0 对 29.5)。
价格触发的需求爆发,在公开信息里有清晰的时间线。2 月 GLM-5 发布后调用量增长 10 倍,算力储备在发布当周耗尽,Coding Plan 一度停售,重新开放后销量增长超过 15 倍。9 月 11 日,公司完成约 50 亿美元再融资(约 20 亿配售加约 30 亿可转债)。9 月 16 日,年度经常性收入指引上调至 30 亿美元。9 月 18 日,FlashX 上线:速度提升到 5 倍(最高 200 tokens/s),定价上调至 2.5 倍。从 9 月 11 日再融资到 9 月 18 日提价,降价抢规模、提价换利润的节奏切换在一周之内走完。
产业含义落在国产芯片这一段:从「跑通」到「承载全部生产流量」,再到「单 token 成本对标主流 NVIDIA」,验证标准连升两级,62 万亿 token 是生产级证据。当然要标注两条保留意见。一是「自研高带宽互联网络」的公开表述仍然模糊,生态配套细节还是黑箱。二是 KV 缓存仍略大于 Kimi-K3 与 DeepSeek-V4-Flash(官方自述,优化仍有空间)。推理经济学的完整图景,推荐对照我们此前拆过的《Token 工厂账本:硅基流动招股书里的推理经济学》一起看:一边是模型公司的自建路径,一边是第三方推理工厂的成本结构。
总结与判断
三个判断。
第一,推理基建的竞争单位,正在从「芯片/模型」变成「工程循环」。 这次案例里最可复用的资产,是「dense feedback 加工程循环」这套方法。它回答的是基础设施工程里最贵的问题(为什么变差),并把答案的组织方式产品化了。它不依赖特定芯片:反馈三特征与骨架库在任何硬件上都成立,这决定了方法的扩散速度会快于任何单点技术。
第二,国产芯片的验证标准升级到了「生产流量+成本对标」。 从「跑通一个模型」到「承载全量生产流量、单 token 成本对标主流 GPU」,这一级台阶已经跨过。下一道门在生态:互联细节的黑箱、KV 优化的余地、多模型多厂商的第二批验证,决定这级台阶能否站稳。
第三,RSI 叙事要按可证伪的方式读。 官方自己划了边界:目标、边界、风险仍属人类。真正的观察指标不是「AI 是否在改自己」的口号,而是反馈环境能否持续产出结构化工程数据、骨架库能否跨代复用——如果每次部署的工程开销持续下降,最小闭环就会自我放大;如果停在单个案例,它就只是一个漂亮的工程故事。
后续关注点:一,GLM-6.0「完全自训练」的进展披露;二,dense feedback 体系是否会以论文或工具形态开放;三,FlashX 上线后的实际体验与定价策略后续;四,更多厂商跟进 Infra Agent(用 Agent 承担基建优化)工程循环的速度;五,国产芯片集群的下一批生产验证(多模型)。
信源
- 智谱 GLM 团队:Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure(z.ai blog,2026-09-17,https://z.ai/blog/glm-built-its-inference-infrastructure ):不到两周、10 万卡、约 3 倍、62 万亿 token、dense feedback 三特征、三个案例、工程循环与边界声明
- 智谱 GLM 团队:GLM-5.3-Flash: Frontier Intelligence, Flash Cost(z.ai blog,2026-08-26,https://z.ai/blog/glm-5.3-flash ):模型架构与基准、国产芯片服务段、3 倍与成本对标表述
- 智谱官方推送:《GLM-5.3-Flash:前沿智能进入普惠时代》(2026-08-26;经智通财经镜像核读):定价结构(1/10、限时 1/20、Opus 4.8 的 1/40)、Ox-Alpha、工程栈细节
- 商业侧公开信息:约 50 亿美元再融资(2026-09-11,财经媒体报道);年度经常性收入指引上调至 30 亿美元(2026-09-16,分析师电话会报道);GLM-5.3-FlashX 上线(新浪科技,2026-09-18);GLM-6.0「完全自训练」蓝图披露(2026-09-15/16,公开报道)
- 本站前作:《不换发动机的换代:GLM-5.3 与后训练的下半场》;《Token 工厂账本:硅基流动招股书里的推理经济学》