
——scale-up 网络的协议与芯片选择
摘要:10 月 7 日 Arista 发布 scale-up 架构 SU-144:单跳最多 144 个、跨机架 1024 个加速器,用以太网做背板、配套液冷机架参考设计。两层选择:协议上,ESUN 以 4 字节头和链路级可靠改造以太网,同内存语义的 UALink、NVLink 竞争;芯片上不自研,7060XE7 采用博通 Tomahawk 6。scale-up 的收入兑现,仍取决于开放阵营的实际部署。
2026 年 10 月 7 日,OCP 全球峰会开幕前五天,Arista 发布了两个相互配套的部分:scale-up 架构 Etherlink SU-144,定义机架级的加速器互连;以及一套液冷机架参考设计,把交换机、软件、液冷、光纤管理、电源和漏液检测打包成可整机交付的方案,由集成商组装测试后运抵机房。发布阵容包括 AMD、Arm、博通、d-Matrix、Meta、微软和高通。
对 Arista 来说,这是 2004 年成立以来最大的一次身份变化。过去二十多年,它的商业模式可以概括成一句话:用最好的商用芯片,跑最好的网络操作系统,卖最好的交换机。AI 把这个模式的边界推到了机架内部——当加速器之间的通信成为性能瓶颈,网络不再只是服务器之间的管道,而是机架里所有加速器共享的背板。Arista 的高级副总裁 Tyson Lamoreaux 在新闻稿里说得很直白:「AI 时代的网络不再只是服务器之间的一条独立管道。它现在是一个紧耦合的机架级背板,直接决定计算能发挥多少价值。」
这次发布值得认真拆解,因为它是三个选择的叠加:协议上选以太网(ESUN),芯片上选博通(Tomahawk 6),交付上选机架(参考架构加验证套件)。本文依次展开这三层,再看竞争格局和收入现实,最后给出判断。
一、同日发布的两部分:SU-144 与机架参考设计
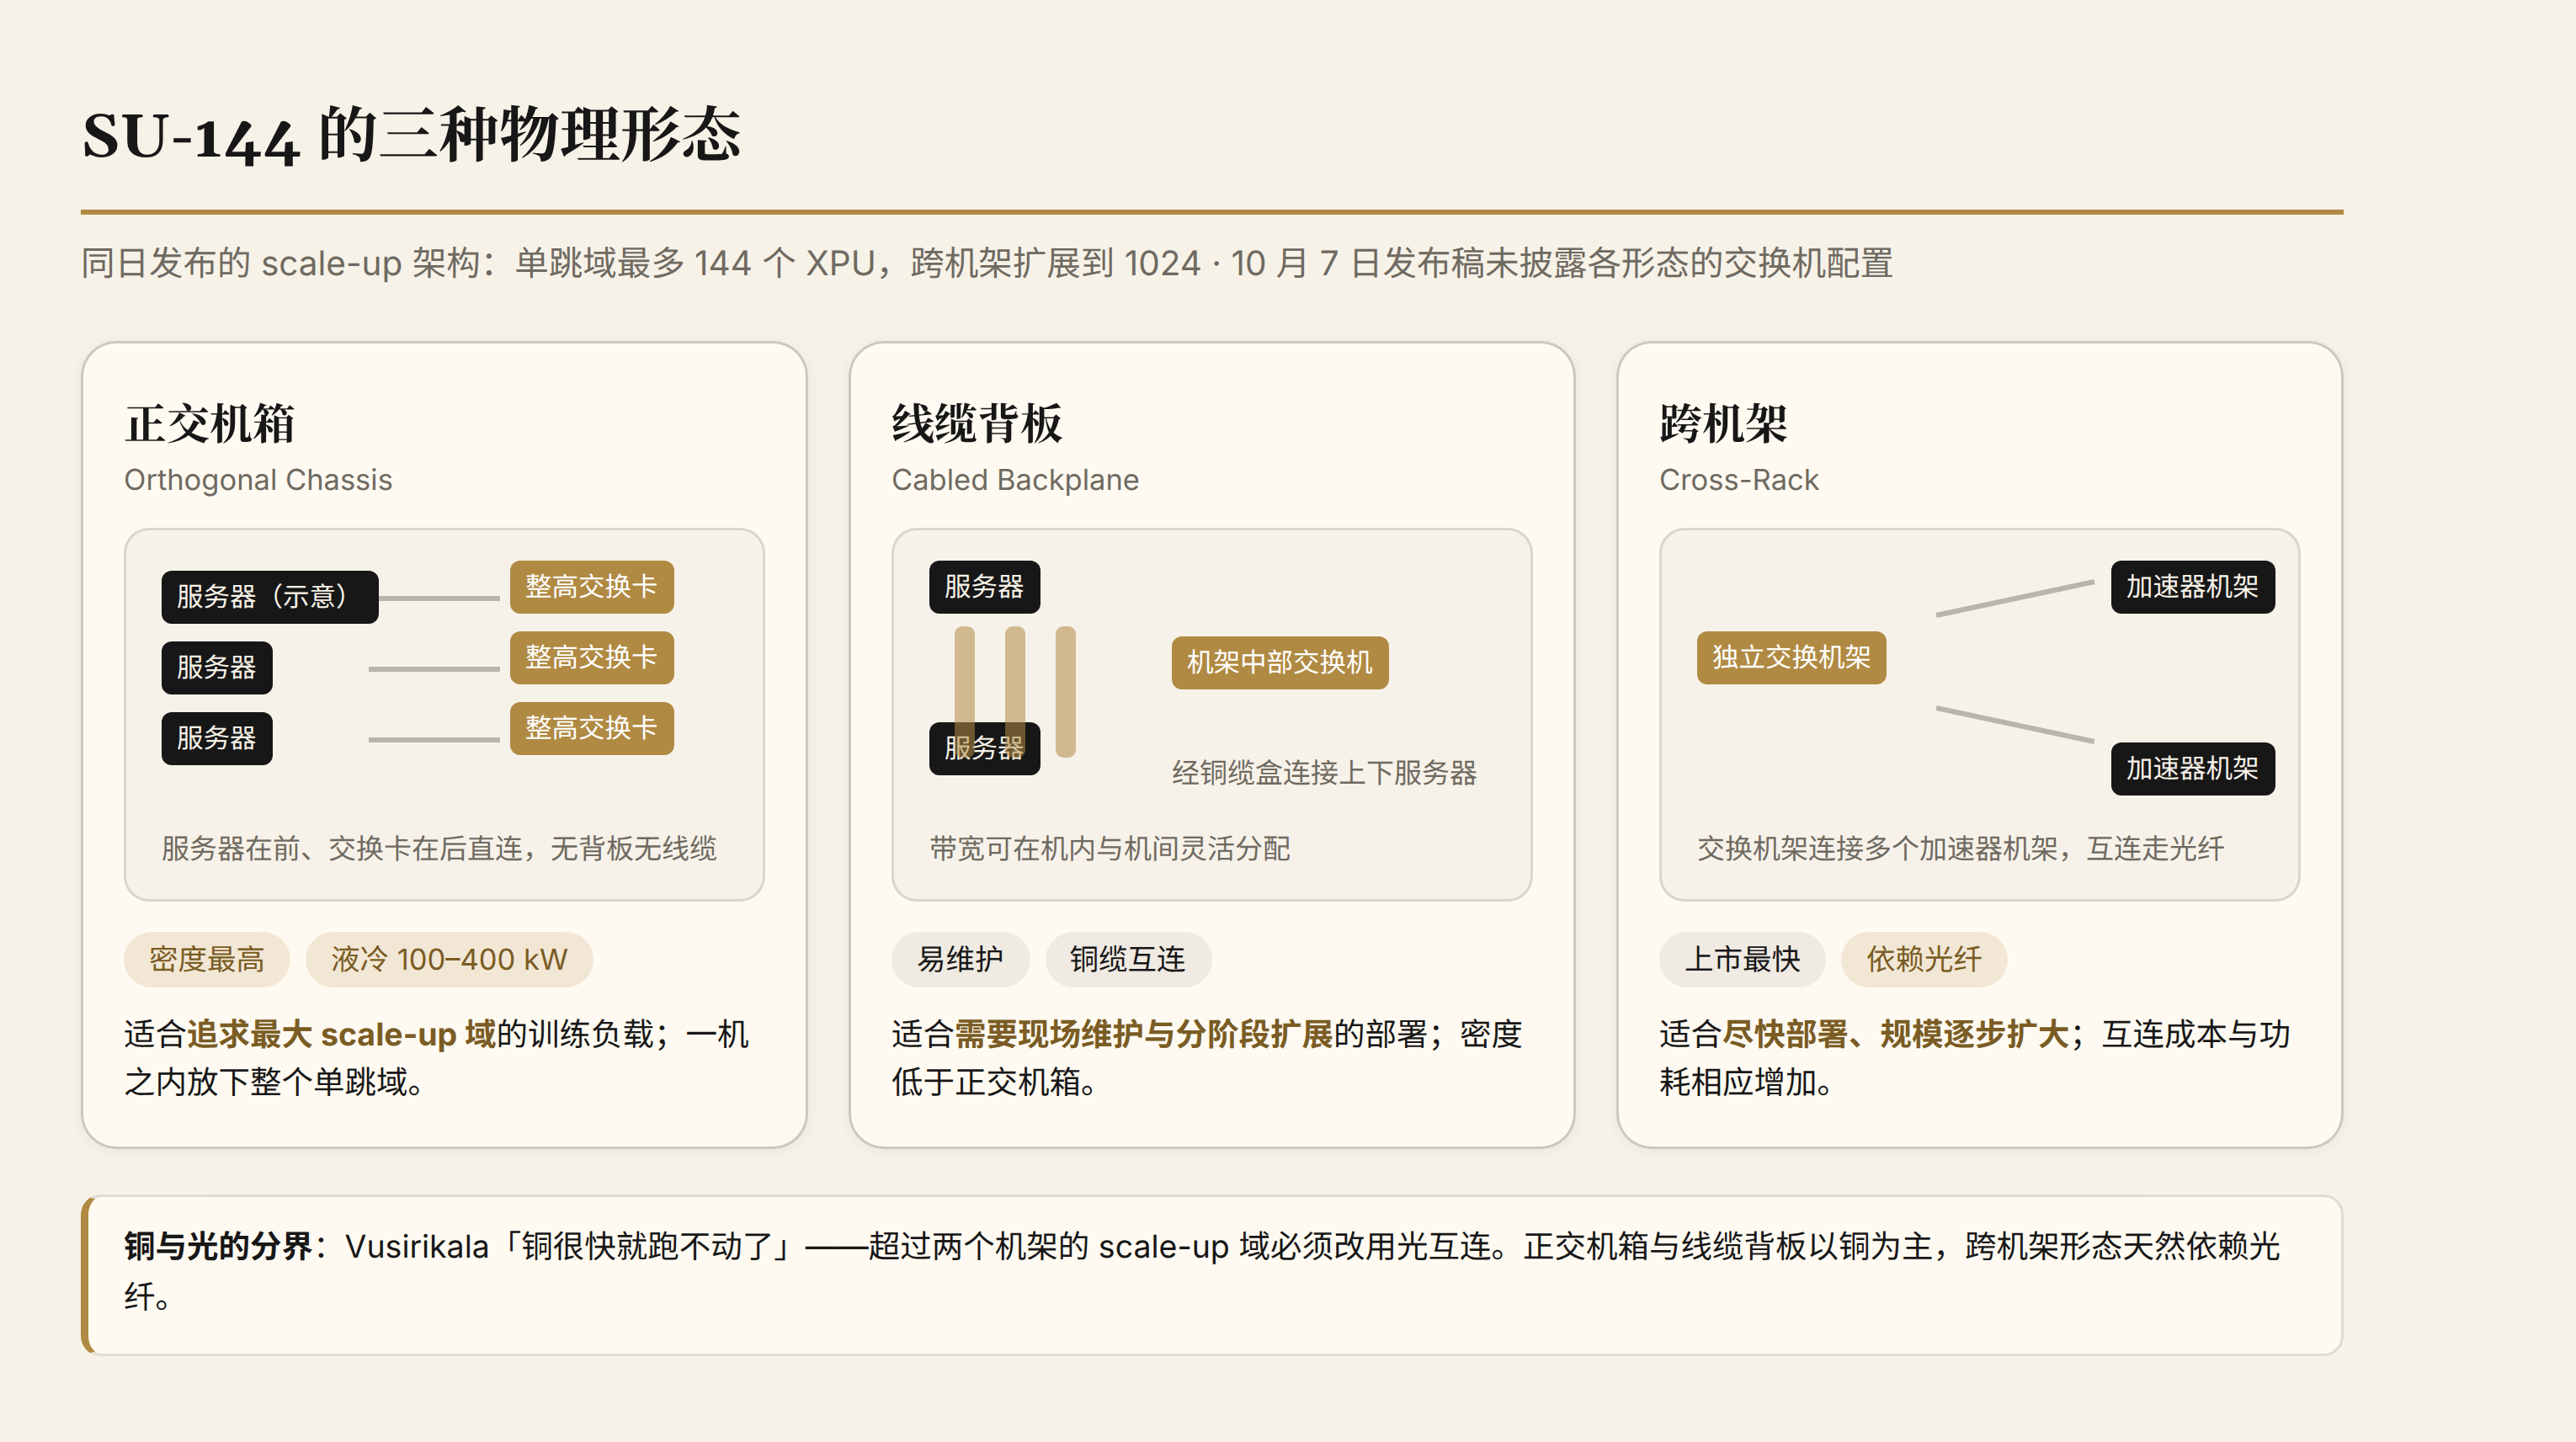
**SU-144 是一个 scale-up 架构。**它把一个机架乃至多个机架的加速器连成一个共享计算域:单跳网络内最多 144 个 XPU(加速器),跨机架拓扑扩展到 1024 个。作为对照,NVIDIA 当前的 NVLink 机架域是 NVL72/NVL144 这一档。Arista 用三种物理形态覆盖三类需求:
| 形态 | 结构 | 特点 | 适合谁 |
|---|---|---|---|
| 正交机箱 | 服务器在前,整高交换卡在后直连,没有背板也没有线缆 | 密度最高;液冷 100–400 kW | 追求最大 scale-up 域的训练负载 |
| 线缆背板 | 交换机位于机架中部,经铜缆盒连接服务器 | 密度较低但易维护;带宽可在机内与机间灵活分配 | 需要现场维护和分阶段扩展 |
| 跨机架 | 独立的交换机架连接多个加速器机架 | 上市最快;增加互连成本与功耗 | 尽快部署、规模逐步扩大 |
值得注意的是,10 月 7 日的发布稿只给了三种形态的结构描述,没有披露各形态分别用什么交换机、怎么组网。Arista 的交换机底座在同日发布的另一部分里。
**同日发布的还有 scale-out 机架参考设计。**这部分明确了硬件:每机架 8、12 或 16 台液冷 7060XE7 系列交换机(单台 102.4 Tbps),加上光纤配线架、液冷歧管、带主动漏液检测的接水盘、机架管理控制器和带电池备份的电源架。scale-out fabric 支持超以太网联盟(UEC)规范、多路径可靠连接(MRC)、多平面路由和动态/集群负载均衡;并且明确支持多种 scale-up 协议共存——ESUN、NVIDIA 的 NVLink、NVLink Fusion,甚至 PCIe。也就是说,Arista 不排斥「NVLink 域加以太网 scale-out」的组合。
两个部分用的是同一套交付模式。一个 16 台交换机的机架配置涉及约 2000 根光纤,现场布线意味着弯径违规、错插、信号完整性问题和坏光模块。Arista 高级产品线经理 Arihant Jain 的判断是:「现场组装、备件替换的老办法必须改变。」机架要在上游集成、测试,再整体运进机房。液冷进一步把这件事变成刚性要求:交换机、冷却歧管和漏液响应必须一起设计——检测到漏液时关一台交换机还是关一排机架?这个决定要不要联动楼宇管理系统?这些以前是设施团队的问题,现在成了网络问题。按 Arista 在分析师简报里给的预期,100T 级交换机明年液冷与风冷约各占一半,到 200T 一档,液冷实质成为必需。
于是 Arista 的角色变成:出交换机、软件(自研 EOS 或开放 NOS 二选一)和设计文档;Netdi 提供统一的诊断与遥测底座,无论跑 EOS 还是 SONiC 都能拿到同一套硬件级诊断。按 Arista 的说法,Netdi 背后累计投入超过 8000 人年,覆盖信号完整性验证、安全启动认证、单粒子翻转容错、光模块与液冷监测。在整机架预集成的交付里,这些硬件级验证能力直接决定机架到场后能不能一次点亮。集成商负责整机架交付。
物理层的路线图也一并给出:今天的 OSFP 可插拔光模块约 1.6 Pb/s 每机架;下一代 XPO 可插拔光模块加开放 CPO/NPO(共封装/近封装光学),提升到 6.5 Pb/s 每机架,数据中心占地省近一半。
这条产品线的时间线分三层:芯片层,博通 Tomahawk 6 在 2025 年年中发布出样、2026 年 3 月宣布规模量产;交换机层,7060XE7 系列今年 6 月发布,按官网分批上市——64 端口 1.6T 空冷机型计划 2026 年四季度,64 端口液冷机型与 128 端口 800G 机型计划 2027 年一季度;机架层,10 月 7 日发布的是参考架构与验证套件,OCP 峰会现场演示整机架。
铜是物理约束的分界线。Arista 负责 AI 系统的 Vijay Vusirikala 在分析师简报里的原话是「铜很快就跑不动了」——超过两个机架的 scale-up 域必须改用光互连。这决定了三种形态的长期排序:正交机箱和线缆背板以铜互连为主,跨机架形态天然依赖光纤。
二、协议选择的起点:scale-up 网络要什么
scale-up 与 scale-out 的区别不在带宽大小,在耦合程度。scale-out 网络连接独立计算节点,承载相对松散的分布式流量;scale-up 网络要把一个机架乃至多个机架的加速器变成一个共享的计算域,承载高频、同步的集合通信(all-reduce、all-to-all)。这决定了 scale-up 网络的技术特征。Arista CEO Jayshree Ullal 与首席开发官 Hugh Holbrook 在 ESUN 发起时的博客里总结了三条:集群内最高带宽、最低时延;跳数压到最少(典型部署是机架内单跳);可靠、按序交付。
这三条允许协议做有针对性的简化,但「简化」不等于「把可靠性问题删掉」。以太网在 scale-up 域里的分工要分两层看。网络层报文头可以做小、转发可以极简:链路误码丢包由链路级重传(LLR)在链路两端之间恢复,缓冲溢出靠基于信用的流控(CBFC)从发送侧限发来避免;但当域的规模超出单台交换机的扇出、或每个加速器的通道数不够用时,就会用到层次化多跳拓扑——ESUN 1.0 为此把层次拓扑、瞬态与持续拥塞控制和路径级故障恢复都写进了规范要求。端点层由 XPU 内的传输栈负责端到端可靠:规范写得明确,链路误码之外的丢包「仍需端到端恢复机制处理」。换句话说,以太网换个小报头不会自动变成一套可靠的共享内存系统;它提供的是低开销、高确定性的数据通路,端点上的事务、排序与重传由 XPU 侧的传输栈负责。
历史上有过三个答案。PCIe 是「本地」互连,CPU 与单机加速器之间够用;Arista 新闻稿开头就把「本地 PCIe 与专有互连的极限」列为发布动机,这个论断对应的是机架级互连的需求场景。NVLink 是唯一被大规模验证的专用 scale-up fabric;也正因为它的成功,其他所有加速器厂商都需要一个自己的答案。
到 2026 年 10 月,这个答案收敛成三条活跃路线:NVLink Fusion(专有平台开放接入点)、UALink(开放内存语义)、ESUN 加 SUE-T(开放以太网)。PCIe/CXL 的重心在机箱内与内存池。
三、四条路线的取舍
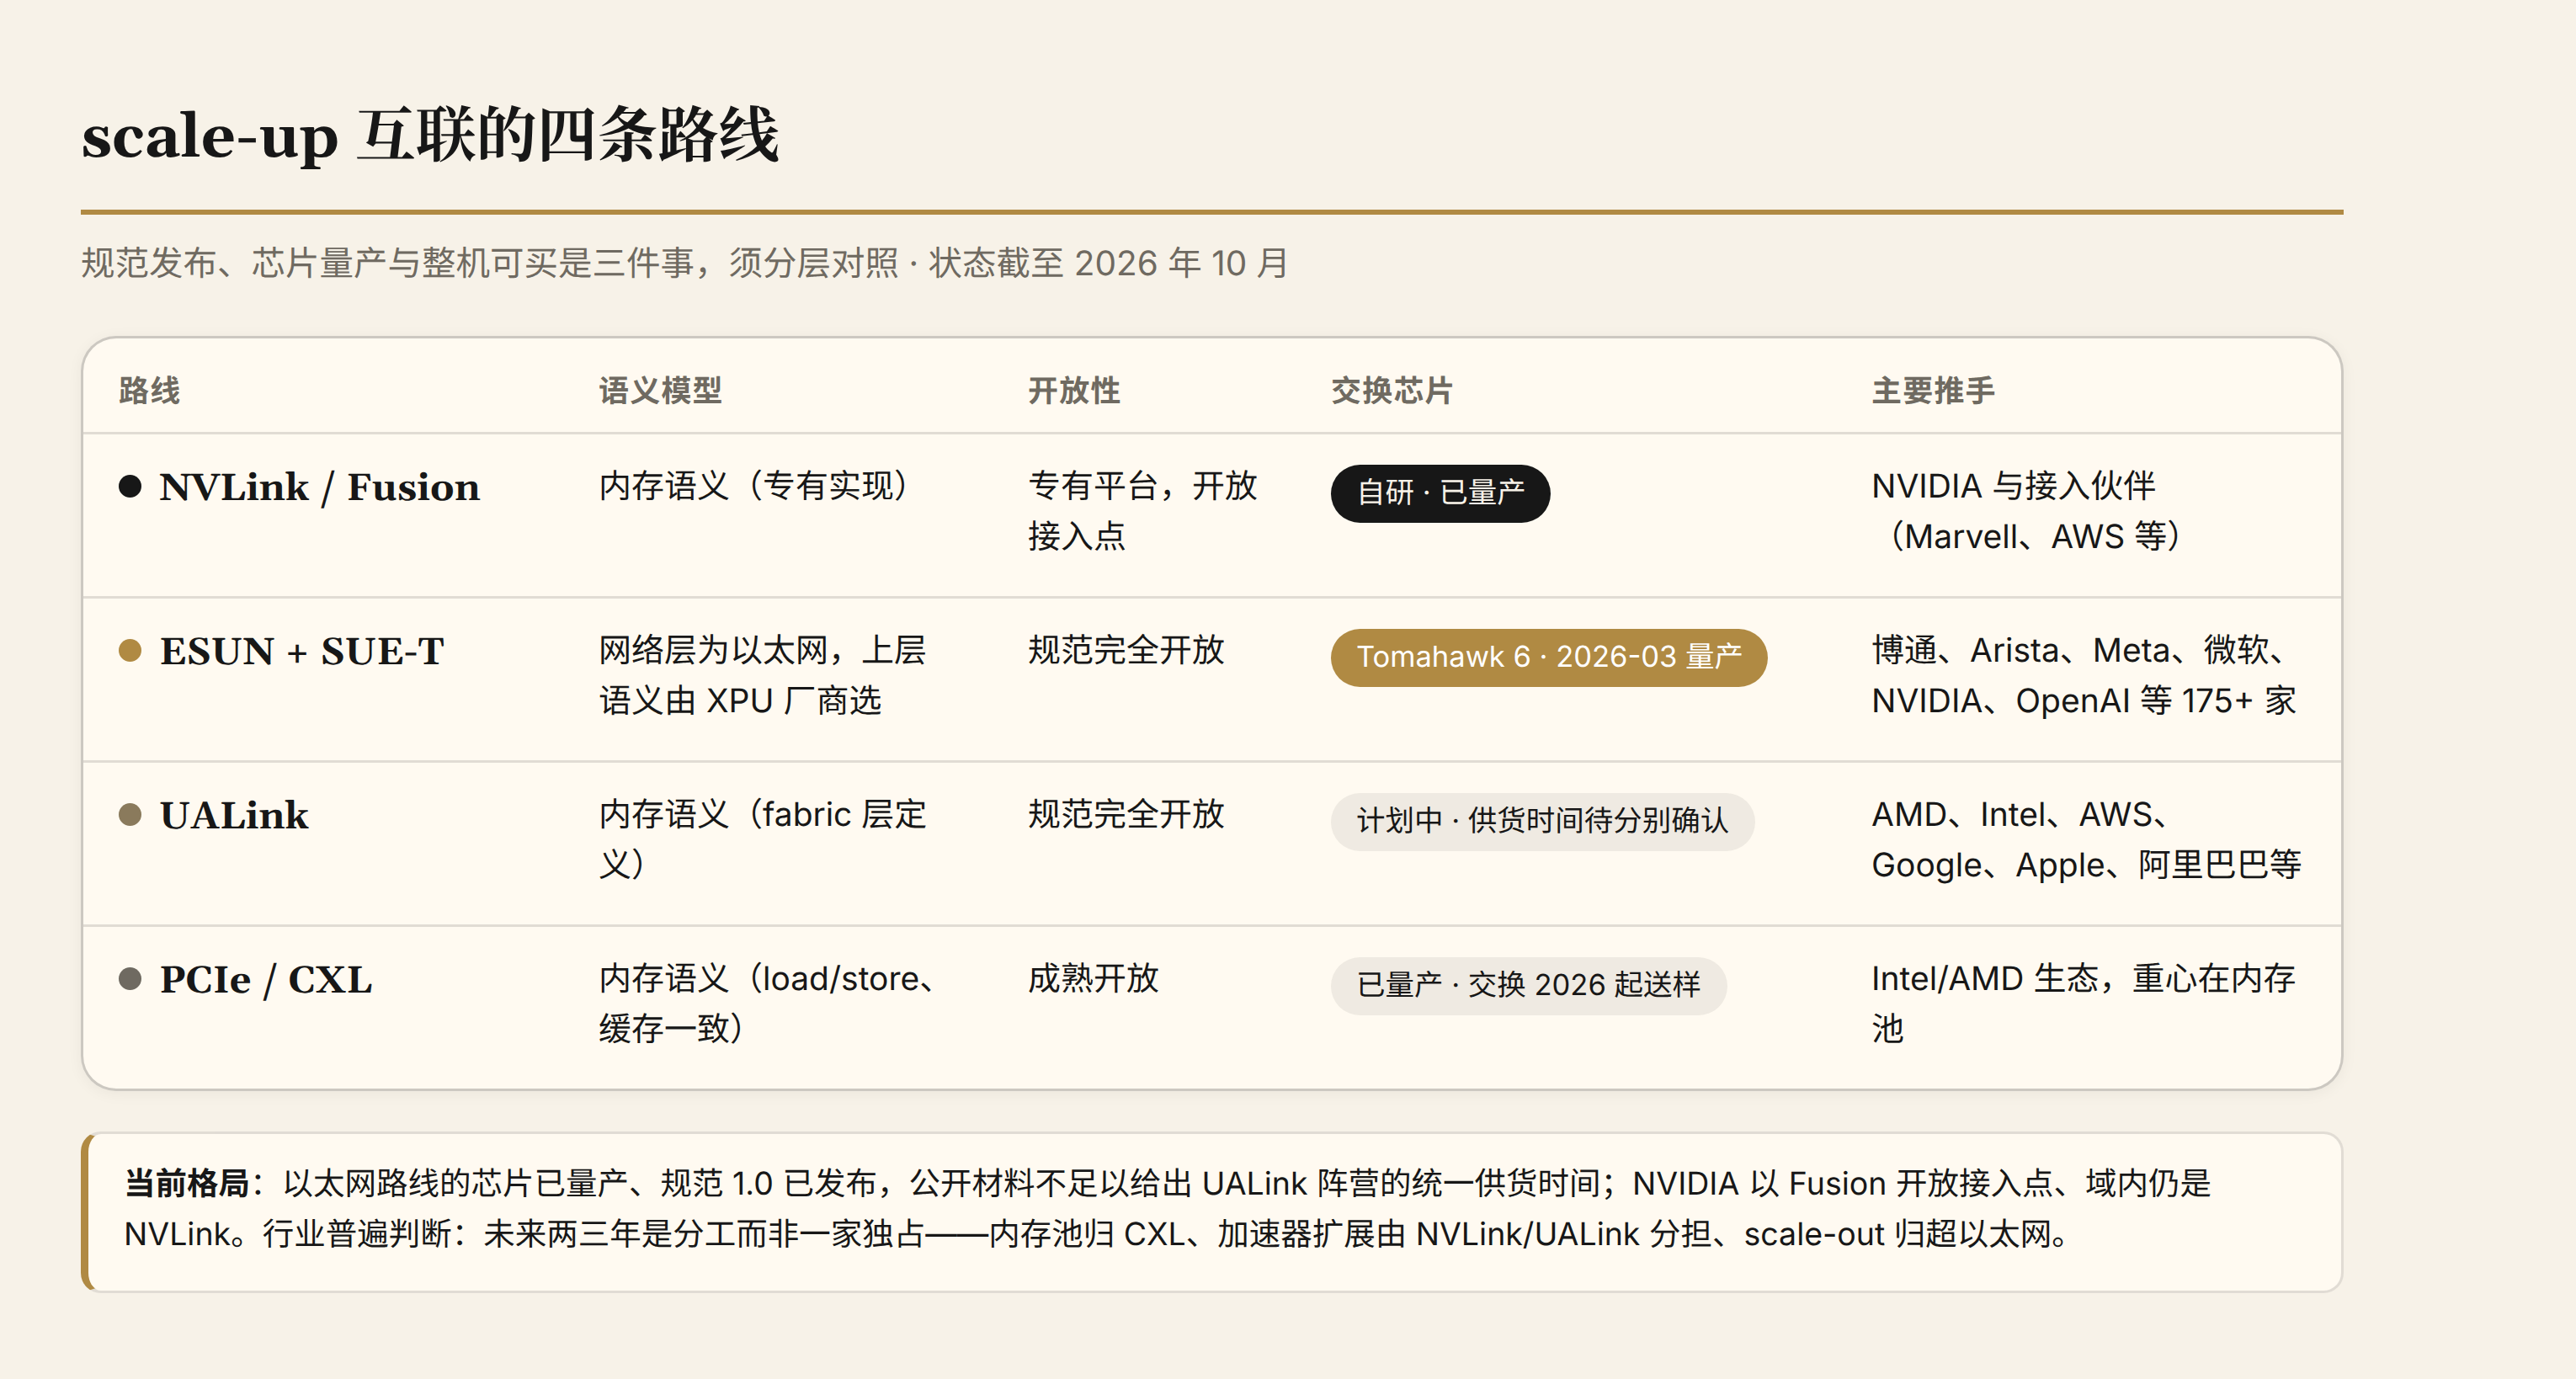
四条路线的成熟度得分层看——规范发布、芯片量产、整机可买是三件事,放在一栏里容易误读:
| 路线 | 规范状态 | 交换芯片 | 主要推手 |
|---|---|---|---|
| NVLink / NVLink Fusion | 专有平台,开放接入点 | 自研,已大规模量产 | NVIDIA 与接入伙伴 |
| ESUN + SUE-T | ESUN 1.0(2026-02 定稿);SUE-T 演进中 | Tomahawk 6 已量产(2026-03 官宣) | ESUN 参与者超过 175 家,包括博通、Arista、Meta、微软、NVIDIA、OpenAI;参与不等于产品已实现 |
| UALink | 1.0(2025-04);2.0(2026-04) | 本文取得的材料不足以确认规模供货;规范进度与厂商交付须分别核对 | AMD、Intel、AWS、Google、Apple、阿里巴巴等 |
| PCIe / CXL | 成熟开放 | 已量产(PCIe 6.0/CXL 交换 2026 年起送样) | Intel/AMD 生态,重心在内存池 |
**NVLink Fusion:用「水平开放」扩大「垂直整合」。**Fusion 在 2025 年 5 月 Computex 发布,核心是一颗互连 chiplet,双向带宽最高 1.8 TB/s。它的逻辑很清楚:自研 XPU 或自研 CPU 的厂商可以接入 NVLink 域——XPU 侧经 UCIe 标准接口接 NVIDIA 的桥接 chiplet,CPU 侧经 NVLink-C2C。接入的是互连与机架架构这层平台;NVIDIA 的技术说明同时明确,Fusion 以模块化 OCP MGX 机架形态提供,「可搭配任意 NIC、DPU 或 scale-out 交换机」。发布后的收编节奏相当快:首批伙伴包括 Fujitsu、高通、MediaTek、Alchip、Astera Labs、Synopsys、Cadence;2025 年 10 月三星晶圆代工加入,11 月 Arm 加入(licensee 从此可以做出厂带 NVLink 接口的 CPU),2026 年 1 月 RISC-V 阵营的 SiFive 加入。2026 年 3 月 31 日,NVIDIA 宣布向 Marvell 投资 20 亿美元,双方建立战略合作:Marvell 提供定制 XPU 和 NVLink Fusion 兼容的 scale-up 组网,NVIDIA 提供配套技术包括 Vera CPU、ConnectX 网卡、BlueField DPU、NVLink 互连和 Spectrum-X 交换机——注意这是这一份合作的分工清单,不是所有 Fusion 用户的强制采购清单。同期更值得记的是 AWS:NVIDIA 官方博客 2025 年 12 月更新披露,AWS 正在采用 NVLink Fusion 搭建搭载 Trainium4 芯片的半定制机架基础设施,同时继续用自己的 Graviton CPU、EFA 网卡和 Nitro 虚拟化体系。这是采用公告,不是投产验收——但方向已经清楚。
对 Arista 来说,这件事的直接含义是:**非 NVIDIA 加速器,不自动等于开放以太网阵营。**Fusion 正在把其中最有交付能力的一批纳入 NVIDIA 的机架与互连生态——即便 scale-out 侧仍可自由选网卡和交换,scale-up 域的互连已经建立在 NVLink 上。
**ESUN 加 SUE-T:把以太网改造成 scale-up 底座。**ESUN(Ethernet for Scale-Up Networking)是 OCP 的工作流,2025 年 10 月由十二家公司发起:AMD、Arista、Arm、博通、Cisco、HPE、Marvell、Meta、微软、NVIDIA、OpenAI、Oracle。注意 NVIDIA 也在名单里——它一边卖 NVLink,一边在以太网标准组织里保留席位,这是标准的对冲。ESUN 1.0 规范 2026 年 2 月定稿、3 月正式发布,参与公司已超过 175 家,Meta 和微软主导了初版。
ESUN 的结构分三层:通用以太网头(统一网络封装)、开放以太网数据链路层(LLR、PFC、CBFC——其中无损可靠交付与 LLR/CBFC 等机制直接引用 UEC 1.0 规范)、以及现成的以太网 PHY。1.0 的关键新东西是 ESUN Header:一个 4 字节的紧凑报文头,按 OCP 官宣的说法,替代通常 28–48 字节的 IP/UDP 头栈。scale-up 流量里有大量小包同步消息,头开销直接占用带宽;这 4 字节里重新装回了拥塞反馈、业务等级、流标签和 TTL。
ESUN 最重要的设计决定是克制:它只标准化「以太网怎么在 scale-up 域里跑得又快又无损」——怎么封装、怎么纠错、怎么不丢包——不规定上层语义。XPU 厂商保留自己的选择:push 还是 pull、内存语义还是流语义、端点是否实现完整的可靠传输栈(SUE 框架为此分了带可靠传输的完整版和只留逐跳 LLR 的 Lite 版)、什么排序规则、什么拥塞策略。
端点那一层由 SUE-T 补齐。博通 2025 年 4 月把自己的 SUE(Scale-Up Ethernet)框架捐给 OCP(v1.0 同年 9 月发布),后来按层次拆分:网络 fabric 层并入 ESUN,传输层独立为 SUE-T,负责 XPU 端点上的可靠传输与事务封装;跨 SUE 实例(跨平面)的负载均衡由 XPU 在传输层之上完成。SUE 框架中的端点实例承载单边内存事务(put/get/atomic),每个 XPU 可挂多个实例、每个实例有 1–4 个以太网口。受控拓扑和预先已知的端点,允许它采用静态建连、每平面单路径以及简单的 go-back-N 重传,减少传输状态的实现开销。
文档以 64 个 XPU 为例:每个 XPU 有 12 个 800G 实例,连接到 12 台交换机,任意两个 XPU 之间可聚合出 9.6 Tb/s 的带宽。这个数来自示例的链路配置,不是协议上限;文档给出的 2 微秒以内往返时延则是设计目标。它们说明了 SUE 希望实现的带宽与时延组合,不能当成某台 SU-144 整机的测试结果。
SUE 统一网络与命令通道,命令集仍由 XPU 定义。两种加速器接入同一张 SUE 网络,并不因此能够相互理解命令或共享内存:端点语义、软件接口与跨厂商互操作仍需双方约定和验证。
**UALink:把内存语义纳入开放规范。**UALink 与 ESUN 的区别是本质性的:ESUN 只规范网络怎么跑,端点语义交给 XPU 厂商;UALink 在 fabric 规范层直接定义内存语义——load/store/atomic 操作、64–256 字节的事务粒度、57 位地址空间(128 PB 直接寻址)、软件管理的一致性。按 UALink 联盟白皮书:200G 每通道、最多 1024 个端点、亚微秒级往返时延(4 米铜互连约 1 微秒)、目标链路利用率 90% 以上。对跨加速器内存池这类场景,fabric 层原生的 load/store 有真实价值——白皮书也明确以此为卖点与以太网路线对比。
UALink 1.0 于 2025 年 4 月发布,2.0 于 2026 年 4 月发布,拆成 Common、200G 数据链路与物理层、Chiplet、管理四份规范,其中 Common 2.0 引入网内计算。3.0 计划在 2027 年推进更高带宽、跨机架扩展和可靠性。这些日期反映规范进展,采用者还要分别确认交换芯片、端点实现及整机交付。本文取得的公开材料不足以给出整个 UALink 阵营的统一供货时间。
董事会的十二个席位说明谁需要它:AMD、Astera Labs、AWS、Cisco、Google、HPE、Intel、Meta、微软,加上 2025 年 1 月进入的阿里巴巴、Apple 和 Synopsys——主力是「既要自研加速器、又不想被任何单一平台锁定」的大厂,加上支撑这个生态的连接、系统与 IP 厂商。
**PCIe 与 CXL:重心在机箱内和内存池。**CXL 4.0(2025 年 11 月发布)把带宽提升到 128 GT/s 并引入端口捆绑,瞄准跨机架内存组合;Marvell 在 OFC 2026 上发布了 CXL 交换和 260 通道的 PCIe 6.0 交换(计划 2026 年三季度送样)。但这条路线当前的落点不在 XPU 主干:按 Astera Labs 2026 年 8 月二季度电话会的口径,CXL 内存控制器的批量出货与主要收入要等到 2027 年,此前以内存池和 AI 推理 KV cache 的探索为主。值得留意的是演示侧的扩展:Astera 在 Computex 2026 展示了 PCIe 6 交换机配合线性可插拔光模块(LPO)的跨机架链路——链路级的可行性演示已有,整域部署与验收的公开证据还没有。
**以太网目前的优势在已有产业链可以复用。**PHY、SerDes、光模块、交换芯片和运维工具都有成熟供应商,ESUN 不需要重新建立一整套物理层生态。UALink 也不必从零做起:Credo 的 224G 多协议重定时器同时支持 UALink 与 ESUN,说明两条开放路线能共享部分物理层器件。它们的主要差异仍在链路之上的协议、端点实现与互操作验证。
Tomahawk 6 已量产,ESUN 1.0 已发布,让设备厂商可以围绕已有芯片开发产品。其他厂商也在进入:Upscale 10 月 8 日发布的 Token Fabric 包括 SkyFabriX 交换芯片,宣布支持 ESUN、SUE-T 和 UALoE,整套平台计划 2027 年初上市;UALink 被列为后续演进支持项,公告没有给出其具体交付日期。这个案例能说明以太网 scale-up 供应商在增加,不能用来判定 UALink 全行业的上市时间。
对于高频集合通信,SUE 的受控拓扑、静态建连和精简传输有明确的工程吸引力。最终是否值得采用,要看这些设计在目标训练或推理负载中兑现了多少有效带宽、尾延迟和故障恢复能力。已有芯片与规范缩短了开发起点到产品之间的距离,端点和整机验证仍然决定最后一段进度。
**但这不是终局。**内存语义不是伪需求:跨加速器内存池、KV cache 共享、参数面同步,都是 fabric 层原生 load/store 能兑现价值的场景。UALink 3.0 在 2027 年推进更高带宽与跨机架扩展,CXL 4.0 守住内存池,NVLink Fusion 收编定制 XPU。行业分析普遍的判断是碎片化至少持续到 2027 年:内存池归 CXL、加速器扩展归 NVLink/UALink、scale-out 归超以太网,没有单一标准覆盖全部场景。
四、芯片选择:二十年不自研,机架产品线押博通
Arista 是商用芯片(merchant silicon)模式最彻底的践行者:不自研转发芯片,差异化全部押在 EOS 软件上。联合创始人 Andy Bechtolsheim 2009 年那篇谈硅片选择的博客里有一句原话:「这一切,我们没有花一美元在自研芯片开发上。」做法是先写好下一代网络操作系统,再选用市面上最好的商用硅——按 Arista 的说法,这让它的产品在成本-性能上长期优于用自研 ASIC 的对手。产品线分工清楚:7060 系列用博通 Tomahawk(低时延、高带宽),7280R/7800R 系列用博通 Jericho(深缓冲、云路由)。
在 scale-up 这个新战场,这个传统延续成了一个非常具体的选择。Arista 今年 6 月发布 7060XE7 系列时,博通交换芯片事业部总经理 Khamisy 的引语说得明白:博通以 Tomahawk 6 102.4T 交换芯片驱动 Arista 的 1.6T 以太网方案,「为超大规模 AI 集群扩展互连容量,实现优化的 scale-up 与 scale-out 连接」。Arista 的说法则是:解锁 Tomahawk 6 的片上资源与特性、同时保持 EOS 或开放 NOS 的软件一致性,交换机「变成统一的机架级 radix」。也就是说,Arista 机架产品线的交换基础是 7060XE7(Tomahawk 6),这个家族同时面向 scale-up 与 scale-out。10 月的发布稿没有逐形态披露 SU-144 的交换配置——这部分要到客户联合设计与量产落地时才会清晰。
Tomahawk 6 本身是目前首个宣布规模量产的 102.4T 交换芯片(博通口径):
- 512 个 200G SerDes(或 1024 个 100G);
- 单颗芯片可单跳全连接 512 个 XPU(每链路 200G,跑 SUE)——这是芯片扇出能力的示例口径;
- scale-out 侧两层组网可覆盖 12.8 万 XPU;
- 原生支持 scale-up 与 scale-out 统一:同一批接口可以在两种用途之间动态划分(博通的说法是 fungible interfaces——云运营商可以按需把 XPU 资产切成不同规模的域);
- Cognitive Routing 2.0 负载均衡与拥塞管理,另有 CPO 封装版本(Davisson)。
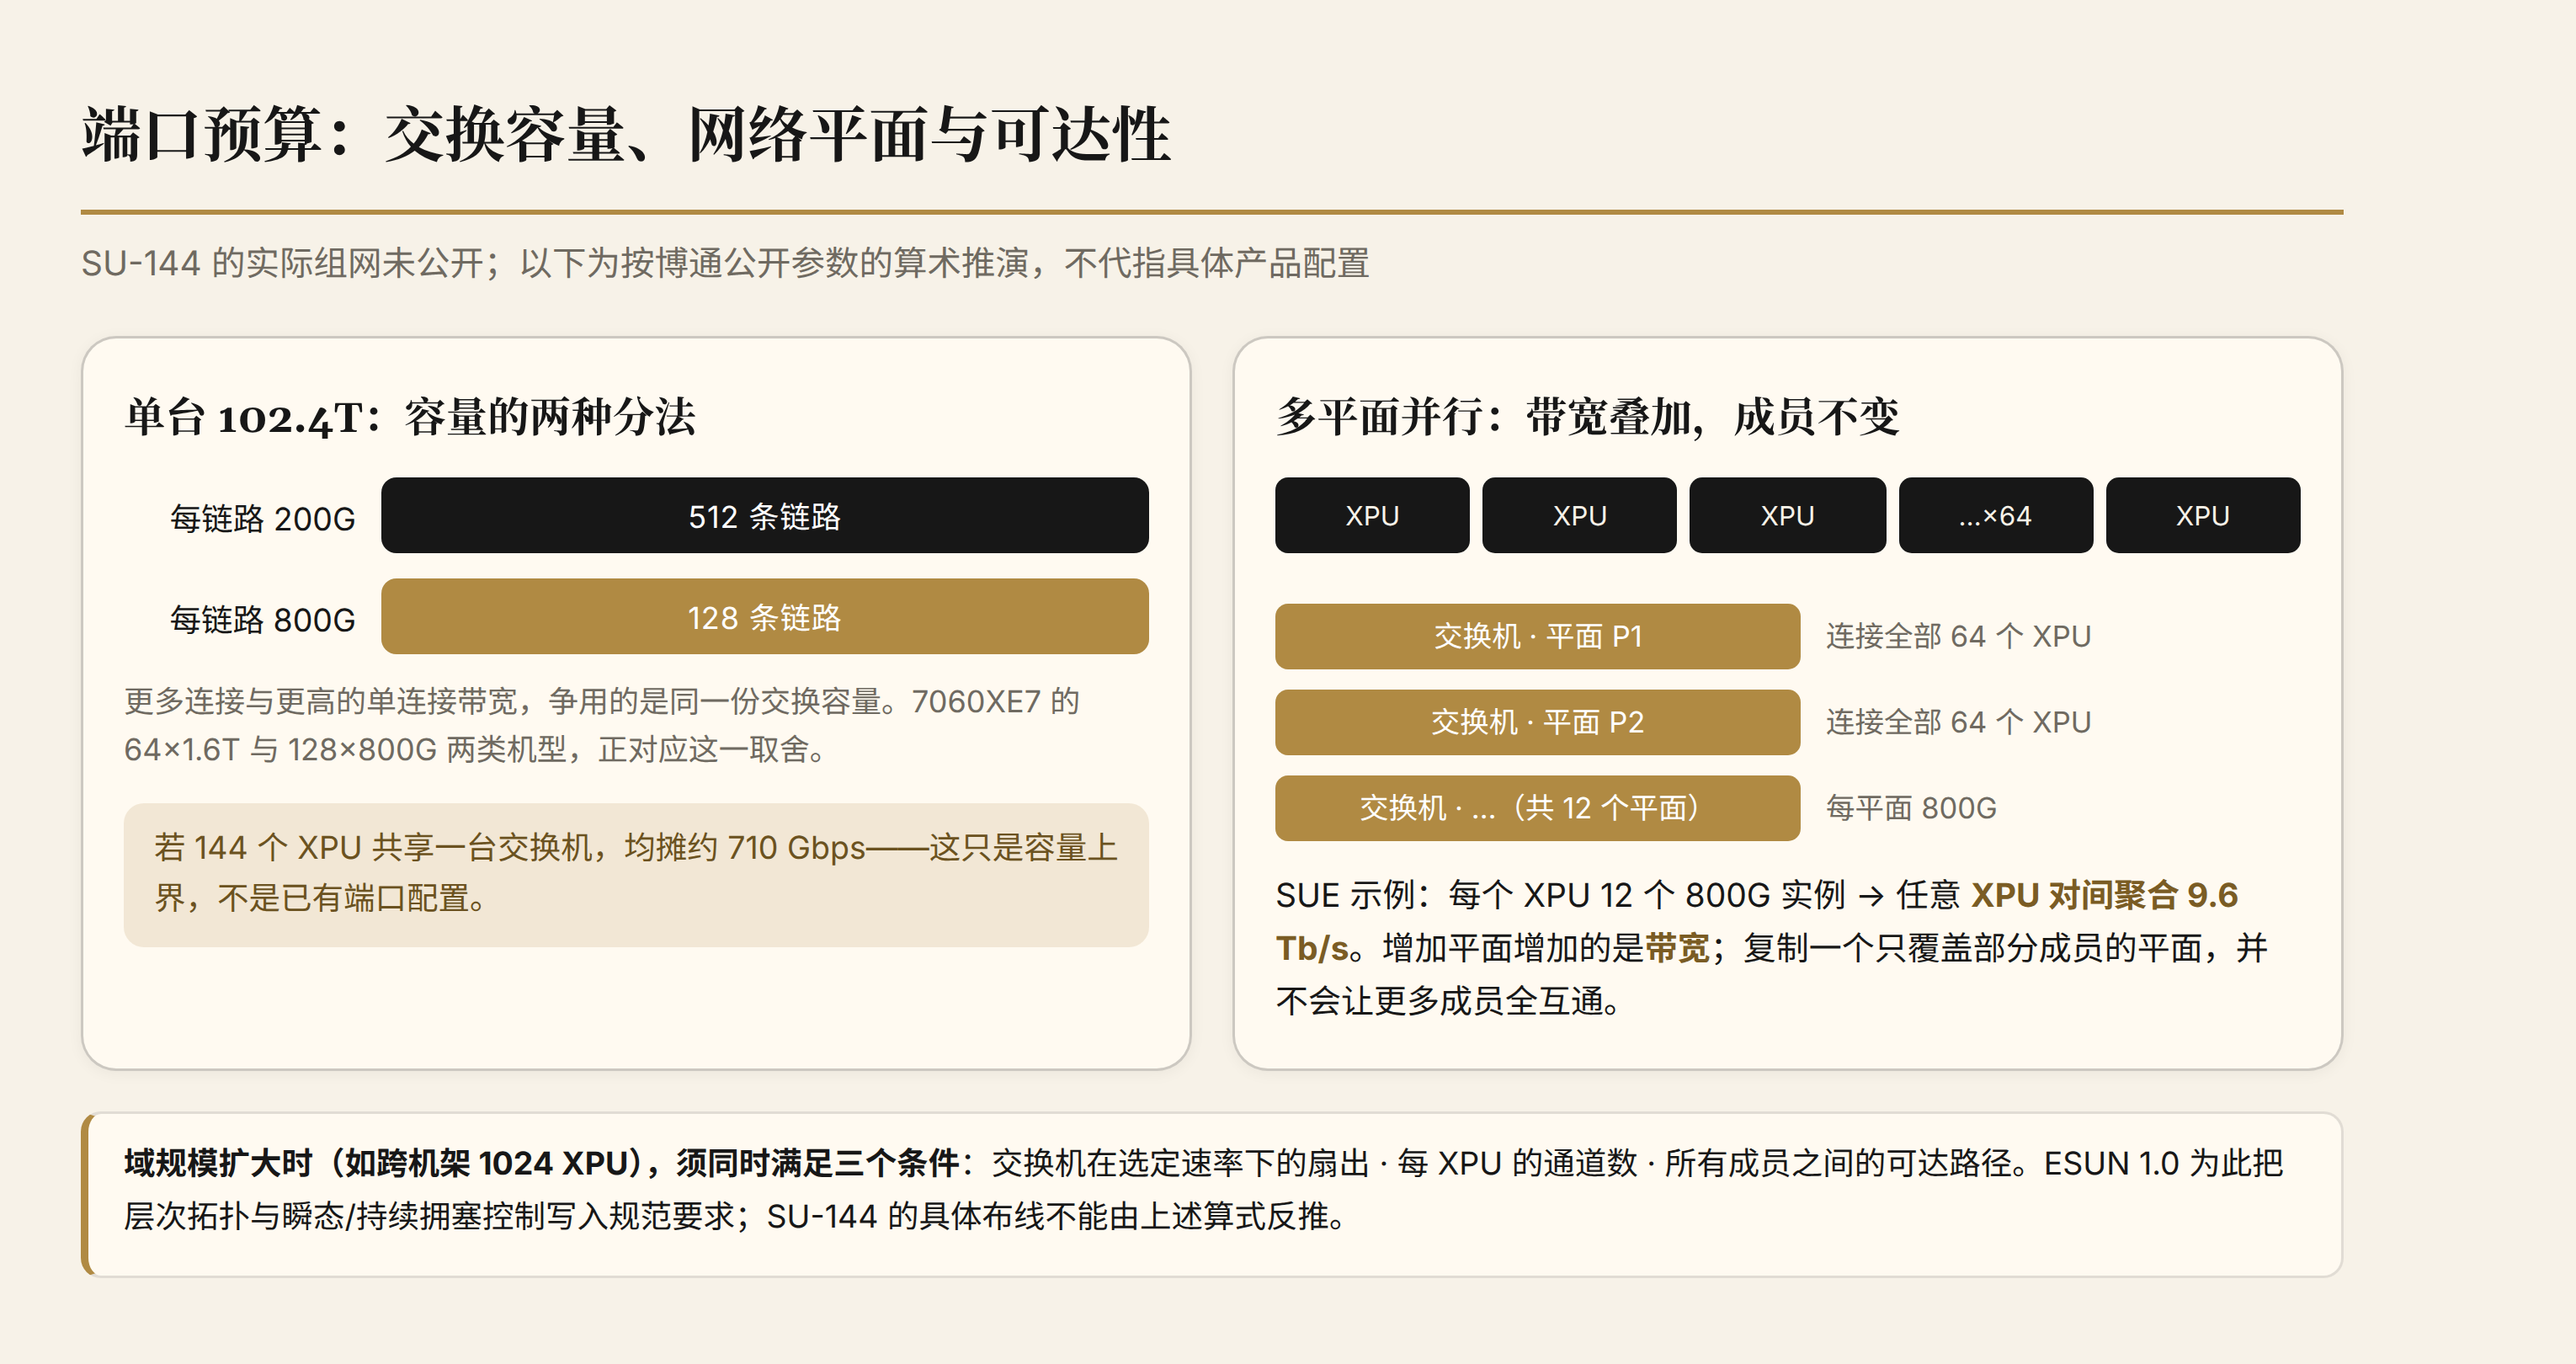
**交换容量、端口速率和域规模,要放在一起算。**102.4 Tb/s 按每条 200 Gb/s 分配,可对应 512 条链路;按 800 Gb/s 分配,则对应 128 条。更多连接与更高的单连接带宽会争用同一份交换容量。如果 144 个 XPU 共享一台交换机,均摊约 710 Gb/s 只是容量上界,实际配置还要满足端口速率和端口数量的要求。
并行网络平面可以提高每个 XPU 的聚合带宽。SUE 的 64 XPU 示例中,每个平面的一台交换机都连接全部 64 个 XPU,12 个 800G 平面叠加到 9.6 Tb/s。增加平面提高的是带宽;复制一个只能覆盖部分成员的独立平面,并不会自动让更多成员全互通。
域规模进一步扩大时,需要同时满足交换机在选定速率下的扇出、XPU 通道数,以及所有成员之间的可达路径。ESUN 允许按需要采用分层拓扑;SU-144 的 1024 XPU 跨机架具体布线尚未公开,不能由上述算式反推。7060XE7 的 64×1.6T 与 128×800G 两类机型,则直观展示了端口数量与速率之间的取舍。
**为什么说这个选择是对的。**第一是时间:自研这一档交换芯片的周期以年计,而市场窗口就在这一两年;TH6 2025 年年中出样、2026 年 3 月宣布量产,Arista 的交换机年内分批上市、机架架构随后落地。第二是生态:博通同时提供交换芯片并参与 SUE/ESUN 规范,Arista 可以复用已有芯片功能与协议实现资源,减少从零开发的工作。XPU 端点如何实现协议、不同厂商组件如何配合,仍要通过组合验证。第三是竞争维度:Accton 等白牌厂商同样用 TH6,思科有自研的 Silicon One,NVIDIA 用自家 Spectrum——scale-up 机架的竞争不在端口速率(大家都会到 102.4T 一档),在软件、运维与交付。硬件同质化反而让竞争集中到 Arista 最强的地方。
**代价也要看清。**第一,绑定在加深。scale-up 域里,Arista 押在以太网上的全部筹码——EOS、机架工程、验证套件——都要建在博通的硅上。而博通是这场竞争里最大的多面下注者:它捐出了 SUE-T(以太网路线),同时还在为 OpenAI 做 10 GW 级的定制 XPU(2025 年 10 月官宣、部署至 2029 年)。不管哪条路线赢,博通的 IP、PHY 与定制芯片都有生意;Arista 的盘子只在以太网这一条上。第二,如果 scale-up 主干最终是 UALink(内存语义、非以太网 MAC),Arista 的以太网软件栈优势会被稀释,它只能等芯片厂商推出 UALink 交换机再跟进。所以 Arista 有真实利益绑在 ESUN 的成功上——它是 ESUN 十二发起者之一,CEO 亲自写博客造势。还有一个佐证:连获得 NVIDIA 投资的 Upscale(据 The Next Web 报道),其第一代 SkyFabriX 芯片也把 ESUN/SUE-T 列为首批支持协议——多面下注是这行的常态,Arista 并不例外。
对冲的方式不是造芯片,而是把「协议无关的交付能力」做深:Netdi 诊断遥测对开放 NOS 同样适用,scale-out 侧明确兼容 NVLink、NVLink Fusion 和 PCIe 域。机架工程、液冷、光纤管理、验证与运维——这些是任何 scale-up 方案都必须完成的工作;Arista 的策略是让这些工作流向自己,无论客户的 scale-up 域最终选什么协议。
真正的护城河也在这一层。SiliconANGLE 的分析指出了关键:scale-up、scale-out、scale-across 三张网用同一套 EOS、遥测与诊断,故障隔离和预测性维护因此延伸进集群最敏感的部分——而 Fusion 开放的只是接入点,scale-up 域内仍是 NVLink;运维层面的这种开放性是 Arista 对客户最有力的说辞。
五、竞争与收入:scale-up 是期权,不是现金流
**NVIDIA 的反制在加速。**前文已列过 Fusion 的收编名单——高通、MediaTek、Marvell、Arm、SiFive、三星代工,加上正在接入的 AWS Trainium4。Arista 的机会因此取决于异构阵营里「想保持独立的那部分」有多大:微软 Maia、Meta MTIA 这类超大规模自研加速器,加上 neocloud。Vusirikala 对 NVIDIA 体系的判断同样直白:「近期没有机会,因为那是专有的。」
**收入结构要按对象分开看。**Arista 2026 年二季报(8 月初发布)的关键数字:
- 单季收入 30.36 亿美元,同比增长 37.7%,历史上首次单季破 30 亿,超出指引;
- 全年收入指引年内第三次上调,至约 126 亿美元(增长 40%);
- 2026 年 AI Fabric 收入目标不低于 35 亿美元,Etherlink 平台累计客户超过 100 家;
- 增长最快的新业务是 scale-across(跨数据中心联网),约占 2026 年 AI 目标的三成。
把这组数字与 SU-144 放在一起看:Arista 的 AI Fabric 收入目前来自 scale-out 与 scale-across,公司整体还有园区网等业务(2026 年目标不低于 12.5 亿美元);scale-up 机架的实质收入,按当前披露节奏更可能出现在 2027 年之后——这是本文的判断,不是管理层指引。SU-144 当前阶段的交付,作用在于占位:在异构阵营选定网络底座之前,让参考架构、验证套件和运维一致性先进入客户的评估清单。
近期有两个观察窗口:10 月 12–15 日 OCP 全球峰会(Arista 展台将展出完整液冷机架,联合创始人 Andy Bechtolsheim 在 10 月 13 日有一场「The Gigawatt AI Data Center Era」的分场演讲),以及 11 月初的三季报。
六、判断
**一、这是 Arista 历史上最重要的一次身份扩张,成败不看发布看部署。**从「卖最好的交换机」到「定义 AI 机架里的网络平台」,中间隔着一条真实的鸿沟:开放设计要求加速器厂商、机架集成商、冷却供应商多方协同,而 NVIDIA 卖的是交钥匙系统——客户买整套系统时,以太网并不总是进入采购讨论。观察点在 2027 年:能否在 AMD、微软 Maia、高通这一阵营里,看到由多个 144/1024 XPU 域组成的大集群真实落地。10 月 12–15 日 OCP 峰会上的演示和 11 月三季报里 AI 订单的质量,是第一手的先行指标。
**二、物理约束作用在所有路线上,以太网生态的机会在兑现速度。**域变大、每链路速率提高,高速链路很快超出无源铜的可达距离(Vusirikala 的判断),光互连的必要性随域规模上升;功率密度则把液冷推成刚需(按 Arista 预期,100T 级交换机明年液冷约五成、200T 实质必需)。这些约束不偏爱任何协议——任何路线都要引入光互连与液冷、做整机架预集成;差别在于兑现路径:以太网生态的 PHY、光模块、交换芯片、运维工具现成且多厂商竞争,把工程需求变成产品的路径短。这是机会,不是保证。软件层也不必提前宣判:UALink 3.0 在 2027 年推进更高带宽与跨机架扩展,CXL 4.0 守住内存池,NVLink Fusion 收编定制 XPU。未来两三年更可能的格局是分工而非一家独占:scale-out 归以太网,scale-up 由三条路线按负载分占,内存池归 CXL。对部署者来说,更有用的结论是 Arista 自己也承认的那条——协议可以共存,运维一致性才是真正的黏性所在。
**三、对国产算力生态,这是一份可以直接借用的模板,但不是唯一的路。**ESUN 与 SUE-T 是完全开放的规范栈。国内自研加速器阵营需要 scale-up 网络时,这条路上每一层——规范、交换芯片、PHY、光模块、运维模型——都有现成供应商和多厂商竞争,省下的是从零定义互连和培育芯片生态的投入;集成者仍要承担的是端点语义实现、组合验证和运维整合,这部分无法省去。同时要看清另一条并行路线:华为已宣布将开源自己的统一互联协议 UB-Mesh(统一总线,配套 SuperPoD 架构,技术论文已公开),目标是统一替代 PCIe、CXL、NVLink、TCP/IP,主战场在中国市场。中国阵营这次既是开放标准的潜在用户,也是自己标准的输出者。两条路并不冲突——哪条走得通,要等真实集群的负载检验。
资料与计算说明:本文依据 2026 年 10 月 9 日前的公开材料撰写,未做硬件实测。中文引语均为转译,字面原文见对应来源。
- Arista 2026-10-07 新闻稿(SU-144 的 144/1024 XPU、三种形态、scale-out 机架的 7060XE7/102.4T 与 MRC/DLB/CLB、XPO 与开放 CPO/NPO 的 1.6→6.5 Pb/s、多协议共存):https://www.arista.com/en/company/news/press-release/24818-pr-20261007
- Arista 同日技术博客(Jain/Vusirikala:rack-scale fabric 五要素、Netdi 诊断定位与 8000 人年、beyond 72/144 XPUs):https://blogs.arista.com/blog/next-gen-scale-up-networking-for-ai-fabrics
- Arista 2026-06-09 新闻稿(7060XE7=TH6、Khamisy 与 Lamoreaux 引语、Azure Maia/Fairwater·Meta·Oracle 背书、LPO 省约 60% 互连功耗):https://www.arista.com/en/company/news/press-release/24102-pr-20260609 ;机型分批(64PS/64PRS Q4'26、64PRS-RV3-L/128PE Q1'27)见官网产品页 https://www.arista.com/en/products/7060xe7-series 及 thedatacenterengineer.com 转载核对
- SiliconANGLE 同日分析(三形态工程细节、Vusirikala/Jain 引语、约 2000 根光纤、液冷五五开与 200T 强制、运维一致性判断、采购讨论口径):https://siliconangle.com/2026/10/07/arista-takes-ethernet-rack-network-becomes-backplane
- OCP ESUN 1.0 官宣(EH 替代 28–48 字节 IP/UDP 头栈、PFC/CBFC/LLR、175+ 公司、十二发起者、Meta+微软主导):https://www.opencompute.org/news/the-ocp-esun-10-specification-has-been-released/ ;ESUN 1.0 规范 PDF(层次拓扑与瞬态/持续拥塞控制要求、链路误码之外丢包需端到端恢复、EH-ECN/CoS/Flow Label/TTL、MACSec):https://www.opencompute.org/documents/ocp-esun-network-operator-requirements-base-specification-rev-1-0-final-pdf
- Arista 博客《The Sun Rises on Scale-Up Ethernet》(2025-10-13,Ullal/Holbrook:三层结构、三特征、SUE-T 定位):https://blogs.arista.com/blog/the-sun-rises-on-scale-up-ethernet
- Broadcom SUE 框架规范 RM104(64 XPU×12×800G 示例与 9.6 Tb/s、<2µs 设计目标、单边内存事务、静态建连与 go-back-N、SUE Lite、命令集 XPU-specific 不保证跨 XPU 互操作):https://docs.broadcom.com/doc/scale-up-ethernet-framework ;Broadcom 官方技术文章(SUE→SUE-T 拆分沿革):https://www.broadcom.com/topics/what-are-the-ethernet-standards-for-ai-infrastructure
- Broadcom Tomahawk 6 量产新闻稿(2026-03-12,初样到量产不到三季度、512 XPU 单跳、128K 两层、512×200G SerDes、Cognitive Routing 2.0、CPO 选项):https://investors.broadcom.com/news-releases/news-release-details/broadcom-now-shipping-worlds-first-1024-tbps-switch-production
- UALink 白皮书(64–256 字节事务、57 位地址、~1µs@4m 铜、90%+ 利用率、与以太网路线对比):https://ualinkconsortium.org/wp-content/uploads/2026/01/UALink_White_Paper_Publication_FINAL_UPDATED.pdf ;UALink 2.0 新闻稿(2026-04-07,四份规范、In-Network Compute 属 Common 2.0):https://ualinkconsortium.org/wp-content/uploads/2026/04/UALink-2.0-Specification-PR_FINAL.pdf ;董事会名单:https://ualinkconsortium.org/specification
- NVIDIA×Marvell 合作新闻稿(2026-03-31,20 亿美元投资、该合作的组件分工、硅光与 AI-RAN):https://nvidianews.nvidia.com/news/nvidia-ai-ecosystem-expands-as-marvell-joins-forces-through-nvlink-fusion ;NVIDIA Fusion 技术博客(任意 NIC/DPU/scale-out 可搭配、UCIe 接入、AWS Trainium4「正在采用」、72-GPU 域 1800 GB/s):https://developer.nvidia.com/blog/scaling-ai-inference-performance-and-flexibility-with-nvidia-nvlink-and-nvlink-fusion/ ;收编时间线与评价:https://thenextweb.com/news/nvidia-marvell-nvlink-fusion-ecosystem-lock-in
- Upscale Token Fabric 公告(2026-10-08,SkyFabriX 支持 ESUN/SUE-T/UALoE、UALink「演进中」、整套平台 GA 2027 年初、d-Matrix 背书;该日期不代表 UALink 实现交付;NVIDIA 投资背景见 The Next Web 与 Reuters 转述):https://upscale.com/blogs/upscale-introduces-token-fabric-the-industrys-most-comprehensive-standards-based-networking-portfolio-for-ai-factories ,HPCwire 同文交叉 https://www.hpcwire.com/off-the-wire/upscale-unveils-token-fabric-to-unify-scale-up-and-scale-out-ai-networking ,NVIDIA 投资报道 https://thenextweb.com/news/upscale-ai-token-fabric-nvidia-ai-chip-networking
- Astera Labs 2026 年 8 月二季度电话会口径(CXL 批量收入 2027)与 Computex 2026 PCIe 6+LPO 跨机架演示:https://www.asteralabs.com/resources/blog/computex-2026-demo-how-linear-optics-enables-longer-link-reach-lower-latency-for-scorpio-smart-fabric-switches/ ;Marvell OFC 2026(CXL/PCIe 6.0 交换,Q3'26 送样)经 Yahoo Finance 转述
- CXL 4.0(2025-11-18)与碎片化判断:https://introl.com/blog/cxl-4-specification-interconnect-wars-ai-memory-december-2025 ;Credo 224G 多协议重定时器(2026-01,UALink/ESUN/Ethernet):https://ualinkconsortium.org/news (member news)
- Arista 博客《The Silicon Choice for Cloud Networking》(「没花一美元自研芯片」):https://blogs.arista.com/blog/the-silicon-choice-for-cloud-networking ;Broadcom-OpenAI 10GW 合作:CNBC 2025-10-13 报道
- Arista 2026 年二季报与电话会(3.036B/+37.7%、126 亿指引、AI ≥3.5B、campus ≥1.25B、scale-across 约三成、100+ 客户):https://investors.arista.com/Communications/Press-Releases-and-Events/Press-Release-Detail/2026/Arista-Networks-Inc--Reports-Second-Quarter-2026-Financial-Results/default.aspx 及 alpha-sense/Motley Fool 电话会转录
- 华为 UB-Mesh:https://www.tomshardware.com/tech-industry/artificial-intelligence/huawei-to-open-source-its-ub-mesh-data-center-scale-interconnect-soon-details-technical-aspects-one-interconnect-to-rule-them-all-is-designed-to-replace-everything-from-pcie-to-tcp-ip ;论文 https://arxiv.org/html/2503.20377v1
- 本文的判断(分层可靠性分工的表述、以太网占上风的三条理由与验证条件、端口预算的算术上界说明、绑定与对冲、scale-up 收入的期权判断、国产生态借鉴与 UB-Mesh 并行路线)为作者综合分析;单台交换容量与域规模的换算(102.4T÷144≈710G)是算术推演,Arista 未披露 SU-144 的实际组网;SU-144 的 1024 XPU 跨机架具体拓扑尚未公开,文中的通用端口预算不能代替产品结构。