
摘要
2026 年的算力市场同时在涨价和降价,这两件事并不矛盾。算力正在从“建设项目”变成“工厂”,持续生产 token 这种商品。本文从记账单位、收入、成本、利润四方面查这本账,得出六个判断:
- token 不是稳定的记账单位。“调用量涨了一千倍”里混着三种增长:用户和场景变多、单任务消耗的 token 变多、计量刻度变化。豆包的对外计费调用只占它总量的一成上下。所以任何“千倍增长”都要拆开读,打折读。
- **价格分两层。**旧能力档在竞争中通缩,年降约 4-5 倍;前沿档仍然坚挺。DeepSeek 8 月的“涨价”主要是收回促销补贴,再加上峰谷分时,峰时输入价仍低于 4 月发布时的挂牌价。真正值得盯的是前沿层能坚挺多久。
- **电不是存量成本的大头,摊销才是。**万卡集群的电费只有折旧的一成上下;电真正的作用是限制新增产能。中国市场的高端 GPU 走两本账:存量 H100 的残值几乎等于原值,持有者赚的是“会计折旧和真实折旧之间的差”;增量 B300 的现货报价比基本面估值高出三成到一倍多,按高位价接盘的人出租本身不赚钱。
- **利润沉在两头,中间层被压薄。**芯片层毛利率约 75%;中间的独立 token 工厂在中国是负毛利(硅基流动 -24%)。模型厂靠“新旗舰领先对手的能力差”赚钱,而这个领先窗口在缩短:GPT-4 级约一年半被追平,推理档从正式版起算只用了约五周。
- **定价权在模型厂手里。**同一个开源模型被多家托管,官方价仍是锚,第三方只能跟。第三方 token 工厂做的是“锚价减成本”的利差生意,两头都不由自己决定。
- **最大的风险在融资结构。**Anthropic 接近 10 GW 的算力承诺,全部到位后年开支是千亿美元量级,而它的年化收入是 300 亿。整条链的偿付能力都押在“token 收入按指数增长”这一个假设上。2027 年交付潮落地时的利用率,是第一次真正的检验。
2026 年的算力市场,有两组同时成立的事实。
一组是涨价。
- 6 月,美国算力平台 Baseten 通知客户:B200 GPU 十月续约价从每小时 2.63 美元涨到 5.10 美元,涨幅 94%。
- 8 月 16 日,DeepSeek 把旗舰 V4-Pro 改为峰谷计价,峰时输入价 1.32 美元/百万 token。5 月转为常态价的促销价是 0.435 美元,相比之下峰时输入涨了两倍,峰时输出涨了 355%。但两点要一并说明:峰时输入价仍低于 4 月发布时的挂牌价 1.74 美元;峰时只占一周时间的约两成,其余时段按半价计。官方给的理由是更有效地利用算力,引导开发者错峰使用。
- 10 月 1 日,Nebius 完成年内第二轮提价,B300 按需价涨到每小时 9.50 美元。
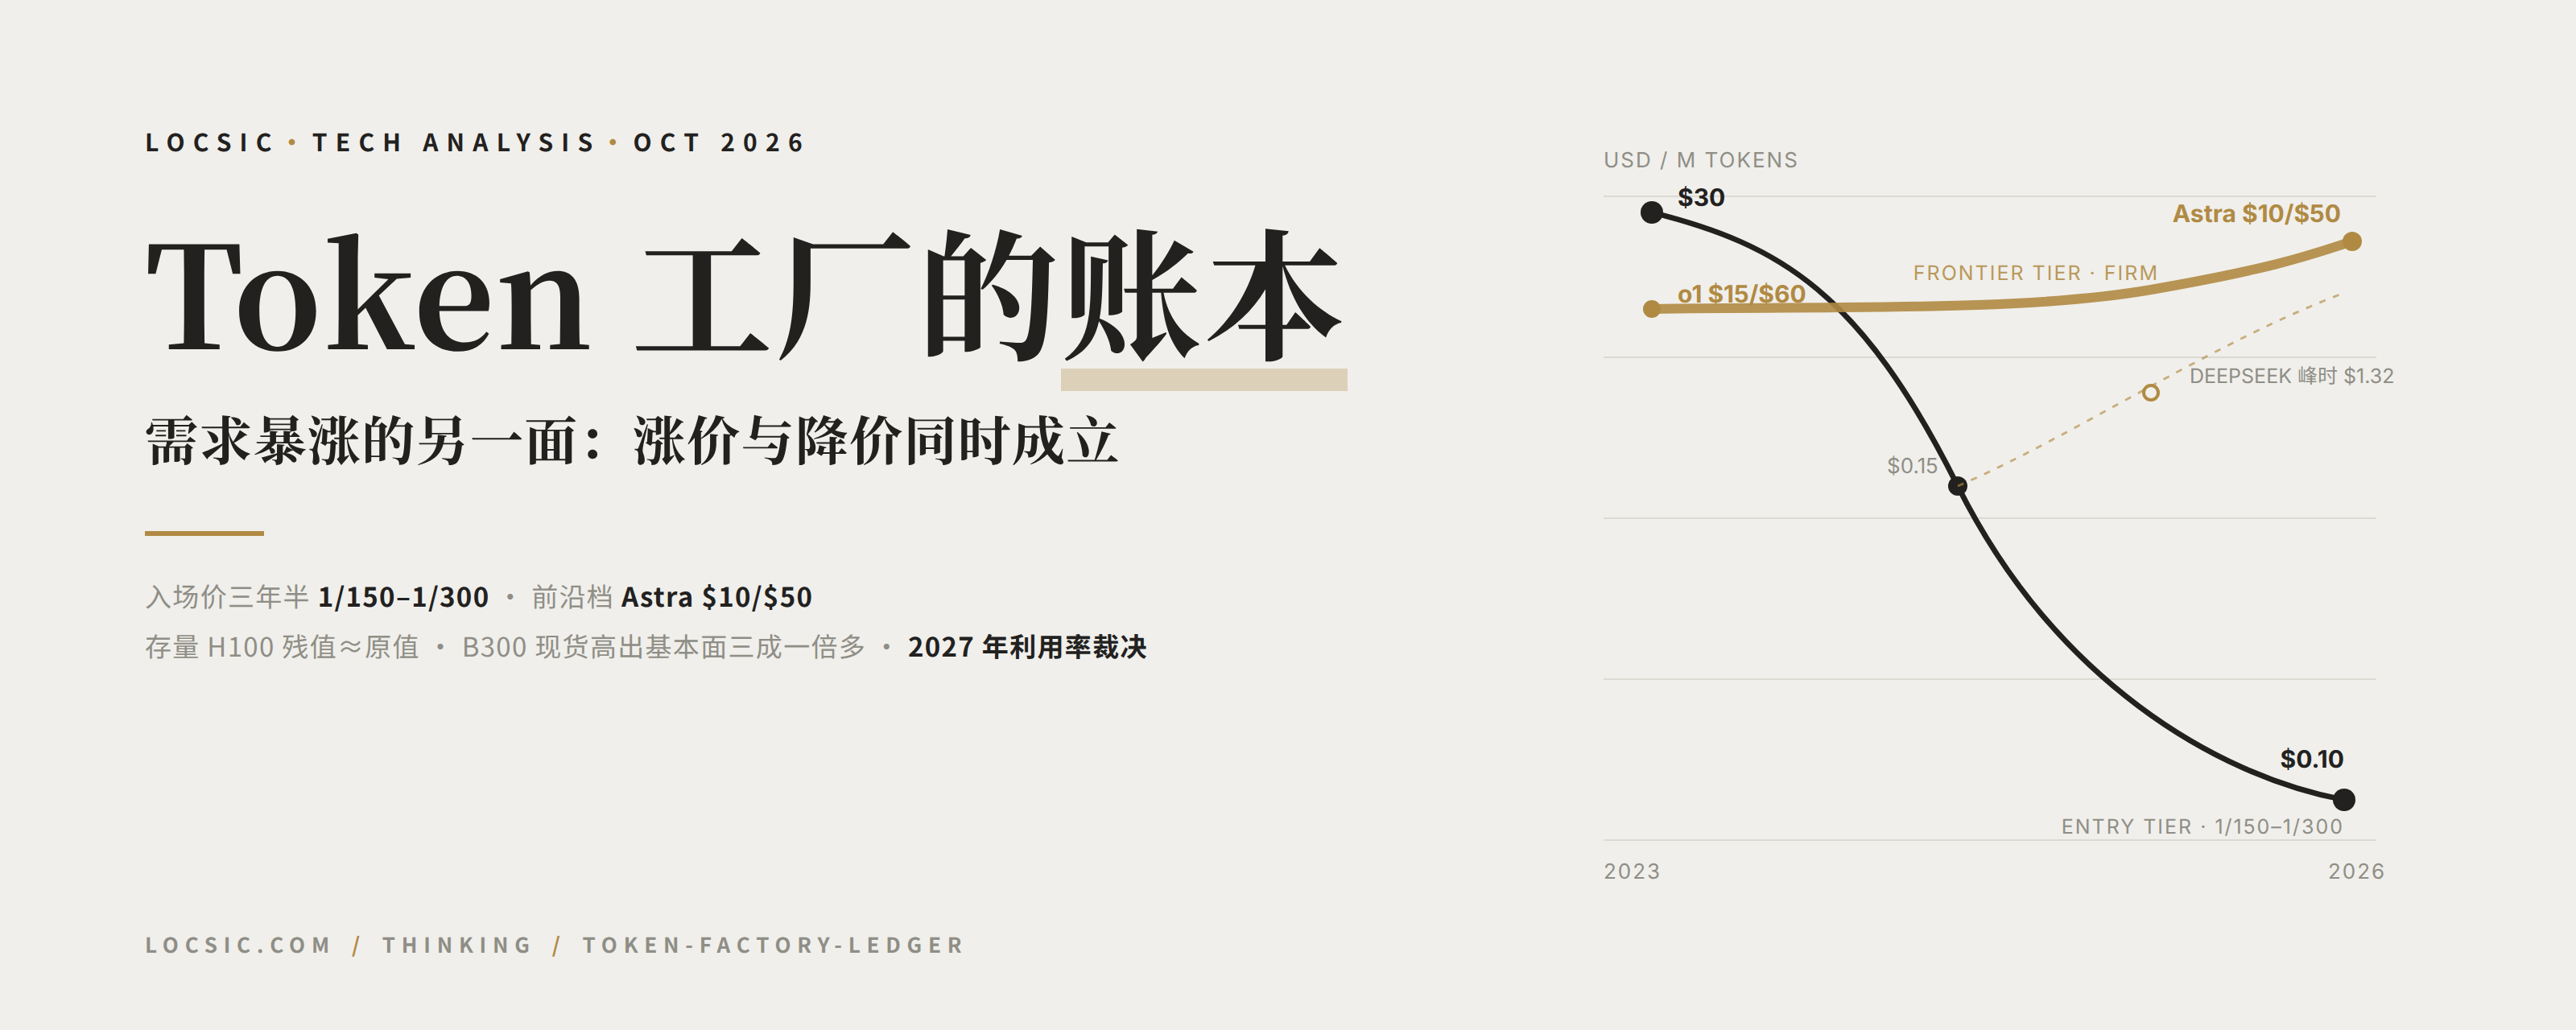
**另一组是降价,这也是过去两年的主叙事。**豆包大模型日均 token 调用量两年涨了 1500 倍;Gemini 3.1 Flash-Lite 输入标价 0.10 美元,只有 2023 年 3 月 GPT-4(30 美元)的三百分之一。
两组事实是同一场转型的两面。算力正在从“建设项目”变成“工厂”:过去是一次性采购、集中训练,现在是持续生产一种叫 token 的商品。中国信通院 2026 年的报告和产业界把这一步概括为“智力服务的千瓦时时刻”(转述口径)。Gartner 的数据也指向这一点:2026 年 AI 优化 IaaS 支出中,推理占 233 亿美元(约 55%),首次超过训练的 190 亿美元。要注意,这只是云上 AI 基础设施的支出,不是全球推理的总支出。
既然是工厂,就有账本:用什么记账,收入从哪里来,成本怎么摊,利润落在谁手里。把这几笔算清楚,看起来矛盾的现象就能各归其位,接下来真正值得盯的变量也会显出来。本文按四页账本来算,依次是记账单位、收入、成本、利润,最后加一页周期。
一、记账单位:token 不是一种稳定的货币
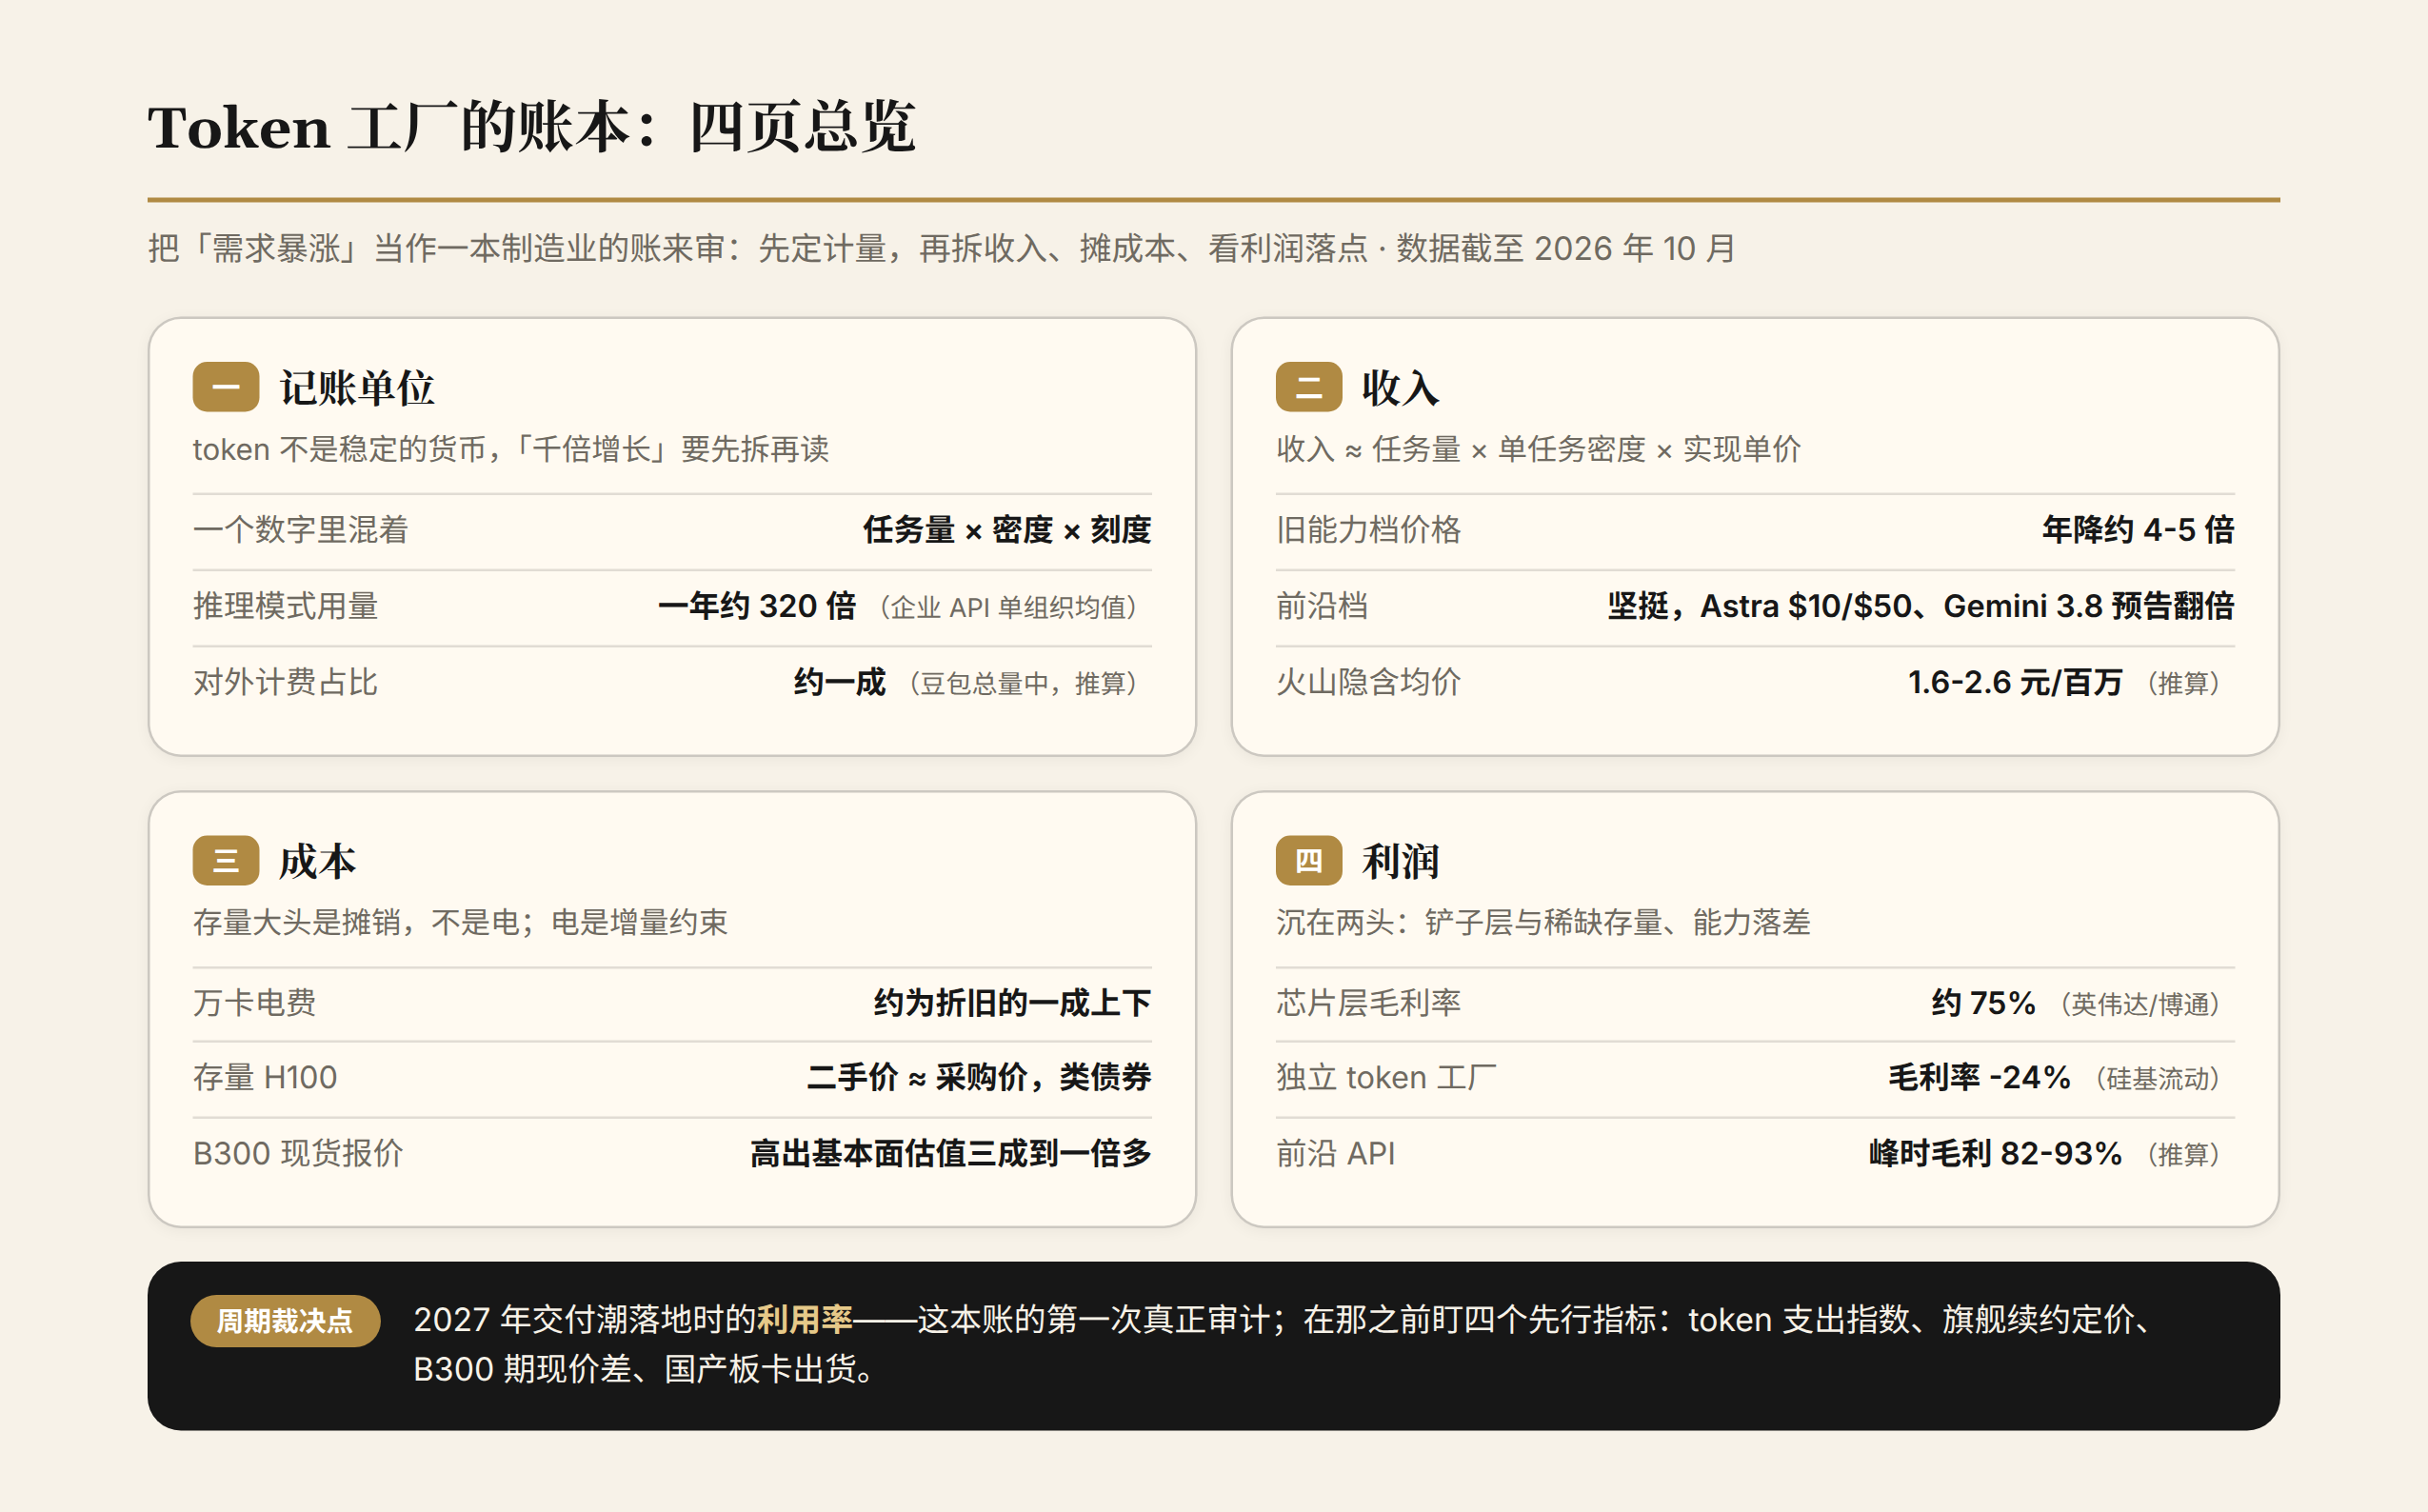
读任何“token 调用量暴涨 N 倍”的数字之前,先要问一句:一个 token 到底代表多少东西?
答案取决于年代。OpenAI 在 2025 年底的企业报告里给过两个数字:
- 过去十二个月,企业客户的 ChatGPT 消息量(总量)增长 8 倍;
- API 侧单个组织平均消耗的推理(reasoning)token 增长约 320 倍。
这两个数不能直接相除。一个是产品总量,一个是每组织平均;而且推理模型 2024 年 9 月才上线,基数接近零。所以 320 倍首先说明的是推理模型普及得极快。
单任务密度上升,要用别的证据来证明:
- 第三方评测机构 Artificial Analysis 实测,同一任务下 Gemini 2.5 Flash(推理模式开启)的 token 用量约为上一代 Gemini 2.0 Flash(非推理)的 17 倍;
- 多模态又叠了一层:火山引擎官方数字显示,Seedance 2.0 生成一分钟 720p 视频要消耗超过一百万 token;
- agent 完成一次复杂任务,消耗数十万 token 是常态。
所以“调用量涨了一千倍”这句话里,混着三种增长:
- 用的人和场景变多了,这是真实的量;
- 每单任务消耗的 token 变多了,这是密度;
- 跨代 tokenizer 换了刻度,这是账面变化。它的方向并不确定:新一代 tokenizer 往往更省 token,反而会让账面量偏小。
前两种是真实增长,第三种是度量问题,但三者都被计进了同一个数字。
度量问题不只停留在理论上。2026 年 3 月,国家数据局披露全国日均 token 调用量突破 140 万亿;同月,火山引擎披露豆包大模型日均使用量 120 万亿。两个官方数字放在一起很难自洽:如果口径相同,豆包一家就占全国的 86%,这和它约一半的公有云 MaaS 份额对不上。可见两者口径必然不同,差别可能在是否含视频 token、是否含集团内部调用、是否只计计费调用,但没有人说清楚。整个产业在用一种会通胀、各家刻度又不一致的货币记账。
标准解法是构造“固定任务篮”:选一组固定任务(一次千字摘要、一次代码修复、一分钟视频),跨代追踪它们各消耗多少 token、值多少钱,就像 CPI 之于货币。但目前没有任何机构持续公布这类数据。现在只能用间接证据确定方向:单请求约 17 倍、一分钟视频上百万 token、一次 agent 任务数十万 token,说明同一代模型之内密度就在上台阶。跨代密度在膨胀,这个方向成立,但量级无法精确。
本文后面所有关于“量”的数字,都应该放在这个背景下读:它们计的是 token,不是任务。
二、收入:把“暴涨”拆成三个因子
Token 工厂的收入可以写成:
收入 ≈ 任务量 × 单任务 token 密度 × 实现单价
第一节说的刻度变化会混进“密度”这一项。三个因子方向不同:任务量和密度在涨,单价在跌。所以收入涨得比 token 调用量慢,应该是常态。下面把数字代进去验证,后面会看到一个例外。
量:三个因子里最扎实的一个
量有连续的官方序列:
- 豆包大模型日均 token:2024 年 5 月发布时 1200 亿,2025 年 12 月 63 万亿,2026 年 3 月 120 万亿,6 月突破 180 万亿。两年涨了 1500 倍,最近一年仍在 10 倍以上。
- 谷歌全系产品月处理 token:2024 年 5 月 9.7 万亿,2025 年 5 月 480 万亿,2026 年 5 月 3.2 千万亿(quadrillion),两年涨了 330 倍。
IDC 的数据给出了另一个口径:2025 年中国公有云大模型全年调用量 1944 万亿 token,同比增长 16 倍,折合日均约 5.3 万亿。这比豆包同期单家披露的日均 63 万亿低了十倍以上。合理的解释是,IDC 统计的应是公有云对外计费的调用,豆包的口径应包含集团内部使用(口径构成是本文的推断)。两个数都真实,但不能直接比较,这又是第一节刻度问题的一个例子。
企业侧同样陡峭:谷歌云有 375 家客户年消耗超过一万亿 token;火山引擎平台上年调用量超万亿的企业,半年内从 100 家翻到 200 家。
价:信息量最大的一个因子
价格不是一条线,而是一族按能力档展开的曲线。按能力把模型分为当期旗舰、上一代旗舰、轻量档三层,同一档内能力相当,不论出自哪家,每一档都有自己的价格史。
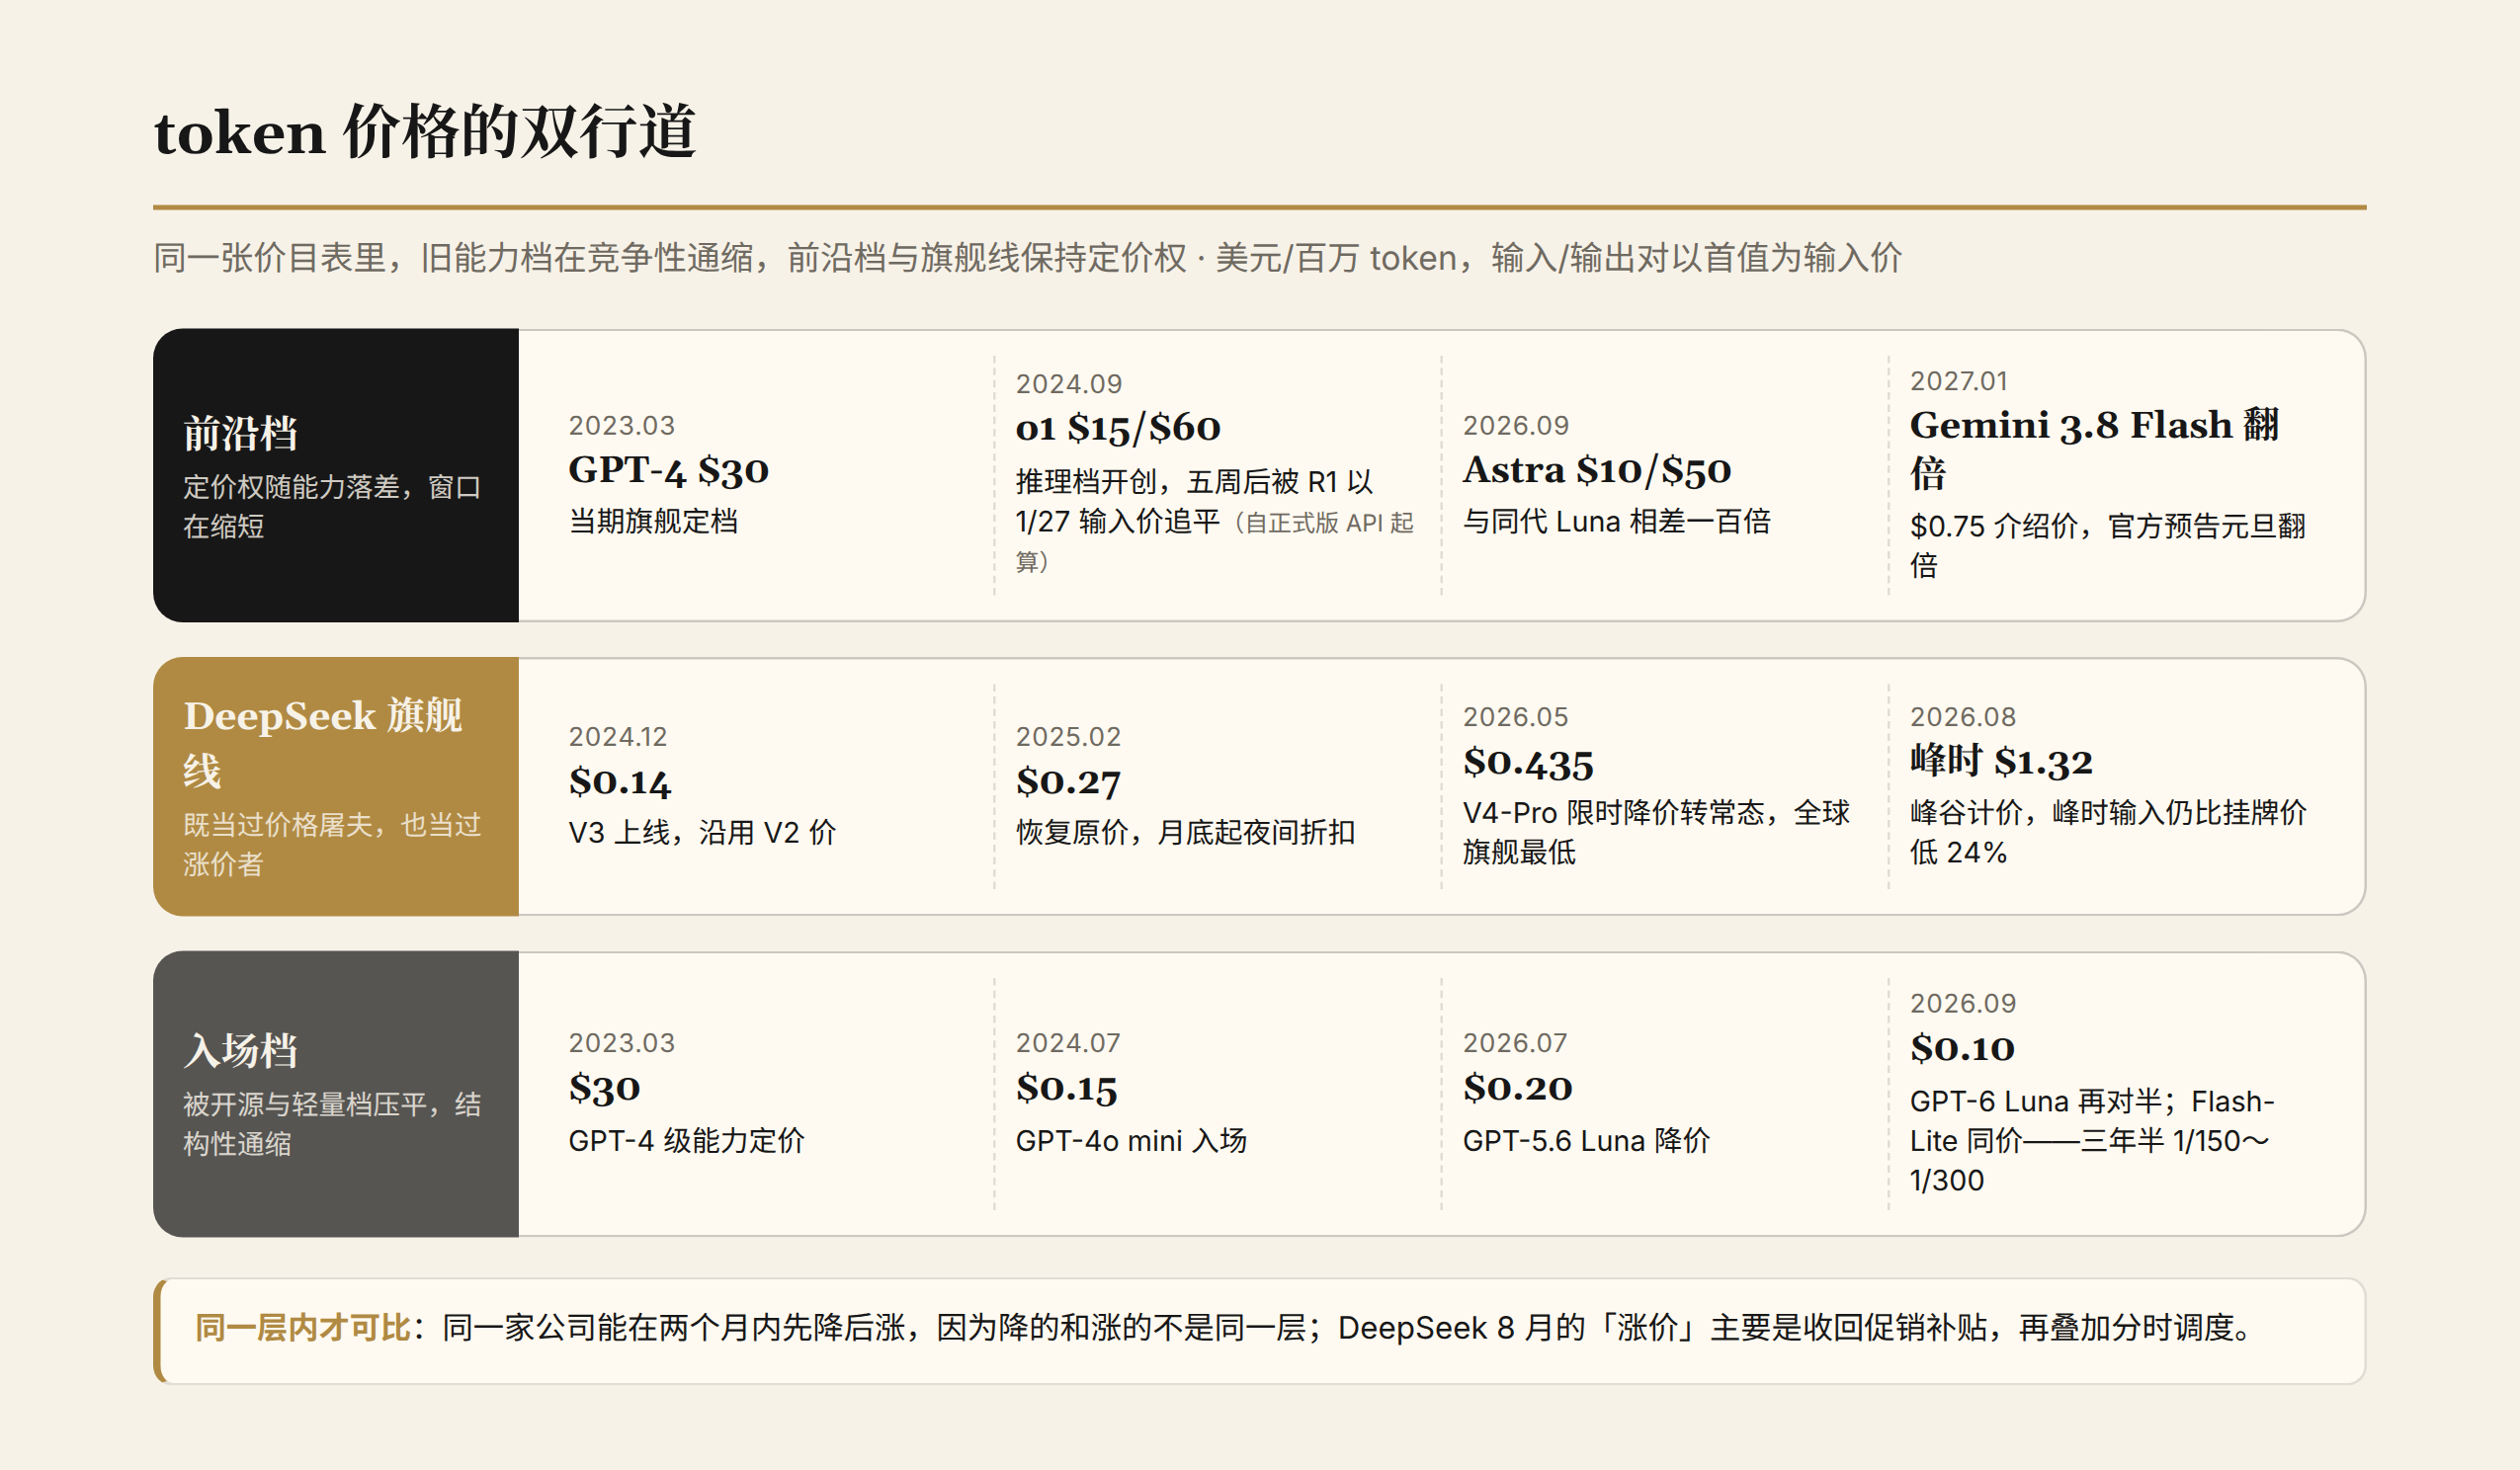
DeepSeek 的官方定价史最能说明问题:两年里它既当过价格屠夫,也当过涨价者。
- 2024 年 12 月:V3 上线,沿用 V2 的价格,输入 0.14 美元/百万。2025 年 2 月 8 日起恢复原价 0.27 美元,比同档美国模型低一个数量级。同月底又对 V3/R1 推出夜间折扣,分时定价的做法从那时就有了。
- 2026 年 4 月 24 日:V4 发布。Pro 挂牌 1.74/3.48 美元,Flash 0.14/0.28 美元。Pro 同时附带 75% 的限时折扣,输入降至 0.435 美元,另设缓存命中价。
- 5 月 22 日:折扣价转为常态价,Pro 输入 0.435 美元、输出 0.87 美元,是全球旗舰模型里最便宜的。
- 8 月:6 日发出涨价预警,13 日随 V4-Pro-0813 正式发布公布新价,16 日起实行峰谷计价。峰时为 UTC 01:00-04:00 和 06:00-10:00(北京时间工作日 9-12 点、14-18 点),仅限工作日,约占一周时长的 21%;其余时段价格减半。
8 月这次调价,要分三个基准来看:
| 时段 | 新价(输入/输出,美元/百万) | 对比 5 月常态价 | 对比 4 月挂牌价 |
|---|---|---|---|
| 峰时 | 1.32/3.96 | 按输入输出 3:1 混合约 3.6 倍 | 输入低 24%,输出高 14% |
| 谷时 | 0.66/1.98 | 混合约 1.8 倍 | 两项都低于挂牌价 |
所以这次“涨价”,主要是把促销补贴收回来,再叠加分时价格调度拥塞。
中国市场还有一条更早的价格线:2024 年 5 月,豆包以 0.8 元/百万的输入价入场(官方称比行业均价低 99.3%)。一个月内,阿里把 Qwen-Long 降价 97%,百度直接免费。
美国梯队呈现的是同一规律的两端:
- 底部:OpenAI 7 月 30 日把 GPT-5.6 Luna 降到 0.20 美元/百万,9 月底 GPT-6 Luna 再降一半到 0.10 美元。以 GPT-4 级质量为基准,入场价三年半降到原来的 1/150~1/300,两端分别对应 0.20 美元和 0.10 美元。按三年半的窗口折算,年降约 4-5 倍;窗口缩到三年就接近 6 倍,基准和窗口的选择对这个数影响很大。
- 前沿:GPT-6 Astra 9 月上市,定价 10/50 美元;Gemini 3.8 Flash 以 0.75 美元的介绍价进场,官方已预告 2027 年元旦翻倍。
两端放在一起看,“token 价格”其实分两层:旧能力档在竞争中通缩,新能力档在供给紧张时有溢价空间。同一家公司能在两个月内先降后涨,是因为降的和涨的不是同一层。DeepSeek 的例子还说明,有些“涨价”只是把补贴价回调到挂牌价附近。
收入:直接看公司的账
- OpenAI:年化收入 2025 年 6 月 100 亿美元,年底约 200 亿,2026 年 8 月超过 400 亿。9 月曾有媒体报道“逼近 700 亿”,10 月初就被修正报道否定,本文以 8 月的数据为准。
- Anthropic:从 2025 年底的 90 亿美元增至 2026 年 4 月官方披露的 300 亿,四个月增长 3.3 倍。
- 阿里云:AI 相关产品收入截至 2026 年 6 月季度已连续十二个季度三位数增长,单季 124 亿元。AI 模型与应用的年化收入指引年内从 80 亿元上调到 300 亿元(与“AI 相关产品”收入口径的对应关系未披露)。
把收入曲线和 token 量曲线对照:
- OpenAI:约 14 个月涨 4 倍,比谷歌一年约 6.7 倍的 token 增速平缓,符合三因子拆解的预测。
- 阿里:同样符合预测。
- Anthropic 是例外:四个月 3.3 倍,年化在 30 倍以上,比任何一条公开的 token 曲线都陡。只有两种解释:要么它自己的 token 量涨得更快(coding agent 的密度效应),要么它的实现单价在上升(收入结构向前沿档和企业订阅倾斜)。两种解释都指向本页的结论:收入弹性最大的地方是前沿层。
火山引擎 MaaS 收入的一致性推算
火山引擎没有披露 MaaS 收入的绝对值,可以用 IDC 的对外计费口径做一致性推算(本文推算,非官方数据):
2025 年基数
- IDC 统计的 2025 年全国公有云对外计费调用是 1944 万亿 token(“对外计费”的口径构成是本文推断)。火山占 49.5%,这是按调用量算的份额(谭待原话:“每两个 Token 就有一个是火山”),约合每年 960 万亿。
- 对照豆包自身的量:按 12 月日均 63 万亿年化,对外计费部分不足 5%;按全年均值算,也只在一成上下。大量调用发生在集团内部,或者不计费。
2026 年测算
- 假设 2026 年外部计费量增长约十倍(2025 年全国增速是 16 倍,这里假设减速),火山对外约 0.96 亿亿 token。
- 如果 MaaS 收入落在 150-250 亿元(管理层“翻五倍”目标对应的区间),隐含实现均价约 1.6-2.6 元/百万。
与牌价对照
- 只对照输入价:约为旗舰档(豆包 2.1 Pro 输入 6 元)的三到四折,量产档(Turbo 3 元)的五到九折。
- 按输入输出 3:1 混合牌价(Pro 约 12 元)算,只有一到两折。
这说明实际调用以轻量档和缓存命中为主,大客户折扣很深,不可能是“主力跑在旗舰档”。
反推 2025 年
- 收入基数 30-50 亿元除以 960 万亿 token,均价约 3-5 元。
- 需要说明,“价格约降一半”是由“量涨十倍、收入涨五倍”这两个假设直接推出来的,不是独立验证。能检验的只是:均价减半,与同期牌价下调、缓存渗透的方向是否一致。目前看是一致的。
- 另外,“翻五倍”既可以理解为乘以 5,也可以理解为乘以 6,区间的上沿会随之变化。
这一页的结论:需求确实在爆炸,但爆炸来自任务量和密度两个因子的叠加,而且大头是内部消耗,收入只跟上了其中一部分。价格曲线上真正值得盯的,不是底部在降(那部分已经在结构性通缩),而是前沿层能坚挺多久。它决定了模型公司能不能持续把新增的密度变成新增的收入。Anthropic 的曲线说明,这件事做得到。
三、成本:每瓦 token、双轨制与折旧错配
Token 的单位成本可以写成:
单位成本 ≈ 电价 ÷(每瓦 token 产出 × 利用率)+ 资本摊销 + 工艺成本
式中的工艺成本,指推理内核、批调度这类把算力变成吞吐的工程投入。几个变量里,最反直觉的是摊销,最容易被说错的是电力。
电力:增量约束,不是存量大头
英伟达在 2026 年 AI Infra Summit 上,把行业 KPI 正式切换为“每兆瓦 token 产出”。它的技术博客给出的口径是:电力最高占 AI 工厂运营成本(OpEx)的 40%。这个数字常被读成“电费是最大成本”,但运营成本不含折旧,而芯片属于资本开支。
自己算一遍就清楚:
- 美国:一台 8 卡 H100 整机功率约 10 千瓦,美国工业电价 8.7 美分/千瓦时,满负荷电费约每小时 0.87 美元。八张卡的时租合计 22.8-36 美元,电费只占整机租金的 2-4%。
- 中国:结构相同。H100 整机电费约 0.43 万元/月,相对 6.7 万元的月租约占 6%。
- 万卡集群(约 1250 台):按 PUE 1.0-1.3 计,年耗电约 1.1-1.4 亿度;按每度 0.4-0.6 元,年电费约 0.45-0.85 亿元。同一集群五年直线折旧约 5.3-5.8 亿元/年,电费约为折旧的一成上下(8-16%)。
“电占 OpEx 四成”和“电只占总成本一小块”两个说法都对,混用就会得出荒谬的结论。电的真正作用不在存量成本,而在限制增量:新产能拿不到电,“每兆瓦 token”才成了全行业的标尺。
摊销:两本完全不同的账
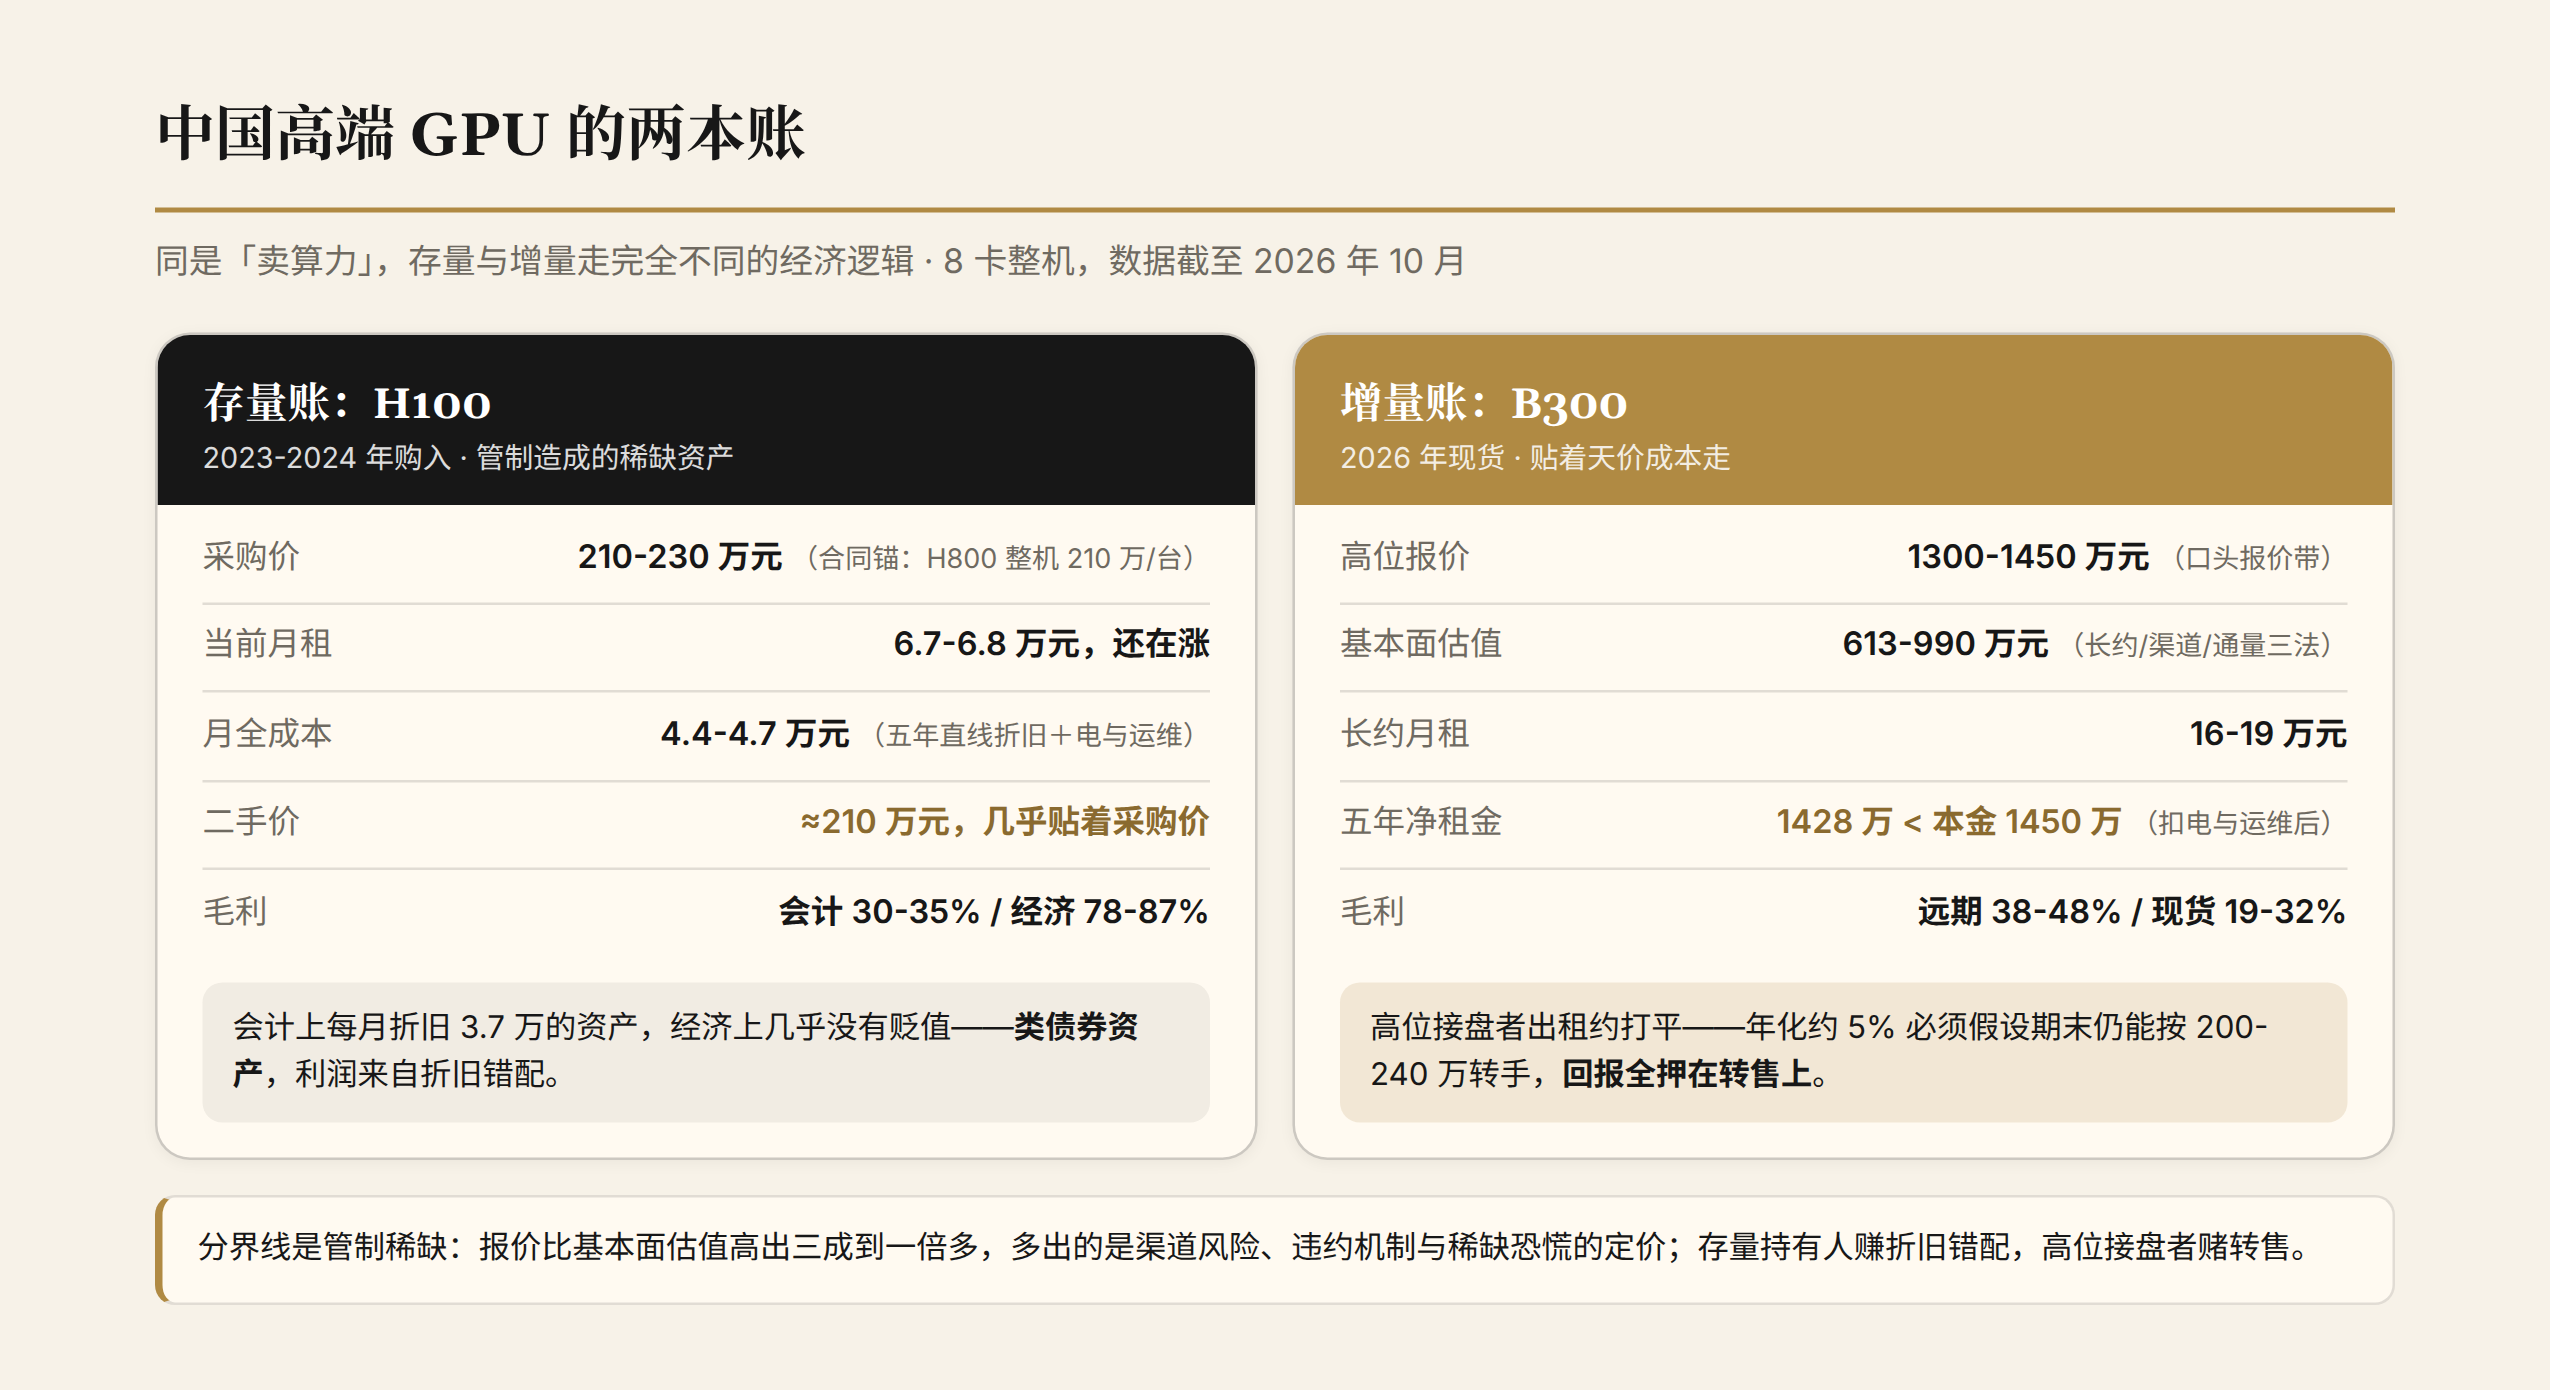
存量成本的真正大头是摊销。2026 年的中国市场上,摊销演出了最戏剧性的一幕:高端 GPU 走的是两本完全不同的账。
存量账:H100
- 一台 2023-2024 年购入的 8 卡 H100,采购价约 210-230 万元。有独立于二手价的合同锚:2023 年 9 月莲花科创公告向新华三采购 330 台 H800 八卡整机共 6.93 亿元,合每台 210 万元;中国电信同期算力服务器集采 4175 台、84.63 亿元,均价约 203 万元(公示经智东西转录);H100 灰市单卡约 28 万元、整机约 235-240 万元——与二手报道两源互证。
- 五年直线折旧合每月 3.5-3.8 万元,加上电费和运维,全成本约 4.4-4.7 万元/月。这与行业专家“H100 月租跌到 4 万元就接近盈亏平衡”的说法吻合。
- 但从 2026 年 5 月起,它的月租是 6.7-6.8 万元,国庆前后还在涨。
- 更特别的是残值:用了近三年的机器,二手价仍在 210 万元上下,几乎贴着采购价。会计上每月折旧 3.7 万元的资产,经济上几乎没有贬值。
管制造成的稀缺,把存量 H 系列变成了类似债券的资产。存量持有者的利润来自“会计折旧与真实贬值之间的差”,而不是运营效率。
增量账:B300
价格走势:
| 时间 | 8 卡 B300 整机国内价格 | 相对美国同款(约 55 万美元,折合约 390 万元) |
|---|---|---|
| 2025 年底 | 约 400 万元 | 大致持平 |
| 2026 年 5 月 | 成交价约 700 万元 | 约 1.8 倍 |
| 2026 年 6-8 月 | 渠道高位报价 1300-1450 万元 | 3.3-3.7 倍 |
6-8 月的价格是顶配现货的口头报价,真实成交量无法核验。
基本面估值有三个口径:
- 渠道成本线:产业链拆解约 910 万元(转运成本 700 万元,加三成风险补偿)。
- 长约倒推:按大客户长协月租上限 20 万元倒推,买方能承受的采购价只有 900-990 万元,隐含约 6-10% 的要求回报率。
- 通量倒推:按 70% 负载、五年摊销、以轻量档 token 价格测算,只有 613-876 万元。这个测算与第四节服务成本推算共用同一类吞吐假设,两者不构成相互独立的验证。
溢价从哪里来:现货报价比长约倒推价和渠道成本线高出三到六成,比通量倒推价高出五成到一倍多。多出来的部分,是在为渠道风险、违约机制和稀缺恐慌定价。违约金只有 5-10%,在涨价周期里,卖方毁约转售是理性选择,合同机制本身就在推高报价。
怎么回本?增量买家只能靠五年期长约锁定月租(16-19 万元)。以下均为本文推算,按月度现金流折现,假设满租、残值记零,不计空置、税费和融资成本;把这些计入后回报还会更低。
| 采购口径 | 年化内部收益率 |
|---|---|
| 远期锁价采购(约 520 万元) | 约 26-38% |
| 现货采购(700 万元) | 约 10-20% |
| 现货高位接盘(1450 万元,月租 25 万元) | 约 -1% 到 +1% |
最后一行要单独解释:五年租金扣除电力运维后约 1428 万元,连本金都覆盖不了,出租本身不赚钱。要做到年化约 5%,必须假设期末机器仍能以 200-240 万元转手。也就是说,回报全押在转售上。
两本账合起来,可以解释租金上的反差。
“硬件贵、租金却追平”的现象只发生在 B300 上:灰市整机比美国同款贵八成(5 月成交价)到两倍多(高位报价),单位算力租金却已接近美国的标准化价格。原因是增量租金紧贴着高昂的现货成本。
H100 不存在这种倒挂:它的中国采购价与美国大致持平,租金低另有原因。存量机器大多已部分回本,政策风险又在价格里打了折扣。
| 中国租金 | 折合美元/卡时 | 与美国对比 | |
|---|---|---|---|
| 8 卡 H100 | 6.7-6.8 万元/月 | 约 1.6 | 美国 10 月水平(2.85-4.50)的三成半到五成半 |
| 8 卡 B300(一年期) | 22-28 万元/月 | 约 5.2-6.8 | Silicon Data 标准化价格(6.71)的八到十成;Nebius 按需价(9.50)的五成半到七成 |
旧代际便宜,是因为存量机账面价值低,灰市资产又内含政策风险折价;新代际接近美国价格,是因为租金紧贴着高昂的现货成本。中美价差收窄的过程,本身就记录了一轮成本推动型通胀。
通胀链
这条通胀链的前三环,每一环都有数据:
- 内存:HBM 与内存合约价 2026 年一季度同比涨 4-5 倍,DDR5 内存条涨超 300%,内存占整机成本的比例从一成升到三四成。
- 整机:H200 整机从 210-230 万元涨到 480-535 万元。
- 租金:春节后普涨 30%,B200 续约涨 94%;Nebius 十月第二轮提价,H100 到 4.50 美元,B300 到 9.50 美元,B300 年内累计涨 56%。
最后一环 token 价格,只能算时间上同步。DeepSeek 8 月调价确实与 B300 从 700 万元冲向 1450 万元发生在同一时期,但不能当作因果证据:
- DeepSeek 自有机队主要不是灰市 B300;
- 官方给的理由是错峰调度;
- 峰时输入价仍低于发布挂牌价。
更稳妥的说法是:旧能力档通缩的斜率由竞争决定,价格的地板则由算力成本划定。在算力普遍紧张、成本上行的周期里,价格屠夫也没有理由继续补贴。
产出折扣:装机总量掩盖的问题
截至 2026 年 6 月,中国智能算力装机 2185 EFLOPS(FP16)。粗算的假设是:典型 MoE 模型每生成一个 token 约需 2N 次浮点运算(N 为激活参数)。按 40B 激活参数,全部用于推理、峰值满负荷运行,理论产出约每天 2300 万亿 token。
但推理的正常效率远低于峰值:解码利用率约 15%,负载约 70%,合计约 10%。按 49B 激活参数(与第四节 V4-Pro 的口径一致)计,全国装机按正常推理效率运转,日产约 200 万亿 token(激活参数在 40-50B 区间内取值,对这个量级结论不敏感)。
实际调用量怎么取,要回到第一节的口径问题。全国 3 月的官方口径是 140 万亿;按头部厂商一个季度增长约五成的速度外推,三季度应在 200 万亿以上。豆包单家口径(6 月 180 万亿)与全国口径不可比,不能直接相加。
两个数放在一起可以得出两点:
- **“综合利用率不到一成”不是闲置的证据。**它就是推理的正常效率。
- **真正的信息是余量不足。**如果观测口径可信,全国算力几乎要全部用于推理,才能产出这个量级,训练侧没有余量。
这个换算对精度很敏感:如果推理普遍以 FP8 部署,有效产能翻倍,观测量占比降到四五成(视激活参数与观测取值)。两边的口径也都很粗(视频 token 怎么计、多模态单价、各家激活参数都不同),这组换算只能用来判断方向。
主要证据来自微观层面:
- 高端卡出租率超过九成;
- 部分机器上架即被租空;
- 新签合同的交付排到 2027 年上半年;
- B300 挂牌中确认可租的只有 11%。
瓶颈不在装机总量,而在有效产出。这个判断由微观证据支撑,宏观换算只说明两者不矛盾。
四、利润:钱沉淀在哪一层
翻到利润页,价值链上五个环节的读数差异极大。
| 环节 | 2026 年读数 | 信源 |
|---|---|---|
| 芯片(商品 GPU) | 英伟达季度收入 962 亿美元(+106%),毛利率 75%,数据中心占 92% | 财报 |
| 芯片(定制) | 博通 AI 半导体单季 167 亿美元(+221%),毛利率约 75%,指引 2027 年 1150 亿、2028 年 2300 亿 | 财报 |
| 云 / 自研芯片 | 微软 AI 年化收入超 370 亿(+123%);亚马逊自研芯片年化超 200 亿;Nebius AI 云 EBITDA 率 50%、容量“上线即售罄” | 财报/股东信 |
| 独立 token 工厂 | 硅基流动 2025 年营收 5533 万元、毛利率 -24%(公有云业务 -119%),年内融资 29 亿元续命 | 融资披露 |
| 模型厂 | OpenAI 年化超 400 亿;Anthropic 300 亿;豆包/千问按量计费,火山 MaaS 目标收入翻五倍 | 官方/推算 |
**利润高度沉淀在“卖铲子”这一层。**英伟达和博通的毛利率都在 75% 上下,博通的自由现金流率 46%。博通还敢把 2028 年收入翻倍的指引,建立在与六大客户的多年协议上。这些协议实际上把客户的未来需求变成了上游的收入能见度,但还不是已经确认的收入。
**中间层在打公用事业式的价格战。**同样是“独立 token 工厂”,中国的硅基流动用负毛利换规模,海外的 Nebius 靠售罄的容量和 90 亿美元客户预付款,把 EBITDA 率做到 50%。同一种商业模式在两个市场读数相反:中国的需求端被 token 价格战压低了能承受的租金,海外的需求端在竞价抢产能。
模型厂的跑步机
模型厂遵循第三种逻辑。芯片层赚的是当期稀缺的钱,云层赚的是规模运营的钱,模型厂赚的是能力落差的钱,而落差会自行消失。这像一台跑步机,分四步转:
- 新旗舰上市时,它所在的能力档上只有它一家,定价权接近垄断。
- 竞争者不必造出同等的闭源模型,只要用开源或低价的方式供给“够用”的版本。GPT-4 的能力在 2023 年 3 月值 30 美元/百万 token;到 2026 年,同等质量的入场价是 0.10-0.20 美元,三年半跌到原来的 1/150~1/300。压力来自两处:开源权重以接近成本的价格供给同档能力,巨头自家的轻量档也在往下压。
- 档位一旦被追平,价格就向供给成本塌缩。在这个价位上,模型厂争不过云和推理平台,因为后者的价格地板就是自己的电价和摊销。模型厂唯一的出路是发布下一个旗舰,重建落差。
- 循环重启:上一档在塌,新一档在立。原地不动的话,收入结构会整体滑进通缩档。
这台跑步机上有一只钟:新档定价权的窗口期,也就是从上市到被可信的低价替代品追平,隔多久。
- GPT-4 级能力:约一年半被开源权重基本追平,以 2024 年 7 月发布的 Llama 3.1 405B 为标志。同期 GPT-4o mini 也以 0.15 美元级的价格入场,两个标志互相印证。追平之后,价格又继续下探了两年。
- o1 开创的推理档:定价 15/60 美元,从 2024 年 9 月 12 日 preview 起就是这个价。2025 年 1 月 20 日,DeepSeek R1 以 0.55/2.19 美元入场,输入价约为 o1 的二十七分之一。从 preview 首发算约四个月,从 12 月正式版 API 算约五周。
窗口期在明显缩短。看懂这只钟,三个现象就都有了解释:
- GPT-6 Astra 与 GPT-6 Luna:前者 10/50 美元,后者 0.10/0.50 美元,整整差一百倍。同一家公司、同一代产品内部的价差,就是落差定价的直接读数。
- Gemini 3.8 的介绍价:官方预告 2027 年元旦翻倍,等于把“这个档位还能稀缺多久”直接写进了价目表。
- DeepSeek 8 月调价:有三个因素同时起作用,分别是收回补贴、调度拥塞,以及 V4-Pro 档位上暂时没有对手的窗口。现有数据拆不出各自的占比。
所以前沿溢价不是贪婪,而是维持费,它支付的是下一轮训练的账单。但它付不清这笔账。Anthropic 300 亿美元的年化收入,对应的是 2027 年接近 10 GW 的算力承诺。按每 GW 每年约百亿美元的租用成本粗算,10 GW 全部到位后,年开支在千亿美元量级;即便分批上线,2027 年当年也是数百亿到上千亿美元。收入覆盖不了,差额只能靠融资补,这正是本节末尾“容量金融化”的另一面。
判断一家模型厂的账本是否健康,最锋利的单一指标不是收入增速,而是两个期限哪个先到:新旗舰定价权的窗口期,还是它的融资窗口。
两种卖法:按 token,还是按卡
这本账里的所有玩家,可以按“卖什么”分成两类:
- 按 token 卖:API 按量计费、订阅打包的 MaaS;
- 按算力卖:时租、月租、裸金属长约、GW 级租约。
两边的体量和走势很不对称。中国的数据如下:
- 算力租赁(按卡按月收费):2026 年一季度规模 680 亿元,同比增长 62%(信通院口径)。中信建投等机构预测全年突破 2600 亿元。这个预测与一季度年化的 2720 亿元有矛盾,按 62% 的同比增速,全年应该明显高于 2600 亿;全年预测大多做于年内较早时候,可能没有更新。
- MaaS(按 token 计费):没有官方总额,只能推算。火山引擎占公有云 MaaS 调用量的 49.5%(已核实为按 token 量计)。按火山的收入区间(本文推算 150-250 亿元)放大,全国大盘约 300-500 亿元。火山单价低于行业均值,所以这是下限估计。
两个口径有重叠:MaaS 厂商自己也在租卡,租赁收入里包含 token 侧的成本。因此两者的比值只能当规模对照,不能当互不重叠的终端支出拆分。带着这个保留来读:目前按卡收的钱,至多是按 token 收的钱的 5-9 倍。
而 token 侧在以三位数增长:阿里 AI 相关收入已连续十二个季度三位数增长,豆包调用量一年涨十倍。算力侧一季度同比增长 62%,机构的全年预测更保守。token 侧的占比每年都在上升。阿里管理层已经把方向说明白了:MaaS 将成为阿里云最大的收入产品。
两种卖法的边界正朝两个方向同时移动:
- **算力商在向前一体化。**租赁商润建股份公开转型“Token 工厂”模式;深圳出现了采购硬件、部署开源模型、向全球卖 token、抽成 2-5% 的分发平台;Nebius 把高毛利的 Token Factory 列为轻资产新业务。原因在于,token 售价里包着算力成本,只有站到 token 一侧,才能吃到密度增长的红利。
- **重度用户在反向退出。**IDC 6 月的调查中,85% 的企业表示需要混合部署。按 token 计价对重度用户意味着“越用越贵”,一旦 token 账单超过自持设备的摊销,企业就会退回去买算力,甚至自建。
两种卖法不会互相替代:token 侧吃密度增长,算力侧吃资本开支。订阅、按量、缓存折扣、包年容量块这类分层定价,正在把两者缝进同一张价目表。
这对读账的意义在于:判断一家公司的利润质量,先看它站在哪一侧收钱。token 侧的毛利由能力落差决定(前面的跑步机),算力侧的毛利由折旧错配和利用率决定(第三节的双轨制),两侧的会计性质截然不同。“Token 工厂”这个词被滥用时,先问一句“你卖的是 token 还是卡”,就能清掉大部分混淆。
五种模式的毛利
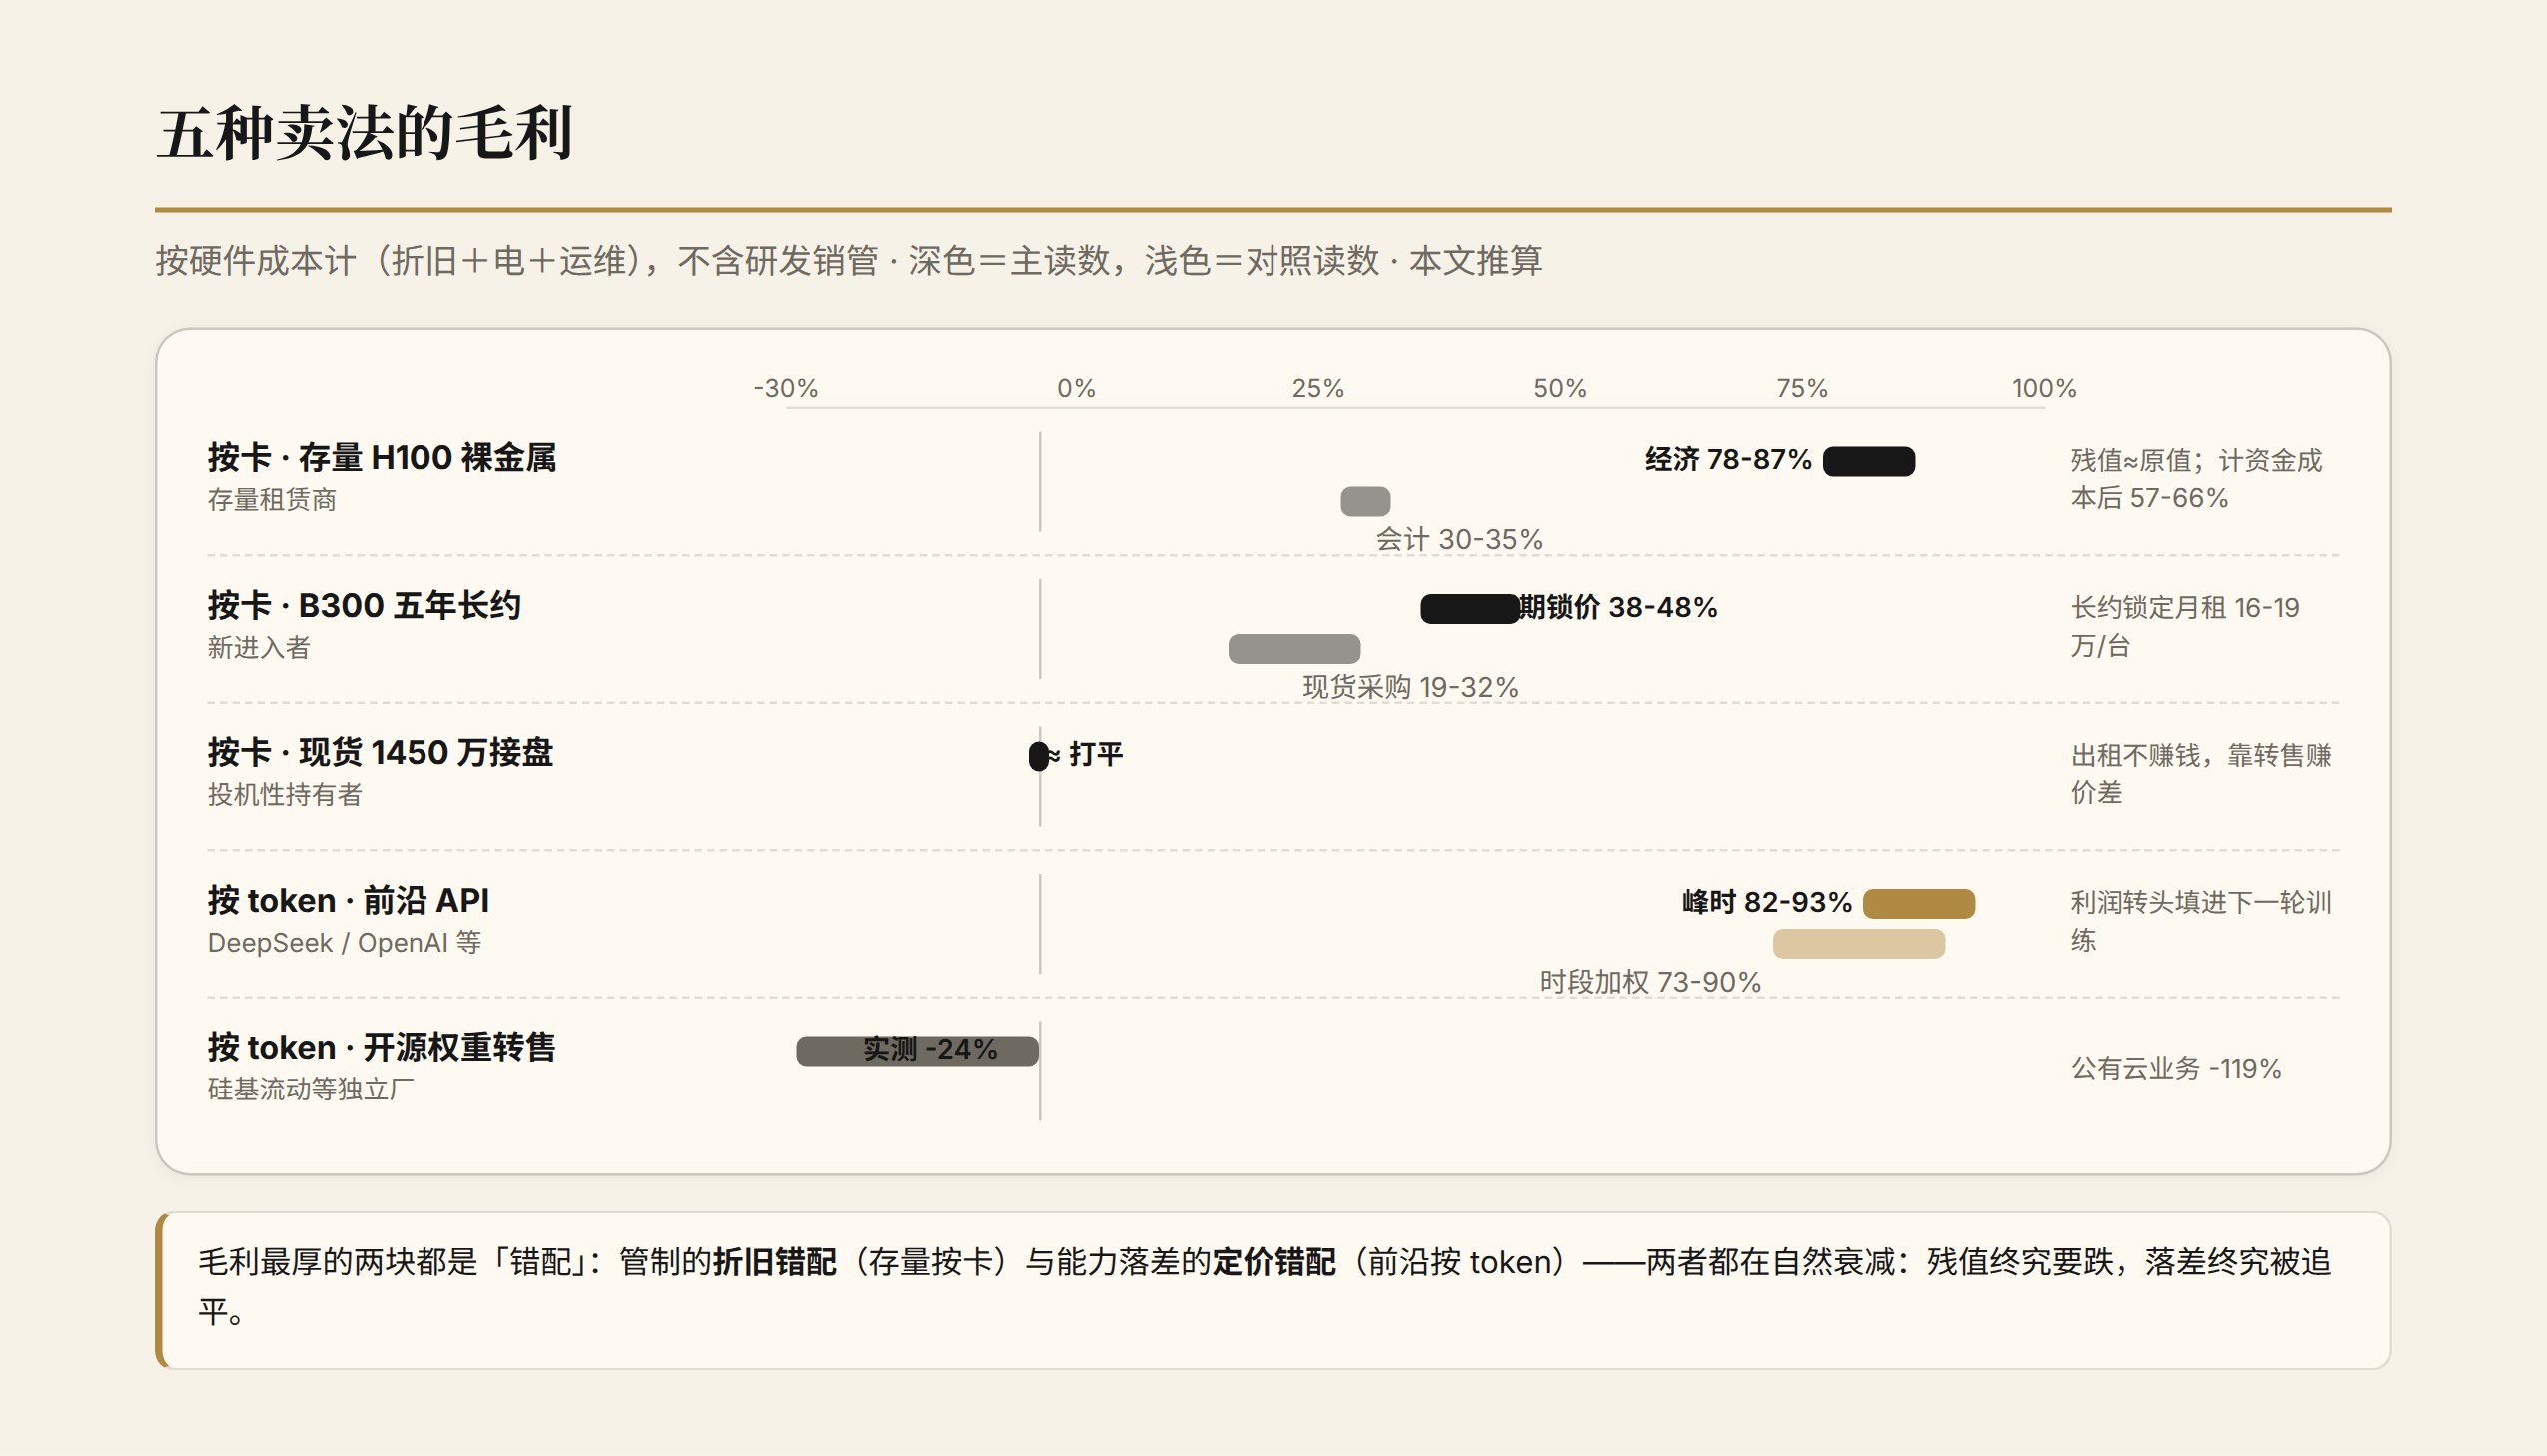
卖法明确了,就可以测毛利。下表按五种典型模式各算一本账,均为本文推算,假设随附。“毛利”都按硬件口径计,即只算折旧、电力和运维,不含研发、销售和管理费用。
| 卖法 | 典型玩家 | 月收入 | 全成本 | 毛利空间 |
|---|---|---|---|---|
| 按卡·存量 H100 裸金属 | 存量租赁商 | 6.7-6.8 万/台 | 会计口径 4.4-4.7 万(五年直线折旧+电与运维);经济口径 0.9-1.5 万(电力运维约 0.9 万+已实现贬值 0-0.6 万) | 会计 30-35%;经济 78-87%;计入资金机会成本后 57-66% |
| 按卡·增量 B300 五年长约 | 新进入者 | 16-19 万/台 | 远期锁价采购口径 9.9 万;现货(700 万)口径 12.9 万 | 远期 38-48%;现货 19-32% |
| 按卡·现货 1450 万购入 | 投机性持有者 | 约 25 万/台 | 摊销 24.2 万+电力运维 1.2 万 | 约打平:出租不赚钱,靠转售赚价差 |
| 按 token·前沿 API | DeepSeek/OpenAI 等 | V4-Pro 混合价(输入输出 3:1):峰时 1.98 美元/百万,谷时 0.99 美元;按时段加权约 1.3-1.45 美元 | 硬件服务成本约 0.14-0.35 美元/百万 | 峰时 82-93%;谷时 65-86%;加权 73-90%。利润转头填进下一轮训练 |
| 按 token·开源权重转售 | 硅基流动等独立厂 | — | 外购算力占销售成本 87% | 实测 -24%(公有云业务 -119%) |
表注:
- H100 经济口径:已实现贬值 =(采购价 − 二手价)÷ 已使用约 34 个月。资金机会成本按市值 210 万元、年化 8% 计,约 1.4 万元/月。
- 前沿 API 的时段加权:峰时约占一周时长的 21%,但正好覆盖北京时间的工作时段,所以按“峰时承载 30-45% 的调用量”假设计算。再计入缓存命中,实际实现价还会更低。
- 服务成本的假设:8 卡 B300、FP8 稠密每卡约 4.5 PFLOPS、49B 激活参数、解码利用率 15%、负载 70%,单机月产约 1000 亿 token。月全成本按采购口径为 9.9-25.4 万元:采购价 520-700 万元时,服务成本约 0.14-0.18 美元/百万;1450 万元现货重建约 0.35 美元/百万;改用 FP16 推理则翻倍。
- 服务成本的局限:这个估算没有区分 prefill(处理输入,单位成本低得多)和 decode(生成输出),对 3:1 的混合偏保守。它也只是“按今天的价格重建一套机队”的边际成本示意,不是 DeepSeek 的实际成本,DeepSeek 自有机队并非灰市 B300。
价目表本身也透露了成本结构(下面是同源旁证,与上表共用吞吐假设,不构成独立验证):
- 峰谷价差:所有档位的峰时价都正好是谷时价的 2 倍,这是时间歧视。
- 缓存价差:缓存命中价是同时段未命中价的 1/50(V4.1-Flash)到 1/30(V4-Pro)。前缀复用几乎不再消耗算力,价目表也按这个标价。8 月调价时缓存命中价同步上调(Pro 峰时 0.044 美元),但相对同时段未命中价,仍是一个数量级以上的折扣。
- Flash 谷时价:V4.1-Flash 的谷时输入价 0.15 美元/百万,与按 V4-Pro 规模推出的服务成本下沿相当。V4.1-Flash 官方模型卡标注激活参数 prefill 8B、decode 16B(552B 骨干、另含 196B Engram 条件记忆),decode 侧不到 V4-Pro(49B)的一半,真实服务成本应该更低,所以谷时价至少不像是亏本引流。但这依赖本文的成本假设,不能视为定论。
DeepSeek 等于把“复用近乎免费、新算贴近成本、利润加在峰时和输出”的三层结构摊开给了市场看。
前沿档的厚毛利主要是调价之后才有的。按 8 月调价前的混合价(约 0.54 美元)计算,硬件毛利只有约 35-74%,算不上暴利。
这张表的排序本身就是判断:
- 毛利最厚的两块,恰好是两处“错配”:管制造成的资产折旧错配(存量按卡),以及能力落差带来的定价错配(前沿按 token)。
- 最薄的两种:被追平的开源转售,以及贴着现货价接盘的增量买家。
两处厚毛利都在自然衰减:残值终究要跌,落差终究会被追平。按卡侧的存量玩家和按 token 侧的模型厂,其实站在同一台跑步机上,只是方向相反:一个在等资产贬值追上租金,一个在等开源追上旗舰。
定价权:锚在模型厂手里
这张表还引出一个必须回答的问题:按 token 卖的两行里,定价权在谁手里?实证答案出奇地干脆:在模型厂手里。同一个开源模型被多家托管,并不会动摇官方价这个锚。
- 硅基流动的价目表:DeepSeek-V4-Pro-0813 挂 1.32/3.96 美元,与官方峰时价一分不差;V4.1-Flash 挂 0.15/0.60 美元,等于把官方谷时价当作常态价。
- TRAE 的调价公告:说得更直白,“因 DeepSeek 官方定价调整”,同步把输入价上调至原来的约三倍。
- R1 时期:华为云和硅基流动上线首日就宣布“与官方同价”,比拼的是速度(官方 API 拥塞时更快),而不是价格。
机制上要把两件事分开:
- 开源对定价权的侵蚀发生在不同档位之间,也就是上一节的跑步机:开源权重追平旧档,压塌价格。
- **在同一个模型内部,开源没有改变官方价的锚地位。**第三方定价高于锚,用户会走官方;低于锚,毛利归零。两头都被钉死,跟随官方价就是唯一的均衡。
这也是上表里开源转售负毛利的微观机制:硅基流动把价格钉在锚上,而它外购算力的成本高于锚价本身。
所以第三方 token 工厂做的是利差生意:毛利 = 锚价 − 自身成本,而两头都不在第三方手里。
- 锚价由模型厂的能力落差和成本曲线决定。DeepSeek 官方文档已经预告:昇腾 950 超节点批量上市后,V4-Pro 将“大幅下调”价格。连锚价的走向,都写在模型厂自己的硬件采购计划里。
- 自身成本由硬件周期决定。
锚价一动,跟随者的毛利就同步重新分配:八月官方调价,钉在锚上的第三方毛利立刻变宽;昇腾 950 上市后的官方降价,就是下一轮压缩。模型厂跑步机的节奏,同时就是第三方 token 工厂的毛利周期表。
留给第三方的空间只剩服务:同价下更快、更稳;或者干脆离开转售红海,去做私有化部署和企业 SLA。
买方的资本结构
买方的资本结构也在变形:
- Anthropic 的 IPO 材料披露,它向博通融资的上限为 420 亿美元,用于支持五年期 TPU 租约。算力采购正在像长期购电协议(PPA)一样长约化。
- OpenAI 的算力从 2024 年的 0.6 GW 增至 2025 年的 1.9 GW。
- 亚马逊在探索把 80 亿美元的英伟达芯片移出资产负债表。
- 四大云厂 2026 年资本开支指引合计 7330 亿美元(+79%)。
供给侧的 GW 承诺、需求侧的多年租约,再加上融资安排,容量正在被金融化。
五、周期:2027 年的利用率会给出裁决
这本账目前最不确定的一页,是周期所处的位置。
看多的一方证据充分:
- Nebius 提价时表示,需求能见度超过 24 个月,客户已经在订 2028 年上半年的容量。
- H100 租金从 2025 年 10 月的低点 1.70 美元,回升到 2026 年 3 月的 2.35 美元,再到 10 月的 2.85-4.50 美元。这个 V 型反转至少说明,上一轮“供给过剩”的清算已经走完。
- 国内在履约的算力合同金额被连续上调,行云科技三笔合同分别上调 201%、79%、13%。
看空的证据同样具体:
- B300 现货报价比长约和渠道成本口径的估值高出三到六成,比通量口径高出五成到一倍多(见第三节),多出来的主要是恐慌和渠道溢价。
- 博通 2028 年 2300 亿美元的收入指引,把尚未建成的 20 GW 产能提前计入了市场预期和估值。
- 2027 年将集中交付 GW 级产能,仅 Anthropic 一家的规划就接近 10 GW。一旦撞上需求增速放缓,租金曲线可以参考 H100 自己的上一轮:从 2023 年 8 美元上下的峰值,跌到 2025 年 10 月的 1.70 美元,用了大约两年。
裁决变量只有一个:2027 年交付潮落地时的利用率。它是“token 工厂过剩还是短缺”的第一手证据,比任何分析师的判断都硬。在那之前,可以持续跟踪四个先行指标:
- Silicon Data 的 LLM token 支出指数:10 月 9 日读数一周上涨 4.9%,是 token 侧价格上行的独立证据。
- 前沿旗舰的续约定价:反映能力跑步机转得多快。
- B300 期货与现货的价差:衡量渠道恐慌的温度。
- 国产板卡出货:单张 4-8 万元、提供“接近 H100 的推理性能”,这是中国在算力稀缺下还能打 token 价格战的底牌。
结语
这本账算下来,支撑三个判断。
**第一,“调用量暴涨”是三个因子叠出来的,读数时必须拆开。**最被低估的是密度因子:推理、agent、视频把单任务 token 消耗抬高了一到两个数量级。它是需求侧最真实的增长,也让所有以 token 计的历史序列天然失真。同样被低估的是内部消耗的比重:火山的对外计费量只有豆包总量的一成上下,收入只吃到了量增长的一部分。产业需要一个固定任务篮;在它出现之前,任何“千倍增长”都应打折阅读。
**第二,毛利不会由技术进步自动送来。**同能力档价格年降约 4-5 倍,英伟达口径的硬件能效提升年化约 2.7 倍,而且 2026 年硬件的单位成本实际在上涨(第三节)。价格下行靠的是算法效率(更小的模型做到同等能力)加上硬件迭代,剩下的差额压在利润率上。这个比较只能定性看,谁填得上差额,取决于竞争格局和利用率。填得上的活下来:售罄的云、有生态的巨头、有工艺的推理平台。填不上的退场:负毛利的独立厂。成本上行周期已经把价格地板抬高,旧档通缩与前沿坚挺同时存在,是同一本账的两页。
**第三,利润目前沉淀在铲子层,以及少数握有稀缺存量或能力落差的位置;中国市场的中间层正在公用事业化。**这个结构的脆弱点不在需求(能见度 24 个月),也不在供给(2027 年才迎来交付潮),而在融资结构。头部模型厂的算力承诺已是收入的数倍,买方在用租约加融资买产能,卖方则把 2028 年的 GW 提前计入了指引和估值。整条链的偿付能力,都押在“token 收入如期指数增长”这一个假设上。2027 年的利用率数字,将是这本账第一次真正的审计。
数据与口径说明
官方一手:
- 豆包调用量序列(火山引擎四次披露)
- 谷歌 token 序列(I/O 2026 主题演讲)
- Gartner AI 优化 IaaS 口径(2026-08-10 新闻稿;推理 233 亿美元约占该口径的 55%)
- 英伟达、博通、Nebius、阿里巴巴财报(阿里 2026 年 6 月季度:AI 相关产品收入单季 124 亿元、连续十二个季度三位数增长,SEC 6-K 通稿)
- OpenAI 企业报告
- DeepSeek/阿里/火山定价页与公告(DeepSeek 峰谷时段与 V4.1-Flash 2026 年 9 月发布,均以官方定价页为准;V4.1-Flash 激活参数另经 NVIDIA HF 官方模型卡与 vLLM 官方文档双源核对)
- Silicon Data 指数(10-09)
- Nebius 提价公告
- 信通院算力规模
- EIA 电价
- o1 定价(OpenAI 官方公告,2024-09-12)
- Llama 3.1 405B 发布日期(Meta 官方博客,2024-07-23)
- H800/H100 整机采购合同价(莲花科创公告、中国电信集采公示转录)
权威转录(B 级):
- 算力租赁专家会与产业调研(新浪财经、晨涧云、SMM 日报)
- H100/B300 租金指数(SemiAnalysis)
- B300 价格时间线(快科技、雷锋网、EET-China,多源交叉)
- 硅基流动财务(融资披露,经铅笔道)
- Anthropic/博通招股书口径(Reuters)
- State of AI Report 2026
- Gemini 2.5 Flash token 用量实测(Artificial Analysis 2025-05,17 倍=推理模式开启对上一代非推理模型)
本文推算(D 级,假设随附):
- 火山 MaaS 隐含收入与实现价:2025 年对外计费 1944 万亿 × 49.5% ≈ 960 万亿(口径构成为本文推断)→ 2026 年外部量 × 10 → 0.96 亿亿 → 150-250 亿元 → 隐含 1.6-2.6 元/百万;反推 2025 年为 3-5 元。“价格减半”由两个假设推出,不是独立验证。
- 中国装机隐含利用率:每 token 2N 次运算;49B 激活、解码利用率 15% × 负载 70% 的口径下,日产约 200 万亿;对 FP16/FP8 敏感。
- 万卡集群电耗:按整机 10 千瓦 × 1250 台 × PUE 1.0-1.3 自算,为 1.1-1.4 亿度。媒体流传的“年耗电 6 亿度”与这组假设不一致,正文不采用。
- H100/B300 全成本与 IRR:按月度现金流折现,假设满租、残值记零,不含空置、税费与融资成本。
- 前沿 API 加权实现价:峰时调用量占比按 30-45% 假设。
- Anthropic 10 GW 开支:按每 GW 每年约百亿美元租用成本量级估算。
- 价格斜率年化:按三年半窗口计为约 4-5 倍,对窗口选择敏感。
已知薄弱点:
- 10 月国内 B300 月租 22-28 万元是趋势带(7 月调研 25 万元,加上多源预测),不是当日实际读数。
- B300 1300-1450 万元是渠道口头报价,真实成交量不可考,文中按“高位报价带”处理。
- “固定任务篮”没有系统数据,密度通胀只能用间接证据论证;OpenAI 的 320 倍主要反映推理模型普及。
- OpenAI 9 月“逼近 700 亿”未经确认,且已有修正报道,正文以 8 月的 400 亿为准。
- GPT-4 级质量的价格匹配存在口径主观性,倍数按行业通行做法(固定基准能力)计为 1/150~1/300 区间。
- 火山 MaaS 推算的收入端是管理层目标,不是已实现收入;“翻五倍”可以理解为乘以 5 或乘以 6。
- 阿里“AI 模型与应用”年化指引(300 亿元)与“AI 相关产品收入”(6 月季度单季 124 亿元)口径不同,对应关系待核。