
——把正确性验证做成可复现的路径
摘要:迁移后的程序持续输出、延迟正常,不代表语义正确。本文讨论两类盲区,并给出一条验收路径:
- 结构错误:张量形状相同、函数正常返回,仍可能每一对都配错(RoPE 公开案例);
- 运行身份:你以为在跑的代码和实际在跑的代码,可能不是同一份(编译缓存的签名链);
- 验收方法:先分清正常误差与语义错误——数值比较带容差,语义不变量精确检查;再做三层检查(算子数值、固定 Token 序列、任务质量)与五步路径(固定基线、算子对照、序列定位、任务回归、环境核对)。
这条链走完,才谈得上「验证过正确」。
前四篇都在谈性能,涉及资源、布局、通信和注意力。这一篇谈一个更隐蔽的问题:一切看起来都在正常运行时,怎样发现迁移其实已经出了错?反过来,两个实现的结果不完全相等时,又怎样判断这是正常误差还是真正的错误?
部署失败有两种。一种很容易发现:程序报错,栈信息直接指向问题。另一种很难发现:程序持续输出,延迟也正常,但某个数据布局、位置编码或缩放处理是错的。模型在「带病工作」,输出看起来像模像样,质量却已经悄悄下降。这类失败之所以危险,是因为常规监控只看延迟和吞吐。这些数字一切正常,出错的只有语义。
一、盲区之一:同样的 RoPE,不同的配对
这不是假设。DeepSeek-V3.2-Exp 在 2025 年 11 月 17 日的更新说明中披露,此前的推理示例里,indexer 的 RoPE 存在实现差异:indexer 要求非交错布局,而 MLA 模块使用交错布局。这个问题可能影响模型表现,随后已经修复(DeepSeek-V3.2-Exp 仓库)。
用一个可以手算的例子看清「配对不同」。 两种布局下,RoPE 的数学形式完全相同:把 q、k 向量的分量两两配成一对,按位置旋转。区别只在于哪些分量配成一对。
取一个 4 分量向量 [1, 2, 3, 4],为了演示,把每一对都旋转 90°。这里只演示配对规则,不是模型真实使用的 RoPE 频率。
| 布局 | 配对方式 | 旋转 90° 后的输出 |
|---|---|---|
| 交错 | 相邻分量配对:(1,2) 与 (3,4) | [−2, 1, −4, 3] |
| 非交错 | 前后两半配对:(1,3) 与 (2,4) | [−3, −4, 1, 2] |
两个输出形状相同,平方和都是 30,各个分量却完全不同。如果把按交错布局排列的数据交给按非交错布局实现的 RoPE,函数照样正常返回,输出也仍是「看起来做过位置编码」的有限值。但每一对旋转的都是配错的分量。
形状校验、NaN 检查、简单问答,都可能照常通过。而用固定输入构造上面这样的对照,就能直接查出这种结构错位。构造对照时要避开全零、全部相等、位置为零这类退化输入,因为它们恰好会掩盖差异。
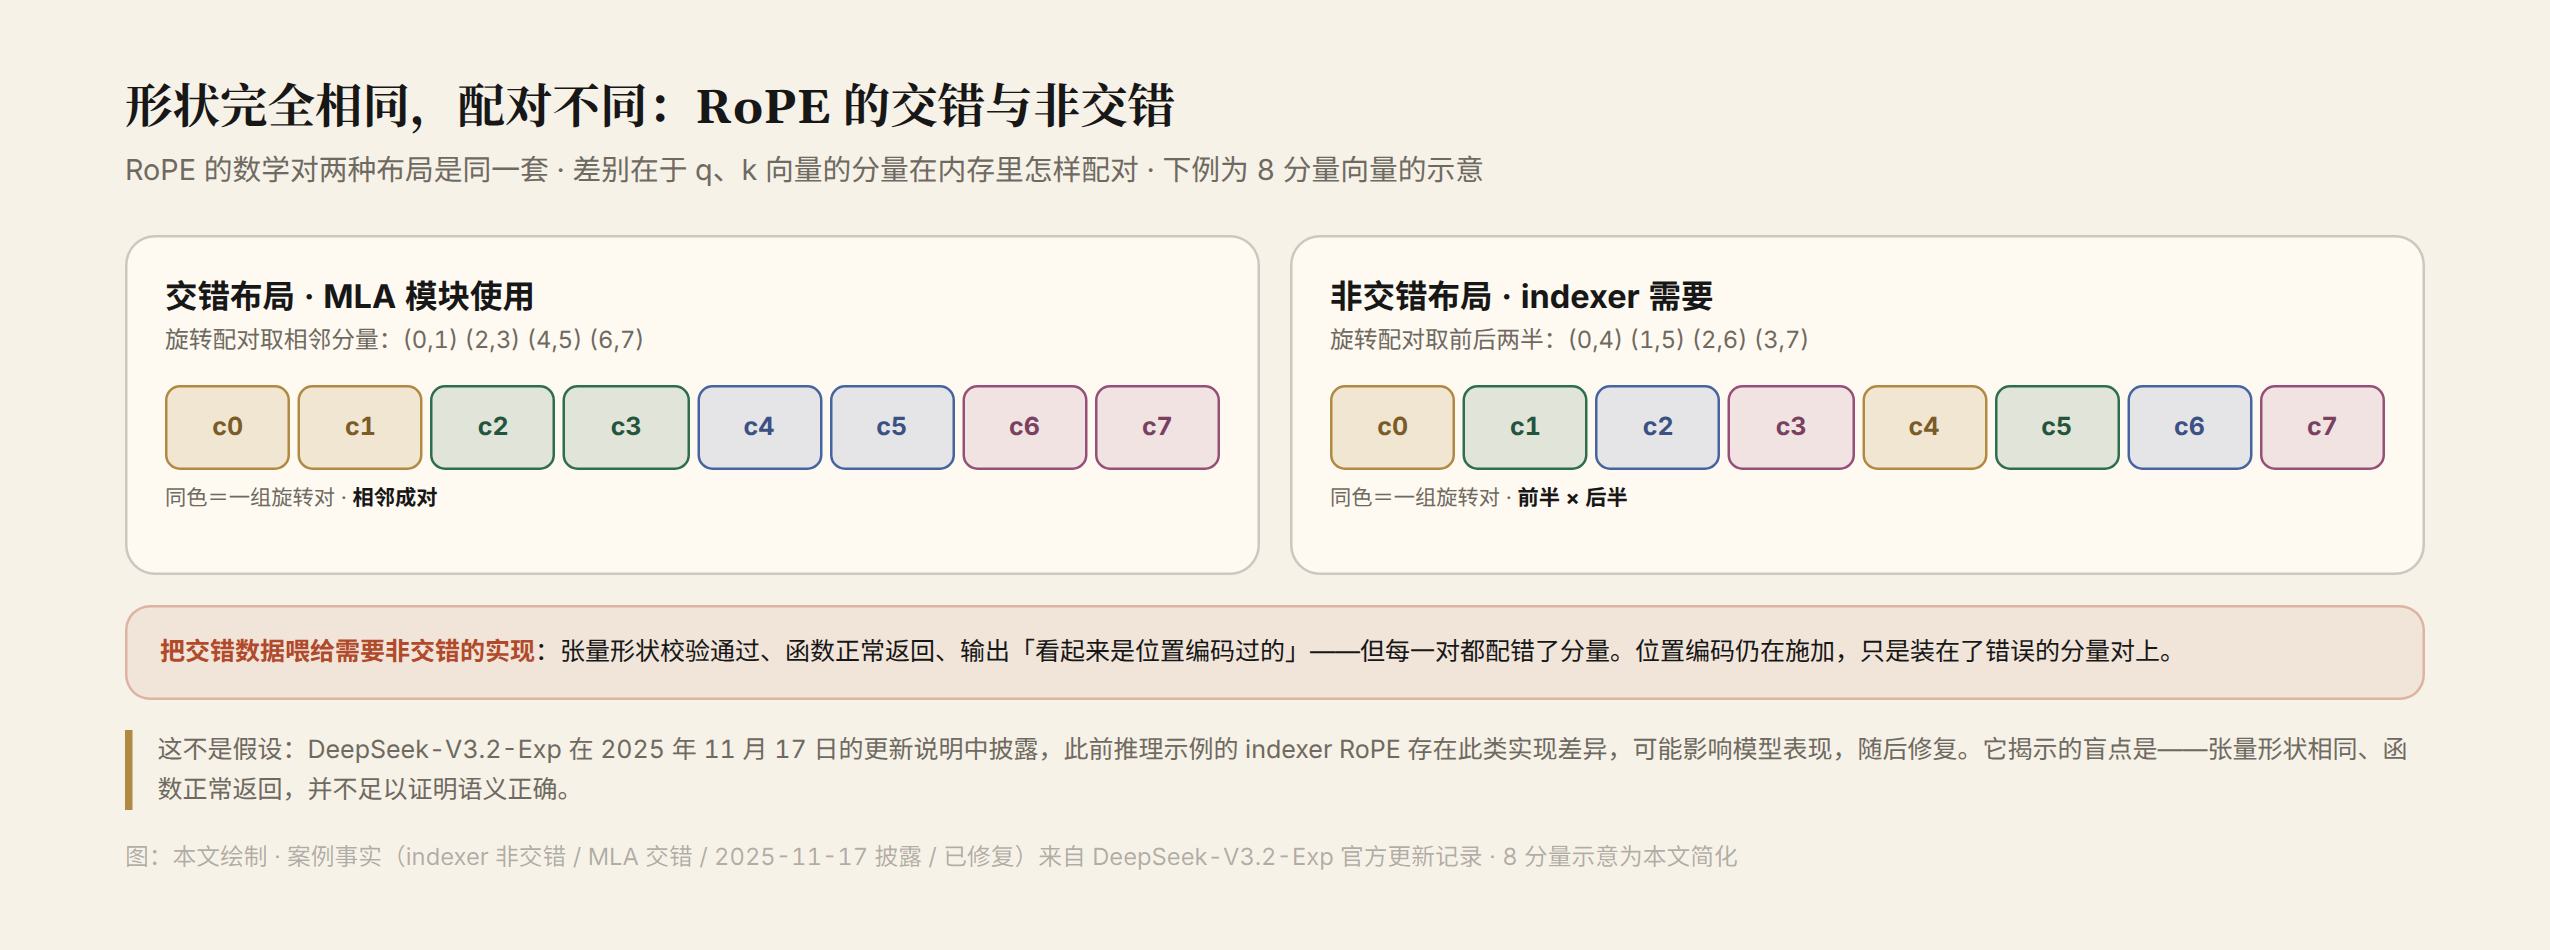
这个案例的价值不在于「项目曾经有 bug」,所有活跃的工程都修过 bug。它的价值在于标出了迁移验收的一个盲区:张量形状相同、函数正常返回,都不足以证明语义正确。 要在验收时查出这类问题,可以用的正是上面这种基于固定输入的构造性对照。官方更新记录只交代了问题内容、影响以及已经修复,问题是怎样发现的,公开材料没有提到。
二、先分清要找的是什么:正常误差与语义错误
迁移前后的结果一定会有数值差异,不能一看到差异就判定出错。有两类差异来源是可以预期的:
- 精度配置。 同一个算子走 FP8/FP4 路径,或者用不同的累加精度,本来就会有相应幅度的误差。第四篇中为了保证精度而关闭 HF32 的回填矩阵乘,就是一个显式取舍的例子:精度要求改变了执行路径,也改变了代价。
- 归约与调度顺序。 分布式归并、分块累加的顺序不同,浮点结果的低位就会不同。DeepGEMM 甚至提供了确定性算法开关,可见项目本身就把「相同输入是否产生相同输出」当作一个可以配置的性质。
与之相对的是语义错误,例如:
- 配对规则错误(第一节的案例);
- 布局转换的方向用反(MN-major 的方向见第二篇);
- 缩放因子的应用位置或次数错误;
- 读取索引时的偏移错误。
提高精度纠正不了错误的配对规则,因为精度再高,算的也还是同一个错位。所以,区分这两类问题要靠结构检查和能拉开差异的输入,不能只看「误差是否随精度提高而缩小」。
同时也要注意,能解释来源,不等于可以接受。 FP8/FP4 和归约顺序带来的偏差,同样必须落在任务约定的数值容差和质量容差之内。不能因为「低精度本来就有误差」,就接受任意大小的偏差。
区分了这两类问题,验收方法也随之不同:
- 数值比较要带容差,容差由精度配置决定。具体数值来自该精度路径与参考实现之间实测的离散范围,不存在一个处处适用的统一阈值。
- 语义不变量要精确检查。 配对约定、布局方向、索引偏移、缩放次数,只有对和错两种结果。
这次开源恰好提供了现成的参照:DeepGEMM 的测试用 aclnn 参考实现交叉验证对应的 GEMM;DeepEP 的测试覆盖了专家对齐为 1 和 128 等情形,并检查专家区间和填充区域是否正确。DeepEP 的这两项检查查的就是结构不变量,而不只是数值。
三、三层检查:各自覆盖什么范围
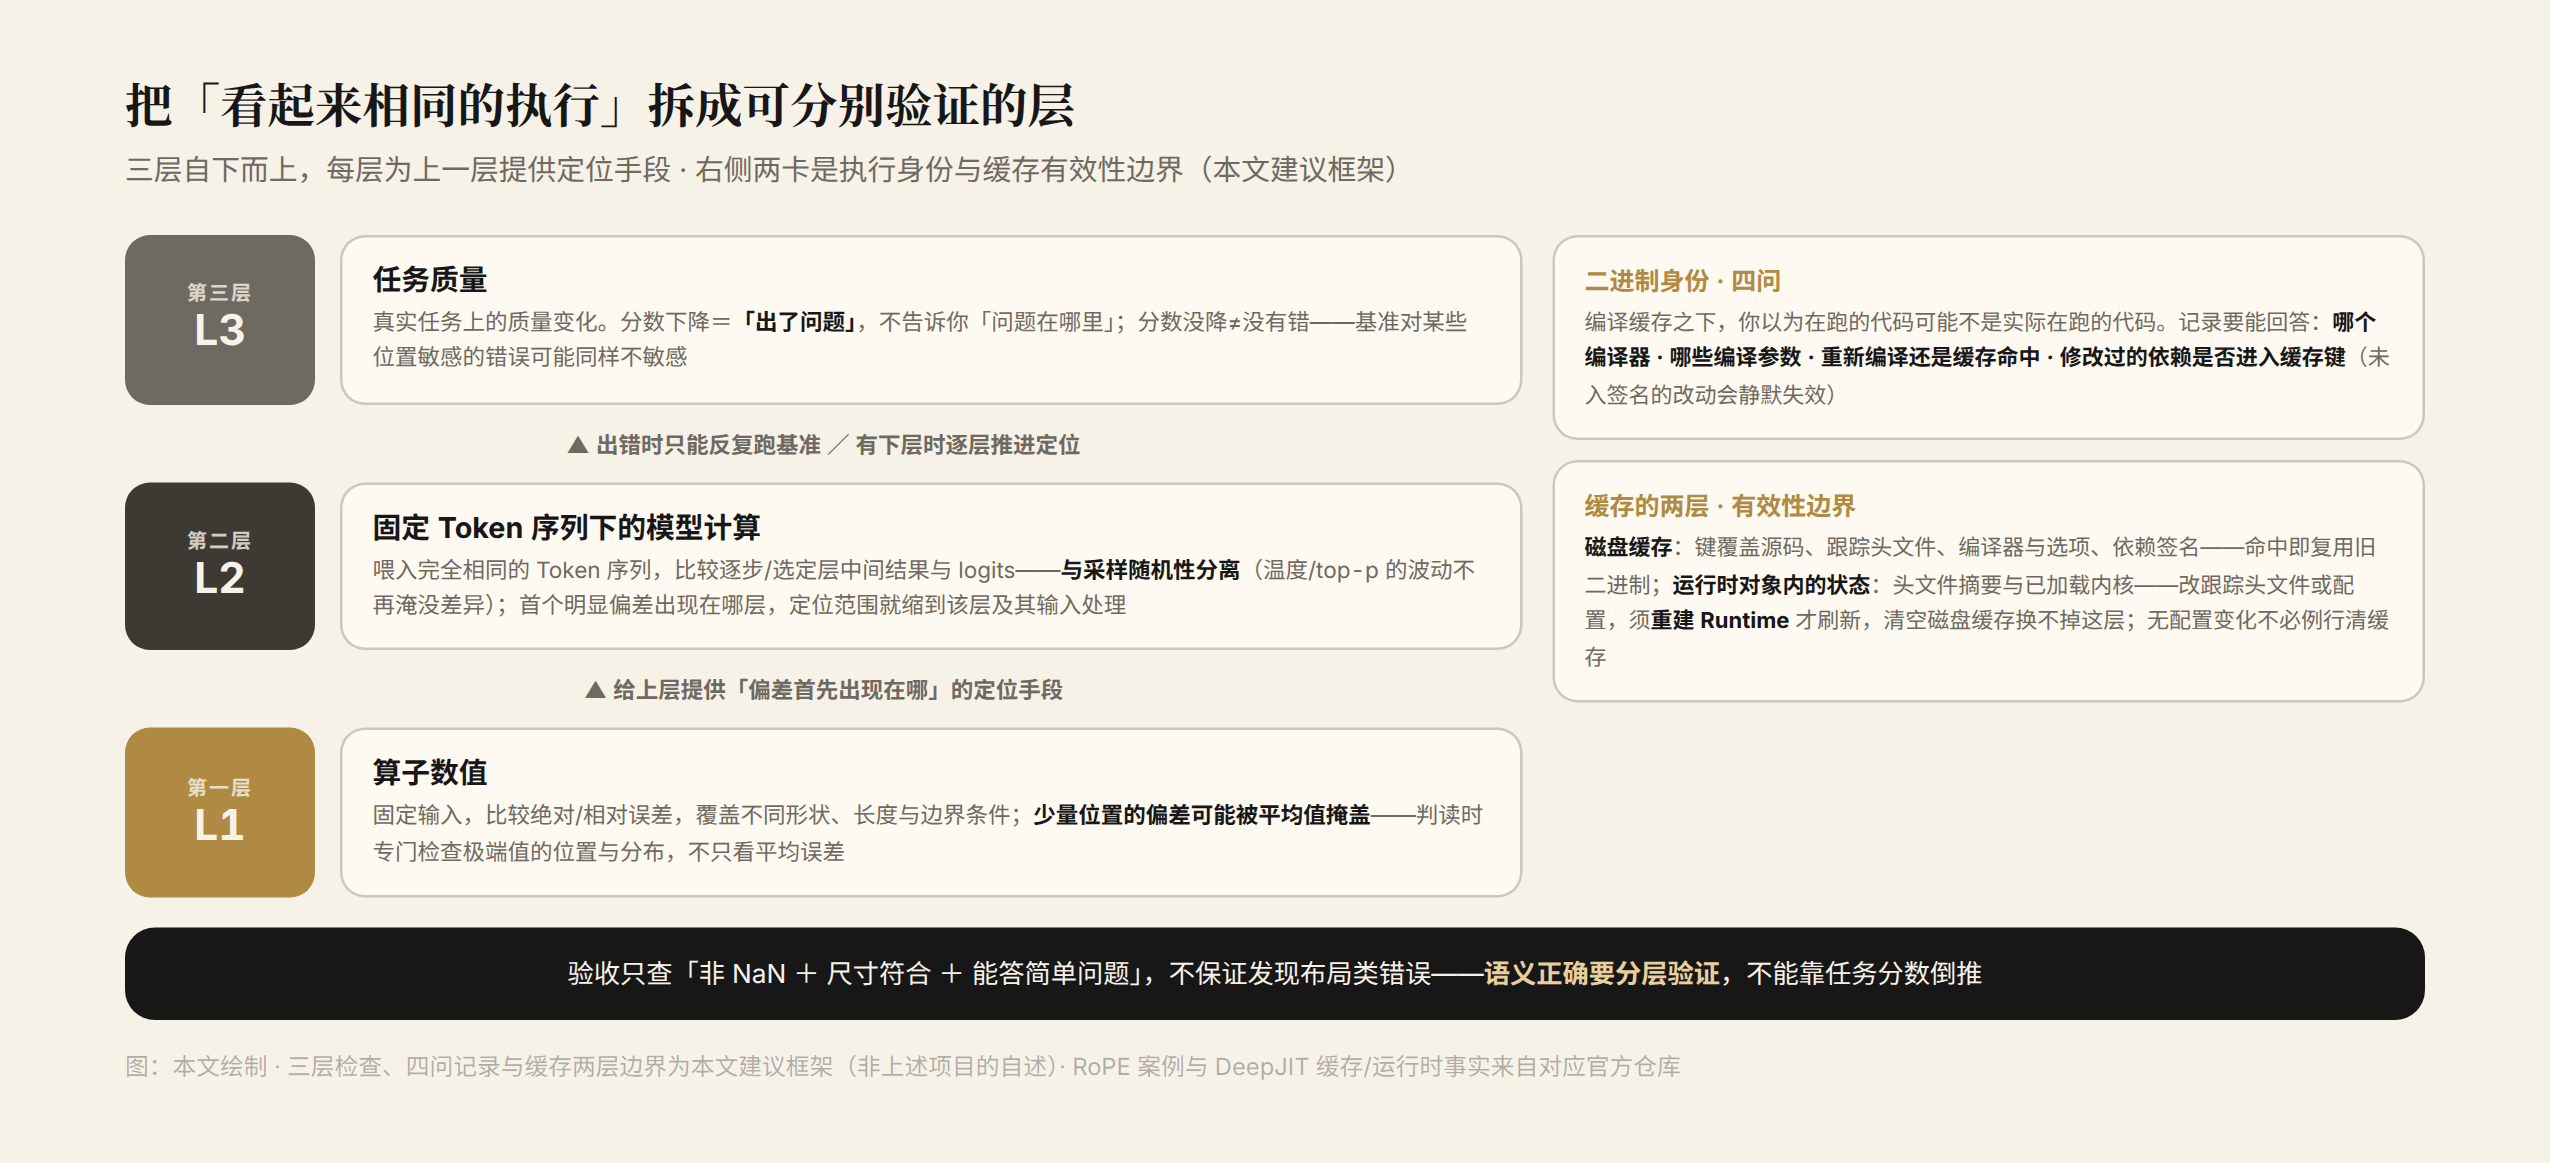
在上述区分的基础上,正确性检查分为三层,每层覆盖不同的范围。
第一层:算子数值。 用固定输入比较参考实现和目标实现的绝对误差与相对误差,覆盖不同的形状、长度和边界条件。少数位置上的偏差可能被平均值掩盖,因此判读时要专门查看极端值出现在哪里、如何分布。
第二层:固定 Token 序列下的模型计算。 给两个实现输入完全相同的 Token 序列,逐步、逐层比较中间结果和 logits。固定输入可以把问题和采样的随机性分开,温度采样、top-p 带来的正常波动不再淹没真正的信号。第一处明显偏差出现在哪一层,排查范围就能从「整个模型」缩小到这一层及其输入处理。第一节的 RoPE 差异正是会在这一层暴露的问题,因为它总是错在特定模块的特定位置。
第三层:任务质量。 也就是真实任务上的分数变化。它能告诉你「可能出了问题」,却不能告诉你「问题在哪里」。分数没有下降也不代表没有错。有些评测任务根本没有覆盖能暴露这类位置编码错误的行为,分数自然不会变化。
四、盲区之二:编译缓存的签名链
正确性还有一个隐蔽的来源:你以为正在运行的代码,和实际运行的代码,可能不是同一份。
DeepJIT 的运行时路径。 这条路径可以直接对照源码核实(提交 3732a3b9 的 runtime.hpp):
- 构造运行时(Runtime):收集应用提供的依赖签名和编译器信息;
compile:合并编译选项,计算缓存键;- 查找缓存:先查已加载的内存缓存,再查磁盘缓存;都没有命中,才调用后端编译,把产物写入缓存,然后加载;
launch:使用合并后的启动选项。
CUDA 和昇腾共用这套模板,各自的设备源码和后端选项不同。
缓存键覆盖哪些内容。 缓存键覆盖源码、被跟踪的头文件、编译器版本、生效的编译选项和依赖签名。关键在于「被跟踪」这三个字:
- 头文件解析器只跟踪用尖括号引入、且路径与配置前缀匹配的 include;用引号引入的 include 会被拒绝。
- 隐式输入不会自动进入签名,比如 CUDA 场景下的
NVCC_PREPEND_FLAGS、CPATH和宿主编译器的选择。这些必须由调用方通过显式依赖签名提供。
真正会静默漏掉的是第三种情况:与配置前缀不匹配的尖括号 include,编译器接受它,解析器却不跟踪它。于是就会出现一种和第一节同类的静默失败:修改了这样一个头文件,它没有进入签名,缓存依然命中修改前的二进制。这次修改等于没有生效。
缓存还有一层内存状态。 README 写得很明确:被跟踪头文件的摘要会在运行时的整个生命周期内缓存。修改了已跟踪的头文件,要重建运行时才会重新计算摘要;清空磁盘缓存,也替换不了已经加载的内核和解析器缓存。
配置在运行时构造时拍下快照并生效。之后要改配置,需要重新构造运行时、更新跟踪范围或补充依赖签名,不能直接修改配置就算完事。这一层状态跟着运行时对象走,而不以进程为边界:在同一进程里重建运行时就能刷新;配置没有变化时,也不需要例行清空缓存。
由此得出核对二进制身份的四个问题:
- 用的是哪个编译器?
- 生效的是哪些编译选项?
- 这次是重新编译,还是命中了缓存?
- 修改过的依赖,是否进入了签名?
五、收束成一条可复现的验证路径
把前几节合在一起,针对这批组件可以写出一条能逐步执行的验收路径,而不只是一份注意事项清单。
第一步:固定基线。 选定参考实现及其版本,可以是 aclnn 参考实现、上游参考内核,或者迁移前的实现。同时记录执行环境:编译器和编译选项、缓存是否命中、确定性开关的设置,以及各个库的环境变量实际生效的值。
第二步:算子层对照。
- 按第二篇的布局约定,逐项验证转换的输出。缩放因子布局转换是否正确,本身就是一项要测的内容。
- 参照 DeepEP 测试的做法,检查分发区间和填充区域。
- 注意力和矩阵乘按精度配置设定容差,并针对边界形状追加测试。
- 语义不变量(配对、方向、偏移、次数)逐项精确比对;数值项则对照该精度路径实测的离散范围,判断是否在容差之内。
第三步:序列层定位。 固定 Token 序列,逐层比对中间结果和 logits。第一处明显偏差会把排查范围缩小到这一层及其输入处理,再回到第二步,针对这两处补充测试。注意,偏差出现在哪一层,不等于根因就在哪一层,也可能是这一层的输入已经错了。
第四步:任务层回归。 跑固定的评测集,把它当作回归指标,而不是定位手段。固定任务也可能因为评测和采样而出现波动,所以要记录重复测量的波动范围和允许误差:
- 能用已知精度路径解释的差异,归为「已解释」;
- 解释不了且影响质量的差异,保留为未解决问题,不要强行归类。
第五步:核对环境身份。 每次升级或修改依赖,都重新回答第四节的四个问题。配置变化后,除了隔离或清空缓存目录,还要确认运行时已经重建,因为清空磁盘替换不了内存中的内核和摘要缓存。DeepGEMM 和 DeepEP 各有自己的环境变量前缀(DG_JIT_、EP_JIT_,未设置时回退到 DJ_JIT_;两家 README 均写明这一回退规则)。多个库同时使用时,要分别确认每个组件的缓存状态。
这条路径的每一步,都能用上这批开源项目自带的资源:参考实现、结构化测试和缓存元数据,使用者不必从零设计验收方法。但这条路径不会自己运行起来,把它真正跑通,是负责迁移的一方要做的工作。
区分误差类型、做完三层检查、核对签名、记录环境,这条链全部走完,才谈得上「验证过正确」。下一篇转向经济账:吞吐提高了 20%,为什么总成本反而可能上升?
资料与计算说明:本文依据各项目的公开仓库和文档撰写,资料核验截至 2026 年 10 月 7 日。
- indexer RoPE 布局差异(要求非交错,MLA 使用交错,2025 年 11 月 17 日的更新说明,已修复)来自 V3.2-Exp 的官方更新记录,问题如何被发现不在公开材料之中。
- DeepJIT 的运行时路径依据提交
3732a3b9中的runtime.hpp。头文件解析规则(尖括号且前缀匹配才跟踪、引号 include 被拒绝、前缀不匹配的尖括号 include 被编译器接受但不被解析器跟踪)、隐式输入不会被自动发现,以及「头文件摘要在运行时生命周期内缓存,修改被跟踪的头文件需重建运行时」,来自 DeepJIT README。 - DeepGEMM 的 aclnn 交叉验证和确定性开关、DeepEP 测试对专家区间和填充区域的检查,来自各自的 README;
DG_JIT_/EP_JIT_回退到DJ_JIT_的规则同样来自各自 README。 - 4 分量旋转 90° 的对照([1,2,3,4] → [−2,1,−4,3]/[−3,−4,1,2],平方和均为 30)是本文构造的示意算例,只用来演示配对规则。
- 三层检查、四个问题和五步验证路径是本文整理的方法框架,不是上述项目的原有表述。容差须依据精度配置和参考实现的实测离散范围确定。
本文没有做硬件实测。本文是「DeepSeek 昇腾开源系列」的第五篇。