
——从内核吞吐到服务容量,再到有效产出
摘要:比较性能的单位,不是设备每秒处理多少 Token,而是相同业务约束下每单位成本完成的有效工作。
- 内核吞吐不等于服务容量:同一配置下 token 数 64→256,MegaMoE 吞吐从 266 升到 659 TFLOPS;
- 成本可能反转:本文构造的算例中,B 资源成本低 20%、原始吞吐高 20%,按有效产出算,单位成本反而高约 5.6%;打平线约在达标占比 63.3%;
- 账要算全:一次性投入与周期性维护进入回收期,各篇的技术选择分别落在不同的成本项上。
前五篇算的是技术账,涉及资源、布局、通信、注意力和正确性。这一篇算经济账,并把技术选择放回服务目标里衡量。算账之前要先解决两个问题:用什么单位来比较?「吞吐」这个词在不同层面上又分别指什么?
先给出结论:比较性能的单位不是设备每秒处理多少 Token,而是在相同的业务约束下,每单位成本完成多少有效工作。
一、先对齐指标的定义
比较之前,先确认双方量的是同一件事。以 vLLM 基准文档给出的客户端测量定义为例:
- TTFT:从发出请求到收到第一段流式输出的时间;
- TPOT:按单个请求计算、不计首个 Token 的平均每 Token 延迟;
- ITL:相邻两段流式输出之间的间隔。
这三个指标都叫「延迟」,但统计窗口和排除项各不相同。如果一段流式输出包含多个 Token,ITL 和 TPOT 就不能互相替代。vLLM 文档自己也提醒过:不同基准工具的指标术语没有统一标准,比较时要看测量点和计算公式,不能只看名字。
二、内核吞吐不等于服务容量
更深一层的问题在于:这些指标衡量的是服务层的结果,而请求要经过一层转换,才会变成算子实际处理的形状。
- 请求长度决定 prefill 的计算量和 KV 的体积;
- 到达过程决定排队情况和突发程度;
- 组批与专家路由决定矩阵乘输入的行数。对一个固定的模型层来说,N 和 K 由这一层的特征维度和矩阵定义决定,不随请求数量变化;组批和路由真正改变的是输入的行数,在 MoE 场景下就是每个专家组收到的 m_i。第二篇已经算过,行数会直接影响内核能达到的吞吐。
- KV 缓存容量决定系统还能不能接收新请求。
所以,内核吞吐是在固定形状下测出的数字;服务容量则要在给定的请求长度、到达过程、调度和缓存条件下,做端到端测量。 批次内外的相互影响、排队、调度、KV 容量和缓存,都会让服务容量偏离由内核数字简单加权得到的结果。
这不是抽象的推论。在 MegaMoE 的官方基准中,配置保持不变(96 个专家、隐藏维度 7168),只把 token 数从 64 提高到 256,计算吞吐就从 266 TFLOPS 升到 659 TFLOPS(见 DeepGEMM README,该表未标注精度配置)。可见内核的「吞吐」本身就随 token 数量变化。把内核峰值当作服务容量,等于假设服务的形状永远停在测基准的那一个点上。
三、成本反转与打平线
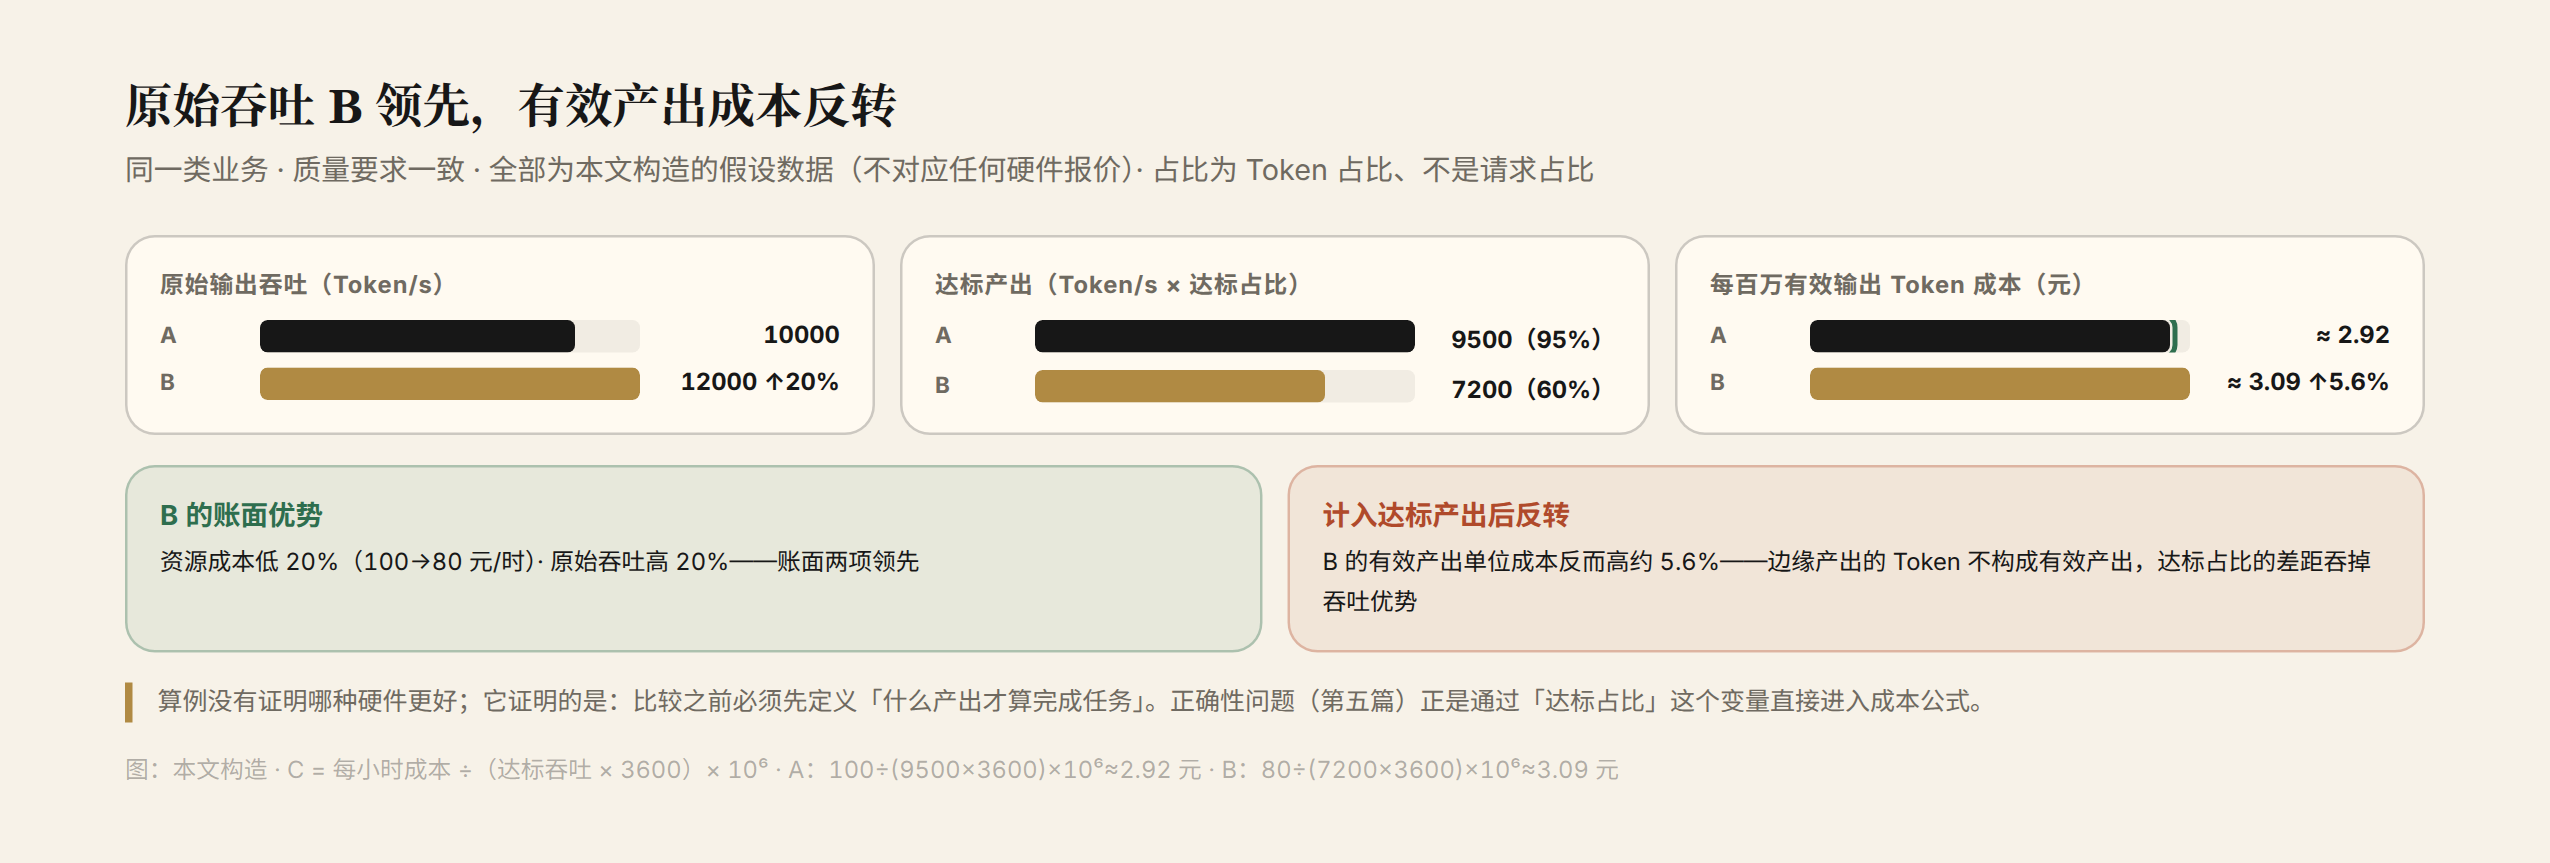
定义清楚之后,就可以算总账了。以下数据全部是假设的,不对应任何硬件报价。假设两个方案处理同一类业务,质量要求相同:
| 项目 | 方案 A | 方案 B |
|---|---|---|
| 每小时总运行成本 | 100 元 | 80 元 |
| 原始输出吞吐 | 10,000 Token/s | 12,000 Token/s |
| 来自达标请求的 Token 占比 | 95% | 60% |
先定义「达标」。 一个请求只有同时满足任务的质量要求和预设的延迟要求,才算达标。把达标请求输出的 Token 数加总,再除以同一段观测时长,就得到达标产出(下文称「有效产出」)。失败和超时的请求同样消耗资源,要计入运行费用和请求统计,不能因为没有达标就不算。
需要说明两点:
- 这里按 Token 加权计算有效产出,和基准工具中按请求数统计的 goodput 不是同一个量。
- 表中第三行是 Token 占比,不是请求占比。请求长度不同时,两种占比不能随意换算。质量阈值按任务约定确定,没有统一的默认值。
再算账。 只看前两行,B 更便宜,吞吐还高 20%。加上第三行,两个方案的有效产出分别是 Q_A = 9,500 Token/s,Q_B = 7,200 Token/s。每百万有效 Token 的运行成本为:
- C_A = 100 ÷ (9,500 × 3,600) × 10⁶ ≈ 2.92 元
- C_B = 80 ÷ (7,200 × 3,600) × 10⁶ ≈ 3.09 元
结论反转了:B 的资源成本低 20%,原始吞吐高 20%,按有效产出算的单位运行成本却高了约 5.6%。
这个例子并不能说明哪种硬件更好,因为数字是构造出来的。它说明的是:比较之前,必须先定义什么样的产出才算完成任务。第五篇讨论的正确性问题,正是通过「达标占比」这个变量直接进入了成本公式。
打平线。 这个算例还可以再推一步。保持 A 的成本和达标占比不变,要让 B 的单位成本和 A 相等,B 的有效产出需要达到 80 × 9,500 ÷ 100 = 7,600 Token/s,也就是原始吞吐 12,000 Token/s 的约 63.3%。所以 63.3% 就是本例的打平线:
- 恰好达到 63.3%,只是打平;超过它,B 才有单位运行成本上的优势。
- 这条线比较的只是运行成本,不包括一次性投入。
- 它会随两个方案的成本比和吞吐比变化,换一组报价就要重新计算。
四、从单点数字到负载曲线
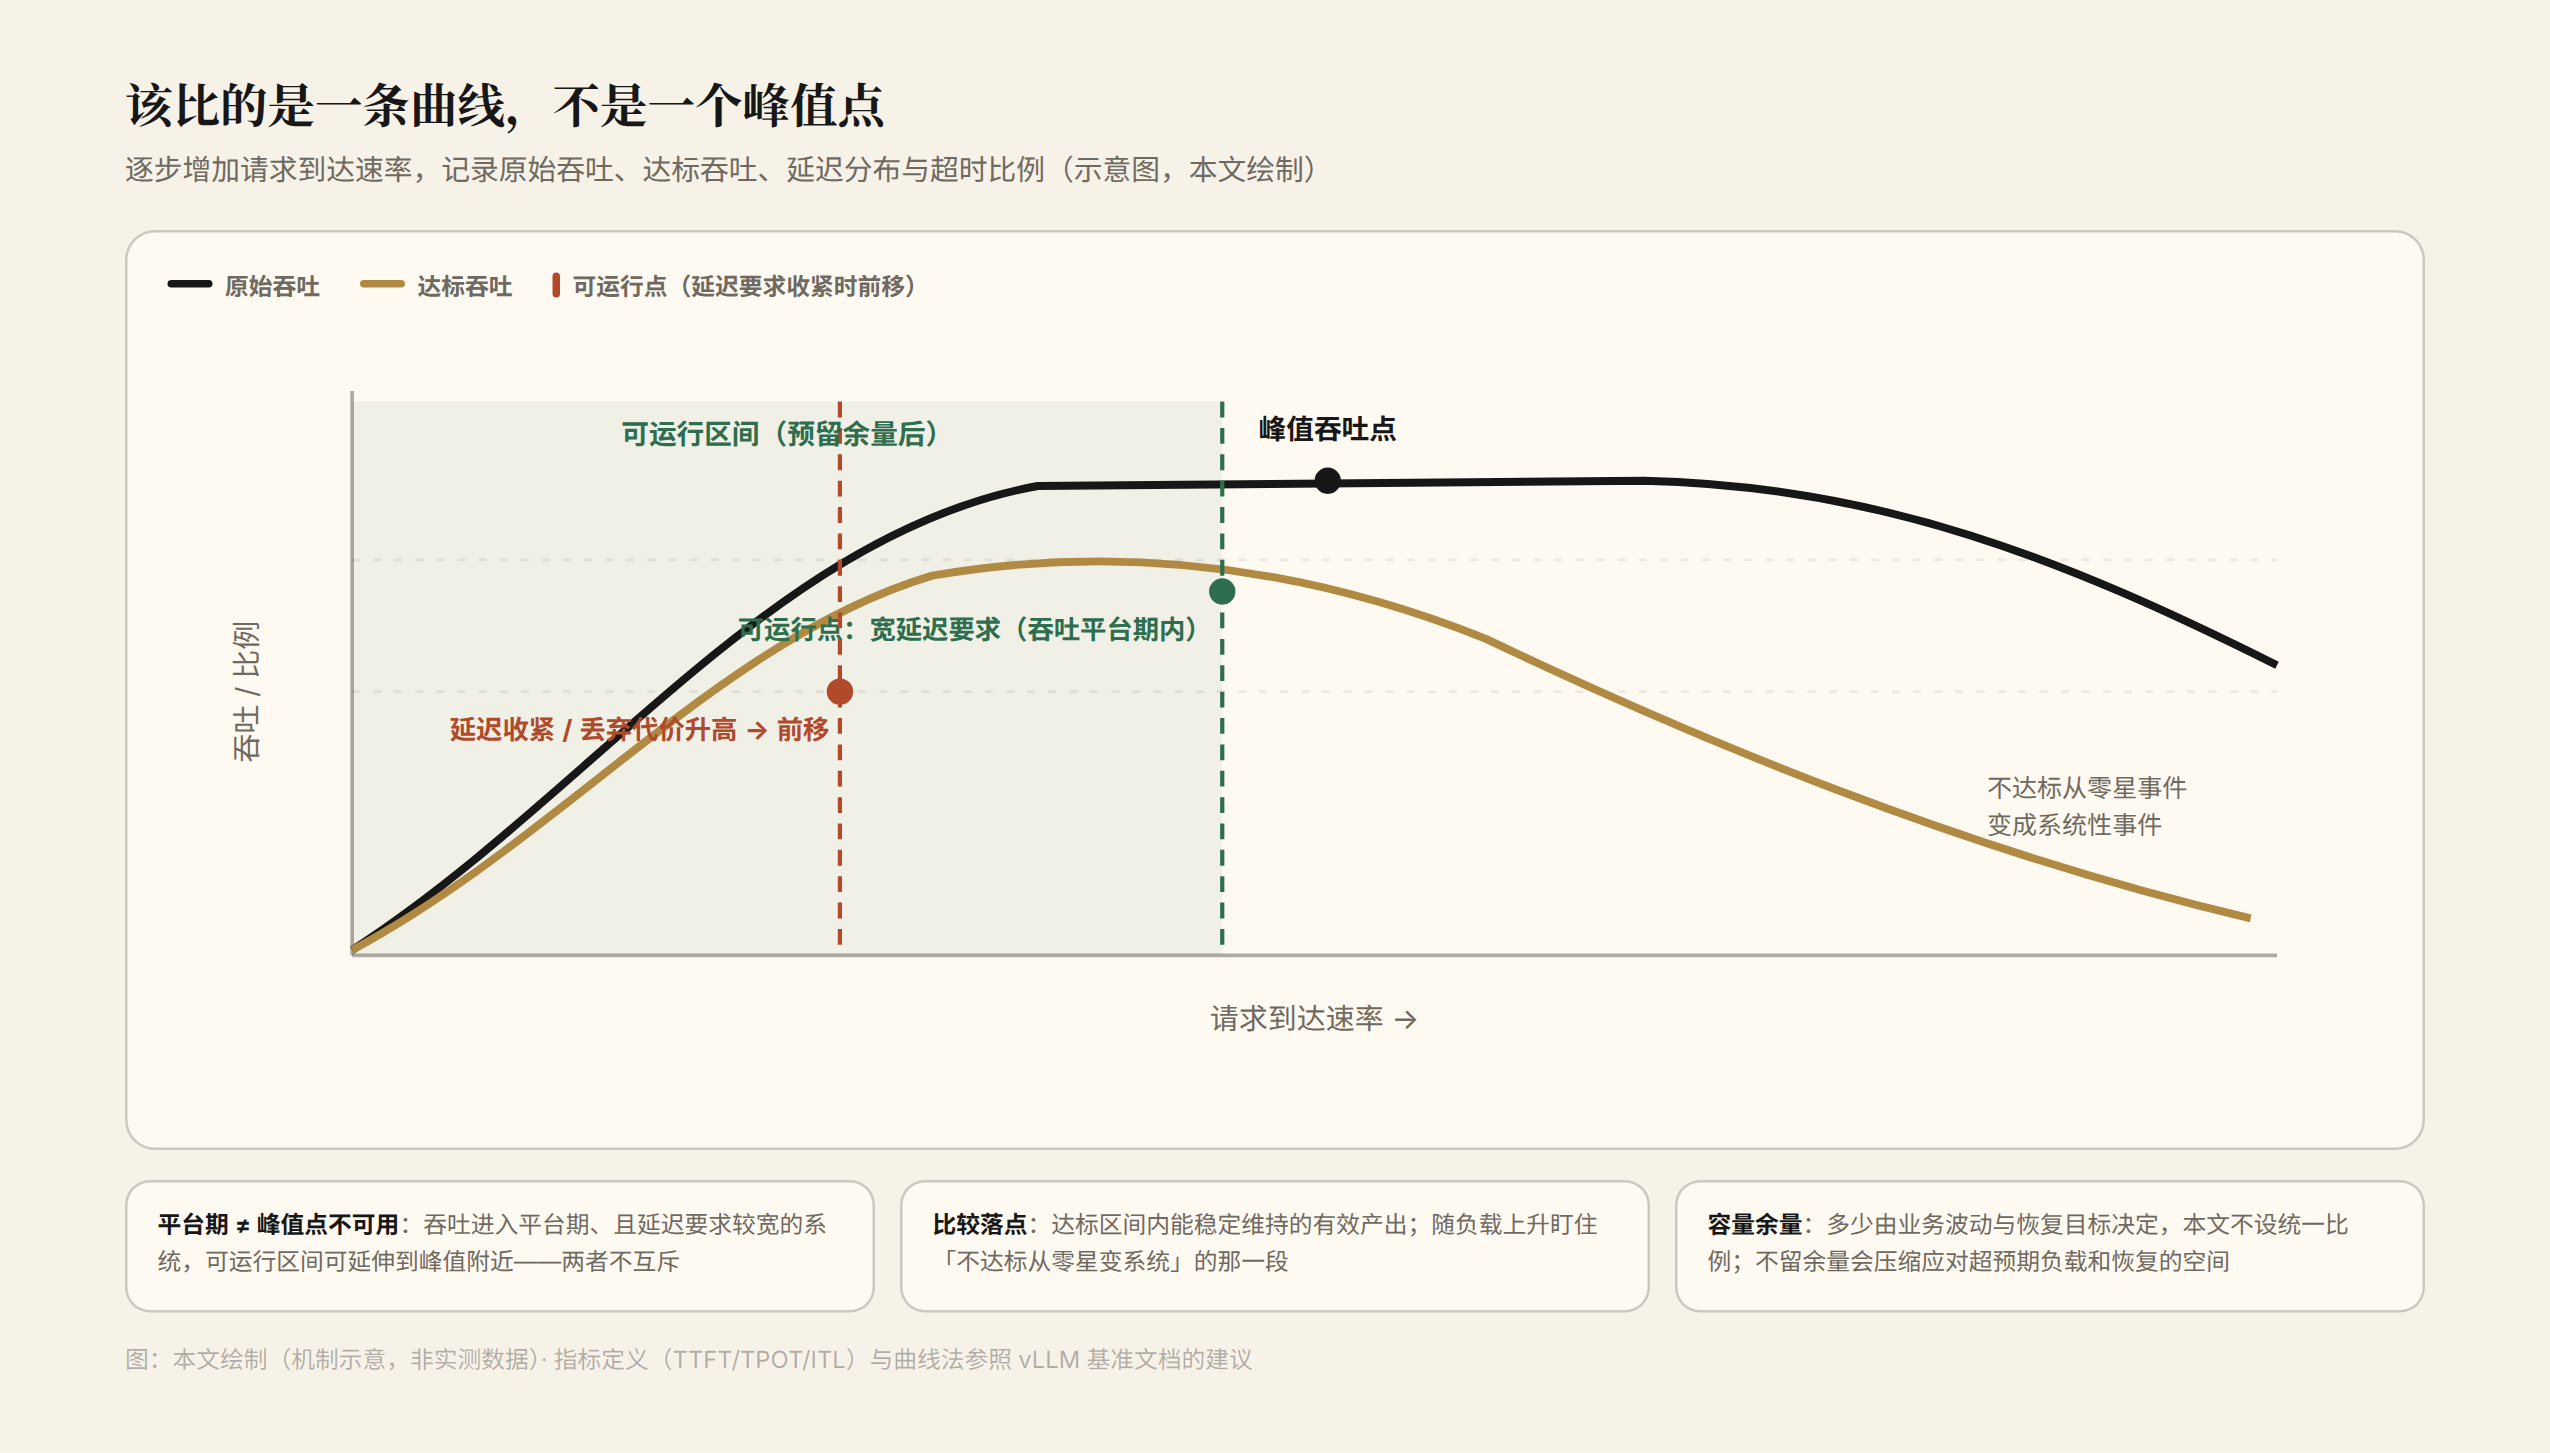
上面的算例用的是单点数字,真实的比较对象应该是一条负载曲线。而「负载」本身要先用工具参数定义清楚。vLLM 基准文档中相关参数的语义如下:
--request-rate:取有限值时,表示受控的到达负载,默认按泊松过程到达;取inf时表示全量并发压测。两者测的不是同一件事,评估容量要用有限速率。--burstiness:只在有限速率下生效,用 Gamma 分布调节到达的波动程度。取 1.0 时就是普通的泊松过程,小于 1.0 更突发,大于 1.0 更均匀。
怎样画曲线。 逐步提高到达速率,每一档都记录原始吞吐、达标吞吐、TTFT 和生成延迟的分布,以及超时和失败的比例。重点观察不达标的请求从零星出现变成成批出现的那一段。真正要比较的,是在达标范围内能够稳定维持的有效产出。
别漏掉客户端排队。 --max-concurrency 限制的是客户端同时在途的请求数,用来模拟背压,但它也会把排队转移到客户端:请求先在客户端等待并发名额,发出之后服务端可能很快就响应。这时如果只看请求发出后的 TTFT,就会漏掉这段等待时间。文档为此提供了两个指标:
client_queue_time:请求在客户端等待并发名额的时间;e2el_including_client_queue:在有限速率下,从到达计划中该请求本应开始的时刻算起的端到端时长,包含客户端排队。
比较曲线时,要把这两项一起列进表里。否则两个方案的「TTFT 相近」,可能只是其中一个把等待藏在了客户端。这是关于测量语义的说明,不是对某个具体系统的实测结论。
可运行点定在哪里,是业务决策,不是工程上的默认值。 如果系统的吞吐已经进入平台期,而延迟要求比较宽松,可运行范围可以一直延伸到峰值附近;如果延迟要求收紧,或者丢弃请求的代价变高,可运行点就要往前移。余量要按业务的波动幅度和恢复目标来定,没有统一的比例。不留余量,会压缩系统吸收突发和从故障中恢复的空间。波动既可以靠容量吸收,也可以用短时排队来换取,但这两种办法都有极限。
五、可比的前提:一致性与缓存
比较曲线时要守住两项一致性:
- 工作负载一致:使用同一组请求,保持相同的顺序和前缀分布,采用同一种缓存策略(要么都从清空状态开始,要么都预热到各自的稳定状态)。双方都是冷启动,并不自动意味着可比,因为同一次运行内部也可能命中公共前缀。要控制的是这些变量本身,而不是只写一句「冷启动」或「热缓存」。
- 指标定义和计时窗口一致:冷缓存和热缓存的数字、不同精度配置下的数字,不能混在同一张表里。
缓存需要单独处理。 vLLM 文档明确提醒,对同一个服务器反复跑基准,可能会复用前缀缓存,从而抬高测得的吞吐。正确的做法不是一律关掉缓存,而是分两次评估:
- 受控对照:双方在相同的缓存条件下比较,找出实现本身的差异;
- 业务回放:保留真实业务中的重复前缀分布,评估缓存对业务的实际收益。
一个主要做重复文档问答的系统,和一个提示几乎从不重复的系统,不应该采用同样的缓存命中假设。把前者的吞吐拿去论证后者的采购,就是把别人的前缀复用收益算成了自己的。
六、运行成本之外:一次性投入与周期性维护
经济账还有一半常常被漏掉:那些不出现在每小时账单上的投入。它们分为两类:
- 一次性投入:首次迁移适配(布局转换、流水线重排、接口对接)和首次验收(也就是第五篇那条验证路径的工作量)。
- 周期性维护投入:版本升级后的组合回归(见第七篇)、日常运维和故障损失。这类投入按实际发生的周期,计入该周期的总成本或净节省。它既不能和一次性投入重复计算,也不能当成付一次就结束的费用。
回收期的算法。
- 回收期 = 一次性投入 ÷ 每周期净节省
- 每周期净节省 = 两方案的运行成本之差 − 两方案的额外维护成本之差(摊到该周期)
计算的前提是:任务量相同、达标要求相同、时间窗口可比。已经计入运行成本的费用,不能再从维护成本差里重复扣除。净节省必须为正:如果新方案在这组条件下的净节省为零或为负,比如运行成本更高、有效产出却更低,那么它就无法收回一次性投入。本文只给出计算框架,不填具体数字。代入真实报价和负载,结论自然就出来了。
前几篇的技术选择分别影响哪一项成本:
- 第二篇的布局转换:如果发生在每一层的激活上,就要计入每个请求的运行时间;
- 第三篇的填充与重叠质量:决定相同带宽下能得到多少有效吞吐;
- 第四篇的供给线——KV 数据从设备内存进入 Cube 核的搬运与转换路径:决定注意力的时延和能达到的批量;
- 第五篇的验证路径:既是一次性投入,又通过达标占比影响运行成本;
- 第七篇的版本升级:每次升级都要重新投入一轮回归测试。
结语
这套比较方法不指向任何具体硬件的优劣,它改变的是我们该问的问题:
- 内核吞吐随形状变化;
- 服务容量必须在给定条件下做端到端测量;
- 采购方案要比较的,是在给定负载和达标条件下,每单位有效产出的运行成本,以及一次性投入能否收回、多久收回。
第七篇(也是全系列最后一篇)把视角再抬高一层:怎样判断这一波开源建立起来的生态,是在真正积累,还是只停留在发布?
资料与计算说明:本文依据 vLLM 公开文档、DeepGEMM README 和本文构造的算例撰写,资料核验截至 2026 年 10 月 7 日。
- TTFT、TPOT、ITL 的定义,前缀缓存的提醒,「指标术语未统一、须比较测量点和公式」的提醒,以及
--request-rate、--burstiness、--max-concurrency、client_queue_time和e2el_including_client_queue(含 schedule-relative 语义)的说明,均来自 vLLM 基准文档(stable 版页面;文档本身未标注版本号,字段名以该版为准)。 - MegaMoE 同一配置下的两组数据(96 个专家、隐藏维度 7168,token 数从 64 增至 256,吞吐从 266.4 TFLOPS 增至 659.2 TFLOPS)来自 DeepGEMM README,属于官方成绩,该表未标注精度配置,不能据此推算其他形状下的表现。
- 第三节的算例和打平线推算(100 元与 80 元,10,000 与 12,000 Token/s,95% 与 60%,2.92 元与 3.09 元,约 5.6%,约 63.3%,约 7,600 Token/s)是本文构造的数据和代数推算,不对应任何硬件报价。
- 达标 Token 的定义、一次性投入与周期性投入的划分,以及回收期框架,是本文提出的判断框架。本文不给出具体的回收数字。
本文没有做硬件实测。本文是「DeepSeek 昇腾开源系列」的第六篇。