
——逐项拆开 95% 背后的设计取舍
摘要:FlashMLA 官方公布的 410/360 TFLOPS,是在各自声明的负载条件下测得的稀疏注意力成绩。成绩背后有三类性质不同的安排:
- 少算:稀疏选择减少每个查询要计算的注意力项。本文按 2,048/131,072 的设定推算。
- 少搬:在片上分块计算并累加结果,减少中间结果在显存和片上存储之间的往返。在线 softmax 的状态就保存在这一层。
- 排紧:执行流水决定这些工作完成得多快,具体包括每核 64 头分组、1C2V 配比,以及经 UB 中转的数据供给线。
三类安排各自减少一类工作,也各有适用条件。换一种输入形状后,性能不能凭峰值利用率推断。
FlashMLA 官方公布的成绩是:Prefill 最高 410 TFLOPS,Decoding 最高 360 TFLOPS,分别达到硬件峰值的 95% 和 83%(README 与昇腾技术报告)。
百分比本身能说明的有限。它表明计算资源用得很充分,却没有说明实现为此做了哪些安排。本篇沿着官方技术报告的决策链逐步展开(昇腾 Prefill 深度报告)。起点是算法要维护什么状态,然后依次看四个设计问题如何得到回答:
- 每个 AI Core 处理多少个头;
- 输出累加器放在哪里;
- 配几个向量核;
- 数据走哪条路进入 Cube 核。
最后看这些决定如何组成一条流水线。走完这条链,「快」就不只是一个数字了。
一、起点:算法本身要维护什么
这个内核计算的是 DeepSeek Sparse Attention(DSA)的前向。它按一张索引表,让每个 q token 只关注「最重要」的那部分 KV 位置。对单个 q token,计算分四步:
- 按索引取出 KV,得到
gathered_kv; - 计算得分 P = QKᵀ;
- 计算 S = softmax(P ×
sm_scale); - 计算 out = S·V。
先认识后文反复出现的几个部件。
- AI Core:昇腾芯片上的计算单元。每个 AI Core 有一个 Cube 核负责矩阵乘,还有向量核负责逐元素计算并协助搬运数据。
- L1:数据进入 Cube 核之前的输入缓冲。
- L0C:Cube 核一侧专用的累加缓冲。
- UB(统一缓冲):位于向量核一侧。
- MTE2:把数据从设备内存读入片上的搬运通路。
- FixPipe:把 L0C 中的结果搬到 UB 的专用通路。
第五节的供给线图会画出完整的数据通路。本节只用到一个事实:L0C 中的结果必须经 FixPipe 才能搬出。
在线 softmax:分块处理,同时维护全局状态。 softmax 需要整行数据才能算出,而 KV 是分块处理的,每块包含 B_TOPK 个选中位置(通常为 64 或 96)。因此实现采用和 FlashAttention 同源的在线 softmax,全程维护四个状态,全部为 float32:
running_max:行最大值;running_max_for_softmax:缩放时使用的参考最大值;running_sumexp:指数和;out_accum:输出累加器。
最终输出按累计的指数和归一化。
skip-scale:不到阈值就不重算尺度。 重缩放有一个触发阈值。只有当真实最大值与当前缩放所用参考最大值之差超过阈值(内核中通常取 6)时,才重新计算尺度。原因是旧的累计量是在旧参考最大值下得到的,要乘以 exp(旧参考最大值 − 新最大值) 才能和新尺度对齐。如果没有触发,就跳过这次重缩放,当前块的指数和、SV 乘法和输出累加照常进行。这个做法叫 skip-scale。
这个技巧在 NPU 上收益尤其大,原因后面会反复出现。如果输出累加器放在 Cube 核一侧的 L0C,缩放就不能原地完成,必须先经 FixPipe 搬到 UB,再由向量核做乘加。每次重缩放都要走这条通路。第三节会看到,最终设计正因如此把累加器固定放在 UB。
跳过重缩放,省下的不只是计算,还有 FixPipe、UB 和向量核的带宽,以及功耗。功耗降下来,频率才能提上去。算法层面的一个判断,直接改变了执行层面要消耗的资源。
二、每核多少个头:64 这个数字从哪里来
第一个设计问题是:每个 AI Core 处理多少个 q 头?报告给出了一个可以直接跟着算的模型。
- 算力侧:Cube 核满载时,每核每周期完成 4096 次 FMA。
- 访存侧:L2 总带宽 5 TB/s,除以 32 个核和 1650 MHz 主频,折合每核每周期约 95 字节。
设头数为 h_q,选中位置数为 topk,维度 d = 512。按一个头组算完单个 q token 的全部选中位置,两类周期分别为:
矩阵计算周期 ≈ h_q × topk × 2d ÷ 4096
              (一次 QKᵀ 加一次 SV)

数据搬运周期 ≈ (h_q × d × 4 + topk × d × 2) ÷ 每核每周期字节数(约 95)
              (读 Q、写输出各按 2 字节计,KV 只读一次)
这里的周期数是整段选中位置的总量。第一节的 B_TOPK 只是循环分块的大小。
代入四档头数(访存周期按未取整的约 94.7 字节/周期计算):
| h_q | topk | 计算周期 | 访存周期 |
|---|---|---|---|
| 16 | 512 | 2,048 | 5,883 |
| 32 | 1024 | 8,192 | 11,765 |
| 64 | 1024 | 16,384 | 12,457 |
| 128 | 1024 | 32,768 | 13,841 |
注:报告原文给出每个头数在 topk=512 与 topk=1024 两档下的完整数据;本表第一行取 512 档,其余三行取 1024 档,数字均为报告原值,跨行比较只用于看趋势。
规律很清楚:
- 少于 64 头:访存周期明显多于计算周期,内核受带宽限制;
- 64 头:计算周期已经超过访存周期(16,384 对 12,457),两者比较接近,转折就发生在 64 附近;
- 超过 64 头:计算周期越来越多地超过访存周期,耗时越来越由计算决定。
那为什么不用 128 头? 有两个硬件事实挡住了:
- L0C 放不下。 128 头的输出累加矩阵为 128 × 512 × 4 字节 = 256 KB,会单独占满 L0C。累加器只能移到向量核一侧,同时需要两个向量核配合,执行「搬一段、累加一段」的细粒度流水。报告直言,这种流水非常难写。
- 吞吐不会更高。 微基准测试显示,矩阵乘指令(MMAD)的行数达到 64 就足以让 Cube 核满载,128 头带不来更高的吞吐。
于是 64 头成了设计点:它正好落在访存与计算的转折附近,也恰好是 Cube 核开始满载的位置。
三、累加器放在哪里:L0C 不能原地乘标量
在线 softmax 直接引出了下一个设计问题:输出累加器放在哪里?这里碰到一条硬件约束:L0C 中的数据只能经 FixPipe 搬出,或者被 Cube 核当作累加器使用,不能原地乘以一个标量。 而重缩放要做的,恰恰是给已经累积的输出乘一个因子。
报告比较了两种方案:
- 方案一:累加器固定放在向量核一侧的 UB。 Cube 核每块算出的部分结果暂存在 L0C,需要时经 FixPipe 搬到 UB,加到 UB 中的累加器上。
- 方案二:累加器留在 Cube 核一侧。 需要缩放时,把累加结果经 FixPipe 搬到向量核一侧,乘以缩放因子,再放回 Cube 核。放回这一步要借助一次「乘单位矩阵」的矩阵乘。
方案二的代价可以精确算出。放回的那一步是一次 64×64×512 的 float 矩阵乘。出于精度要求必须关闭 HF32,此时 Cube 核每周期只能做 256 次 FMA,这一步要花 8,192 个周期——按本文换算,相当于一个块主计算(约 1024 周期)的 8 倍,完全不可接受。注意,这里的每周期 256 次 FMA 是关闭 HF32 后 float 矩阵乘的吞吐,和第二节主矩阵计算每周期 4096 次 FMA 的满载不是同一种负载,两者不能直接比较。
最终选择了方案一:累加器放在 UB。
回头看第一节,skip-scale 省掉的正是「FixPipe 搬出加向量累加」这条路。两项设计在这里汇合。算法上少触发一次重缩放,硬件上就少一次搬运和累加。而累加器固定放在 UB,又让那些必须发生的重缩放不再需要把结果放回 Cube 核。
四、为什么需要两个向量核:三处资源各自不够用
昇腾 950 的每个 AI Core 有一个 Cube 核和两个向量核。如果内核只用一个向量核(1C1V),另一个就可以去运行模型中的其他模块或做跨设备通信,整机 MFU 会更好看。报告否定了这个方案。三处资源各自不够用,每一处都单独构成理由:
其一,MTE2 的发射队列。 单个向量核同时在途的 MTE2 拷贝请求最多 16 条。即使用上第五节讲的 gather2 合并请求,也只有 32 个 token 在途。这个内核需要逐 token 稀疏读取,32 个远远不够。
其二,反量化。 解码阶段要把 FP8/FP4 的 KV 缓存解成 bfloat16,再交给 Cube 核。微基准测试显示,单个向量核的反量化速度跟不上 Cube 核的消耗速度。
其三,FixPipe。 只用一个向量核时,FixPipe 每核每周期只能搬 128 字节。64 头时,每块的矩阵乘周期为 B_TOPK × 16,FixPipe 搬运周期为 1024 + B_TOPK × 2。要让 FixPipe 不成为瓶颈,需要 B_TOPK > 73.14。取 96 或 128 虽然满足条件,却会让本来就紧张的 UB 更拥挤,还会加重第一条的队列问题。
三条理由指向同一个结论:采用 1C2V,由两个向量核分担 MTE2 发射、反量化、FixPipe 搬出和 softmax。这并不是「多配了一个核」,而是供给线上多处瓶颈共同决定的配比。
五、供给线:数据走哪条路进入 Cube 核
需要的部件前面都已出现,现在把它们连成完整的通路。
问题:布局不匹配。 KV 在设备内存中按 ND 布局存放,Cube 核却要求 NZ(分形)布局。通常的做法是在数据从设备内存进入 L1 的路上顺便完成转换。但这个内核的 KV 按索引逐 token 稀疏搬运,没法在搬运途中做转换。
被否决的捷径。 报告试过一条捷径:把单个 token(512 个 bfloat16)拆成 32 个 32 字节的块,直接拷进 L1。但 AI Core 中负责发起访存的 BIU 单元,只有在源地址和目的地址都连续时才会合并访问。目的端按 B_TOPK × 32B 的跨距排布,地址不连续,L2 带宽利用率因此过低,瓶颈马上转到了 L2。
最终路径:经 UB 中转。
设备内存(ND)─ MTE2 稀疏读取 → UB(向量核反量化,SIMD 向量核做 ND→NZ)
            ─ MTE3 → L1 → Cube 核 → L0C ─ FixPipe → UB

这条路上有几项专门针对「逐 token 稀疏」的优化:
- gather2。 如果每个 token 单独发一条 MTE2 请求,很快就会超出 16 条的队列深度。因此把请求的
burst_count设为 2,源跨距设为两个 token 起始地址之差,一条请求就能搬两个 token。拷贝参数由 SIMD 向量核实时计算,不会阻塞标量核。 - 解码阶段的 KV 布局。 旧版 FlashMLA 的 KV 块把所有 token 的数据放在前面,所有 scale 放在后面,每个 token 需要两次 MTE2。这个内核把每个 token 的数据和 scale 相邻存放,一次就能拷完。
- ND→NZ 转换本身。 用 loadalign 读取、按跨距写入来完成转换;输出缓冲多留一行,避免 UB bank 冲突;用自增指针消除地址更新开销;一次处理相邻的 256 字节对,让所有 bank 同时工作。报告称,这一转换最终达到了 UB 读写吞吐的峰值。
所以,注意力内核从来不只是两个矩阵乘。QKᵀ、softmax、SV 和输出累加在片上交替进行。Cube 核处理的每一块数据,背后都有一条由读取、缓冲、反量化和布局转换组成的供给线。
六、流水:把等待安排进时间表
到这里,设计方向已经确定:64 头、1C2V、累加器放在 UB、KV 经 UB 中转。最后一层是流水排程,目标只有一个:不让 Cube 核空闲。 Cube 核一侧的基本排程是:
P[i] = Q·K[i]ᵀ → O += S[i−1]·V[i−1] → P[i+1] → O += S[i]·V[i] → …
前一块的 SV 被有意推后。P[i] 在第一步就已算出,却要到第四步才被使用,中间空出约 1024 个周期(按 B_TOPK=64 计,QKᵀ 与 SV 各约 512 周期;取 96 时空档相应更长)。这段时间正好够完成三件事:FixPipe 把 P[i] 从 L0C 搬到 UB,向量核算完 softmax,再把 S[i] 送回 L1。等待并没有消失,而是被安排进了时间表。
向量核一侧的排程更密。 同一时间,它要处理分属五个不同块的工作:
- 读取第 i+5 块的索引;
- 为第 i+3 块做布局转换和 UB→L1 拷贝;
- 为第 i+1 块计算 softmax;
- 为第 i 块缩放输出 O;
- 同步 skip-scale 信号。
复杂度主要来自两个硬件事实:
- skip-scale 的信号由 SIMD 向量核产生,但 SS 缓冲——一块只有标量核能读写的缓冲区,配合跨核标志传递信号——只有标量核能访问。处理不好,就会出现一次阻塞式同步。
- 硬件流水线按顺序发射指令。前面一条向量指令如果因为条件未满足而卡住,整条 PIPE_V 都会跟着停下。
因此,排程要仔细安排每条指令的发射顺序,才能让所有单元都保持忙碌。
还有两个减少空闲的细节:
- 指令缓存很小(Cube 32K、向量核 16K、SIMD 8K,单位 KB)。代码要用硬件循环指令控制体积,并限制内联。
- L1 分为两个 bank。 把张量对半放进两个 bank,就能让两边的带宽同时用满。
七、三种性质不同的改进,各有各的边界
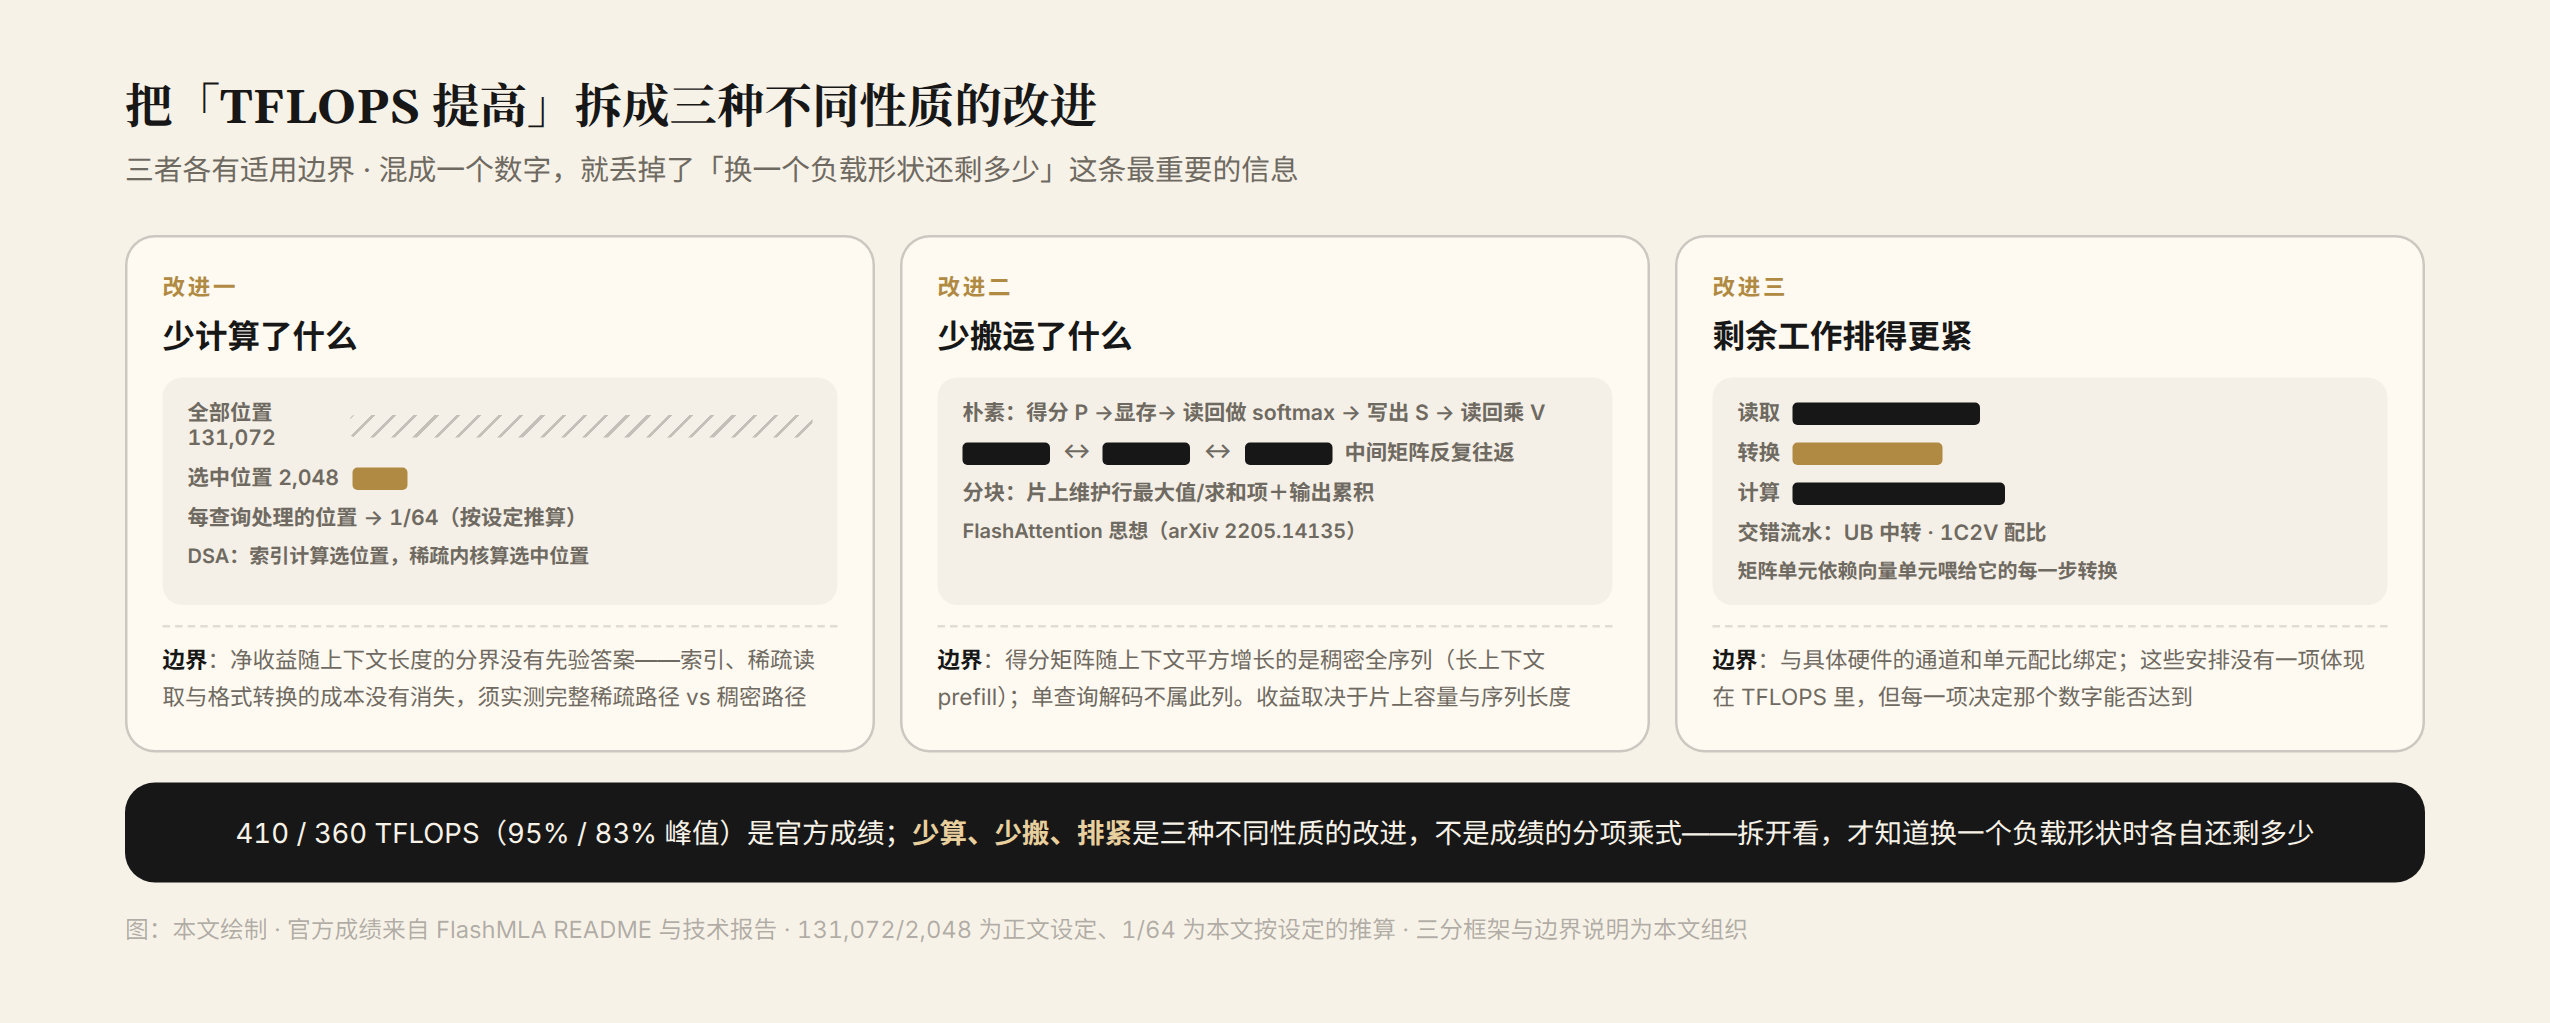
除了成绩本身,还要把三种改进分开来看。
先说明设定。稀疏选择按索引表,把每个查询要处理的位置从 131,072 个减到 2,048 个,即原来的 1/64(本文按此设定推算)。这只是选中位置数的比例,属于算法工作量的设定。410/360 TFLOPS 则是另一回事:它们是官方在各自声明的负载条件下测得的稀疏注意力吞吐(README 标注面向 DeepSeek-V4.1 模型)。工作量的比例不能换算成吞吐的比例,更不代表整体加速了多少。
三种改进各自的作用和边界如下:
- 少算:位置选择。 它减少每个查询要计算的注意力项。实际能省多少时间,还要看索引计算和格式转换的额外开销随上下文长度如何增长。省下的计算减去这些开销,才是净收益,官方数字没有给出这个差值。
- 少搬:分块与片上累积。 第一节的在线 softmax 状态就保存在这一层。中间矩阵不必在设备内存和片上之间来回搬运,数据按块流过片上存储,不需要把整段序列一次装进来。能省下多少往返,取决于片上容量允许的分块大小、序列长度和数据复用情况。
- 排紧:执行流水。 也就是第二至第六节的全部安排。它依赖本文所述的单元配比、通路宽度和队列深度,换一种负载形状就要重新测量。
换一种形状时,这三者不会同步变化。只报告一句「TFLOPS 提高了」,丢掉的正是这部分信息。
下一篇暂时不谈性能,讨论一个更隐蔽的问题:一切看起来都在正常运行时,怎样发现迁移其实已经出了错。
资料与计算说明:本文依据 FlashMLA 的公开仓库和昇腾技术报告撰写,资料核验截至 2026 年 10 月 7 日,并保存了固定版本的副本。410/360 TFLOPS(峰值的 95%/83%)和 V4.1 负载说明来自官方 README,正文展开的全部设计决策来自官方深度报告,第二节周期表为报告原值(报告含每个头数在 topk=512/1024 两档的完整数据,正文表为节选并已注明)。DSA 分为索引和稀疏注意力两部分,这一划分来自 V3.2-Exp 的公开材料。1/64 是本文按 2,048/131,072 的设定推算的;「8,192 周期约等于一个块主计算的 8 倍」为本文按 B_TOPK=64 的换算。本文没有做硬件实测。本文是「DeepSeek 昇腾开源系列」的第四篇。