
——把一次专家并行往返完整走一遍
摘要:衡量 MoE 通信,只看 GB/s 不够,下面四件事要分开测:
- 带宽:官方五档带宽从 EP8 到 EP128 单调下降;
- 填充:在本文构造的算例中,对齐填充让处理的槽位达到有效数据的三倍;
- 负载:同步执行时,一个阶段的耗时取决于最晚完成的设备;
- 重叠:重叠的收益取决于依赖结构和资源争用,要测出这部分收益,需要把设备上的执行流、通信流和主机侧的发起、等待放到同一条时间线上。
四件事各自测清楚,同样的带宽才可能对应一个解释得通的端到端结果。
第二篇讲分组矩阵乘时留了一个问题:最忙专家的 m_i 和等待结构要单独分析。原因很简单:几个阶段需要同步汇合时,整段耗时由最晚完成的设备决定。干活最多的设备不一定最慢,但最慢的那台一定会拖住整段。
本篇离开单颗芯片,沿着 DeepEP-Ascend 的公开接口,把一个 MoE 层里 token 的往返完整走一遍。要回答的问题是:缓冲区何时创建、何时复用、何时销毁,数据在哪一步就位,等待发生在哪里。路径走通以后,再看通信优化的四个观察维度,每个维度就都能对应到具体的步骤。
一、一次往返的完整时序:从路由到归并
一个 MoE 层的往返分三段:
- dispatch:按路由结果把每个 token 的输入分组,发往专家所在的设备;
- 专家计算:专家侧执行分组矩阵乘;
- combine:把加权后的结果归并回原来的请求。
缓冲区:长期存在,一次创建,反复复用。 这三段不是每次临时发起的,而是都围绕一个长期存在的 EPBuffer 组织(DeepEP README):
- 每个专家并行组创建一个缓冲区,跨层、跨 microbatch 复用;
- 构造时要指定每个 rank 的最大 token 容量、隐层维度和 top-k,所有 rank 的容量必须一致;
- 缓冲区池可以用
get_buffer_size_hint规划。全部用完、等待结束后,要显式销毁。
容量为什么必须一致?因为这是 all-to-all 通信,每个 rank 的接收缓冲区都要装得下所有对端按容量上限可能发来的数据。只要有一方低估了容量,另一方按上限发来的数据就会放不下。
dispatch:发起后立即返回。 训练、prefill 和 decode 使用同一组接口。调用 buffer.dispatch 时,传入本 rank 的输入 x、路由结果 topk_idx(固定为 int64)和路由权重,再加上几个决定执行方式的参数:
expert_alignment:要与分组矩阵乘的 token 对齐一致;do_expand:把数据展开成专家侧的布局;do_zero_padding:按对齐粒度补零;do_cpu_sync:专家内核直接使用设备侧计数时可以关掉,省去一次 CPU 同步;async_with_compute_stream与defer_epilogue:让通信相对当前计算流异步执行。
调用会立即返回一个 pending 对象。
标准用法本身就是一种交错调度。 README 给出的标准用法可以概括为:先发起通信,再运行与它无关的计算,等到需要结果时再 wait。 示例中夹在 dispatch 和 wait 之间的是共享专家。后续步骤如下:
- wait 返回收到的输入、路由信息和一个 handle。handle 记录了这次分发的分组与计数结构,训练时反向传播还要复用它。
- 专家侧的分组矩阵乘处理收到的数据,第二篇讲的对齐约定在这一步生效。路由权重
recv_weights也在这条计算路径上应用一次。 - 结果交给
buffer.combine。归并的是已经加权的结果,共享专家的输出作为 bias 一起加入。 - 再次 wait,得到最终输出。
一次往返的时序因此是:
路由 → dispatch(异步)→〔共享专家等无关计算〕→ wait(取得输入与 handle)
     → 分组 GEMM(乘路由权重)→ combine(异步,归并已加权结果,bias = 共享专家输出)
     → wait → 输出
把这条时序和第一篇的组件图对照,就能看出接口设计的用意。dispatch 和 combine 都可以先发起、后等待,中间的空档由使用者安排没有依赖关系的计算。handle 保存这次分发的路由关系,供 combine 和反向传播使用。所以通信和计算不是简单的「先通信、后计算」,而是一组可以交错执行的操作,由 wait 的时机明确控制。
二、issue、drain、epilogue:计时和等待的边界
官方带宽表注明:计时包含 issue 和 drain,不包含最后的 epilogue(DeepEP README)。这三个词对应三段工作:
- issue:提交通信内核;
- drain:完成数据搬运;
- epilogue:收尾工作。按官方实现,
defer_epilogue会把「主机等待接收计数」和「拷贝收尾」一起推迟到事件等待时执行,推迟的不只是一个计算内核。
设备侧的等待由 wait() 负责。 它让当前流等待已记录的事件,并把收尾工作排进当前流,这条流上的后续算子按顺序读取结果即可。这个依赖只对当前流有效。它能保证本流的后续算子按顺序读到结果,但不代表 CPU 已经等完了所有设备工作。另一条流如果要用这些数据,需要先做跨流同步。
主机侧的等待是另一回事。 do_cpu_sync 只负责把接收计数同步回 CPU,和上面的流依赖不是同一种等待。这个开关什么时候值得关掉,见本节末尾。
这条边界对测量和工程实现都有影响。
对测量的影响。 带宽数字不包含 epilogue。如果用通信数据量除以表中带宽来估算整层时延,就会漏掉收尾工作和等待时间。比较两个实现时,必须核对双方的计时各自覆盖哪些阶段,例如是否计入了收尾。这和第六篇讨论的指标定义是同一类问题。
对工程实现的影响。 先看缓冲区。只要还有未完成的操作,缓冲区就不能调整大小、复用或销毁。复用同一块缓冲区的前提,是它上一次承载的通信已经全部完成。如果不同层的通信同时在进行,应该给它们各自独立的存储并分别管理生命周期,而不是靠调整 wait 的先后顺序提前腾出同一块缓冲区。
再看 handle 在不同阶段的复用。handle 记录了这次分发的路由与计数结构,combine 和反向传播都要用到它。一个训练步中 handle 会被复用多次,每次复用前,它对应的那次通信必须已经完成。哪个操作先 wait、哪个后 wait,要按这个要求安排。
do_cpu_sync 把同样的思路用在了计数上。默认情况下,各专家收到的 token 计数会同步回 CPU。如果专家内核直接使用设备侧计数,这一步就可以关掉,主机不必为了知道「每个专家收到多少行」专门做一次同步。开关虽小,但省掉了流水线上的一次停顿。
三、四个观察维度:路径走通之后再看
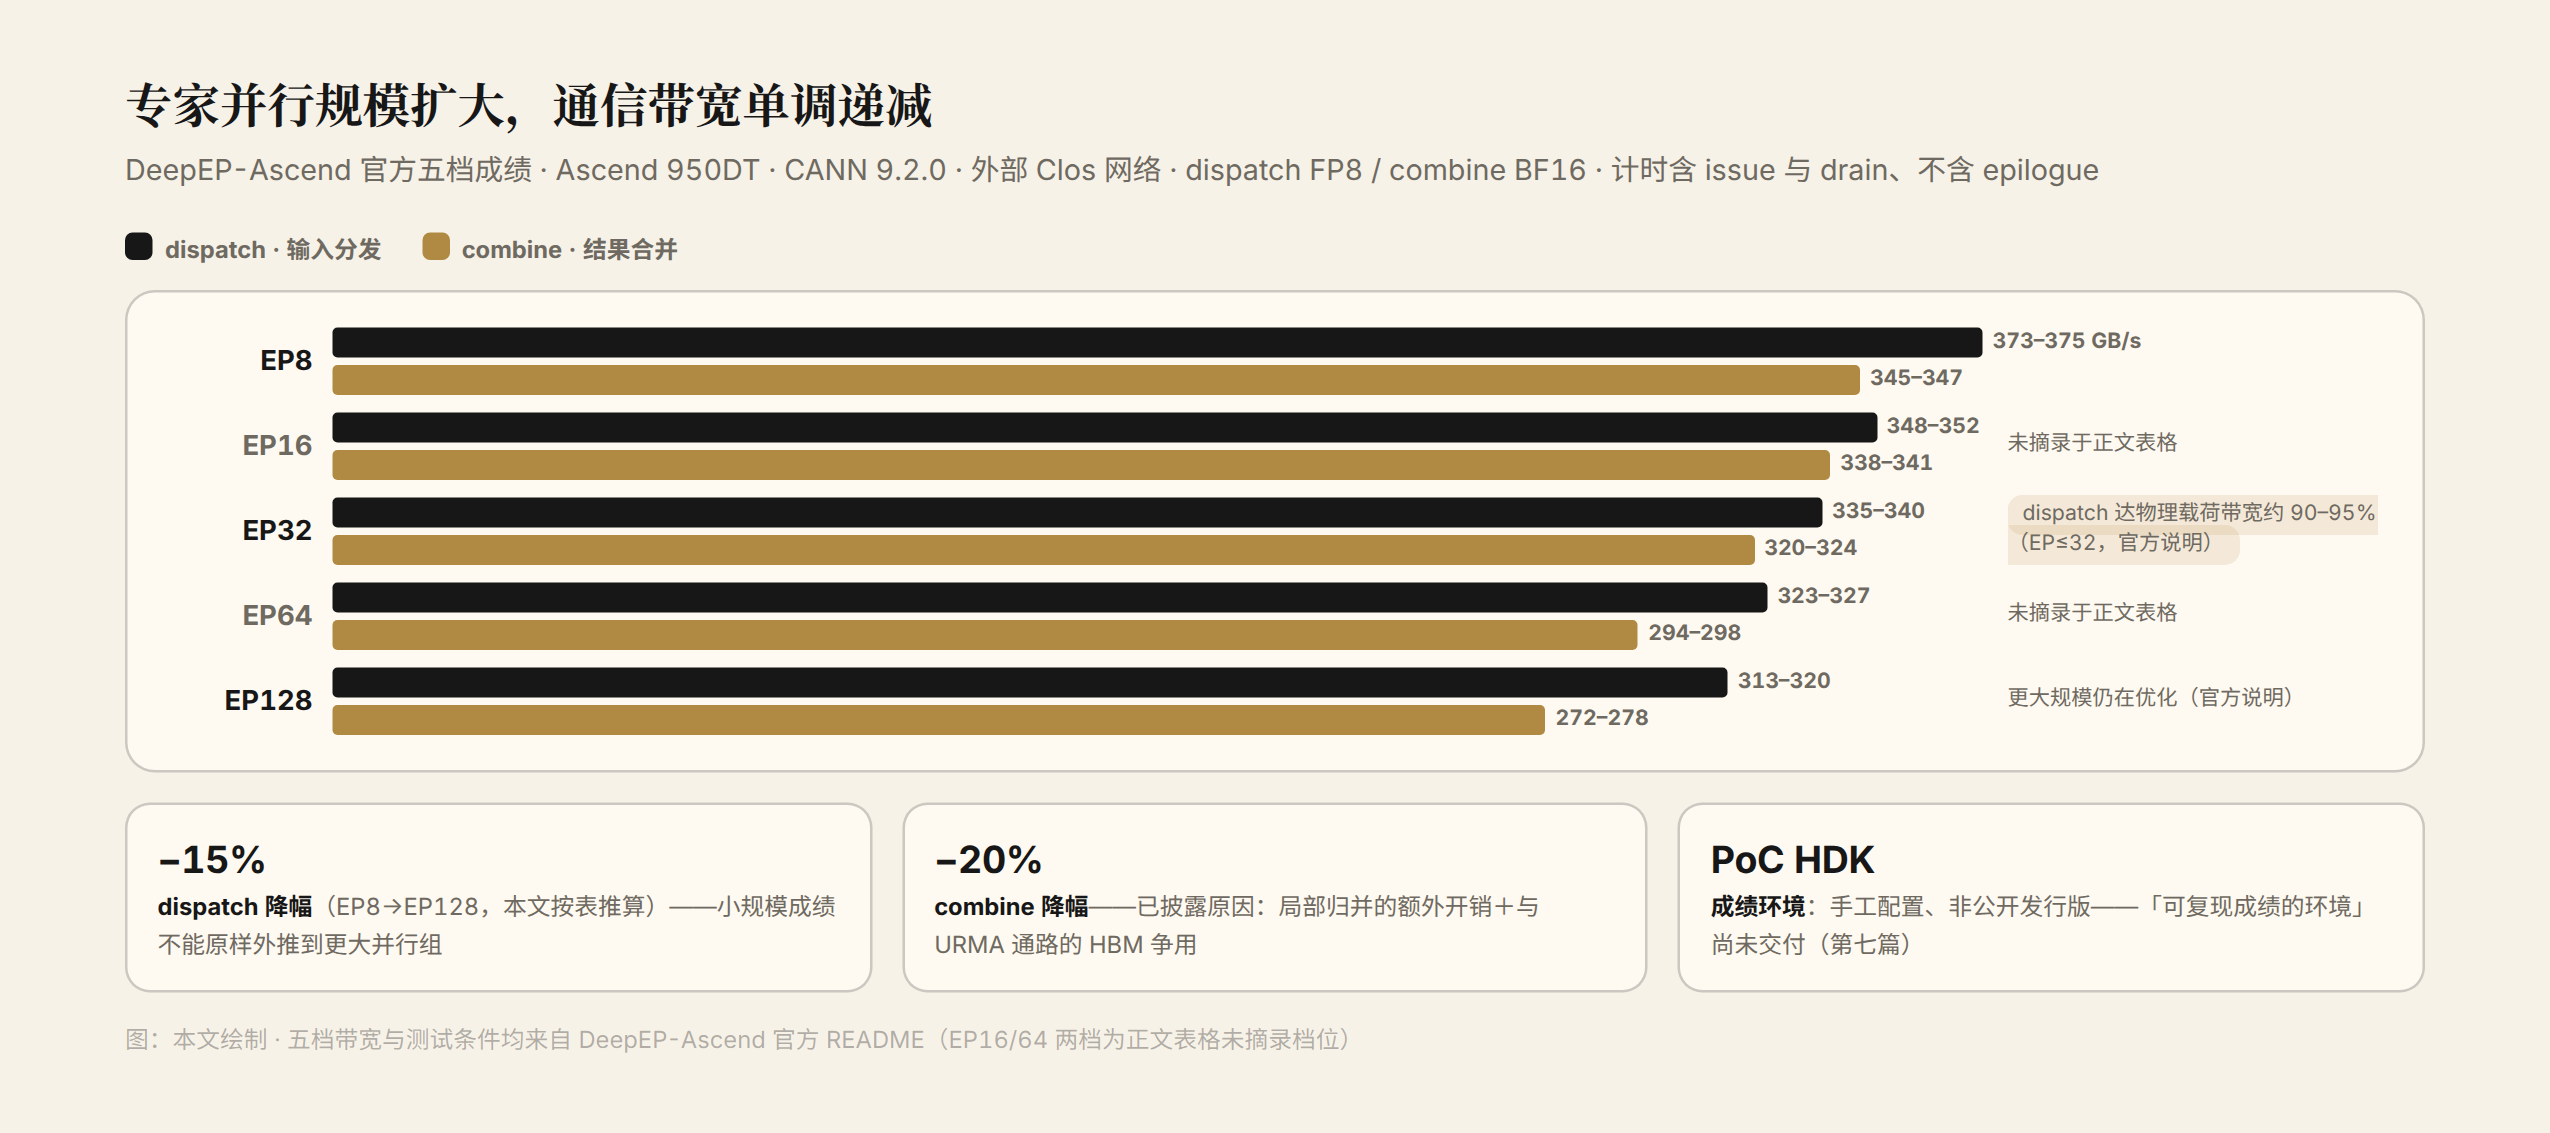
有了前面的路径,官方的五档带宽表才能读懂。测试条件如下(DeepEP README):
- 硬件与软件:Ascend 950DT,CANN 9.2.0,手工配置的 PoC HDK;
- 网络:外部 Clos 网络(supernode 的 netlayer 1);
- 负载:每个 rank 容量 16384 个 token,隐层维度 7168,256 个专家,top-6;
- 资源与配置:32 个 AI Core/64 个向量核(官方写法 32 AI cores / 64 AIVs),专家对齐 128,无 bias;
- 精度:dispatch 为 FP8,combine 为 BF16;
- 采样:每档预热 10 次,采样 50 次,并清空缓存。
| 专家并行规模 | Dispatch | Combine |
|---|---|---|
| EP8 | 373–375 GB/s | 345–347 GB/s |
| EP16 | 348–352 GB/s | 338–341 GB/s |
| EP32 | 335–340 GB/s | 320–324 GB/s |
| EP64 | 323–327 GB/s | 294–298 GB/s |
| EP128 | 313–320 GB/s | 272–278 GB/s |
五档全部单调下降。按表推算,从 EP8 到 EP128,dispatch 下降约 15%,combine 下降约 20%。README 解释了部分原因:EP ≤ 32 时,dispatch 能达到物理载荷带宽的约 90–95%;combine 偏低,一是局部归并有额外开销,二是 URMA 通路上存在 HBM 争用。更大规模下的性能仍在优化。
带宽只是第一个维度。下面把另外三个维度放回这条路径上看。
填充。 第一节的 do_zero_padding,就是第二篇所说填充开销实际产生的地方。设对齐粒度为 128,三个专家分别收到 1、1、126 个 token,每个都向上补齐到 128,共占 384 个槽位。有效数据只有 128 行,占三分之一。用填充放大系数 A_pad(处理槽位 ÷ 有效行数)表示,这里 A_pad = 3。碎片越多,行数低于对齐粒度的组越多,放大就越严重;具体增加多少,要按实际行数和对齐粒度计算。同一个零碎的分布,往往既压低算术强度,又抬高填充比例。
负载。 同步执行时,如果四台设备分别需要 10、10、10、30 毫秒,这一阶段的耗时接近 30 毫秒,而不是平均值 15 毫秒。前三台再怎么提速,也缩短不了关键路径。诊断时,先把每台设备的 token 数和耗时对照起来看:
- 最慢的设备 token 确实偏多,始终是同一台,且与专家放置有关:这时才调整放置;
- token 数相近,耗时却差很多:先检查设备状态和执行路径;
- 最慢的设备随请求变化:同样先对照 token 数和耗时。只有负载也跟着变化,才说明是路由波动造成的;仅凭「最慢的设备在变」,不足以下结论。
重叠。 第一节的时序就是接口层面的重叠,但「支持异步」不等于已经拿到了收益。设通信需要 40 毫秒,可并行的计算需要 60 毫秒,理想情况下重叠后总时长接近 60 毫秒。如果两者同时执行引发资源争用,计算被拖到 80 毫秒,通信被拖到 70 毫秒,重叠部分的时长就由较慢的计算决定。总时长约为 80 + h,h 是排在计算之后、无法被重叠覆盖的收尾时间,是本文假设的参数。只有 h 小于 20 毫秒,重叠才仍然快于串行执行的 100 毫秒。
能否拿到收益,取决于依赖结构和资源争用。要把设备上的执行流、通信流和主机侧的发起、等待放到同一条时间线上,测出实际的重叠程度和争用情况,只看线程时序是不够的。README 写明了「支持异步」,但这些数字要靠实测得到。
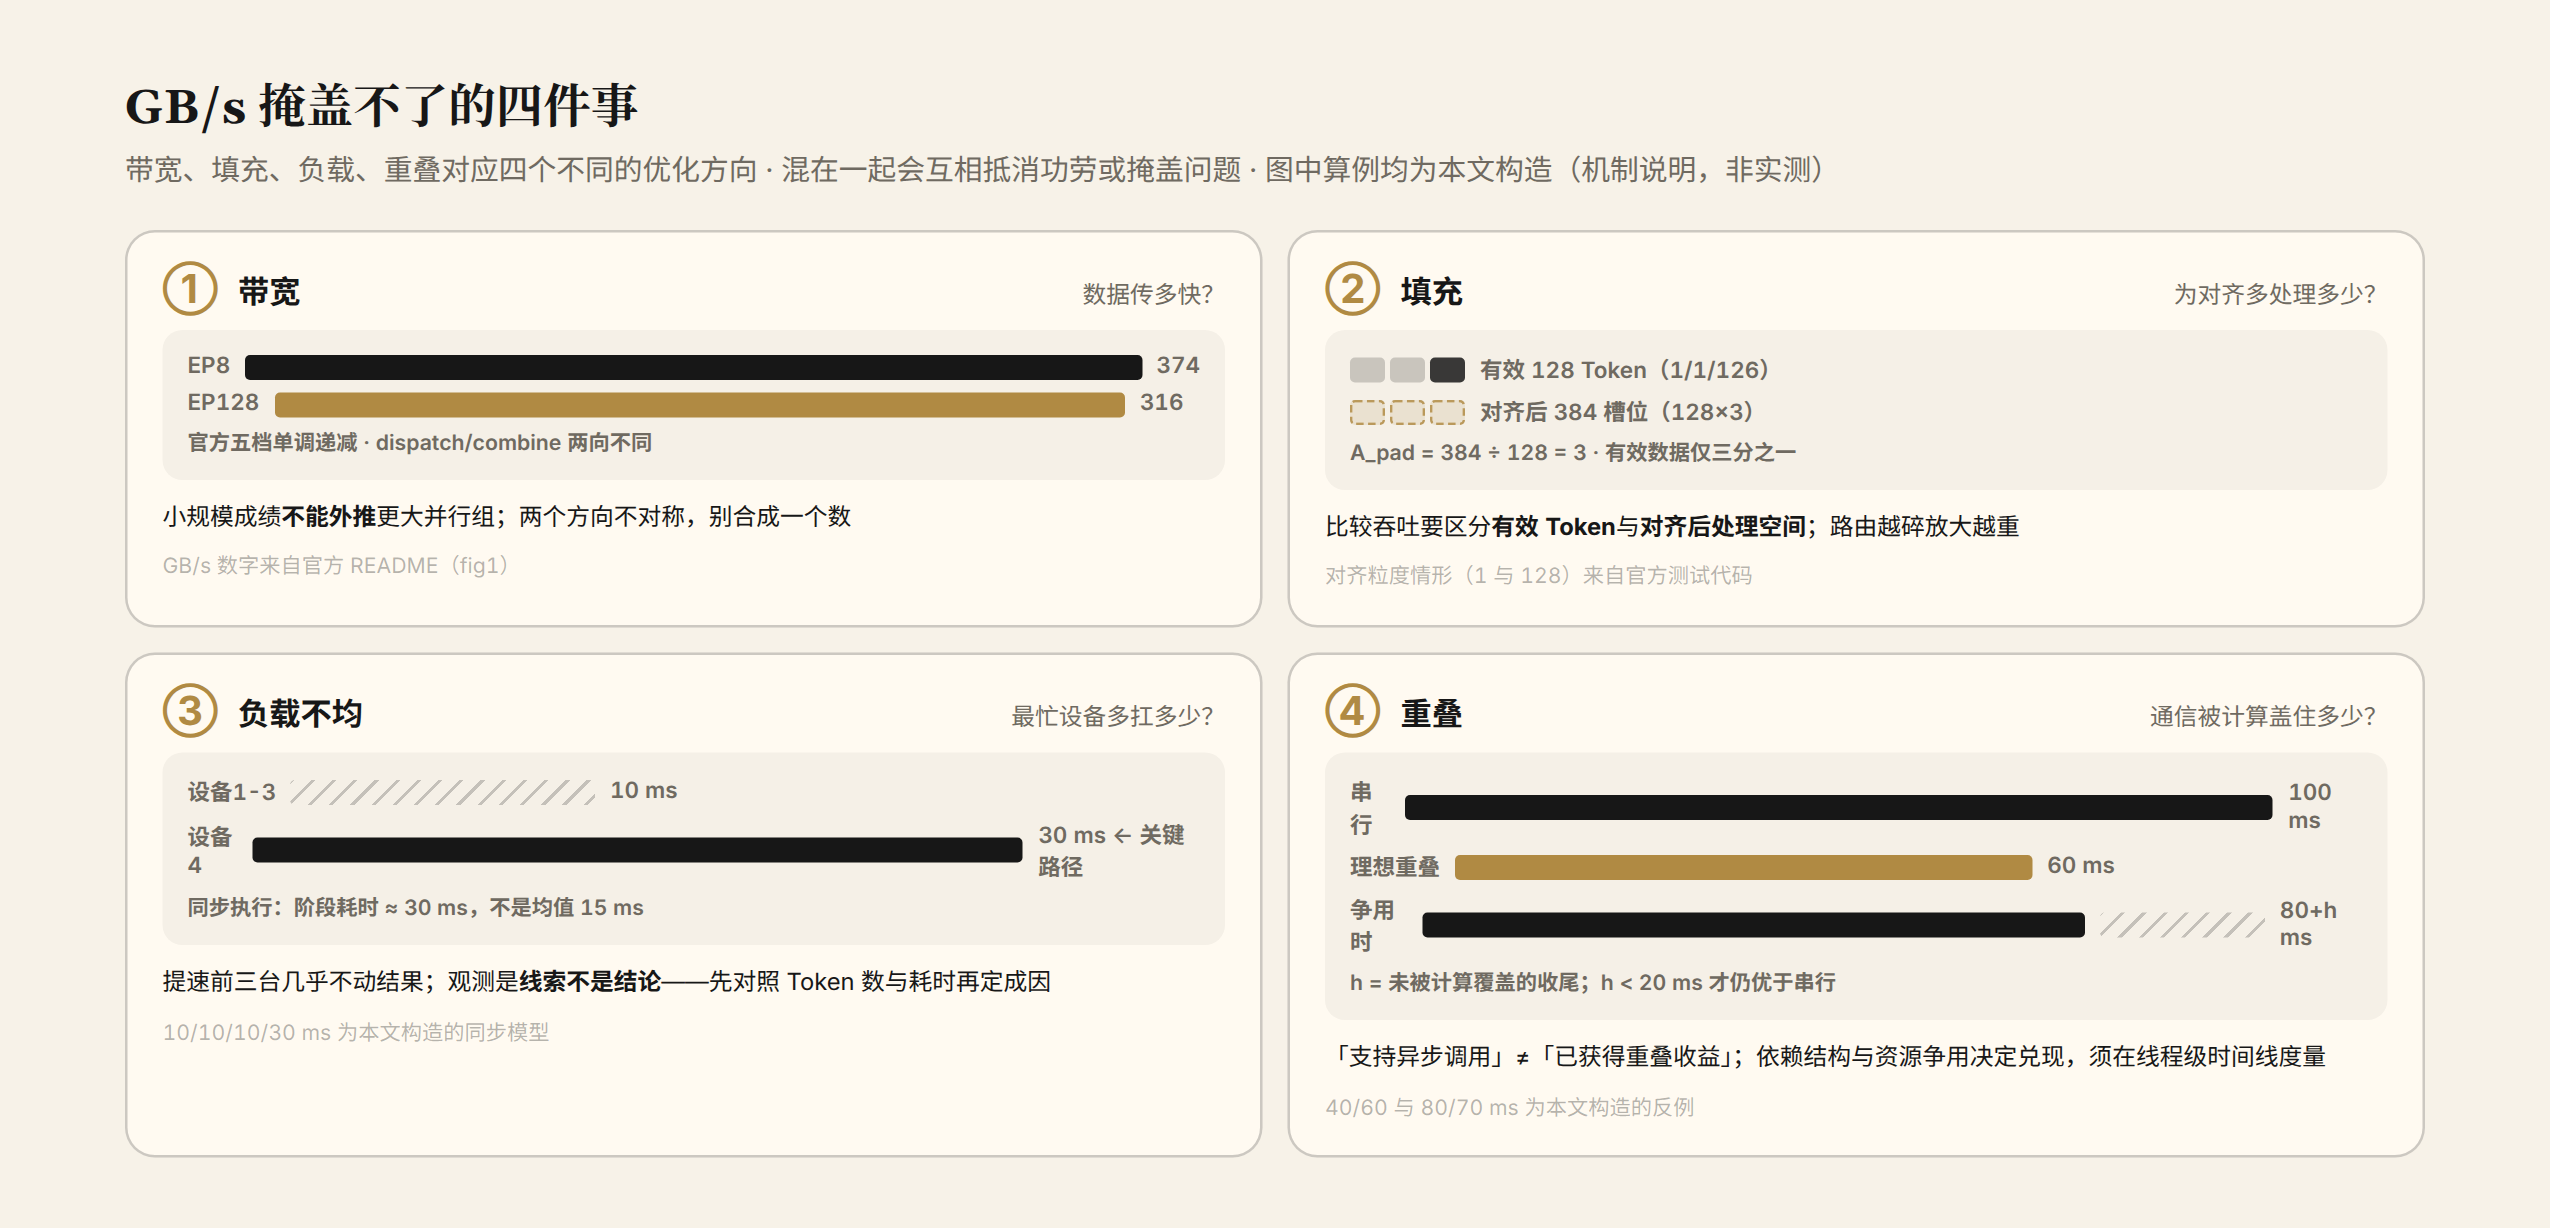
四个维度合在一起看,问题就不再是「通信带宽高不高」,而是:在真实的路由分布和计算负载下,通信还有多少时间留在关键路径上。
四、公开条件和完整路径之间还差什么
把接口清单完整读一遍,才知道框架还要补哪些东西(DeepEP README):
| 状态 | 内容 |
|---|---|
| 可用 | EP dispatch/combine,有以下约束:do_expand 和 allow_multiple_reduction 必须为 True,do_handle_copy 必须为 False,路由索引为 int64。num_sms 参数在昇腾上用于选择 AI Core 数。缓存模式下的 dispatch/combine 复用 handle 中保存的计数 |
| 开发中 | Bucket 集合通信:批量 all-gather 已可用,reduce-scatter 和 all-reduce 内核仍在开发。专家负载均衡:lb_prefetch_weights、lb_reduce_grads 已提供与原版一致的 API,但昇腾通信内核尚未实现 |
| 实验性 | PP、Engram |
| 明确不支持 | 混合通信、CPU 侧 Engram 存储、图捕获 |
这份清单的读法和第一篇一样:接口对齐不等于能力对齐。
- 推理框架如果想把整套执行放进类似 CUDA Graph 的图捕获,不支持图捕获就是一条无法绕过的限制;
- 并行策略如果依赖 reduce-scatter,Bucket 集合通信的缺口决定了方案是等内核补齐,还是另找办法绕开。
还有一个环境上的事实要记入比较条件:这些成绩来自一套手工配置的 PoC HDK,而不是公开发行版。第七篇会把「代码看得懂」和「成绩能复现」之间的距离纳入生态判断。
下一篇回到芯片内部,看这批开源组件中性能数字最亮眼的一个:FlashMLA 的稀疏注意力,以及 95% 峰值利用率背后在数据供给上的取舍。
资料与计算说明:本文依据 DeepEP-Ascend 的公开仓库和官方测试代码撰写,资料核验截至 2026 年 10 月 7 日,并保存了固定版本的副本。以下内容均来自官方 README:EPBuffer 的生命周期,dispatch/combine 的接口与参数含义,「先发起通信、再做无关计算、最后 wait」的用法,五档带宽表及全部测试条件(含 32 AI cores / 64 AIVs 的官方写法),「计时计入 issue/drain、不计入 epilogue」的说明,以及能力分级和开发中清单。对齐的两种情形(1 与 128)来自官方测试代码。以下内容由本文构造或按表推算:填充算例(1/1/126 → 384 个槽位,A_pad=3),10/10/10/30 毫秒的负载模型,40/60 与 80/70 毫秒的重叠反例,以及 EP8 → EP128 的降幅(约 15%/20%)。「容量一致是为了让接收方装得下对端发来的数据」,是本文对这条一致性要求的解读。本文没有做硬件实测。本文是「DeepSeek 昇腾开源系列」的第三篇。