
一万张 GPU 的集群,应该配多少台沙盒服务器?
只知道卡数,还算不出这个答案。同一轮训练,要求七天完成还是十四天完成,每秒需要交付的训练数据就不同;这些数据需要多少推理计算、会同时占用多少任务环境,也随之变化。这里的「训练场」,指承载 Agent 工具执行和任务状态的沙盒基础设施:它接收模型动作、执行任务、返回结果,不负责生成模型输出。
不妨先把任务定下来:一周内完成 1,000 次外层迭代,每次消费 4,096 条轨迹。整轮约 410 万条,平均每秒需要交付 6.8 条。这是最终能进入训练批次的数量,生成后被过滤或丢弃的轨迹还没有算进去。
下面从这个需求出发,计算推理侧的吞吐门槛和环境侧的平均占用,再检查训练更新能否跟上。
一、一周目标:每秒 6.8 条有效轨迹
基础设施失败、超时、版本过旧或配方过滤,都会消耗生成产能。记有效入批率为 p,原始生成需求就是有效轨迹需求除以 p。
这里统计的是轨迹能否入批,不是任务是否成功:失败轨迹也可能是有价值的训练样本。统计时应保持任务配比和组批要求不变,不能靠优先消费短轨迹来提高这个指标。
以下列出本文设定与引用的观测参照:
| 参数 | 取值 | 来源 |
|---|---|---|
| 外层迭代次数 | 1,000 次 | 本文设定 |
| 每次迭代消费轨迹 | 4,096 条(512 个任务 × 8 次采样,GRPO 组内比较) | 本文设定 |
| 时间约束 | 7 天(604,800 秒) | 本文设定 |
| 每条轨迹输出 | 约 3.3 万 token(64 个交互步 × 每步新增 512;交互步指一次模型动作加一次环境反馈) | 本文设定 |
| 卡的分配 | 训练 7,000 张,推理 3,000 张 | 本文设定 |
| 单卡输出吞吐扫描点 | 60、75、200 token/s/卡 | 本文设定 |
| 轨迹环境时长 | 1,044 秒(借论文容器中位寿命 17.4 分钟代均值) | 论文披露(DSec,arXiv 2609.22978);代入是本文设定 |
| 单节点密度 | 容器 3,200 / microVM 800(示范运行点);样本日峰值 1,048 / 524 | 论文披露 |
| 平台日创建 / 峰值在线 | 约 300 万个每天 / 超过 38 万 | 论文披露 |
| 生产单元与云溢出 | 160 节点;利用率超 80% 分流云端,200 台云 VM 吸收约 30% 峰值溢出 | 论文披露 |
口径与边界:60、75、200 是情景扫描点,不是实测值;DSec 的数字只用作环境侧的规模与行为参照,不用于推断 DeepSeek 的实际 GPU 配比;本文算的是完成既定训练预算的时间,不讨论 1,000 次迭代能否到达某个能力目标;全部边界由本文假设推出,发布前须实测校准。
二、第一条门槛:约 74 token/s/卡
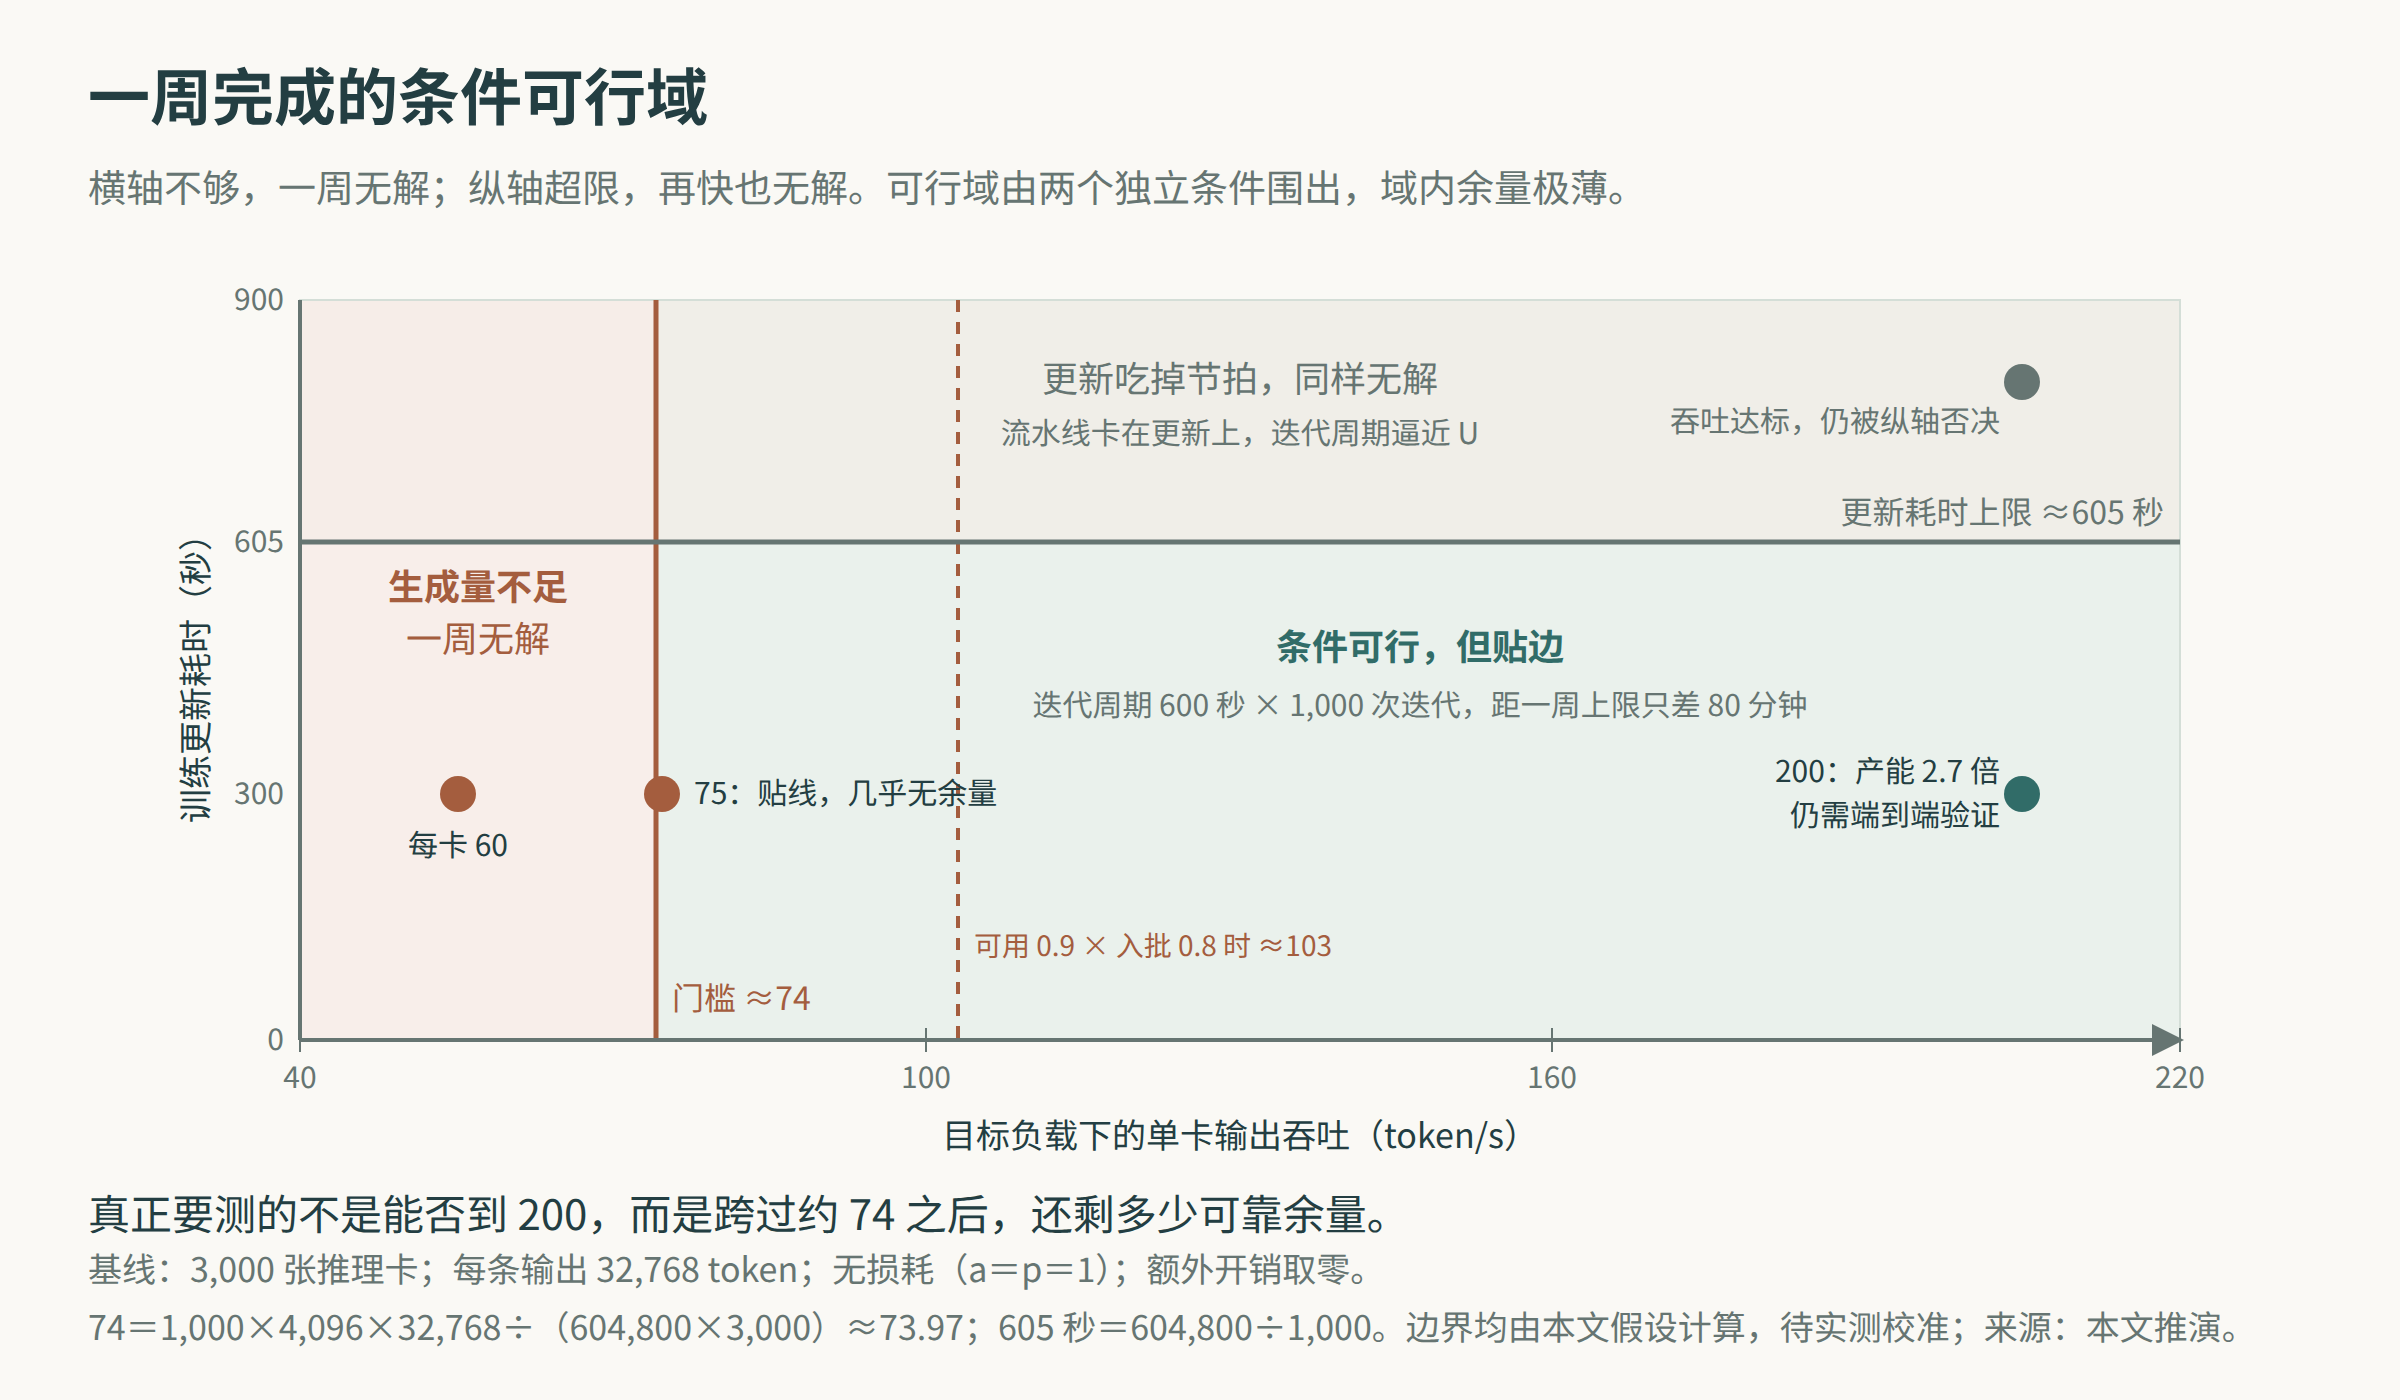
每条轨迹按 32,768 个输出 token 计算,410 万条轨迹对应的总输出量,分摊到一周和 3,000 张推理卡上,无损耗门槛约为 74 token/s/卡(1,000 × 4,096 × 32,768 ÷(604,800 秒 × 3,000 张)≈ 73.97)。60 达不到要求,75 几乎没有余量,200 则留出了选择空间。
| 单卡输出吞吐(目标负载) | 折合轨迹产能 | 相对 6.8 条/秒 | 怎么读 |
|---|---|---|---|
| 60 token/s | 约 5.5 条/秒 | 0.81 倍 | 生成量一项就不满足期限 |
| 75 token/s | 约 6.9 条/秒 | 1.01 倍 | 几乎没有损耗与运行开销余量 |
| 200 token/s | 约 18.3 条/秒 | 2.7 倍 | 原始产能有余量,端到端可行性仍需验证 |
60、75、200 是情景扫描点,用来观察低于、接近和高于临界值时的资源约束。在 200 token/s/卡的扫描点,需求约占标称产能的 37%,这是供需比,不等于实际 GPU 利用率;瓶颈的位置也随档位变化:60 档卡在生成,200 档移到训练更新与环境侧。
这个门槛必须用目标 Agent 负载来测。上下文、工具返回和缓存行为改变了,吞吐也要重新测量。
吞吐怎样统计
Agent 生成一段动作后,要等环境执行,再根据结果继续生成;一次任务里,这样的往返可能发生很多次(rollout 指模型与真实环境交互、生成训练数据的整个过程)。同样一张推理卡,放在线上问答服务中和放在 Agent 训练中,实际产出未必相同。本文需要的是后者的吞吐:目标负载下的输出吞吐,即在目标上下文、工具返回和缓存条件下,推理服务运行期间每张卡产生的输出 token 数,尚未扣除最终未入批的轨迹。单条轨迹的完成时间还受环境执行和反馈时延约束,不能仅由输出 token 数推算;本文按期限折算平均吞吐。
本文用输出 token 衡量推理产出,输入处理、工具返回和缓存行为带来的成本,则反映在目标负载下的实测吞吐中。即使复用了前缀 KV,也不能把输出 token 量当作全部计算量。统计时,用整个推理池的输出总量除以测量窗口内分配的 GPU 卡秒,不能只统计正在解码的设备,或只用内核执行时间作分母。
计入损耗,门槛随之上浮。记生成服务可用时间占比为 a、有效入批率为 p,两项损失分别进入运行时间与样本:取 a=90%、p=80%,并假设全部尝试的平均输出量仍为 3.3 万 token,73.97 ÷(0.9 × 0.8)≈ 103 token/s/卡。若采用的测量结果已包含其中某项损失,不再重复折减;拿线上问答的吞吐来代替 rollout 吞吐,分子和分母测的就不是同一件事。
三、平均 7,100 个在途环境
沿用基线假设:每条轨迹占用一个环境,平均占用时间为 1,044 秒,所有轨迹均能入批。按利特尔法则,平均在途量等于到达速率乘平均占用时间,每秒约 6.8 条对应约 7,100 个在途环境。
计入入批损耗后,只有在全部尝试的平均环境占用量不变时,这个数才按 1/p 放大。初始化失败后立即退出,与运行很久后因超时被丢弃,对环境的消耗不同,测量时需要一起统计。
还有一处系统性低估要说明:利特尔法则要的是平均占用时长,这里代入的是中位寿命 1,044 秒,而寿命分布明显右偏(第四节的容器 p99 约为中位数的 13 倍),均值大概率高于中位数。用容器侧 p50 与 p99 粗略拟合成对数正态分布,平均占用约 1,900 秒,平均在途量约 1.3 万个,接近基线的两倍;这是方向性粗估,实际倍数取决于真实分布。两个设定之间可以做一次自洽检查:每条 3.3 万 token 输出 ÷ 1,044 秒占用 ≈ 单流 31 token/s 的解码速度(按均值 1,900 秒则约 17 token/s),尚未扣除工具执行时间,说明轨迹长度与环境时长大体相容。
算出平均 7,100 个在途环境后,还缺一个决定节点数的数据:运行这类任务时,每台服务器能在目标时延下承载多少环境。
DSec 给出了不同后端的运行密度:容器后端单节点示范运行点 3,200 个、microVM 后端 800 个,论文原话是「示范运行点,不是硬上限」;样本日观测到的单节点峰值是 1,048 个容器加 524 个 microVM,这是两个后端各自的峰值,直接相加隐含了同一时刻同时到达的假设。这里需要区分三个词:
- 观测密度:这台服务器曾经装下过多少环境。
- 服务容量:满足时延和可靠性要求时,它装得下多少。
- 规划容量:扣掉故障、突发和碎片之后,愿意承诺多少。
论文数字基本是第一类,配置承诺要的是第三类,观测密度不能直接当作另一套系统的容量承诺。
做除法之前还要对齐单位。160 个节点、3 万核、250TB,平均每节点约 188 核、1.56TB 内存;节点规格并不统一,比较台数时必须同时说明核数、内存与服务能力。
回到开头的问题。以样本日观测到的单节点容器峰值 1,048 个为准,7,100 个在途环境约需 7 台;按均值修正后的约 1.3 万个计算,约需 13 台。若采用示范运行点 3,200 个,只需 3 到 5 台。这 13 台只是算术下限:再计入 80% 的入批率,在途量约 1.61 万、约需 16 台;进一步按 500 秒节拍把有效供给提到每秒 8.19 条,原始生成率约 10.2 条,在途约 1.95 万、约需 19 台。我会按 25 台上下规划,给故障、突发,以及观测密度与服务容量的差距留出余量。和 DSec 一个 160 节点的生产单元相比,这个数约为其六分之一;原因在于本文只算一路训练任务的稳态,没有计入评测、环境构建和多个团队共用平台的负载。
平均并发只描述稳态。环境定容还要分别回答三个问题:在途容量(内存、存储、实例配额)够不够;目标并发下工具执行的平均与尾部时延、结果验证的吞吐是否满足要求;一批环境同时启动后,多久能开始第一次有效交互。环境消耗更稳健的记账单位,是每次轨迹尝试累计占用的沙盒秒、CPU 核秒与内存 GB 秒:一条轨迹可以跨多个沙盒(中途重建),也可能结束后保留状态;再叠加评测与环境构建等未计入负载。
四、节拍、余量与一致性
推理产能足够,并不意味着训练能按时结束。还要看样本生成与参数更新能重叠多少。
本文设定异步生成、批量训练。每个迭代周期(相邻两次外层迭代的间隔)结束后发布一次权重,单条轨迹从头到尾使用同一版权重。一次外层迭代消费一批轨迹并完成训练更新,其中可以包含多次优化器更新;权重发布指新版本对推理侧可见。
在稳态流水线里,攒够一批完成样本的间隔可以短于单条轨迹的运行时间。靠的是多批轨迹同时在途:这一批正在完成,下一批已经运行了一段时间。这让训练侧有机会持续拿到数据,也使不同版本的轨迹同时留在系统里。节拍缩短后,有两处压力会上升:训练更新得跟上,权重切换得处理好还在跑的轨迹和 KV 缓存。一次更新需要多久、轨迹中途是否换权重、切换后要重算多少缓存,这些选择会一起改变实际产能;不能先按理想吞吐配卡,再把一致性问题留给部署阶段。

把节拍写成可以检查的条件。记每批消费轨迹数为 B,满足配比与新鲜度要求的有效供给速率为 R_eff,每次外层迭代的训练更新耗时为 U,迭代次数为 n。在生成与更新充分重叠的理想近似下,稳态迭代周期:
L ≈ max(B / R_eff, U)
完成整轮训练还需满足:
T ≈ n × L + T_extra ≤ T_budget
T_extra 汇总启动、收尾,以及尚未计入其他项的不可重叠开销;T_budget 为时间预算。额外开销与吞吐测量中的停顿损失应划清边界,避免重复计算。
训练更新耗时 U 是另一项需要测量的变量,取决于训练卡数、批量、并行策略和优化器更新次数,本文没有实测。以 60 token/s/卡的情景为例:一周输出需求约 22.2 万 token/s,推理侧缺口约 700 张;从训练侧调出约 700 张卡,可以补上这项生成量缺口,训练侧随之降到约 6,300 张,若更新耗时近似随卡数反比伸缩,会拉长约 11%。实际只能按模型副本与并行组的粒度挪动。
多出来的推理产能,用来减卡,还是缩短工期?
假设生成与更新能够充分重叠,每轮按 600 秒运行,1,000 轮需要 600,000 秒。一周还剩 80 分钟,留给启动、收尾和其他额外开销的空间并不宽裕;600 秒只能算边界点,稍有额外开销就会超出一周。
把周期缩短到 500 秒,情况就不同了。主循环结束后,名义时间余量提高到约 17.3%。这份余量可以留给重试、停顿和负载波动,但它需要更高的供给速率:每秒要有 8.19 条有效轨迹进入训练,比基线高约 21%。
沿用无损耗和固定轨迹长度的假设,推理侧的门槛随之升到每卡约 89.5 token/s。若平均环境占用时长也不变,同时在途的环境则从约 7,100 个增加到约 8,550 个(按均值粗估约 1.56 万)。时间宽裕了,推理和环境两侧的要求却提高了。
还要看权重发布。若仍然每轮发布一次,新版本出现得更快,尚未结束的长轨迹就可能跨过更多版本。系统要决定,是保留旧版本让任务跑完,还是切换权重并处理相应的缓存和样本问题。
因此,推理侧有富余之后,不能只问还能少用多少张卡。还要比较:这些资源用于缩短工期,是否比用于降低投入更有价值。答案取决于更新时间、长尾负载和样本新鲜度能否承受更快的节奏。
一致性:换了权重,旧轨迹怎么办
我倾向于让旧轨迹用旧权重跑完,同组 8 条轨迹在同一版权重上启动,并保留最近 10 个版本;超限时整组处理(整组丢弃,或整组降权),不在组内混用版本。理由来自本文的配方:GRPO 在每组 8 条采样之间做比较,组内样本最好出自同一版权重。按本文的寿命拟合,上限取 4 时,600 秒节拍下约两成轨迹会超限,接近第二节 p=80% 的全部损耗预算;取 10 时降到约 5%,500 秒节拍下约 7%。以上均为单条轨迹的比例;整组丢弃时,按组内最长轨迹计,组级比例在 5% 到约 35% 之间(500 秒节拍为 7% 到约 46%),取决于同组轨迹时长的相关性。按组算,600 秒节拍下上限取 4 的组级上界约为 83%(1 − 0.8⁸)。上限取 10 时若按组级上界计,丢弃方案已超出 p=80% 的预算,此时只能选整组降权,或进一步放宽上限。可容许的版本差还没有实测依据,10 是暂定值;附录 A1 列明的实测项补齐后再定。AReaL(arXiv 2505.24298)选了另一种做法:收到权重更新请求就中断所有进行中的生成,丢弃旧权重算出的 KV 缓存,用新权重重算后继续生成。这个取舍解决了调度问题,代价是重算的算力,以及「一条轨迹内换过权重」的定义问题。AReaL 对陈旧数据和混合行为策略另做了 PPO 处理;本文只借用它的工程做法,能否移植到 GRPO 配方还要另行验证。对照之下,保留 10 个版本意味着多版本并存:占用推理显存、摊薄批处理,吞吐实测也应在目标版本数下进行。
新鲜度:平均版本差、尾部、超限比例
版本差指一条轨迹从开始到被消费之间跨过的权重版本数。在本文的理想时序下,600 秒迭代周期对应的平均版本差按中位寿命约 1.7,按均值粗估约 3.2(推导见附录 A1);无论哪种口径,尾部都更值得关注:若暂以沙盒寿命近似轨迹时长,文中引用的容器与 microVM p99 寿命分别约 13,900 秒与 12,800 秒(约 3.9 与 3.6 小时,按论文图 7 的分布读数,论文正文给出的是超过三小时的下界),在 600 秒的发布周期下对应约 23 和 21 个发布周期;实际版本差还受启动版本、排队和消费时序影响。因此,运行时需要同时记录平均版本差、尾部版本差和组级超限比例;周期、版本差与稳定性的关系见附录 A1。
侧栏:同样一周,为什么有的训练跑 30 步
小米 MiMo-V2.6 的强化学习训练(官方发布文章;2026 年 9 月 22 日发布,官方口径训练历时不到六天)有一组官方数字:Flash 与 Pro 两路各完成 30 个 RL 步骤、约 75 万条轨迹(官方表述未明确是否按模型分别计),单次更新 1,568 个样本,全异步架构,上下文最高 100 万 token,单步 35 亿到 37 亿 token。
为什么同样一周,有的训练只跑 30 步?官方数字本身就能拆开:约 75 万条 ÷ 30 步 ≈ 每步 2.5 万条轨迹,而单次更新只有 1,568 个样本,每个 RL 步大约包含 16 次优化器更新。MiMo 的一「步」相当于本文的若干个外层迭代。按单步 35 亿到 37 亿 token ÷ 2.5 万条计,每条约 14 万到 15 万 token;这个折算把全部 token 计为 rollout 生成,未经确认,暂不用于修正参数。比较资源需求之前,需要先统一迭代、样本和 token 的统计口径。
五、峰值怎么扛:DSec 的云溢出
DSec 用云 VM 吸收沙盒需求的瞬时峰值,稳态负载留在本地;本地利用率超过 80% 时,放置引擎把符合条件的新建请求分流到云端;生产中一个规模单元用 200 台云 VM 吸收了约 30% 的峰值溢出。生产定容因此要决定哪些负载留在本地、哪些可以弹性溢出,并让镜像分发、状态和调度路径支撑这种分流。DSec 为此把容器运行时和 EROFS 镜像加载路径原样搬到云 VM 上,镜像集离线同步到云端文件系统。
DSec 披露了云端吸收部分峰值溢出的机制,但这一比例不能直接用于拆分 38 万峰值在线量。容量反推需要先统一统计范围:在线量是否含云端,溢出统计的是请求还是并发,哪些任务具备分流资格。部署时要先划清本地底座、弹性容量和排队限流各管哪一段负载。峰值在线量只能用来核对,不宜直接倒算台数。
结尾:测什么,怎样改变决策
部署前要测的是下面四项:
| 要测的量 | 建议口径 | 它决定什么 |
|---|---|---|
| 有效轨迹供给与消费 | 在固定任务配比下,分别记录满足入批条件的轨迹供给率,以及训练实际消费率 | 生成能否满足候选节拍,训练能否及时消费,整轮预算能否按时完成 |
| 训练更新周期 | 区分数据等待、更新服务时间、发布与不可重叠开销 | 7:3 分配是否成立;600 秒迭代周期是否可行 |
| 环境服务能力 | 目标任务混合下的在线量、准备时延、工具执行时延 | 在途容量与安全密度 |
| 新鲜度与缓存重算 | 平均与尾部版本差、组级超限率、同组轨迹时长的相关性、权重切换后的缓存重算量 | 流水化能否持续提供有效产能 |
测试应在同一套端到端配置和任务配比下进行,同时观察轨迹供给、训练消费、环境时延与版本差,并覆盖稳态、突发和长尾。只有这些要求能够同时满足,前面的计算才有依据转化为配置。
如果只能先测一项,我先测目标 Agent 负载下的单卡 rollout 吞吐。它决定落在 60 档还是 200 档,也决定瓶颈在生成侧还是训练侧。
附录
A1 版本差的离散推导
时间线:权重按批发布,每个迭代周期一次;一条轨迹在一个迭代周期窗口内随机开始、从一而终(中途不换权重),完成后进缓冲区,等下一个批边界被消费。记轨迹时长为 W、迭代周期为 L;批次发布下权重每 L 秒换一版,一条轨迹从开始到被消费跨过几版,版本差就是几。按消费侧计法,版本差等于消费时的现行版本减去样本开始时的现行版本(新权重在消费之后才发布),期望恰好等于 W 除以 L。容易多算的一笔等待:按秒算,缓冲里的样本平均等半个迭代周期;但在版本计数里,等待终止于消费边界,贡献零个版本,不另加二分之一(离散时间线模型:起始时刻均匀分布的稳态理想化)。若按发布后计法,每个样本再恒加 1。整个推导属于发布顺序既定、起始相位均匀、无额外积压,且轨迹完成后可在下一边界消费的理想模型。它只作比较基准,实际版本差可能高于或低于它。
代入数字(W=1,044 秒):迭代周期 600 秒时,期望约 1.7(版本差为 1 的概率约四分之一、为 2 的约四分之三);224 秒约 4.7;746 秒约 1.4。按均值 1,900 秒粗估,三档分别约 3.2、8.5、2.5。其中 224 秒与 746 秒来自 4,096 条按 200 档与 60 档产能攒批的间隔(4,096 × 32,768 ÷(3,000 × 吞吐))。在这一设定下,迭代周期越长,版本差越小,因为发布随批锁定;给定可容许的平均版本差,它转成迭代周期的下限;同时数据的墙钟年龄随迭代周期增大。发布与训练迭代解耦的机制(长尾负载常用)下,版本差按滞留时长乘发布频率增长,靠任务编组或回放管理。理论参照是异步 GRPO 的稳定性研究(arXiv 2607.01083):稳定性边界近似由同步间隔 S 与学习率 η 的乘积刻画,最大稳定学习率约随 S 的倒数缩小;对陈旧引入的更新偏差的 O(Sη) 上界依赖局部正则条件。该研究以优化器更新次数定义同步间隔 S,本文以外层迭代定义发布版本;两者口径不同,不能直接代换,本文不据此给出算法稳定性保证。要给出定量的新鲜度边界,缺的实测是权重发布周期、学习率所处的稳定域、可容许版本差上限。
A2 远端敏感性
以下是单因素情景计算,暂时固定平均轨迹时长和环境密度。实际提速时,两者也可能变化,因此这些结果用于观察参数影响,不作为实际扩容预测。若仅保持本文平均占用时长不变,3,000 张推理卡在 1,000 和 2,000 token/s/卡下,分别对应约 9.6 万和 19.1 万个平均在途环境(按均值 1,900 秒粗估约 17.4 万和 34.8 万)。继续套用两种容器侧历史密度:样本日峰值 1,048 折约 91/182 个、示范运行点 3,200 折约 30/60 个算术等效节点(按均值粗估约 166/332 个与约 54/109 个;microVM 侧的两个密度未用上)。这些数字只展示密度假设如何影响换算,不代表提速负载下的可承诺容量,实际节点数仍需重新验证该负载下的服务能力。注意这已经跨出一周目标的场景:需求速率随产能走,在途与节点数按比例放大,这些数字不能拿去回答「一周完成要配多少」。
时间约束放宽到两周,60 token/s/卡的情景下,原始生成吞吐约束不再排除该配置;更新、新鲜度和环境侧仍需验证。两周下迭代周期可落到 746 秒以上,批次发布下平均版本差反而略降(约 1.7 到 1.4,按均值粗估约 3.2 到 2.5),但节拍变慢,数据的墙钟年龄也变老。
这些参数分别控制不同约束:训练预算与期限决定有效轨迹需求;输出长度、吞吐、入批率和可用时间决定生成侧资源;环境占用及负载构成决定平均并发与服务容量;训练更新耗时和发布机制决定可采用的运行节拍。哪一项最值得优先优化,取决于目标负载下的实测瓶颈和参数不确定性。
资料与计算说明: 本文基于论文《DeepSeek Elastic Compute (DSec): A Sandbox Infrastructure for Effective Agentic Training at Scale》(arXiv 2609.22978,2026 年 9 月 19 日提交)的公开数字与本文标注的设计假设撰写;云端溢出机制引自该论文 §3.4,单节点密度引自其披露的分后端示范运行点与样本日观测。小米 MiMo-V2.6 数字来自其官方发布文章与公开训练面板,以官方口径为准。异步稳定性参照 arXiv 2607.01083(异步 GRPO 的 Sη 稳定性边界);权重切换机制参照 AReaL(arXiv 2505.24298)实现细节;前缀缓存成本口径参照 vLLM 稳定版文档的 Automatic Prefix Caching 页(docs.vllm.ai/en/stable/features/automatic_prefix_caching/)。本文推演参数均为设定值,随文标注。数据截至 2026 年 10 月 5 日。