GTC Berlin 的重点落在芯片之外:更快交付的 AI 工厂、约束智能体权限的运行时,以及供企业继续训练的开放模型。英伟达正在把客户采用 AI 时遇到的工程难题逐项纳入产品。客户获得了速度和便利,也需要重新计算对这套平台的依赖。
10 月 21 日,黄仁勋在柏林 Tempodrom 的 GTC 主题演讲上,没有靠一颗新芯片制造悬念。Vera Rubin 已经公布,台上展示的是量产系统。新的发布集中在工厂如何交付、智能体如何运行,以及企业如何把自己的数据用起来。[1]
对采购方而言,芯片以外的工作同样昂贵。买下 GPU 以后,客户仍要完成系统集成、业务适配和安全治理。英伟达正在把这些工作纳入同一套产品体系。承担的工程环节越多,它就越有机会参与客户后续的技术选型。
一 演讲的重点落在芯片之外
黄仁勋先从欧洲企业讲起。欧莱雅、Revolut、Spotify、默克、沃达丰、Zara、保时捷、雀巢、汇丰,被列在同一张名单上:它们来自不同国家和行业,都在与英伟达合作。英伟达对欧洲科技生态承诺的投入接近 100 亿美元,合作伙伴超过 1.2 万家。这番开场要说服欧洲的,是把本地的工业经验与数据用于生产 AI。[1,24]
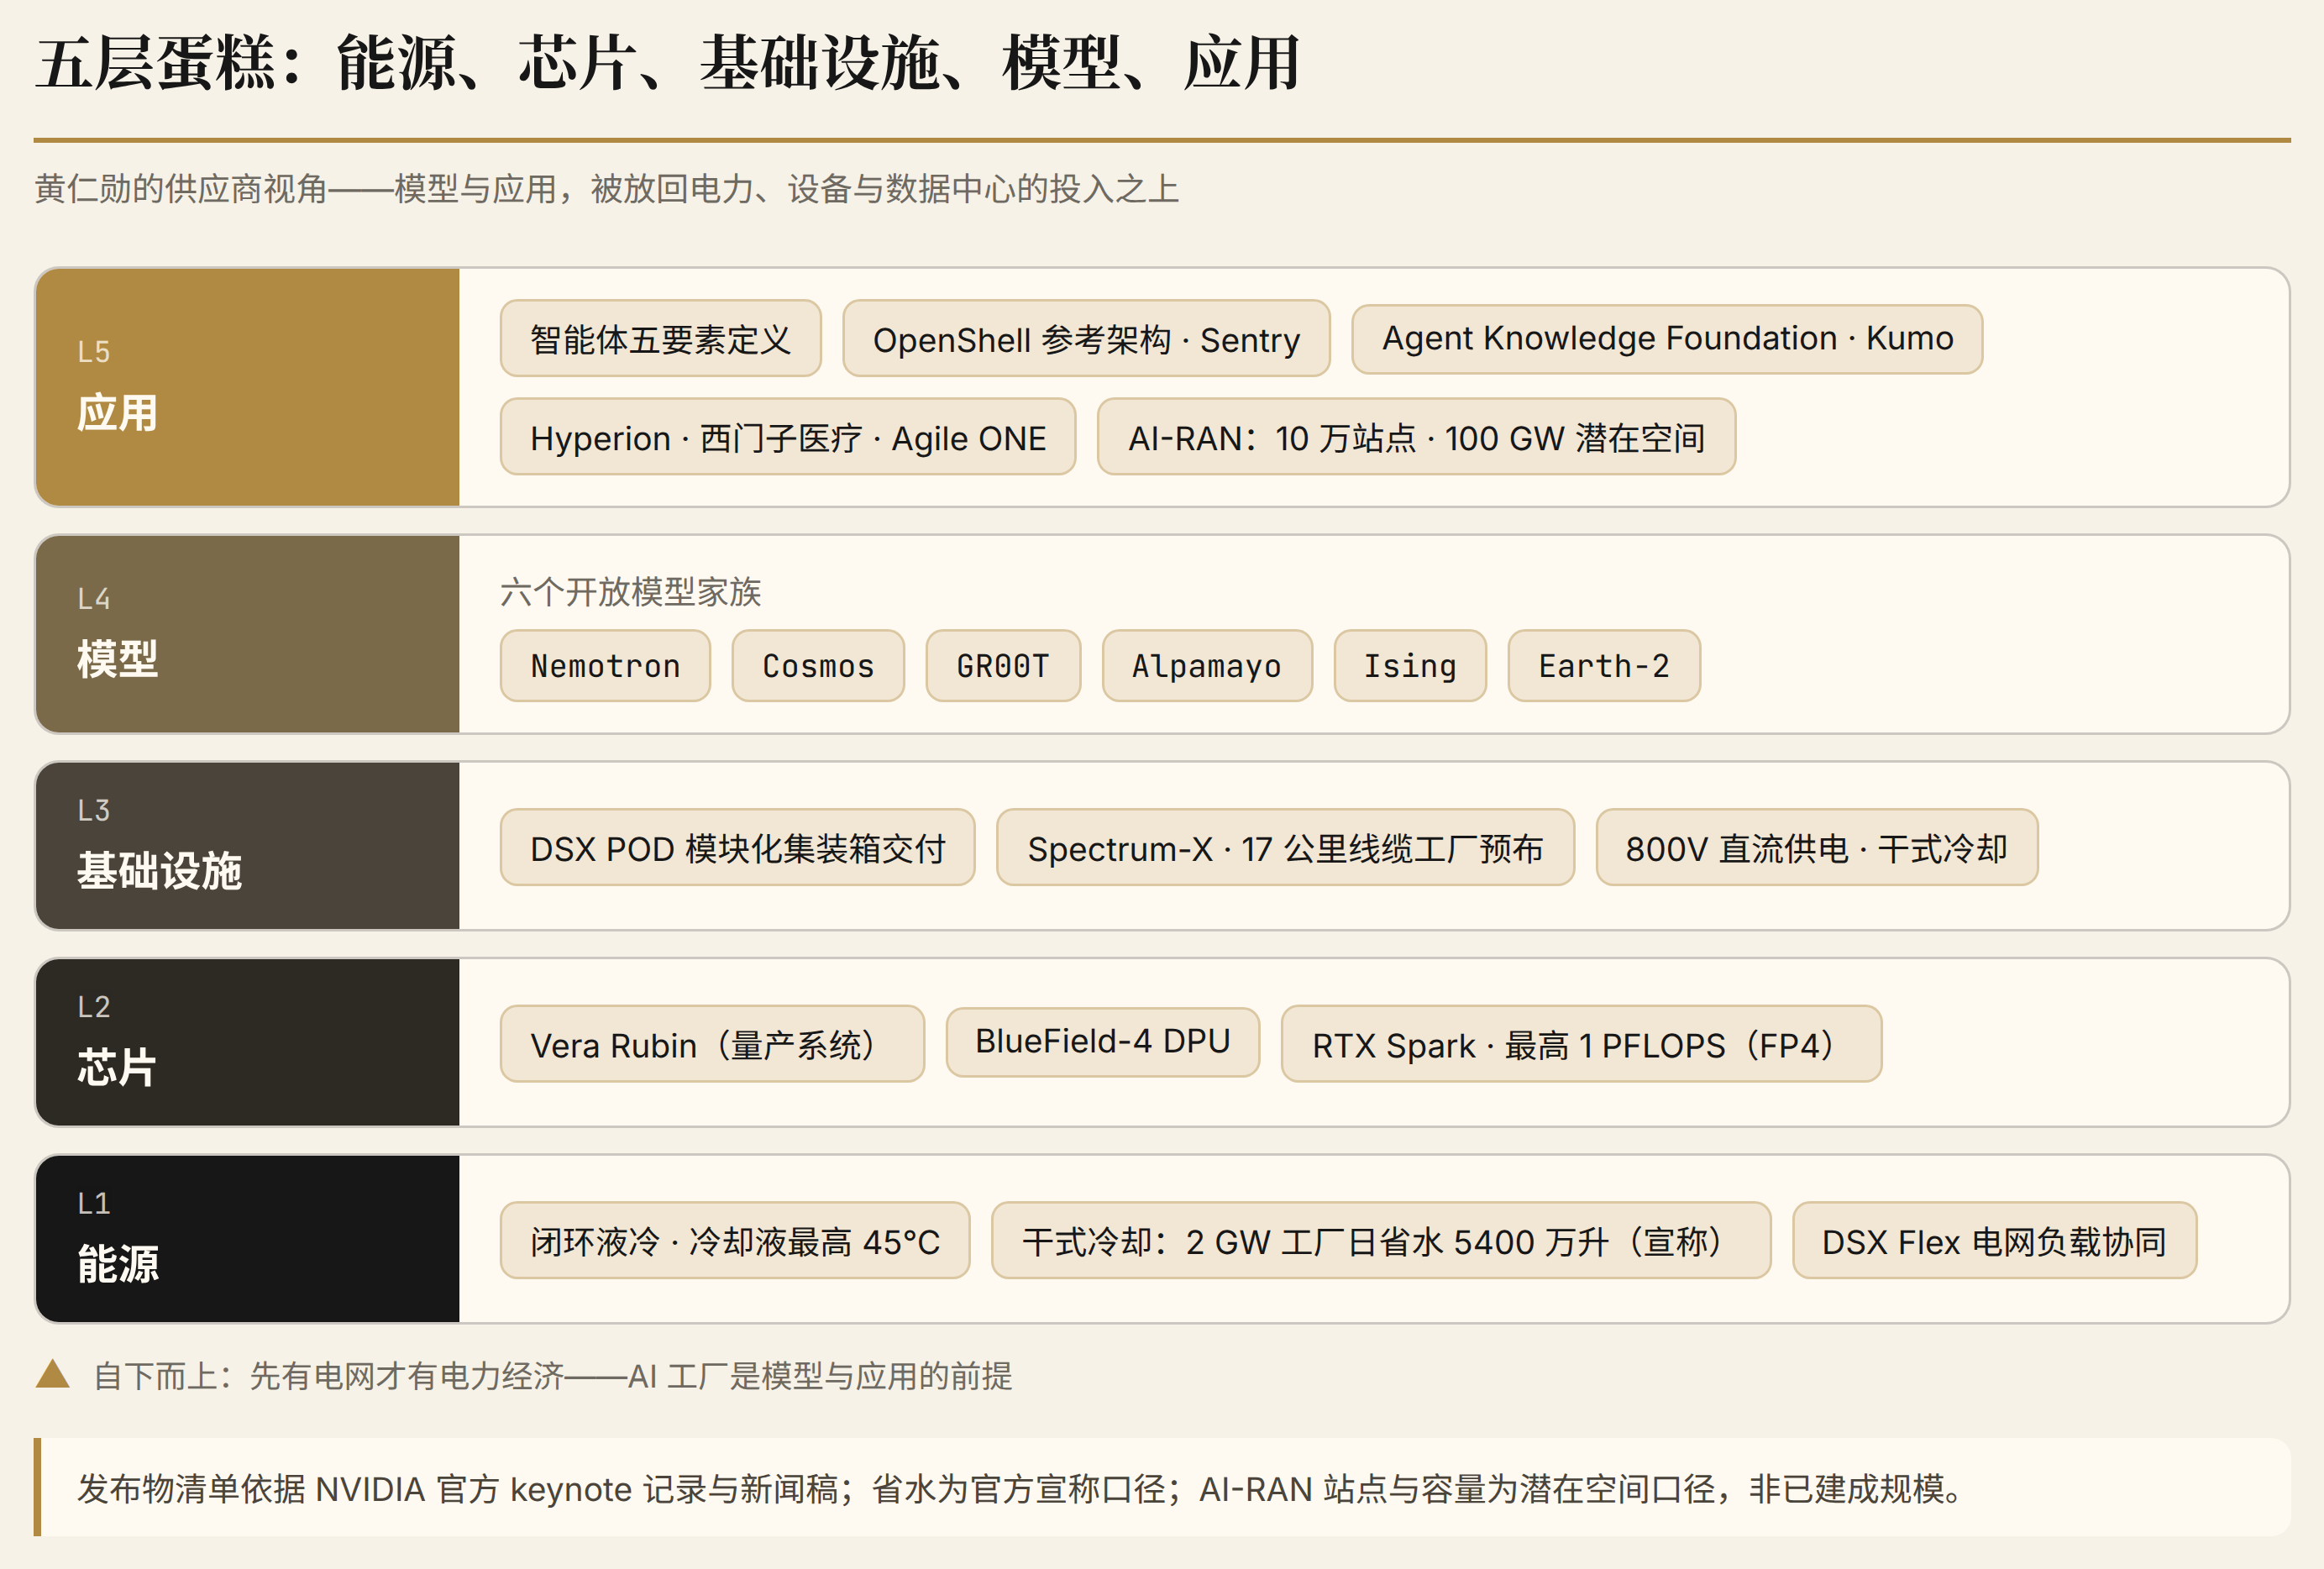
随后是那张「五层蛋糕」:能源、芯片、基础设施、模型、应用。这个分层有鲜明的供应商视角。它把人们最容易注意到的模型和应用,放回电力、设备与数据中心的投入之上;英伟达也借此解释,为什么一家 GPU 公司要参与越来越多的工程环节。[2]
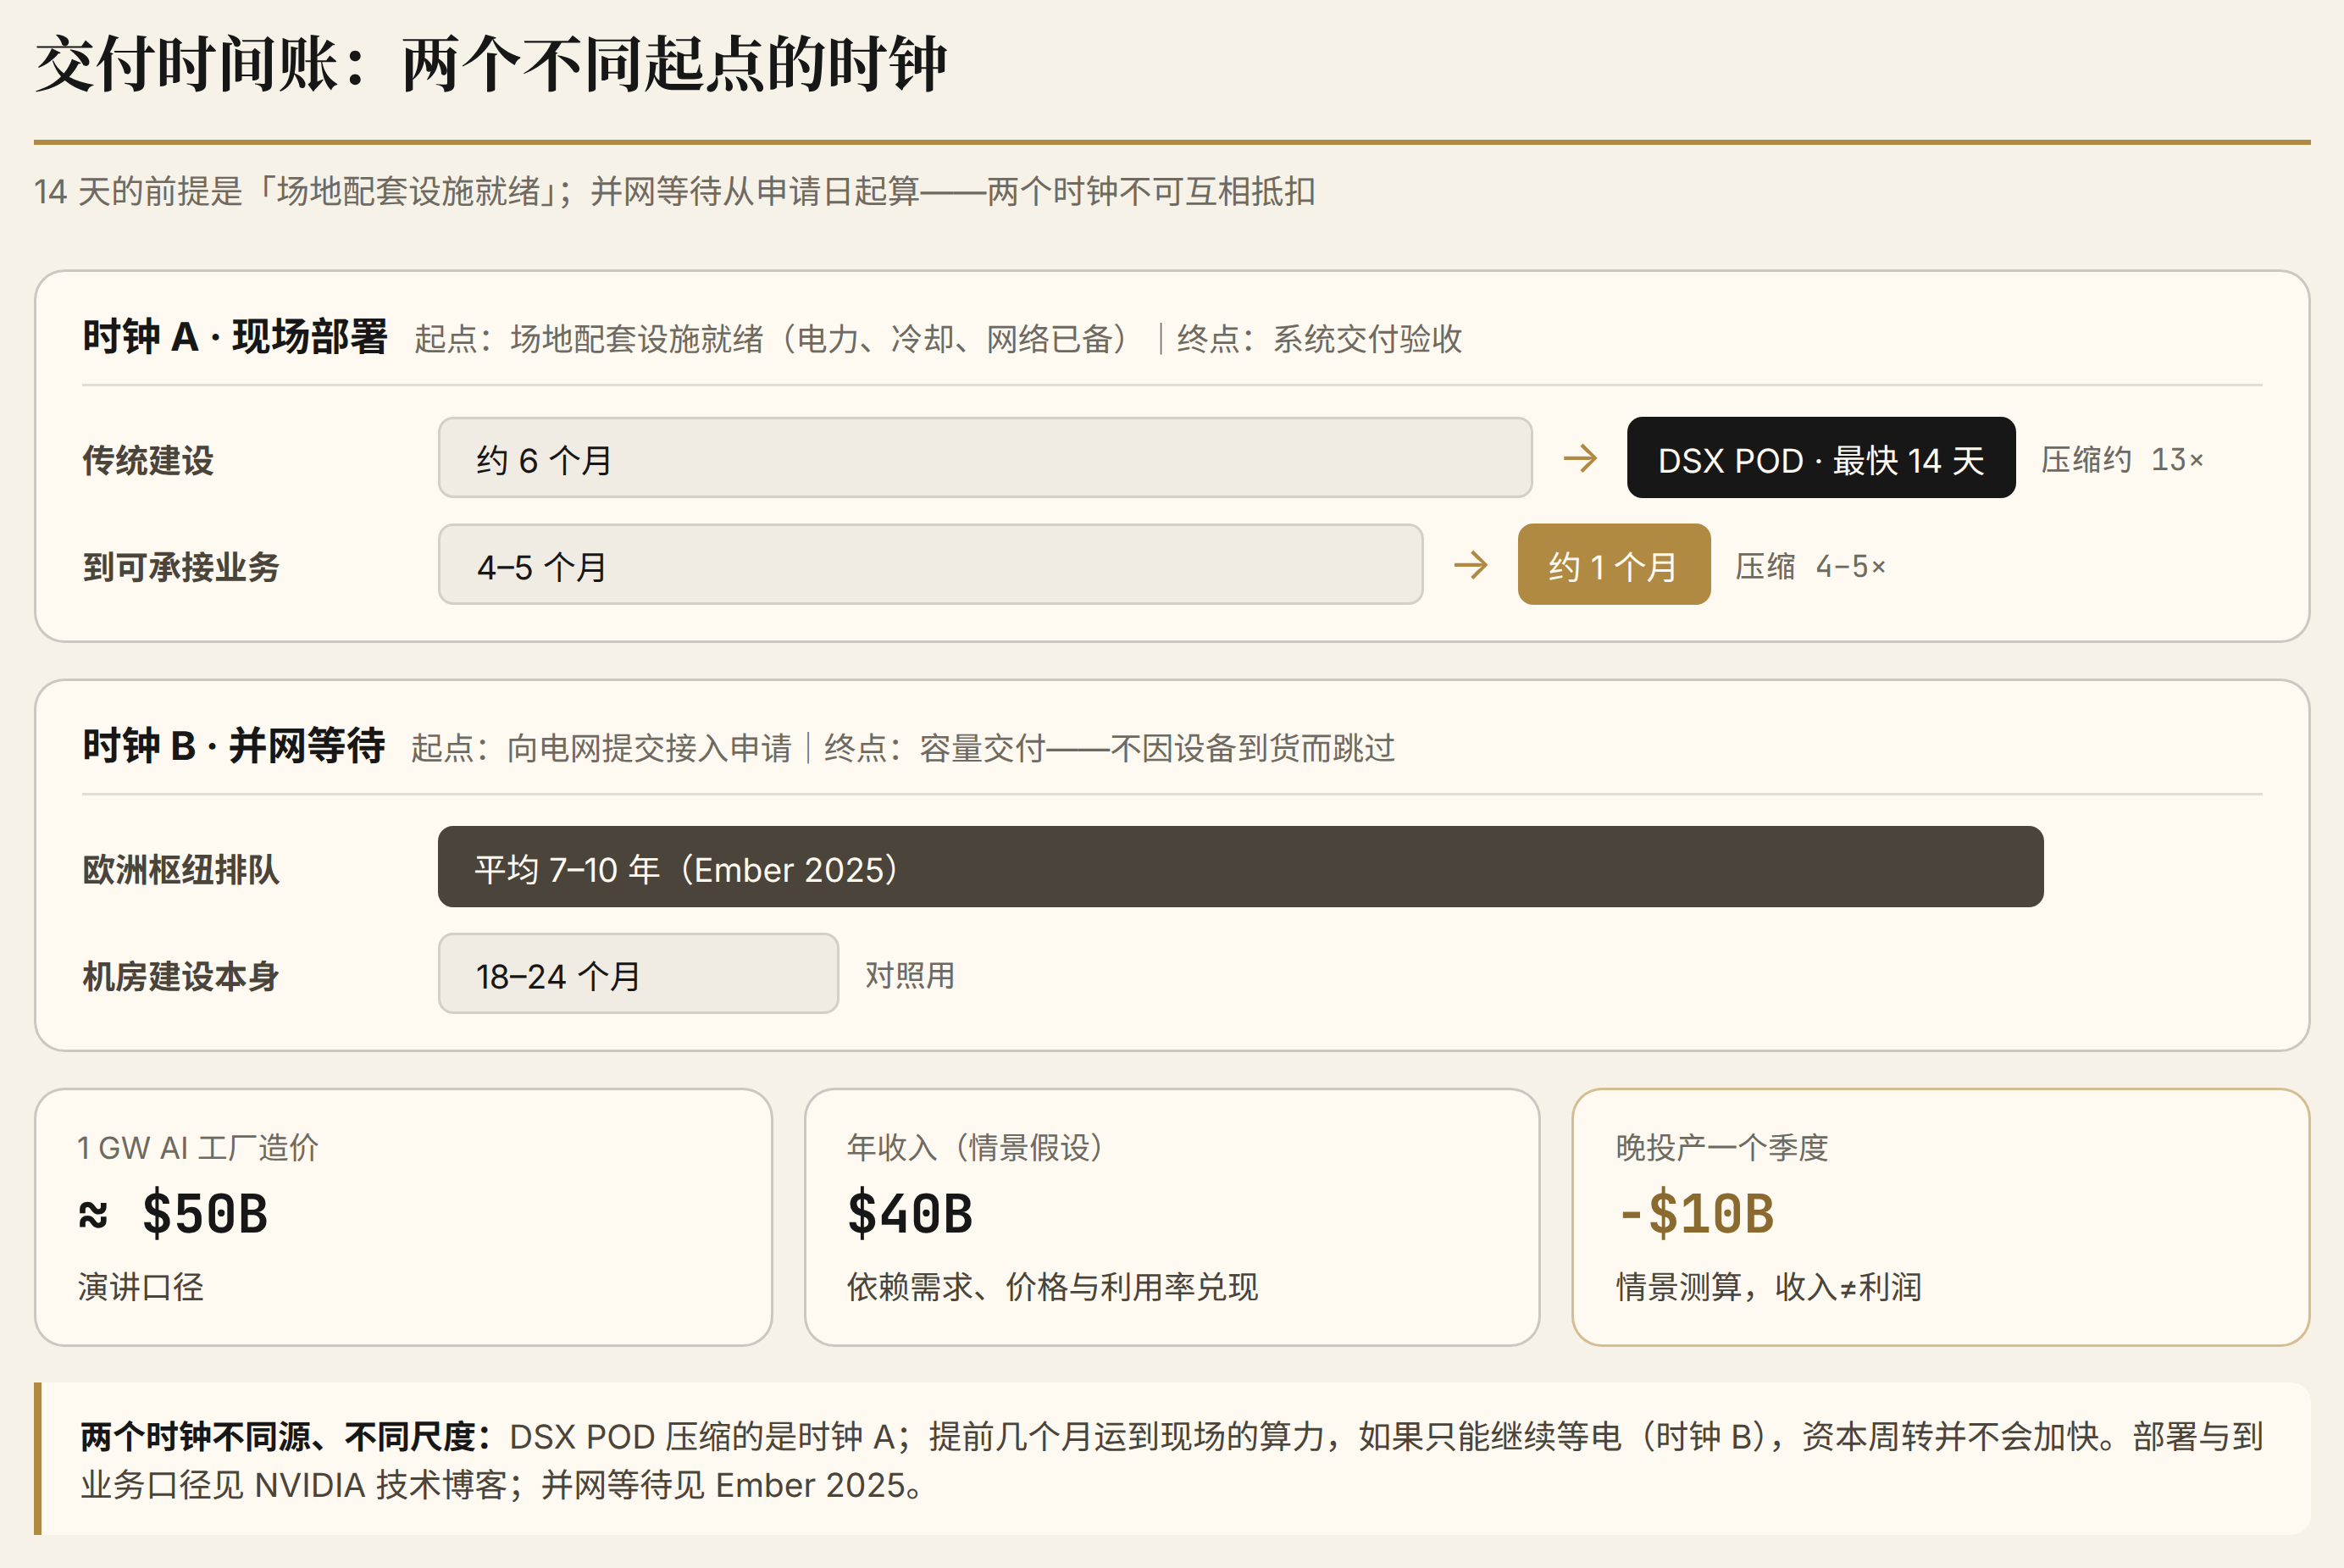
硬件部分的重点是 DSX POD。计算、网络、机架供电和液冷管路在工厂内完成集成与测试,以模块化集装箱形态运到现场。英伟达宣称,在场地配套设施已经就绪的前提下,现场部署可从约六个月缩短到最快 14 天,合作伙伴预计在 2027 年初开始交付。这里发布的是参考设计与交付方式,实际制造、当地工程和服务仍由合作伙伴承担。[3,13]
智能体部分,黄仁勋列出五个组成要素:模型、负责工作编排和记忆管理的 harness、沙箱、知识、工具。OpenShell 位于智能体与它能够操作的系统之间,负责隔离、权限和策略执行。此次参考架构进一步把模型推理、智能体执行和安全监控分配给 Rubin、Vera 与 BlueField-4。[4]
开放模型也在这套分工里。六个家族分别覆盖语言模型 Nemotron、世界模型 Cosmos、机器人 GR00T、自动驾驶 Alpamayo、量子与经典混合计算 Ising,以及天气和气候预测 Earth-2。英伟达提供基础模型及相关数据、训练工具,让企业用自己的行业数据继续训练。黄仁勋把这条路称为通向「主权智能」的路径。[1,5]
模型之后还有两段容易被发布清单淹没的内容。Agent Knowledge Foundation 负责连接企业知识,覆盖文档解析、检索和结构化数据;Kumo 面向结构化数据预测。CUDA-X 则提供仿真、求解、数据处理等计算工具。它们解释了智能体如何从回答问题走向执行任务,也说明英伟达的软件业务已经延伸到模型之外的工作流程。[1,6,7]
行业案例沿着这条路线展开。电信领域,诺基亚与英伟达在 T-Mobile 商用网络完成了首个 AI-RAN 呼叫。演讲提到的约 10 万个站点、100 GW,则是电信及分布式数据中心可转化为 AI 基础设施的潜在空间,不能当作已建成的 AI-RAN 规模。医疗领域,英伟达与西门子医疗正在开发 AI 放疗方案,把设备和患者解剖的数字孪生、治疗规划、实时影像与自适应控制连接起来。[8,9,25]
汽车部分,奔驰、大众商用车、沃尔沃与 JLR 的下一代车型被纳入 Hyperion 平台的合作版图。机器人部分,与 Agile Robots 合作的 Agile ONE SN 参考平台,计划于 2027 年初提供给研究者。演讲还展示了药物研发、工厂生产准备和车辆设计中的智能体工作流程。它们的共同用途,是为模型、知识与计算工具的组合寻找具体业务。[1,10,11]
收尾是个人 AI。已上市的 RTX Spark 被拿到台上,官方规格包括最高 128GB 统一内存与最高 1 PFLOPS 的 FP4 AI 算力。机器人演示把本地建模与仿真、云端训练、策略回传和实机部署串在一起,最后四只 Microduck 机器鸭上台。这个演示强调的是本地与云端工作流程的贯通。[1,12]
把这些内容放在一起,英伟达的商业意图就很具体了。客户可以从一台个人电脑、一个行业模型或一套智能体运行时开始,随后接入同一家公司的计算库、服务器和工厂设计。入口越多,整套平台进入企业采购的机会就越大。
二 十四天部署改变了哪一段工程
DSX POD 的价值,在于把复杂的现场工作提前搬进工厂。
大型 AI 系统的交付涉及网络连接、液冷、供电、固件与集群验证。任何一项没有完成,都可能让已经到货的昂贵设备继续闲置。工厂预集成可以让现场基础设施准备与设备装配并行,减少现场反复排错,也让验收流程更容易重复。英伟达试图向客户出售的,是更可预测的投产日期。[13]
黄仁勋在演讲中用了一笔粗账说明它的价值:一座 1 GW AI 工厂,资本投入约 500 亿美元;如果年收入达到 400 亿美元,推迟一个季度投产,就有约 100 亿美元的收入机会被推迟或错过。[14]
这个数字依赖需求、价格和利用率都能兑现。收入也不等于利润,延迟确认的收入与永久流失的收入不能混算。不过,它指出了设备采购表容易遗漏的一项成本:设备到货以后,资金占用还在继续;真正开始回收投资,要等系统能够稳定承接业务。
因此,14 天必须连着它的前提一起读。英伟达新闻稿写得很清楚,现场电力、冷却、网络等配套设施需要先准备好。集装箱内的管路可以在工厂完成测试,现场仍须接入水路和排热系统。标准化接口减少了工程量,却没有取消机房之外的建设。[3,13]
欧洲最漫长的等待,恰恰可能发生在这里。Ember 2025 年的研究指出,在法兰克福、伦敦、阿姆斯特丹、巴黎、都柏林等传统数据中心枢纽,新项目接入电网平均需要七至十年。地区之间差异很大,一些新兴选址的等待明显更短,但这个差距足以改变投资落在哪里。[16]
英伟达已经开始介入电网协同。DSX Flex 尝试根据电网条件调节工厂负载,并协调现场电源与储能;DSX MaxLPS 则在既定功率预算内调整资源分配。冷却方面,公司称 Vera Rubin 可使用最高 45℃的冷却液,闭环液冷配合干式冷却,在 2 GW 规模下,相比传统冷却塔每天可减少约 5400 万升冷却用水。这些都是有条件的设计与性能宣称,仍需项目实测。[15]
负载调节有助于缓解接入约束,却无法代替变电站、输电线路和审批。对欧洲项目而言,最先需要确认的往往仍是电力何时可用,以及设备交付能否与之匹配。提前几个月运到现场的算力,如果只能继续等电,资本周转并不会因此加快。
也没有必要据此宣布,AI 工厂的最佳形态已经统一为集装箱。英伟达自己的技术说明仍保留传统建设与现场集成。更扎实的趋势是:预集成的范围从机架扩展到更大的模块,供应商开始为更多系统接口和交付步骤提供统一设计。[13]
这给其他超节点与系统供应商提出了新的要求。产品竞争除了性能,还需要交付一个经过验证、能按期接入业务的系统。DSX POD 能把这件事做到什么程度,要等首批项目交付后,看现场调试、验收和实际投产各用了多久。
三 智能体安全让运行时成为新的采购项
黄仁勋关于安全的批评很直白:靠一段提示词恳求智能体不要删除文件、不要访问密钥,无法构成可靠的权限控制。模型可能误解指令,也可能被外部内容诱导。只要它能够执行操作,企业就需要在模型之外设置可执行的边界。
OpenShell 解决的正是这一层问题。它在三月已经进入开源预览,九月底随智能体安全平台扩大发布;柏林这次将它进一步组合为全栈参考架构。安全规则由外部机制执行,限制智能体能够接触的文件、网络、工具与凭据,并记录相关行为。模型本身的安全研究仍然必要,运行时控制则为企业提供另一道独立防线。[23,4]
Sentry 是其中更贴近硬件的一部分。它运行在 BlueField-4 的独立信任域里,监控行为并执行策略。按照英伟达的技术说明,检测到威胁或策略违规后,可以在毫秒级隔离智能体。官方把它称为 OpenShell 软件边界之外的可选硬件保护。[17]
「毫秒级」需要守住这个含义。它描述检测到违规后的隔离动作,不能自动扩展为对所有危险行为的实时识别,更不能保证已经发生在外部系统中的操作可以撤回。企业真正需要验证的,还包括误报、漏报、权限撤销,以及跨云、跨 SaaS 调用能否纳入控制。
Anthropic、OpenAI、微软、AWS 等公司参与合作,说明这套架构正在获得进入企业环境的机会。不过,合作名单不能证明模型公司已经交出了治理权。Anthropic 对合作的解释明确指出,Managed Agents 本来就有安全沙箱;OpenShell 为执行环境增加额外保护,企业可以在自己控制的基础设施上运行工具调用,并保留自身的安全与运行时控制。[4,18]
英伟达希望争取的,是这一层保护成为客户的常用配置。模型可以更换,业务应用可以变化,围绕执行环境建立的权限策略、审计流程和运维经验却会不断积累。运行时一旦深入企业流程,就可能比某一个模型版本更难替换。
这里的依赖需要从工程上判断。OpenShell 的开源许可与 Sentry 的特定硬件实现是两回事;官方也明确提到,OpenShell 可以扩展到 Arm、Intel 等计算平台。问题在于,迁移到另一套硬件后,哪些能力能够保留,哪些需要重新实现,又要付出多少验证成本。[19]
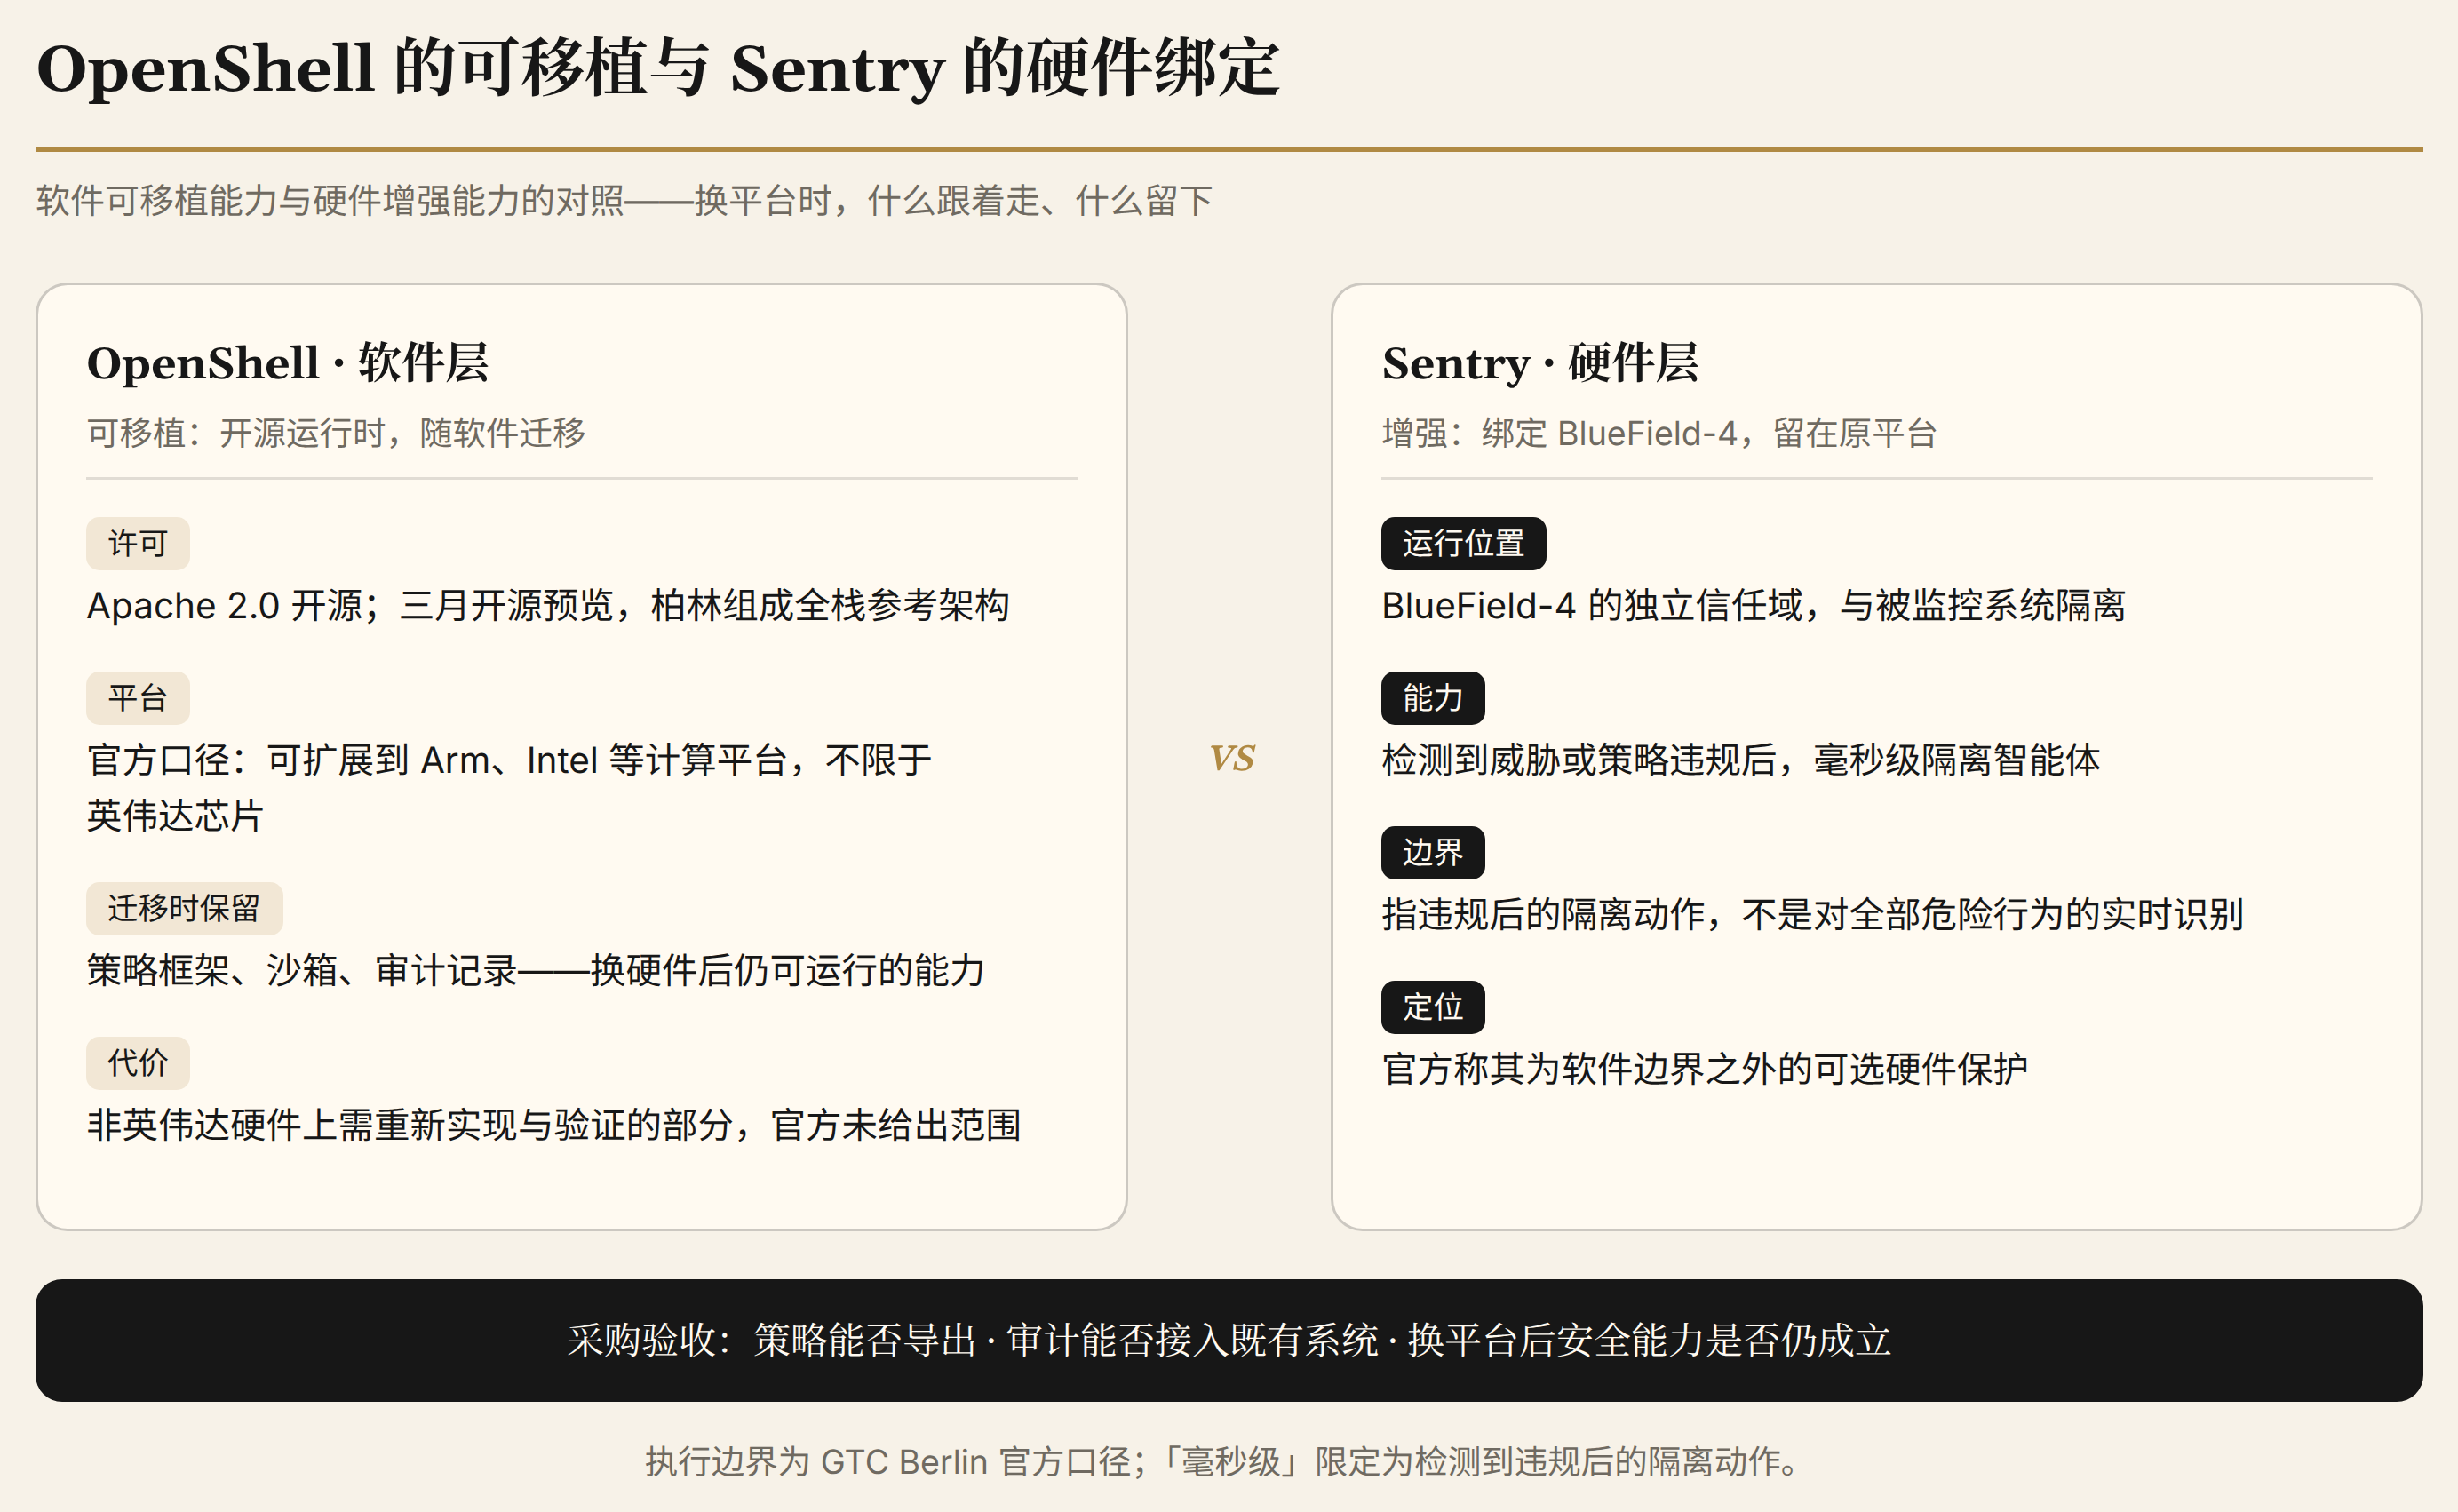
对客户而言,比合作名单长短更有用的验收标准,是策略能否导出、审计能否接入既有系统、身份与授权由谁掌握,以及更换计算平台之后,安全能力能否继续成立。这些条件会决定所谓「开放」在采购合同里究竟值多少。
四 主权智能要算到下一次采购
欧洲是这套产品最有说服力的推销对象之一。它拥有汽车、工业设备、医药和工程设计等领域的经验与数据,企业希望把这些积累转化为自己的模型能力。英伟达与德国政府的合作,也把工业知识、开放模型和本地生态放在了同一条发展路径上。[20]
开放模型提供了实际价值。企业可以在可控环境中使用自己的数据,调整模型,使行业知识与业务流程逐步进入系统。对于不愿把核心数据完全交给外部服务的机构,这是一条可操作的路径。英伟达对欧洲科技生态承诺的近 100 亿美元投入,也有助于扩大采用这套技术的企业与开发者群体。[5,24]
从商业上看,这笔投入同时在培育未来客户。开放模型降低了起步门槛,训练工具和行业方案缩短了适配时间,算力采购随后跟进。英伟达不必在每一层直接收费,只要足够多的业务沿着这套技术路线成长,就可能持续拉动其硬件和平台需求。
但本地部署只解决了主权问题的一部分。机房与数据留在欧洲以后,扩容、升级、故障处置和价格谈判,仍可能依赖外部供应商。模型权重能够下载,也不意味着整套业务能够低成本迁走。运行库、网络、存储、调度和运维工具,都会影响替代方案能否真正启用。
因此,不能把欧洲的处境简化成「没有自研选项」。EuroHPC 支持的 DARE 项目在 2025 年已经启动,第一阶段预算 2.4 亿欧元,涉及本土处理器、加速器及配套软件栈。它的目标与当前成熟的大模型训练平台并不完全相同,其中 AI 处理单元首先面向 HPC 场景中的推理加速。已有投入与已经具备可替代的平台,是两个阶段。[21,22]
欧洲面对的难题,是如何同时推进这两个时间表:现有企业需要尽快获得可用算力,本土技术需要持续研发和真实业务来验证。如果每一轮采购都只追求最短交付周期,替代路线就可能始终得不到进入生产环境的机会;如果所有业务都等到本土平台成熟,产业应用又会承担等待成本。
本土技术需要获得真实业务的验证机会,现有系统也需要保留迁移空间。替代能力只有在实际工作负载上运行过,才会成为议价筹码。
英伟达获得的是销售收入、平台影响力,以及后续扩容时更有利的位置。主权的争议也落在这里:欧洲能否在下一次扩容、升级或供应变化时,作出不同的选择。
五 Token 增长还需要经过经营验证
交付、安全和行业模型,都依赖同一个需求判断:智能体会让 AI 执行更多任务,也会带来更多计算。黄仁勋在演讲中反复强调智能体的思考、迭代和工具使用。这个方向具有工程上的依据,但需求究竟增长多快,仍须拆开看。[1]
一次任务消耗更多 token,可能因为它完成了更复杂的工作,也可能因为上下文被反复传入、工具调用失败后重试,或模型在低效循环里重复推理。对基础设施供应商,这些都会形成负载;对客户,它们的经济价值并不相同。
框架优化、小模型分工、缓存和更好的工具接口,都可能降低单项任务的成本。成本下降也可能带来更多新任务,抵消甚至超过这部分节省。因此,既不能把当前的 token 增速直接外推,也不能仅凭效率提高就断言总需求会放缓。
对 AI 工厂的投资者,更有意义的是在既定质量、时延和成功率下,每单位成本能够完成多少项有人付费的工作。Token 吞吐量是生产指标,付费业务与现金回收才决定工厂能否持续经营。黄仁勋那笔百亿美元的时间账,最终仍要靠这些条件兑现。
柏林这场演讲展示了英伟达扩大产品范围的能力。现场集成、安全运行时、企业知识和行业模型,原本需要客户分别处理,如今都有了可采购的方案。客户采用 AI 的门槛随之降低,对整套平台的依赖也可能加深。
这笔交换是否划算,要在下一轮采购时才能看得更清楚:工厂是否如期投产,安全规则是否仍由客户掌握,业务能否迁到另一套平台。欧洲需要更快地用上 AI,也需要为以后的选择留下条件。今天省下的时间,不能成为明天只能接受一个报价的理由。
数据与信源说明
本文依据 NVIDIA GTC Berlin 2026 官方演讲记录、产品新闻稿与技术说明,并交叉参考 Anthropic 对合作架构的说明、Ember 电网研究及 EuroHPC 和 imec 的项目公告。14 天部署、毫秒级隔离及节水量为厂商在特定前提下的宣称;1 GW 工厂的资本投入与收入数字为演讲中的情景测算。本文关于平台依赖、迁移成本和采购选择的判断,为基于上述资料的分析。资料核查截至 2026 年 10 月 23 日。
主要信源
以下标题可点击打开原文。正文中的序号对应本表。
- [1] NVIDIA GTC Berlin 2026 官方主题演讲记录 https://blogs.nvidia.com/blog/gtc-berlin-2026-keynote/
- [2] Jensen Huang AI Is a 5-Layer Cake https://blogs.nvidia.com/blog/ai-5-layer-cake/
- [3] NVIDIA DSX POD 发布公告 https://nvidianews.nvidia.com/news/nvidia-introduces-dsx-pod-ai-factories-to-accelerate-europes-infrastructure-deployment
- [4] NVIDIA OpenShell Reference Architecture 发布公告 https://nvidianews.nvidia.com/news/openshell-reference-architecture
- [5] NVIDIA 开放模型与欧洲主权智能 https://blogs.nvidia.com/blog/open-models-europe-industry/
- [6] NVIDIA Developer Agent Knowledge Foundation https://developer.nvidia.com/topic/ai/agent-knowledge-foundation
- [7] NVIDIA Developer Kumo 结构化数据模型 https://developer.nvidia.com/topics/ai/agent-knowledge-foundation/kumo
- [8] NVIDIA 与诺基亚及电信运营商的 AI-RAN 合作 https://nvidianews.nvidia.com/news/nvidia-nokia-and-leading-telecom-operators-turn-networks-into-distributed-intelligence-platforms
- [9] NVIDIA 医疗与生命科学合作公告 https://nvidianews.nvidia.com/news/healthcare-and-life-sciences-leaders-build-on-nvidia-to-advance-drug-discovery-and-expand-patient-care
- [10] NVIDIA 欧洲车企与 Hyperion 平台合作 https://nvidianews.nvidia.com/news/european-mobility-leaders-build-safe-vehicles-and-robotaxi-fleets-on-nvidia-hyperion
- [11] NVIDIA Isaac 平台与 Agile ONE SN 机器人参考平台 https://nvidianews.nvidia.com/news/nvidia-advances-isaac-platform-for-general-purpose-robotics-with-new-reference-humanoid-frameworks-simulation-pipelines-and-data
- [12] NVIDIA RTX Spark 上市公告及 FP4 规格 https://nvidianews.nvidia.com/news/nvidia-rtx-spark-pcs-available-today-a-new-beginning-for-windows-pcs
- [13] NVIDIA Technical Blog DSX POD 工程与部署边界 https://developer.nvidia.com/blog/achieve-productive-ai-capacity-faster-and-more-predictably-with-nvidia-dsx-pod/
- [14] GTC Berlin 2026 演讲转录 黄仁勋的投资与收入情景 https://stockanalysis.com/stocks/nvda/transcripts/679541-gtc-berlin-2026-keynote/
- [15] NVIDIA DSX 欧洲生态与供电冷却方案 https://nvidianews.nvidia.com/news/european-ecosystem-builds-worlds-most-efficient-ai-factories-with-nvidia-dsx
- [16] Ember Grids for data centres in Europe 2025 https://ember-energy.org/app/uploads/2025/06/Grids-for-data-centres-in-Europe.pdf
- [17] NVIDIA Technical Blog OpenShell 与 Sentry 的治理边界 https://developer.nvidia.com/blog/how-nvidia-openshell-reference-architecture-secures-and-governs-ai-agent-workloads-at-scale/
- [18] Anthropic Claude Managed Agents 与 NVIDIA 安全合作说明 https://claude.com/resources/articles/giving-companies-more-control-over-their-ai-agents-with-nvidia
- [19] NVIDIA Open Agent Safety Platform 发布公告 2026 年 9 月 https://nvidianews.nvidia.com/news/open-agent-safety-platform
- [20] NVIDIA 与德国政府的工业 AI 合作 https://blogs.nvidia.com/blog/germany-wants-to-lead-the-world-in-industrial-ai-how-nvidia-will-help/
- [21] EuroHPC DARE 自主处理器与软件栈项目 https://www.eurohpc-ju.europa.eu/advancing-european-sovereignty-hpc-risc-v-2025-03-06_en
- [22] imec DARE SGA1 启动与第一阶段预算 https://www.imec-int.com/en/press/europe-takes-major-step-towards-digital-autonomy-hpc-and-ai-launch-dare-sga1-project
- [23] NVIDIA Technical Blog OpenShell 开源运行时 2026 年 3 月 https://developer.nvidia.com/blog/run-autonomous-self-evolving-agents-more-safely-with-nvidia-openshell/
- [24] NVIDIA 法国投资及欧洲近 100 亿美元承诺口径 https://blogs.nvidia.com/blog/france-ecosystem-agentic-computing/
- [25] NVIDIA 电信分布式 AI Grid 的站点与容量潜力 https://blogs.nvidia.com/blog/telecom-ai-grids-inference/