
OCP2026|AI网络开放继续深入
从交换芯片适配扩展到端点协同与平台管理
开放网络过去的一项重要进展,是让同一套软件适配不同交换芯片。OCP 2026把这条路线推进了两步:主机端点开始更深地参与网络流量分配,交换机的平台管理也开始寻求共同接口。带宽提高仍然重要,但本届更值得追踪的问题是,硬件选择增加之后,哪些协同和管理工作也能随之复用。
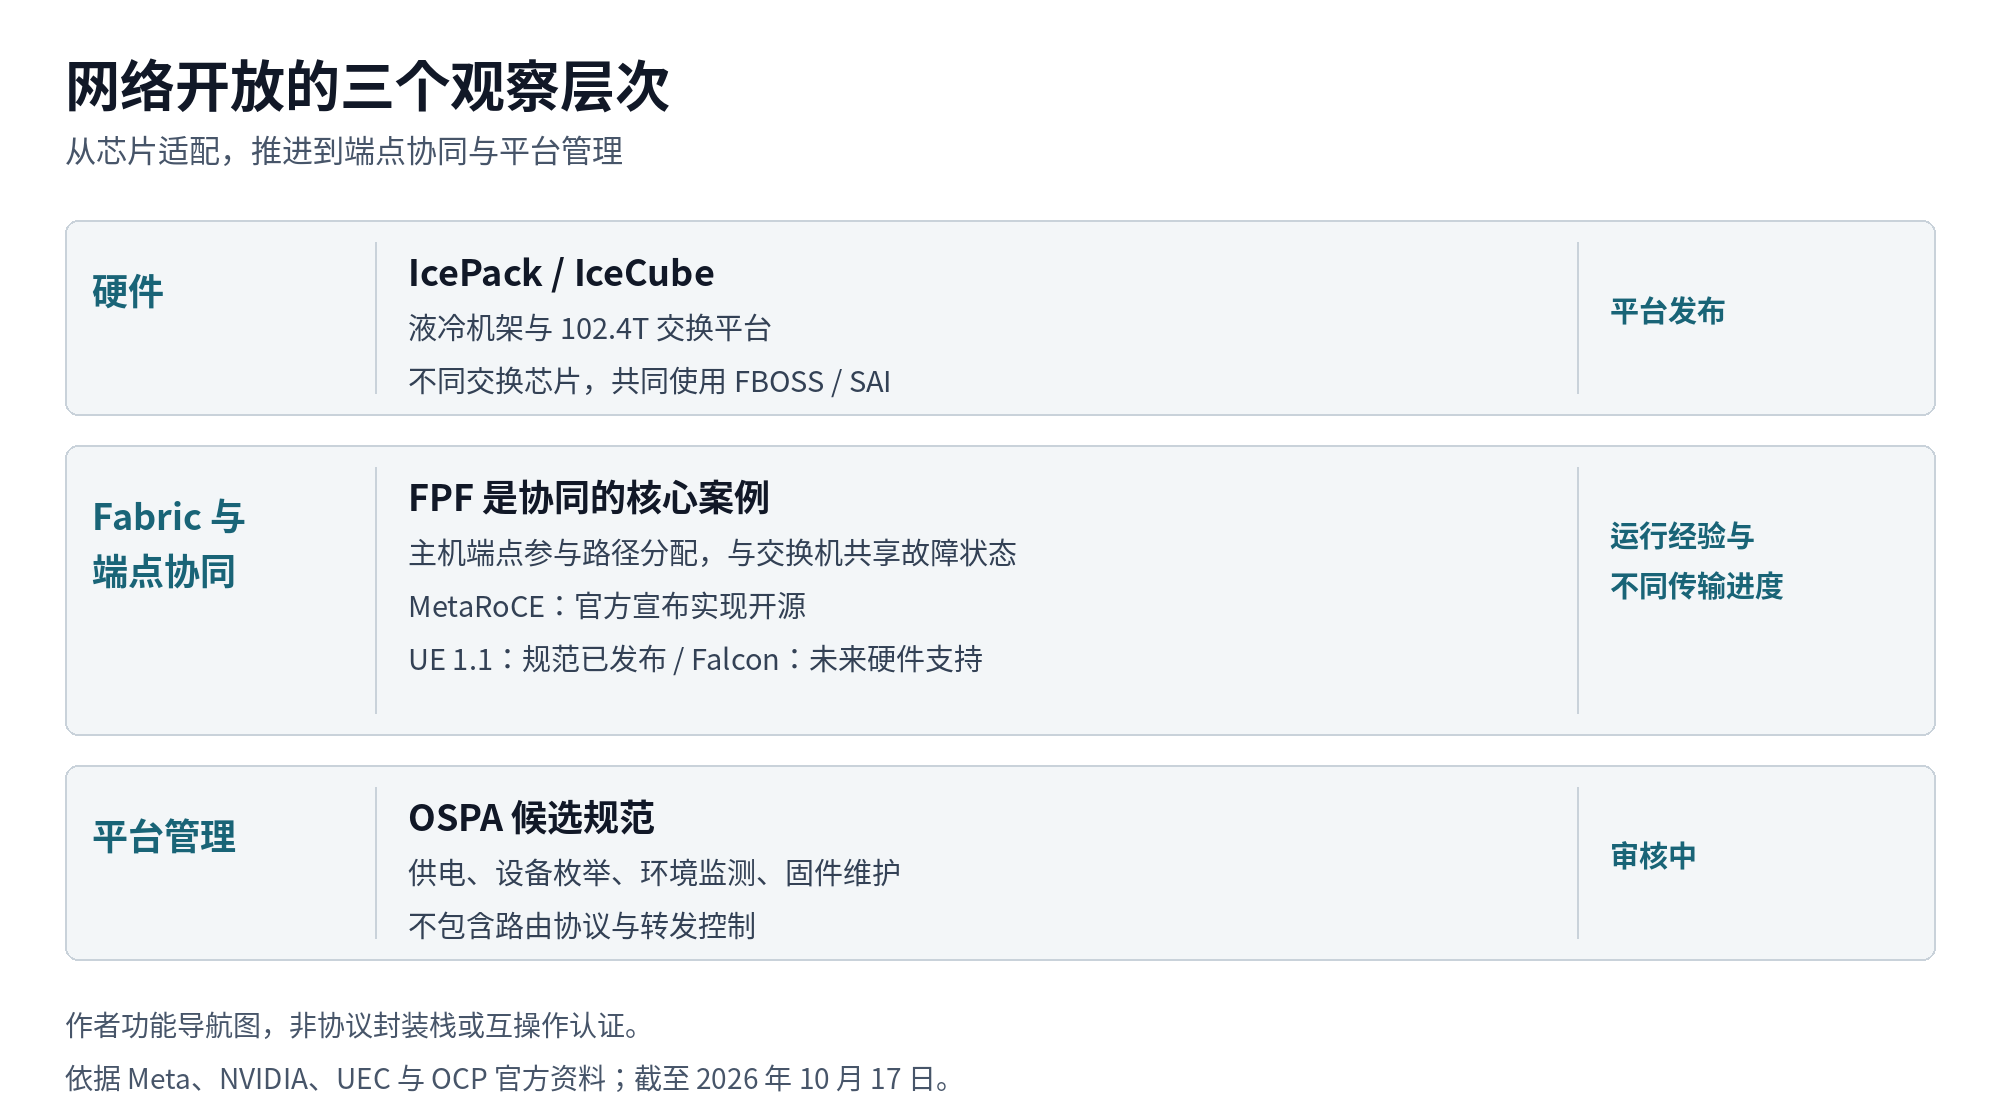
本文沿三层阅读这些变化。硬件层看IcePack与IceCube怎样把更高交换容量装进液冷机架;Fabric与端点协同层以FPF多平面为核心,解释更多路径为什么需要更聪明的端点;平台管理层看OSPA如何减少新设备反复适配的工作。MetaRoCE、UE 1.1与Falcon分别放回第二层的实现、标准和产品支持进度,不把它们当作同一场速度排名。[1][2][3][4]
同一套网络软件开始支持更多交换硬件
Meta本届公布的IceCube交换刀片提供102.4 Tbps容量,达到其前代51.2T平台的两倍,并装入IcePack液冷网络机架。产品有Broadcom Tomahawk6C和NVIDIA Spectrum-6两种芯片版本,共同使用FBOSS网络操作系统及OCP SAI。后者为软件控制交换硬件提供共同接口,使芯片选择与上层软件之间可以保留更清晰的边界。[1]
NVIDIA将Spectrum-6版本称为N-IceCube,并明确其进入IcePack平台。[2] 这比笼统说“开放网络支持多种芯片”更具体:运营方正在尝试围绕一套软件栈组织不同交换硬件。公开材料支持平台与合作进展的判断,但没有完整披露所有配置的交付节奏、量产数量和现场可靠性数据。
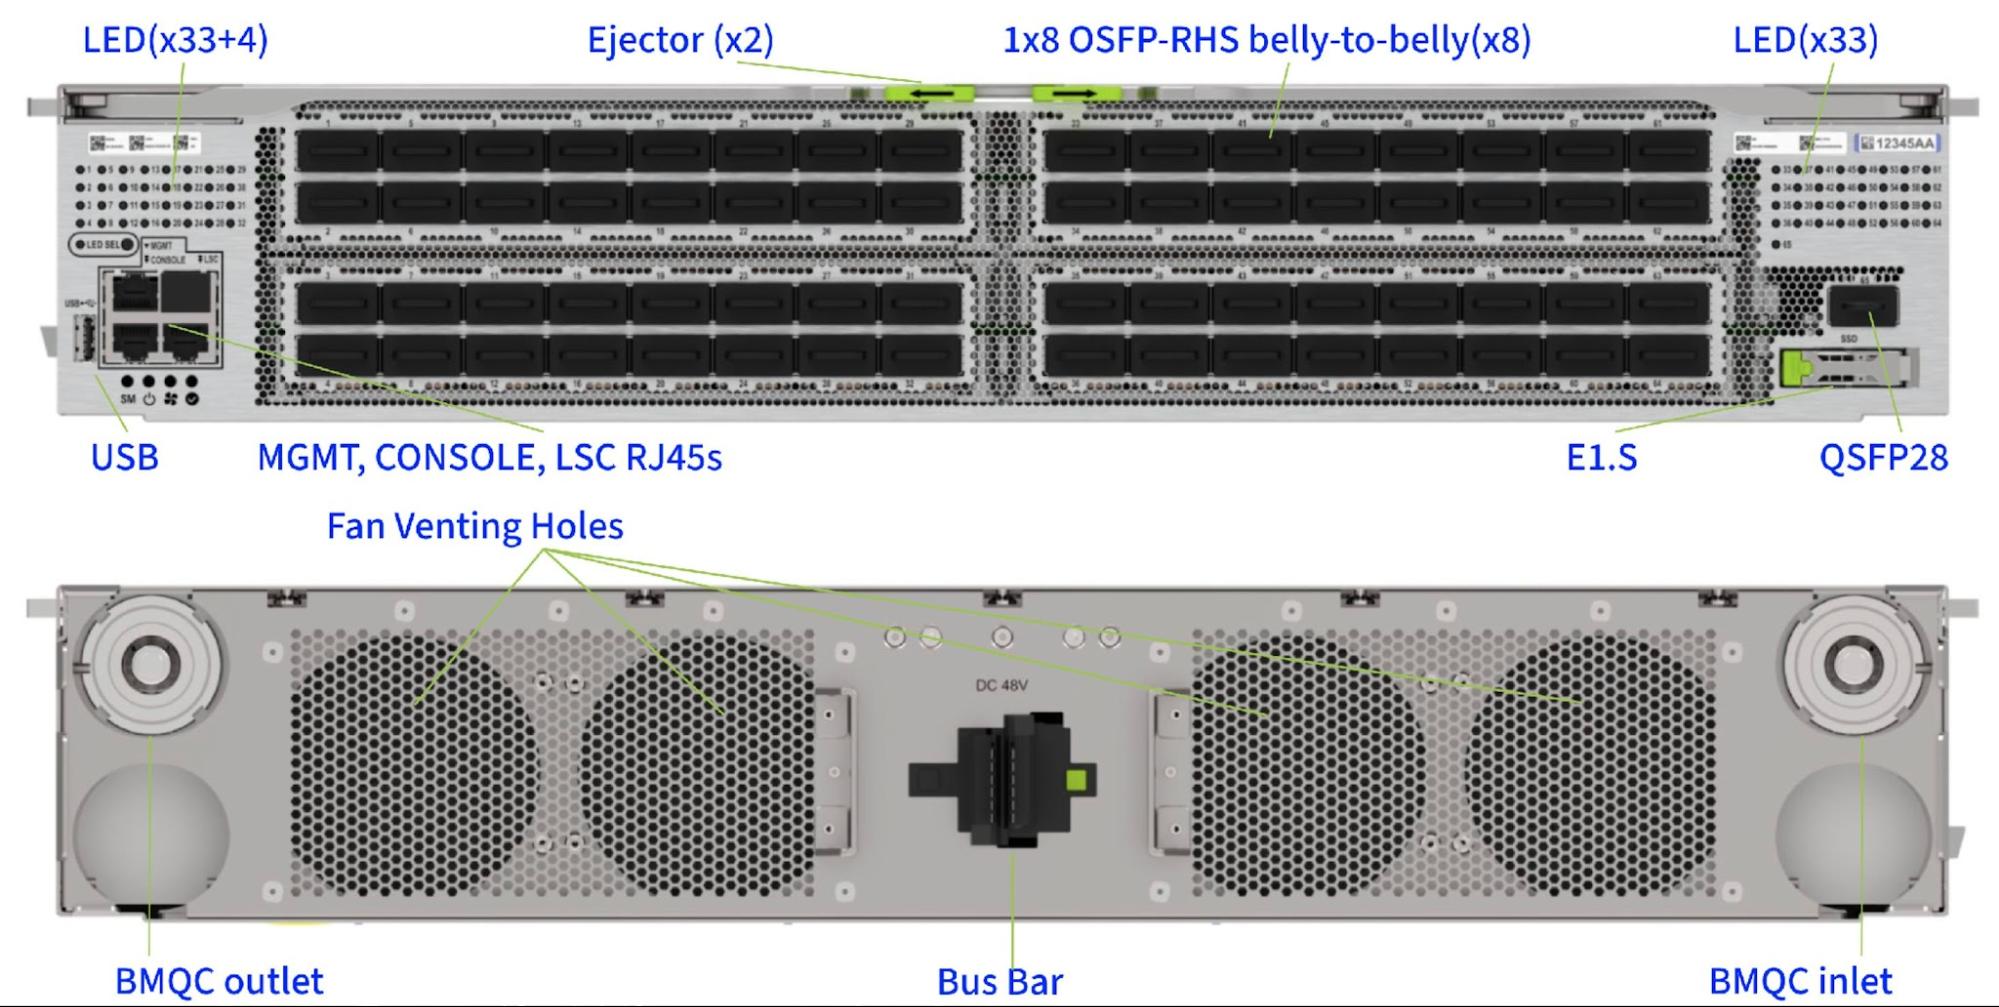
容量提高可以在适当拓扑下连接更多端点,或减少实现同等规模所需的设备和层级。它不会自动变成GPU作业提速:如果端点注入能力、光模块或上联配置没有同步改变,额外交换容量就可能暂时用不上。因此,102.4T说明产品获得了怎样的连接条件,实际收益还要沿数据路径往前看,到发送数据的主机端点为止。
液冷把另一些条件也拉进了网络交付。交换刀片更换、歧管维护和冷却故障的影响范围,都需要与网络冗余一起考虑。过去分别由网络和设施团队处理的接口,开始出现在同一配置里。更高热密度因此既是扩容机会,也要求设备在散热、供电及维修方面具备可重复的系统设计。
FPF让端点与Fabric共同决定有效带宽
FPF是理解第二层变化最直接的案例。Meta的Flattened Planar Fabric让每个GPU经八条独立链路接入八个网络平面,由NIC在硬件中分配报文,并把原有三层Clos收敛为两层。Meta说明该方案已经在其基础设施运行,运行经验也正与云合作伙伴共享。[1] 这是一项实际系统经验,具体链路配置列在技术说明中。
变化的重点不是平面数量,而是流量分配的责任向主机移动。交换机提供路径,NIC在发送时就参与选择,主机还需要获得路径状态。如果一个平面退出,继续向它平均分配流量会浪费可用带宽;如果一个平面只是变慢,系统又不能只用“连通或断开”两种状态处理。端点和交换机必须共同识别这些变化,才可能把剩余资源有效用起来。
以一个说明性场景为例:某条路径的容量下降,但其他路径仍然健康。网络若继续等量分流,部分数据会不断积压在慢路径;若发送端调整分配比例,才有机会利用其他路径的余量。这个例子说明协同需要解决的问题,不是FPF在某个故障测试中的实测结果。是否能够及时发现退化、调整后是否出现新的拥塞,都取决于具体实现。
多路径也改变了接收端看到的数据。同一操作的报文可能先后经过不同路径,到达顺序因此变化;一部分报文还可能丢失或重传。传输机制必须在这种情况下维持可靠完成,而应用仍希望继续使用明确、稳定的通信接口。拓扑、传输与应用语义便在这里连接起来:它们分属不同层,却不能各自独立选择最理想的行为。
这解释了为什么只增加交换机路径,并不够完成多平面产品化。NIC如何分流、交换机如何反馈状态、传输怎样处理乱序和丢失,需要在同一套配置中验证。对运营方,真正有用的比较是相同GPU规模和负载下的有效通信时间,以及部分路径退化后的行为。健康状态下的线速只是其中一项证据。
传输开放分别推进实现 标准与硬件支持
本届几项传输消息,应放在FPF所代表的协同需求之后阅读。MetaRoCE的机制在2026年8月已经公开,本届Meta官方宣布实现开源。其设计围绕逐路径状态、乱序接收与有损网络上的可靠传输展开,回答的是端点怎样利用多条并不总是完美的路径。[1][5]
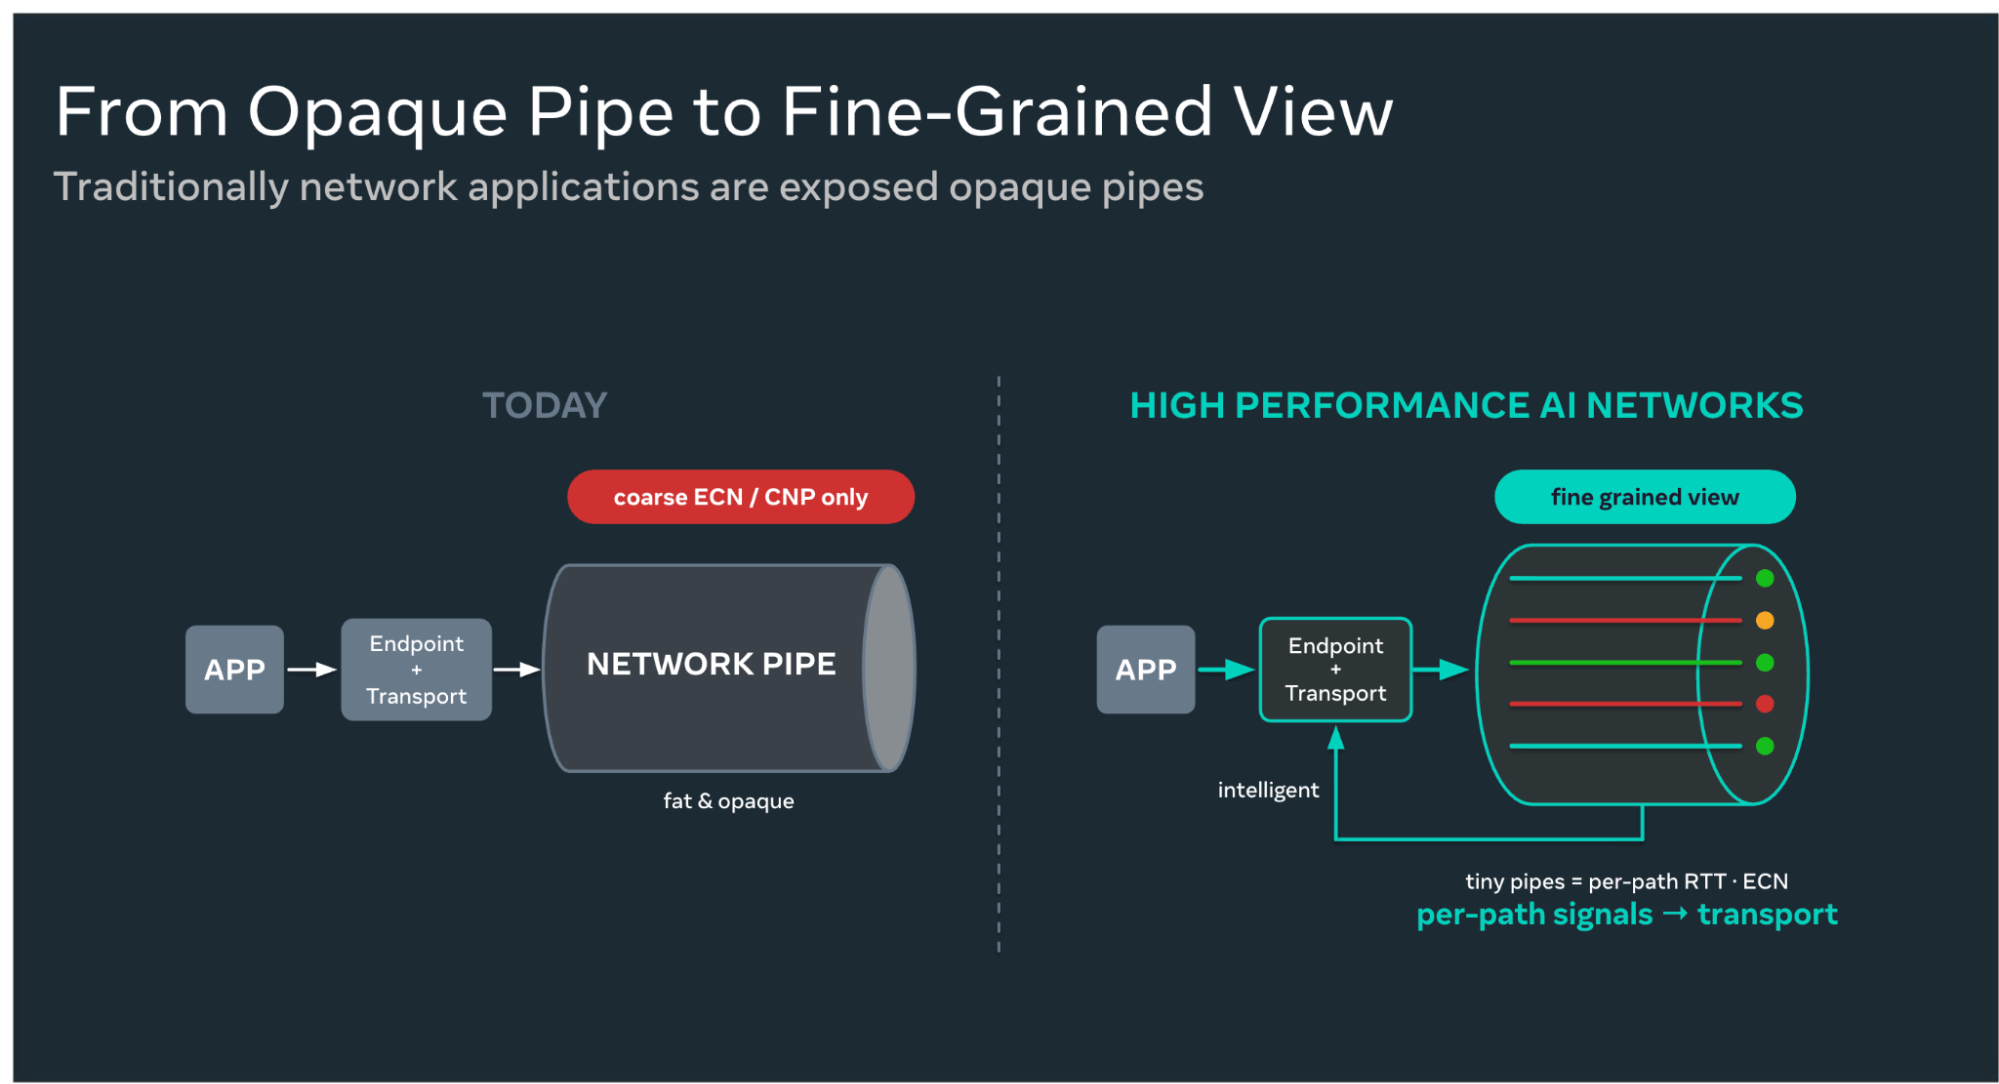
宣布开源为采用者进一步检查实现提供了方向,实际采用仍须确认代码位置、版本、许可证和硬件适配范围。一个实现即使可以取得,也未必直接适用于任意NIC;驱动、固件、测试环境以及应用完成和错误语义,都可能形成移植工作。本文对MetaRoCE开源进展的依据是官方公告,没有把它扩写为已核验的代码仓库或可部署版本。
UEC在10月12日正式发布UE Specification 1.1,推进的是共同标准。新增能力涉及应用接口兼容、网络参与集合通信、拥塞信息传递和可编程控制,同时也包含面向Scale-up的优化。它由Ultra Ethernet Consortium发布,与OCP的ESUN是不同规范;双方的协作不能被理解为两个版本名称可以互换。各项机制的作用与性能边界放在技术说明,正文关注其对生态的影响:更多实现可以围绕共同语义和接口开发。[3]
Falcon则体现未来硬件支持合作。Google与NVIDIA宣布,未来ConnectX-10 SuperNIC和BlueField DPU将支持Falcon Transport,结合硬件加速与DOCA软件,并以保留标准RDMA编程接口为目标。这是一项产品路线图,尚不能写成当前所有相关设备已经支持Falcon。[2]
这些消息并不证明传输生态已经收敛为一种协议。它们分别推进实现公开、共同规范与硬件支持,也留下不同的适配工作。对计划采用开放网络的团队,合适的下一步不是先选一个名称,而是明确应用依赖哪些语义、目标端点能执行哪些机制,再检查标准与产品之间还有哪些空白。
OSPA把开放推进到交换机平台管理
第三层变化发生在数据转发之外。Meta、Microsoft和Alibaba发起OSPA,试图为交换机的平台管理建立共同参考架构。OCP在10月8日将其Revision 1.0.0 candidate标为正在基金会审核的贡献;它仍是候选规范,不能当作正式批准的最终版本。[4]
这项工作的动因是一个具体的重复成本。SAI等接口帮助软件跨交换芯片适配,但同样的ASIC装进不同整机之后,电源、传感器、设备枚举和固件维护仍可能表现得不同。每增加一个硬件型号,软件团队就要重新接入这些平台功能。芯片升级越快,这些看似外围的工作越容易影响新设备导入速度。
OSPA尝试统一供电管理、硬件访问、资产枚举、环境控制、固件恢复和诊断等平台接口。它不覆盖路由协议与转发表控制,因而也不取代FBOSS这样的网络操作系统。可以把它理解为补齐数据平面接口之外的设备管理边界:软件不仅要知道怎样转发数据,也要稳定地识别、监测、升级和恢复承载这些功能的整机。[4]
这对不同参与者有不同价值。OEM和ODM有机会复用平台设计,减少按客户重复开发;运营方有机会用一致的日志、遥测和恢复流程导入更多硬件。收益能否兑现,取决于候选规范之后的实现、测试和版本治理。支持SAI的产品并不自动符合OSPA,参与起草的厂商也不意味着全部产品已经实现它。
判断这类开放接口的实用价值,可以看更换供应商时剩下多少工作:哪些软件可以保留,哪些测试必须重做,哪些故障处理流程需要调整。多家硬件进入采购清单只是开始;若每次替换仍需大量一次性适配,供应选择就难以转化为持续的运营弹性。OSPA值得追踪,正因为它针对的是规格表之外、却反复消耗工程时间的部分。
BAG说明开放网络仍有距离边界
更大的本地Fabric还可能通过BAG等聚合层向多楼宇和园区扩展。Meta在2026年2月已经公开BAG,本届继续介绍运行机制和区域骨干网,应将它视为既有架构的扩展经验。园区、城域与广域也必须分别讨论,不能因为都称为Scale-across就忽略距离和控制域的差别。[1][6]
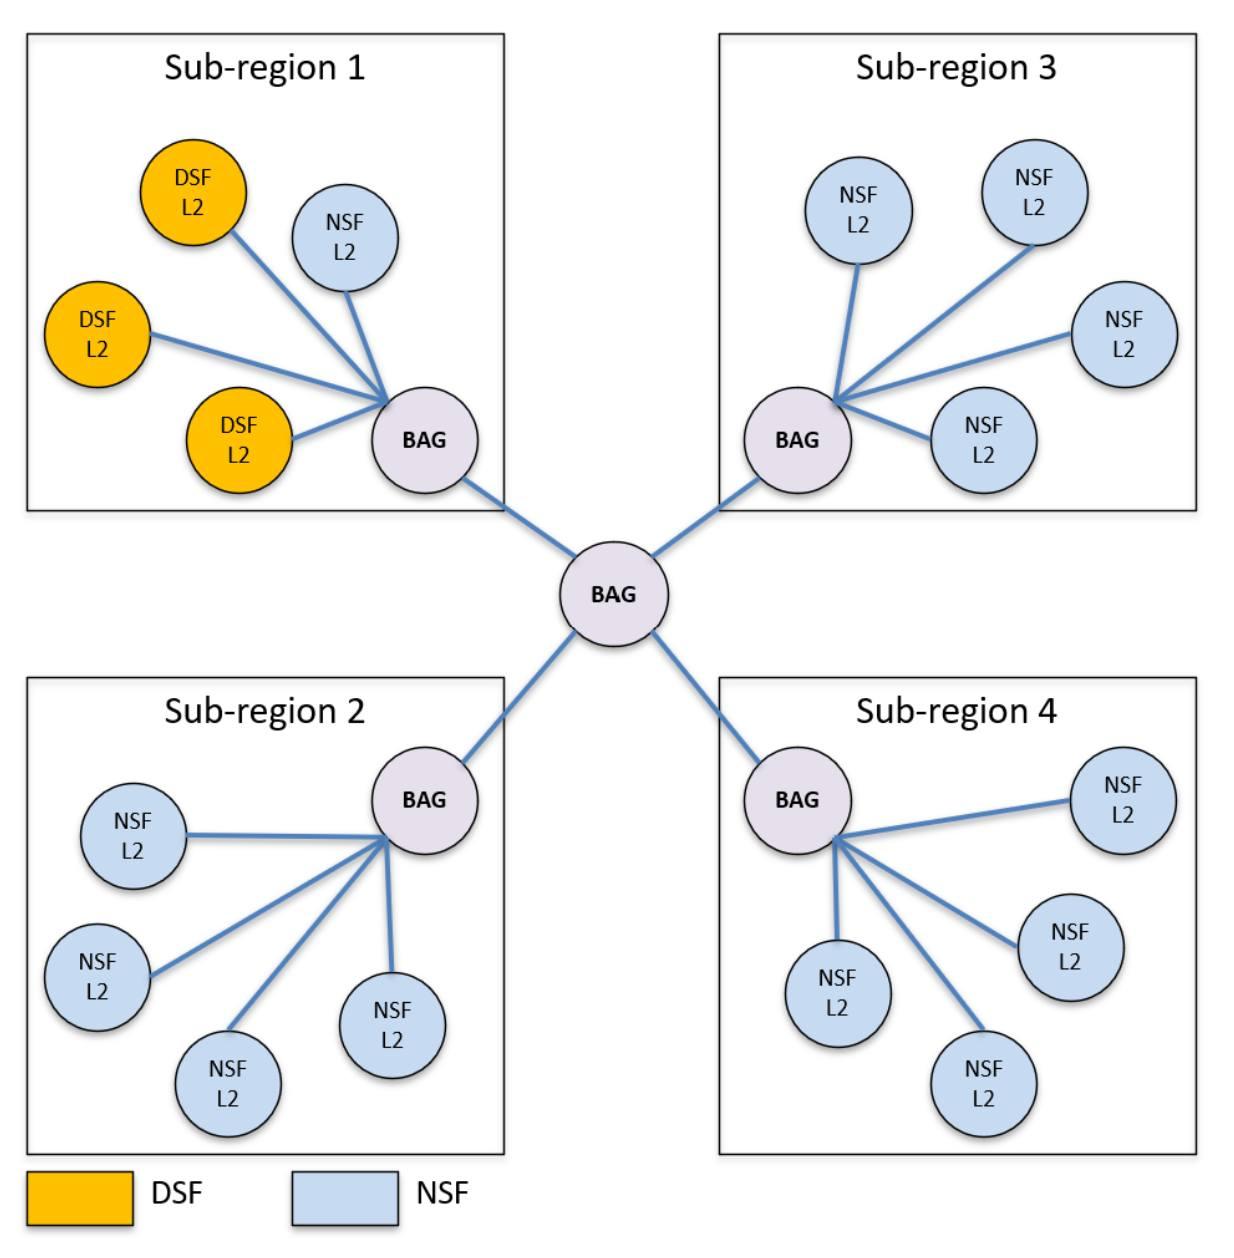
端点控制能更充分地使用现有路径,却无法消除光纤传播时间;多个平面可以提供替代路径,也不保证底层光纤路由彼此独立。高频同步应放在适合的低时延范围内,再依据模型的实际通信需求安排跨域流量。BAG为扩展提供结构,跨域有效产出仍要经过容量、竞争和故障条件的验证。
Meta分享的云伙伴统一点到点与集合测试,也说明接口一致之后仍需共同交付基线。[1] 端点行为、拥塞策略、遥测和版本组合能够重复验证,不同来源的容量才有机会被稳定地统一使用。这一要求适用于跨园区扩展,也适用于更换一个本地网络供应商。
下一步是减少端点与平台的重复适配
本届网络开放的主线,是把可复用的边界从交换芯片继续向外推进。IceCube展示同一软件栈面向不同硬件的产品实践;FPF说明主机端点与Fabric必须共同工作;传输相关发布分别推进实现、标准和未来硬件支持;OSPA则尝试减少整机管理层的重复适配。它们带来的共同机会,是让硬件变化不再要求上层系统处处重新开始。
因此,建设者应把开放性落实为可验证的迁移能力。换一代芯片或一家整机供应商后,应用接口是否稳定,路径退化时是否仍能维持可靠完成,设备枚举与固件恢复能否沿用共同流程,都比单独统计支持了多少协议更有意义。成熟度不同的发布可以同时值得跟踪,但必须分别进入试点、产品选型和长期规划。
OCP 2026并未宣告所有网络层已经统一。它让下一步工作变得更清楚:在保持硬件选择的同时,降低端点协同和平台管理的集成成本。谁能够用清楚的接口、版本与测试证明这种可移植性,谁的开放网络方案才更容易被反复部署。
技术说明
硬件容量与公开验证口径
IceCube公布102.4 Tbps、128×800G的交换容量,并有Tomahawk6C和Spectrum-6两种芯片版本;IcePack基于ORV3-HPRv1。官方设计图不能用来判断两个版本的全部结构相同,也不提供量产规模证明。[1][2]
Meta披露的FPF配置为每GPU八条100G链路,分别进入八个平面,合计800G连接规模,而非每个平面都向该GPU提供800G。拓扑从三层Clos收敛为两层,主机与交换机共同参与故障控制;这些运行经验不能直接替任意客户配置保证性能。[1]
2026年8月的MetaRoCE资料公开了64节点AMD GPU硬件验证和多平面故障场景。它们支持对机制的判断,不能单独证明百万GPU或任意广域距离上的生产指标。本届官方宣布实现开源;本文未核验具体代码仓库、版本、许可证及部署可用性。[1][5]
UE规范新增机制分别解决什么问题
UET Verbs兼容改进旨在降低应用迁移代价。保持应用接口并不代表底层完全无需修改,还需要确认实现支持的语义、资源模型和错误处理范围。[3]
网络内集合通信INC把部分规约等操作放进网络。UEC用规约与广播的通信量说明某些过程可减少数据传输,并给出最多两倍通信收益的示例;这不是训练或推理整体提速两倍。应用在相关操作上花多少时间、交换机实现哪些运算、数值与故障语义是否满足要求,都会影响最终收益。[3]
拥塞信号CSIG将沿途瓶颈信息带给端点,帮助控制算法依据更具体的网络状态调整;可编程拥塞管理PCM提供共同的编程接口,便于围绕工作负载开发控制策略。前者改善可见性,后者改善控制逻辑的表达与可移植性;实现某一项,不等于实现全部UE 1.1功能。[3]
UE 1.1还包含面向Scale-up的优化。其发布机构为UEC,与OCP ESUN的范围和版本进度不同;UEC公告说明双方正在协调下一版ESUN及端点相关工作。ESUN的产品与规范进度另见Scale-up专题。[3]
采用时要固定的兼容边界
MetaRoCE的官方开源宣布、UE 1.1正式规范发布与Falcon未来硬件支持合作,是不同类别的证据。应用接口相似不能代替线上的协议兼容验证,公开规范也不能代替具体网卡、固件和驱动的实现清单。[1][2][3]
OSPA处于候选审核阶段,范围为交换机平台管理;路由协议和转发控制不在其中。硬件层应确认端口、供电、散热与软件版本,端点协同层应确认分流、拥塞与故障处理,平台层应确认导入、升级和回退。测试保持工作负载与可靠性目标一致,才能比较不同组合。[4]
来源与口径
资料截至2026年10月17日。IceCube为本届公布的产品平台;FPF按Meta披露的运行经验描述;MetaRoCE区分8月机制介绍与本届官方宣布实现开源,未据此核验代码仓库与许可证;UE 1.1已发布但不归为OCP自有标准;OSPA为审核中的候选规范;Falcon支持为未来产品计划。文中的集成、采购及经济影响判断为作者分析,不是厂商性能承诺。
[1] Meta,OCP Summit 2026 Powering AI with Open Innovations in Scale-Up Scale-Out and Scale-Across Networks,2026年10月12日
https://engineering.fb.com/2026/10/12/open-source/ocp-summit-2026-powering-ai-with-open-innovations-in-scale-up-scale-out-and-scale-across-networks/
[2] NVIDIA,Amid Ecosystem Adoption NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide,2026年10月12日,Spectrum-6与Falcon章节
https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
[3] Ultra Ethernet Consortium,Ultra Ethernet Consortium Releases Specification 1.1 Advancing AI and HPC Networking,2026年10月12日
https://ultraethernet.org/ultra-ethernet-consortium-releases-specification-1-1-advancing-ai-and-hpc-networking/
[4] OCP,Introducing OSPA Unifying the Switch Platform Layer for Open Networking,2026年10月8日
https://www.opencompute.org/news/introducing-ospa-unifying-the-switch-platform-layer-for-open-networking/
[5] Meta,MetaRoCE A New RDMA Transport Built for AI-Scale Ethernet,2026年8月24日
https://engineering.fb.com/2026/08/24/networking-traffic/metaroce-rdma-transport-ai-ethernet/
[6] Meta,Building Prometheus How Backend Aggregation Enables Gigawatt-Scale AI Clusters,2026年2月9日
https://engineering.fb.com/2026/02/09/data-center-engineering/building-prometheus-how-backend-aggregation-enables-gigawatt-scale-ai-clusters/