
OCP 2026 机架越来越开放
平台为何仍难替换
芯片供应与部署能力正在共同约束 AI 基建。NVIDIA 扩大机架、设施和运维软件的开放范围,AMD 用 Helion 组织 agent 的执行与推理资源,Intel 则强调既有风冷设施里的扩容机会。三种路线争夺的都是更快上线的能力;但图纸可得、部件可换与平台可迁移,仍是三回事。
2026 年 10 月 12 日至 15 日,Open Compute Project(OCP)全球峰会在圣何塞举行。NVIDIA 贡献 Vera Rubin 相关机架与计算托盘设计,AMD 宣布计划贡献 Helion 机架规范,Intel 更新 GPU D 系列推理卡,并展示开放加速卡形态与 Xeon 机架生态。把这些发布放在一起,最值得注意的不是谁又多了一张卡,而是厂商正在把多少原本需要逐个项目协调的工作,变成伙伴能够共同实现的接口。[1]
这不是领先者突然拥抱开放的故事。早在 2024 年,NVIDIA 就已向 OCP 贡献 MGX/GB200 NVL72 的机架及托盘设计。2026 年的新变化,是开放继续向更高功率的机架、设施条件、电网行为和部署软件扩展。与之同步,前沿大规模集群的采购与验收边界也在扩大:买方越来越需要评估一套可上线、可维护的系统,而非只比较单卡性能。[2]
“机架的开放战争”因此有一个更具体的含义:谁能让更多制造商、集成商和运营商围绕自己的架构工作,谁就更有机会成为下一轮建设的默认选择。开放可以扩大供应选择,也可以扩大某个平台的覆盖范围。这两件事并不矛盾。
瓶颈没有整齐地搬家
过去两年,讨论 AI 基建往往从 GPU、HBM 和先进封装的供应开始。到 2026 年秋天,这些约束没有消失,电力接入、冷却改造、机架集成与验收却也越来越难绕开。与其宣布瓶颈已经从芯片“转移”到部署,不如说,决定上线日期的关键路径正在因项目而异。
NVIDIA 在 8 月财报电话会上同时谈到供应约束,以及土地、电力和厂房需要提前两三年筹备。这解释了厂商为什么同时关心供应和部署:即使拿到了加速器,其他前置条件也未必同步就绪。IEA 的分析则估计,电网约束可能推迟约 20% 原计划在 2030 年前建成的全球数据中心容量。前者是公司的经营判断,后者是情景分析;两者都支持部署约束的重要性,但都不能证明芯片从此不再稀缺。[3] [4]
可以把一个项目的上线过程简化成几条并行路径:设备交付、电力接入、冷却和网络准备,最后汇合到系统集成与验收。在前置工程能够并行、最终验收必须等待它们完成的简化条件下,上线时间接近“最晚就绪的前置条件,加上剩余集成验收时间”。真实项目存在交叉施工和分阶段投产,这个关系是用来辨认约束的示意,不是工期预测。
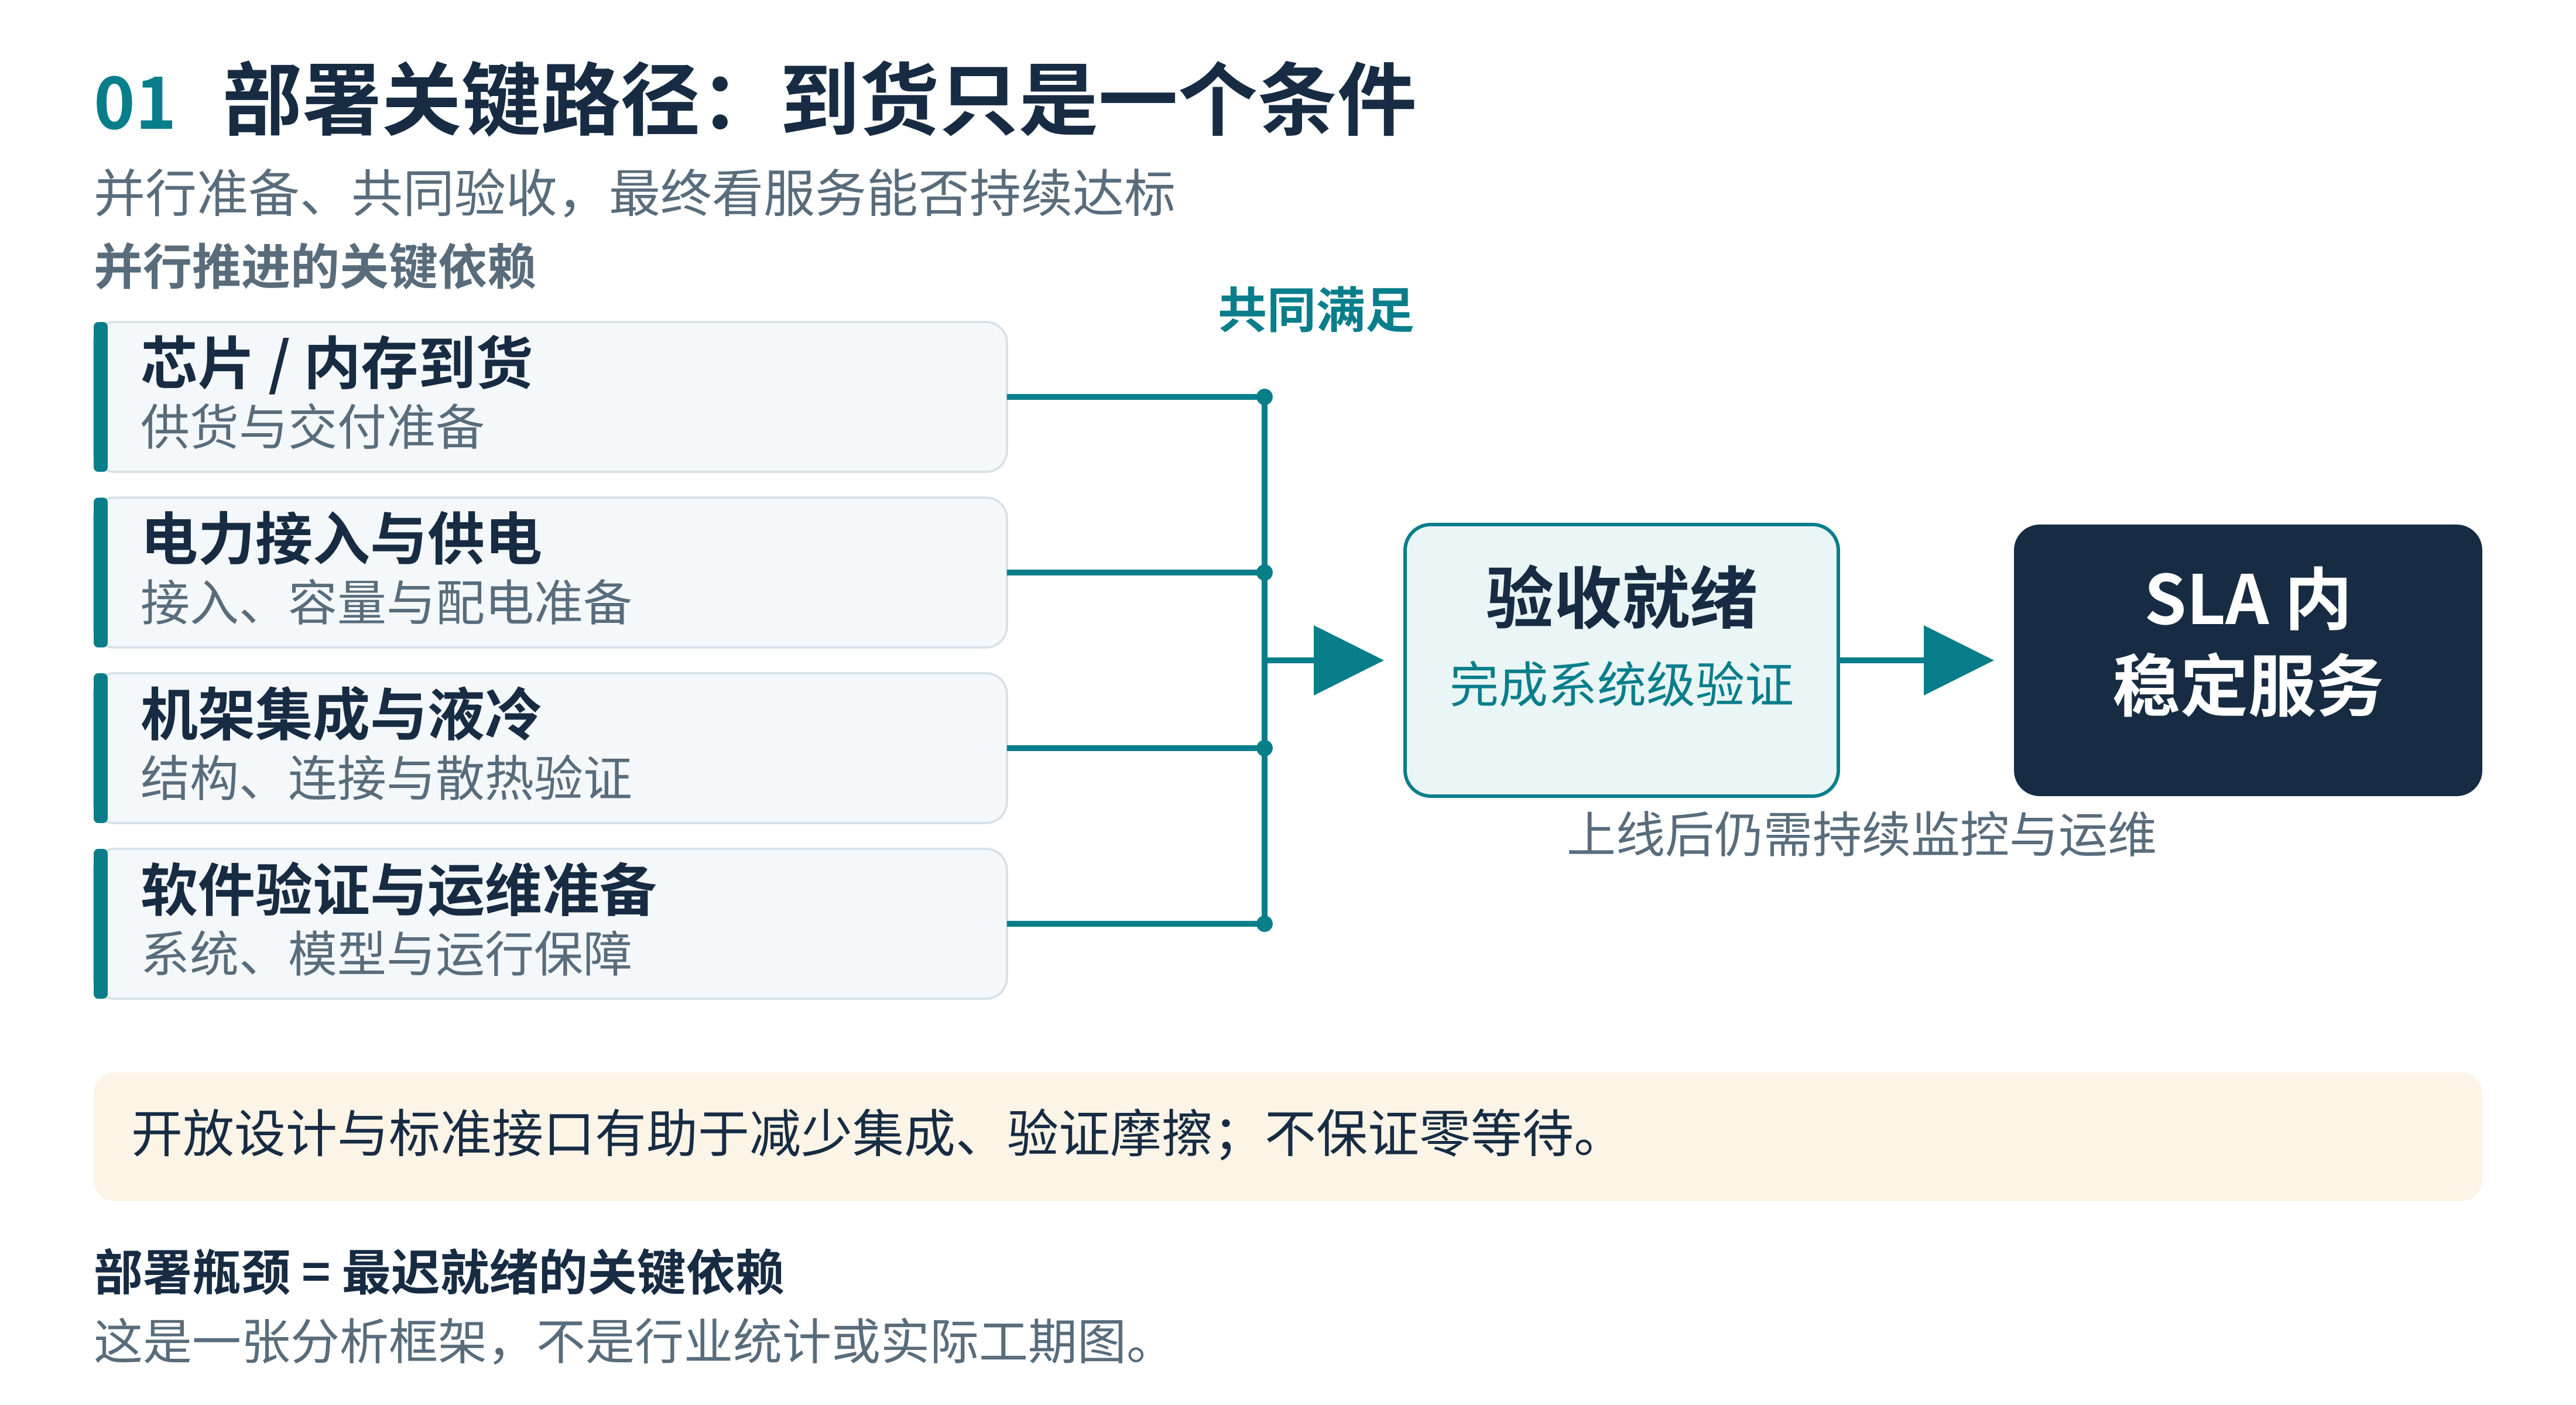
开放参考设计的价值就在这些交界处。制造商可以更早知道机架的机械边界,电源与冷却供应商可以围绕共同接口备货,集成商不必为每个客户重新发明一套连接方式。标准化若能减少返工,就可能缩短从设备到达至可用算力的时间。
但这是一条需要验证的因果链。公布规范,是厂商试图减少部署摩擦的证据;它还不是交付周期已经缩短的证据。真正能检验这轮开放的指标,应包括合格供应商数量、首次验收通过率、现场调试时间和故障更换时间,而不只是贡献了多少份文件。
开放 要过四道门
在比较三家公司之前,需要先拆开一个被反复使用的词。
第一道门是规范可得:公开了什么文件,按什么许可使用。第二道门是可实现:设计资料、关键部件与实现条件是否足够,别人能否真正造出来。第三道门是可互换:不同供应商的部件是否通过兼容验证,换件会不会影响安全、性能与保修。第四道门是可迁移:把工作负载搬到另一个平台之后,模型效果、服务时延与运维能力能否维持。
这四道门不是一个统一的“开放分数”。贡献机械设计,不等于贡献芯片实现;采用 PCIe,不等于所有服务器都能直接安装;软件开源,也不意味着它依赖的硬件能力同时变得跨平台。开放许可同样不等于作品进入公共域,具体权利与条件仍要看对应文件。[5]
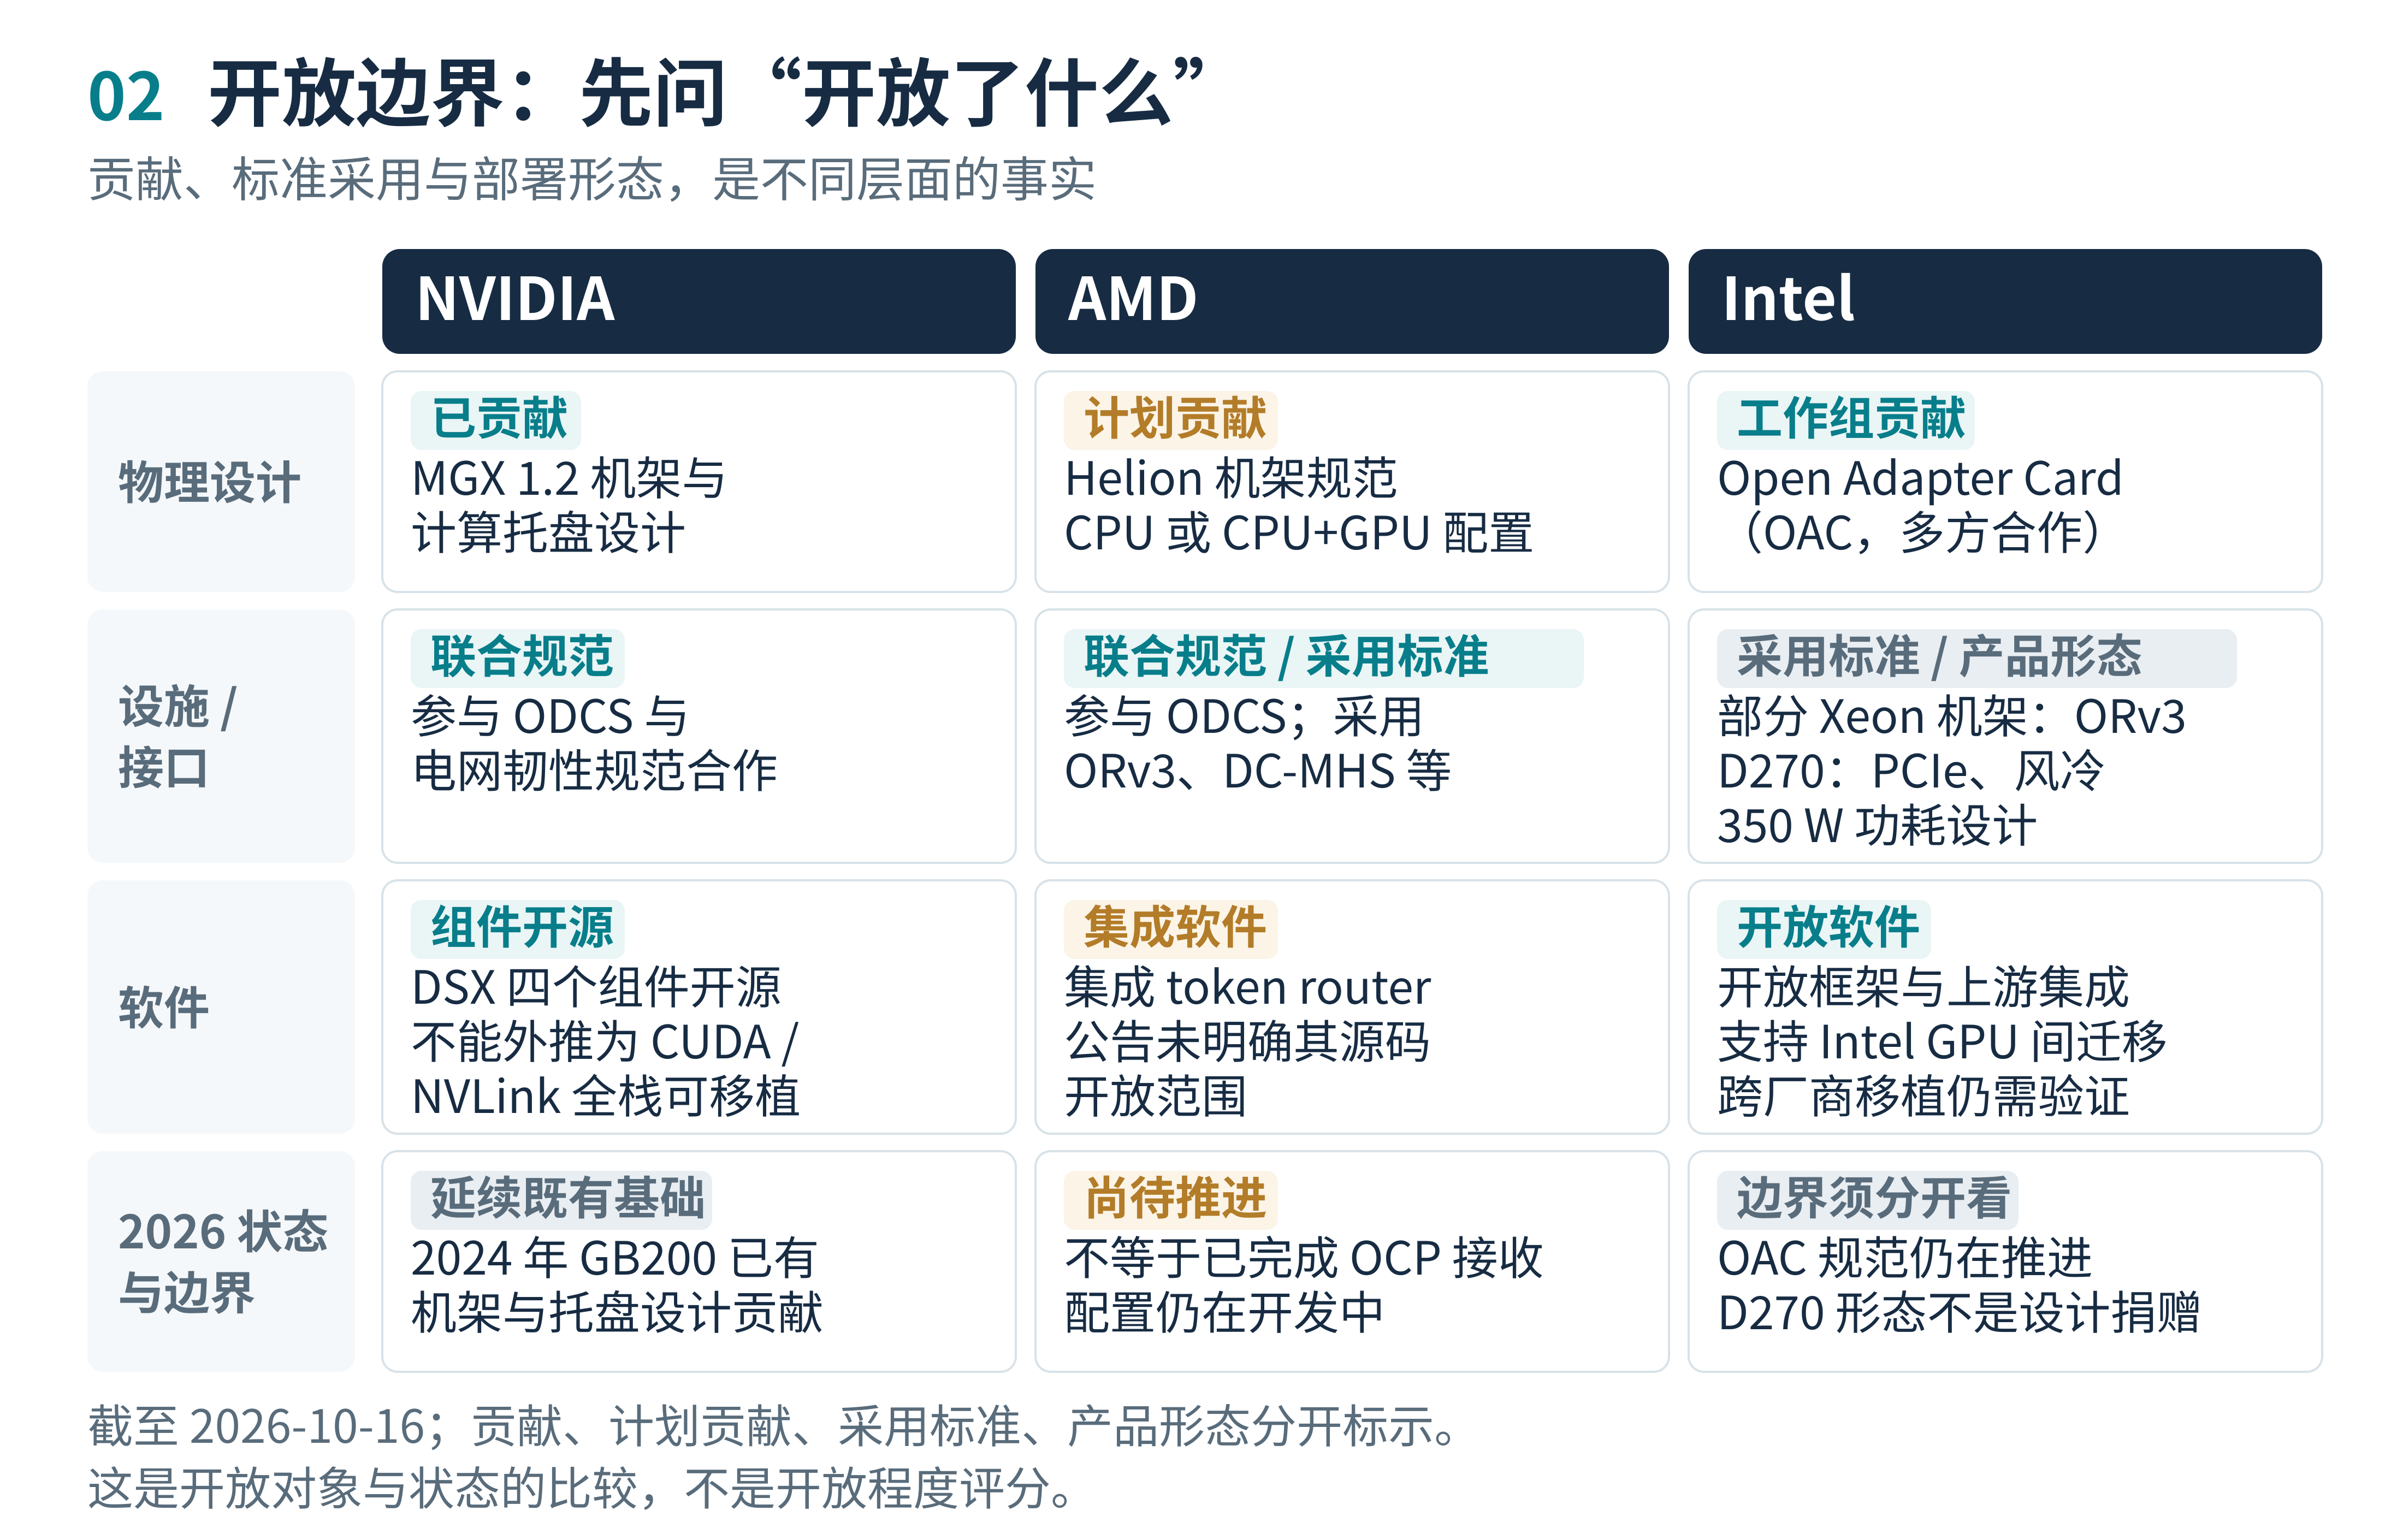
对采购方,这个区分十分实际:在同一架构内增加两家制造商,和把业务从一种加速器迁到另一种,解决的是不同的问题。前者主要改善供货与议价,后者还需要重新处理软件、网络、性能与运营责任。
NVIDIA 让更多人能建 仍然围绕同一个平台
NVIDIA 这次通过 MGX 1.2 向 OCP 贡献 Vera Rubin 的机架与计算托盘设计。公布的支持范围包括最高 250 千瓦的机架部署、5,000 安培液冷母排、盲插液冷连接、无风扇液冷计算托盘,以及标准化的电力和冷却接口。这些数字描述的是设计包络和接口能力,并非整机架已经完成独立测试的性能成绩。[6]
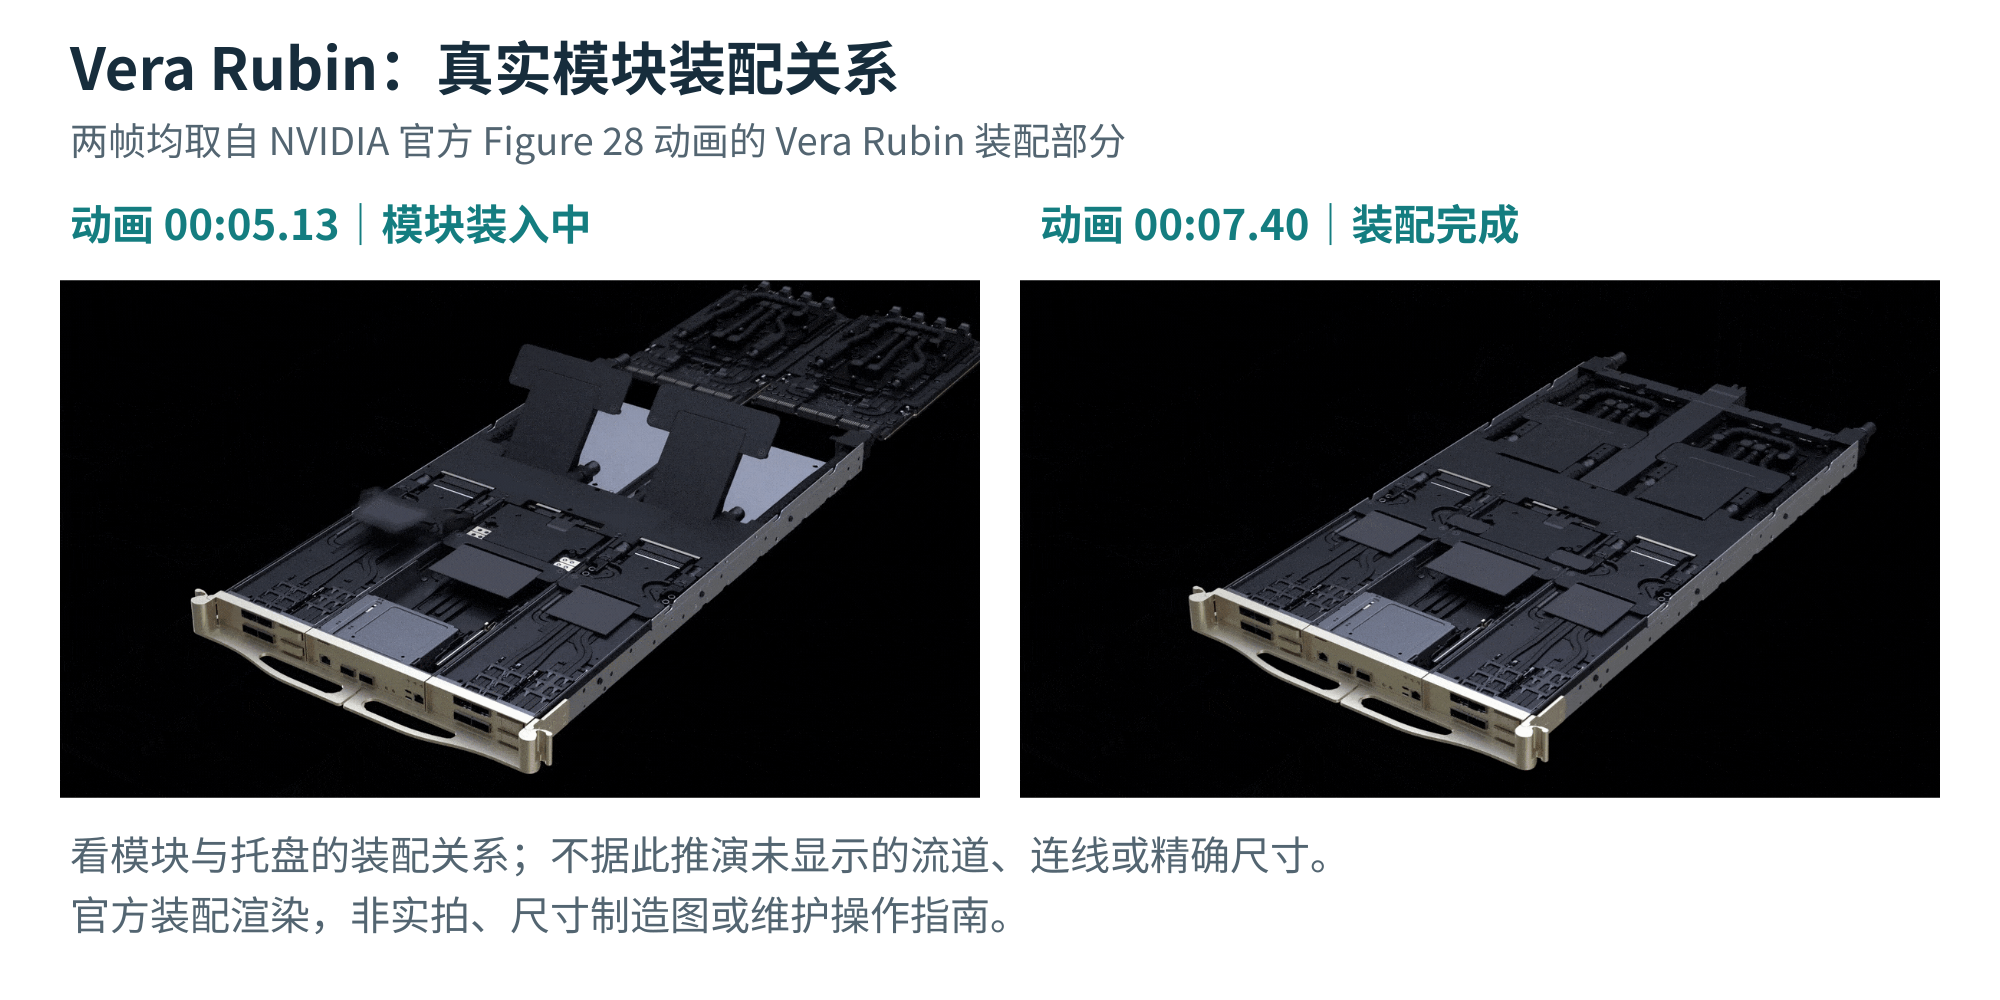
托盘的意义不能只靠参数理解。模块如何插入、怎样固定,冷却与供电连接如何对齐,维护时需要拆开哪些部件,都会影响装配和维修。NVIDIA 官方托盘装配动画把这些关系呈现得比一张机架正面图更清楚:模块化的价值,首先落在制造与服务动作上。动画可以帮助理解结构,却不能拿来代替装配时间实测。[7]
开放继续向机架外延伸。ODCS v0.7 由 NVIDIA、AMD、Google、Meta 共同发布,涵盖设施供电、冷却与物理布局;电网扰动性能规范则由 Google、Meta、Microsoft、NVIDIA 共同贡献。两份规范分别在 8 月和 9 月生效;峰会把此前形成的标准推到更多制造商和运营商面前。不同的署名名单说明合作范围不同,但仅凭名单还不足以推导阵营关系。[8] [9]
其中最容易被误读的是“两秒恢复”。电网规范约定的是:在规定的电压故障穿越条件内,接入点电压回到正常范围后,计算负载在两秒内恢复至故障前的 90%。这不是任意停电后两秒恢复全部业务的保证,冷却系统的恢复也不包含在同一个承诺里。把条件写清楚,并不会削弱规范的意义;它恰恰使要求可以被工程团队测试和验收。[9]
更高功率也把供电改造推到台前。围绕低压直流供电的开放工作,同时讨论利用现有交流设施与面向新建数据厅的过渡路径;NVIDIA 本届介绍的 Visionbay K-1,则围绕其 800V 直流参考架构组织电源与散热。这里不只有“推倒重建”一种选择:从哪里集中转换电能、改动到机架还是数据厅,都影响工程范围。开放接口能帮助这些环节协同,但具体场地是否值得改、怎样改,仍要单独设计。[6] [20]
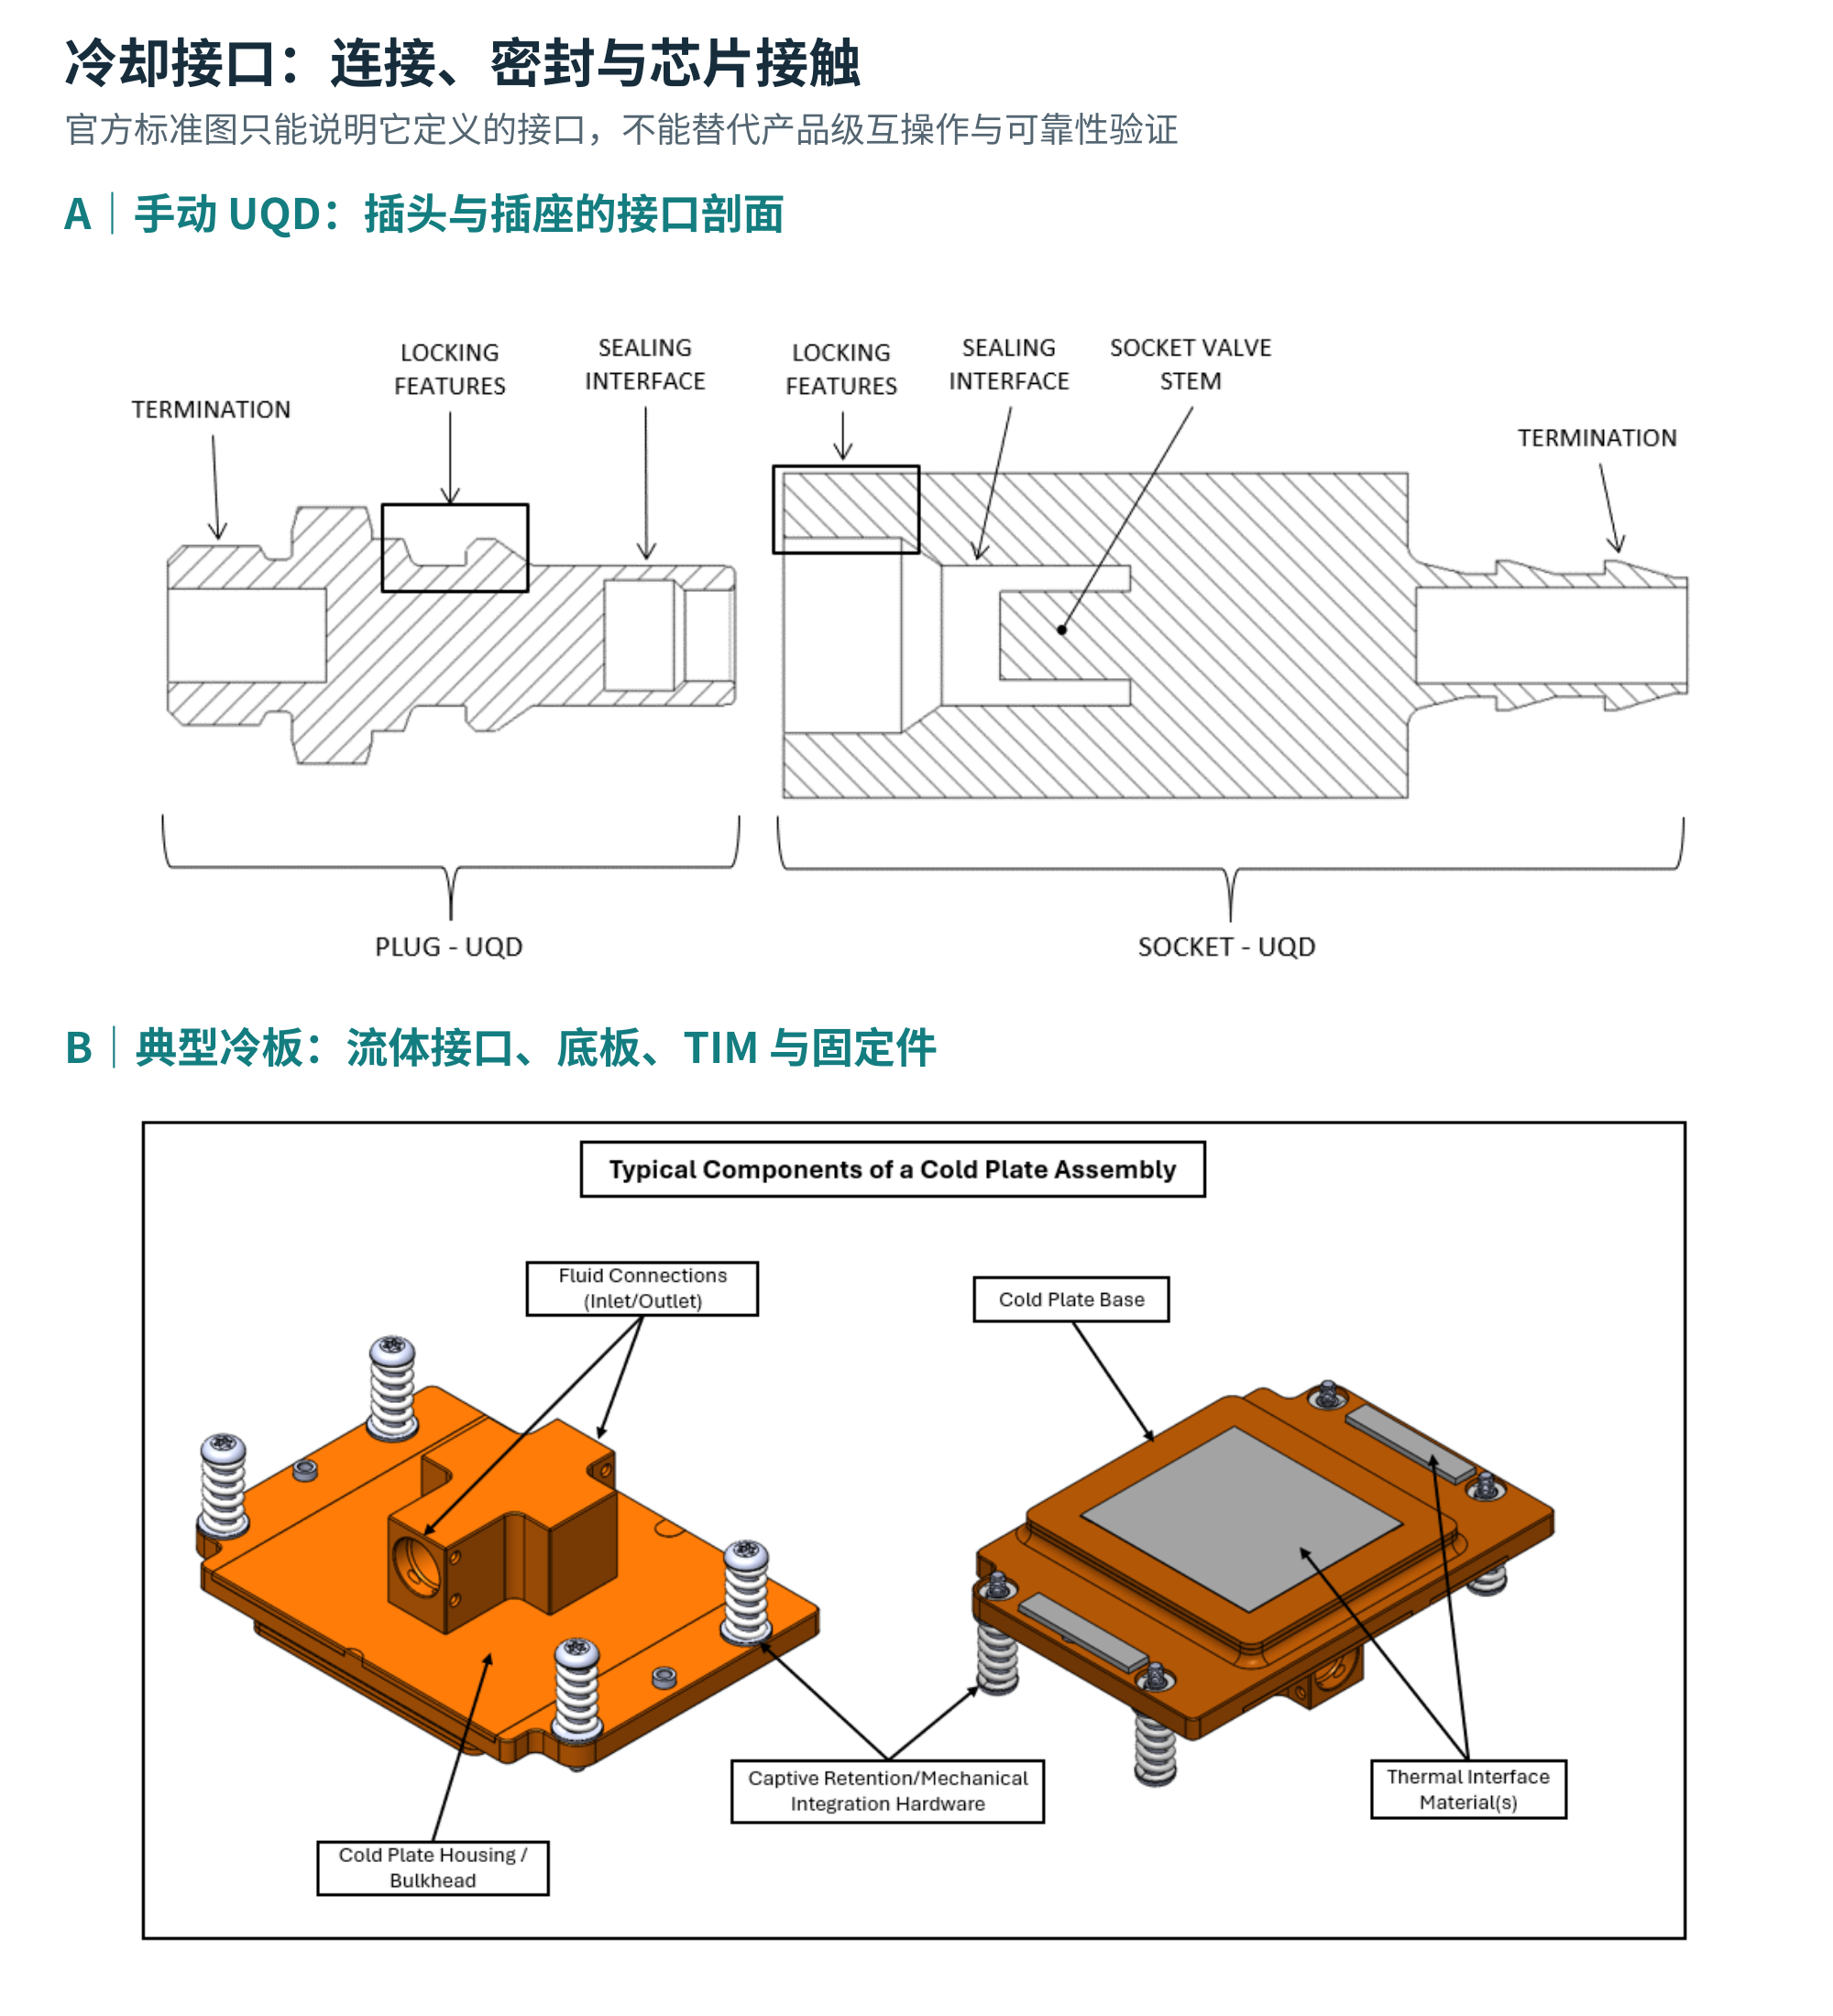
接口开放之所以需要落到工程细节,也可以从液冷看出来。公开一个快接的配合尺寸,只解决“怎样接”的一部分;密封、材料兼容、压力损失和寿命仍需要验证。冷板还要面对接触、固定、流动与热性能的组合约束。共同规范减少重复协调,却不免除产品验证,也不会让不同供应商的零件天然等效。[10] [11]
软件也进入了这条部署链。NVIDIA 此次增加的四个 DSX 开源组件,分别覆盖网络配置、集群就绪检查、机架管理和裸机部署。10 月 13 日,NVIDIA 又宣布将完整 Run:ai 平台开源,并保留商业支持渠道。因而,这一轮动作不能简单概括为“只开放硬件外围”。[6] [12]
更准确的边界是:代码与接口的开放,仍可能围绕某个平台的能力展开。Run:ai 的 GPU Fractioning Operator 使用 CUDA 原生能力,就是一个具体例子。NVLink Fusion 同样扩大了合作伙伴接入自定义 CPU、XPU 的路径,但接入 NVIDIA 的互联体系,不等于其他厂商已经能够独立替代整套实现。[12] [13]
NVIDIA 的路线因此更像是扩大平台的可参与范围:让更多企业制造、部署和管理这套系统,同时继续用互联、软件兼容性与验证体系组织它。对买方,这可能降低建设摩擦;对 NVIDIA,这也可能让自身架构更容易成为事实上的默认实现。
AMD 用机架把 agent 的两种负载拆开
AMD 的 Helion 容易与 Helios 混淆,但两者不是同一个产品。Helios 面向大规模 GPU 训练与推理;Helion 则是基于 OCP 规范的 agentic AI 参考设计,重点是把 agent 的执行资源与模型推理资源按需要组合。
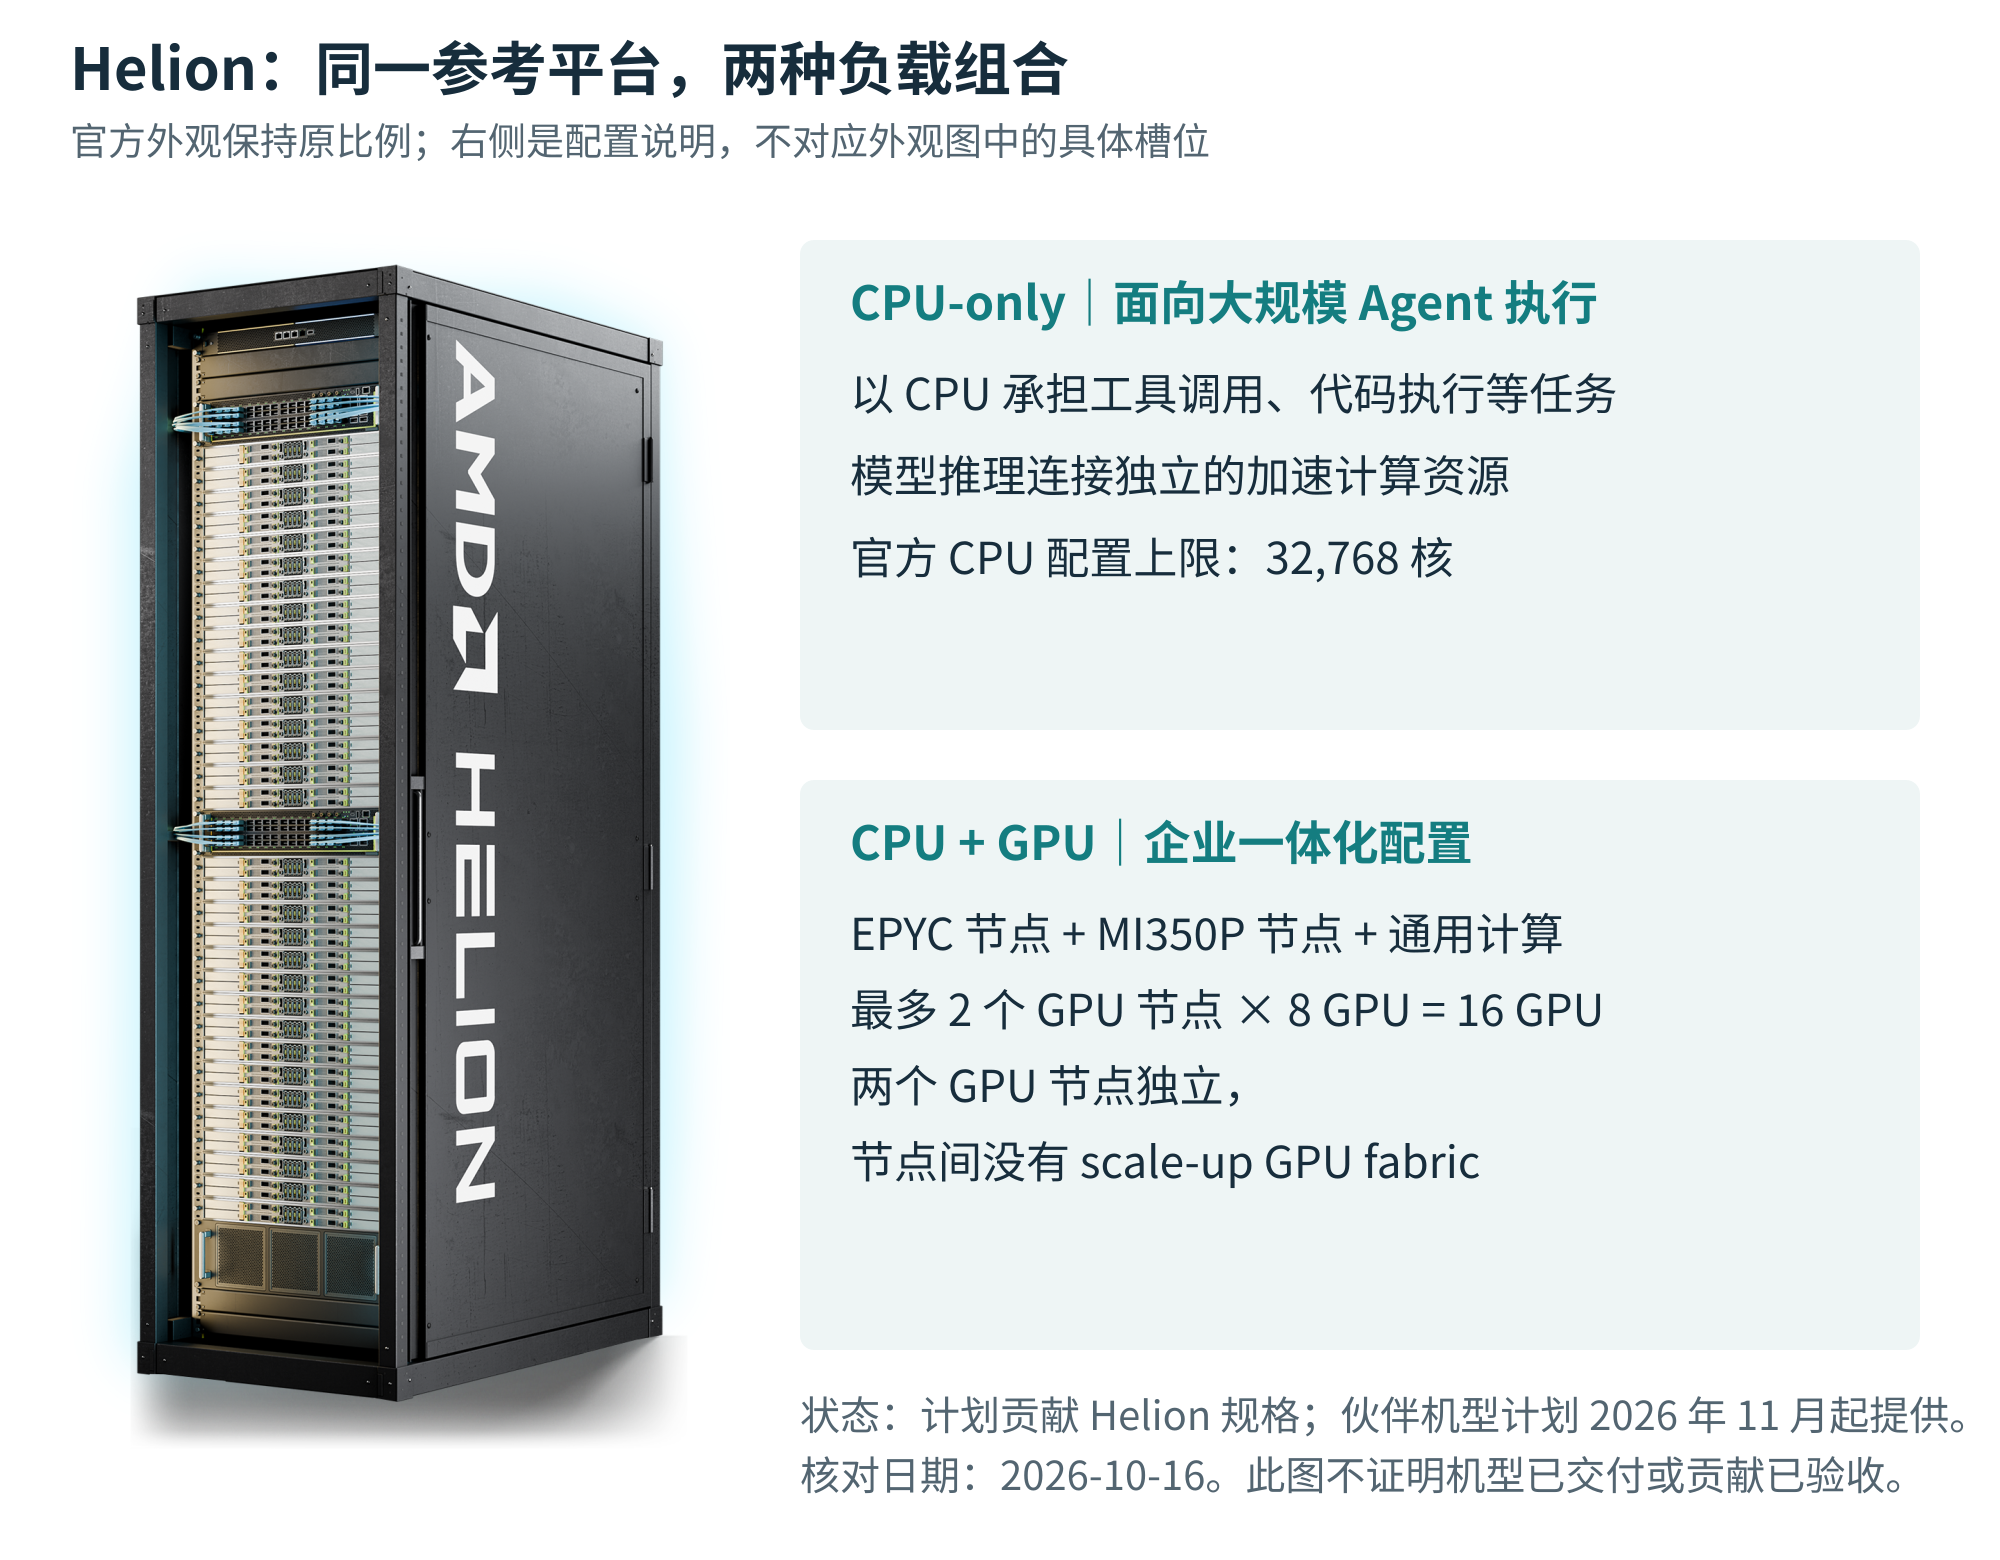
Helion 有两种代表性配置。面向超大规模客户的 CPU-only 机架,使用第六代 EPYC,最高提供 32,768 个 CPU 核心,并连接独立的模型推理基础设施。企业配置则把 CPU 与 GPU 节点放进同一方案:官方产品页列明最多两个八卡 MI350P 节点,合计 16 张加速卡;这两个节点之间没有形成统一的 GPU scale-up 互联域。同架部署,并没有把两组 GPU 合成一个统一的 scale-up 系统。[14]
这里比核心数更有信息量的,是对工作负载的拆分。agent 调用模型之外,还要执行代码、运行工具、处理数据和维持隔离环境。这些工作不应全部按 GPU 推理的资源比例扩容。CPU 与推理资源能够分开建设,意味着运营者可以针对实际负载调整配比,而不是为增加执行能力一并购买更多加速器。具体比例仍取决于工具类型、并发与隔离要求,机架核心数本身不能证明能支撑多少 agent。
AMD 还把 token router 纳入集成软件能力,让请求在前沿模型与开源模型之间分配。它提示了另一个竞争方向:机架方案开始包含“怎样使用模型”的运营逻辑。不过,官方发布没有充分说明这一组件的许可、策略导出和可替换性,是否形成新的依赖仍待观察。真正值得问的是,用户能否保留自己的策略、替换路由器,以及接入其他平台上的模型。[15]
这仍是一套通过伙伴落地的蓝图。AMD 在发布稿中使用“计划向 OCP 贡献规范”的措辞,并称伙伴开发中的 Helion 配置计划于 2026 年 11 月开始提供。应把规范贡献、具体机型上市与规模化交付分开观察;本文引用的官方材料尚未给出足以横向比较的机架级实测。AMD 的机会,是让伙伴更容易围绕自己的 CPU 与加速器形成可交付方案;买方拿到的好处,则要等具体配置、软件和服务一起落地后才能判断。[15]
Intel 把 少改设施 变成竞争条件
Intel 选择的切口不同。GPU D 系列,原代号 Crescent Island,基于 Xe3P 架构,公布的规格包括 1.5 TB/s 内存带宽、1.3 PFLOPS FP8 峰值算力和 350 瓦功率包络,采用标准 PCIe 风冷形态。容量必须拆开看:Intel 自有卡是 160GB LPDDR5X,480GB 是伙伴 ODM 设计的可选上限。目前处于客户送样阶段。[16]
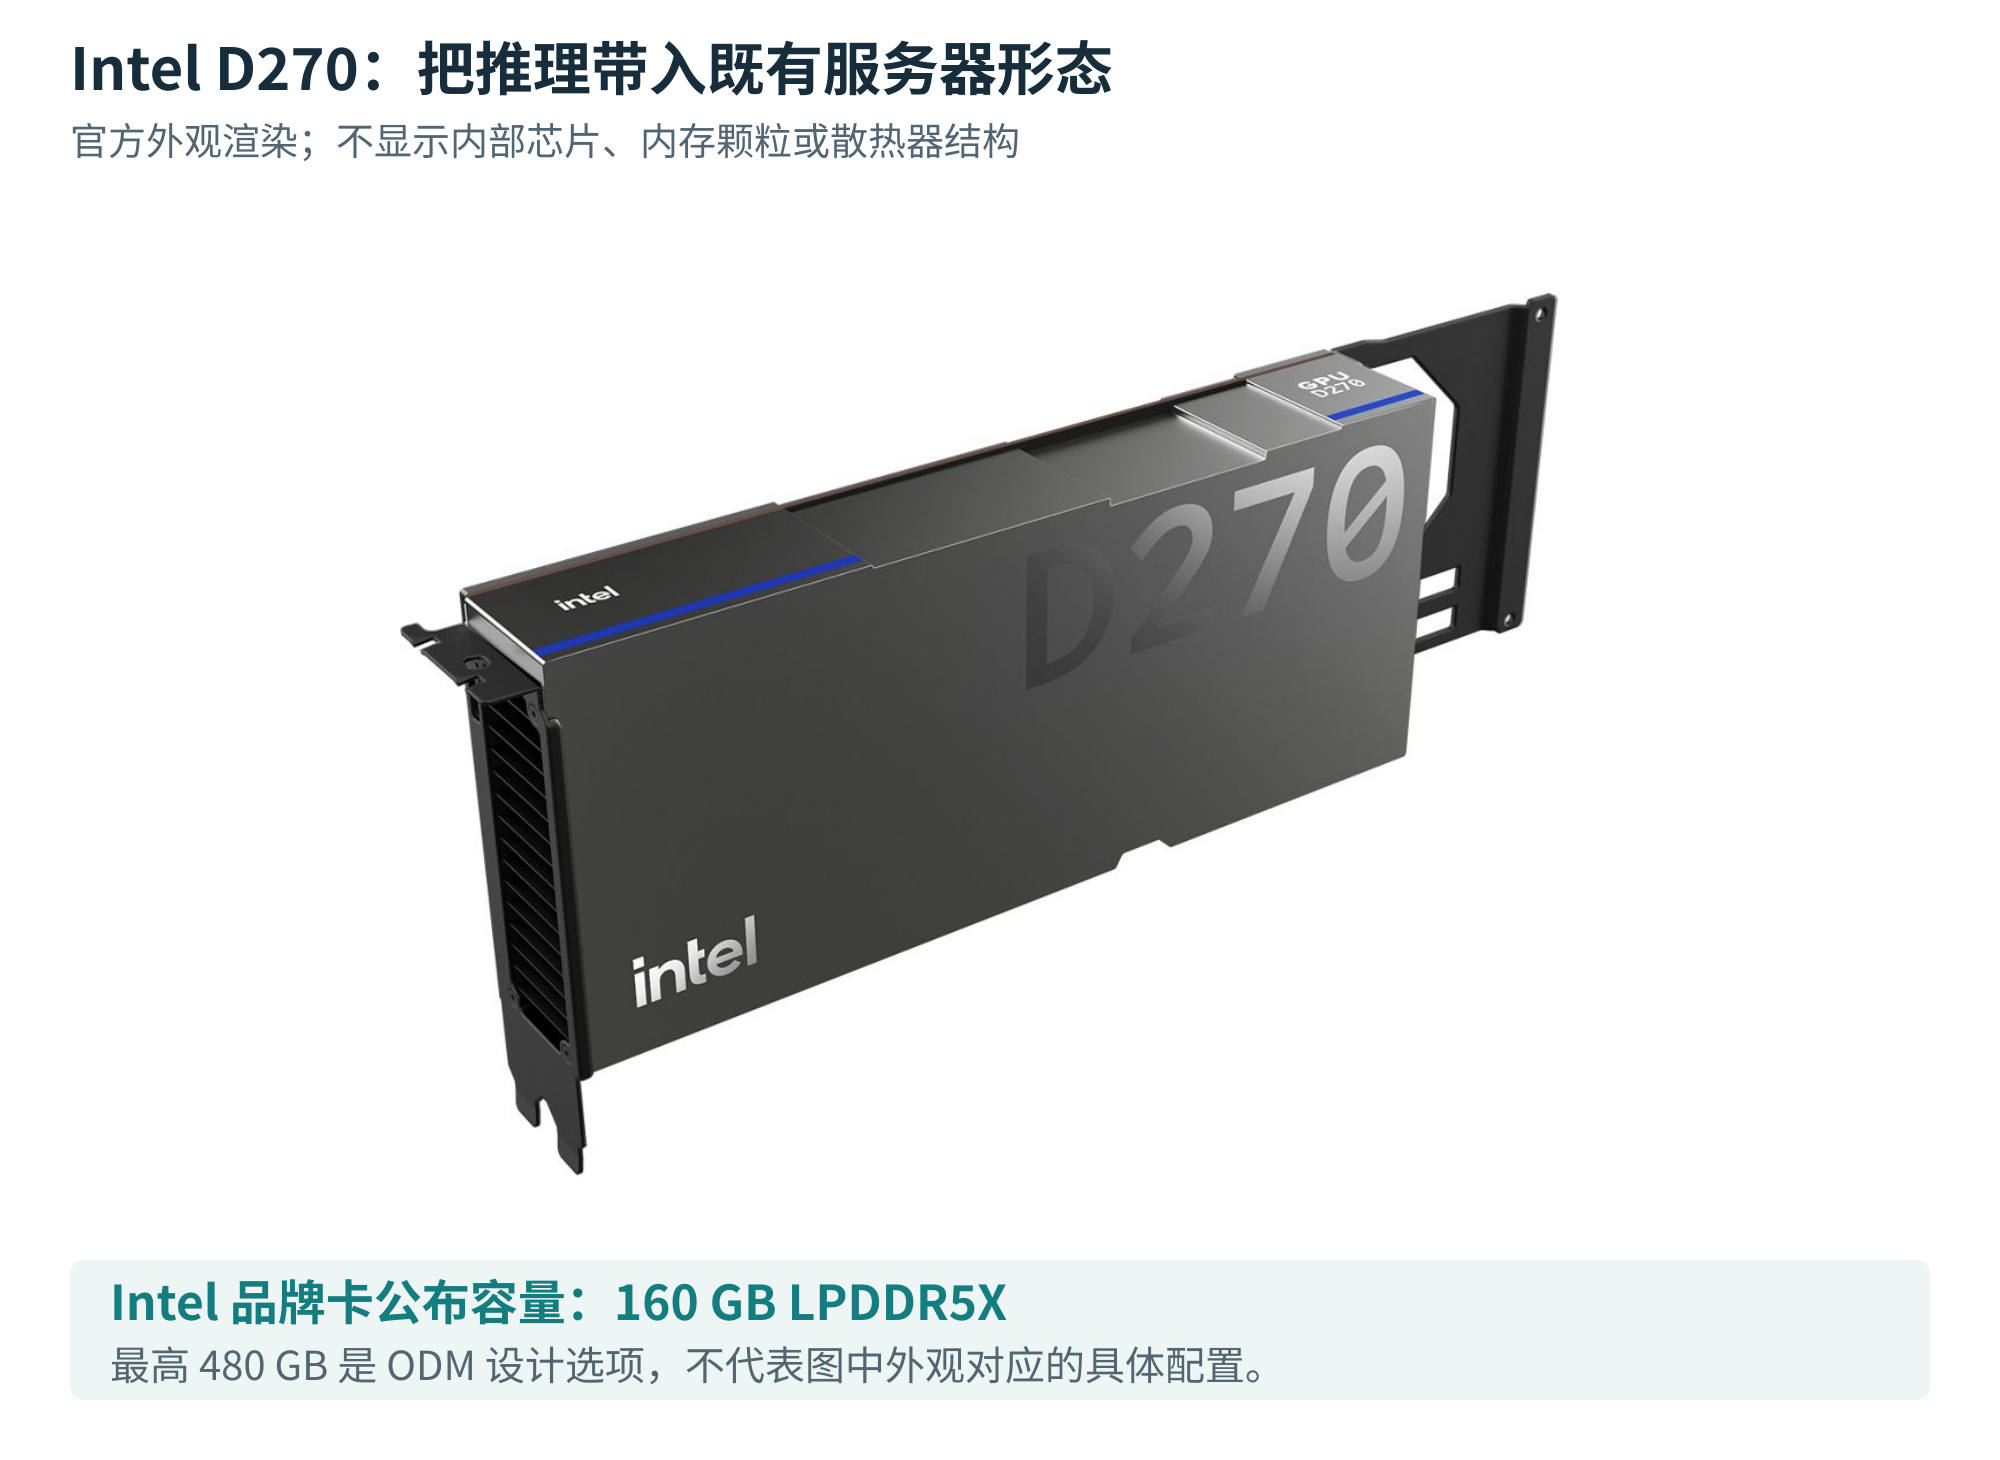
这套方案强调的,是在既有设施里增加推理能力。对无法立即建设高功率液冷环境的企业,少改电源、冷却和服务器,可能比追求最高单卡峰值更重要。但“面向既有设施”不是“任何旧服务器都能即插即用”:槽位尺寸、供电、风道、固件、驱动和服务软件仍需验证。
风冷部署也不是 Intel 独有的市场。NVIDIA 自己就有风冷的 RTX PRO 6000 Blackwell Server Edition:96GB GDDR7、1.597 TB/s 带宽、最高 600 瓦功率。D 系列的特殊之处,是在相近量级的带宽下提供更大的可选容量,而不是独占风冷部署。350 瓦和 600 瓦也只是功率规格,不能直接推出哪张卡完成相同任务更省电。[17]
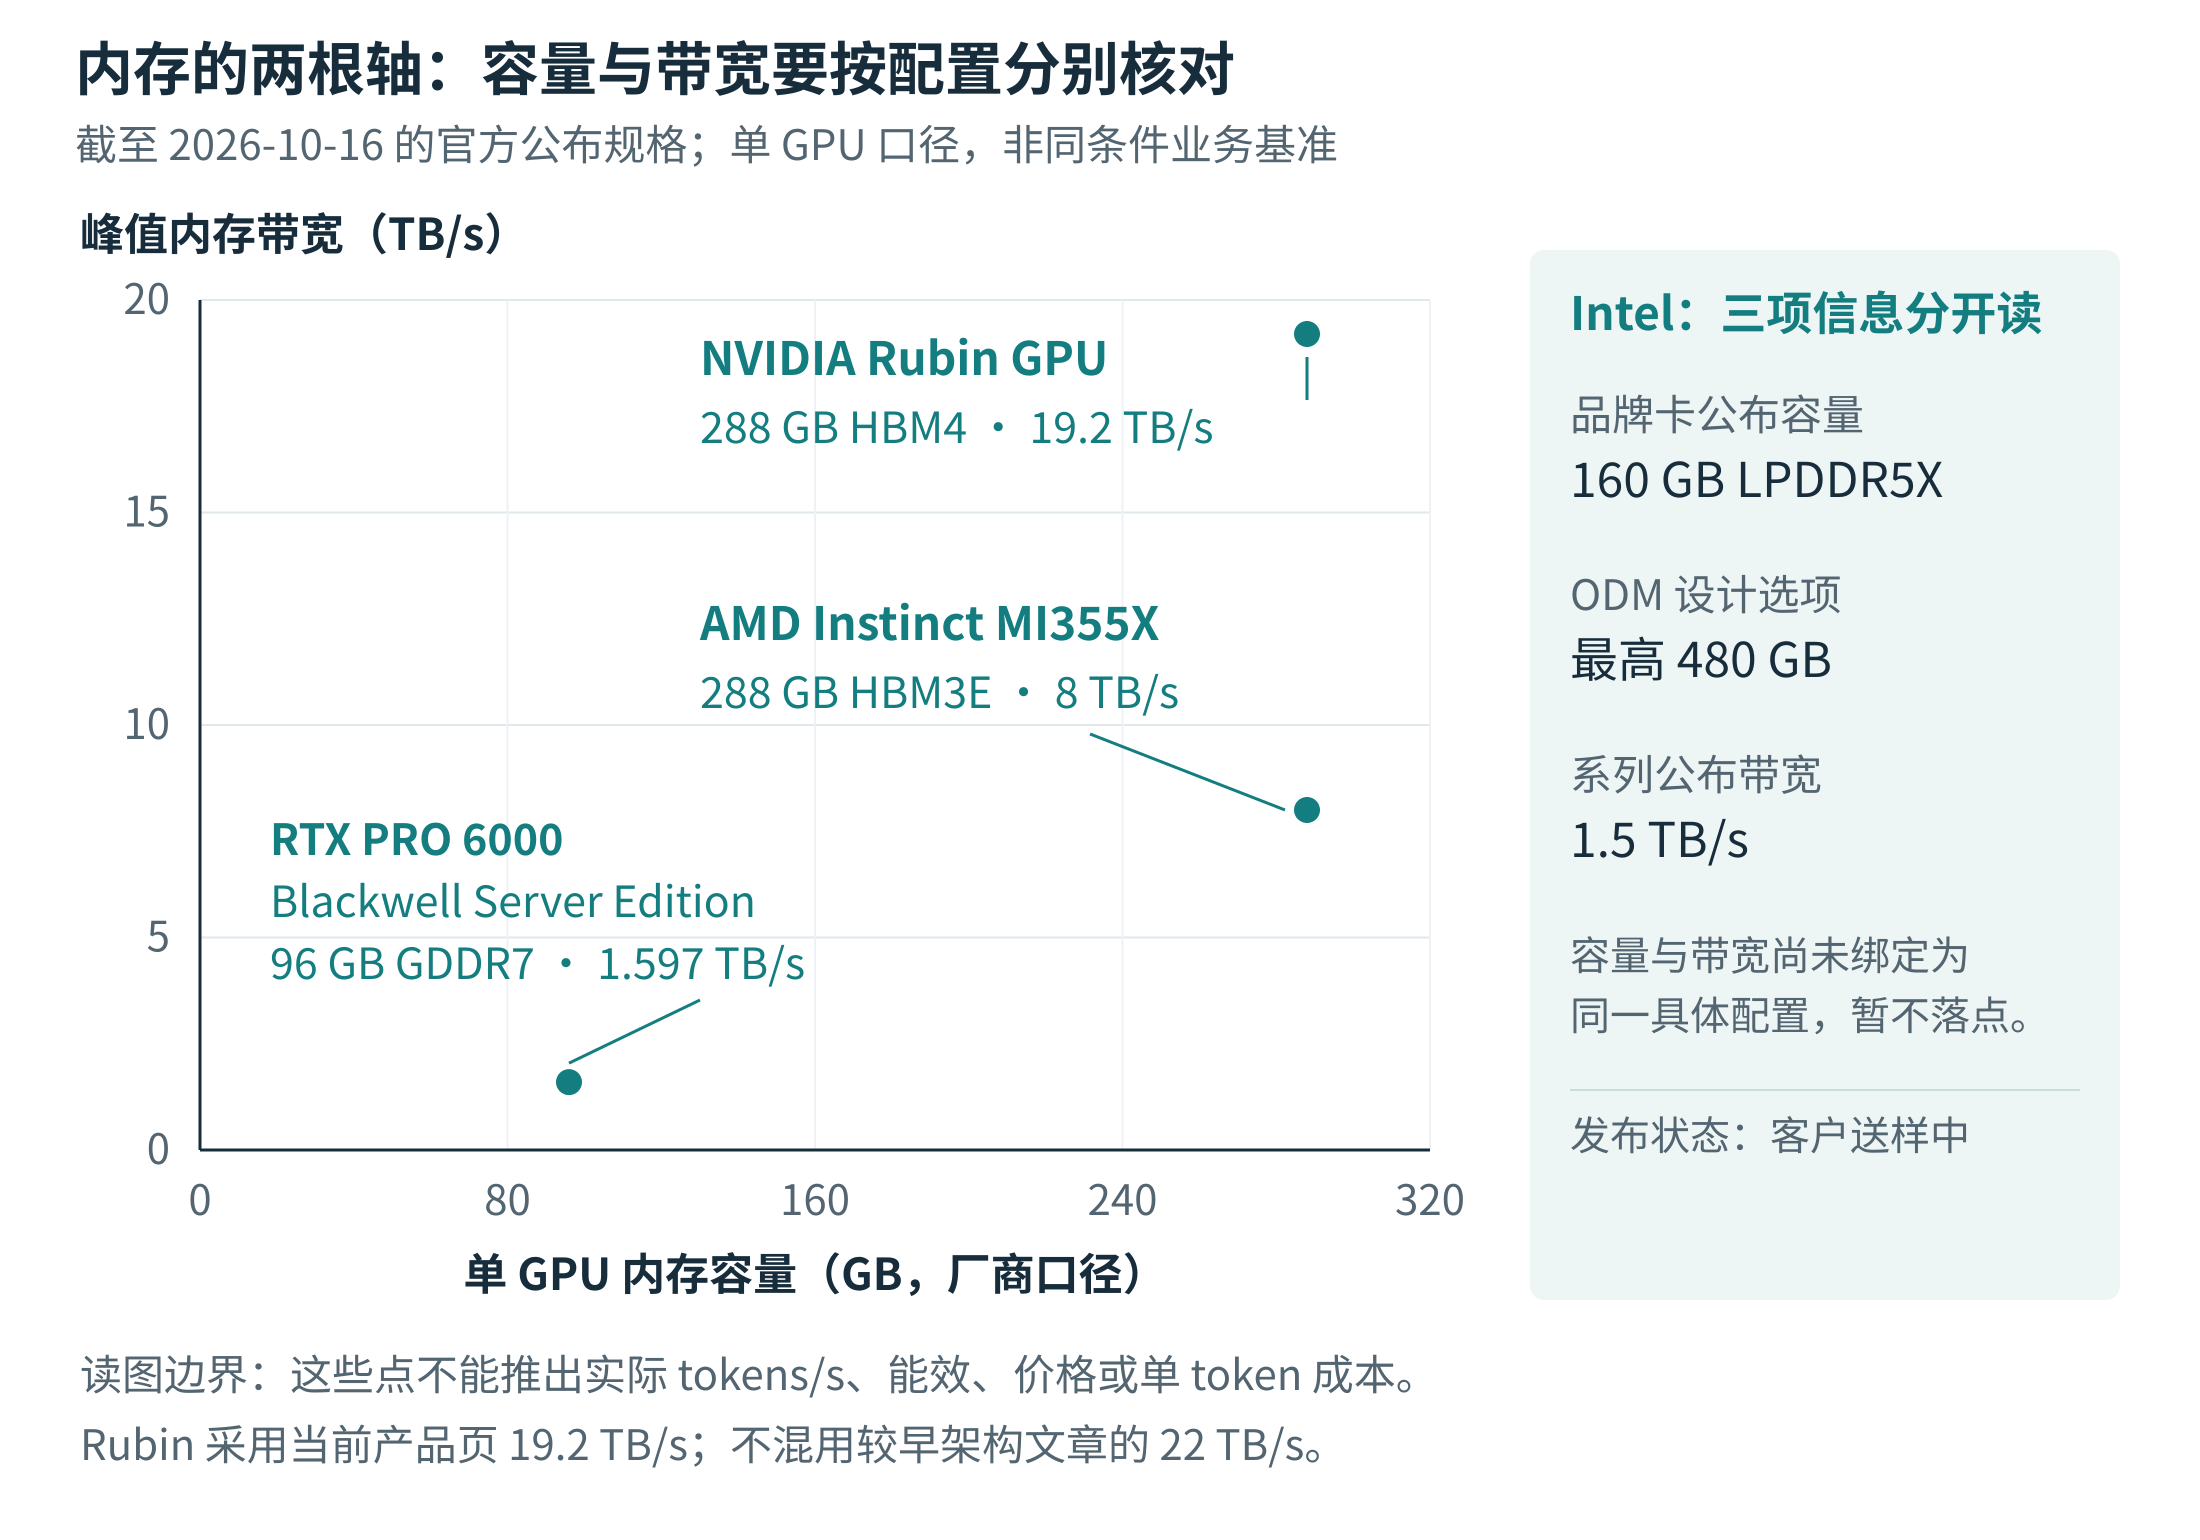
Intel 也并非没有开放贡献。本届官方稿介绍了 Open Adapter Card 工作组的标准化加速卡形态工作,并展示采用 OCP Open Rack v3 的 Xeon 机架生态。区别在于,它的 D 系列叙事更强调利用已有基础设施,而不是以贡献一套新的整机架蓝图为中心。[16]
大容量什么时候才会变成便宜的 token
Intel 的路线提出了一个好问题:推理是否需要重新计算内存的价值?答案是需要,但不能把它简化成“训练只看带宽,推理只看容量”。训练本来就受计算、容量、带宽与互联共同约束;推理内部也有不同阶段。
处理输入的 prefill 可以利用大量并行计算;逐步生成输出的 decode 往往更受内存访问影响。KV cache 随上下文长度和并发增长,能占用大量容量。更大的内存可以容纳更多权重与缓存,减少部分换入换出,并为批处理留下空间;但请求装得下之后,还要回答它们多久能得到结果。[18]
用一个最简单的容量算术就能看出宣传参数缺少什么。一个 3,000 亿参数的模型,若每个权重分别使用 2、1、0.5 字节,单是权重就约为 600、300、150GB。这还没有算量化元数据、KV cache、激活和运行时开销。因此,“480GB 能承载 300B 模型”只能在给定精度与服务配置下理解,不能推出任意 300B 模型都能单卡高效运行。这是容量计算,不是对 D 系列吞吐的预测。
在线服务还有一组不能省略的条件:相同模型与质量要求,相同输入输出长度分布,相同首 token 时延(TTFT)和每输出 token 时间(TPOT)目标。MLPerf 的在线服务场景也使用这类时延要求。离线任务可以等待批次做大,交互服务却可能在容量用满之前,就先碰到用户等待时间的上限。[19]
跨卡同样不是天然吃亏。模型并行会引入通信,但也增加可用计算、内存和总带宽;在某些时延要求下,多卡可能比勉强装进一张大内存卡更合适。究竟哪条路线更便宜,要看真实模型、通信路径、运行时和负载,而不是从“少用几张卡”直接得出结论。
采购时可以把账压缩成两个指标。每百万合格输出 token 的成本,等于每小时全系统成本,除以这一小时实际交付的合格输出 token 数,再乘一百万。“合格”指满足质量和约定时延;全系统成本应包含硬件摊销、主机与网络、设施、电力、运维,并计入闲置与不可用时段的影响。每 token 能耗则是实际测得的系统能量,除以同一时间窗内交付的合格 token 数。
一个条件计算足以说明为什么不能只看瓦数:假设两套待比较的板卡持续功率恰好是 350 瓦与 600 瓦,前者要有更低的板卡能耗/token,其合格吞吐就必须超过后者的约 58%。这只是代数关系,既不是实测,也未计整机、网络和冷却能耗。价格与合格吞吐尚未齐备时,D 系列首先是一种值得验证的容量路线;它是否提供更便宜的推理,仍待同条件比较。
开放减少了一种依赖 未必减少另一种
回到机架,开放最直接的商业收益,是让更多供应商有机会围绕共同设计参与制造和交付。这可能减少重复适配,扩大同平台采购选择。但“集成环节的毛利必然下降”仍然说得太快:重复设计的溢价可能被压缩,验证、液冷调试、故障处理和交付保证却可能变得更值钱。价值有可能重新分配,而不是从整个环节消失。
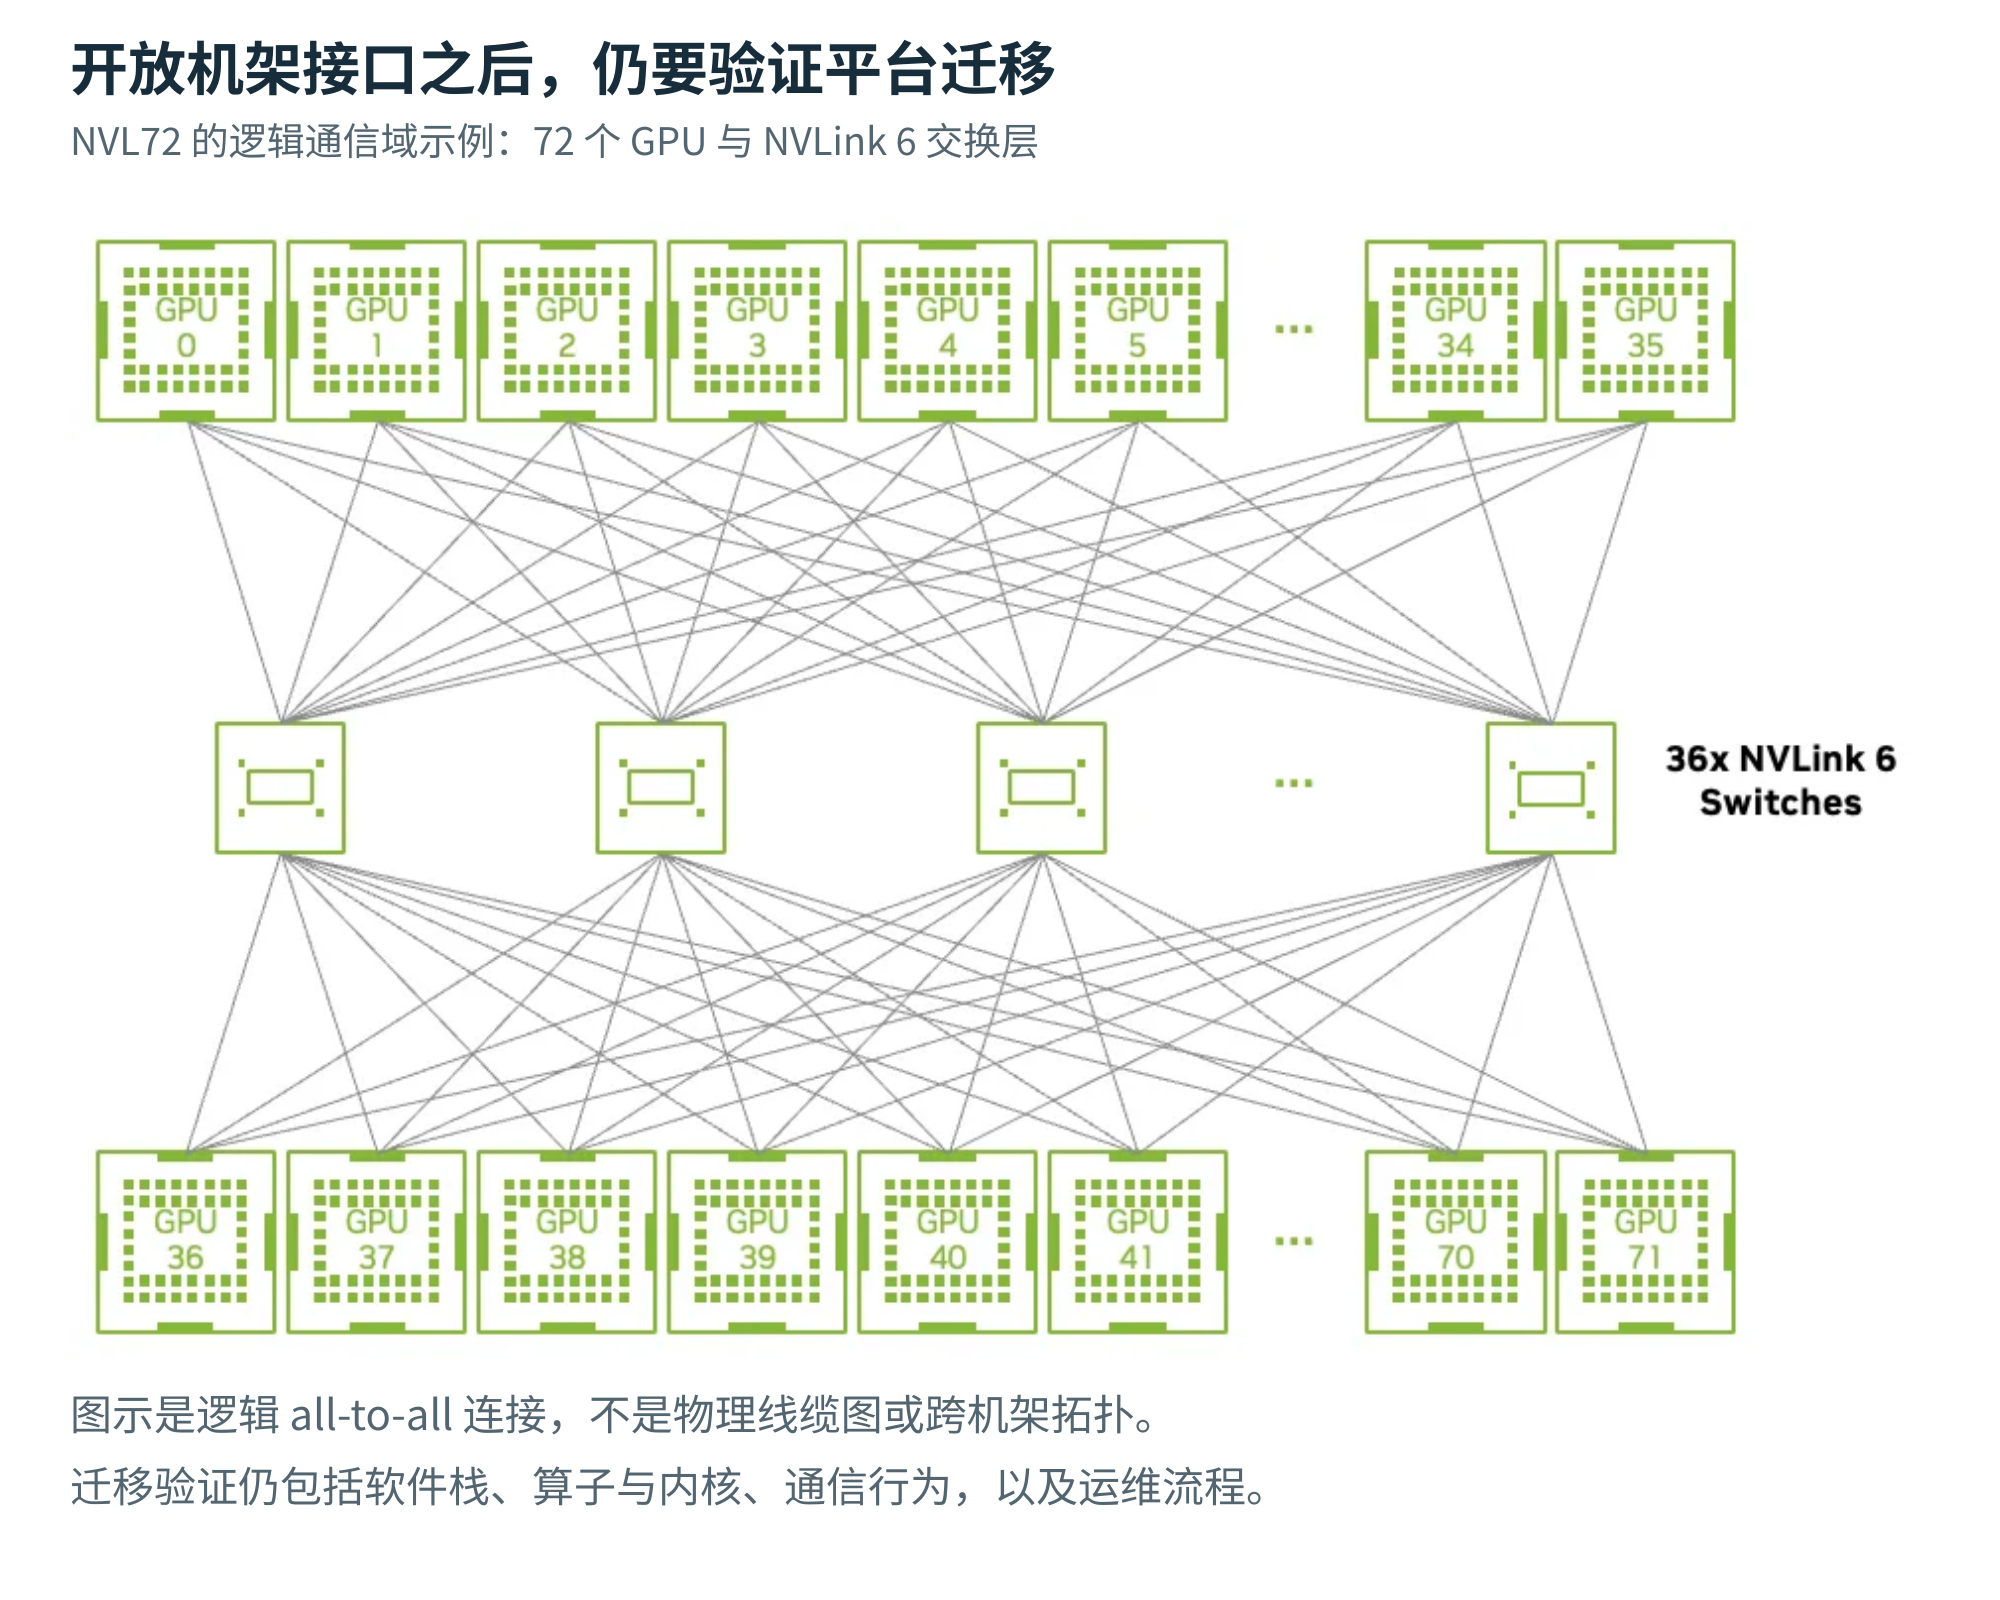
平台迁移的账也要分开。CUDA、内核和软件生态从来就不是只存在于一张卡上,所以锁定并非到了 2026 年才从芯片“上移”到软件。更重要的变化是,需要共同验证的系统边界扩大了:加速器、CPU、互联、供电、液冷、固件、调度和服务软件一起决定系统表现。即使机械图纸开放,换掉其中一种核心架构,仍可能触发重新适配与验收。
这种扩大并不要求所有买家都购买整机架。前沿大集群重视机架级通信与交付,企业推理可能继续按服务器、插卡或云端服务扩容。Intel 的路线本身就在提醒市场:部署条件与工作负载不同,合理的采购单位也不同。整架采购是其中一条路线,其他形态仍有清晰的需求与边界。
因此,这轮开放最有价值的判断,不是三家公司各自画了多大一面围墙,而是它们分别降低了哪一种参与门槛。NVIDIA 让更多伙伴能够建设和运营围绕其平台的系统;AMD 用可配置蓝图组织 agent 的执行与推理能力;Intel 把标准形态、开放软件和既有设施兼容性放到前面。三者都在争取更快进入生产环境,但跨平台迁移自由并不会随贡献文件的数量自动增长。
接下来值得盯的,不只是哪份规范又增加了一个署名。Helion 的计划贡献是否落成可用文件,具体机型是否兑现交付;D 系列何时有可比的价格、软件和服务性能;开放接口能否带来更多经过验证的第二供应商;部署时间与故障恢复是否在真实项目中改善。这些信号,才会把“开放换部署速度”从一个合理解释,变成可观察的结果。
机架越来越开放,最先增加的可能是参与建设的自由;平台是否更容易替换,仍要看退出时需要付出什么。对买方,真正值得争取的不是抽象的开放承诺,而是在上线之前就弄清楚:哪些部件能换,哪些性能要重测,哪些软件与运营能力能够带走。
资料与口径
本文资料核对截至 2026 年 10 月 16 日。产品参数以相应厂商公布资料为准,不等于独立实测;规范条款描述设计或验收要求,不等于所有产品已经符合。Helion 的贡献与交付使用计划性表述,Intel 480GB 为 ODM 设计上限。原创示意图与容量算术均注明假设;官方结构、装配、剖面和拓扑图按其原本用途使用,不补绘未公开结构。
参考资料与配图出处
配图中的实物照片、官方设计图与逻辑示意分别标明。原图保持比例及结构,中文解读置于图外;图中器件上限和历史参数以对应出处、日期与条件为准。
[1] 2026 OCP Global Summit — Open Compute Project,2026-10-12 至 2026-10-15
https://www.opencompute.org/summit/global-summit
[2] NVIDIA Contributes Blackwell Platform Design to Open Hardware Ecosystem — NVIDIA,2024-10-15
https://nvidianews.nvidia.com/news/nvidia-contributes-blackwell-platform-design-to-open-hardware-ecosystem-accelerating-ai-infrastructure-innovation/
[3] NVIDIA Q2 FY2027 Earnings Call Transcript — NVIDIA Investor Relations,2026-08-26
https://investor.nvidia.com/files/content_files/TRANSCRIPT_-NVIDIA-Corp-NVDA-US-Q2-2027-Earnings-Call-26-August-2026-5_00-PM-ET.pdf
[4] Energy and AI:AI and energy security — International Energy Agency,2025
https://www.iea.org/reports/energy-and-ai/ai-and-energy-security
[5] Contribution Templates & Agreements — Open Compute Project,核对:2026-10-16
https://www.opencompute.org/contributions/templates-agreements
[6] OCP Global Summit: NVIDIA Opens Vera Rubin Architecture — NVIDIA,2026-10-12
https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
[7] Inside the NVIDIA Rubin Platform: Six New Chips, One AI Supercomputer — NVIDIA Technical Blog,2026;核对:2026-10-16
https://developer.nvidia.com/blog/inside-the-nvidia-rubin-platform-six-new-chips-one-ai-supercomputer/
[8] Open Data Center Specification v0.7.0 — NVIDIA、AMD、Google、Meta / OCP,生效:2026-08-27
https://www.opencompute.org/documents/open-data-center-spec-revision-0-7-0-4-pdf
[9] Interface Specification Between Hyperscalers and Utility Grid for Disturbance Performance v1.0 — Google、Meta、Microsoft、NVIDIA / OCP,生效:2026-09-17
https://www.opencompute.org/documents/ocp-base-spec-interface-specification-between-hyperscalers-and-utility-grid-for-disturbance-performance-pdf
[10] Universal Quick Disconnect Design Specification v2.0.0 — Open Compute Project,v2.0.0;核对:2026-10-16
https://www.opencompute.org/wp-content/uploads/2026/10/OCP-Design-Spec_UQD_v2.0.0.pdf
[11] Cold Plate Test Specification v1.0.0 — Open Compute Project,v1.0.0;核对:2026-10-16
https://www.opencompute.org/wp-content/uploads/2026/10/OCP-Cold-Plate-Test-Specification-V1.0.0.pdf
[12] NVIDIA Run:ai Is Now Open Source as Part of NVIDIA DSX AI Factory Platform — NVIDIA Technical Blog,2026-10-13
https://developer.nvidia.com/blog/nvidia-runai-is-now-open-source-as-part-of-nvidia-dsx-ai-factory-platform
[13] NVLink Fusion: Build Semi-Custom AI Infrastructure — NVIDIA,核对:2026-10-16
https://www.nvidia.com/en-eu/data-center/nvlink-fusion/
[14] AMD Helion Agentic AI Rack:产品页与FAQ — AMD,核对:2026-10-16
https://www.amd.com/en/products/rackscale-solutions/helion.html
[15] Introducing AMD Helion, Agentic AI Compute at Rack Scale — AMD Investor Relations,2026-10-12
https://ir.amd.com/news-events/press-releases/detail/1301/introducing-amd-helion-agentic-ai-compute-at-rack-scale
[16] Intel Accelerates Open Infrastructure for the Agentic AI Era — Intel,2026-10;核对:2026-10-16
https://www.intel.com/content/www/us/en/newsroom/news/artificial-intelligence/intel-accelerates-open-infrastructure-agentic-ai-era.html
[17] RTX PRO 6000 Blackwell Server Edition:官方规格 — NVIDIA,核对:2026-10-16
https://www.nvidia.com/en-us/data-center/rtx-pro-6000-blackwell-server-edition/
[18] Mastering LLM Techniques: Inference Optimization — NVIDIA Technical Blog,2023-11-17;核对:2026-10-16
https://developer.nvidia.com/blog/mastering-llm-techniques-inference-optimization/
[19] MLPerf Inference v5.0 Advances Language Model Capabilities for GenAI — MLCommons,2025-04
https://mlcommons.org/2025/04/llm-inference-v5/
[20] Powering the Next Era of AI: Transition to LVDC — Open Compute Project,核对:2026-10-16
https://www.opencompute.org/news/powering-the-next-era-of-ai-how-google-microsoft-and-nvidia-are-standardizing-and-accelerating-the-industry-transition-to-lvdc/
[21] NVIDIA Contributes NVIDIA GB200 NVL72 Designs to Open Compute Project — NVIDIA,2024-10-15
https://developer.nvidia.com/blog/nvidia-contributes-nvidia-gb200-nvl72-designs-to-open-compute-project/
[22] Intel GPU D270 | Inference-Optimized Data Center GPU — Intel,2026-10-16
https://www.intel.com/content/www/us/en/products/details/discrete-gpus/data-center-gpu/d-series.html
[23] Open Adapter Card — Open Compute Project,2026-10-16
https://www.opencompute.org/projects/semi-private-workstreams/open-adapter-card/
[24] AMD Instinct MI355X GPU 产品数据表 — AMD,2025-10 datasheet,2026-10-16核对
https://www.amd.com/content/dam/amd/en/documents/instinct-tech-docs/product-briefs/amd-instinct-mi355x-gpu-brochure.pdf
[25] NVIDIA Vera Rubin NVL72 官方产品规格 — NVIDIA,当前产品页,2026-10-16核对
https://www.nvidia.com/en-us/data-center/vera-rubin-nvl72/