
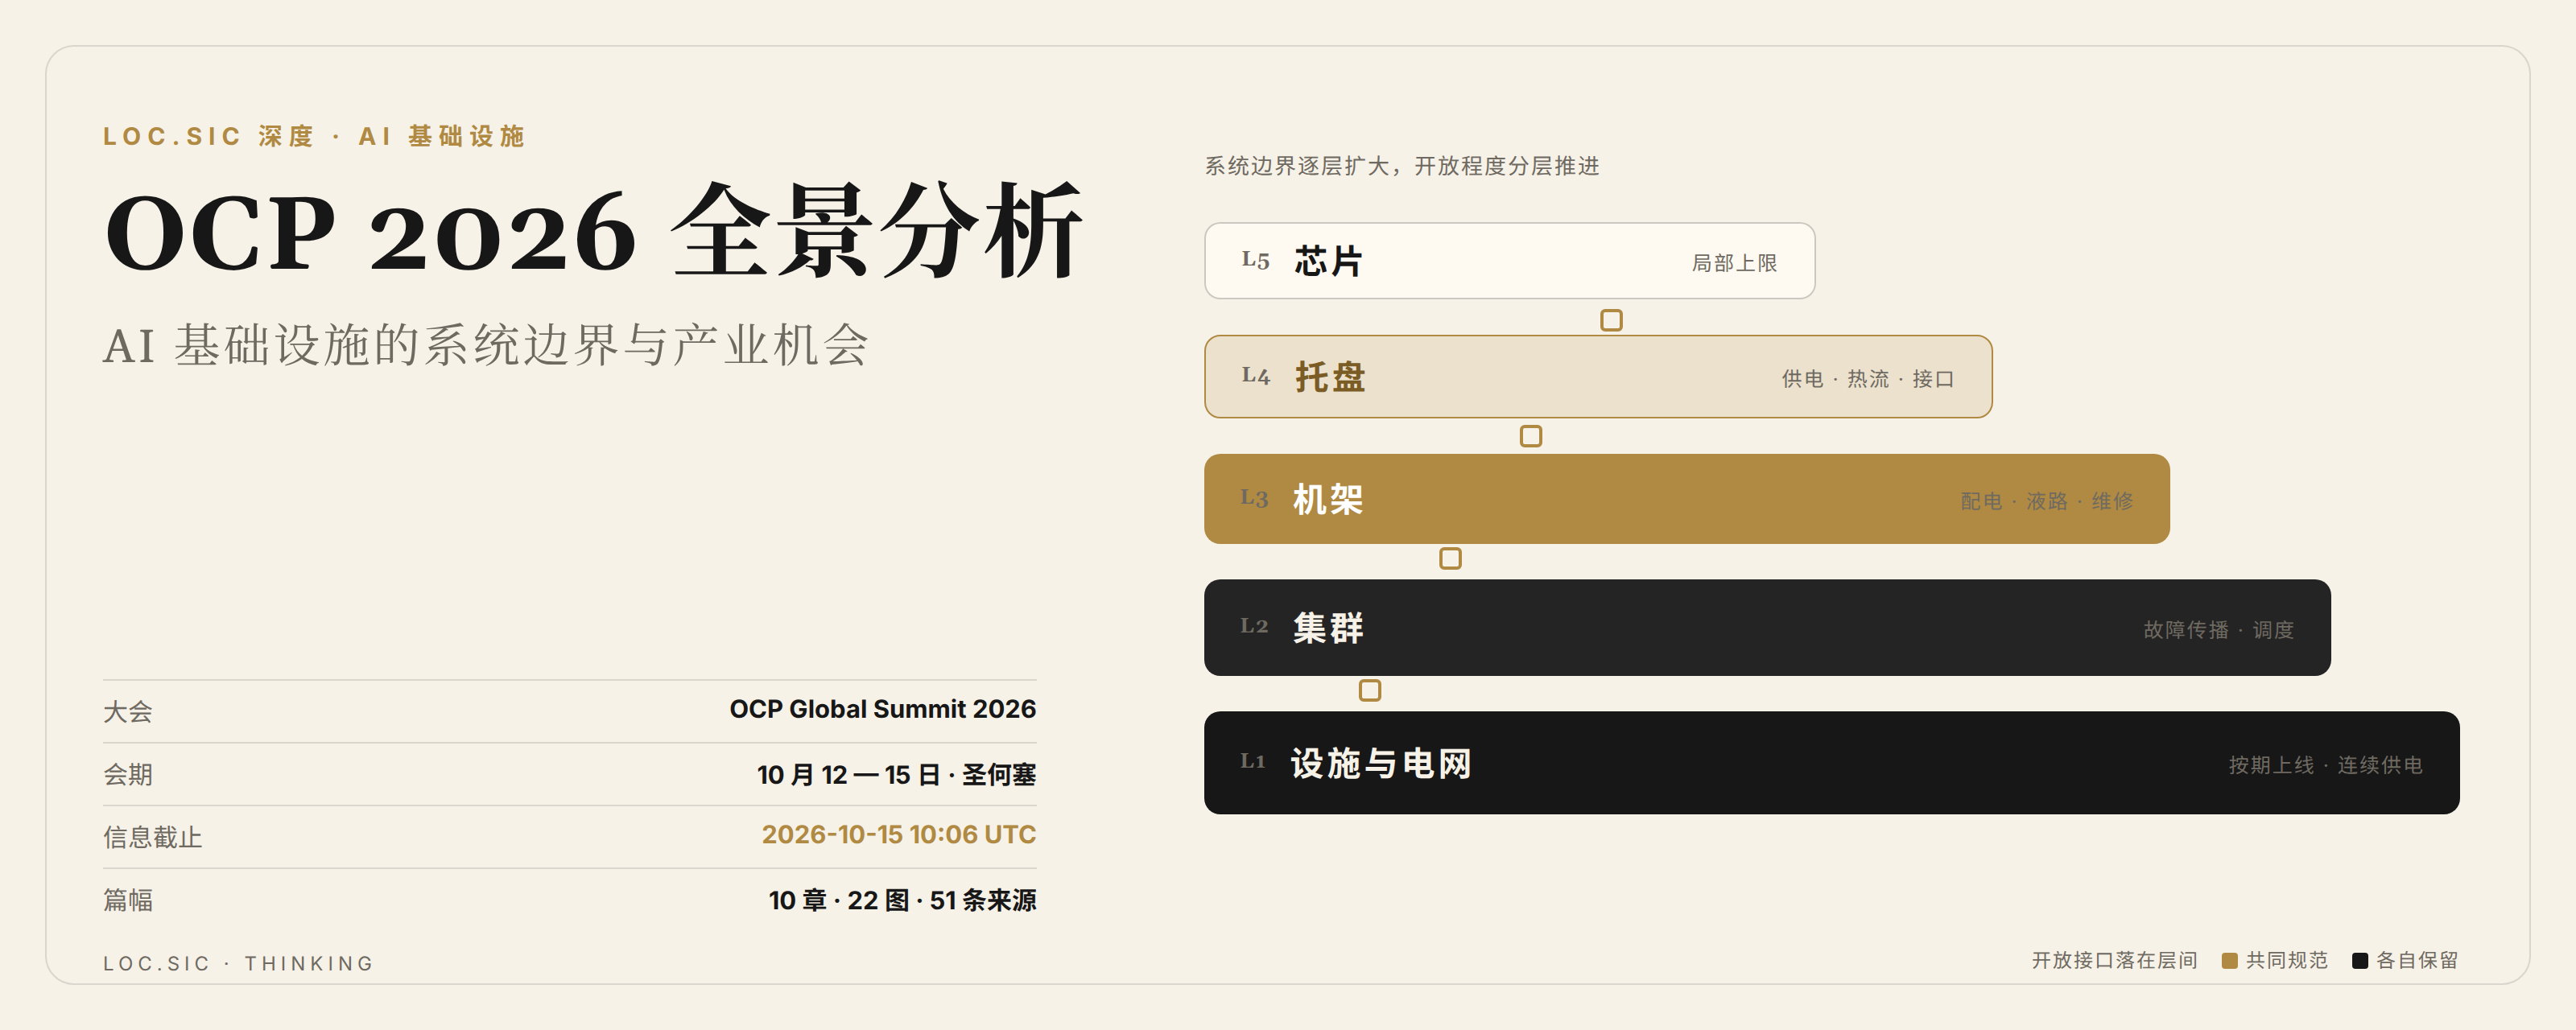
OCP 2026 全景分析
AI 基础设施的系统边界与产业机会
信息截止 2026 年 10 月 15 日 10:06 UTC 北京时间与新加坡时间 18:06 圣何塞当地时间 03:06 PDT
OCP 2026 最值得重视的变化,是 AI 基础设施的设计、交付与运维单位继续扩大。芯片性能决定局部上限,机架及多机架通信域决定算力怎样协作,供电、冷却与故障恢复决定这些算力能否持续成为可出售的服务。开放标准的价值因此延伸到服务器以外,但各层的开放程度、互操作能力和商业成熟度差异很大。采购一套符合开放接口的机架,并不意味着其中的加速器、互联和软件已经可以自由替换。
对服务器、云服务与存储产品团队,本届大会给出的共同方向是:把产品承诺从峰值规格推进到可验证的系统结果。应该同时回答真实业务吞吐、尾延迟、持续供电散热能力、故障后的有效容量和上线周期。对于以模型服务为核心的 Token 工厂,更合适的目标是满足质量和时延约束的有效产出,而不是单独追求每秒 Token 数。
本报告所指 OCP 2026 为 10 月 12 至 15 日在圣何塞举办的 OCP Global Summit,并纳入会前紧邻大会的官方公告。截止时大会最后一天的日间议程尚未举行,因而这是一份进行中的全景判断,不将预告议程当作已经发生的发布或部署。来源以 OCP、厂商公告、正式技术文档及代码库为主;厂商性能数字保留其测试或预测属性,文中的工程判断与行动建议不作为已实测的收益。[1]
01 系统边界扩大与开放程度分化
理解今年的技术密度,需要先把设计对象分成几个相互约束的层次。模型和业务决定算力、内存容量及通信形态;加速器和 CPU 决定托盘的供电、热流密度与接口;机架决定配电、液路、布线与维修方式;集群决定故障传播和资源调度;设施与电网决定能否按期上线、连续供电和扩大容量。任何一层改变,都可能迫使相邻层重新验证。这是机架级集成越来越有吸引力的根本原因,也解释了为什么单块芯片的优势不能直接换算成整个服务的经济优势。
OCP 在 2025 年 10 月已提出扩大到 chip-to-grid 的数据中心愿景。2026 年的增量主要是把这个愿景转化为更多接口、参考设计和跨领域协作;不能把它重新包装为本届首次提出。OCP 同时明确指出,800V 直流母线与布局仍有待完善,光互联的通用开放要素也尚未充分定义。这意味着方向较清楚,实施仍存在缺口。[2]
“开放”至少包含四种不同的能力。设计文档可获得,帮助供应商理解系统;接口有共同规范,帮助不同部件连接;存在多厂商验证,帮助客户降低替换风险;软件和运维链可迁移,帮助客户真正转换供应商。前三种可以逐步改善,第四种往往最难。若驱动、通信库、编译器和故障诊断仍深度绑定某个平台,机械和电热设计的开放带来的主要收益,是扩大制造和集成生态,而不是立即消除平台依赖。
从工程上看,开放还会重新分配责任。垂直集成平台通常由一个供应商承担系统结果,开放组合则需要有人负责跨部件验证。客户可以获得更多选择,却不能省去兼容性矩阵、固件联调、异常工况测试和备件管理。真正有商业价值的开放方案,应能明确说明谁对链路错误、漏液、功率波动和集群恢复负责,以及该责任覆盖哪些软硬件版本。
本届会议因此更适合被看作不同成熟度的工程进展集合。正式规范解决的是共同语言;参考设计提供可复用起点;展台演示证明特定条件下能够运行;计划上市说明供货目标;规模运行才提供持续可靠性的证据。产品路线图可以参考所有这些信号,采购承诺却应主要建立在可交付配置和可复验数据上。后文沿这条界线讨论各技术方向。
02 算力平台与 CPU 的重新分工
机架级平台的竞争已经同时覆盖加速器和 CPU。NVIDIA 本届公开 Vera Rubin 的部分机架与托盘设计,MGX 1.2 支持最高 250kW,并加入盲插液冷等接口能力。这里的开放对象是选定的系统设计,250kW 是架构支持值,不能理解为所有机架的实用功率,更不能外推为整个 GPU 与软件平台开源。[3]
AMD Helios 则是跨年度演进的例子。它在 2025 年已有展示,今年的重点是生产爬坡、初始客户安装与工作负载验证。AMD 同场展示 Verano,但其可用时间仍指向 2027 年。这些信息说明平台正在从设计走向交付,尚不足以证明所有客户已进入稳定的大规模量产阶段。[4]
AMD 的新蓝图 Helion 把另一类需求凸显出来:agent 执行不只消耗模型推理资源,也需要沙箱、代码执行、编排和通用服务。官方描述了 CPU-only 与 CPU/GPU 混合机架,并计划贡献规范;合作伙伴配置仍开发中,目标可用时间为 2026 年 11 月。其最高 32,768 核等数字属于配置上限,不能与混合机架中所有其他上限同时相加。[5]
这个方向的产品意义,不在于找出一个固定 CPU 与 GPU 配比。检索、浏览器操作、代码执行和长时间等待外部工具,会产生完全不同的资源曲线。大量短生命周期沙箱可能首先受启动时延和隔离开销限制;数据密集工具可能受 CPU 内存带宽限制;只做简单工具路由的服务则未必需要高密度 CPU 机架。团队应从每种任务的执行轨迹出发,统计 CPU 活跃时间、内存驻留、I/O 与模型调用的重叠关系,再决定独立扩容还是混合部署。
纯 CPU 池与推理集群分离,有利于按各自需求扩缩容,并减少模型代际变化对 agent 执行资源的牵连。混合机架对中等规模企业更容易采购和运维,但也更容易因业务结构变化出现一边饱和、另一边闲置。服务器厂商如果能提供经验证的组合区间、独立维护单元和一致的管理接口,其价值会高于单纯提供更多 SKU。
Arm 本届发布的 agentic 基准也应放在这个背景下理解。其公布的 Signal65 验证工作包含服务器实测和机架级建模,不是完整机架对完整机架的所有业务通用结论。不同图表还采用不同 AMD 基线。CPU 选型应直接复现本方的沙箱、检索和编排负载,不能把某个平均倍数当作架构的普遍优势。[6]
另一个值得跟踪的分支是大容量、较低功率的推理卡。Intel 本届材料描述了采用 LPDDR5X 的 GPU D-series,处于客户采样阶段;“最高 480GB”覆盖 ODM 可实现的配置,Intel 自有品牌卡为 160GB。容量可以增加模型状态的容纳空间,但长上下文和高并发吞吐仍取决于带宽、数据布局与软件执行效率,不能直接与 HBM 平台的吞吐画等号。[7]
03 超节点需要按通信与故障边界比较
Microsoft Maia 300 展示了把推理系统继续向大通信域推进的路线。官方给出 96 加速器、167kW 的机架配置,并计划从 2027 年开始生产部署。其相对 GPU 系统的效率提升是预期值;相对 Maia 200 的倍数是整架 Token 吞吐,既不是同功率的普遍比较,也不是单芯片提升。当前已服务生产负载的 Maia 200 与未来 Maia 300,应始终分开。[8]
架构文档进一步描述了最高 128 架、12,288 加速器的共同通信语义范围,机架内使用电连接,跨架使用光连接。不同路径拥有不同跳数和延迟;跨架带宽数字还附有并发条件,不能解读为全部设备同时无阻塞互传。这里真正值得分析的是系统如何把较大的通信范围交给软件使用。[9]
大通信域能够给模型放置提供更多组合,也可能让空闲容量更容易被利用。但共同通信语义不等于物理上的统一延迟。张量并行、专家并行、流水线并行与预填充及解码(prefill/decode)分离,对通信的敏感程度不同。调度器需要知道本地、同架和跨架路径的差异,尽量把频繁同步放在更紧密的范围,把容量扩展放在能够容忍额外路径的范围。否则,表面上获得更大的资源池,实际可能增加同步等待。
横向比较超节点时,节点数量尤其容易误导。72 个加速器的机架、96 个加速器的机架和上万设备可寻址的通信域,描述的并非同一层级。应逐项比较可共同执行的任务范围、实际集合通信(collective)或全互连通信(all-to-all)效率、拥塞下的尾延迟,以及维修时受影响的最小单位。峰值链路速率只能解释其中一部分。
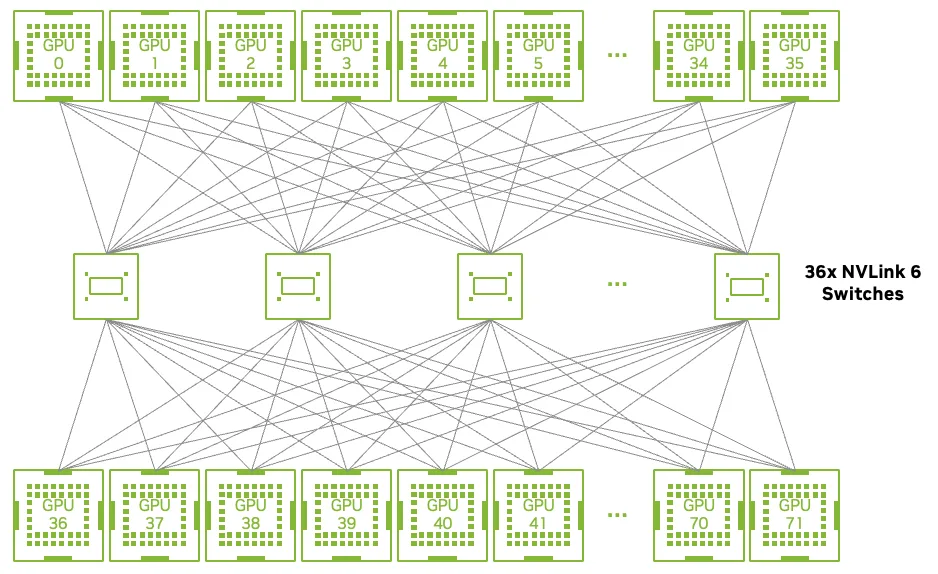
集成度还改变了可靠性的算术。规模越大,观察到单部件故障的频率通常越高;关键在于故障能否局部隔离,以及应用能否以降级方式继续服务。可热插拔的托盘不代表任务自动恢复,备用加速器也不等于无需重建状态。采购验收应包含链路降级、节点退出、重启和回补容量的完整过程,把恢复时间、丢失工作量与剩余服务能力写进测试。
因此,超节点对云产品的意义是提供更细致的服务分层。紧密通信任务购买低延迟域,松耦合推理和独立 agent 任务使用更弹性的池;不同等级应有相应定价和可用性承诺。硬件扩大的资源边界,只有通过可观察的拓扑和可执行的调度策略,才能转化为客户可感知的性能。
04 网络标准并未收敛为一种协议
网络需要区分 scale-up、scale-out 与跨设施连接。前者主要解决紧密协作的加速器通信,第二类承载更大集群的训练和服务流量,跨楼或跨园区又会引入更明显的传播时延与故障边界。它们可以共享以太网的器件与运维生态,但不能据此推断传输语义、拥塞控制和错误恢复已经统一。
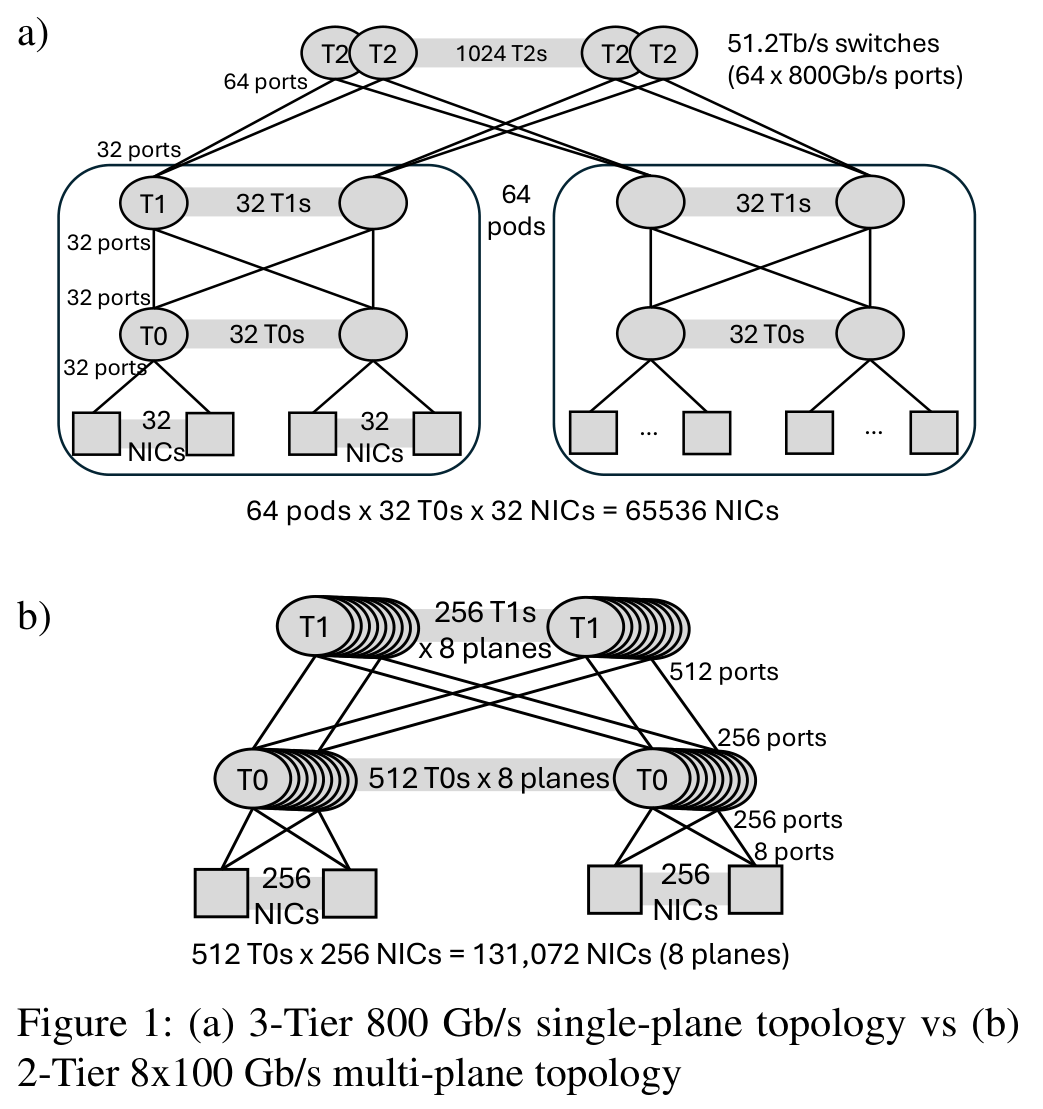
多路径可靠连接 MRC 是今年重要的生产证据,却不是本届才首次出现。OpenAI 在 5 月公布该方案及其大型 GB200 集群部署,通过多平面、喷包和端点恢复改善扩展性。这里的进展是把路径多样性变成系统可用的能力;它与依靠 PFC 的无损以太网方案有不同的拥塞和丢包处理假设。[10]
Meta 本届材料则体现了另一条渐进路线:当前出货的 Tahan 使用既有 RoCE 机制,未来更大 scale-up 方案才计划采用 ESUN。它还提出开放交换机平台抽象,减少传感器、固件和电源管理的碎片化。因此,同一家公司也可能同时维护不同代际和不同语义的网络,不能用“全面进入新协议”概括。[11]
ESUN 1.0 的规范在今年早些时候已发布,其核心是运营方对 fabric 的需求;1.1 在推进中。UALink 2.0 也在 4 月发布,包含计算、管理和分层演进方面的规范。公开规范提供共同开发基础,仍不能替代端点和交换芯片的供货、通信库适配以及跨厂商互操作验收。[12][13]
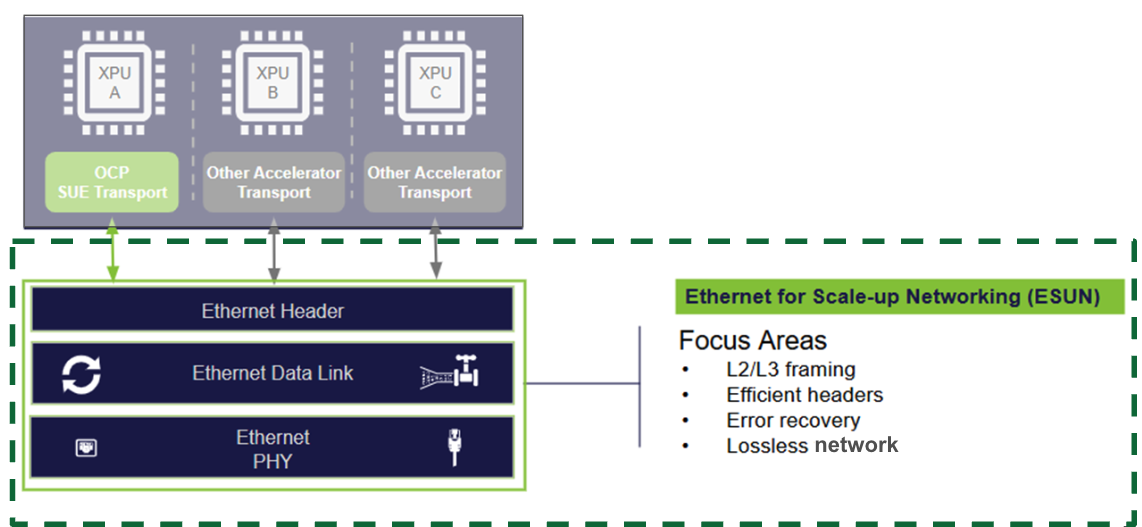
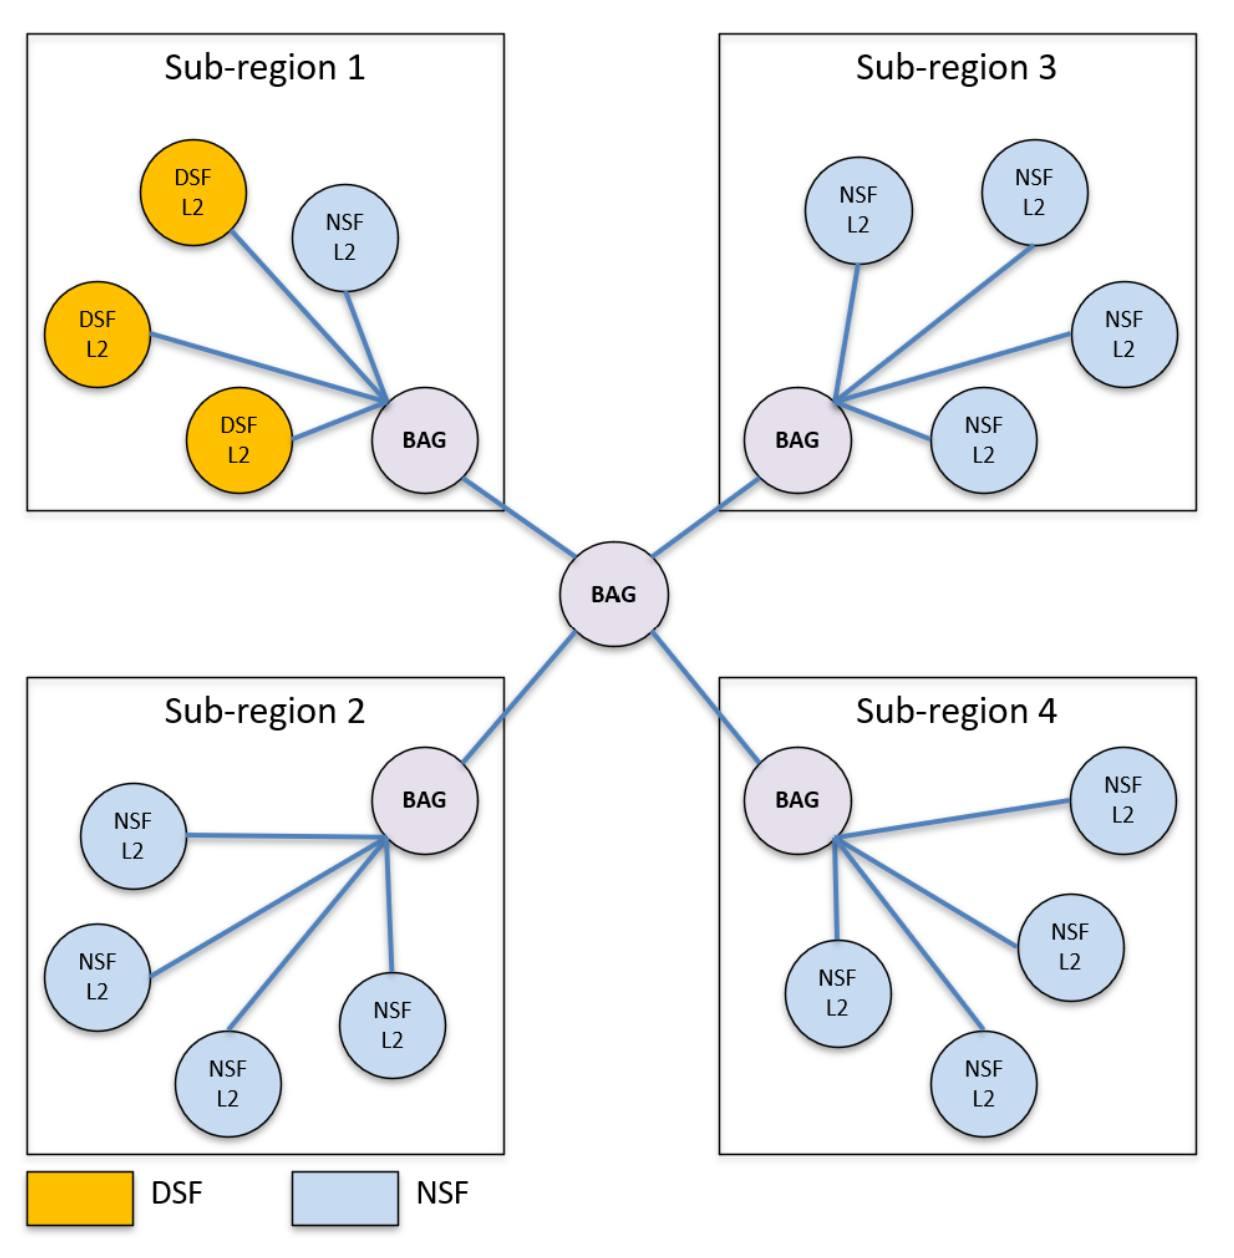
多平面网络的工程吸引力,在于用更多相互独立的路径减少层级,并把部分故障转成可容忍的带宽下降。代价是乱序重组、路径选择、拥塞反馈和遥测都更依赖端点与网络协作。交换机拥有相同速率,或都运行 SONiC、SAI,并不能证明升级、QoS 和恢复行为一致。验收应覆盖丢包、微突发、单路径失效和混合负载,而不是只测无拥塞吞吐。
对网络产品团队,应把“支持某协议”拆成清晰的能力表:端点版本、交换配置、通信库、分区隔离、拥塞算法和可观察指标。对云团队,网络拓扑与模型调度需要共同设计。任务跨越更远区域之前,应先评估通信占比和尾延迟预算;地理上分散的容量有容灾和电力方面的价值,但并不自动构成与单机架等价的超节点。
05 光互联进入系统工程阶段
共封装光学 CPO 将光引擎靠近交换或计算芯片,试图缩短高速电连接;可插拔模块保留现场维护与独立更换的优势。OCP 2026 同时出现两条路线的投入,这比“某一种光学形态即将全面胜出”更符合工程现实。NVIDIA 与 Cisco 宣布的 USFP 面向更高带宽密度,开放规范和多来源社区项目仍属计划,不能当作已经完成的供应链。[14]
CPO 的成熟度也不一致。Celestica 发布 DS6005 系统,Lightmatter 的交换方案属于生产验证平台,其计算托盘属于概念验证;Wiwynn、Ayar Labs 与 GUC 则展示集成光学计算系统的功能验证。这些是有意义的系统进展,但不等于所有方案都已具备规模交付和多年现场运行记录。[15][16][17]
从工程上看,缩短电链路可能减少相关器件功耗,却把一部分复杂度转移到封装、光纤耦合、清洁、热漂移和维修边界。外置、可更换的激光器能够改善某些故障的维修方式,但光引擎或封装本体的失效仍可能要求更换更大的部件。系统比较必须采用一致的功耗边界,同时计算激光、控制器、冷却和备用能力,不能把局部节省直接当成整机节省。
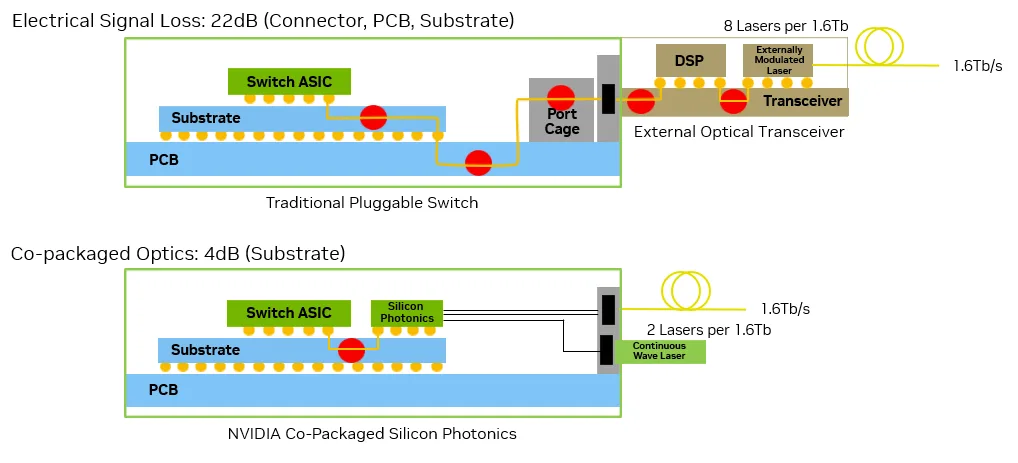
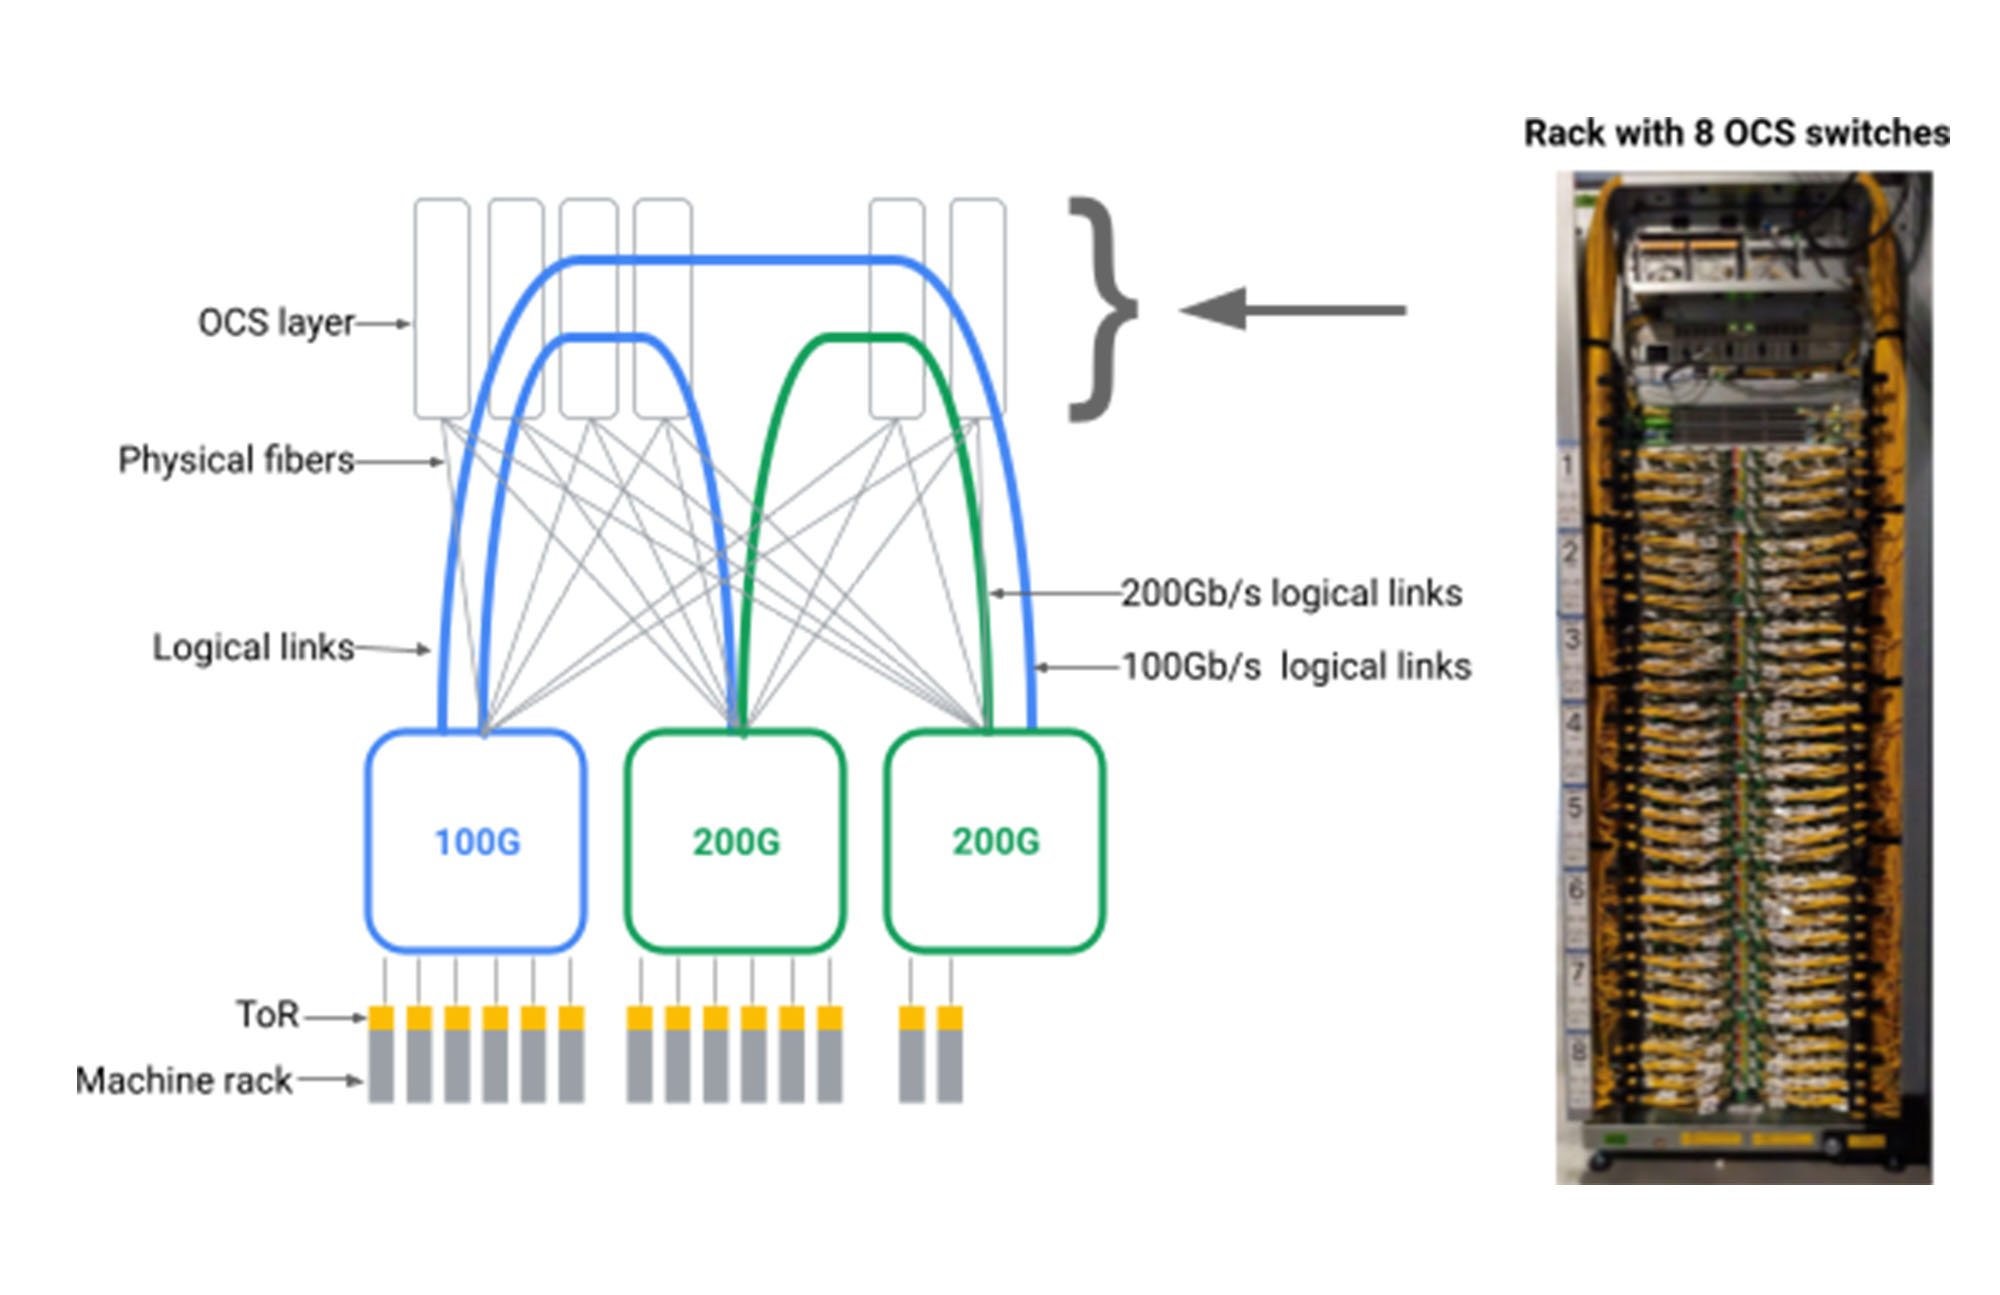
光路交换 OCS 还应单独讨论。它改变的是光路径拓扑,CPO 改变的是电光转换位置;二者可以组合,却解决不同问题。OCP 的 OCS 工作围绕接口、控制、遥测与互操作展开。其潜在收益需要依赖可预测流量和适配的调度器,重配置时间与瞬态影响必须进入任务评估。[18]
近期产品决策宜保留可维护的光学路线,同时建立 CPO 小规模验证环境。采购问题应从端口速率延伸到光口失效率、激光故障影响面、现场清洁、盲插寿命和备件成本。只有当系统级节能和业务收益足以覆盖维护复杂度,光学集成度的提高才形成可兑现的优势。
06 高压直流把电力约束带入算力设计
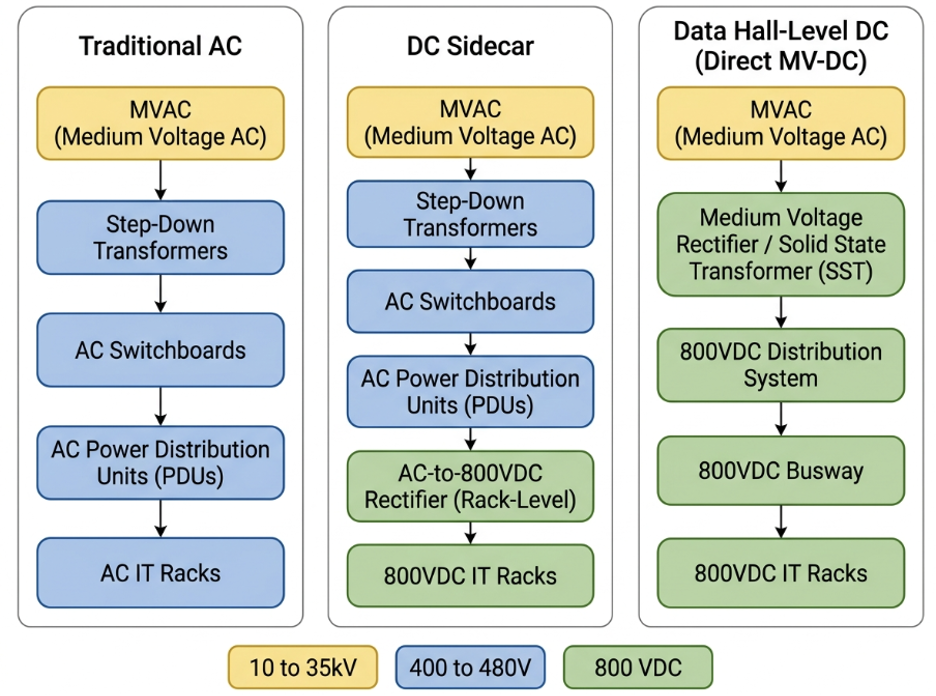
电压提升的机制可以用一个简化计算说明。在不考虑转换损耗、冗余和配电拓扑的稳态条件下,传输 1MW 功率,48V 对应约 20.8kA,800V 对应约 1.25kA。这个例子只解释为什么高功率机架会推动高压配电;它不意味着铜耗或系统能耗按同一倍数降低,也不是具体设备的设计建议。导体长度、截面、转换级、保护策略与安全要求都会改变结果。
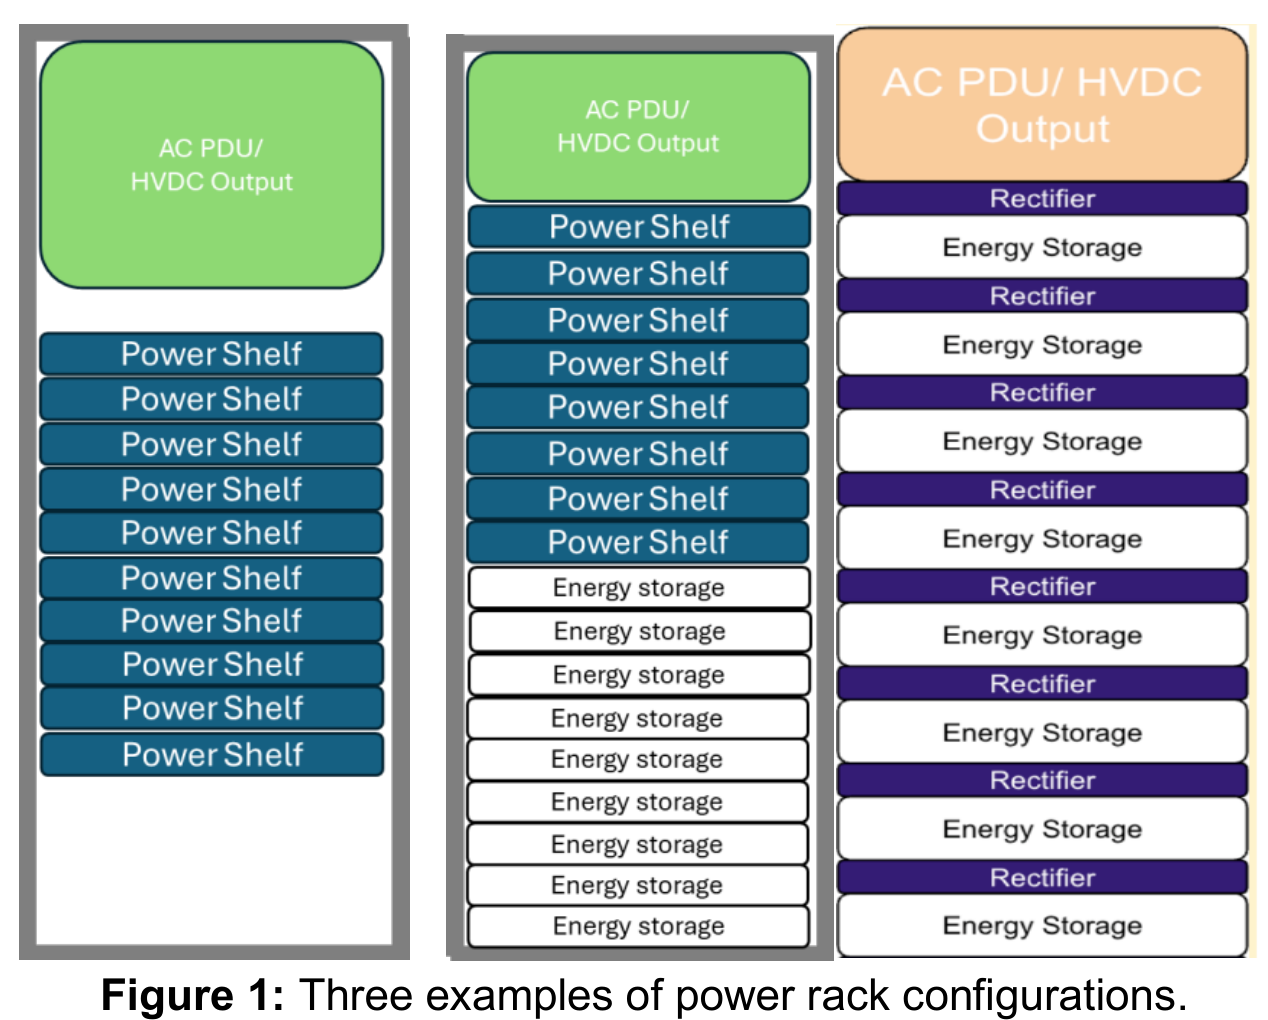
Diablo 的侧车路线把电源转换从 IT 机架中分离,为供电与计算独立扩容提供空间。已核验的 OCP v0.7 文档覆盖 ±400V 或 800V 以及储能选项,但部分连接器内容仍有待定项。侧车因此是可复用的架构方向,不能被理解为所有厂商接口已完成互换验证。[19]
高压直流也并非必须一次改造整座机房。NVIDIA 在 8 月描述过从现有交流机房中的电源机架,走向行级供电,再走向原生直流设施的阶段性路径。这些是跨年度路线和目标,不能全部计作本届已落地的能力。[20] 侧车有利于分阶段推进,代价是占用空间、增加保护协调要求;行级集中化可能提高复用程度,也会扩大某些故障的影响面。
OCP Open Data Center v0.7 面向未来设施的跨厂商边界设计,保留风冷与液冷的组合。其功率密度和集群规模应视作设计目标,而非 2026 年行业部署统计。[21] 对产品团队而言,设施接口的意义是尽早约定供电、液路、机械和管理条件,减少服务器完成后才发现机房无法接入的返工。
更容易被忽视的是电网扰动与计算恢复之间的关系。OCP 的扰动接口规范在限定电压条件下要求,正常电压恢复后两秒内达到故障前 90% 的计算负载;该范围不等于整座机房任意故障的恢复保证,冷却负载还需要单独处理。[22] 若电气系统恢复早于热管理能力,立即回升的算力反而可能触发新的保护动作。
因此,电力控制、冷却控制和任务调度应该共享状态。故障后先恢复多少负载,取决于可用电源路径、流量、温度和储能余量;短时限功率是否会造成任务重试,也需要应用侧配合。Token 工厂不能只优化额定 MW 下的峰值输出,还应验证负载阶跃、限电和维修状态下的可用产能。储能、固态变压器和现场发电可以增加选择,但展会展示本身不能回答长期成本和可靠性问题。
07 液冷采购走向接口与生命周期验证
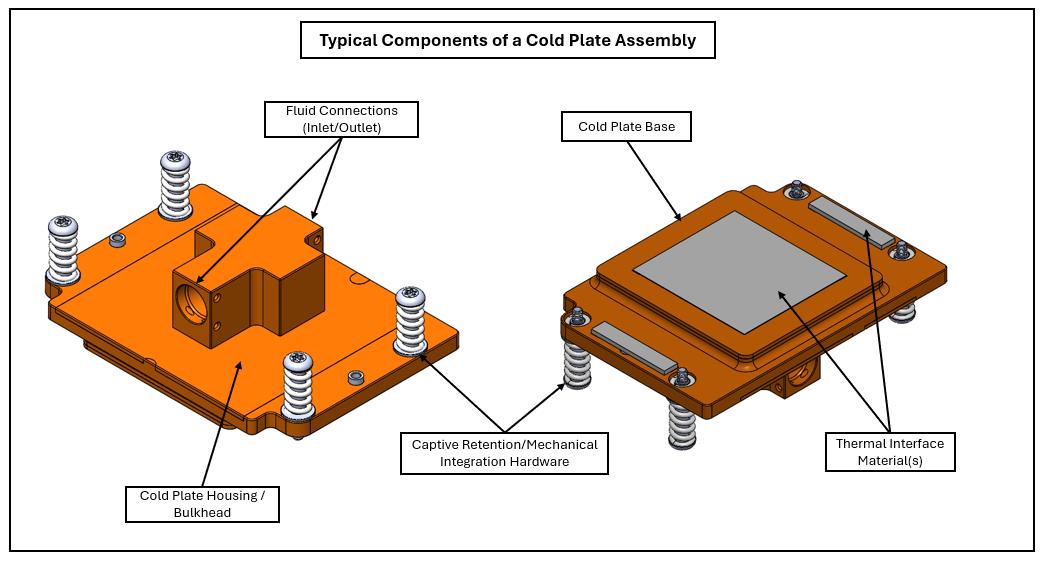
液冷已经进入整套系统的采购语言。冷板能够移走多少热量,只在指定介质、温度、流量和压差下成立。CDU 标称 MW、机架额定功率和芯片热设计功率之间没有自动的一一对应关系。连接器、过滤、脱气、水质、泵冗余和设施侧热交换中的任一短板,都可能改变最终可持续承载的功率。
会前至本届相关规范进展值得重视。UQD v2.0 合并手动与盲插相关要求,并包含供应商交叉验证;兼容性仍需结合部署评估。单相直冷冷板测试规范则覆盖热阻、压降、漏率、耐压、腐蚀与机械循环等项目。这些工作把采购从“看最大散热功率”推进到可重复的工程验收。[23][24]
但标准不能消除所有混配风险。密封材料、尺寸公差、阀行程和液体条件都可能影响实际表现。即使两个产品各自声称符合规范,客户仍需要验证它们在组合状态和老化之后的行为。液路的维修边界也必须明确:更换一个托盘时哪些阀门关闭,流量如何重分配,泄漏检测触发后是否需要停整个机架,恢复操作由谁承担。
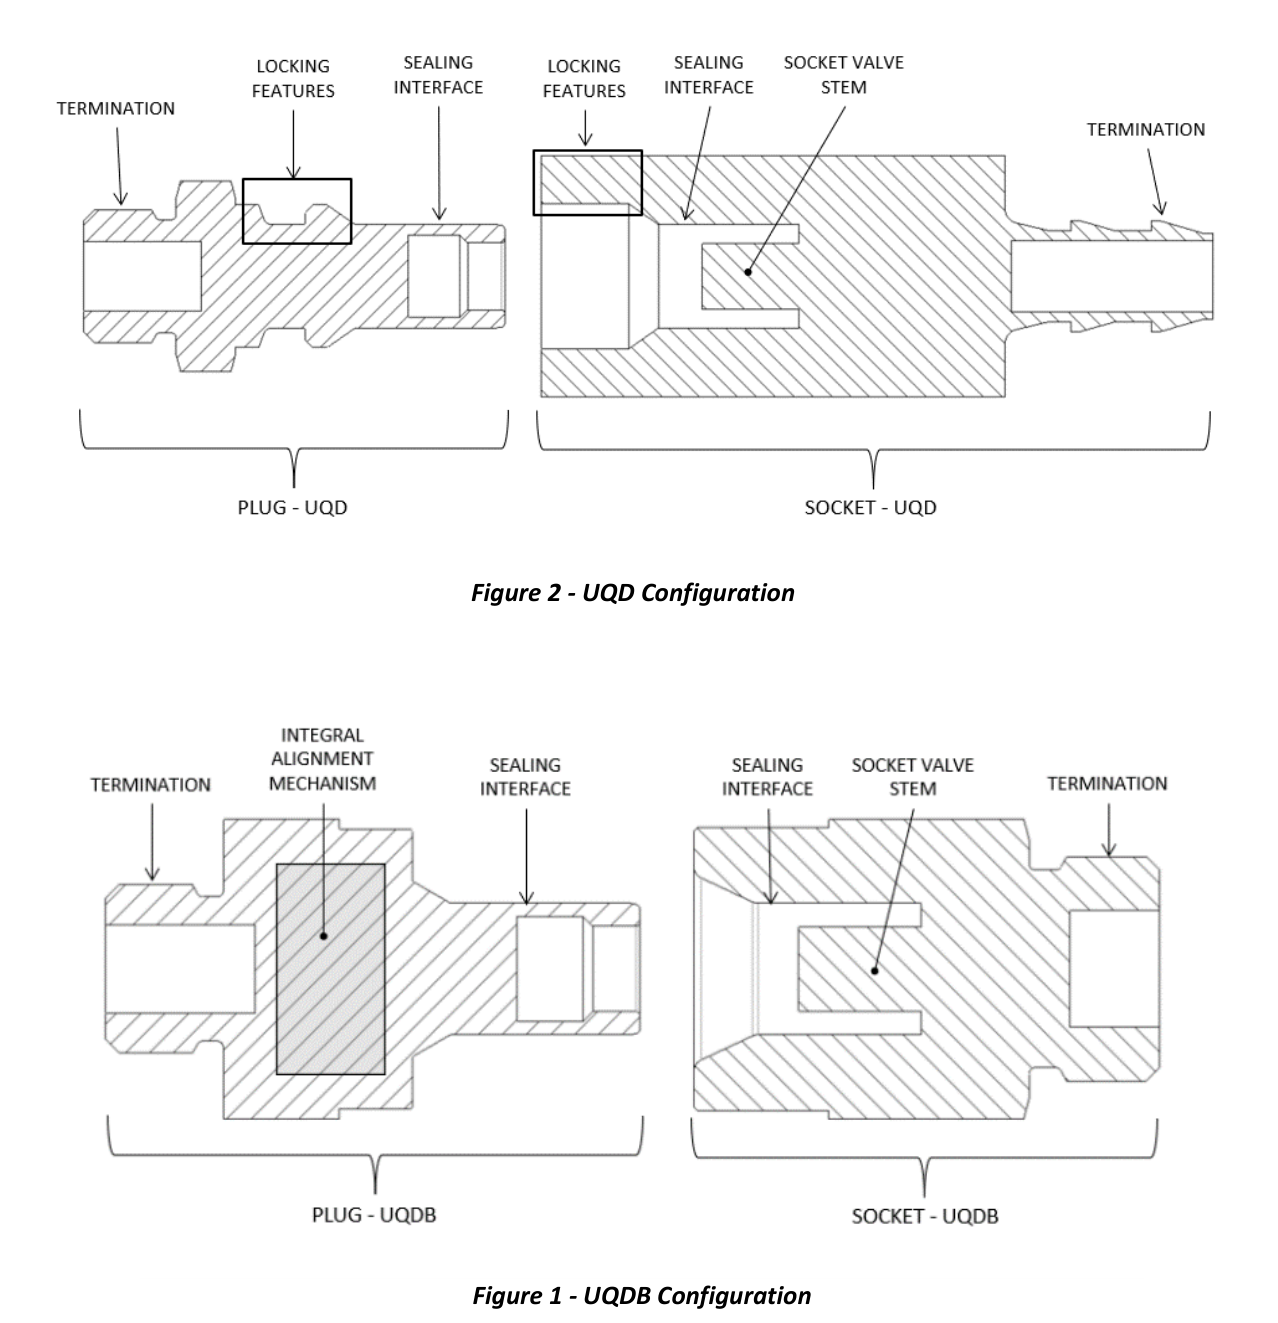
展示设备应按状态评估。Delta 的发布稿给出了 Deschutes CDU 的特定工作点,并计划 2027 年第一季度量产;Rittal 与 Bosch 的高压侧车仍是开发样机。两者都能帮助理解产业方向,但不能据此写成已经完成规模运行验证。[25][26] 比较设备时,应要求同一供回液温度、approach 温差、冗余状态和泵耗口径,否则标称功率的大小缺乏可比性。
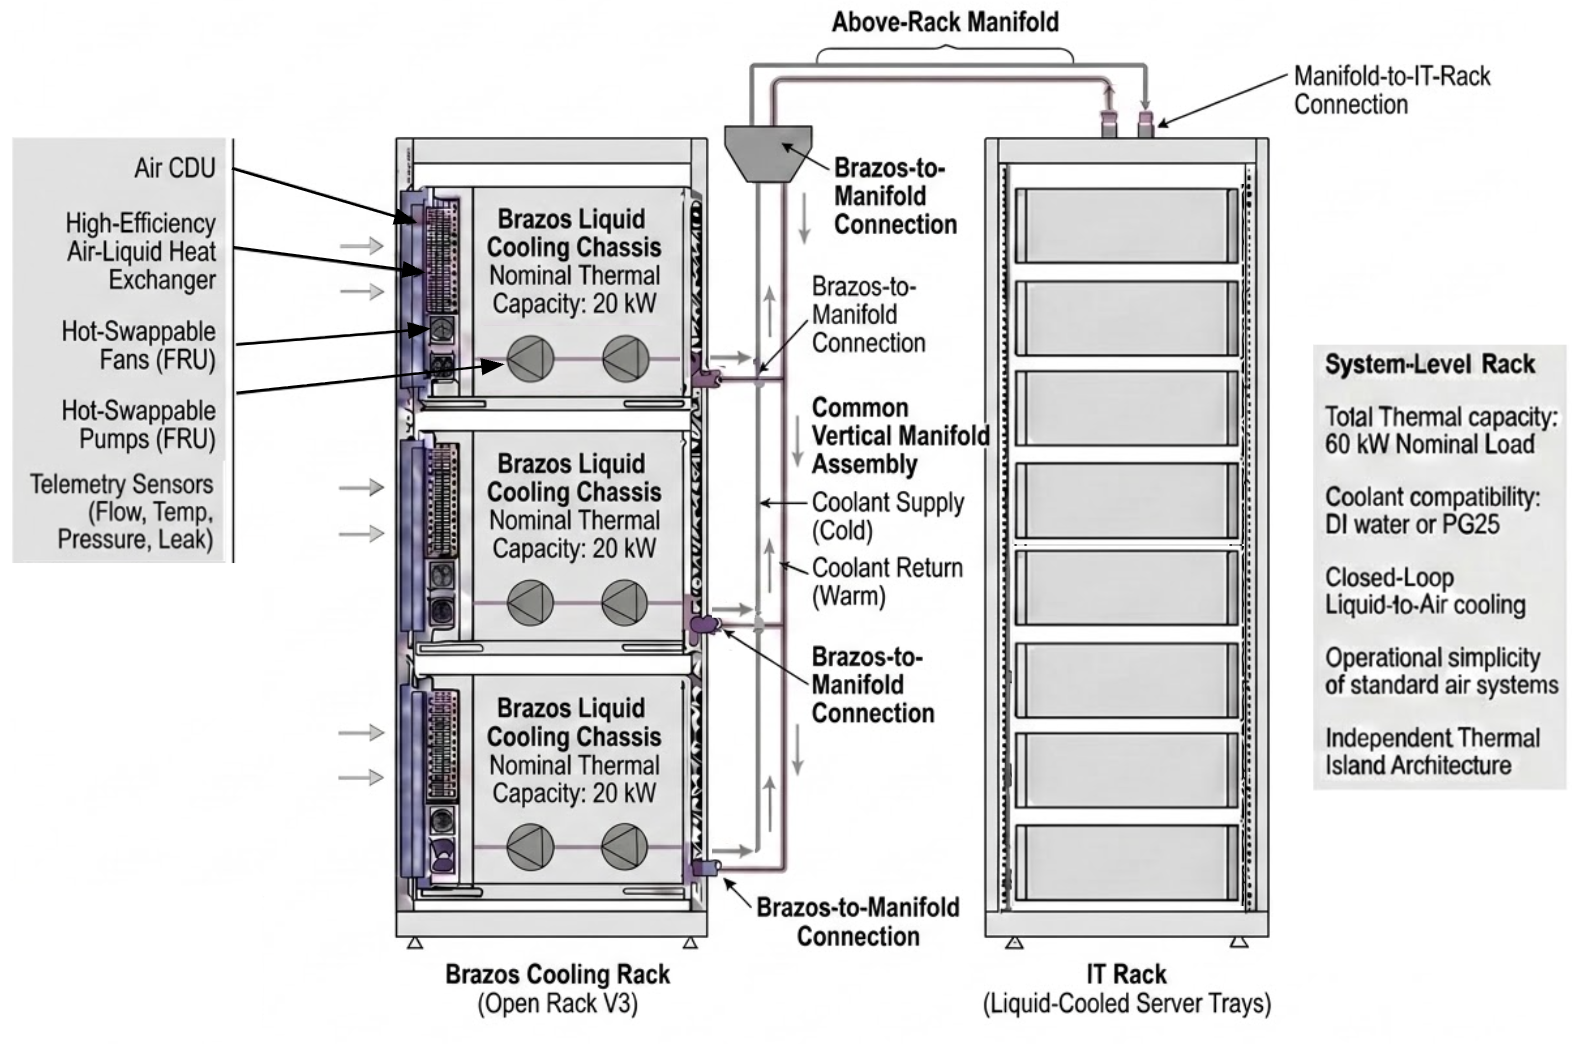
路线选择也需要考虑存量机房。Google 今年较早发布的 Brazos 是面向具有足够供电和空气处理能力的风冷机房的液到空气方案。这说明部署液冷 IT 不一定要求整栋建筑立即完成水系统改造,但较低功率的改造方案不能外推到 MW 级机架。[27]
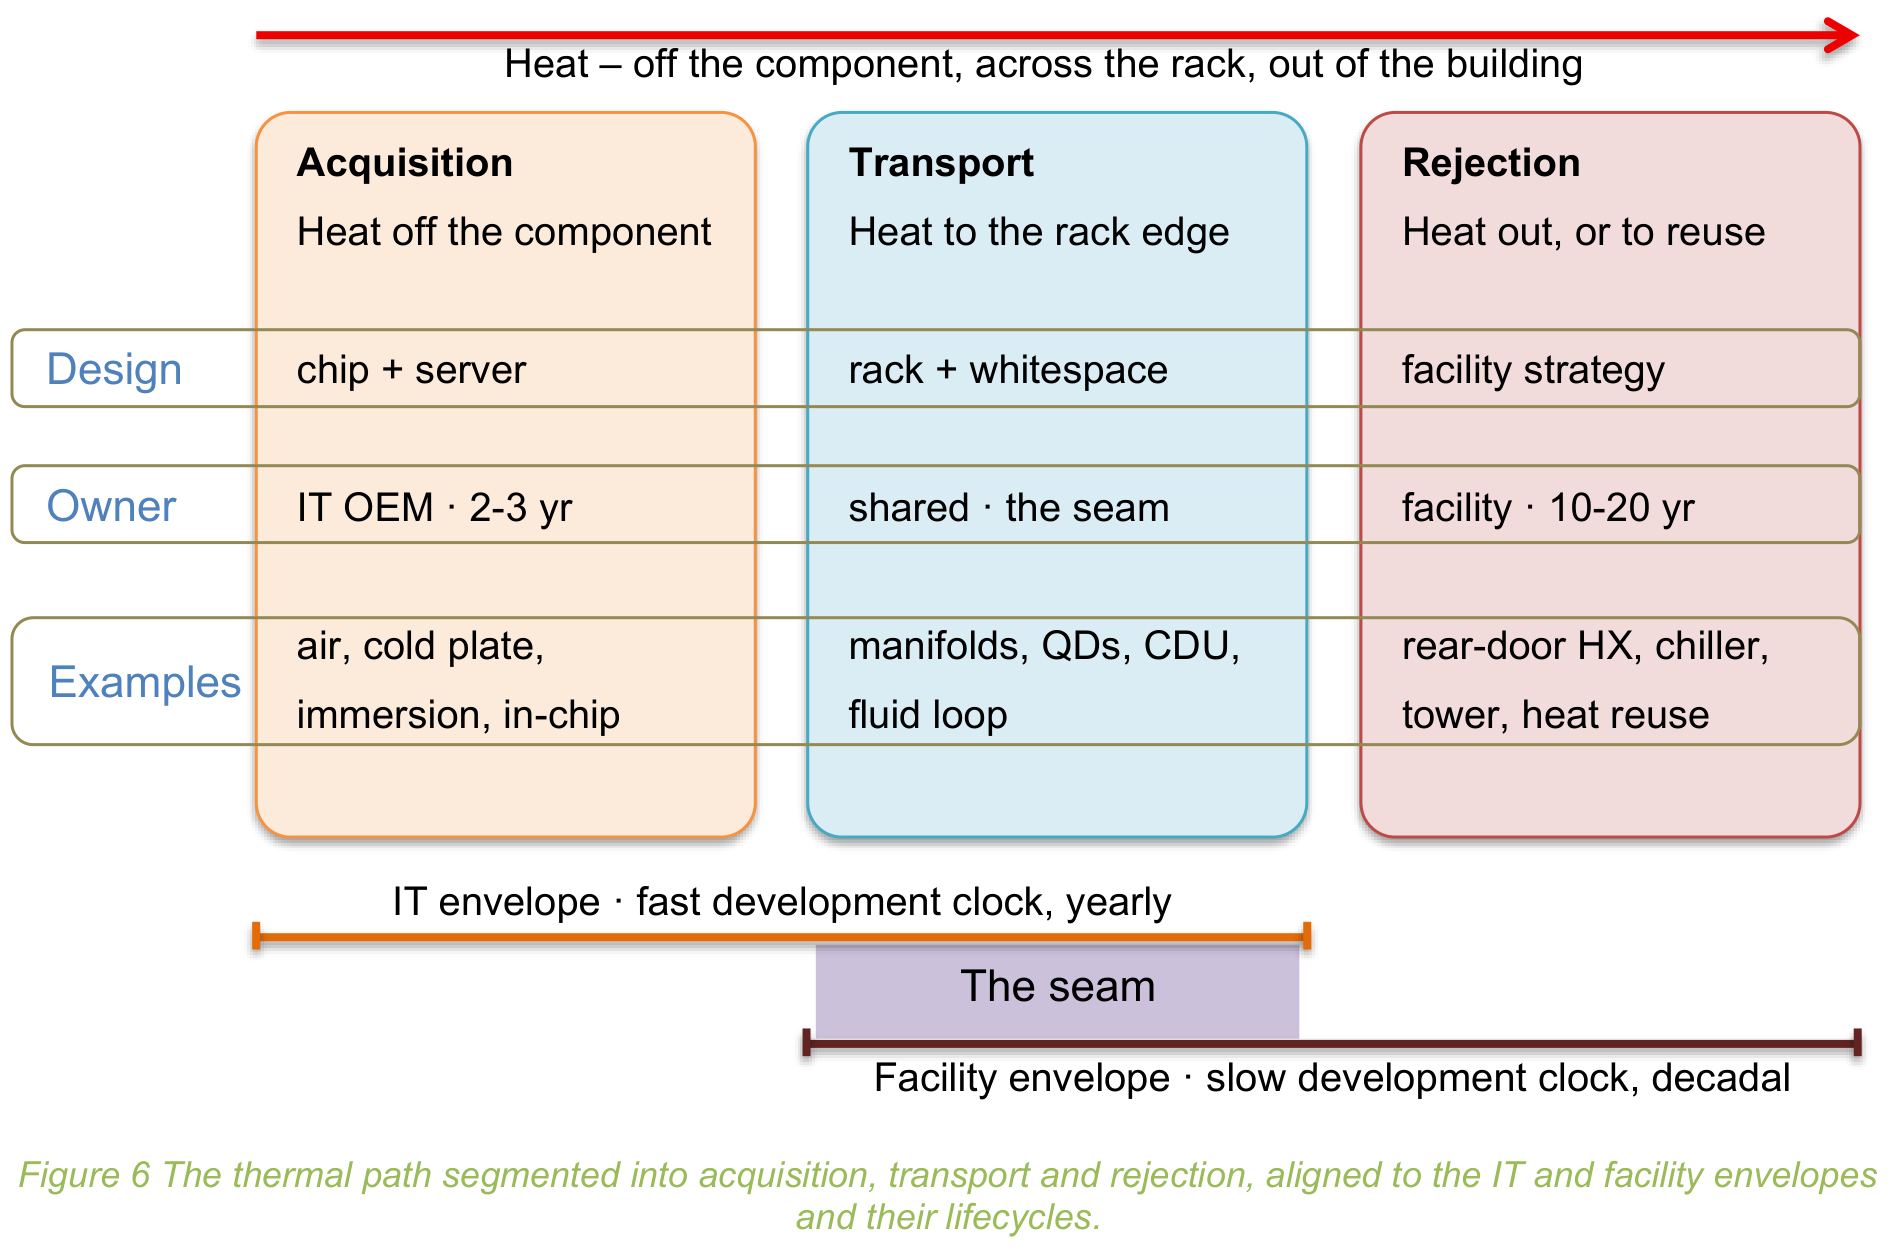
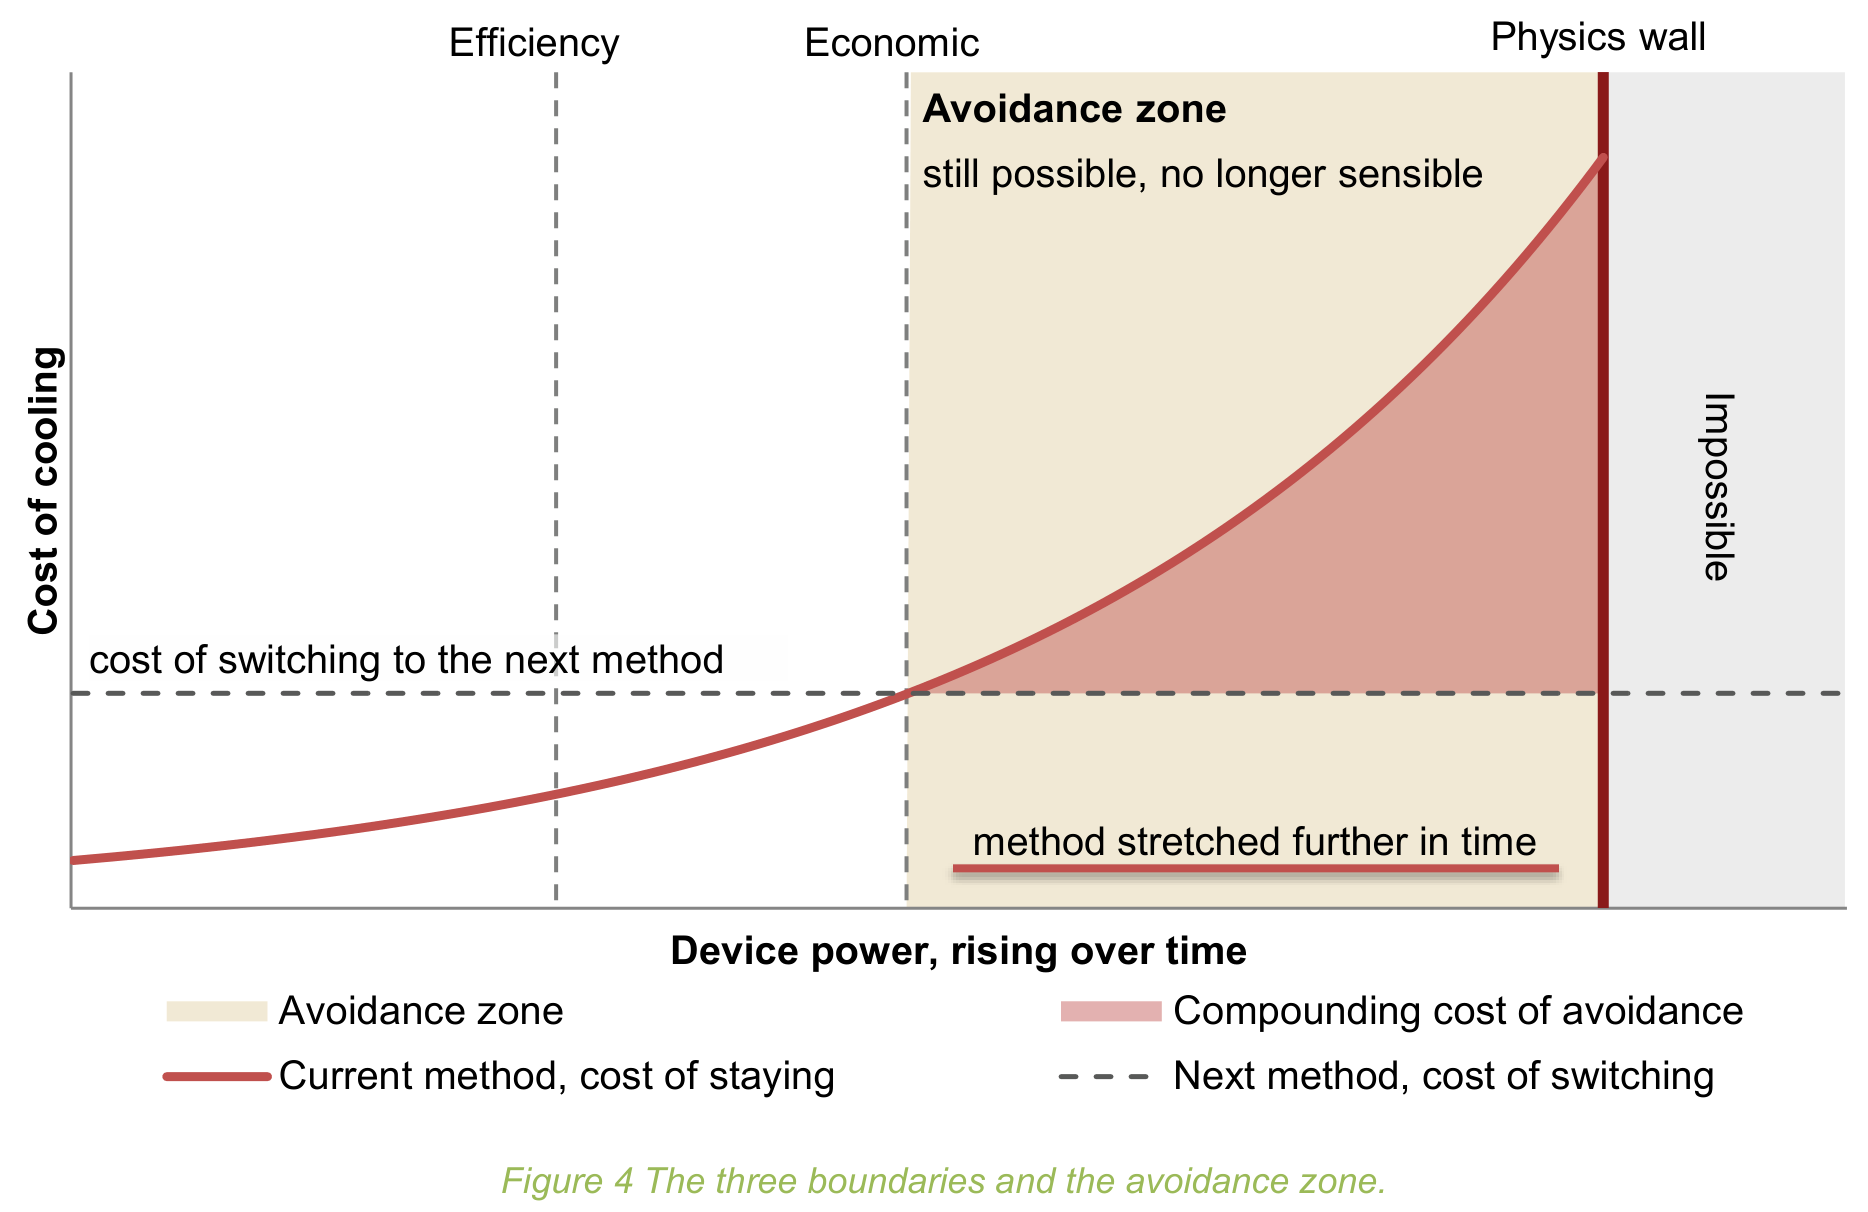
工程上更有价值的能力,是把出厂测试、运输后的检查和现场调试连起来。团队应验证部分负载、泵或电源单故障、冗余维护、真实 AI 功率波动和热循环。冷却方案还要在电力、用水、占地与维护成本之间选择,不能只追求某个 PUE 数字。OCP 新发布的 Thermal Boundaries 白皮书提供的是这种多约束分析框架,而不是对某一路线的产品性能认证。[28]
08 内存和存储开始共同服务推理工作集
推理基础设施的一个重要变化,是工作集不再只按“内存装模型、存储放文件”划分。权重、键值缓存(KV cache)、检索对象、会话状态和 agent 执行数据具有不同寿命与复用方式。热数据需要低延迟或高带宽;容量层需要更低的单位成本;冷数据则需要可靠保存。设计难点是让数据在这些层之间移动的代价,小于保留它们所节省的计算和等待。
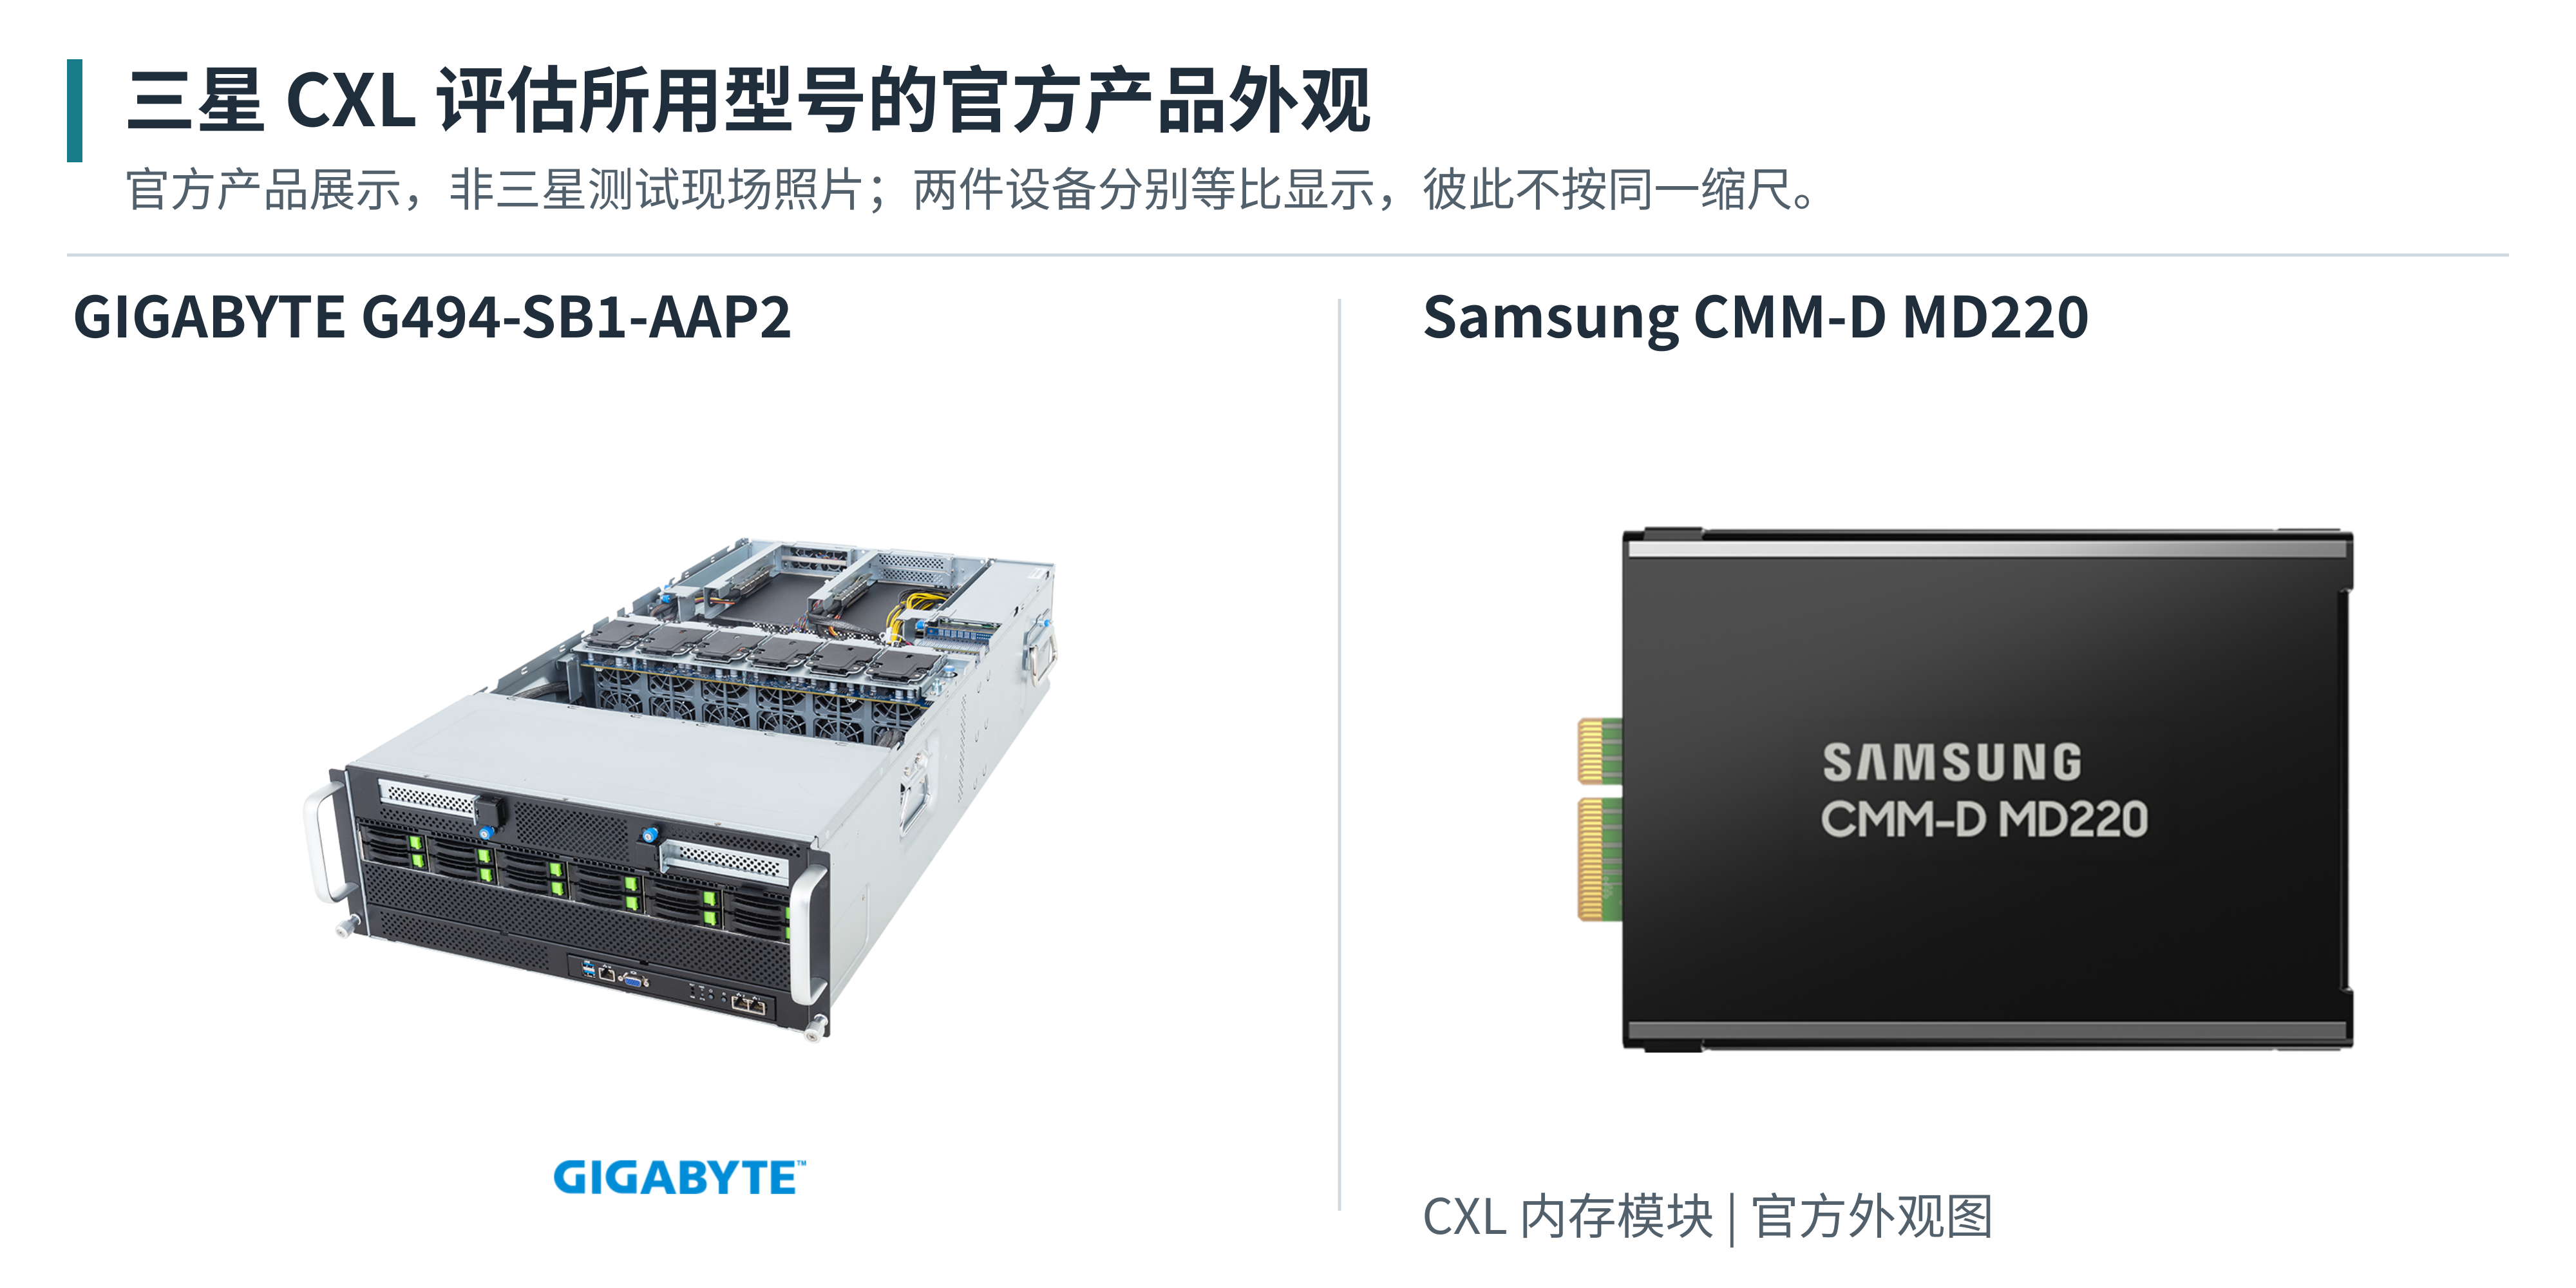
三星本届展示了 CXL 动态内存池,以及将灵活数据放置(FDP)和较大的 NVMe 最大传输大小(MDTS)与 LMCache 结合的 KV 缓存方案。其演示结果依赖指定负载,不能推广为所有模型的固定收益。值得关注的共同点,是硬件容量开始与运行时的分配、回收和 I/O 策略一起设计。[29]
高密度 SSD 为较冷的工作集提供更多选择。三星 BM1773 技术页列示最高 245.76TB 的容量及其耐久度口径;Kioxia LD4 本届展出的是限定客户评估样品,当前样品容量与未来扩展目标不同。容量增长本身既不代表持续写入能力相同比例提高,也不证明目标产品已量产。[30][31]
高带宽闪存 HBF 则是更靠近 xPU(CPU、GPU 等处理器)的读取优化 NAND 层探索。已公开的 v0.7 架构文档早于本届大会,它与 HBM 在一致性、访问特征和用途上存在区别,不能当作成熟的高带宽内存 HBM 等价替代品。[32] 对产品规划,HBF 更适合先跟踪接口、封装和运行时条件,不能仅凭目标带宽和容量提前计算已可实现的成本优势。
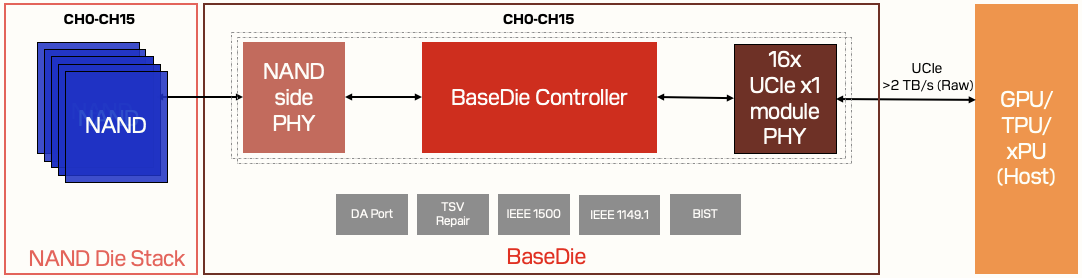
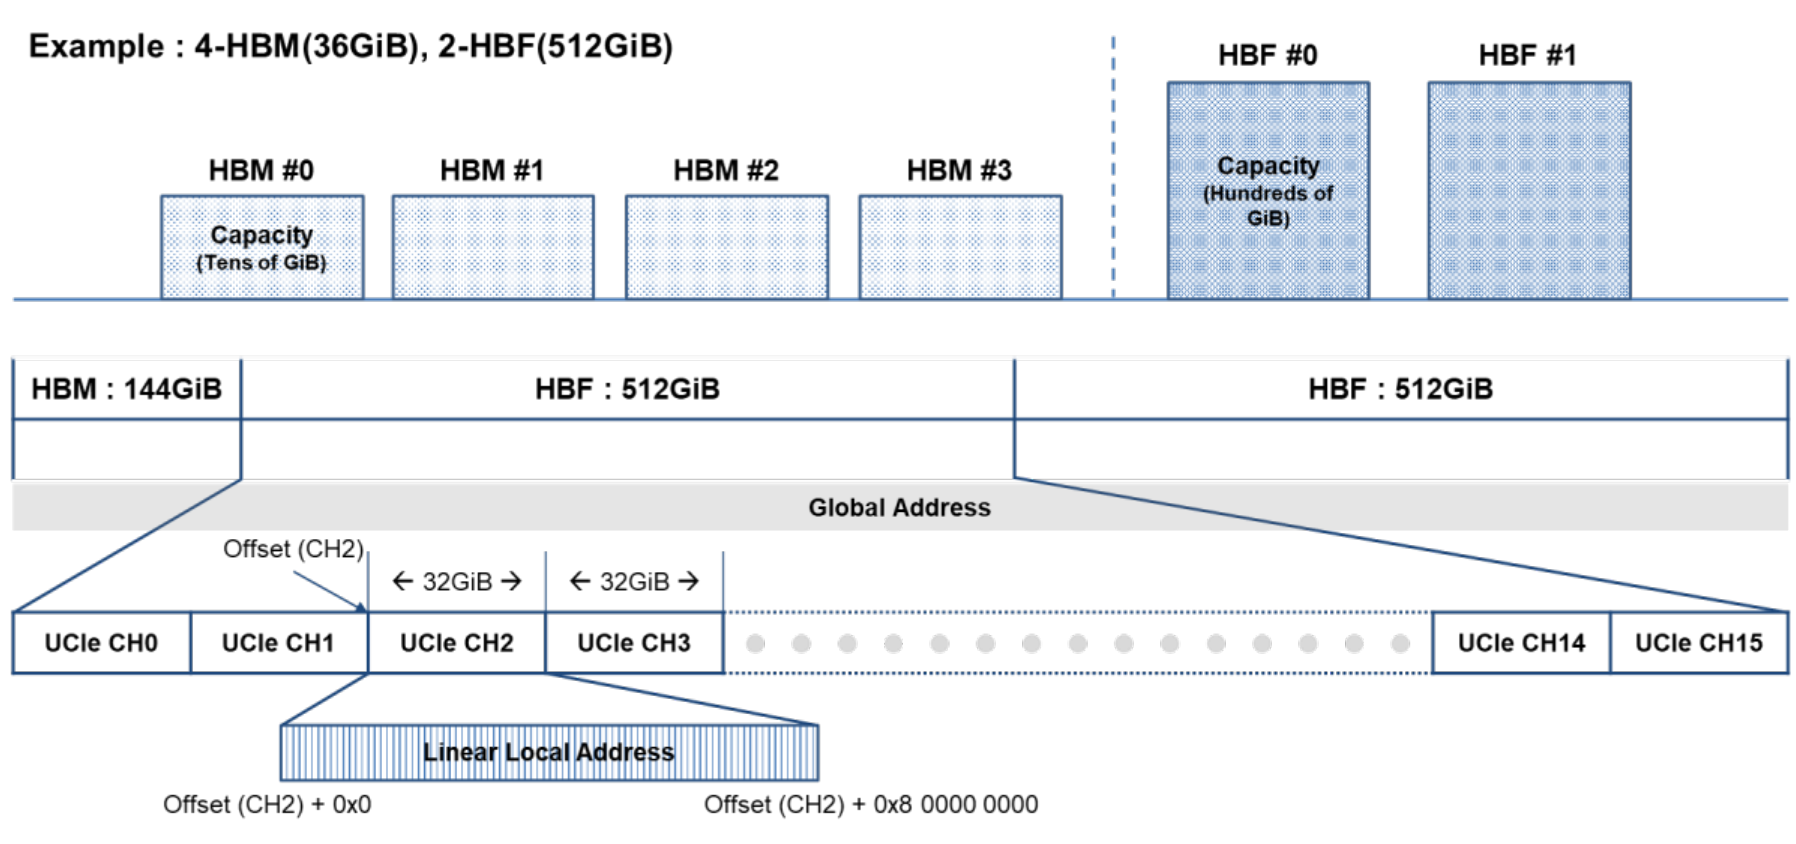
从工程上看,KV 分层的收益取决于复用率和避免重算的价值,同时要扣除传输、排队、管理和失效恢复的开销。长上下文、多轮会话或多租户 agent 可能拥有更多复用机会,短会话则未必值得搬移。缓存命中率也不足以单独判断收益:命中了一个很冷但很大的对象,仍可能因传输占用影响其他请求。需要在统一模型、精度与请求分布下,观察首 Token 时延(TTFT)、逐 Token 时延(TPOT)和满足服务目标的吞吐(goodput)。
CXL 池化同样需要软件边界。可扩展内存不自动等于任意 GPU 都能以同样成本访问,也不意味着不同租户可以直接共享 KV。NUMA、拓扑、所有权、加密、回收与迁移策略必须同时定义。若硬件暴露了容量,而运行时无法正确放置数据,池化可能把局部容量不足转成跨链路等待。
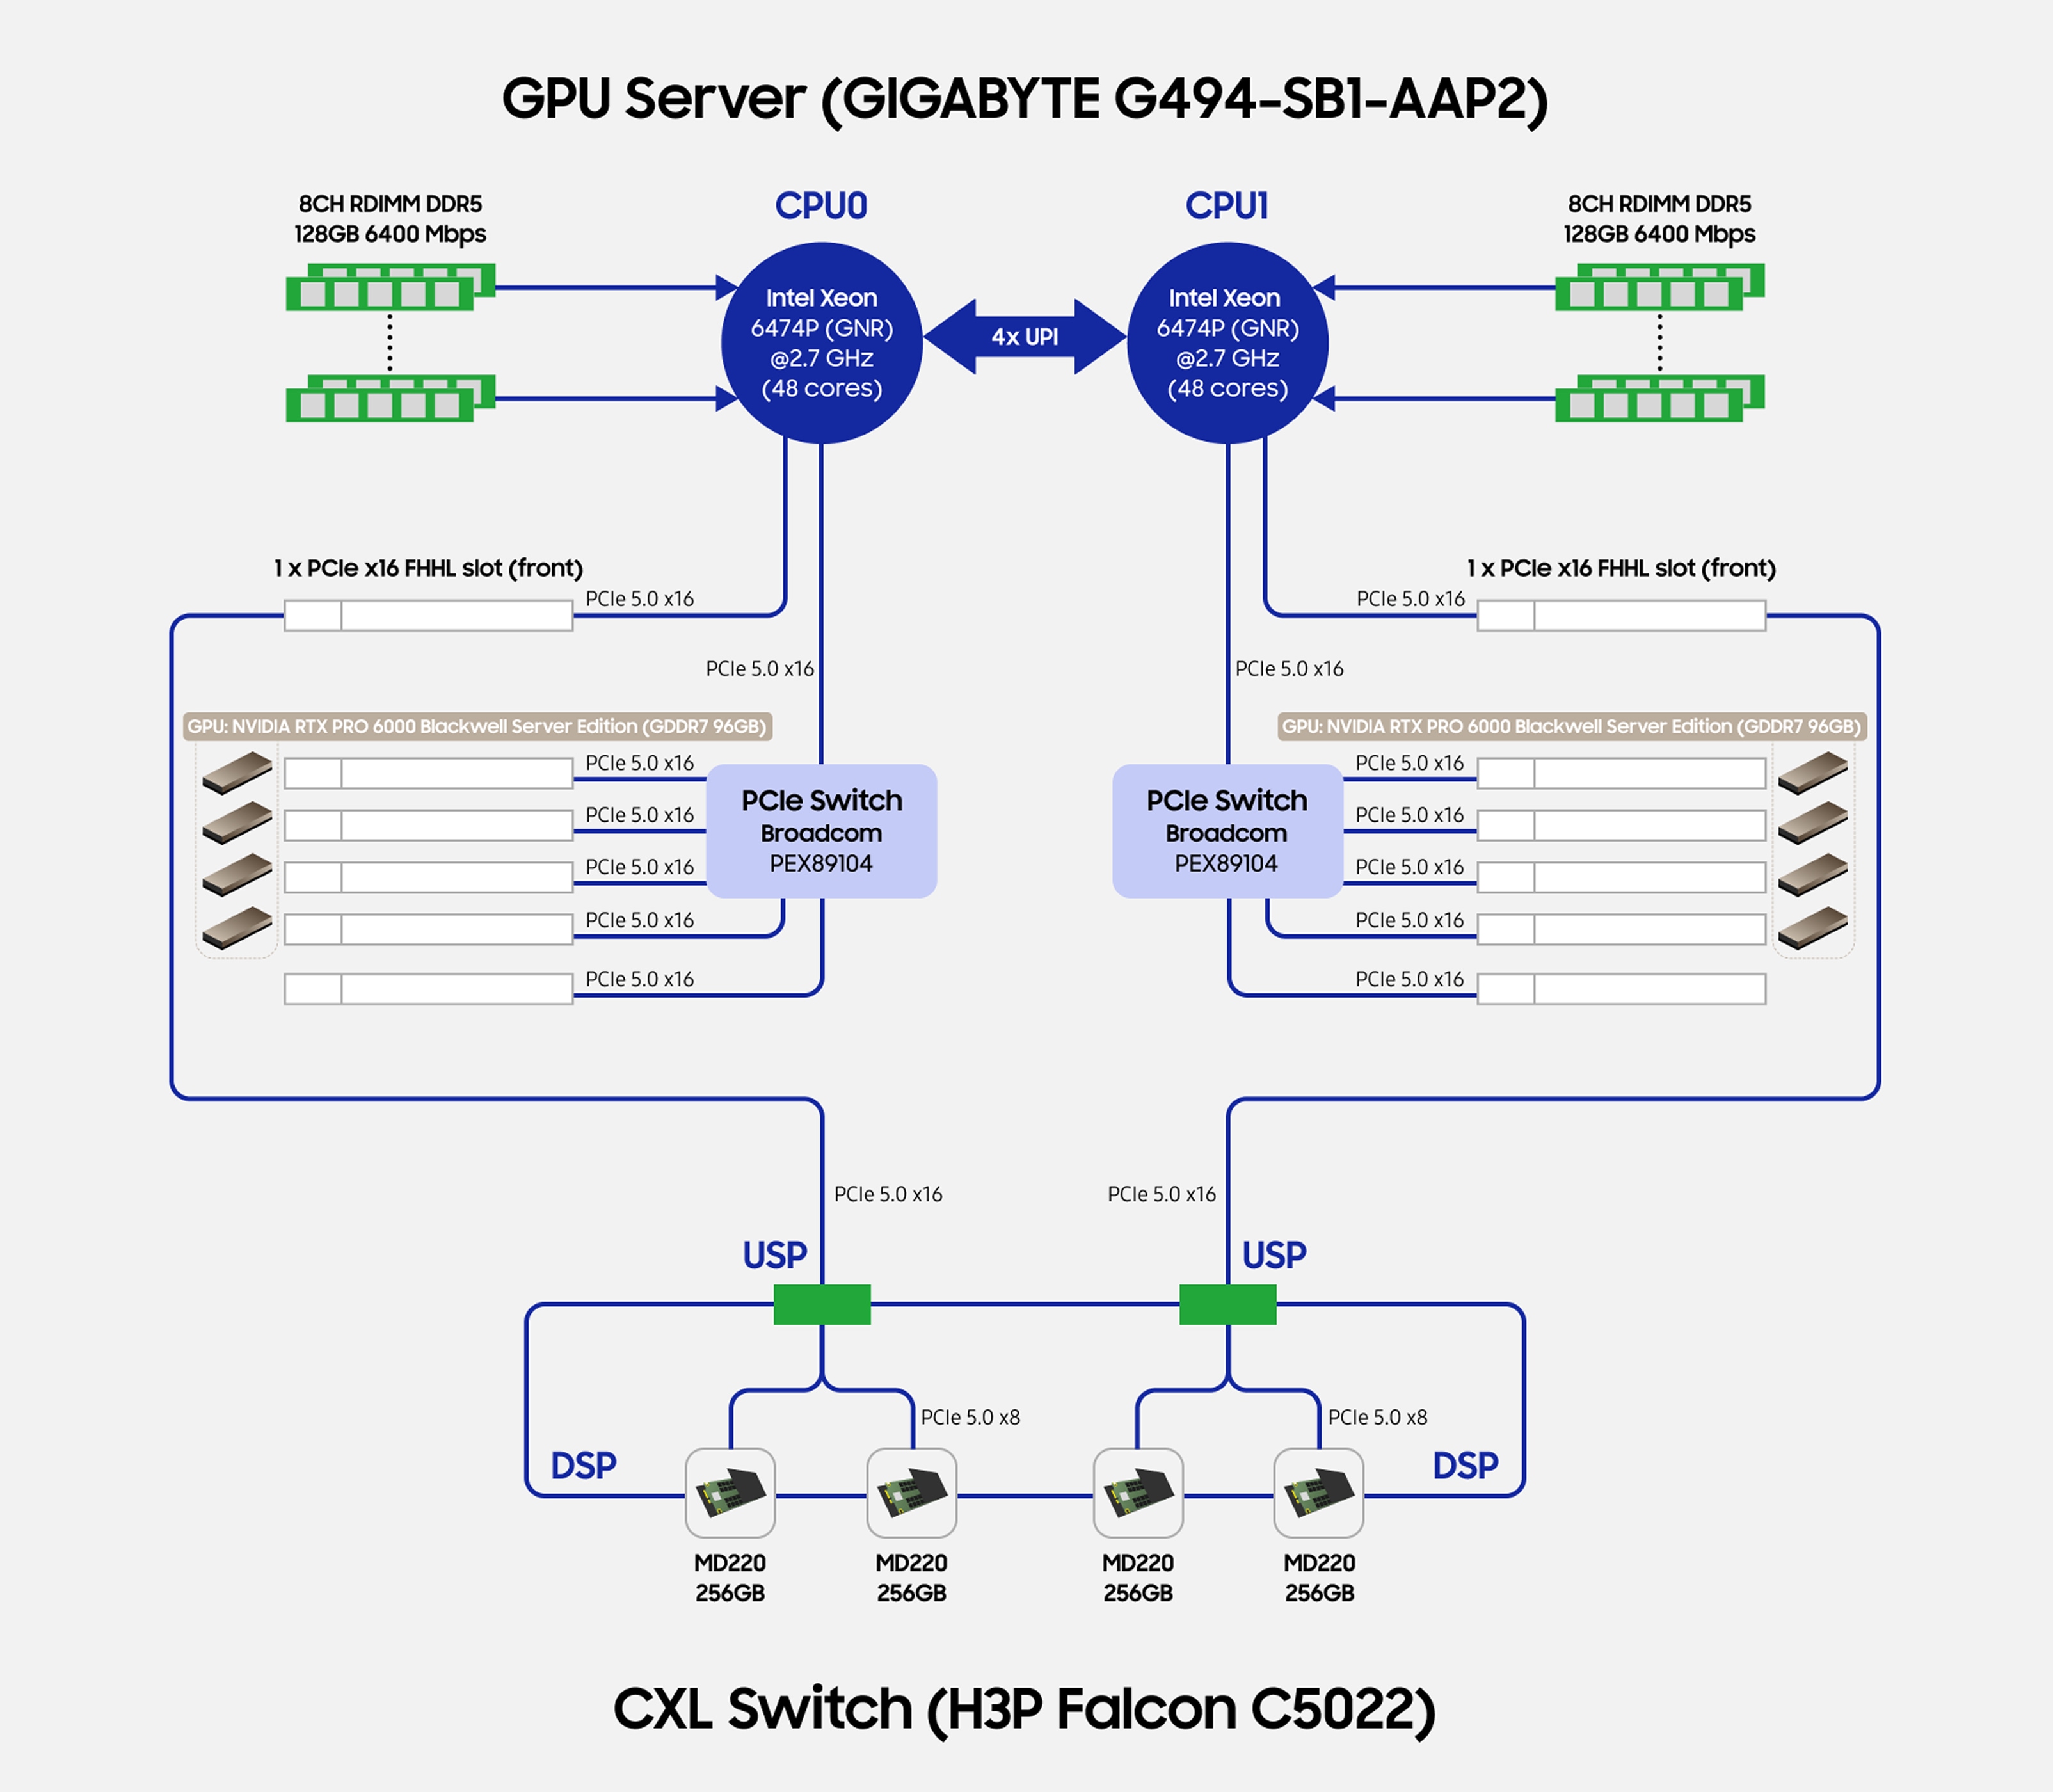
服务器产品的机会在于统筹 PCIe/CXL 通道、DRAM 容量、扩展槽和供电散热,避免 GPU、NIC 与存储互相挤占 I/O。存储产品的机会则延伸到低 CPU 开销、写放大控制、QoS、缓存生命周期和恢复。云服务应把这些能力映射到可计费的容量和服务等级,而不只是新增一种“更大内存”实例。
09 管理与安全向机架和集群延伸
当故障的影响越过单机,管理软件就需要知道完整的依赖关系。一个托盘掉线,可能来自自身固件、供电、液路、网络或上游设施;如果各系统只有各自告警,恢复过程仍要依赖人工拼接。开放管理接口的实际价值,是让这些状态可以被一致读取、关联和处理,而不是仅仅让仪表盘显示更多传感器。
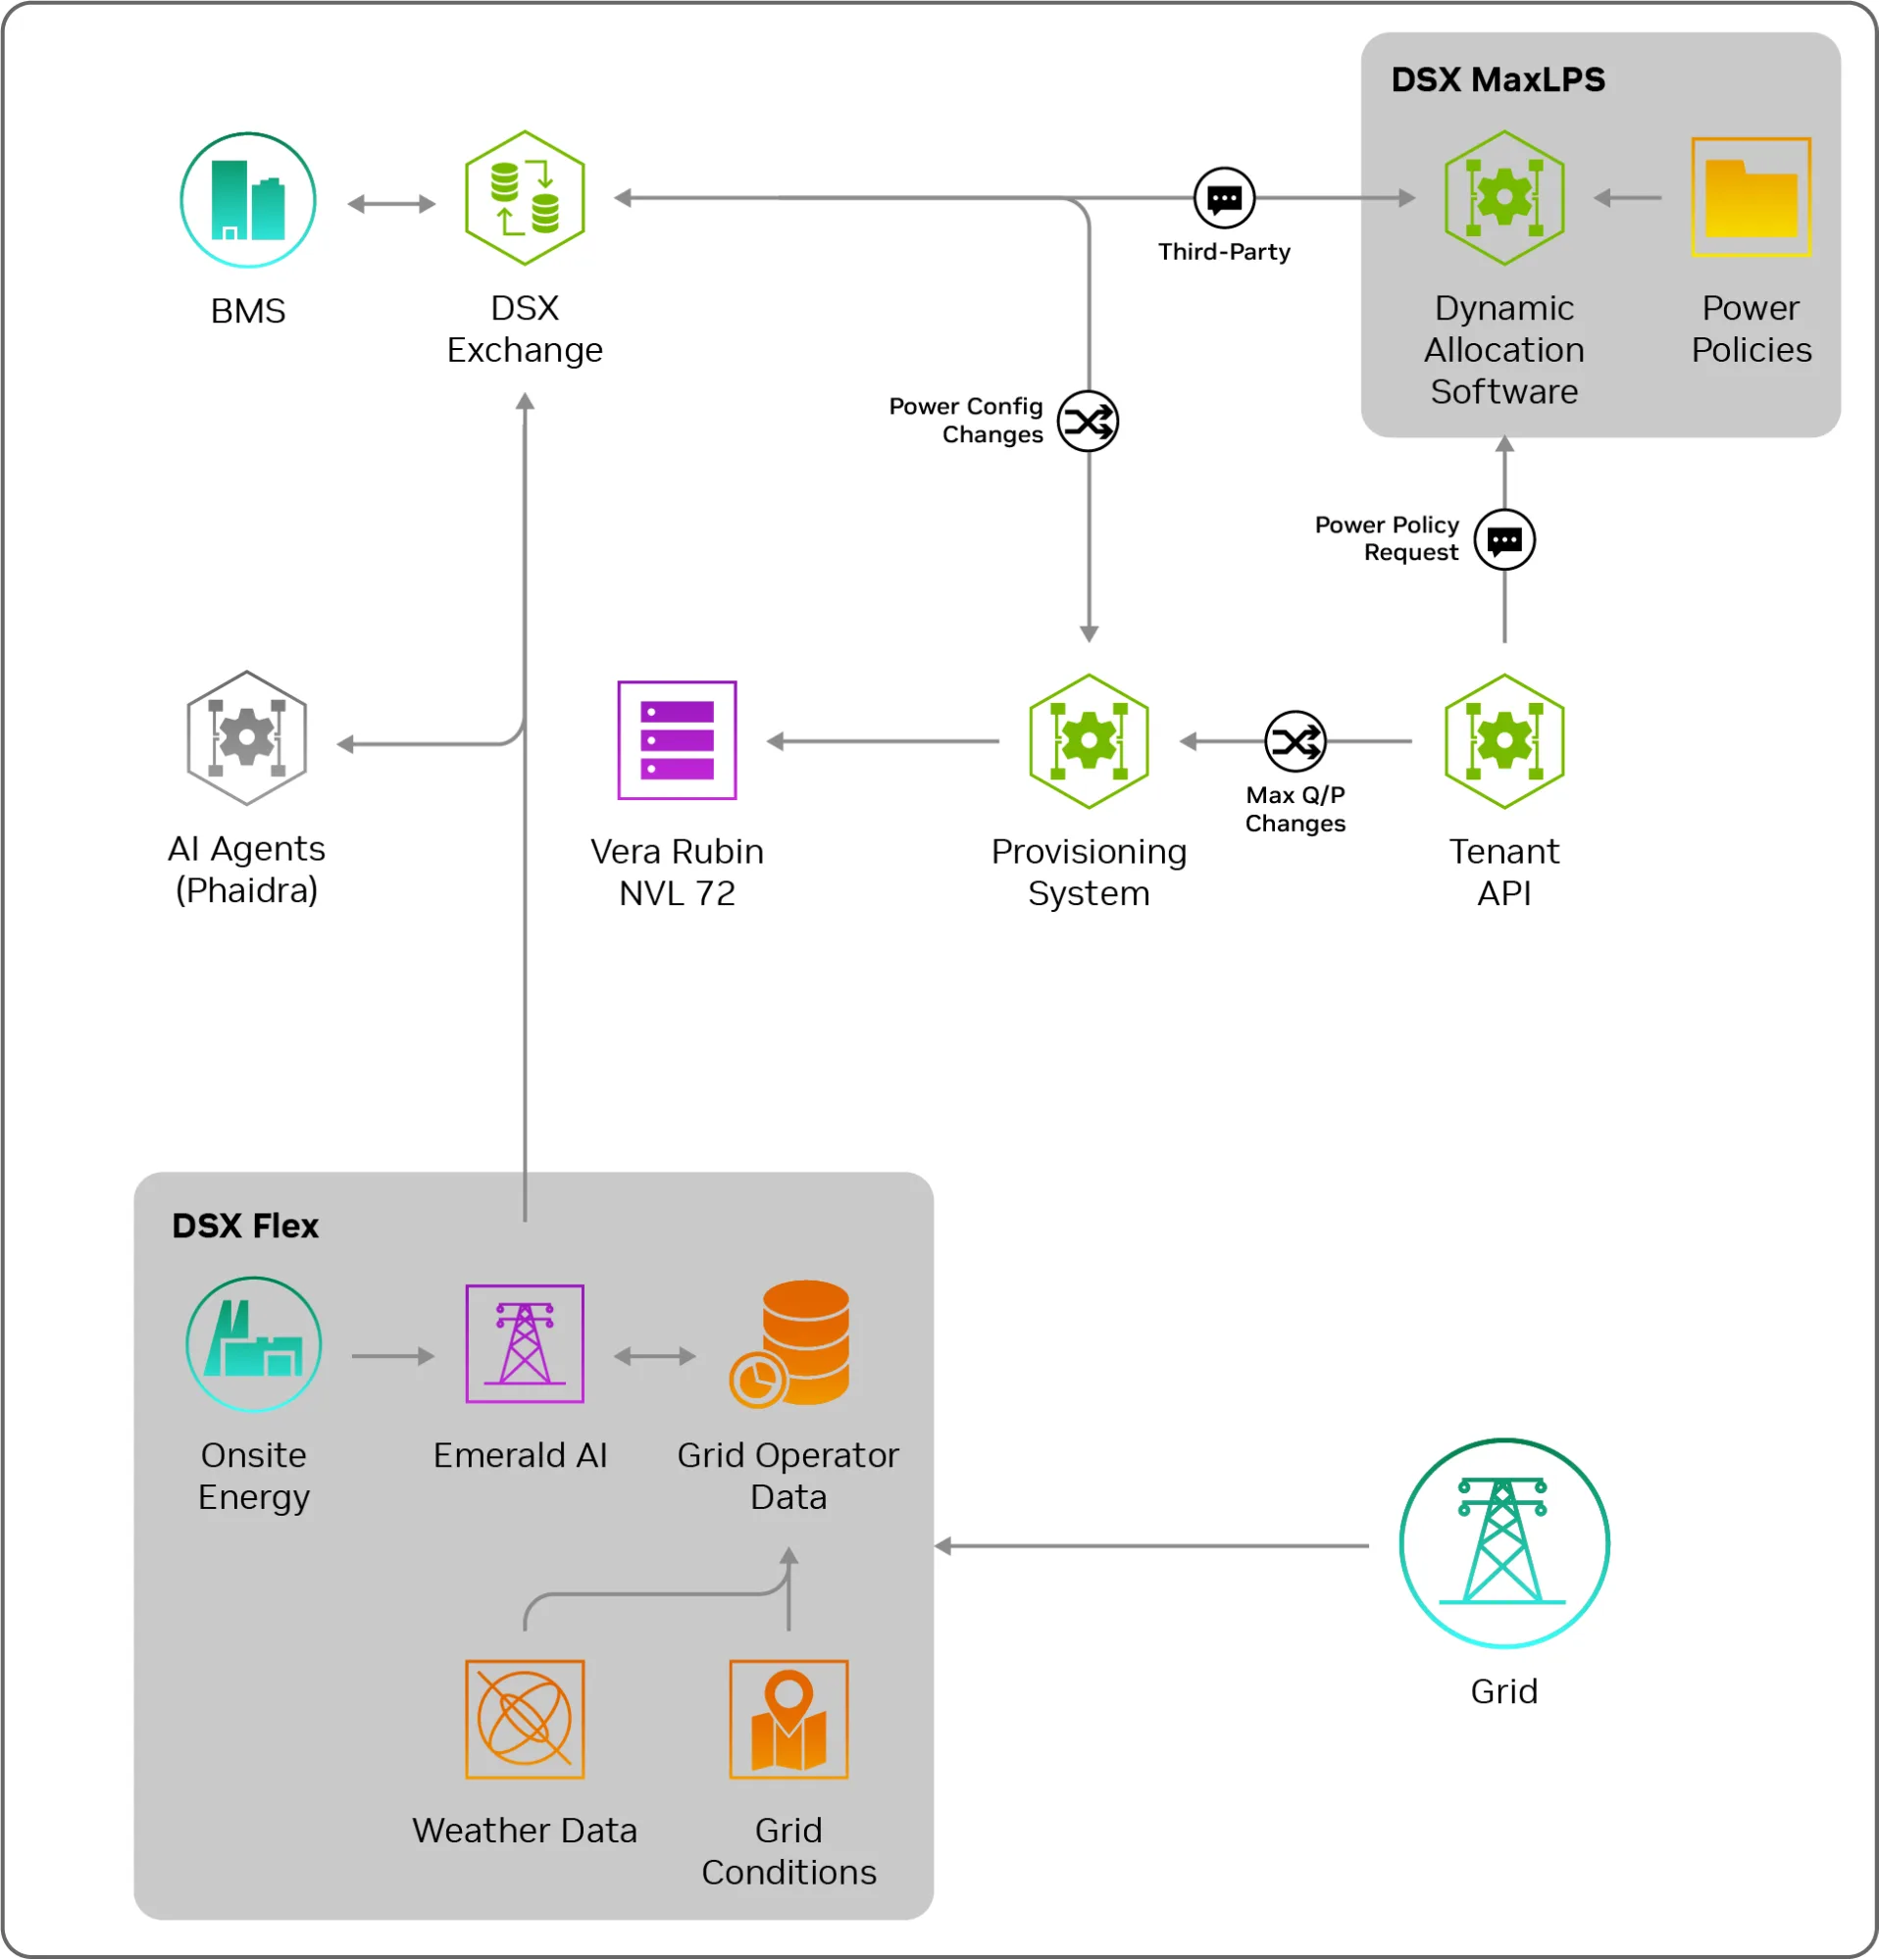
NVIDIA 开放的 Rack Management Service 将机架电力、资产、固件和交换配置纳入服务接口,但参考对象仍是其基础设施,不能默认成为所有厂商的通用实现。其 Cluster Readiness Engine 通过通信和训练测试帮助识别问题节点,并不负责自动隔离节点。网络配置组件还明确标注 Developer Preview,不建议用于生产。组件开放与完整自动修复之间,仍有平台团队需要承担的工作。[33][34][35]
实际落地应先建立稳定的资产身份和版本关系,再把健康检查与调度系统连接。自动隔离策略需要避免误杀可用容量;重新接纳节点应验证网络、热状态与软件版本,而不是仅看它已经重新上电。升级过程中,混合版本能否运行、回滚是否保留密钥和配置、故障是否会扩散到整架,都是管理产品必须回答的问题。
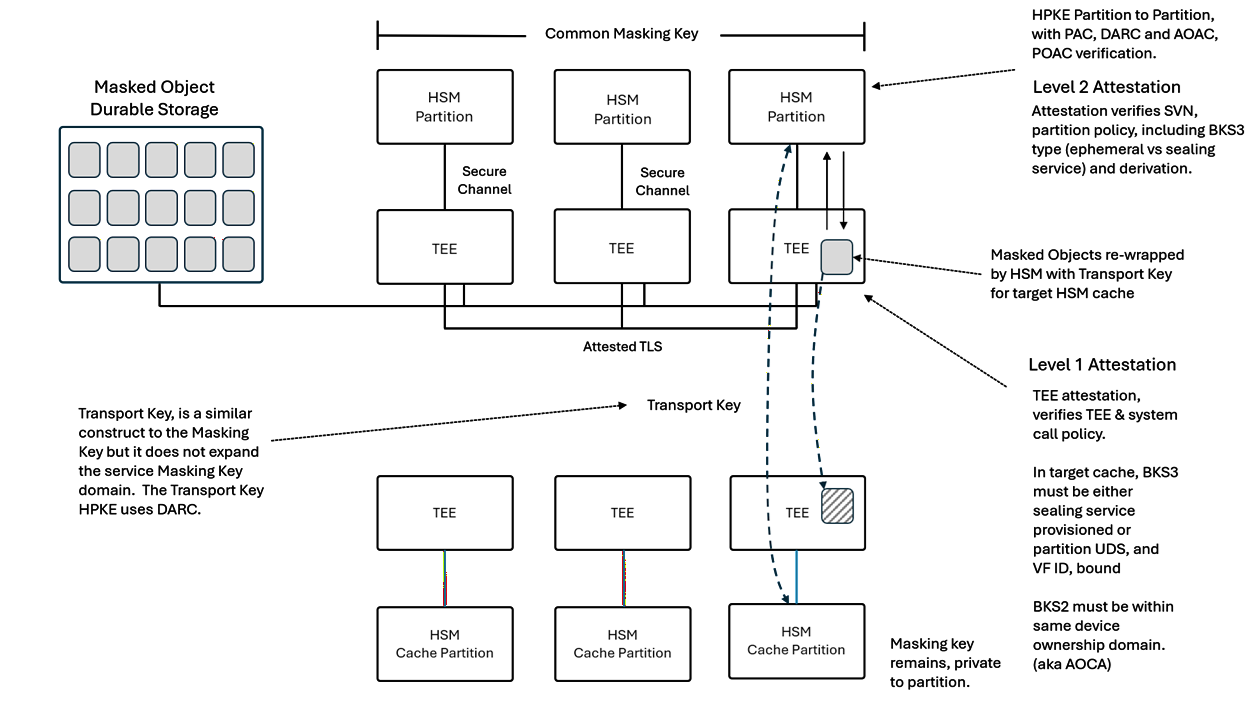
安全的边界也在扩展。本届正式启动的 SCMP 工作组,目标是把可信启动、证明、控制、恢复与所有权生命周期扩展到机架或 pod,并复用既有基础。它目前是工作组与架构目标,不能当作统一接口已经落地。[36] 安全控制面只有覆盖更新、维修和转售后的状态,才能保护硬件生命周期,而不仅是第一次开机。
Tessera Integrated HSM 则是本届新的开放安全项目,涉及架构、协议、软件和固件等内容;完全开放的硅实现属于后续推进方向,相关认证目标也不等于整个项目已经通过认证。[37] 这类项目可能降低硬件密钥服务的接入成本,但客户仍需区分实现方式、隔离边界和物理防护等级,不能只看共同接口名称。
对云服务而言,安全与可用性需要一起设计。密钥不可用可能让计算资源无法接单,证明服务故障可能阻止节点加入,更新错误可能造成整批容量退出。验收应覆盖签名升级、回滚、所有权转移、密钥撤销和恢复,并观察对业务吞吐的影响。开放源码有助于审计和适配,却不能替代明确的漏洞响应、维护期限和供应商责任。
10 芯粒与边缘让开放生态形成不同层次
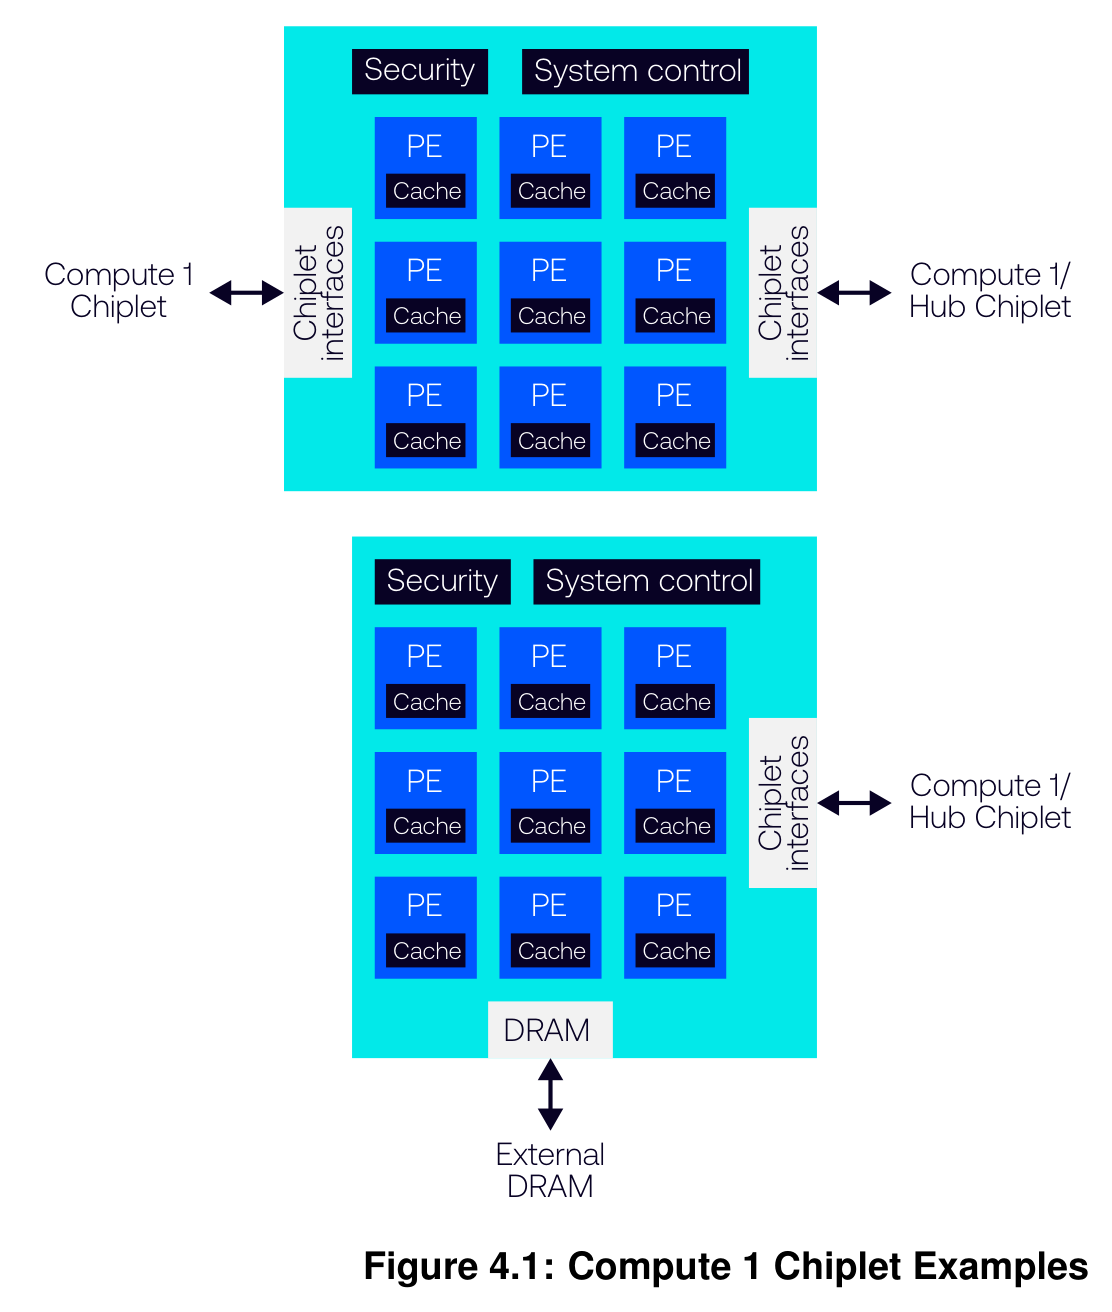
芯粒、固件和边缘计算是理解 OCP 全景的重要补充。FCSA 的基础架构规范与 BoW Flexi 等工作,试图为模块化硅和互联提供共同基础;这些文件有各自的范围和时间,不能都称为本届新标准,也不能把适用于较低性能场景的接口直接当作高端加速器互联替代方案。[38][39]
从工程上看,芯粒标准化可以改善不同团队协作的起点,但完整系统还要解决封装、电源完整性、热耦合、测试与良率。电气接口能够连接,不代表软件枚举、错误处理和供应责任已经一致。对服务器企业,短期更实际的机会是把系统需求提早反馈到芯片与封装设计,减少在整机验证阶段才暴露的问题;进入芯粒供应链则需要更长周期和不同能力。
边缘场景又会改变优化目标。OCP AI Computing Continuum 项目面向区域机房、企业、电信和工业等环境,强调在功率、热和空间约束下建立模块化基础设施。这是项目范围与发展方向,不能解释为各类边缘产品已经使用同一套成熟标准。[40]
企业 agent 平台可能更看重现有机房可部署性、远程运维和数据边界,区域云可能更关心稳定的电力与可扩容单元,工业现场则还要面对环境条件和现场维护能力。将 MW 级机架简单缩小,并不能自动满足这些需求。开放生态的扩散更可能表现为可组合的接口和管理方法,而不是只有一种物理形态。
这也解释了不同参与者的策略。超大规模云厂商通过共同规范分摊基础设施开发成本,同时保留工作负载、芯片和软件的差异化;芯片厂商开放选定接口,扩大合作伙伴可制造和可集成的范围;ODM 与系统厂商的竞争力则越来越依赖验证、交付和服务。开放不会自然消除利润空间,它会把价值从孤立部件规格转移到能够明确承担系统结果的环节。
产品团队应该做有选择的加法与减法。对热插拔、故障诊断、跨厂商验收和供应替代能力做加法;对缺乏真实工作负载支持的配置组合做减法。多供应商只有在第二来源完成相同验收、固件维护和备件准备后,才成为可用选择。只保留一张可兼容清单,无法降低实际切换风险。
附录 重点公开信号与成熟度
截至信息截止时点。下表区分文档、演示、发布和未来可用计划;“最高”均保留原来源的条件,不代表可同时实现全部上限。
| 对象 | 选定公开指标 | 状态 | 使用边界 |
|---|---|---|---|
| MGX 1.2 | 最高 250kW | 本届部分设计贡献 | 架构支持值,不是所有部署的实用功率 [3] |
| Maia 300 | 96 加速器及 167kW | 计划 2027 年生产部署 | 效率为预期;整架吞吐不可当作单芯片指标 [8] |
| AMD Helion | CPU-only 最高 32,768 核 | 开发中,计划 2026 年 11 月可用 | OCP 贡献仍属计划,配置上限不能叠加 [5] |
| Intel GPU D-series | ODM 最高 480GB LPDDR5X | 客户采样中 | Intel 自有品牌卡 160GB,不代表 HBM 等价吞吐 [7] |
| ESUN 1.0 | 运营方网络需求规范 | 会前已发布,1.1 推进中 | 需求规范不等于完整协议与量产互操作 [12] |
| USFP | 400Gb/s 每电通道;首批计划 16 条全双工通道 | 本届宣布形态与计划 | 开放规范及多来源项目尚待推进 [14] |
| Celestica DS6005 | 102.4Tb/s CPO 交换机 | 本届系统发布 | 未据此确认广泛量产或多年运行记录 [15] |
| Lightmatter CPO | 204.8Tb/s 交换平台 | 生产验证平台 | 四 XPU 托盘为概念验证,状态不同 [16] |
| Diablo 400 | ±400V 或 800V | v0.7 文档已公开 | 部分连接器项目仍有待定内容 [19] |
| Delta Deschutes | 2MW 于 3°C approach | 展出,计划 2027 年一季度量产 | 采用该发布稿口径;须统一工作点比较 [25] |
| UQD v2.0 | 手动与盲插要求整合 | 2026 年 9 月 22 日生效 | 跨厂商混配仍需部署验证 [23] |
| 三星 DCD CXL 池 | TTFT 最高降 38%,goodput 最高 3.3 倍 | 厂商特定负载演示 | 相对静态分配,不能推广为通用收益 [29] |
| HBF v0.7 | 读取优化 NAND 近端层 | 2026 年 8 月 3 日规范 | 早于本届;规范不构成实测或量产证据 [32] |
| SCMP | 机架与 pod 安全控制 | 本届正式启动工作组 | 仍是架构目标,非已落地统一标准 [36] |
| Tessera HSM | 开放架构与软固件等 | 本届新项目 | 完全开放硅和认证目标不等于已完成 [37] |
配图来源与使用说明
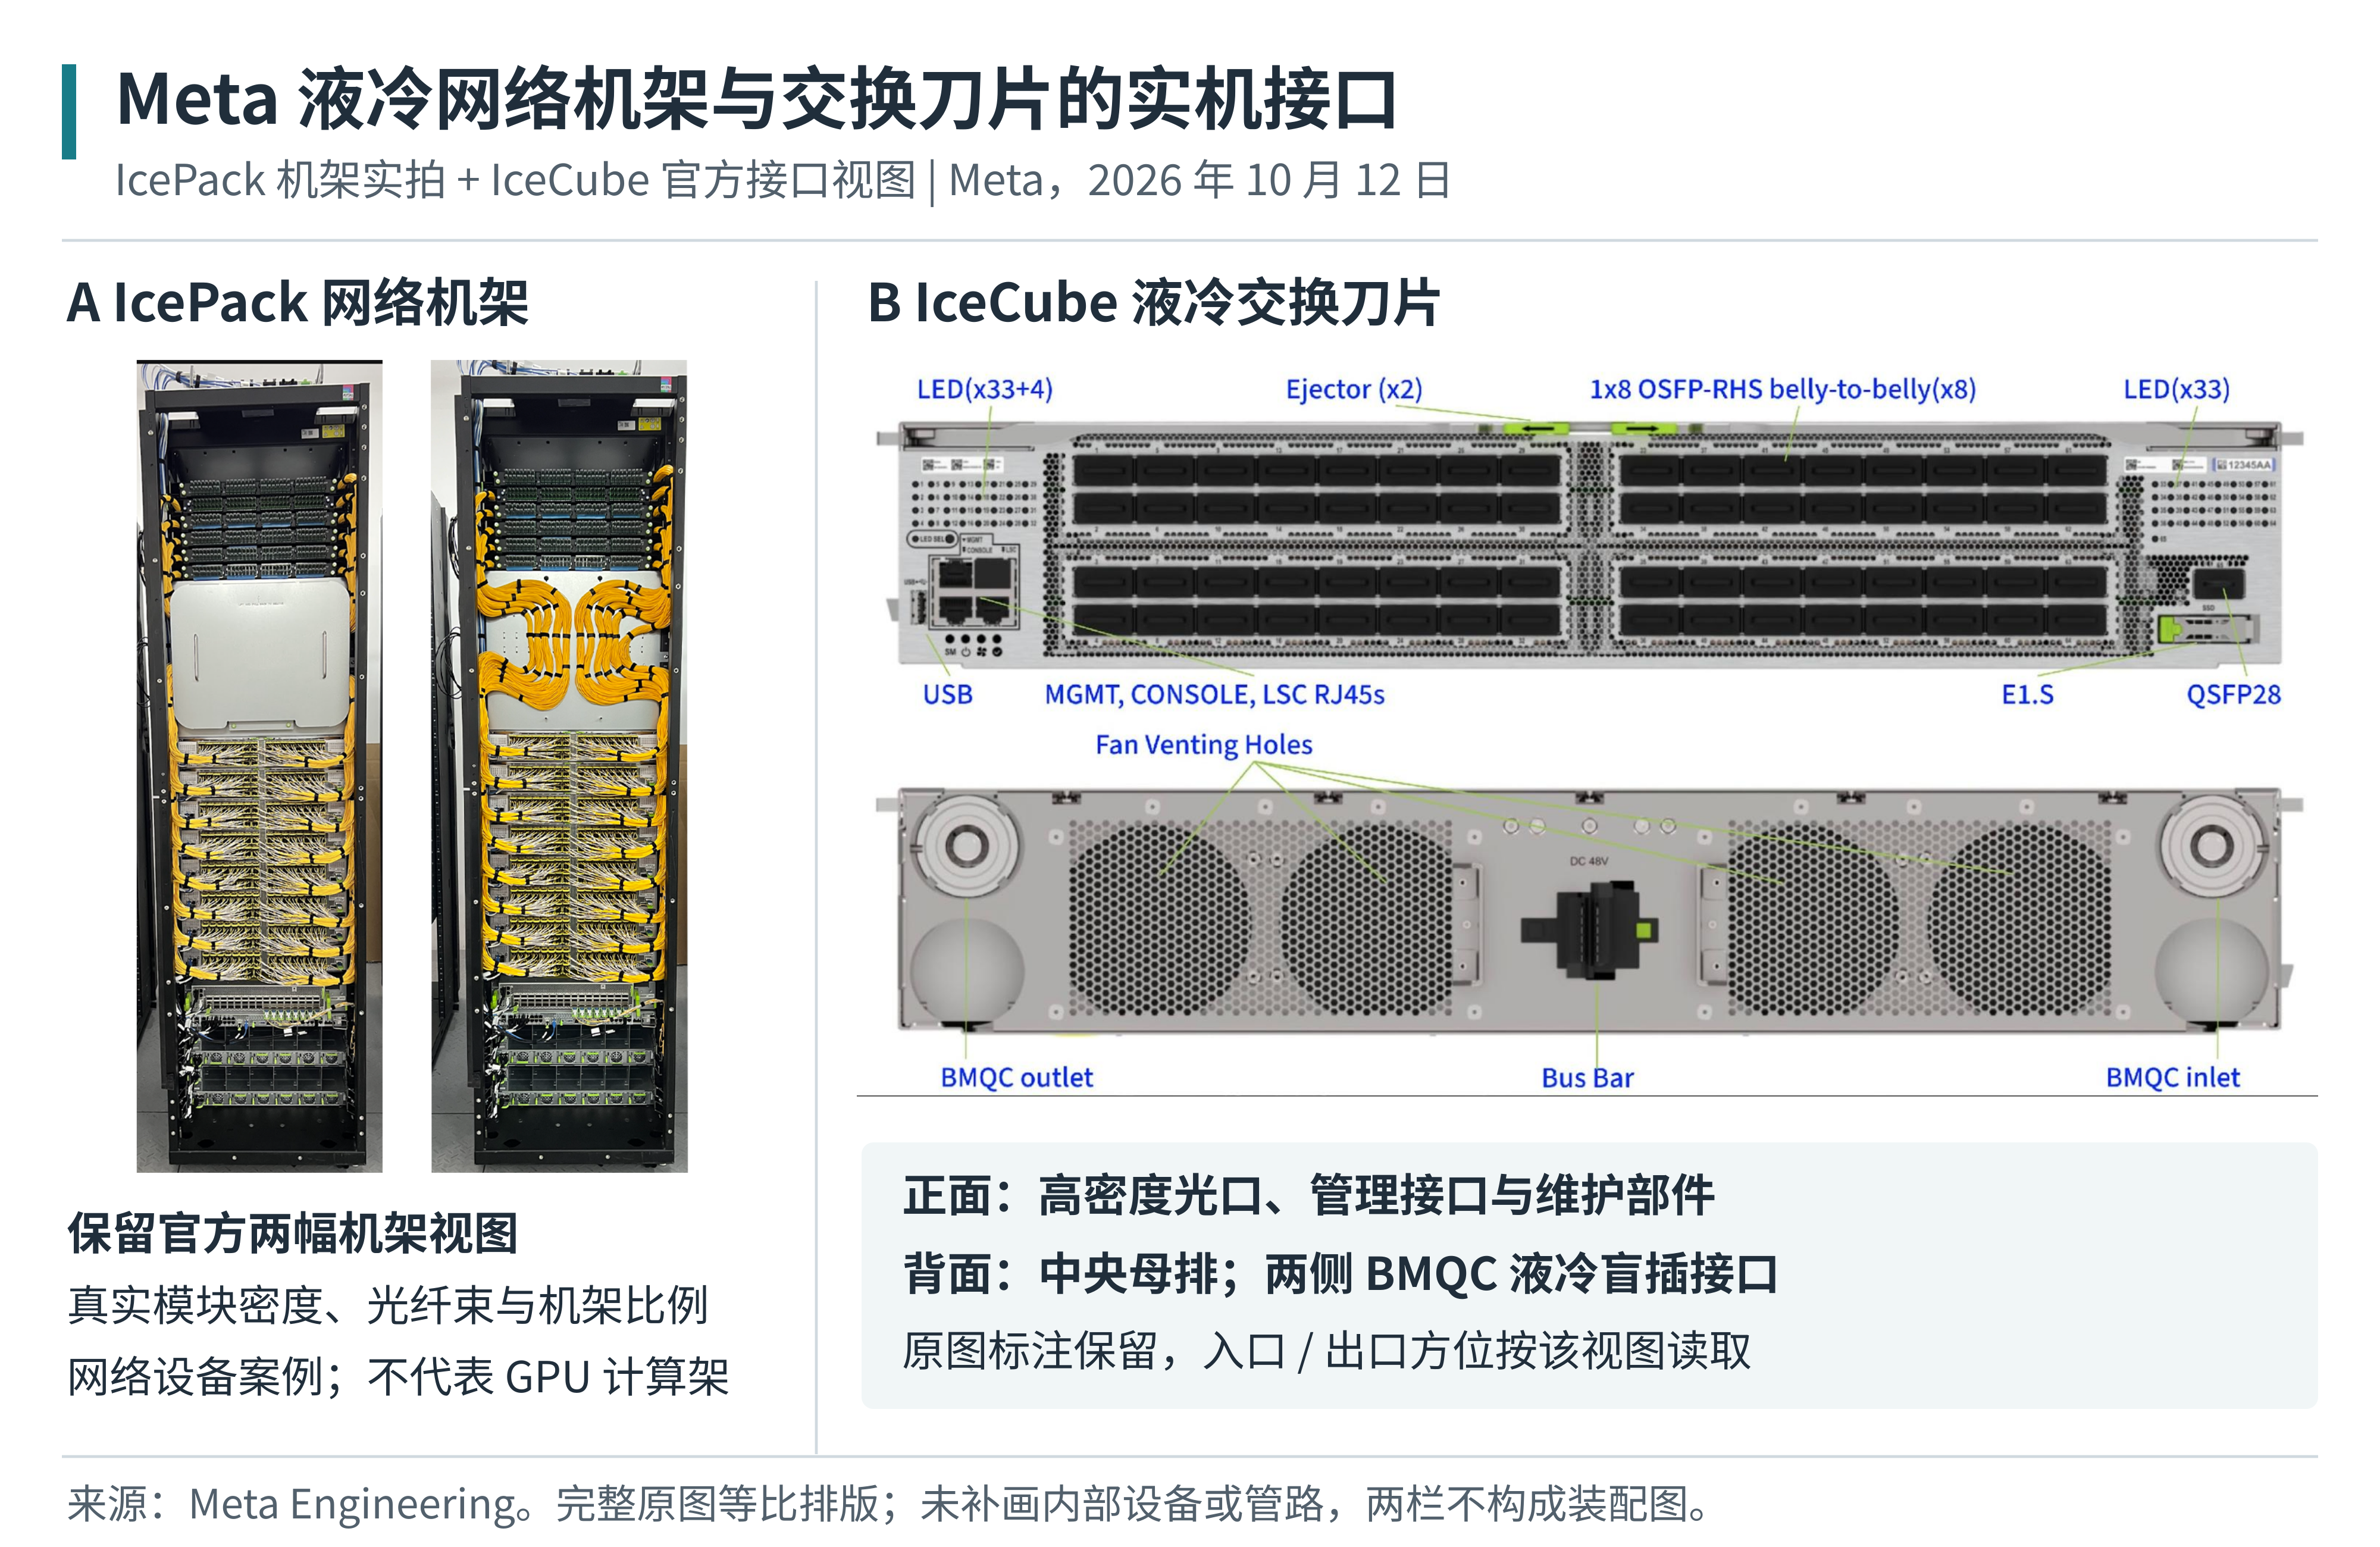
官方图保留原有标签、结构与必要图例;PDF 图仅裁去页面周边正文,未改绘内容。中文图注用于解释工程关系,图中的上限、工作点与特定案例数值不自动适用于其他产品。设备外观与评估连接图分别说明,不将逻辑关系补画成未公开的实物结构。
图 11 与图 15:Rolf Brink、Mohan J. Kumar、Steve Mills、Kelley Mullick,Thermal Boundaries in AI Infrastructure,OCP,2026,v1.00。分别取自第 29 页图 6、第 19 页图 4,原图裁切,内容未改。许可为 CC BY-SA 4.0。
其他官方图来自相关厂商、标准组织的技术文章、产品页、规范或官方规格仓库,出处、图像性质与版本见各图图注及参考资料。原图的权利和许可按各自来源保留;上述 CC 许可不用于推断其他厂商图或整份报告的许可。
图 1 按 Meta 官方机架实拍与接口原图编排;图 16 展示评估资料涉及型号的官方产品外观,图 19 保留三星原始连接图。图片均按原始比例呈现,中文解释置于图外;产品照片不等于测试现场照片,未补画不可见内部结构。
参考资料
以下为正文、配图与附录所用的一手资料。正文判断仍截至封面所列时点;增补配图采用此前已经公开的资料,未把背景图视作本届新增发布。规范日期采用已核验的版本或生效信息。点击网址可打开原文。
[1] OCP 2026 Global Summit 官方会议信息 — OCP Foundation,2026 会议信息
https://www.opencompute.org/events/ocp-summit/2026-ocp-global-summit/
[2] Realizing the OCP Open Data Center Ecosystem Vision — OCP Foundation,2026 官方综述
https://www.opencompute.org/news/realizing-the-ocp-open-data-center-ecosystem-vision/
[3] Vera Rubin MGX 与 DSX 开放贡献 — NVIDIA,2026 年 10 月 12 日
https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
[4] OCP 2026 Lisa Su Keynote Takeaways — AMD,2026 年 10 月 12 日
https://newsroom.amd.com/news/ocp-2026-amd-ceo-lisa-su-keynote-takeaways/
[5] Introducing AMD Helion Agentic AI Compute at Rack Scale — AMD,2026 年 10 月 12 日
https://ir.amd.com/news-events/press-releases/detail/1301/introducing-amd-helion-agentic-ai-compute-at-rack-scale
[6] Arm AGI CPU Agentic Benchmarks — Arm,2026 年 10 月 13 日
https://newsroom.arm.com/news/arm-agi-cpu-agentic-benchmarks
[7] Open Infrastructure for the Agentic AI Era — Intel,2026 OCP 官方材料
https://www.intel.com/content/www/us/en/newsroom/news/artificial-intelligence/intel-accelerates-open-infrastructure-agentic-ai-era.html
[8] Azure Maia 多吉瓦部署与 Maia 300 公告 — Microsoft,2026 年 10 月 12 日
https://blogs.microsoft.com/blog/2026/10/12/microsoft-to-expand-azure-maia-system-to-multi-gigawatt-deployments/
[9] Deep Dive into Azure Maia 300 Architecture — Microsoft Azure,2026 年 10 月 12 日
https://azure.microsoft.com/en-us/blog/deep-dive-into-azure-maia-300-architecture/
[10] MRC Supercomputer Networking — OpenAI,2026 年 5 月 5 日
https://openai.com/index/mrc-supercomputer-networking/
[11] OCP Summit 2026 Scale Up Scale Out and Scale Across Networks — Meta Engineering,2026 年 10 月 12 日
https://engineering.fb.com/2026/10/12/open-source/ocp-summit-2026-powering-ai-with-open-innovations-in-scale-up-scale-out-and-scale-across-networks/
[12] ESUN 1.0 规范发布说明 — OCP Foundation,2026 年 3 月 10 日
https://www.opencompute.org/index.php/blog/the-ocp-esun-10-specification-has-been-released
[13] UALink 2.0 Specification Release — UALink Consortium,2026 年 4 月 7 日
https://ualinkconsortium.org/wp-content/uploads/2026/04/UALink-2.0-Specification-PR_FINAL.pdf
[14] NVIDIA and Cisco Introduce USFP — NVIDIA 与 Cisco,2026 年 10 月 12 日
https://nvidianews.nvidia.com/news/nvidia-and-cisco-introduce-new-pluggable-optics-form-factor-to-scale-ai-factories
[15] DS6005 CPO Data Center Switch — Celestica,2026 年 10 月 12 日
https://celestica.gcs-web.com/news-releases/news-release-details/celestica-introduces-ds6005-data-center-switch-co-packaged
[16] Open Rack CPO Switch and XPU Scale Up Server — Lightmatter 官方发布稿,2026 年 10 月 12 日
https://www.prnewswire.com/news-releases/lightmatter-delivers-open-rack-cpo-switch-and-xpu-scale-up-server-through-independent-collaborations-with-flex-and-other-industry-partners-302906361.html
[17] Integrated Optical Compute System Live Demonstration — Wiwynn 与 Ayar Labs 及 GUC,2026 年 10 月 13 日
https://www.wiwynn.com/news/wiwynn-ayar-labs-and-guc-advance-co-packaged-optics-with-live-demonstration-of-integrated-optical-compute-system-at-ocp-global-summit-2026
[18] Optical Circuit Switching 子项目 — OCP Foundation,项目说明
https://www.opencompute.org/projects/networking/optical-circuit-switching/
[19] Diablo 400 v0.7.0 规范 — OCP Microsoft Google Meta,2026 年 3 月 1 日
https://www.opencompute.org/documents/ocp-specification-diablo-400-v0-7-0-final-pdf
[20] 800 VDC Power Architecture for AI Factories — NVIDIA,2026 年 8 月 11 日
https://blogs.nvidia.com/blog/800-vdc-power-architecture-ai-factory/
[21] Open Data Center v0.7.0 — OCP AMD Google Meta NVIDIA,2026 年 8 月 27 日生效
https://www.opencompute.org/documents/open-data-center-spec-revision-0-7-0-4-pdf
[22] Utility Grid Disturbance Performance Interface v1.0.0 — OCP Google Meta Microsoft NVIDIA,2026 年 9 月 17 日生效
https://www.opencompute.org/documents/ocp-base-spec-interface-specification-between-hyperscalers-and-utility-grid-for-disturbance-performance-pdf
[23] Universal Quick Disconnect v2.0.0 — OCP Foundation,2026 年 9 月 22 日生效
https://www.opencompute.org/wp-content/uploads/2026/10/OCP-Design-Spec_UQD_v2.0.0.pdf
[24] Single Phase Cold Plate Test Specification v1.0.0 — OCP Foundation,2026 年 9 月 3 日生效
https://www.opencompute.org/wp-content/uploads/2026/10/OCP-Cold-Plate-Test-Specification-V1.0.0.pdf
[25] Grid to Chip Infrastructure at OCP Global Summit 2026 — Delta 官方发布稿,2026 年 10 月 8 日
https://www.prnewswire.com/news-releases/delta-to-showcase-energy-saving-grid-to-chip-infrastructure-solutions-for-sustainable-ai-at-ocp-global-summit-2026-302902203.html
[26] Rittal OCP 2026 RiMatrix HPC — Rittal,2026 年 10 月 12 日
https://www.rittal.com/us-en_US/News/Rittal-OCP-2026
[27] Brazos Liquid Cooling for Air Cooled Data Centers — Google Cloud,2026 年 6 月 16 日
https://cloud.google.com/blog/topics/systems/brazos-liquid-cooling-system-for-air-cooled-data-centers
[28] Thermal Boundaries in AI Infrastructure v1.00 — OCP Foundation,2026 年 10 月 12 日发布
https://www.opencompute.org/wp-content/uploads/2026/10/Thermal-Boundaries-in-AI-Infrastructure.pdf
[29] Samsung OCP 2026 展示与议程 — Samsung Semiconductor,2026 OCP 官方活动页
https://semiconductor.samsung.com/events/ocp-2026/
[30] BM1773 Ultra High Density Storage Solution — Samsung Semiconductor,产品技术说明
https://semiconductor.samsung.com/news-events/tech-blog/samsung-bm1773-ultra-high-density-storage-solution-for-ai-data-centers/
[31] LD4 系列评估样品发布 — Kioxia,2026 年 10 月 9 日
https://www.kioxia.com/ja-jp/business/news/2026/20261009-1.html
[32] HBF Architecture Specification v0.7.0 — OCP Sandisk SK hynix,2026 年 8 月 3 日
https://www.opencompute.org/documents/ocp-hbf-architecture-specification-v0-7-0-final-pdf/
[33] Rack Management Service README — DSX AI Factory,截至 2026 年 10 月 15 日读取
https://github.com/dsx-ai-factory/nv-rms
[34] Cluster Readiness Engine README — NVIDIA,截至 2026 年 10 月 15 日读取
https://github.com/NVIDIA/cluster-readiness-engine
[35] Network Configuration Manager README — DSX AI Factory,截至 2026 年 10 月 15 日读取
https://github.com/dsx-ai-factory/nv-config-manager
[36] SCMP OCP Workstream 正式启动公告 — Lattice 与工作组伙伴,2026 年 10 月 13 日
https://ir.latticesemi.com/news-releases/news-release-details/industry-leaders-formally-launch-scmp-ocp-workstream-open-secure
[37] Open Source Integrated HSM Technology — Microsoft Azure,2026 年 10 月 13 日
https://azure.microsoft.com/en-us/blog/advancing-hardware-security-with-open-source-integrated-hsm-technology/
[38] Foundation Chiplet System Architecture v1.0.0 — OCP Foundation,2026 年 2 月生效
https://www.opencompute.org/documents/fcsa-1-0-0-pdf/
[39] BoW Flexi v1.0.0 — OCP Foundation,2026 年 9 月 17 日生效
https://www.opencompute.org/wp-content/uploads/2026/10/bow-flexi_1p0_final.pdf
[40] AI Computing Continuum 项目 — OCP Foundation,项目说明
https://www.opencompute.org/projects/aicc/
[41] Scaling AI Factories with Co Packaged Optics for Better Power Efficiency — NVIDIA Developer,2025 年 8 月 18 日,图 2 技术背景
https://developer.nvidia.com/blog/scaling-ai-factories-with-co-packaged-optics-for-better-power-efficiency/
[42] G494 SB1 AAP2 GPU Server 官方产品页 — GIGABYTE,页面未标首发日期,2026 年 10 月 15 日读取
https://www.gigabyte.com/Enterprise/GPU-Server/G494-SB1-AAP2
[43] CMM D CXL Memory 官方产品页 — Samsung Semiconductor,页面未标首发日期,2026 年 10 月 15 日读取
https://semiconductor.samsung.com/cxl-memory/cmm-d/
[44] Breaking AI Memory Limits with CXL Memory Pooling — Samsung Semiconductor,页面显示 2026 年 7 月 9 日,图 2
https://semiconductor.samsung.com/news-events/tech-blog/breaking-ai-memory-limits-with-cxl-memory-pooling/
[45] Optimizing KV Cache Offloading to CMM D in a CXL Switch based Memory Pool — Samsung Semiconductor,2026 年 6 月,图 2 第 7 页,配置表第 10 至 11 页
https://download.semiconductor.samsung.com/resources/white-paper/Optimizing_KV_Cache_Offloading_to_CMM-D_in_a_CXL_Switch-based_Memory_Pool.pdf
[46] Tessera Deployment Models 图 16 — TesseraHSM 官方规格仓库,2026 年 10 月 9 日提交 bcdb7539
https://github.com/TesseraHSM/tessera-specs/blob/bcdb753953dbb0067a7764130e47b0d156adf6fb/Tessera – Deployment Models.md
[47] NVIDIA DSX OS Modular Software for Operating AI Factories — NVIDIA Developer,2026 年 5 月 31 日,图 2,会前背景
https://developer.nvidia.com/blog/nvidia-dsx-os-delivers-open-modular-software-for-operating-ai-factories-at-scale/
[48] Powering the Next Era of AI Transition to LVDC — OCP Foundation,2026 年 8 月 11 日,页面更新 9 月 24 日
https://www.opencompute.org/news/powering-the-next-era-of-ai-how-google-microsoft-and-nvidia-are-standardizing-and-accelerating-the-industry-transition-to-lvdc/
[49] Inside the NVIDIA Rubin Platform — NVIDIA Developer,2026 年 1 月 5 日,页面更新 8 月 21 日,图 11 与 18
https://developer.nvidia.com/blog/inside-the-nvidia-rubin-platform-six-new-chips-one-ai-supercomputer/
[50] Resilient AI Supercomputer Networking Using MRC and SRv6 — OpenAI 及合作作者,2026 年 5 月 5 日公开,第 2 页图 1
https://cdn.openai.com/pdf/resilient-ai-supercomputer-networking-using-mrc-and-srv6.pdf
[51] The Evolution of Googles Jupiter Data Center Network — Google Cloud,2022 年 8 月 23 日,历史背景
https://cloud.google.com/blog/topics/systems/the-evolution-of-googles-jupiter-data-center-network