
OCP2026|USFP与CPO并行推进
光互连选型取决于链路瓶颈与维护边界
2026年OCP大会上的光互连进展,正在形成三条面向不同瓶颈的路线。可插拔USFP希望在有限的交换机面板空间中继续增加连接能力;交换机CPO把光电转换移近交换芯片,缩短高速电路径;计算光学I/O则把光连接带到计算封装附近,服务加速器之间及计算系统内部的互连。对于建设Token工厂的企业,选择应从受限的链路开始,再看哪种产品边界适合自己的部署和维护体系。
10月12日,NVIDIA与Cisco宣布USFP形态与生态计划;同日,Lightmatter公布与Flex合作的交换托盘生产验证系统,以及另一项独立合作中的XPU托盘概念验证。10月13日,Wiwynn、Ayar Labs与GUC展示集成光计算系统,把光引擎运行、遥测和系统管理放到同一平台上验证。[1][2][3] 这些发布的成熟度不同,但共同使客户能够更具体地讨论如何采用光互连。各项容量、接口参数和验收字段集中列在文末技术说明中。
USFP延续模块维护方式
当交换机面板空间不能继续扩大时,靠增加模块数量提高连接能力会遇到机械密度限制;继续提高每通道速率,又会给连接器和主机电通道带来信号质量压力。USFP同时调整通道数量、速率和连接器实现,试图让可插拔模块继续扩展。[1][9]
这条路线的吸引力,在于模块仍是可以单独采购、管理和更换的部件。对于已经围绕面板模块建立库存与维修流程的运营团队,这保留了相对熟悉的服务边界。若密度提升使一台交换机能接入更多端点,系统设计者也可能减少仅为端口数量而增加的设备。不过,是否能进一步减少网络层级,仍取决于交换芯片容量、端口拆分、拓扑和超售比,不能由模块容量直接推导。
采用USFP时,首先要确认主机支持条件。其外形占用空间接近OSFP,并不意味着能插进现有OSFP端口工作;连接器、电气接口、主机供电和散热必须逐项匹配。对现有设备的升级计划,应以完整兼容性声明和验证结果为依据,而不是只看模块尺寸。
其次要把采购时点与规格进度分开。NVIDIA与Cisco提出通过未来的社区主导多源项目形成开放行业规范;截至本文资料日期,USFP仍是形态与生态计划,并非OCP已批准标准。[1] 计划也不能证明多家模块已经互换验证或批量供货。对看重既有维护方式的客户,当前适合先核对未来平台的接口与散热路线,待规格、供货和互操作证据明确后再决定导入。
交换机CPO转向整机验证
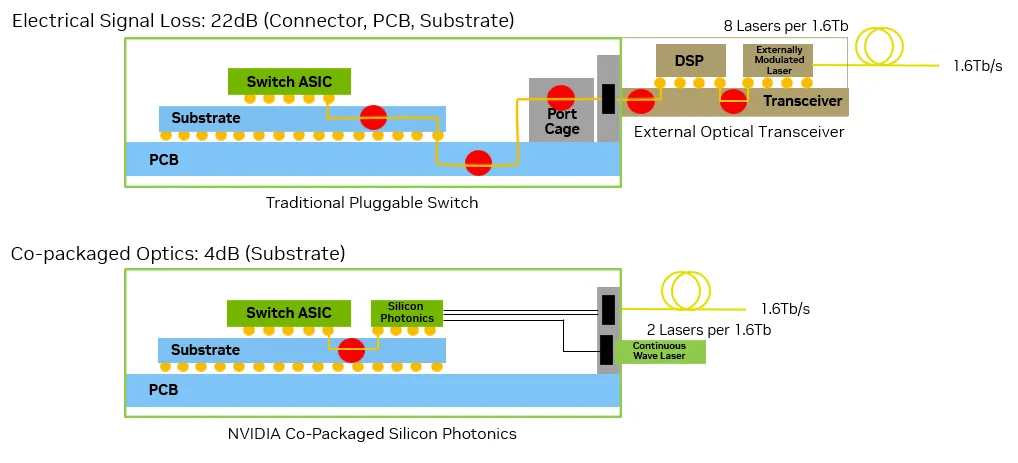
可插拔模块通常位于设备面板,交换芯片与模块之间需要经过板级电通道及连接器。CPO把光引擎放到交换芯片附近,让光纤承担较长距离传输。[4] 对高速电连接已经成为功耗、密度或信号质量约束的新平台,这提供了另一种设计方向,也意味着封装、制造和维修需要一起调整。
Lightmatter与Flex的交换托盘是本届大会上的一个具体例子。它把光引擎、外部光源和液冷集成到面向标准机架及模块化服务器体系的托盘中,定位为生产验证系统。[2] 这一阶段表明项目正在检验制造路径,但尚不能证明量产出货规模、客户部署数量或长期可靠性。
制造路径为何重要,可以从装配过程看得更清楚。一个光引擎在实验板上工作,与一套系统能按稳定流程装配,是不同的工程问题。光纤怎样接入封装、装配顺序如何安排、哪些接口可以拆开、液冷结构如何让出布纤空间,都会影响生产节拍、返工和交付。采用已有机架与服务器模块边界,有助于系统厂及早讨论机柜适配和供应链组织,避免在光芯片完成后重新设计外围结构。
供光部件的位置同样影响整机设计。Lightmatter的Guide DR可以放入托盘内部,并带有集成冷板。[6] “外部光源”中的外部,是相对于光引擎而言,不必位于机箱面板。内部供光可能释放面板空间,同时要求产品定义光源如何拆换、冷却怎样断开、供光路径怎样管理。对计划采用交换机CPO的客户,这些条件应和制造良率、返修流程一起进入试点验收。
计算光互连先验证加速器收益
计算光学I/O把光连接带到计算芯片附近,解决的是计算系统内部及加速器之间的传输问题。它与交换机CPO共享光电集成技术,但产品对象和验证任务不同。光学I/O本身也不决定链路使用以太网、某种Scale-Up协议,还是具有特定一致性语义的互连;协议、流控和软件共同决定端到端行为。
Lightmatter的XPU托盘来自与另一家ODM的独立合作,利用其模块化服务器基础设施,展示开放硅光架构如何进入计算托盘。[2] 该系统的定位是概念验证。它既不是Flex交换托盘的另一种配置,也不能与后者的生产验证进度合并为一个量产结论。
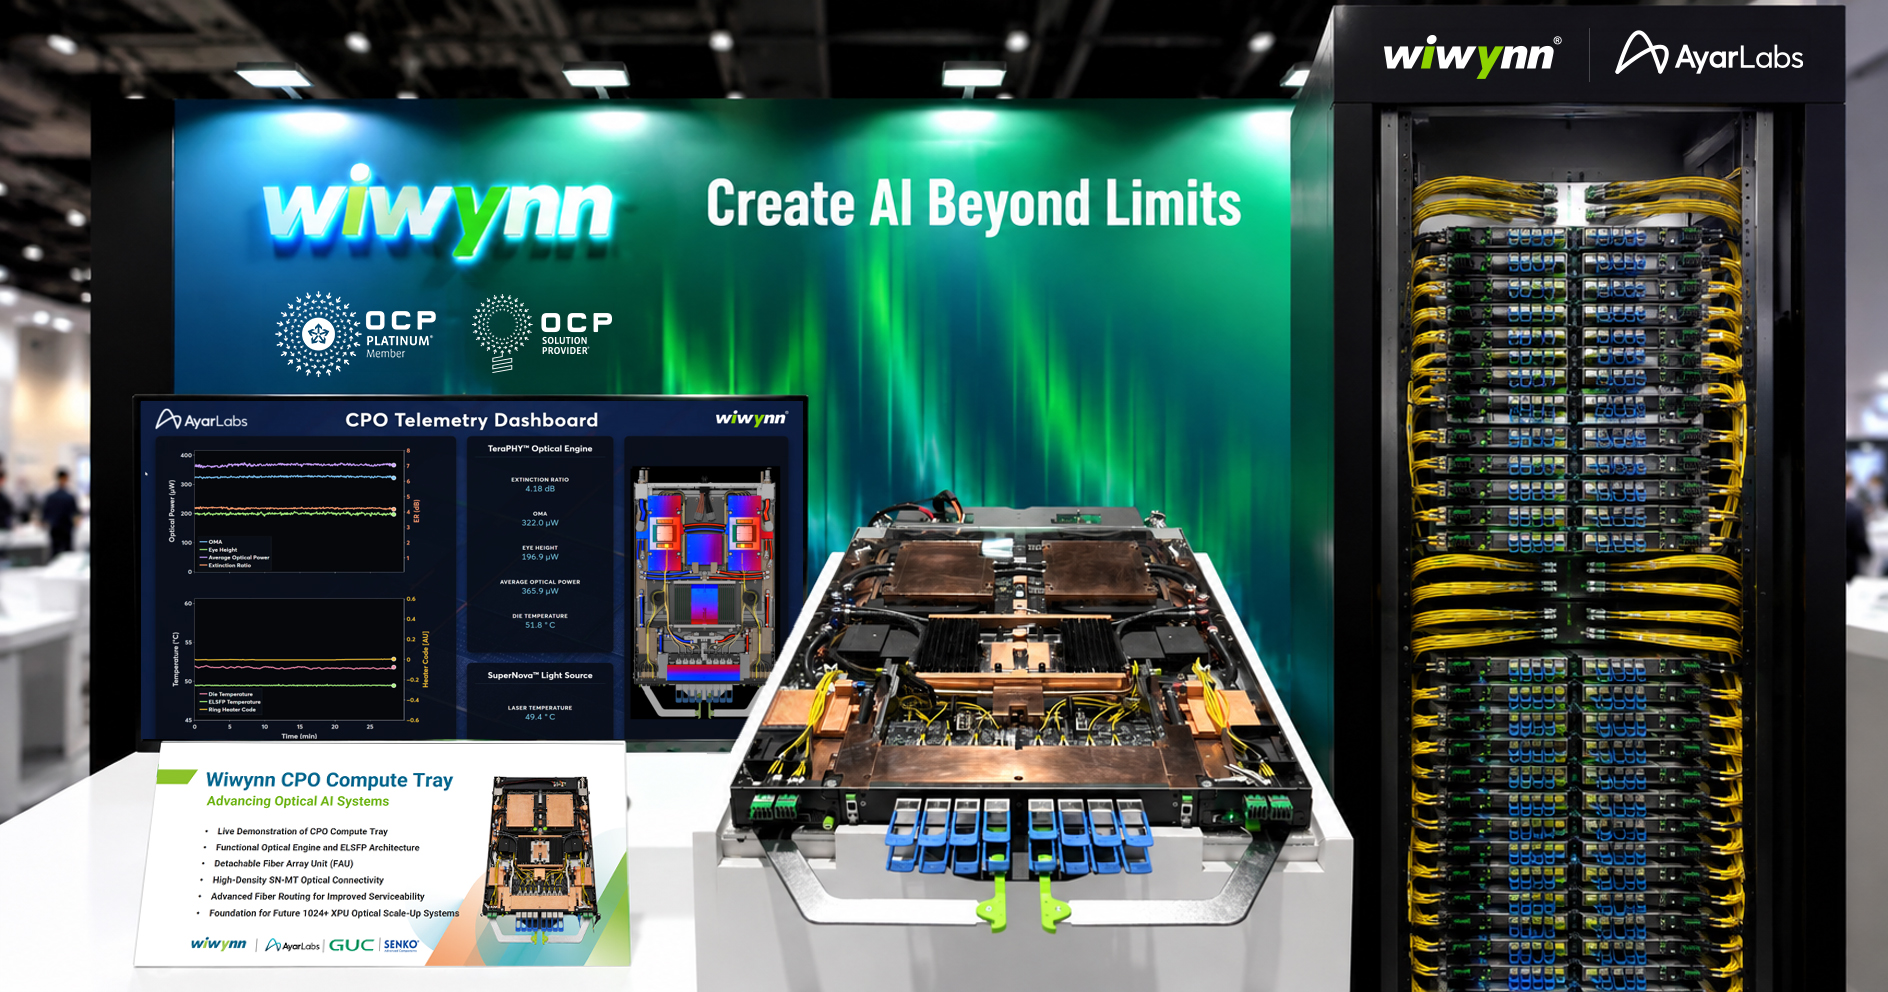
Wiwynn、Ayar Labs与GUC则把重点放在运行中的计算平台。三方将多芯片封装、光引擎和外置光源集成在一起,持续读取光引擎遥测,并展示可拆光纤连接与机内布纤。[3] 相比此前的机架级架构合作,这次推进到了平台集成和功能验证。
现场运行的价值,在于原本分散的约束开始同时出现。计算负载带来的热变化会影响光器件,封装和冷板限制布纤空间,系统控制器需要识别光引擎及光源状态。运行平台让合作方能检查这些接口是否衔接,也让客户有机会提出系统管理要求。但链路在线、遥测可读、某段观察窗口内指标稳定,仍不能替代长期运行统计、批量制造良率和故障恢复测试。
因此,计算光学I/O更适合从有明确互连瓶颈的工作负载出发,由计算芯片、光学和系统团队联合验证。试点需要同时观察物理链路、协议软件与作业表现,确认新增带宽是否让计算资源完成更多有效工作。只看到光接口达到目标速率,还不足以决定整套计算平台如何迁移。
先沿供光路径找到故障
理解光互连运维,可以先看一个供光异常情形。OIF在2022年的管理白皮书中指出:供光光纤出现问题时,光源本身未必能直接察觉,光引擎却可以从输入光功率发现异常,再由主机控制器协调处理。[7] 这不是本届演示发生过的故障,而是解释管理需求的典型情形。
沿用这个情形,运维人员若只看见光源状态正常,就可能找错排查起点。管理系统需要保存光源、供光路径、光引擎与业务端口之间的对应关系,把使用端的异常追溯到正确路径,并在拆换前判断哪些业务会受影响。若多条链路共享电源、控制器或供光连接,故障还可能同时影响它们;冗余评估应检查这些共同依赖,而不只是数光源模块的数量。
有了这条排查路径,遥测字段才有实际用途。光功率帮助发现供光变化,温度和调节活动帮助观察工作条件,错误计数和业务状态则用于判断影响。Wiwynn展示的光引擎遥测,以及OIF已经发布的外部光源管理接口,分别提供了系统演示与管理规范层面的依据。[3][8] 规范存在不等于平台已实现全部字段,也不意味着客户的告警系统能直接使用;详细字段及验收口径见技术说明。
找到故障之后,还要能够恢复。面板模块、外部光源、光学子组件、计算板和整块交换托盘,可能分别构成替换单元。NVIDIA此前介绍过可现场更换的外部光源,说明共封装并不要求所有光学部件都随主芯片一起更换。[5] 客户仍须确认一次维修影响多少链路或计算资源、恢复需要多长时间,以及是否必须停止液冷、拆开光纤或送回工厂。
试点应把热负载变化、供光异常、管理控制器失联和维护后复测放在同一套验证中,检查业务是降速还是作业中断。光引擎、封装、光源和整机可能来自不同厂商,采购方需要一个能收集完整日志、复现条件并组织失效分析的责任主体。运维能力的价值,是让一次成功演示逐步变成可以重复扩容的产品。
采用路线要从真实瓶颈出发
三条路线可能以不同节奏进入产品,也可能同时出现在一座AI工厂中。面板密度受限、同时希望延续模块维护方式的系统,可以重点跟进USFP的接口和生态进度;高速电路径成为新交换平台主要约束时,可以评估交换机CPO,并把制造与服务流程一起验证;加速器互连受限时,计算光学I/O值得开展联合试点,验收对象应包括实际工作负载。
选择路线之后,下一步是把“开放”落实到接口。大会发布、采用OCP规范和获得正式标准认可,是不同层次的事实。Lightmatter对接既有机架与服务器模块边界,有助于减少集成中的重复劳动,却不能直接证明光引擎互操作。[2] 采购方需要知道哪些接口已有公开规格、哪些仍为供应商专有定义、哪些要由双方联合验证,才能判断未来的采购与升级自由度。
最后,比较应回到相同的容量、能耗和恢复口径。模块容量、交换托盘容量与计算托盘的聚合带宽分别描述不同对象;物理线速也不等于应用持续吞吐。共享光源、额外冷却及实际利用率都应进入预算,不能把器件效率直接当成整机节能。技术说明保留了参数对应关系和能耗算例,便于按同一边界复核。
本届大会最值得带入下一轮采购与设计的变化,是光互连开始围绕可交付的系统展开。模块路线需要稳定的多源生态,交换机路线需要可重复的制造和服务流程,计算路线需要协议、软件和工作负载共同验证收益。哪条路线先采用,应由它解除的具体约束和能够交付的证据决定。
技术说明
USFP接口与容量口径
USFP的完整名称是Ultra-Dense Small Form Factor Pluggable。首批规划面向交换机和SuperNIC,在OSFP尺寸的占用空间内提供16个全双工lane。电接口目标由200Gb/s每lane提高到400Gb/s每lane。Cisco同日说明将容量路线明确为:16个lane对应6.4Tb/s聚合容量;未来扩展到32个lane时对应12.8Tb/s,并计划继续增加通道数。[1][9] 联合公告中的最高容量应按这一扩展路线理解,不能解释成首批配置的发送与接收速率相加,也不能当成应用有效吞吐。
连接器采用二维阵列及两阶段插入动作,先插入模块,再接合高速触点,以改善高速连接和插入力控制。TE Connectivity与Amphenol参与笼子、连接器和模块生态建设。[1] 尺寸接近既有外形,只说明一项机械约束;主机兼容性还包括连接器、电气、供电和散热。
厂商宣称,相对200Gb/s每lane的可插拔模块,目标方案可提供4倍带宽密度和约1.3倍能效。密度比较包含通道数与速率同时翻倍的贡献;能效比较不等于整台交换机功耗下降30%。最高100W模块散热支持能力则是设计承载范围,既不是每只模块的实测功耗,也不是节能结果。[1]
已发布系统的具体配置
Lightmatter与Flex的交换托盘标称204.8Tb/s、1RU,采用八个Passage双向光引擎,由Guide DR供光,集成在液冷机箱中,以ORv3与MHS为基础。另一项独立合作的XPU托盘采用另一家ODM的DC-MHS基础设施,包含四个加速器和两颗CPU,厂商标称合计102.4Tb/s的Scale-Up光带宽,并采用Passage、Guide DR及可拆vClick光接口。[2] 前者是生产验证系统,后者是概念验证,两项容量既不描述同一对象,也不能直接与模块容量排序。
Guide DR产品资料将其描述为放入NIC bay的LNIC光源模块,并带有集成冷板。[6] 这一形态说明“外部光源”可以位于机箱内部,评估时仍要核对内部维护与冷却连接条件。
Wiwynn三方演示采用GUC多芯片封装、Ayar Labs的TeraPHY光引擎与SuperNova外置光源;演示还包括可拆卸纤维阵列单元FAU及机内布纤。[3] 这些配置支持平台集成与功能验证的描述,未提供量产良率、长期可靠性或平均修复时间统计。照片中的瞬时读数和机架外观也不能证明实际拓扑规模或生产吞吐。
光电集成与维修的工程条件
主芯片与面板模块之间的走线、封装引出和连接器共同消耗信号预算。为达到目标误码率而采用的均衡、重定时或信号处理,可能增加功耗与延迟。CPO缩短其中一段电路径,但光引擎进入高价值封装附近后,会与先进封装、测试和热设计更直接地相互制约。[4] 图2所示参数仅适用于NVIDIA特定的200Gb/s通道与1.6Tb/s案例。
制造流程要明确何时测试光学功能、何时接入光纤、怎样处理不良件,以及返工是否影响计算或交换芯片。原先可在整机之外独立筛选的模块能力,有一部分需要前移到封装与系统流程中。
可拆光接口有助于分离光纤与芯片组件的装配步骤,但不能单凭“可拆”判断现场可维修性。产品应给出连接器清洁和检查要求、重复插拔后的损耗分布、工具及人员条件。只有这些要求明确后,才能判断是否适合在机房替换,以及替换后的复测如何完成。
遥测字段与验收方法
Wiwynn公告列出的字段包括发送端TX加热器活动、眼高、光调制幅度OMA、消光比ER,以及光引擎和外部光源温度。[3] OIF于2024年发布的ELSFP CMIS实现协议,另为模块温度、供电、通道偏置电流与光功率等监控提供管理基础。[8] 两组信息分别来自演示公告和管理协议,不能据此推断演示平台已经实现后者全部字段。
正式验收应核对每个字段的单位、精度、采样速率、事件保留和告警门限,并检验其能否进入客户监控系统。调节量持续增加而链路仍在线,可能反映工作余量变化;原因须结合环境、供光与错误计数判断,单一曲线不足以诊断器件老化。记录还应能与供光路径及业务端口对应,使故障定位、影响判断和维护后复测使用同一套信息。
容量与能耗的比较方法
容量比较需同时给出通道数、每方向速率、聚合范围,以及是否包含协议编码和纠错开销。双向总量不等于单方向可用能力,端口容量之和不等于任意两点间带宽。训练集合通信和推理请求进入真实拓扑后,还受拥塞、同步和负载分布影响。
能耗应以完整链路为边界,计入光源、驱动、接收、调节、信号处理及额外冷却需求。共享光源的固定功耗怎样分摊、链路利用率是多少,都应明确。不能把容量增加后的每比特能耗与前代不同负载下的整机功耗直接相比。
作为作者假设算例,在持续有效吞吐为100Tb/s、统计边界相同的条件下,每比特节省2pJ,对应约200W功率差;全年按8760小时连续运行,约为1752kWh。该算例不代表任何发布产品。真实集群还需区分固定功耗与随负载变化的部分,结合密度、能效和利用率,才能换算为每单位有效计算产出的收益。
开放接口与供应链交付
接口核验需要逐层进行:机箱尺寸、光连接器配合、光功率与波长、链路协议,以及管理软件识别。各层应列明公开规格、既有实现协议、供应商专有定义和联合验证项。开放可能只发生在其中一层,不能用一个标签替代全部证据。
多源供货也要按部件判断。连接器拥有两家供应商,不代表两种光引擎可以直接替换;更换激光器还可能涉及供光功率、波长组合、管理字段和安全流程。供应链交付内容应包括经过验证的固件版本组合、备件兼容范围、返修周期,以及系统级问题的日志收集、复现和失效分析责任。
来源与口径
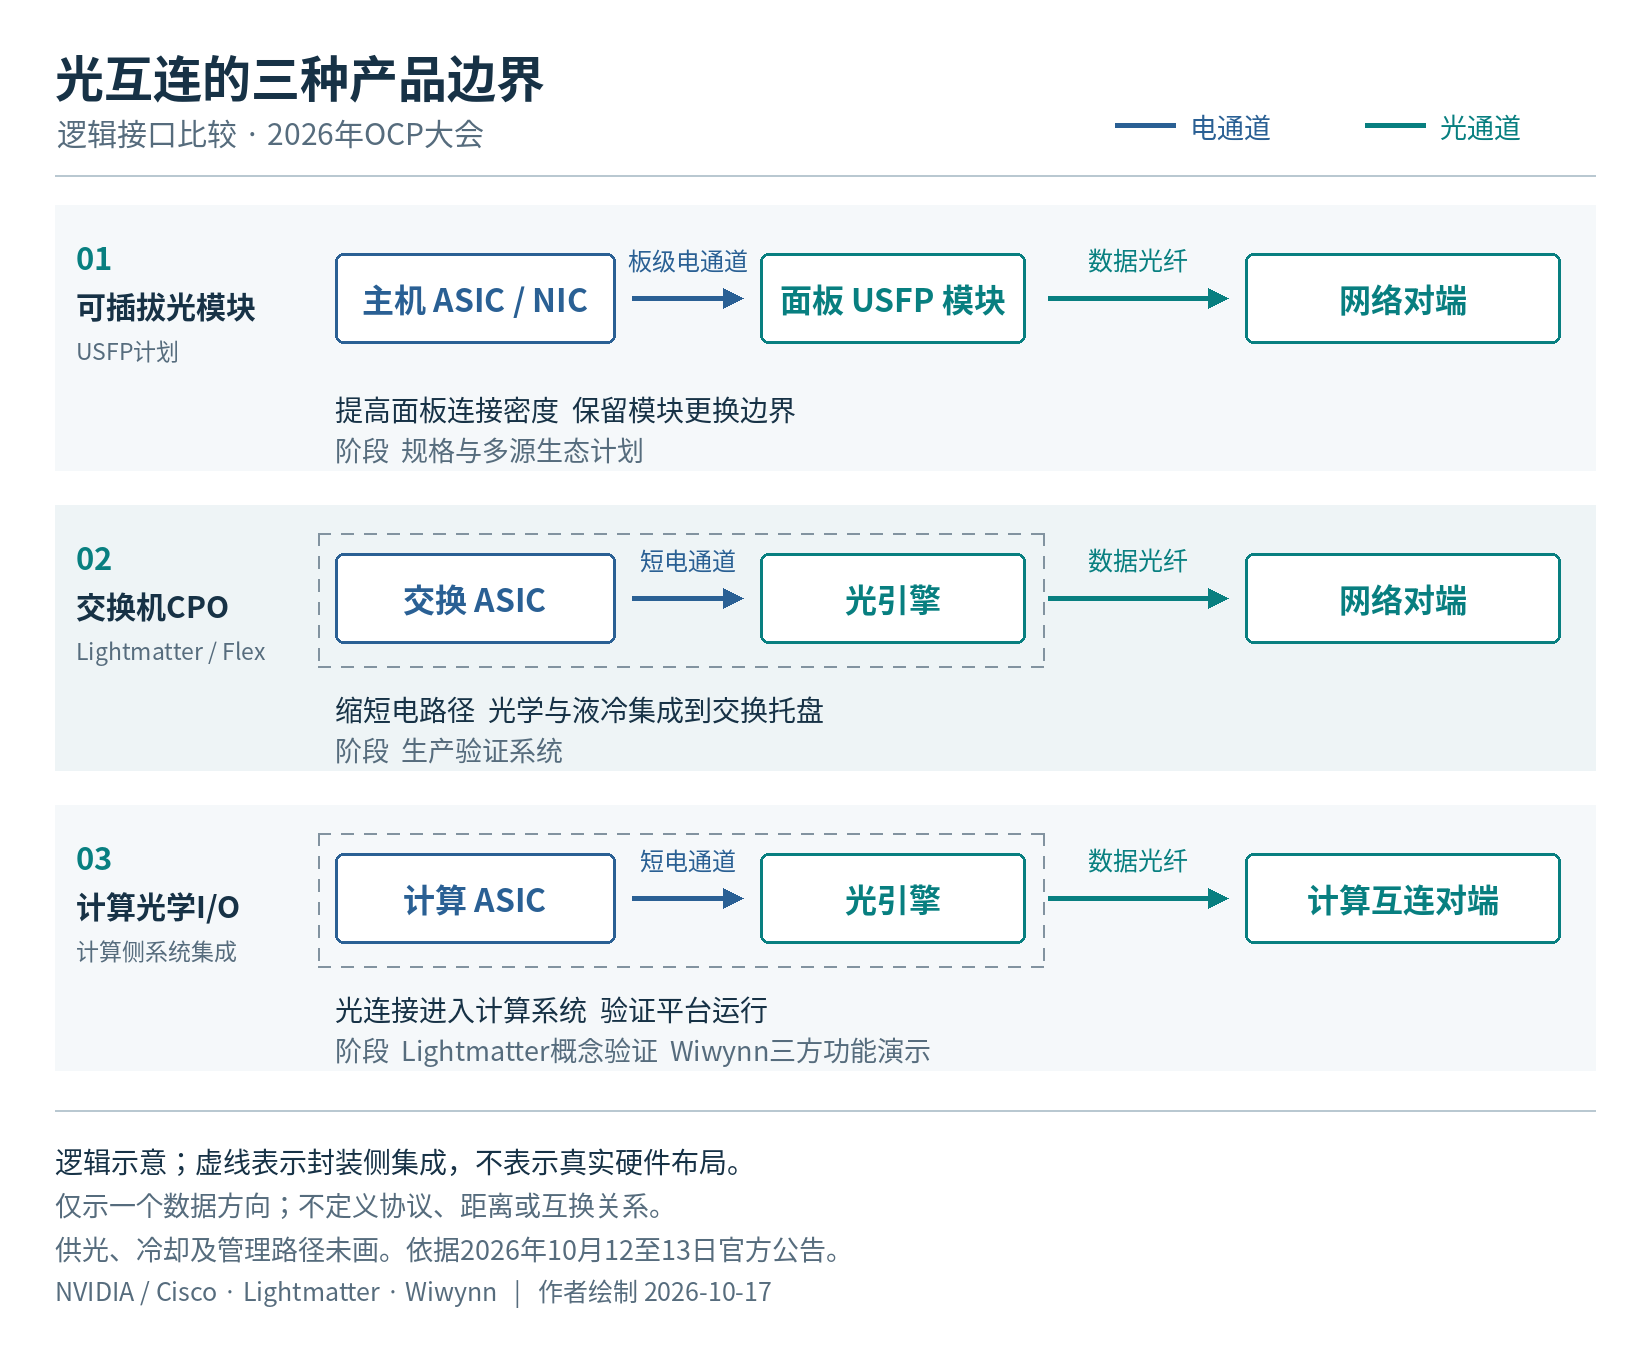
资料截至2026年10月17日。本文将2026年新品计划、生产验证系统、概念验证和现场功能演示分别标注;2022至2025年材料仅作机制与管理背景。所有厂商容量和效率声明均保留原有适用范围,未用不同聚合口径进行横向性能排名。能耗算例为作者假设分析。图1为作者逻辑示意,图2和图3为带来源的官方原图。
[1] NVIDIA与Cisco,NVIDIA and Cisco Introduce New Pluggable Optics Form Factor to Scale AI Factories,2026年10月12日
https://investor.nvidia.com/news/press-release-details/2026/NVIDIA-and-Cisco-Introduce-New-Pluggable-Optics-Form-Factor-to-Scale-AI-Factories/default.aspx
[2] Lightmatter,Lightmatter Delivers Open Rack CPO Switch and XPU Scale-Up Server Through Independent Collaborations with Flex and Other Industry Partners,2026年10月12日
https://lightmatter.com/press-release/lightmatter-delivers-open-rack-cpo-switch-and-xpu-scale-up-server-through-independent-collaborations-with-flex-and-other-industry-partners/
[3] Wiwynn,Wiwynn, Ayar Labs, and GUC Advance Co-Packaged Optics with Live Demonstration of Integrated Optical Compute System at OCP Global Summit 2026,2026年10月13日
https://www.wiwynn.com/news/wiwynn-ayar-labs-and-guc-advance-co-packaged-optics-with-live-demonstration-of-integrated-optical-compute-system-at-ocp-global-summit-2026
[4] NVIDIA,Scaling AI Factories with Co-Packaged Optics for Better Power Efficiency,2025年8月18日,图2及相关正文
https://developer.nvidia.com/blog/scaling-ai-factories-with-co-packaged-optics-for-better-power-efficiency/
[5] NVIDIA,How Industry Collaboration Fosters NVIDIA Co-Packaged Optics,2025年8月26日,外部光源部分
https://developer.nvidia.com/blog/how-industry-collaboration-fosters-nvidia-co-packaged-optics/
[6] Lightmatter,Guide DR产品资料,页面未标注发布日期,2026年10月17日查阅
https://lightmatter.com/products/guide-dr/
[7] OIF,Management of External Light Sources and Co-Packaged Optical Engines,OIF-MGT-Co-Packaging-ELSFP-01.0,2022年11月1日,第8.2节
https://www.oiforum.com/wp-content/uploads/OIF-MGT-Co-Packaging-ELSFP-01.0.pdf
[8] OIF,Implementation Agreement for External Laser Small Form Factor Pluggable CMIS,OIF-ELSFP-CMIS-01.0,2024年9月4日,第8.2、8.11节
https://www.oiforum.com/wp-content/uploads/OIF-ELSFP-CMIS-01.0.pdf
[9] Cisco,Cisco and NVIDIA Announce USFP: Expanding the Path to AI Connectivity,2026年10月12日,Accelerating the next generation of AI fabrics部分
https://blogs.cisco.com/news/cisco-and-nvidia-announce-usfp-expanding-the-path-to-ai-connectivity