
OCP2026|AI工厂供电标准化
供电设计必须衔接扰动响应与服务恢复
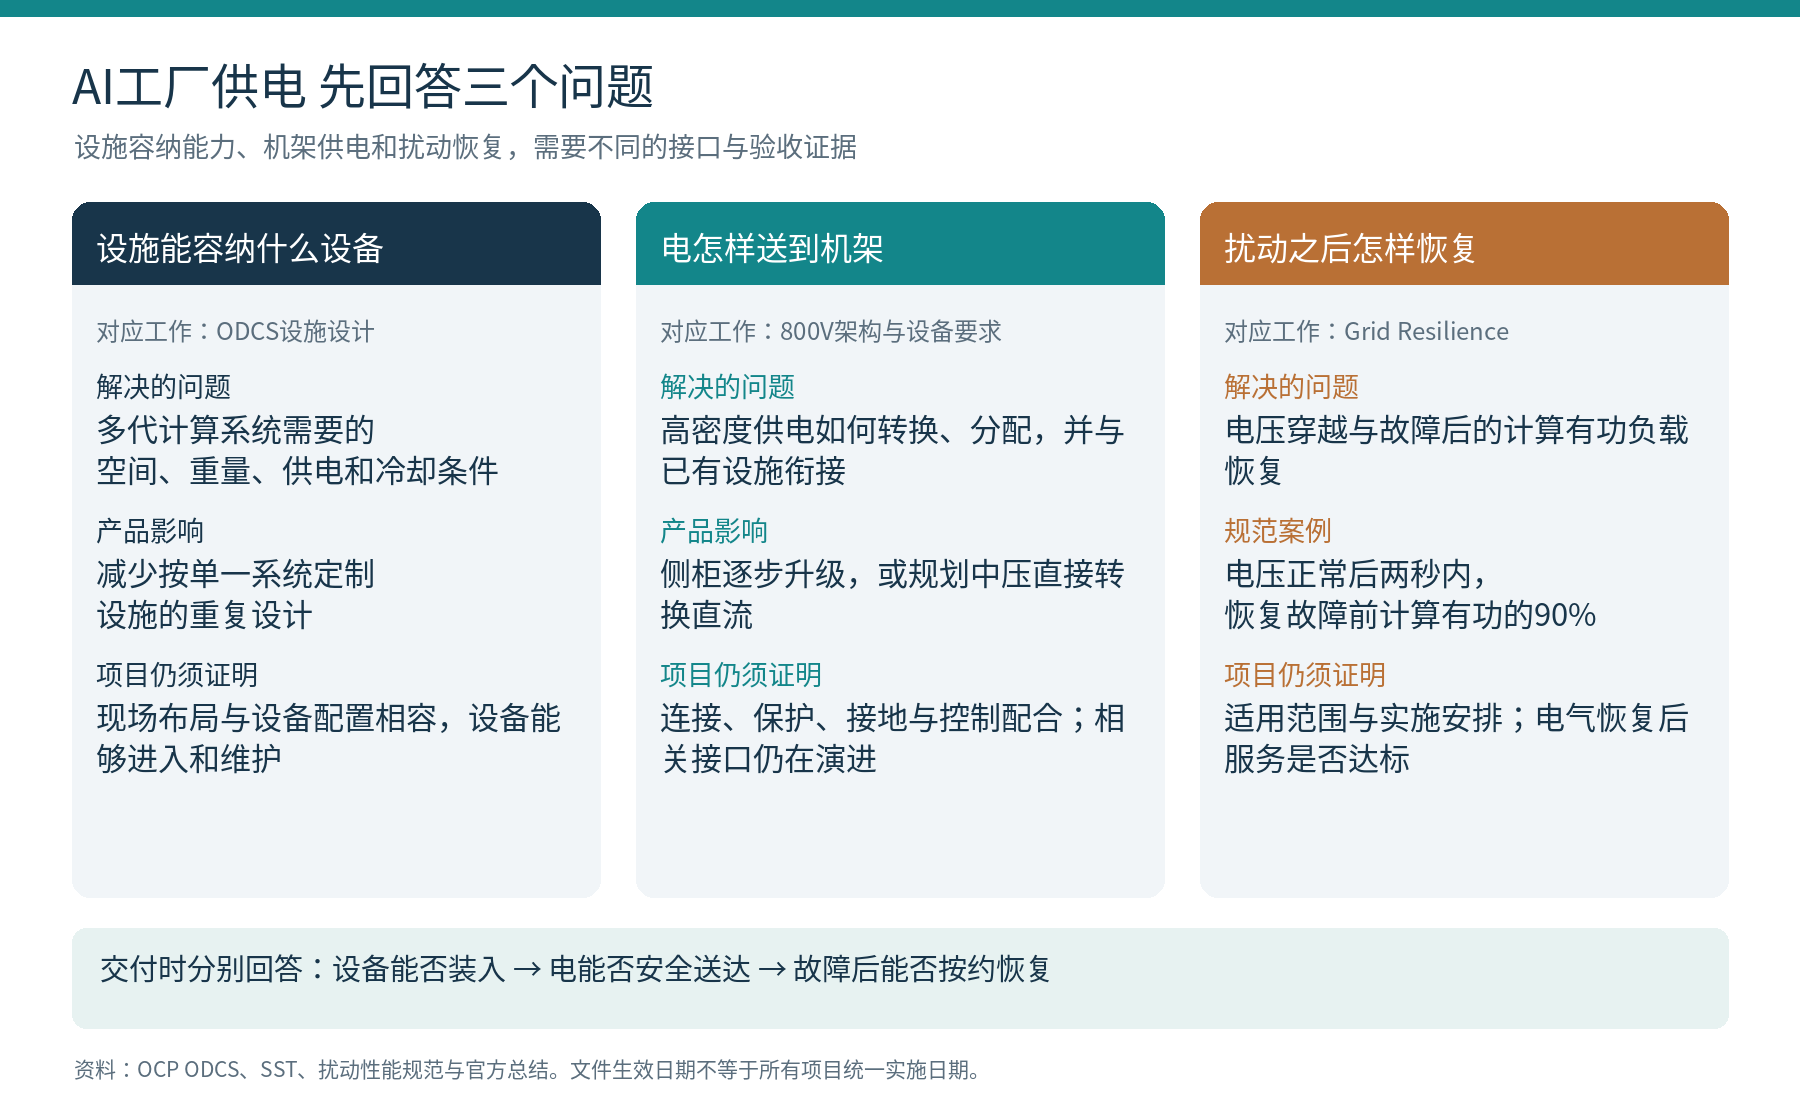
建设AI工厂,供电团队与计算团队必须先回答三个问题:设施能够容纳什么设备,电怎样送到机架,电网发生扰动后计算负载又该怎样恢复。它们分别决定建筑能否接住下一代系统、供电链能否承受更高密度,以及平台能否在异常中保持可预测的行为。
2026年OCP Global Summit汇集的供电进展,可以按这三个问题来读。ODCS为设施条件提供共同设计边界,800V相关工作推进供电架构与设备接口,Grid Resilience约定电压扰动下的负载表现。[1][2] 三者解决的是相互关联但不能替代的问题:一座机房空间足够、直流母线也能送电,并不意味着它已经通过电压穿越验证,更不意味着用户的Token服务能够同时恢复。
对于CTO,最有用的变化,是这些要求越来越可以提前写入供应商接口、配置和验收计划。下文先沿着设施、供电和恢复路径解释产品影响;版本、贡献方及较细的能量和训练算例集中放在技术附页。
设施要为多代计算系统留下什么条件
ODCS的实际增量,是把早期面向特定系统的设施设计,扩展为下一代多平台指导。它移除Google特定的近期表格、TPU Pod扩展及园区布局等内容,把固定排长改为以每英尺功率密度表达的模块化设计。[3] 这意味着设施供应商得到的目标,正从为某一家计算系统定制机房,转向预留可以容纳多种系统的空间、电力与冷却条件。
这并非抽象口号。文件涉及搬运通道、机柜重量、机房高度、供电分块以及冷却歧管可达性。它们决定一代服务器退出后,下一代能否进入同一建筑,是否需要重做楼板、走廊或上方管线。文中的密度采用kW/ft线性排布口径,不能直接当成每平方英尺密度或单柜功率。设计单位若把口径读错,即使设备参数完全正确,设施总量仍可能出现数量级偏差。
对系统厂,这种共同边界可以降低售前重复设计,但并不消除现场工程。土建、机架、供配电和冷却团队应把各自假设放到同一接口表中:运输状态与运行状态的重量是否一致,侧挂电源是否另占位置,歧管能否在不搬走相邻设备时维护。ODCS提供的是共同设计出发点,具体项目仍需把它转换成可签收的配置和图纸。
800V怎样改变电到机架的路径
800V受到关注有直接的物理原因。在相同有功功率、忽略转换损耗的简化比较中,200千瓦经50V直流传输需要4000安,经800V传输约需250安。若再人为固定导体电阻,电阻损耗会随电流平方下降。但实际设计会改变导体截面、距离、绝缘和保护,所以这不能直接换算成整座机房的节电比例,更不能把高压直接送到芯片。[6]
OCP在8月已公布了两条迁移路径。已有机房可以在计算柜旁设置电源侧柜,将现有480V交流转换为直流;较长期的路径则让中压交流直接转换为800V直流,再向整个数据大厅配电。前者仍要求现场有足够交流容量和排内空间。已公布的Mt. Diablo正负400V方案,与计划支持原生800V的后续版本也要分开识别,不能仅因两者具有相同总电位差就默认接口相容。[6]
SST v0.3把中压输入与800V输出之间的设备要求公开,给电力设备厂商更明确的研发目标;LVDC白皮书描述架构选择及相关问题。它们都很重要,但不是所有母线、接头、保护和操作流程已经完成统一的证明。OCP在本届官方总结中仍明确指出,800V到机架的母线与布局设计尚未完成。[2][5] 厂商可以据此提早开发产品,采购方则应明确哪些参数已冻结、哪些接口仍可能变化。
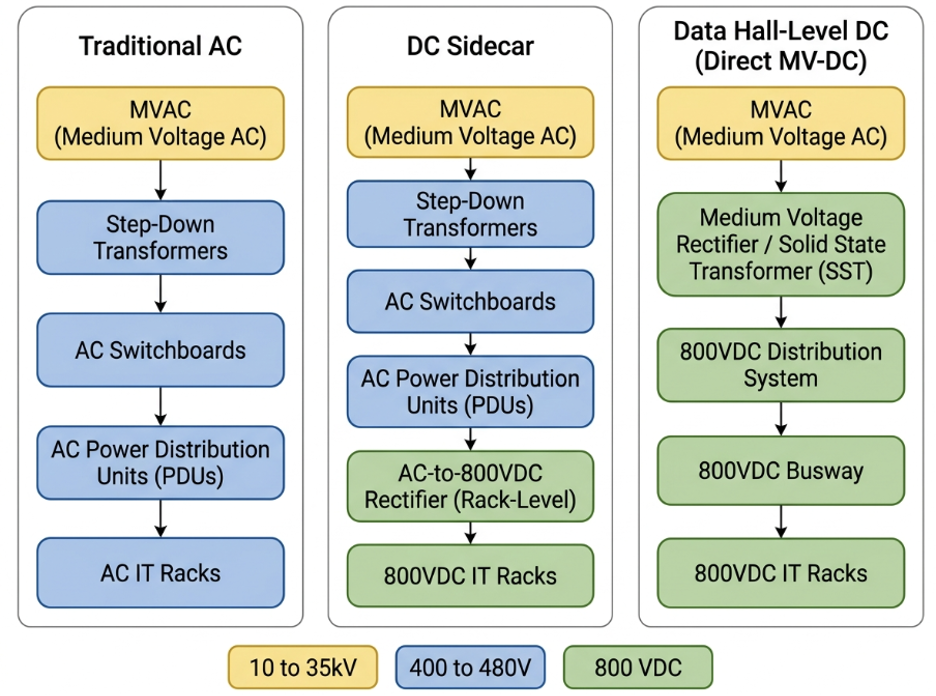
800V还把责任链向上游拉长。机架厂需要给出允许输入范围、故障隔离和接地条件;转换设备供应商需要说明限流、启动及恢复行为;设施方需要证明保护配合与维护边界。对客户而言,有价值的产品不是一张写着800V的规格页,而是这些接口在同一配置中经过验证。换一个电源模块或固件版本,是否必须重新做动态测试,也应在交付前约定。
电压恢复之后 计算负载应怎样重新取电
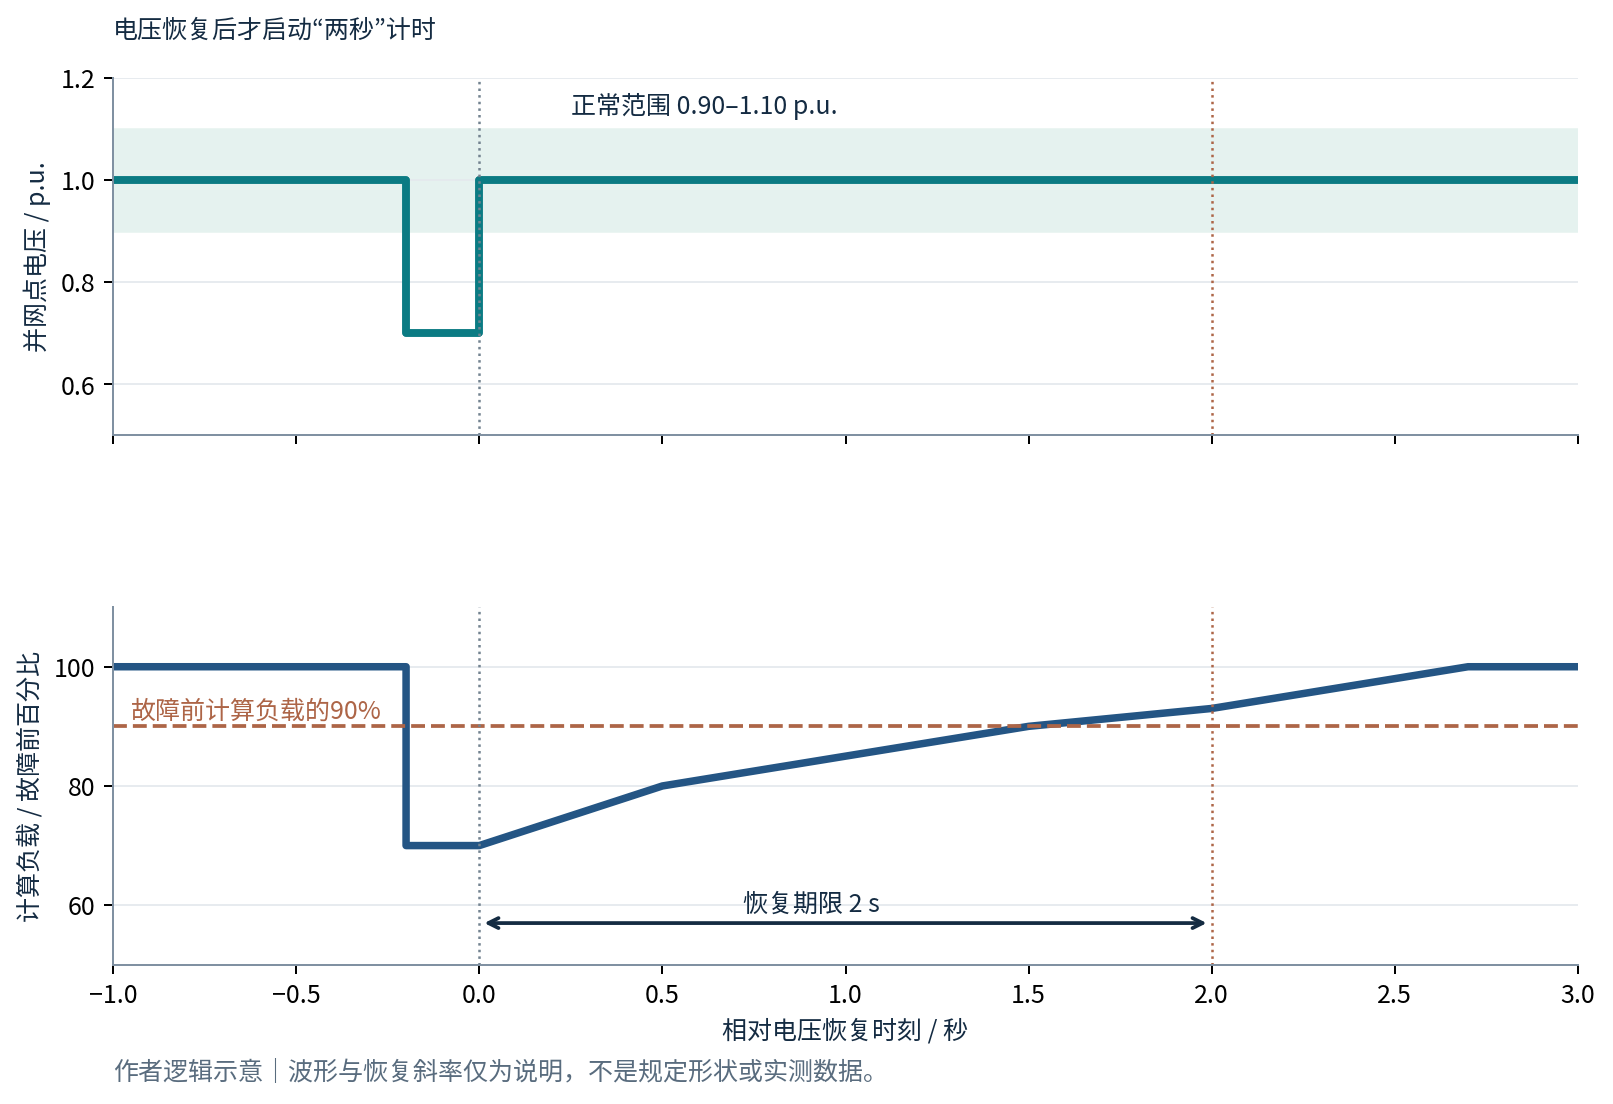
电网扰动规范提供了一个明确的验收案例。《超大规模数据中心与电网扰动性能接口规范》聚焦电压穿越与故障后有功恢复。规定故障包络内,并网点电压回到0.90至1.10标幺值之后,计算负载必须在两秒内恢复到故障前有功功率的90%。标幺值以额定电压为1。[4]
“两秒”既不是从故障出现时起算,也不是AI服务恢复时间;其对象是计算负载,不能扩大成全设施制冷与辅助系统。规范还把爬坡速率、强迫振荡等留给后续工作。[4] 这说明共同供电语言正在逐项建立,而不是一份文件已经回答所有动态问题。项目仍要在并网条件中明确适用故障、测量边界及保护协调。
文件标注的2026年9月17日是该版本的生效日期,不代表所有地区、所有项目从当天起统一强制实施。第4.5节提出的是分阶段落实建议:另定性能要求的实施日期,建议对此前已运行或已签并网协议的设施,在设施寿命期内保留不追溯适用的存量安排;超出原协议容量的增长仅对增量适用;同时为存量设施建立自愿、尽力而为的改造路径,并建议实施日后进入研究和签约的新项目在投运时达标。[4] 这些是建议框架,实际约束仍由项目适用的规则与并网安排确定。
为什么负荷恢复也要受约束?大型计算负荷突然消失,会改变电网的发用电平衡;电压正常后继续长时间留在备用电源上,也会延续失衡。因此,服务器保持供电与设施满足电网要求是两项需要分别证明的能力。对运营者,获得100兆瓦接入容量并不意味着可以任意改变这100兆瓦的取电行为。
电气恢复之后 Token服务可能仍在恢复
供电验收与服务验收应在同一次事件中分别记录。训练应尽量保住状态和通信组,而交互请求更容易受到排队放大的影响。即使取电和设备处理能力已经恢复,用户体验仍可能落后。
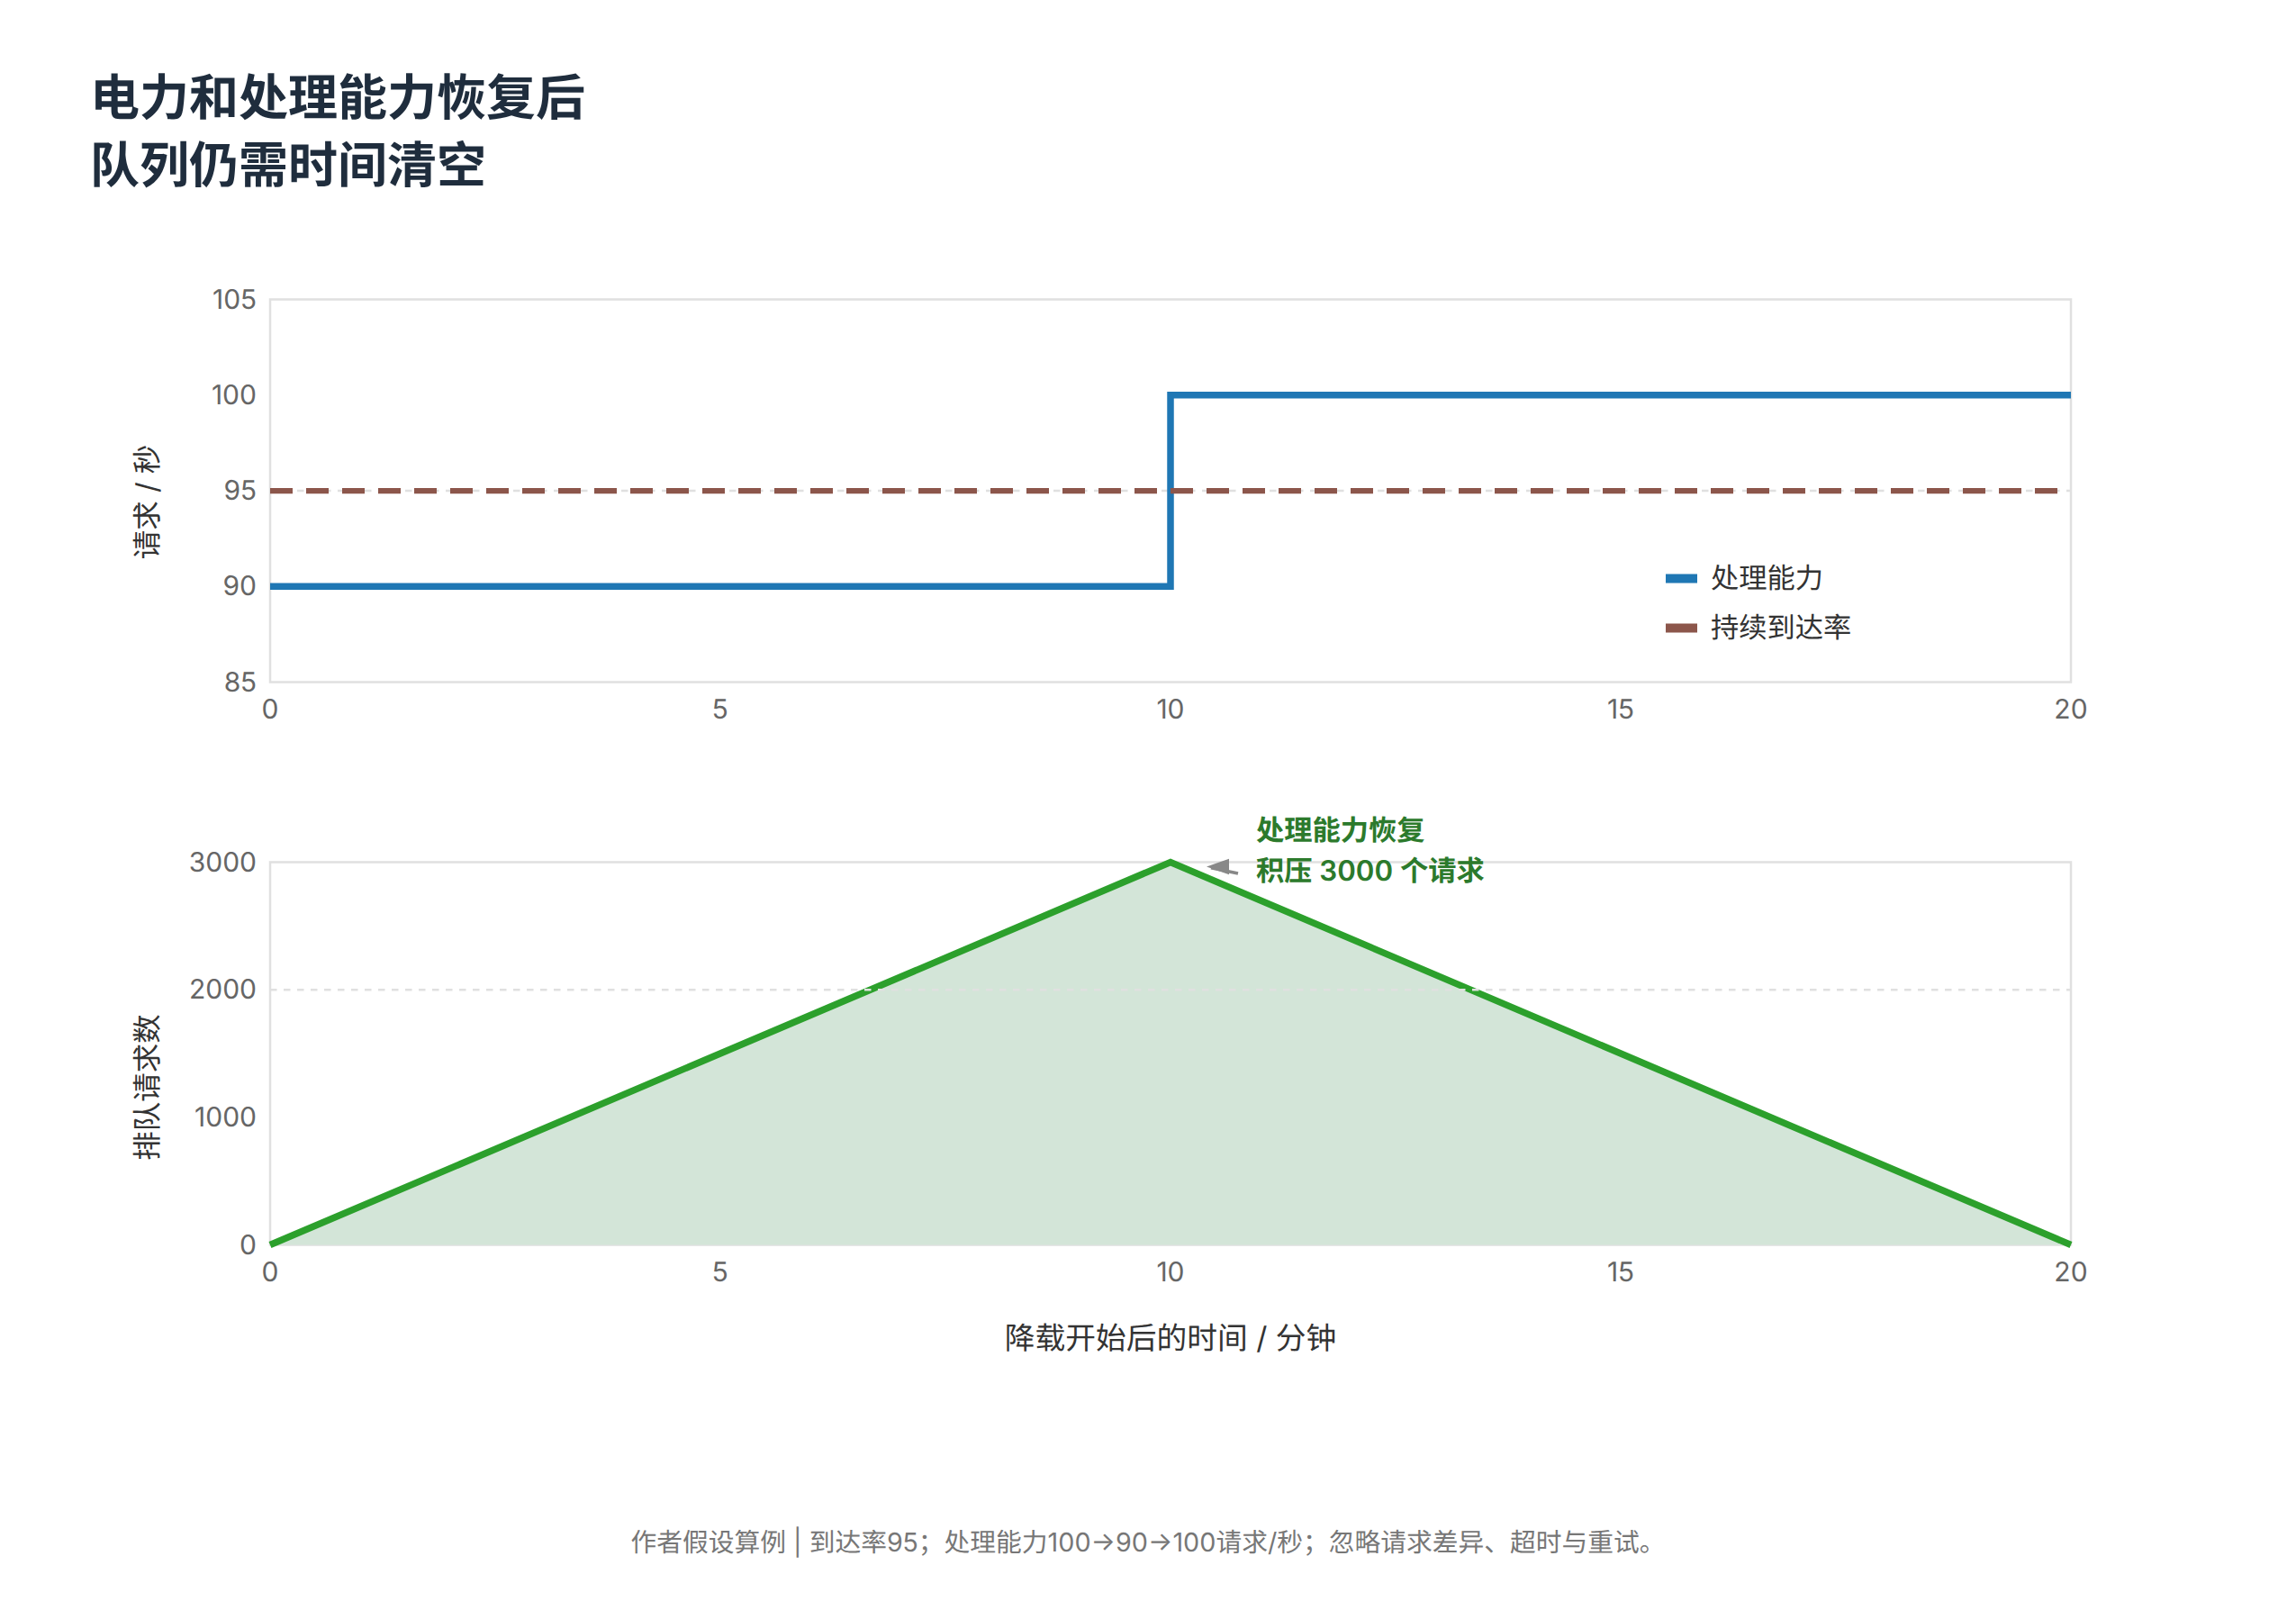
离线推理可以在截止时间允许时排队,适合用交付期限换取用电灵活性;交互推理则必须守住首Token、Token间隔、错误率和尾部时延。假设正常处理能力每秒100个请求,到达95个;降载后只能处理90个,十分钟便积压3000个。恢复100之后,每秒只能净消化5个,还要十分钟清空。此例忽略请求长度差异、超时和重试,仍足以说明电气达标不自动等于服务达标。
故障穿越与需求响应还应保留两条独立路径。前者面对突发电气扰动,后者按照约定改变需求,可能有提前通知、迁移或错峰空间。Google与I&M、TVA的机器学习需求响应合作明确受地点与可靠性约束;NVIDIA WPPS则能把功率配置接入BCM及Slurm流程。[9][10] 这些提供了较慢时间尺度的调节入口,不能证明任意请求都可随时中断,更不是毫秒保护机制。
从PSU到调度器 必须有清楚的控制权
电压变化首先遇到整流器、PSU及本地保护;上层还有UPS、电池储能和设施控制,计算侧则有GPU功率控制、机架管理及作业调度。它们拥有不同的信息与动作速度。本地保护可能在软件看到告警前已经执行,任务迁移却还涉及数据、通信组和状态恢复。不能要求中央调度器独自承担所有时间尺度的响应。
具体时间常数不能跨厂商套用。验收应测量每层的检测延迟、命令传播、稳定时间及失联默认动作,并检查最慢节点。设施控制器要求降功率、任务调度器要求恢复吞吐时,谁持有最终限额,冲突如何仲裁,也必须写进控制接口。把几个管理API连接起来,并不等于控制回路已经稳定。
开放供电改变的是供应链分工
对于电源设备厂商,共同要求有助于减少为不同客户重复开发的版本,但也把竞争推向可验证的动态性能。额定效率相近的两套设备,在限流、异常恢复和与储能协调时,可能呈现不同表现。供应商应交付模型、测试条件和限制说明,让集成商可以判断哪些行为已经被覆盖,哪些还需要项目级验证;缺少这些资料,开放图纸仍可能形成新的集成黑箱。
对于机房运营者,设施寿命通常跨越多代计算系统,共同接口的价值在于保留升级选择,而不是保证升级免费。可以在采购阶段划出稳定部分与可更换部分:建筑及上游容量按较长期目标规划,转换模块、机架连接和控制策略按版本交付。若未来接口改变,合同应明确替换边界、停机窗口和责任方,而不是把全部兼容风险留给下一代服务器项目。
软件厂商也会获得新的产品空间,但应以可核验的数据为基础。功率策略需要知道哪些客户有硬性时延承诺、哪些任务允许延后、哪些分区还有备用能力;设施侧则需要可信的执行反馈。一个显示功率曲线的面板不等于闭环控制,只有触发、执行、验证及失败处置都能追溯,管理软件才真正参与了供电能力交付。
共同规范最终要落到可售容量和责任归属
新的交付报告应把并网点电压、有功功率、UPS和储能状态、机架功率以及任务指标放在同一时间轴上。还要记录固件、保护设置、负载构成和初始电池状态。否则,一次成功恢复难以复现,电力团队与计算团队也可能把因果顺序看反。重复扰动、管理网络失联、部分电源退出和低储能余量,应进入联合测试。
容量经营随之改变。额定设备数、获得的接入容量和满足服务承诺的可售容量未必一致。多租户平台需要区分保证容量与可中断容量,事先约定限额分配及降级记录;不能把全部调节余量卖掉,再让用户承担没有约定的性能损失。投资回报也应同时计算接入进度、有效产出和恢复成本,扣除储能消耗、额外散热及验证开销。
本届进展的产业意义,正在于共同设计条件、设备接口和动态行为开始彼此衔接。ODCS让设施更容易面向多代系统,800V为高密度供电提供演进方向,Grid Resilience把电网要求变成可讨论的验收语言。谁能将这些文件转成版本清楚、责任明确、能够复测的产品,谁才有机会把开放基础设施变成稳定交付Token的能力。
技术附页一 储能的支撑窗口与规范恢复期限
以下算例只比较功率和能量。假设某计算分区平时消耗100兆瓦,需要本地电源额外支撑20兆瓦,持续3秒。这里的3秒从本地电源开始承担缺口时起算,是人为设定的供能窗口;前文规范的两秒则从并网点电压恢复正常之后起算,测量计算负载恢复,两者没有规定的等同关系。
若缺口在3秒内恒定,能量为20兆瓦乘3秒,即60兆焦,约16.7千瓦时;若缺口从20兆瓦线性降到零,则为三角形面积,约8.3千瓦时。数值不对应任何设备测试。千瓦时看似很小,变换器、母线和保护装置仍须把20兆瓦送到正确负载;具体缺口曲线和所需支撑时长应由实际系统分析确定。
实际配置还需要考虑损耗、温度、老化、冗余及可用荷电状态。平时用于削峰的电池,在故障时是否仍有余量?负载恢复与电池补能是否叠加产生新峰值?NVIDIA的2026年BESS设计说明将荷电状态、限流和控制优先级列为系统问题。[8] 产品团队因此要同时交付兆瓦、千瓦时和响应行为,不能只卖一个电池容量数字。
改造成本也要按路径估算。若现有PSU或UPS无法提供所需动作,解决方案可能涉及设备替换、控制更新和停机施工;不能默认一次固件升级就能实现穿越。新建项目更容易从接口阶段安排余量,存量项目则需要逐层确认可改造边界。共同规范降低的是沟通歧义,不能抹去物理资产的代际差异。
技术附页二 训练状态与硬件功率平滑
训练、离线推理和交互请求对降载的承受方式不同。同步训练中,一部分设备变慢可能拖住整个通信组;停机则引入重算。若检查点间隔十分钟、故障均匀发生且最新检查点可用,平均重算区间约五分钟,另外还要计入恢复和通信重建。这只是透明的条件估计,不能代替实际训练框架测试。
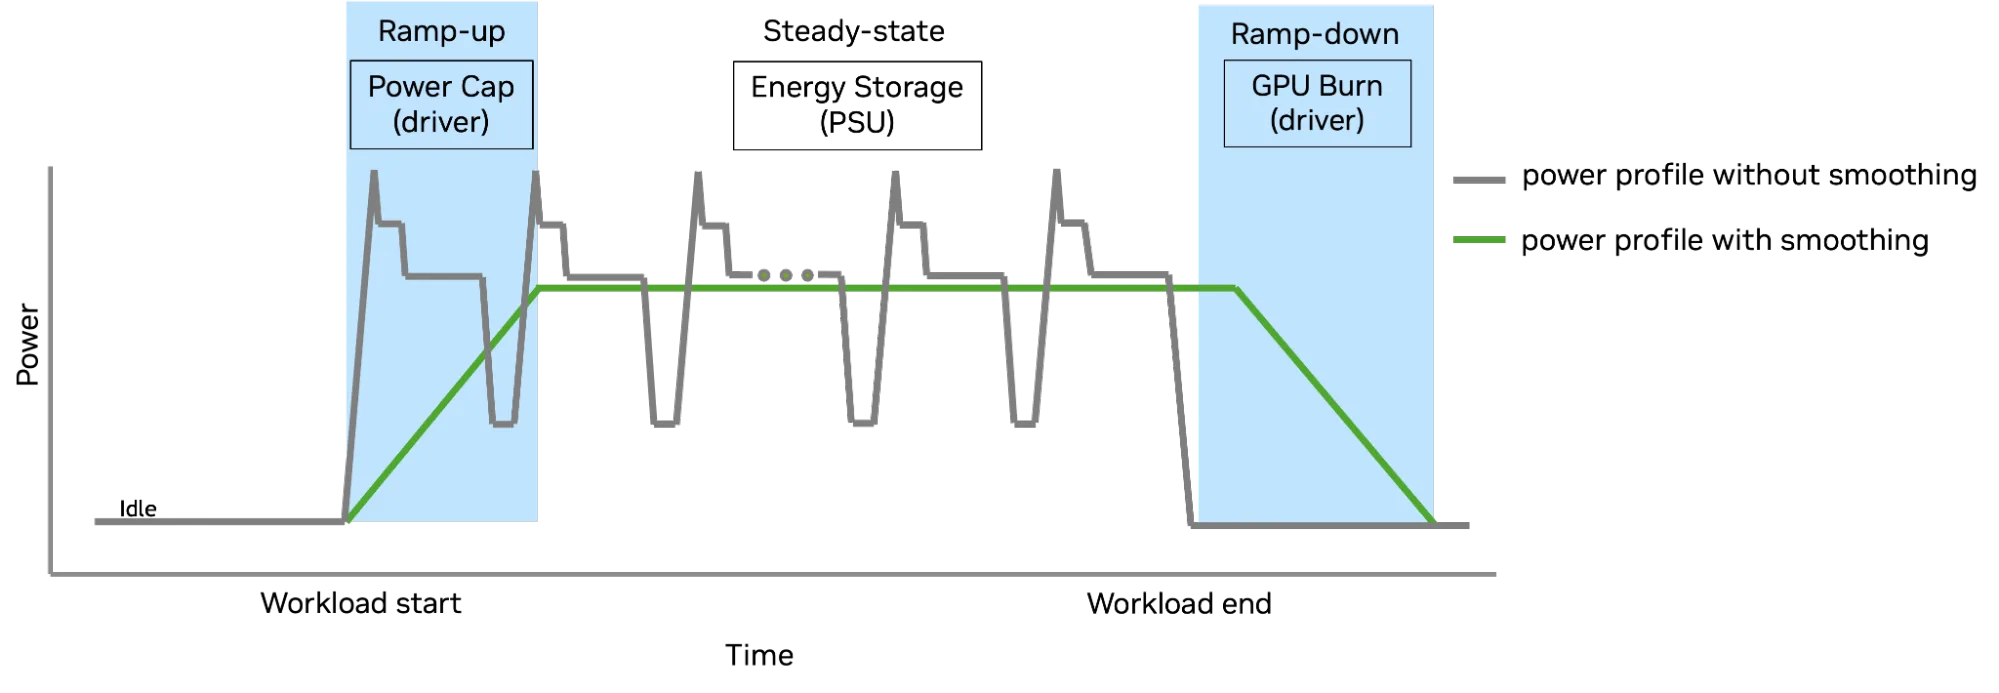
NVIDIA在2025年GB300 NVL72技术说明中,将功率上限、PSU电容储能及GPU受控功率消耗用于平滑负载。[7] 它说明计算硬件能够参与塑造上游功率曲线,但不是本届电网规范的合规证据。尤其是为了平滑下降而继续消耗的电能,并未产生有效Token,必须计入效率。曲线更平与单位有效产出更省电,不能混用。
技术附页三 文件版本与供电架构成熟度
ODCS v0.7由AMD、Google、Meta与NVIDIA共同参与,面向2027至2028年设施。其封面生效日为2026年8月27日,版本历史的0.7条目为6月23日;这两个记录分别保留。相较Google主导的早期版本,它扩大了面向多种计算平台的范围。[3]
Grid Resilience对应的扰动性能接口规范为v1.0.0,由Google、Meta、Microsoft与NVIDIA参与,文件生效日为2026年9月17日。文件版本已发布,与各个并网项目何时采用是两个判断;第4.5节的实施建议不能自动替代项目条款。[4]
800V相关工作包括LVDC架构白皮书、设备要求和项目规划。中压转800V直流的SST规范仍为v0.3,封面生效日为2026年6月22日,版本历史将其记为首份草案。峰会上的Visionbay K-1是面向未来Vera Rubin部署的800V工厂规划,不作已经投产认定。OCP也明确800V到机架的母线与布局仍有未完成工作。[1][2][5]
来源与口径
资料截至2026年10月17日。工程算例与验收建议均为作者分析。ODCS封面为2026年8月27日,版本历史0.7条目为6月23日,二者分别保留;本文不将峰会集中发布等同于所有文件在10月首次生效。800V项目规划不作投产认定。
[1] NVIDIA,OCP Global Summit: Amid Ecosystem Adoption, NVIDIA Opens Vera Rubin Architecture to Help Scale AI Factories Worldwide,2026年10月12日
https://blogs.nvidia.com/blog/ocp-global-summit-vera-rubin-scale-ai-factories/
[2] OCP,Realizing the OCP Open Data Center Ecosystem Vision,2026年10月12日,设施贡献及未来未完成接口
https://www.opencompute.org/news/realizing-the-ocp-open-data-center-ecosystem-vision/
[3] OCP,Open Data Center: Next-Generation ML Infrastructure Design Principles,Revision 0.7.0,版本历史及第3至6节
https://www.opencompute.org/wp-content/uploads/2026/10/Open-Data-center-Spec-Revision-0.7.0-4.pdf
[4] OCP,Interface Specification Between Hyperscalers and Utility Grid for Disturbance Performance v1.0.0,文件生效日2026年9月17日,第4.2.2、4.4.3、4.5节及表1
https://www.opencompute.org/documents/ocp-base-spec-interface-specification-between-hyperscalers-and-utility-grid-for-disturbance-performance-pdf
[5] OCP,Solid State Transformer Specification v0.3.0,封面生效日2026年6月22日,版本历史标为首份草案
https://www.opencompute.org/documents/ocp-sst-design-specification-v0-3-final-pdf/
[6] OCP,Powering the Next Era of AI: How Google, Microsoft and Nvidia Are Standardizing and Accelerating the Industry Transition to LVDC,2026年8月11日,迁移路径图及接口工作范围
https://www.opencompute.org/news/powering-the-next-era-of-ai-how-google-microsoft-and-nvidia-are-standardizing-and-accelerating-the-industry-transition-to-lvdc/
[7] NVIDIA,How New GB300 NVL72 Features Provide Steady Power for AI,2025年7月28日
https://developer.nvidia.com/blog/how-new-gb300-nvl72-features-provide-steady-power-for-ai/
[8] NVIDIA,Designing Production-Ready Battery Energy Storage Systems for AI Factories,2026年6月10日
https://developer.nvidia.com/blog/designing-production-ready-battery-energy-storage-systems-for-ai-factories/
[9] Google,How we’re making data centers more flexible to benefit power grids,2025年8月4日
https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/how-were-making-data-centers-more-flexible-to-benefit-power-grids/
[10] NVIDIA,Workload Power Profile Solution Introduction,Mission Control 2.0.0管理文档,2026年7月16日更新
https://docs.nvidia.com/mission-control/docs/systems-administration-guide/2.0.0/wpps/introduction.html