基于 OpenAI 于 2026 年 10 月 26 日的公开声明与多方信源交叉核查|信息截至 10 月 27 日晚
10 月 26 日,OpenAI 一口气公布了三项由内部模型产出的科学成果:证明所有维度的局部光滑化猜想(调和分析)、证伪指数时间假设 ETH(计算复杂性理论)、为四维杨-米尔斯理论建立严格数学存在性证明(量子场论)。舆论反应的两端,一端是社交网络上「如果成立,这是数学与理论计算机科学史上最大的单日」的欢呼,另一端是「把 AI 关回笼子」的警惕。这两句话都对,因为这次真正值得看的不只是三份证明本身,还有 OpenAI 给它们安排的三种不同的信任等级。
一、三发齐射,但信任分了三级
先看事实。三项声明都来自 OpenAI 未公开的内部研究模型。其中计算机科学一项,模型在 10 月 16 日给出自然语言证明,次日即完成 Lean 形式化验证,从证明到机器逐行核验只隔了一天。
但 OpenAI 对三项成果采用了三种截然不同的公开策略,这个细节比成果本身更能说明问题:
| 声明 | 公开材料 | 把关安排 |
|---|---|---|
| ETH 被证伪 | 67 页论文+Lean 4 代码全部公开 | 原提出者 Impagliazzo、Paturi 与 MIT 的 Ryan Williams 组织公开独立审查 |
| 局部光滑化猜想(全维度) | 59 页论文+Lean 4 代码全部公开 | 专家建议直接放出,交由研究者自行推导完善 |
| 四维杨-米尔斯存在性 | 未公开预印本与代码 | 交 Arthur Jaffe、David Gross 等五位物理学家先重写消化 |
第一档是「材料全放+原作者审查」:ETH 的两位提出者 Russell Impagliazzo 和 Ramamohan Paturi——1999 年定义这个假设的正是他们——如今被请来检查 AI 是不是把它推翻了,审查组第三位成员、MIT 的 Ryan Williams 是下界理论与算法设计方向的顶尖学者。三人明确声明:参与组织审查不等于认证结果。OpenAI 同时承诺出资赞助一场学术会议,组织全球学术界共同检验。
第二档是「材料全放、社区自行消化」:数学方向的专家给出的建议是,把这些 AI 生成的文稿直接公开,让研究者自己去推导和完善。OpenAI 自己的说法是,这些文稿最恰当的理解方式是「原始研究数据」,而不是论文。
第三档是「材料不放、先由权威重写」:杨-米尔斯这项虽然 OpenAI 称 10 月 16 日已跑通形式化验证,却是三发中唯一连手稿都没挂出来的,理由是交给物理学家先「重写消化」。
三种策略对应三种可信度自评。这大概是一家 AI 实验室第一次如此直白地承认:AI 产出的证明,不是每一份都配得上同样的信任。
二、ETH:三十年下界体系的那根支柱
三发里真正让理论计算机科学界倒吸凉气的是 ETH。要理解它,可以从一个密码锁开始:锁有 n 位,每位只能取 0 或 1,你不知道正确密码,但掌握一批线索,每条线索涉及最多三位——「第一位和第二位不能都是 0」「第二位为 0,或者第三位为 0」。问是否存在一组取值让所有线索同时成立。这就是 3-SAT 问题,NP 完全问题的祖师爷。
四位的锁最多试 16 种组合。一百位的锁有 2^100 种组合,聪明的算法不必逐一尝试,但对于一般情形的 3-SAT,算法到底能有多快?1999 年,Impagliazzo 与 Paturi 给出了他们的判断:不存在时间复杂度为 2^{o(n)}(亚指数)的算法能解决一般 3-SAT,最坏情况下绕不开随变量数增长的指数级代价。这就是指数时间假设。
这个假设从未被证明,但过去近三十年里几乎所有人都相信它,并在它之上建立了一整套「条件性下界」:图论、数据库查询、计算几何、计算生物学里数百篇论文的结论形如「假设 ETH 成立,则问题 X 不可能有亚平方时间算法」。ETH 成了理论计算机科学里标注「计算死刑」的坐标系原点。
OpenAI 的论文标题毫不含糊:《指数时间假设是错的》。手稿给出一种确定性算法,能在亚指数时间 exp(n/(log n)^{1/2+o(1)})、多项式空间内精确计数固定宽度 CNF 公式的可满足赋值个数。注意这是计数版本——不只是判断有没有解,而是精确数出有多少组解,比判定更强。3-SAT 是它的一个特例。只要亚指数算法存在,ETH 的断言就被否定。
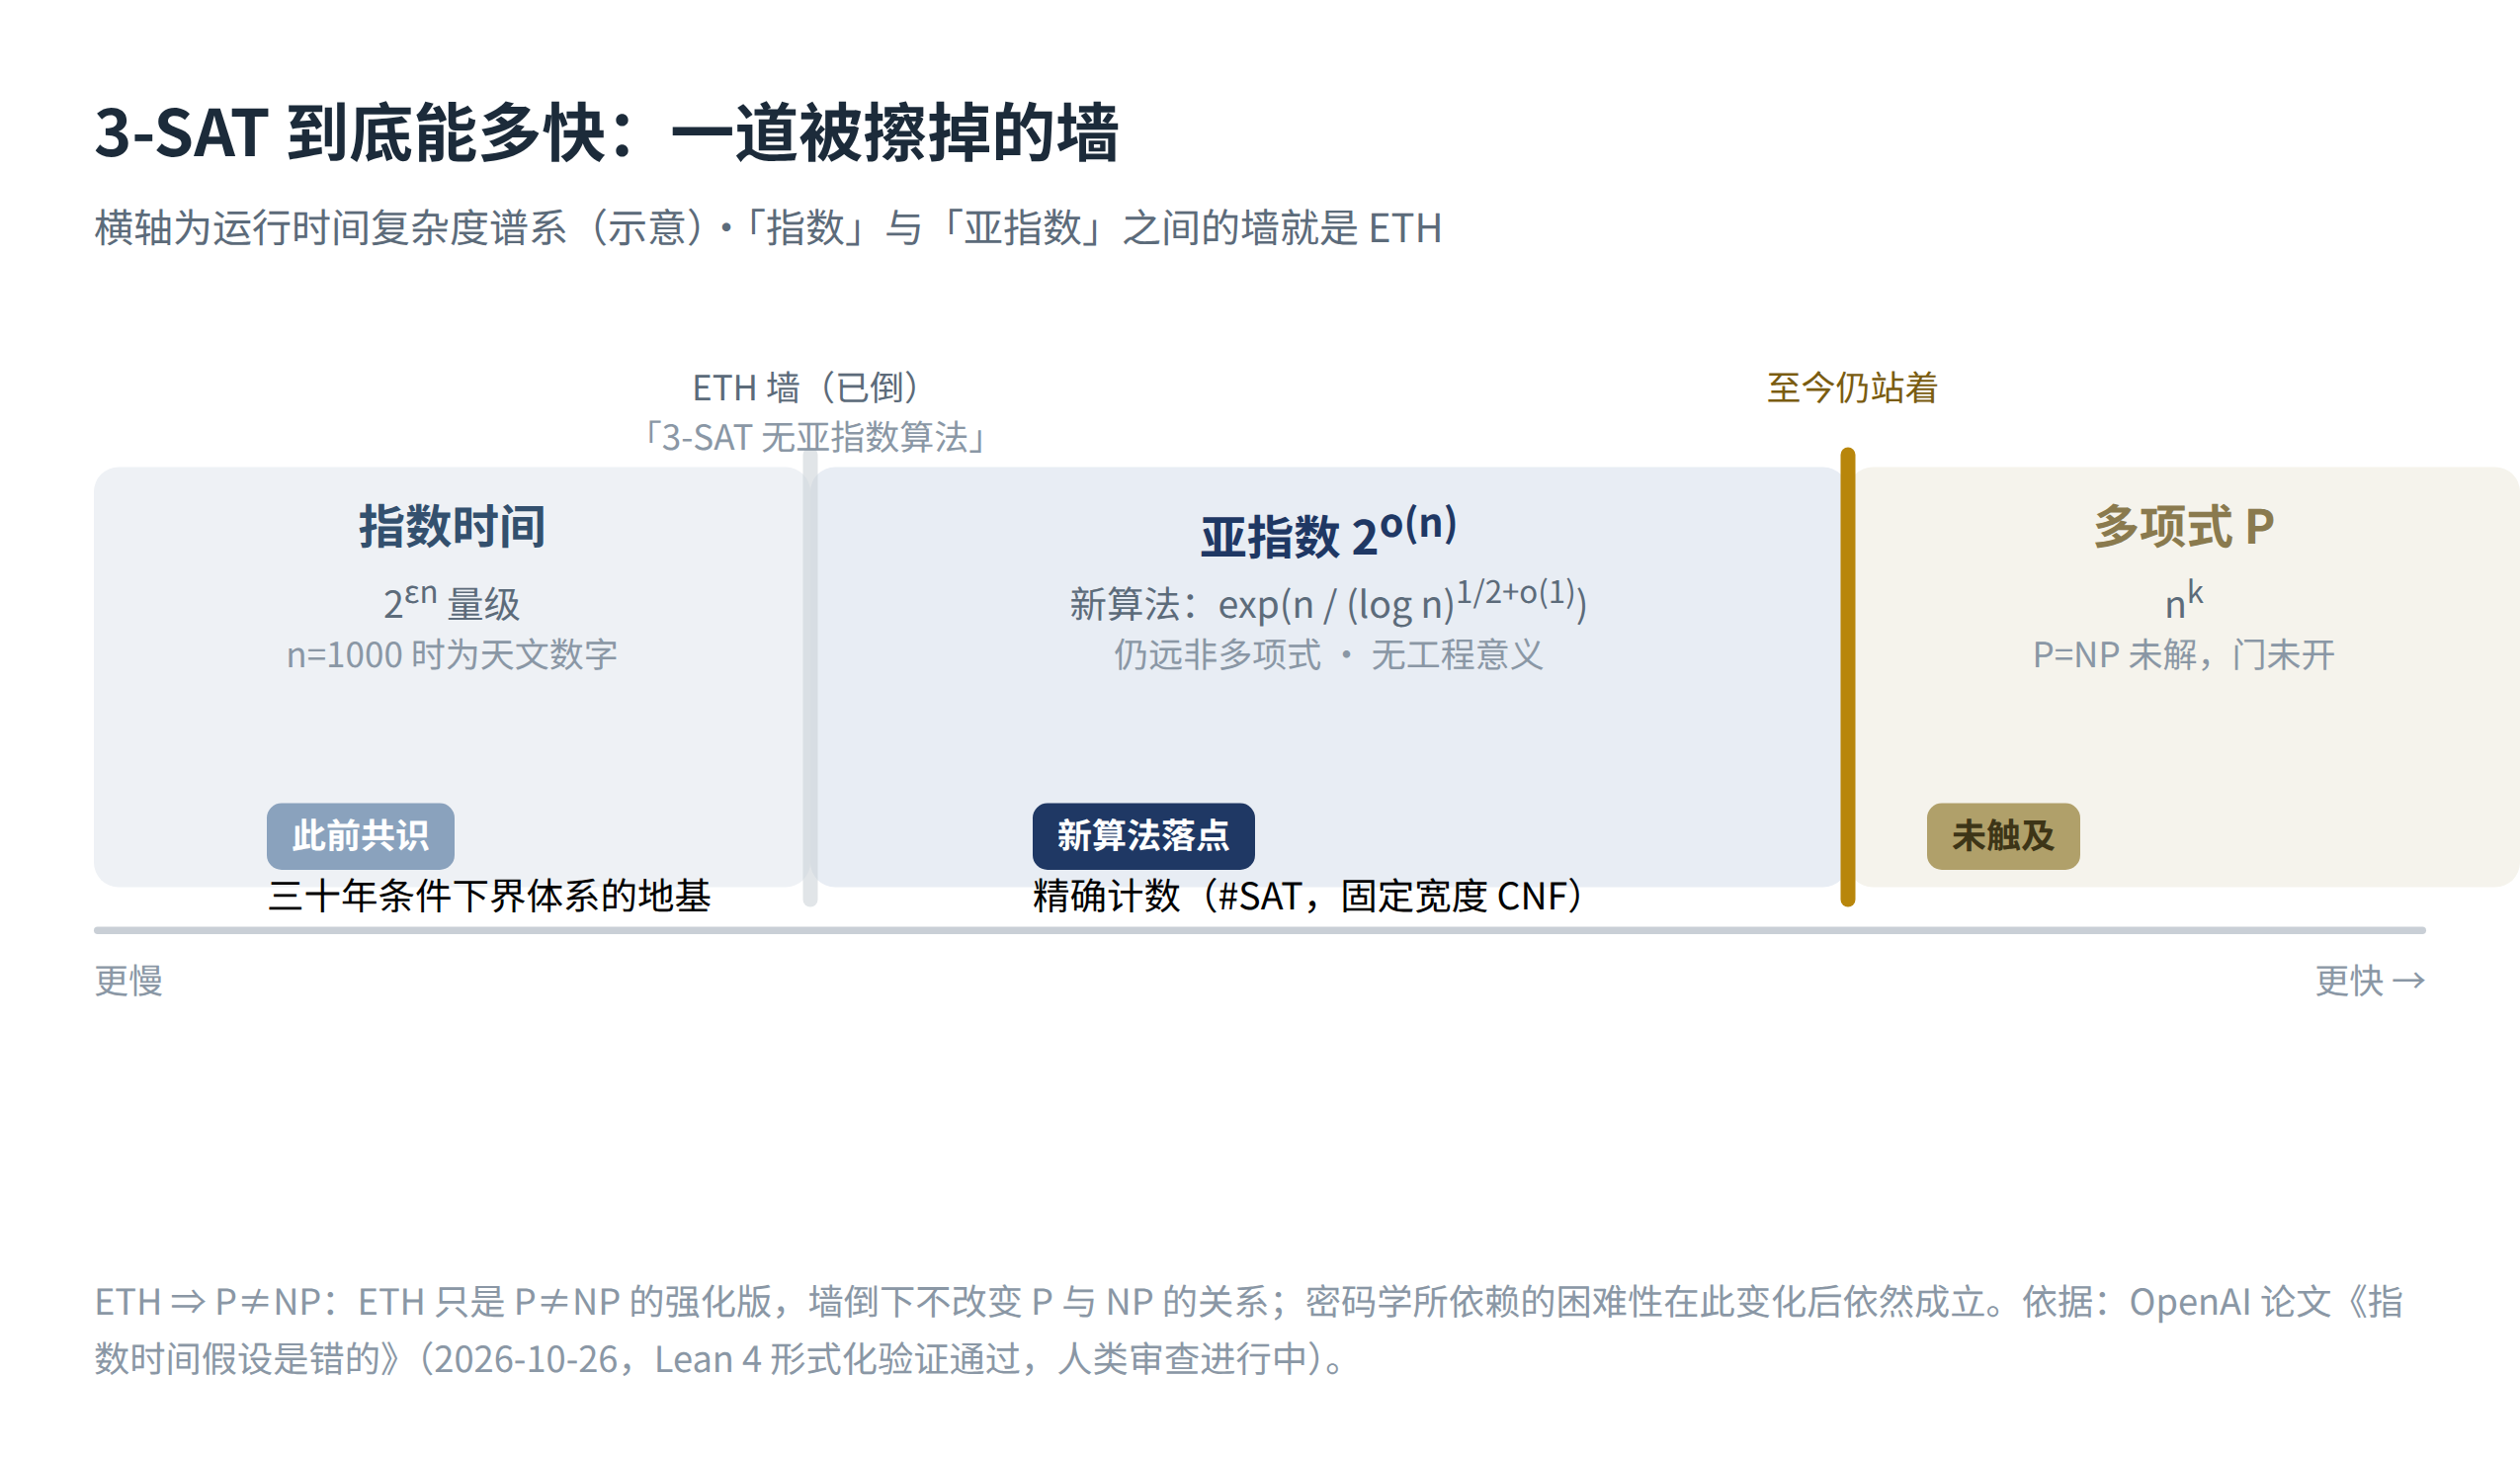
三个边界必须说清。第一,这不等于证明了 P=NP:ETH ⇒ P≠NP,反过来 ETH 被证伪只说明 3-SAT 存在亚指数算法,离多项式时间还有本质距离,P 与 NP 的大门并没有被推开。第二,密码学今天没有破:亚指数仍然意味着天文数字的计算量,按 exp(n/√log n) 口径,n=1000 时的工作量在 10 的近百次方到上百次方量级(取决于对数底的约定),没有任何工程意义。第三,这个算法不会进入任何实用的 SAT 求解器:它的价值不是加速,而是划掉了下界地图上的一根经线。
那数百篇建立在 ETH 之上的论文怎么办?逻辑上它们没有作废——「若 ETH 则 X」依然是定理。但前提的可信度塌了,这些下界的实际含义需要重新评估:要么找到无条件证明,要么换一个仍然可信的假设。而且更强的 SETH(强指数时间假设)蕴含 ETH,ETH 倒下意味着 SETH 名下的那批下界也连带失去前提。科学史上少有这样的时刻:出题人被请回来,组织审查一份推翻自己假设的 AI 证明。
三、挂谷与杨-米尔斯:数学和物理的两发
数学那发同样有分量。局部光滑化猜想是调和分析的核心问题,关涉波动方程解的正则性如何随时间演化;它向下推出 Kakeya 极大猜想、Kakeya 维数猜想和 Stein 球面限制估计——合起来几乎推平了这一领域的四大经典难题。背景值得尊敬:2025 年 2 月,王虹与 Joshua Zahl 用一百多页论文解决了三维挂谷猜想,被视为调和分析的世纪性进展。OpenAI 这次声明的是全维度(n≥2)的局部光滑化,覆盖面更广,且据称核心工具是一条此前没人用过的辅助偏微分方程——如果成立,这是工具箱级别的更新,不只是单点突破。59 页预印本与 Lean 4 代码已全部公开。
物理那发则要克制得多。克雷研究所 2000 年的千禧年题面「杨-米尔斯存在性与质量间隙」要求两件事:一是构造性存在性,即在四维时空中严格构造出满足公理(Wightman 公理或 Osterwalder-Schrader 反射正性)的非平凡量子规范场论;二是证明质量间隙。OpenAI 声明的是与第一件相关的结果——四维 QCD 与纯杨-米尔斯的存在性,质量间隙只字未提。量子场论作为现代物理的基石,在严格数学层面始终缺乏地基,任何实质进展都重大。但三发中唯独这项没有公开手稿和代码,社区讨论最热烈的恰恰是这个反差:为什么 10 月 16 日就跑通了形式化验证的工作,反而不放原始材料?官方口径是交由五位物理学家(包括题面作者 Arthur Jaffe 与诺奖得主 David Gross)先重写消化。这个安排说得通——物理证明的表述与传统数学形式化之间的翻译工作量可能巨大——但它也意味着,这一发目前完全依赖五位专家的信誉背书,外界连检查的入口都没有。
四、Lean 验证能证明什么,不能证明什么
这次「一天完成形式化验证」的叙事需要一个精确的拆解,因为它正是所有兴奋和所有争议的交点。
Lean 这类证明助手做的事情是:给定一个形式化陈述和一段证明代码,机器逐行检查每一步推理是否由公理和已有定理严格导出。它能证明的是:如果陈述写对了,证明就没有漏洞。这件事上机器比人可靠——人类审稿会累、会跳步、会被名气说服,Lean 不会。
它不能证明的是:陈述本身是否忠实对应你想证的那个数学命题。把「ETH 是错的」翻译成形式语言时,每个定义怎么映射、量词顺序怎么摆、边界条件怎么处理,这些翻译环节仍出自人类(或 AI)之手。一条 Lean 验证通过的代码,完全可能证明了一个与原命题有微妙差别的命题——形式化圈子里这类「陈述正确性」事故并不新鲜。这正是为什么 Impagliazzo、Paturi 和 Williams 的审查组依然必要:机器负责推理链,人负责陈述与意义。
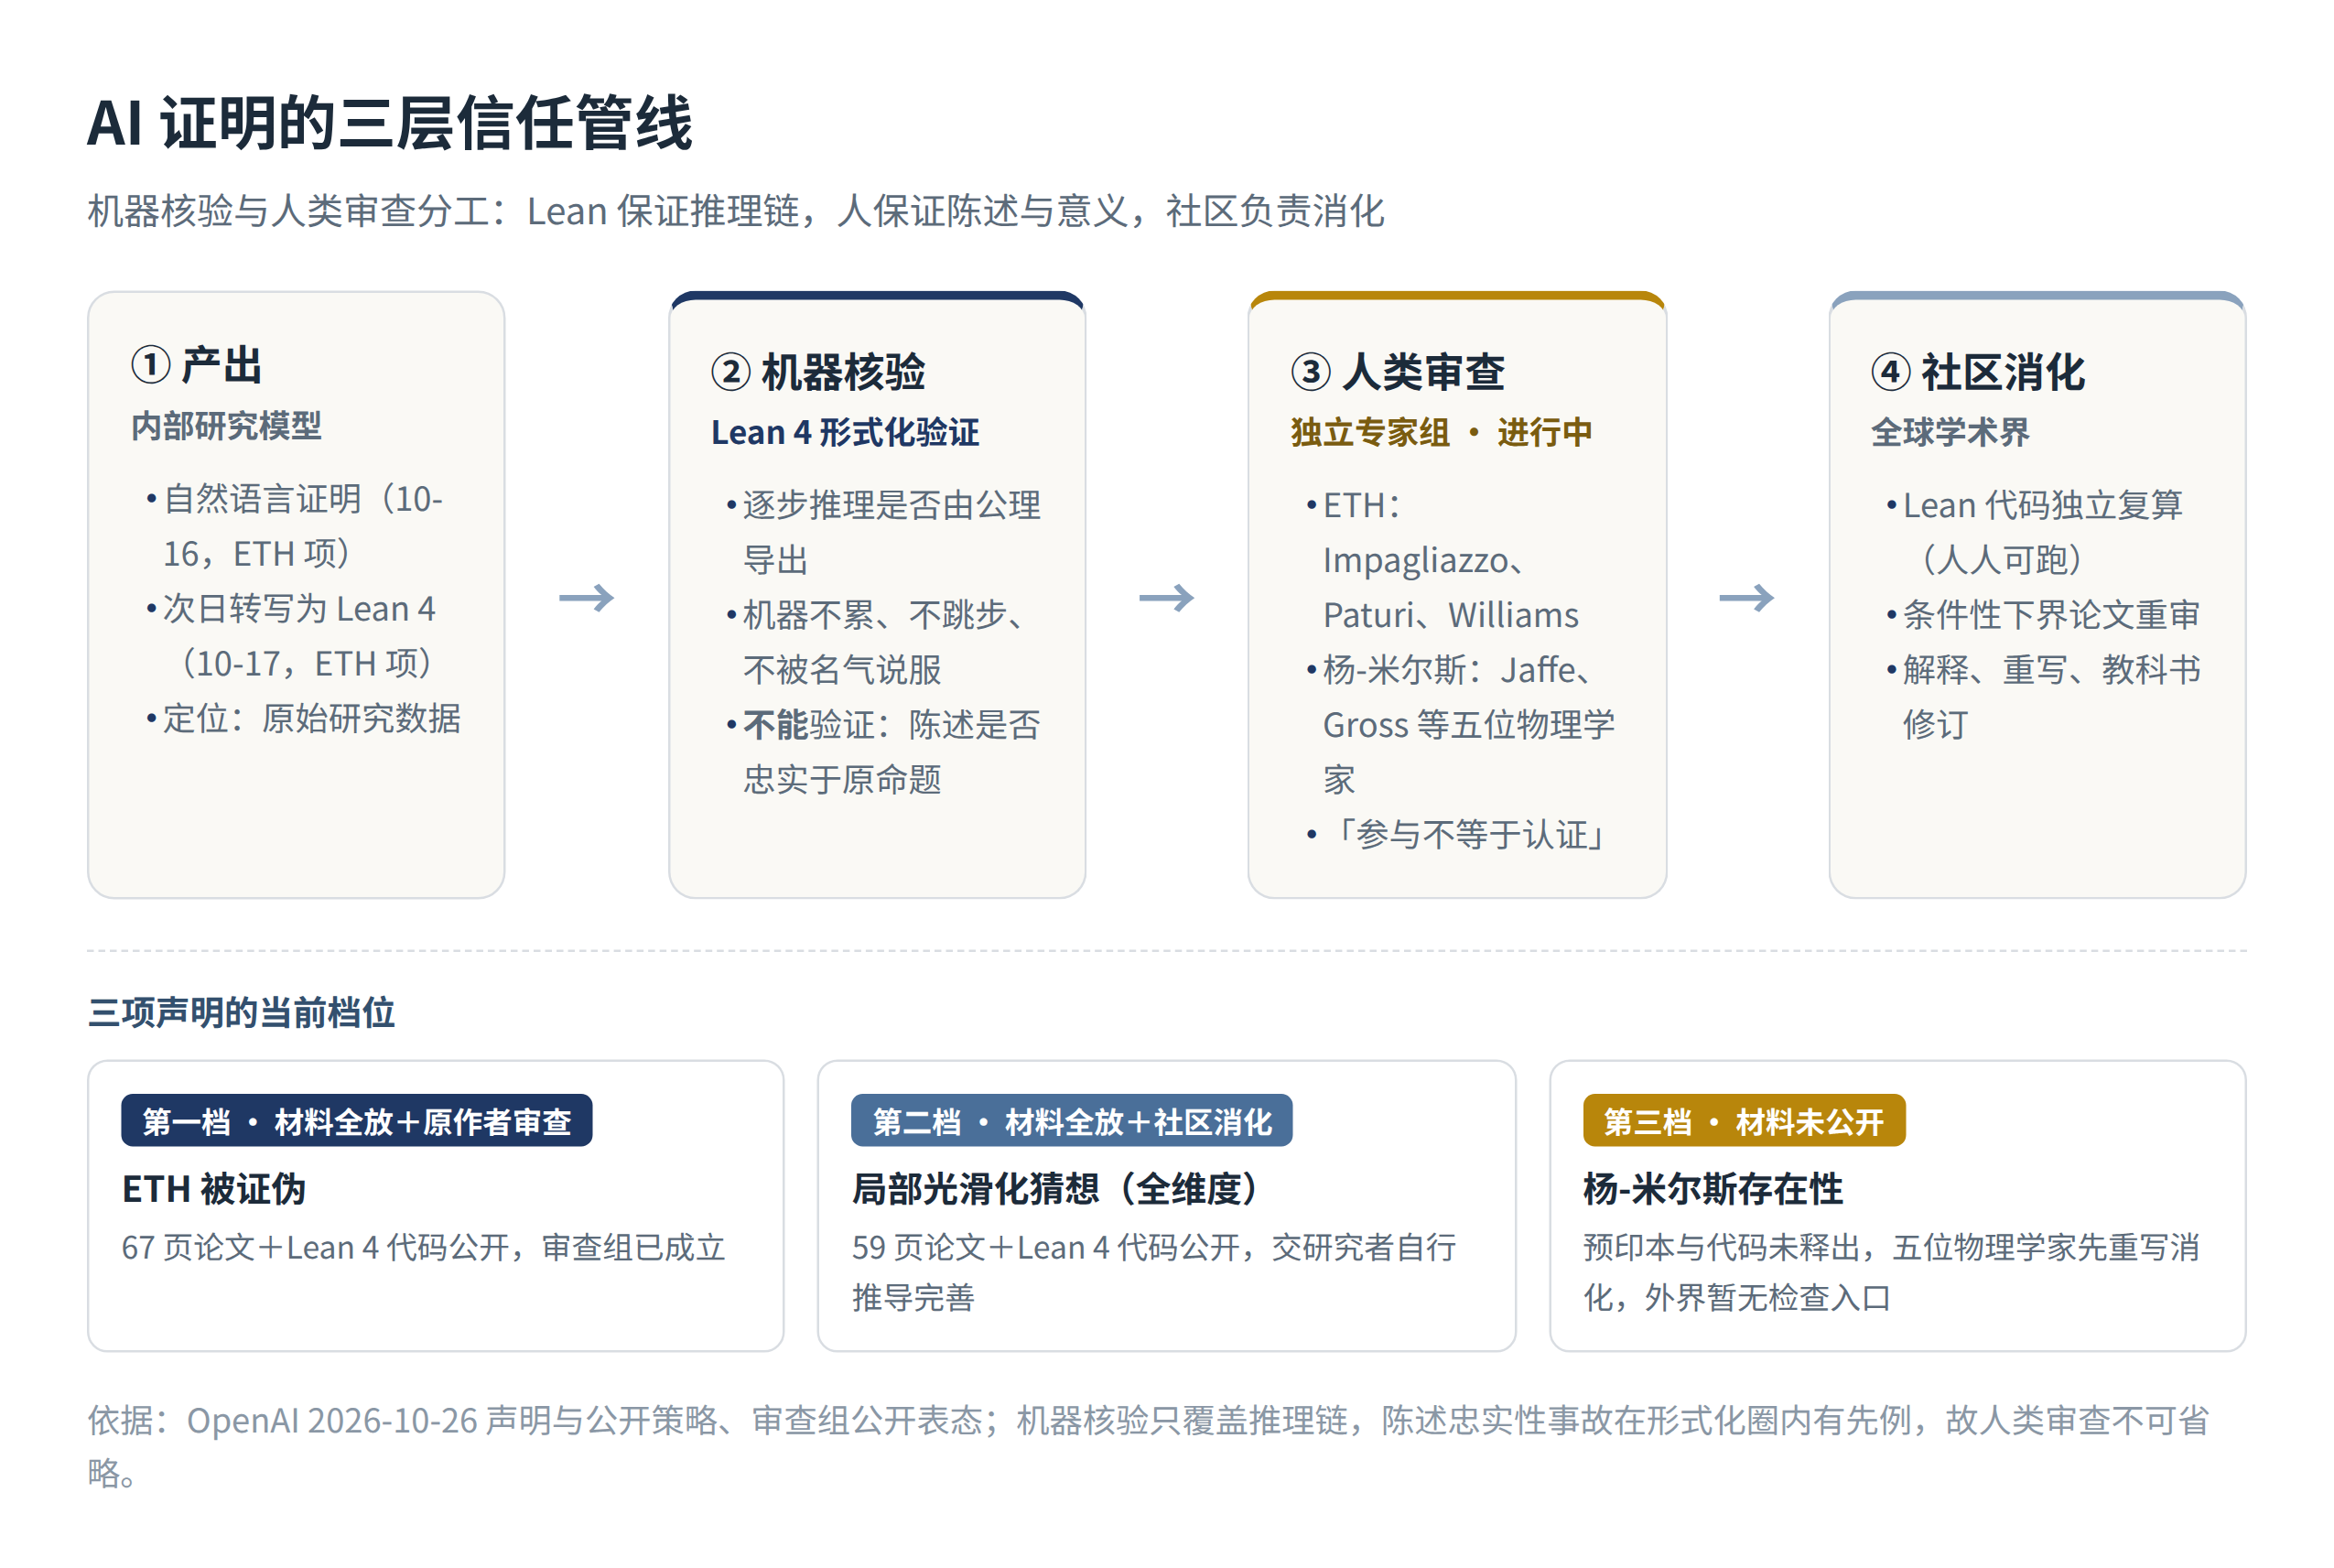
这也解释了 OpenAI 的「原始研究数据」定位为什么聪明。三周前(10 月 6 日)OpenAI 刚放出 722 篇 AI 数学手稿(372 个成果族、17 个方向),Nature 当时的标题是「AI 数学的验证危机」。这次的三发是吸取教训后的版本:不再把 AI 文稿当论文扔出去,而是分级处理——能形式化的形式化,能审查的组织审查,翻译成本太高的先让权威消化。发布流程本身成了研究成果的一部分。
顺带一个传播观察:中文面流传「Anthropic 的 Claude 同日独立找到类似 ETH 反证、两家结果独立且并发」的说法,截至本文写作只有单一中文信源,没有 Anthropic 官方声明或第二信源佐证。这条消息恰好是本次信息生态的样本:越符合「AI 竞赛」叙事的传闻,传播越快,核查成本越高。
五、业界反应与争议点
反应光谱两端拉得很开。诺奖得主 David Gross 说,对于不了解的人来说,ETH 被证伪「非常令人惊讶,影响太深远了」。清华大学理论计算机学者陈立杰公开感慨「指数时间假设是错的」。社交网络上有模型生成的感想称「如果成立,这是数学与理论计算机科学史上最大的单日」,也有数量可观的「把 AI 关回笼子」。陶哲轩此前转发过「人类数学协会」针对 722 手稿的声明,代表了数学共同体里对 AI 论文洪水的制度化警惕。
争议集中在四点。
科研模式的争议。「原始研究数据」意味着论文生产的分工彻底改变:AI 负责产出证明,人类数学家负责转译、解释、消化。支持者说这是数学家的杠杆放大,反对者问:如果理解速度跟不上产出速度,数学知识还是不是人类的知识?一篇没人看得懂的证明,在认识论上处于什么位置?
**条件性结果的连锁重审。**数百篇「假设 ETH 成立」的下界论文面临前提重估。这是教科书修订级别的工作量,也可能会催生一批「在新假设下重建下界」的论文——对理论 CS 社区既是损失也是题材。
**媒体叙事的两极。**媒体端从「AI 一夜攻克三大世纪悬案」式的欢呼到「还需独立验证」的提醒,与审查组「参与不等于认证」的克制形成鲜明对照。冷读的关键在于:目前的一切都还是「OpenAI 声明+机器验证通过」的状态,独立的人类审查刚刚开始,历史上形式化验证通过后被发现陈述有误的案例真实存在过。
**理论与工程的鸿沟。**亚指数算法对 n=1000 的实例没有工程意义,短期内不会改变任何实际系统的运行速度。ETH 被证伪改变的是「什么是可能」的理论地图,不是「什么可行」的工程现实。把这两件事混为一谈,是此类新闻最常见的放大器。
六、怎么读这件事
三个判断。
第一,可信度的分级比结论本身更重要。三项声明用了三档公开策略,这是 AI 科学产出第一次被制度性地当作「分级信任对象」处理。无论三项证明最终命运如何,「AI 证明+Lean 核验+人类审查陈述」这个三层结构,很可能成为之后 AI 科研产出的标准管线。
第二,验证的不对称性是这次真正的新闻。AI 写的营销文案无法机器核验,AI 写的证明可以。凡是能被形式化的领域——数学、理论计算机科学、部分理论物理——都将最早感受到 AI 产出能力的冲击,因为机器核验把验证的信任成本大幅拉低;无法形式化的领域则仍要依赖传统的同行评议。学科之间的 AI 受益顺序,正在被「可验证性」重新排序。
第三,现在下「AI 领先人类理解宇宙」的结论为时过早。ETH 审查尚未结束,杨-米尔斯手稿尚未公开,局部光滑化证明还等着社区消化。真正让人记住的可能是这个画面:1999 年提出假设的人,在 2026 年组织审查推翻它的 AI 证明——科学共同体的自愈机制,正在被这场冲击激活,而不是失效。
接下来值得盯四件事:审查组对 ETH 证明的公开结论;Lean 代码的独立复算结果(任何人都能跑);杨-米尔斯手稿是否会释出;以及那批条件性下界论文的重审动向。在独立审查落锤之前,本文所有关于「ETH 已被证伪」的表述,都应读作「OpenAI 声明并机器验证通过,人类审查进行中」。
资料来源
- OpenAI 2026-10-26 公开声明及 GitHub 仓库(ETH 论文 67 页、局部光滑化论文 59 页、Lean 4 代码)
- 机器之心《OpenAI 掀翻计算机科学 30 年基石,还解决了挂谷猜想》(2026-10-27)
- 新智元《「王的猜想」全维度告破,30 年铁律 ETH 塌了》(2026-10-27)
- 51CTO《OpenAI 宣布一口气解决数学物理计算机三大世纪科学悬案》(2026-10-27)
- 网易(审查安排细节;其中 Anthropic 同日复现说法为单一信源,未采信为事实)
- 知乎问答:四维杨-米尔斯存在性题面拆解、局部光滑化发布流程讨论(2026-10-27)
- Techmeme 2026-10-27 首页聚合(英文媒体反应谱)
- 王虹、Joshua Zahl 三维挂谷猜想证明(2025-02,arXiv)
本文为研究性分析,三项声明的最终有效性以独立学术审查结论为准。