
模型开源时交出的权重里,藏着训练开始前一瞬的记录:GPU 给几十亿参数填初始值,随机数落进文件的方式随芯片代次而不同,其中一小部分还会原样留到发布。一份个人研究据此读出,四家中国实验室今年的六个模型初始化于受出口管制的 Blackwell——作者还租了一台 GB200 当场复现。但指纹能证明的到此为止:芯片在哪、归谁、是否违规,权重一概不知。方法怎么工作、证据有多硬、边界在哪里,是本文要讲的事。
把随机数种子设为 953049583,在一块 B300 上运行没有改动过的 PyTorch——DeepSeek-V4-Flash 里精选的 469 行权重中,461 行被重新生成,相关系数全部超过 0.99,其中 445 行与发布版逐位一致。
这不是重训模型,只是重复了训练开始前的一个动作:给参数赋初始值。那些经历了漫长训练、最终打包发布的权重里,有一部分还保留着最初的样子。
2026 年 11 月 12 日,Will DePue 在个人站点 Unemployment Labs 发布研究:DeepSeek、月之暗面、MiniMax 和蚂蚁集团自今年 4 月起陆续发布的六个模型,包含与 NVIDIA Blackwell 初始化相符的数值指纹;同系列的较早版本,留下的多是 Hopper 的痕迹。这个主张很容易被压缩成一句轰动的标题,但报告的证据比标题精细得多——它追溯的是初始权重如何生成,由此支持对初始化硬件的判断;至于随后整场训练用了什么设备、芯片在哪里、归谁所有、是否违规,需要另外的证据。
这份报告以个人研究名义发布,没有经过同行评审,全文也没有包含任何被点名实验室的回应;下文的模型读数和复现实验均来自作者披露。11 月 13 日,报告链接了公开验证仓库,提供部分保留权重、重建脚本和真机检查程序——检查脚本在一台笔记本上几秒就能跑完,另一个脚本用未修改的 PyTorch 在 GPU 上复现;完整的搜索过程和统计处理仍在仓库之外,需要分别检验。作者的背景只说可核的部分:DePue 自述曾在 OpenAI 参与 Sora 1&2 开发与 o3/4o 后训练,他的 X 和 LinkedIn 简介都写着「前 OpenAI」。本文不猜动机,所有结论按单方研究转述。
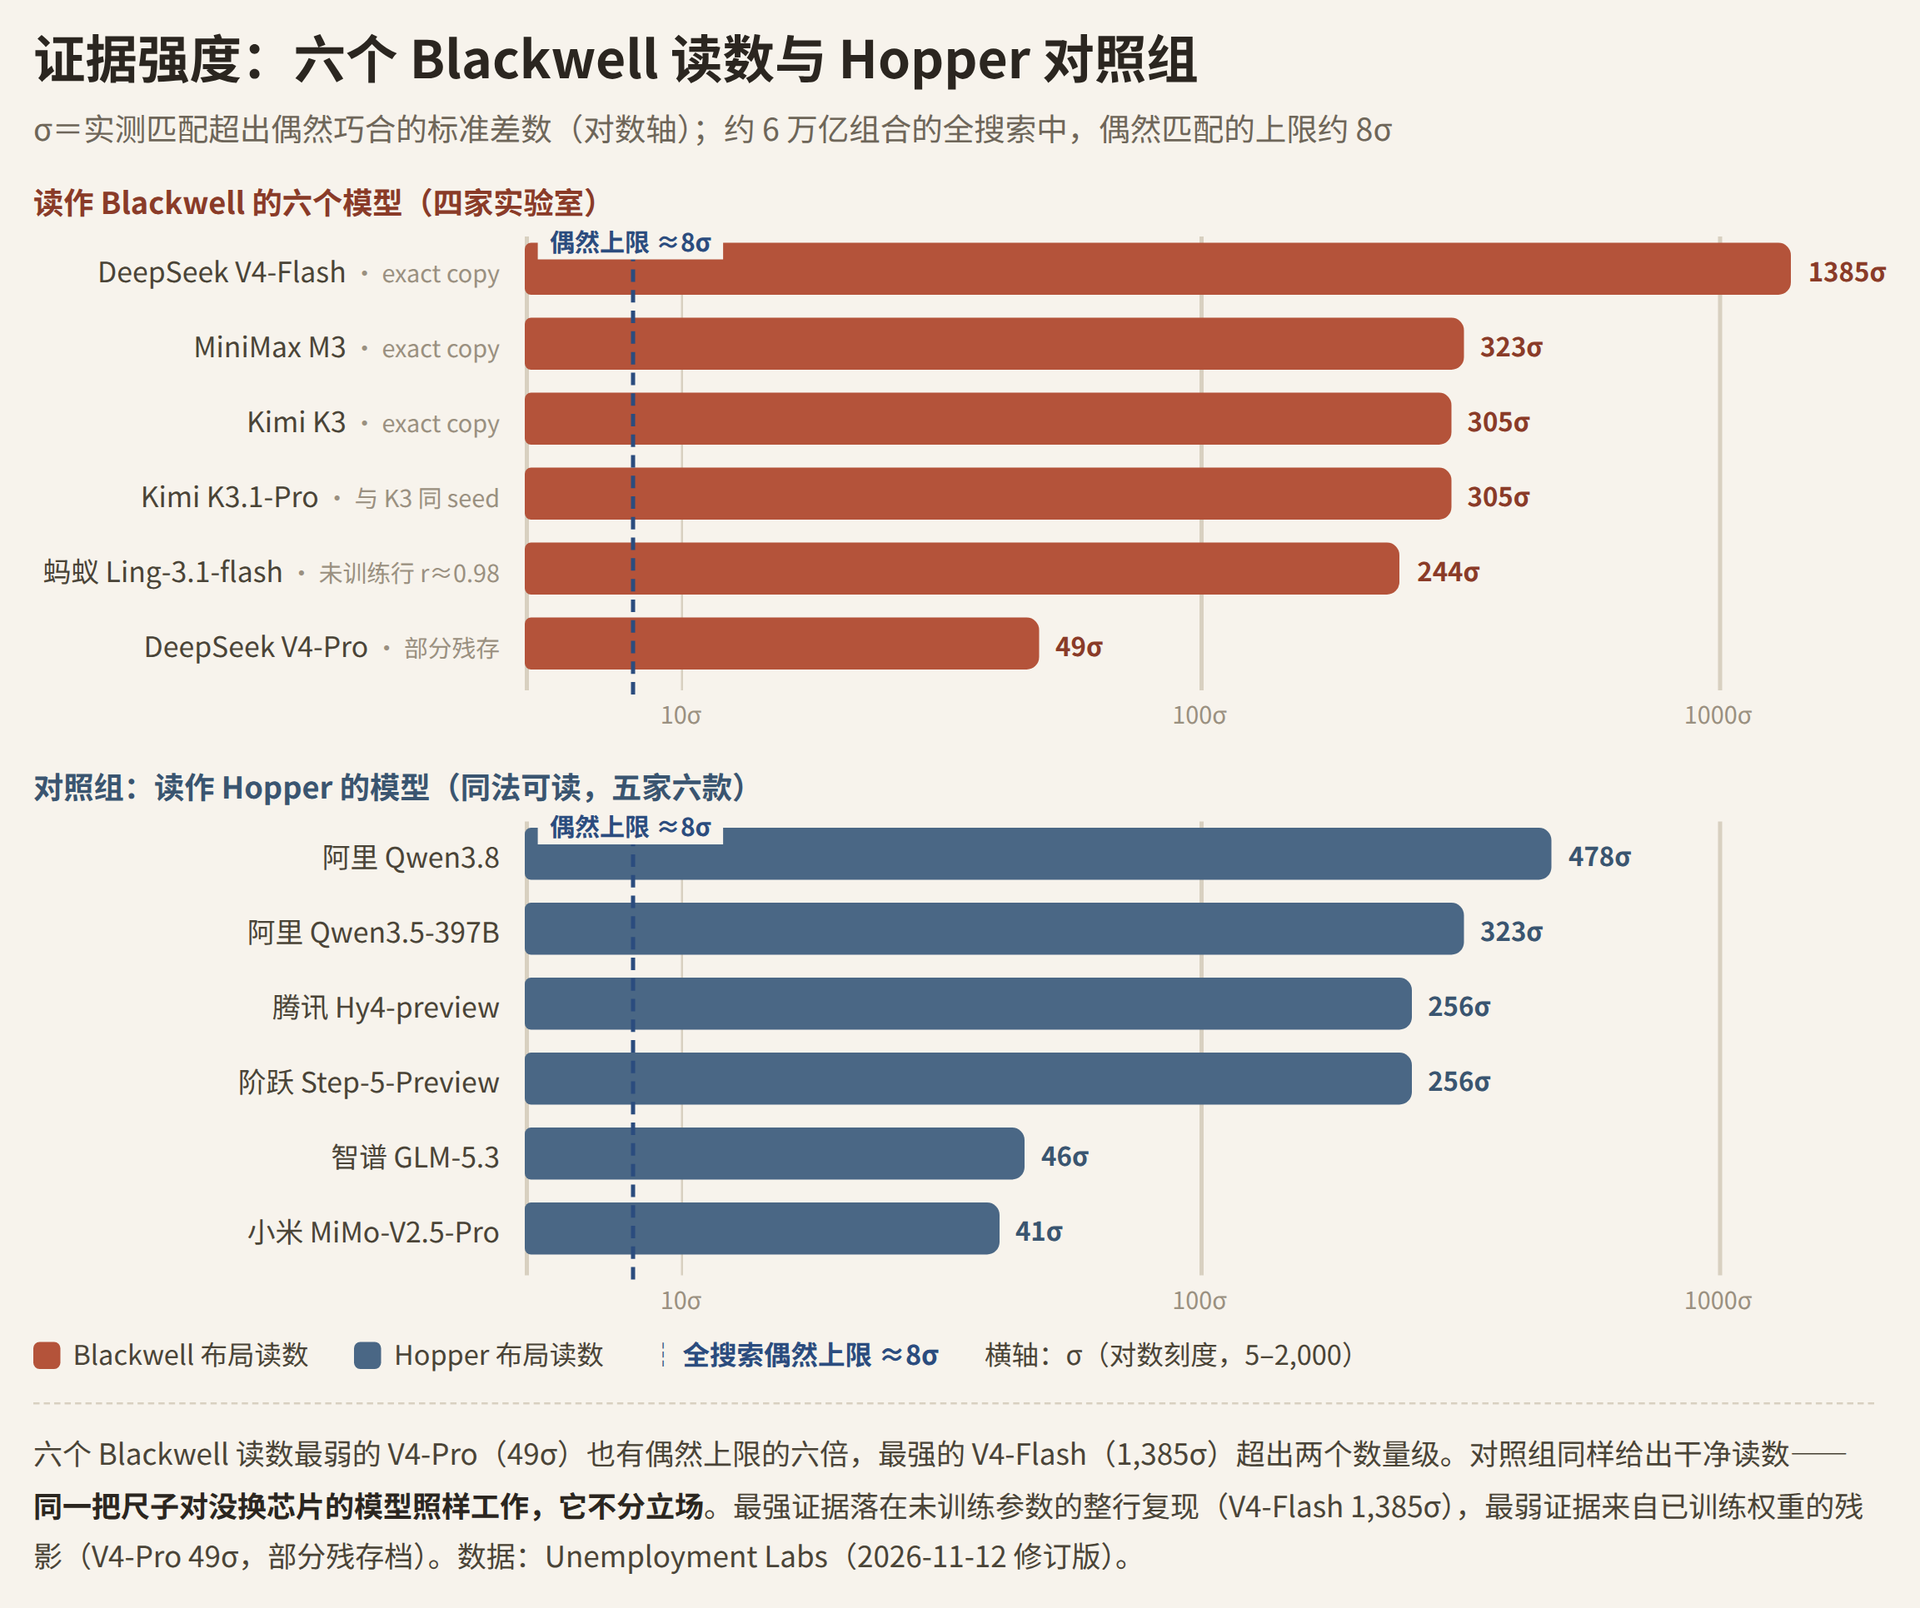
报告用 sigma(标准差)衡量证据强度,数值越高,观测结果偏离偶然匹配越远。六个模型各自最强的读数在 49σ 到 1,385σ 之间——这个数字怎么定的、有多硬,第三节讲。
一、随机数也有排班表
理解这套方法,要回到模型还没有学会任何东西的时候。
训练开始前,参数要先被赋予初始值。在报告考察的实现中,这些值来自 Philox 伪随机数算法:数字看起来杂乱,却可以在算法、随机数状态和执行条件固定时重新生成。随机种子 seed,是这套过程的起点。
不过,要复现一份权重,仅仅生成同样的数字还不够,还要把它们放回同样的位置。
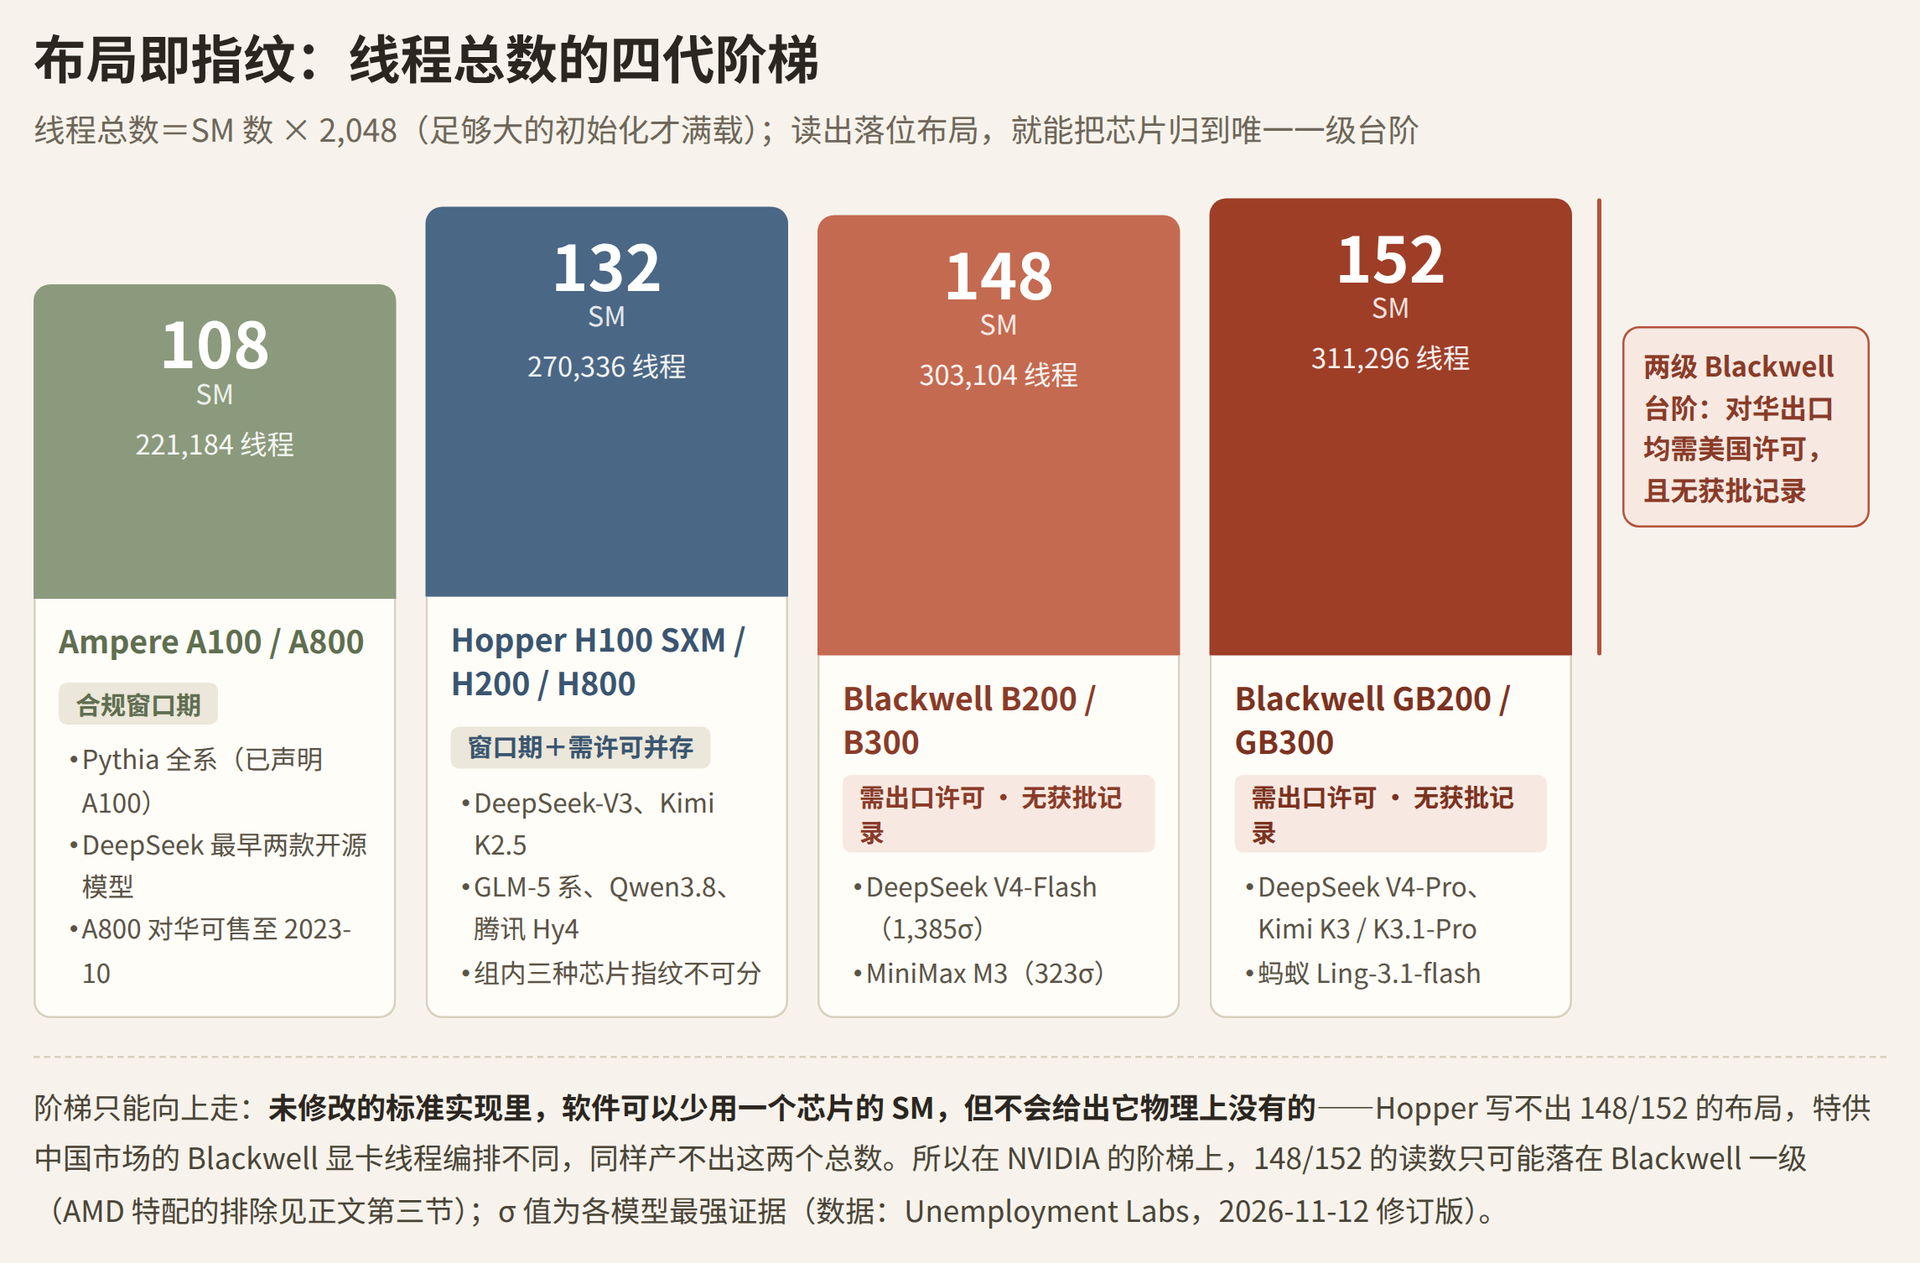
为了尽快填满庞大的参数张量,PyTorch 把工作分给 GPU 上的大量线程,每条线程负责一串随机数,也负责一组写入位置。框架根据 GPU 的 SM 数量等属性选择线程网格(SM 是流式多处理器,GPU 内部的一组计算单元);网格一变,同一条随机数序列在权重中的落点也随之改变。在报告检验的初始化路径下,当张量足够大时,线程总数达到 SM 数×2,048。于是几种硬件配置形成了不同的排列:
| 报告对应的硬件配置 | SM 数 | 初始化线程网格 |
|---|---|---|
| Ampere A100 / A800 | 108 | 221,184 |
| Hopper H100 SXM / H200 / H800 | 132 | 270,336 |
| Blackwell B200 / B300 | 148 | 303,104 |
| Blackwell GB200 / GB300 | 152 | 311,296 |
148 和 152 对应两类 Blackwell 配置,不能据此进一步区分 B200 与 B300、或 GB200 与 GB300;表中的线程数也特指这条初始化路径选择的执行网格。
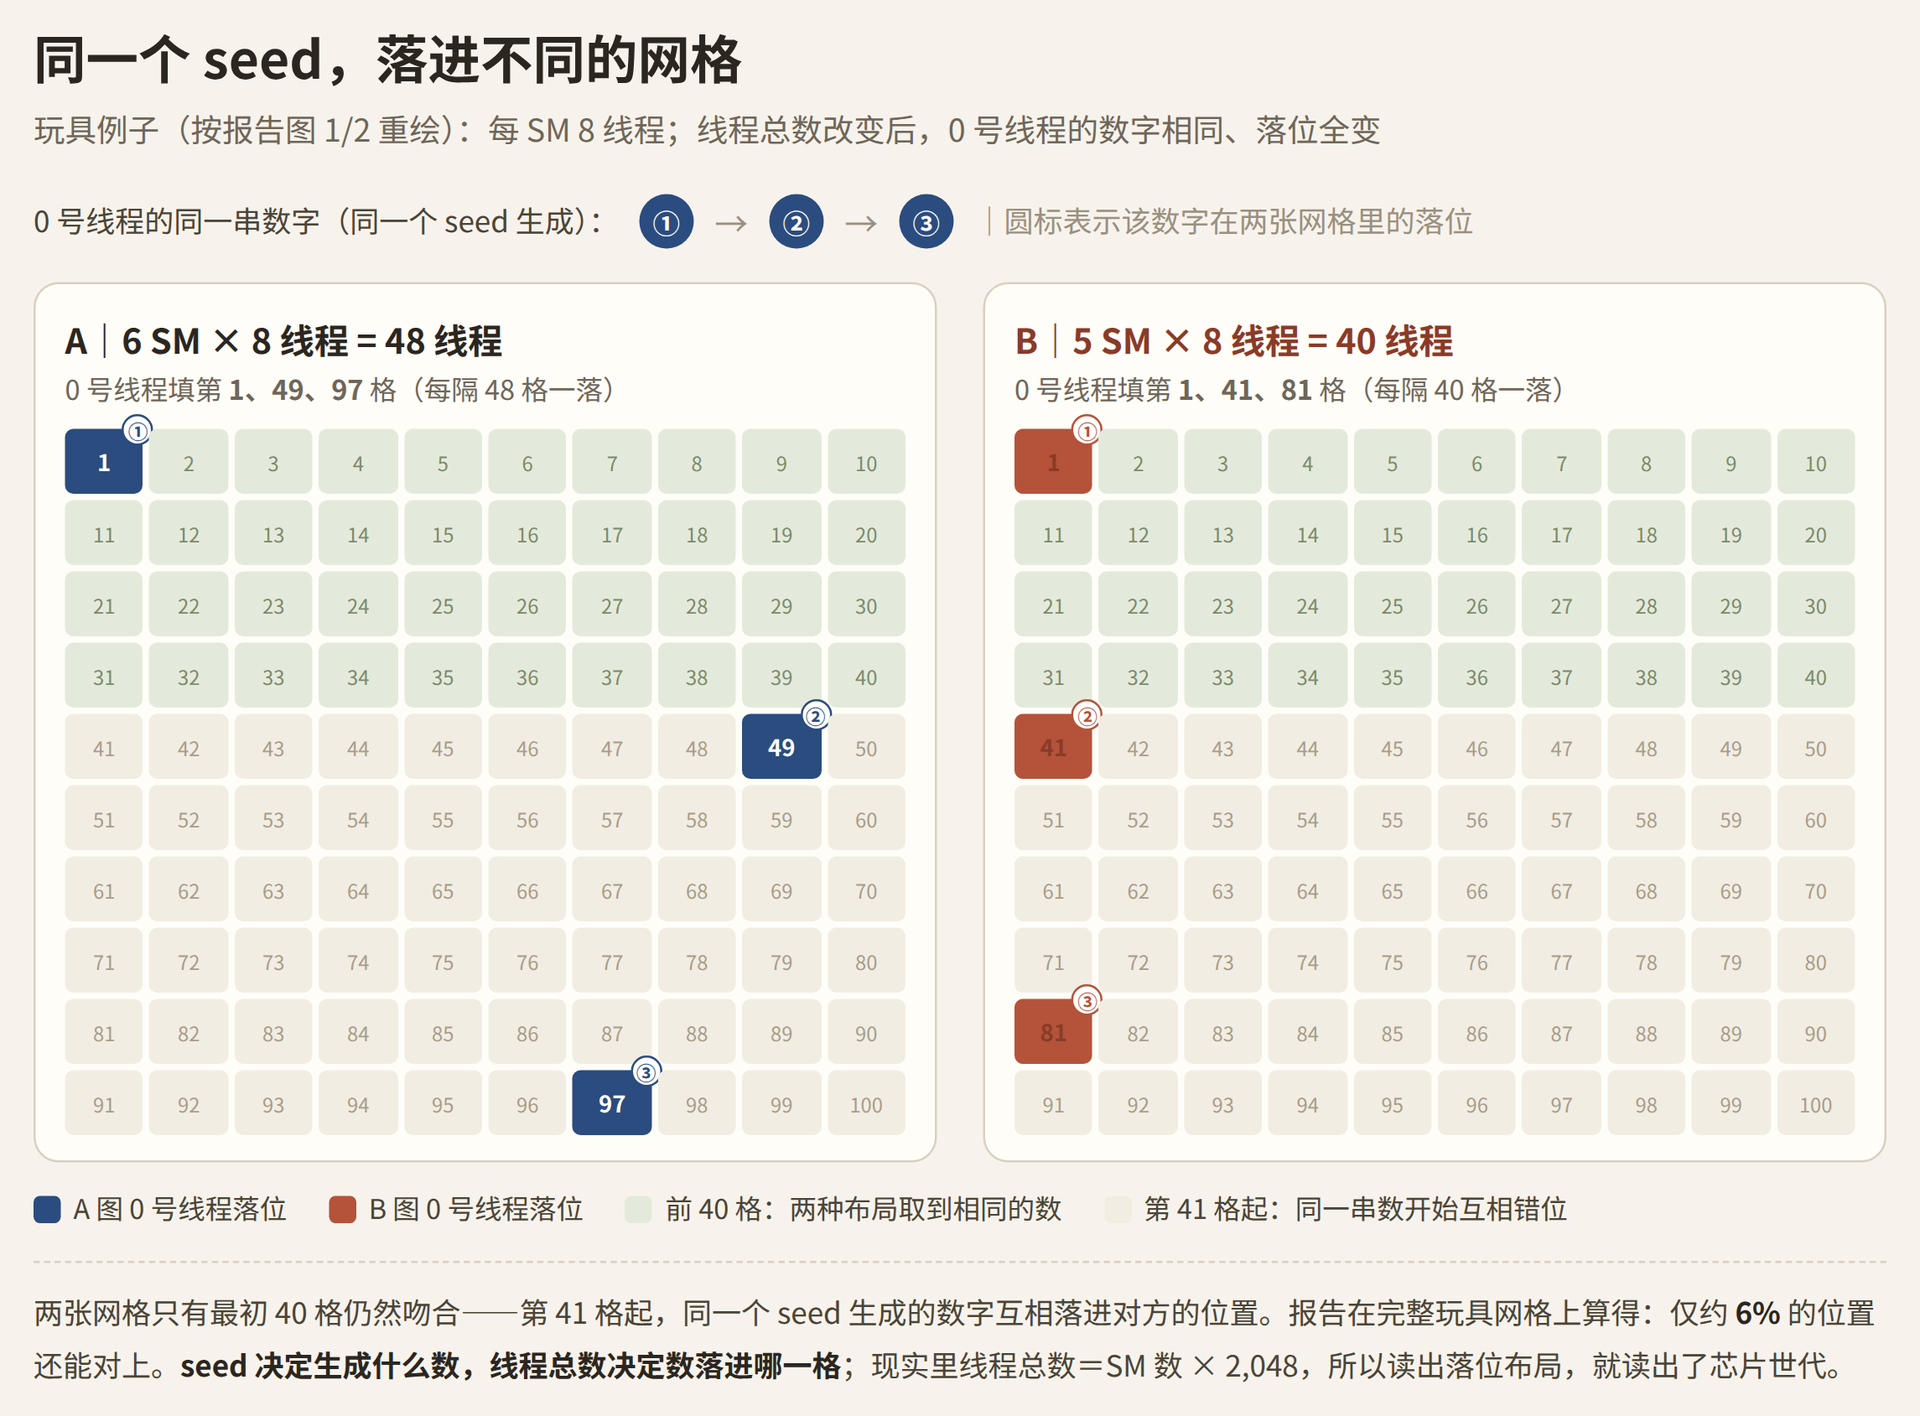
把规模缩小,事情就直观了。假设一块玩具 GPU 有 6 个 SM、每 SM 8 线程,共 48 条,所有线程轮流向一排格子填数:0 号线程负责第 1、49、97 格,每隔 48 格写一次。换成 5 个 SM 的玩具 GPU(40 条线程),保持相同的随机数条件,0 号线程仍然生成那串数字,但它们落在第 1、41、81 格。数字相同,位置变了。在报告展示的玩具矩阵中,两种排列只有约 6% 的位置还能对上。
在这个简化模型里,seed 决定每条线程生成什么数,线程网格决定这些数写到哪里。搜索时两个条件必须同时成立:种子正确、布局错误,会把正确的数字放错位置;布局正确、种子错误,会生成另一批数字。
真正令人意外的,是这种排列能活到训练结束以后。
报告找到的第一类痕迹,来自仍保留初始化结构的参数,其中包括一些没有经历有效更新的嵌入行——绑定罕见 token 的权重,整个训练从未动过,初始值原样保留,可以与候选种子和布局重新生成的数值直接比对(报告口径 exact copy,相关系数 r>0.999;经过裁剪或取整的模型降到 r≈0.98)。部分样本在真机检查时逐位一致。「高度相关」和「逐位一致」是两回事:前者说明两组数值的变化关系接近,后者要求存储下来的数值表示完全相同,是更具体的复现结果。
另一类痕迹藏在已被训练改动的参数里。最终权重等于初始值加上训练期间的全部调整;只要调整没有完全淹没最初的差异,研究者仍可能从大量参数中检出微弱的关联。报告在 V4-Flash 全部 42 层做了这样的分析,平均每层约 74.5 万个权重:Blackwell 布局下,初始值较大的参数最终值仍略微偏大(r=0.066,57σ);换 Hopper 布局,这个关系消失。相关性很弱,但样本量让它能被检出。作者同时自注:这是在这批权重里观察到的现象,「不是保证每次训练都能存活的性质」。
二、六个模型,两个 Blackwell 布局
沿着这条线索,报告在四家实验室的六个模型中读到了两类与 Blackwell 相符的布局。
| 实验室 | 模型(发布时间) | 读出布局 | 证据强度 |
|---|---|---|---|
| DeepSeek | V4-Flash(2026-04) | 148 SM:B200/B300 | 1,385σ,exact copy |
| DeepSeek | V4-Pro(2026-04) | 152 SM:GB200/GB300 | 49σ,部分残存 |
| 月之暗面 | Kimi K3(2026-07) | 152 SM:GB200/GB300 | 305σ,exact copy |
| 月之暗面 | K3.1-Pro(2026-11) | 152 SM:GB200/GB300 | 与 K3 同 seed,305σ |
| MiniMax | M3(2026-06) | 148 SM:B200/B300 | 323σ,exact copy |
| 蚂蚁集团 | Ling-3.1-flash(2026-10) | 152 SM:GB200/GB300 | 244σ,未训练行 r≈0.98 |
表中的 σ 是作者在特定统计模型下计算的标准化匹配分数,衡量观测结果偏离随机基线的程度,不能直接当作「归因正确的概率」。而报告对这些读数的措辞很克制:指纹「支持(support),但本身不能证明(do not by themselves prove)」训练全程发生在 Blackwell 上。
把同系列模型排在一起,会出现一条颇有意味的时间线。DeepSeek 从 V4 起出现 Blackwell 布局,MiniMax 从 M3 起,月之暗面从 K3 起,蚂蚁在 Ling-3.1-flash 上变化;对应的较早版本——V3、M2.7、K2.5、Ling-3.0——读出的都是 Hopper,DeepSeek 更早的部分模型还留着 Ampere(108 SM)的痕迹。注意这些时间点来自权重的发布日期:它们标记的是公开模型中何时出现新的初始化特征,定位不了实验室何时获得设备、何时开始使用。
同一份报告也给出 Hopper 对照:智谱 GLM-5.3、阿里 Qwen3.8 与 Qwen3.5-397B、腾讯 Hy4-preview、阶跃星辰 Step-5-Preview、小米 MiMo-V2.5-Pro,五家六款全部读作 132-SM 布局(41–478σ)。这个布局与 H100 SXM、H200、H800 都相容,方法本身分不出具体型号。同一套方法对没换芯片的实验室照样给读数,读不出的模型也如实写读不出。
K3.1-Pro 与 K3 共用 seed,作者据此推测前者可能是后者的检查点加后续后训练。不过共享 seed 本身还不足以重建继承关系——报告里 DeepSeek V3 与 V4-Flash 也共用同一个种子(953049583)。
三、让匹配经得起检验
从海量数字里找到一种排列,并不自动意味着发现了硬件指纹。搜索空间越大,偶然出现漂亮结果的机会就越多。
报告先做留出检验:用一组权重寻找种子和布局,选定组合后,再去预测另一组没有参与搜索的权重,并且不回头调参。匹配能延伸到事先没用过的数字上,证据就比「在搜索样本里找到高分」更有分量。
接下来为偶然匹配设定参照。整个搜索涉及约 6 万亿个 seed 与布局组合;在作者采用的正态分布模型下,单次 5σ 匹配的偶然概率约三百五十万分之一——放进单次实验很小,放进数万亿次尝试就不再稀奇。报告因此用约 8σ 作为全搜索偶然匹配的参考线,六个模型的读数全部越过它:49σ 到 1,385σ,最低的单项检验也有 20σ。这些数字有一个前提:统计模型正确描述了数据中的随机波动。更高的分数可以反驳该模型下的偶然匹配,不能自动排除另一种生成机制。
相比巨大的 σ 数字,真机复现更容易让人把握这条证据链的分量。作者把 DeepSeek 的种子 953049583 分别放到 H100 和 B300 上运行原版 PyTorch:H100 逐位重现了 V3 的全部 57,344 个保留值,却重现不了 V4-Flash;B300 方向相反,重现出 V4-Flash 精选 469 行中的 461 行(445 整行逐位一致,8 行被训练部分改动),却重现不了 V3。种子加一,两台机器都没有得到匹配行。作者还租了一台 GB200,用月之暗面的种子 20256586 重现了 Kimi K3 的全部 13 条保留行,种子加一,匹配同样消失。正反对照共同约束了结果:匹配依赖特定种子,也依赖特定布局。
报告还拿有公开硬件披露的模型做了一致性检查:24 个案例全部读对,包括使用 A100 的 Pythia 系列、使用 H100 的 Llama 3.1、技术报告列出 GB200 训练阶段的 Nemotron-3 Ultra。这组结果有价值,但不能直接换算成「准确率 100%」——其中 11 个是尚未开始训练的 step-zero 检查点,同系列模型也并非彼此独立。它验证的是方法与已知案例的一致性,不是对所有模型的准确率。
还有一个更棘手的替代解释:AMD。MI300X 常规配置 304 个计算单元,可以划分为两组 152,也可以配置为只用 148,其随机数实现能够产生相同的底层序列——作者在真机上确认,这种非常规配置确实能重现 148/152 布局。布局相同,因此还不足以单独确定供应商。区分要靠数值实现中的细微差异:V4-Flash 的保留权重里有 377 个值对应两条实现路径会产生不同结果的情形,其中 363 个匹配 NVIDIA、0 个匹配 AMD。在报告测试的路径之间,这为 V4-Flash 提供了更硬的供应商区分证据(conclusive 的范围仅指 NVIDIA 而非 AMD,不指「全程 Blackwell 训练」);同一检验无法为其余五个模型定论,作者认为 AMD 解释「非常不可能」——那要求把整个集群特意配置成 Blackwell 的单元数,何况蚂蚁的公开仓库 cuLA 里就有今年 3 月底在 GB300 上跑的基准结果。还有一层:MI300X 本身同样受对华出口管制,即使 AMD 分支成立,改变的只是「哪一家的受管制芯片」,不改变「受管制硬件」这个结论。
四、初始化之后,证据还能走多远
这套方法的辨识力,来自硬件属性与软件实现共同留下的痕迹。PyTorch 的 DistributionTemplates.h 根据设备属性选择线程网格,再按线程索引和网格步长生成、写入随机数——在报告检验的标准、未修改路径下,Hopper 配置不会自然产生那两种 Blackwell 布局。但从源码可以推知:软件可以改变网格选择和索引映射,CUDA 的线程块也能在有限数量的 SM 上分批调度。所以这种指纹不能写成物理上无法仿制的硬件签名,它的归因力建立在具体实现和常规初始化流程的前提上。
即使接受 Blackwell 初始化的判断,模型随后的训练史也没有被完整揭示。权重可以在 A 系统上生成、搬到 B 系统训练;已有检查点也可以在另一类设备上继续训练。如果 NVIDIA 设备负责初始化、昇腾后来参与计算,留下的初始化痕迹未必能揭示后者的参与;反过来,检出 Hopper 指纹,也不能排除模型后来在 Blackwell 上继续训练。Kimi K3 的证据是「至少 64 个分别设置种子的进程留下相同的 152-SM 布局」——它加强的是初始化布局的一致性,不能换算成 64 块 GPU,更读不出完整训练集群的规模。
位置和渠道是另一层问题。权重里的一串数字没有机房地址,也没有采购合同。报告原话:「权重无法揭示芯片归谁所有、位于何处」「仅凭它,不能确立芯片被走私进中国、或发生过出口管制违规」。海外渠道确实存在:报告指出 Blackwell 可以从中国境外的数据中心租用;具体的先例是 Megaspeed——NVIDIA 官方 2025 年 10 月的声明说它在境外「运营着一个小型商业云——和世界各地的许多其他公司一样,这是美国出口管制规则所允许的」;同一时期新加坡警方已对其立案,据《纽约时报》当时报道,美国商务部也在调查。证据到这里落在中间态:接触受管制硬件有了技术证据;获取方式与位置不可知。可能的解释至少有三条——按现行规则在海外租用、走私入境、其他未明渠道——报告不选边,本文也不替现实收窄。
五、从权重到万卡,中间隔着多少假设
报告还尝试估算这些模型背后用了多少 Blackwell。第一道假设写在前面,报告原话是「assuming each model was trained on the hardware that initialized it」——假设每个模型的训练就发生在生成它初始权重的那批硬件上。接受这个前提后,算式并不复杂——所需 GPU 数量 ≈ 训练总计算量 ÷(单卡有效算力×训练时间)。总计算量按活跃参数量、训练 token 数和注意力开销估算,有效算力多数按峰值 20% 计(DeepSeek 按 25%,其上代自报 39%),时长按发布时间线推测;H100 等效按 NVIDIA 公布的峰值换算,B200/B300≈2.3 张、GB200/GB300≈2.5 张。
| 模型 | H100 等效 | Blackwell 估 | 区间 | 假定时长 |
|---|---|---|---|---|
| V4-Flash | 3,500 | 1,500 | 250–5,000 | 50 天 |
| V4-Pro | 7,500 | 3,000 | 750–6,500 | 70 天 |
| Kimi K3 | 11,500 | 4,500 | 1,000–9,500 | 70 天 |
| M3 | 3,500 | 1,500 | 200–7,000 | 60 天 |
| Ling-3.1-flash | 4,000 | 1,500 | 400–6,500 | 100 天 |
| 分项之和 | ~30,000 | ~12,000 | 7,000–22,000 | — |
这组假设下,规模最大的单次训练是 Kimi K3,中心估计约 4,500 颗。五次训练的配置估值相加约 12,000,含义要谨慎:同一批 GPU 可以跨时间、跨任务复用,没有训练起止和资源共享的信息,就不能把这个加总读成「四家合计拥有 12,000 颗 Blackwell」;7,000–22,000 是作者自给的聚合区间,不是分行上下限直接相加,其聚合方法也未在正文展开。这个算式对假设很敏感:时长减半,卡数翻倍;效率估高,卡数被低估;token 数估高,方向相反。而这些关键输入恰恰不是指纹能回答的——DeepSeek 的 token 数是实验室自报,其余三家来自作者尚未发表的方法,各次训练的实际效率和持续时间都没有直接确认。报告引用的两个公开案例也显示同代硬件的巨大差异:Mistral Large 4 用 3,800 颗 Grace Blackwell,微软 MAI-Base-2 用 16,000 颗、38 天。
金额换算又往前走了一步。报告引用《华尔街日报》一笔约 3.6 万颗 Blackwell、总价超 25 亿美元的交易口径,均摊约 7 万美元一颗,再把最大单次训练折算到 2–3 亿美元。注意均摊值可能包含整机、互联或其他系统成本,不能当作裸芯片报价,更推不出相关实验室实际支付了多少。
这些估算在报告发布当天就修订过一次:初版按 NVIDIA 基准效率给出最大训练 2,000–3,000 颗、1.5–2 亿美元,同日修订注自述已披露的 Blackwell 实跑效率低于基准,整体上调。报告对这一层的自评是逐字的:"We are not confident in these estimates."(我们对这些估算没有信心。)权重匹配可以很强,集群规模仍然可以很不确定——两者依赖不同的证据,不能借用彼此的确定性。
六、公开权重里的另一部历史
硬件归因之外,这份报告还展示了另一种可能:从权重里追溯模型自己的工程史。月之暗面 K2.7-Code 的 254 条保留行是稳定的 80/20 混合——约八成继承 K2.5 的 Hopper 布局值,约两成是匹配 148-SM 的新抽取,且每一行的混合比例都相同。作者据此判断这是「合并的检查点,而非混合硬件」。线索把问题从「初始值在哪里生成」延伸到了「一个模型如何继承、组合另一个模型」。
但权重也经常沉默。闭源模型无从入手;百度 ERNIE-5.5 用 PaddlePaddle 训练,能恢复 seed(2760)却读不出硬件;部分 Qwen 模型在 CPU 上初始化,没有 GPU 指纹;美团 LongCat-2.0 和 DeepSeek V4.1-Flash 都没有被这套搜索检出痕迹(LongCat 模型卡称「完全在 AI ASIC 超级节点上训练」,一处已删除的微调配置指向昇腾 910)。这些结果只说明方法没读到信号,不能证明某种芯片从未参与,也回答不了初始化方式为什么变化。
V4.1-Flash 值得单独看,把它放进一条时间线里更清楚:2025 年 6 月,DeepSeek 工程师在 GitHub 评论里写「我们没有 SM100 GPU」(SM100 即 Blackwell 架构);2026 年 4 月起,V4 系列的初始化指纹读作 Blackwell;而 DeepSeek 公开的 DeepInfer 明确支持 NVIDIA SM100 和昇腾 950,公开性能测试用的就是 SM100(这一点我们在《DeepInfer 深度解析》里写过,HN 讨论中 Gregory Maxwell 也指出这「算不上秘密」);DeepInfer 当前支持的模型,正是这份报告未能检出指纹的 V4.1-Flash。两件事可以同时成立——推理引擎支持什么硬件,与最终权重是否保留可识别的初始化结构,回答的是不同问题。
在我看来,这项工作的价值在于:把一部分原本依赖实验室披露的初始化历史,变成了可以直接拿权重检验的问题。它提出了明确的生成机制,也给出了留出检验、错误种子对照、跨硬件复现和替代实现检查,每一环都有具体对象,可以被别人重新检查。公开部分验证材料,与整条研究链已完成独立复现,仍有距离——下一步的进展将来自独立研究者:能否从原始权重跑出同样结果,哪些结论只在特定版本或设置下成立,还有没有未排除的替代解释。
围绕算力的讨论,由此多了一类可以动手检查的材料:模型自己的权重。那些几乎没有改变的初始数字,可能保存着一段工程历史。能读出多少,就解释到多少;其余的,留给后续的证据——以及三个值得盯的观察点:被点名实验室是否回应、质疑或起诉;PyTorch/cuRAND 上游会不会因此调整默认布局行为(DistributionTemplates.h),方法依赖的实现细节一旦变化,取证窗口就开始关闭;出口管制执法层(实体清单节奏、海外租用规则)会不会因此收紧——那是黄仁勋案与 Megaspeed 时间线所在的另一条线,本文不展开,只在这里提一句。
相关阅读:《DeepInfer 深度解析:DeepSeek 如何把模型、缓存与调度一起设计成 Token 工厂》|《出口管制的两道裂缝》|《2026.11 AI 算力需求趋势观察》
信源:Will DePue, "Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs"(Unemployment Labs,2026-11-12 发布,本文依据 11-13 查阅版本);公开验证仓库 github.com/macrogrants/checkpoint-forensics(2026-11-13);Hacker News 讨论串(item 50474883);CNBC 2025-10-10(NVIDIA 声明);NYT 2025-10-09(商务部调查,经 CNBC 转引);WSJ 2026-03(单价口径,经报告转引);PyTorch DistributionTemplates.h(github.com/pytorch/pytorch);各模型权重与技术报告见原报告 Sources 节。