
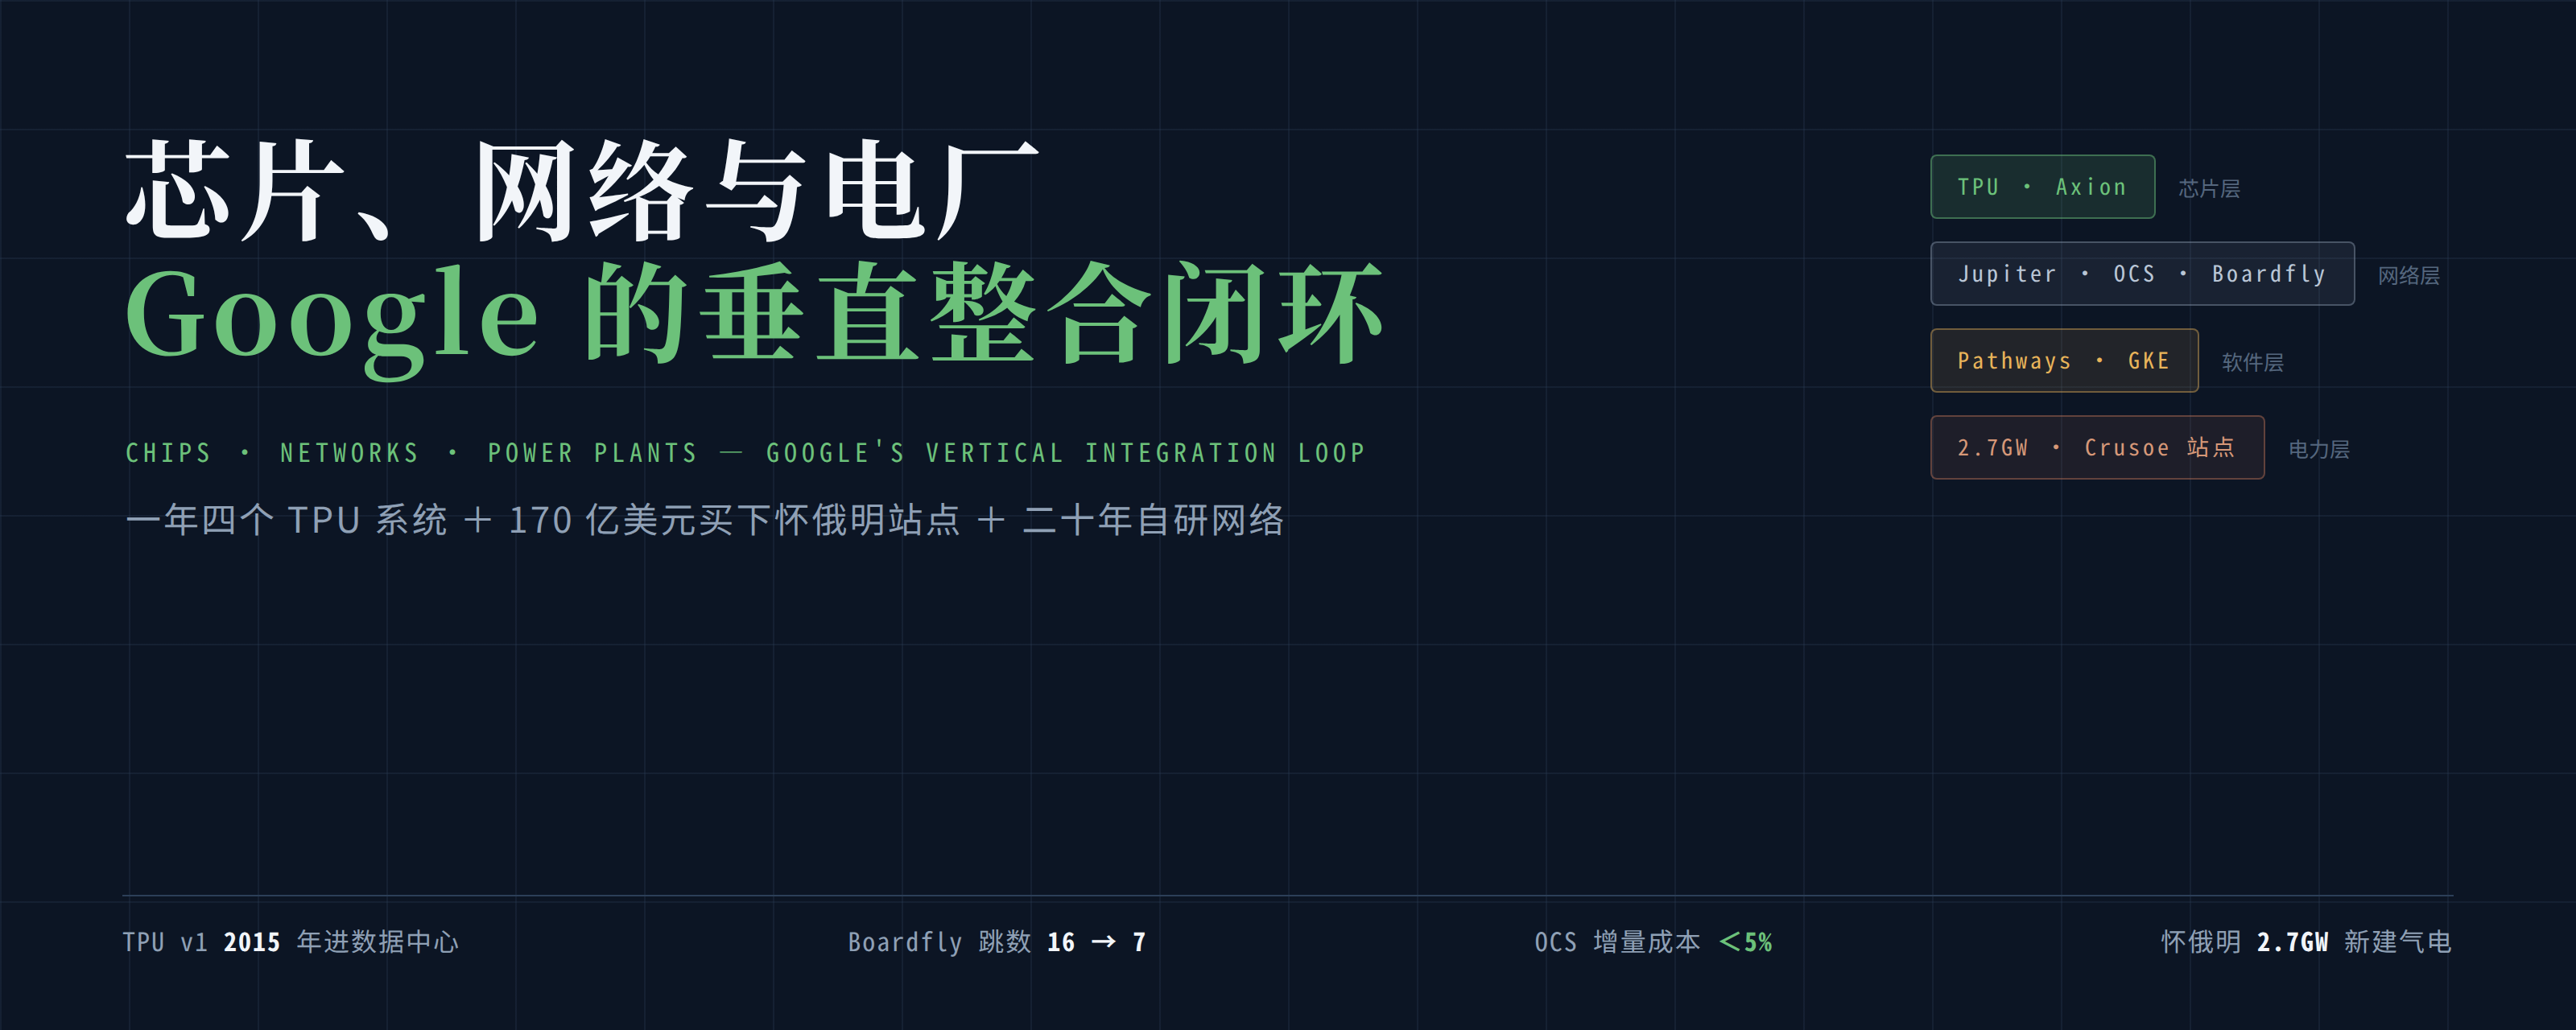
AI 算力的瓶颈正在从芯片转向电力。Google 一周之内发布了两个新 TPU 系统,又买下怀俄明的一座数据中心站点。一年推出的四个 TPU 系统背后只有两份硅设计;自研数据中心网络从 2005 年的 Firehose 起已经演化了二十年;Crusoe 交易又把电力和土地纳入自营范围。本文从芯片、网络、软件、电力四层拆解这条垂直整合路线,看它由什么构成,边界又在哪里。
多数公司还在为 GPU 供给和网络带宽发愁时,Google 在一周之内做了两件事:发布两个新的 TPU 系统,它们没有重新流片,是用现有芯片重新组合出来的;买下一座数据中心站点,把电力和土地收进了自营范围。再加上已经跑了二十年的自研数据中心网络,Google 的思路和「换一台更大的交换机」完全不同:它要把算力栈的主要层级都握在自己手里。
2026 年 11 月上旬,Google 接连走了三步。11 月 5 日,它宣布投资 170 亿美元在怀俄明建设首个数据中心。第二天,它从开发商 Crusoe 手中买下了整个站点。11 月 9 日,它发布了第八代 TPU 的第三、第四个系统:面向机密计算的 TPU 8tx,以及把两颗推理芯片封进同一封装的 TPU 8i Max。这距 4 月发布 8t 和 8i 只过去了七个月。三件事指向同一个问题:算力从哪里来。
本周我们分析过的网络墙研究(Turbalance 与 LBNL 的高基数交换机仿真)代表了一种答案:造一颗基数高出十倍的交换芯片,把多层网络压平成单跳。Google 给出的是另一种答案:芯片自己设计,网络自己演进了二十年,现在连电力和土地也开始自己持有。两条路线要解决的问题有重叠,做法却几乎没有交集。
下文逐层拆解:芯片层的组合方式、网络层的演进脉络、软件层的调度,以及电力层的交易结构。每一层都有公开规格和论文可以依据;Google 没有披露的部分,文中会明确标注。
一、芯片层:一年四个系统,不是四颗芯片
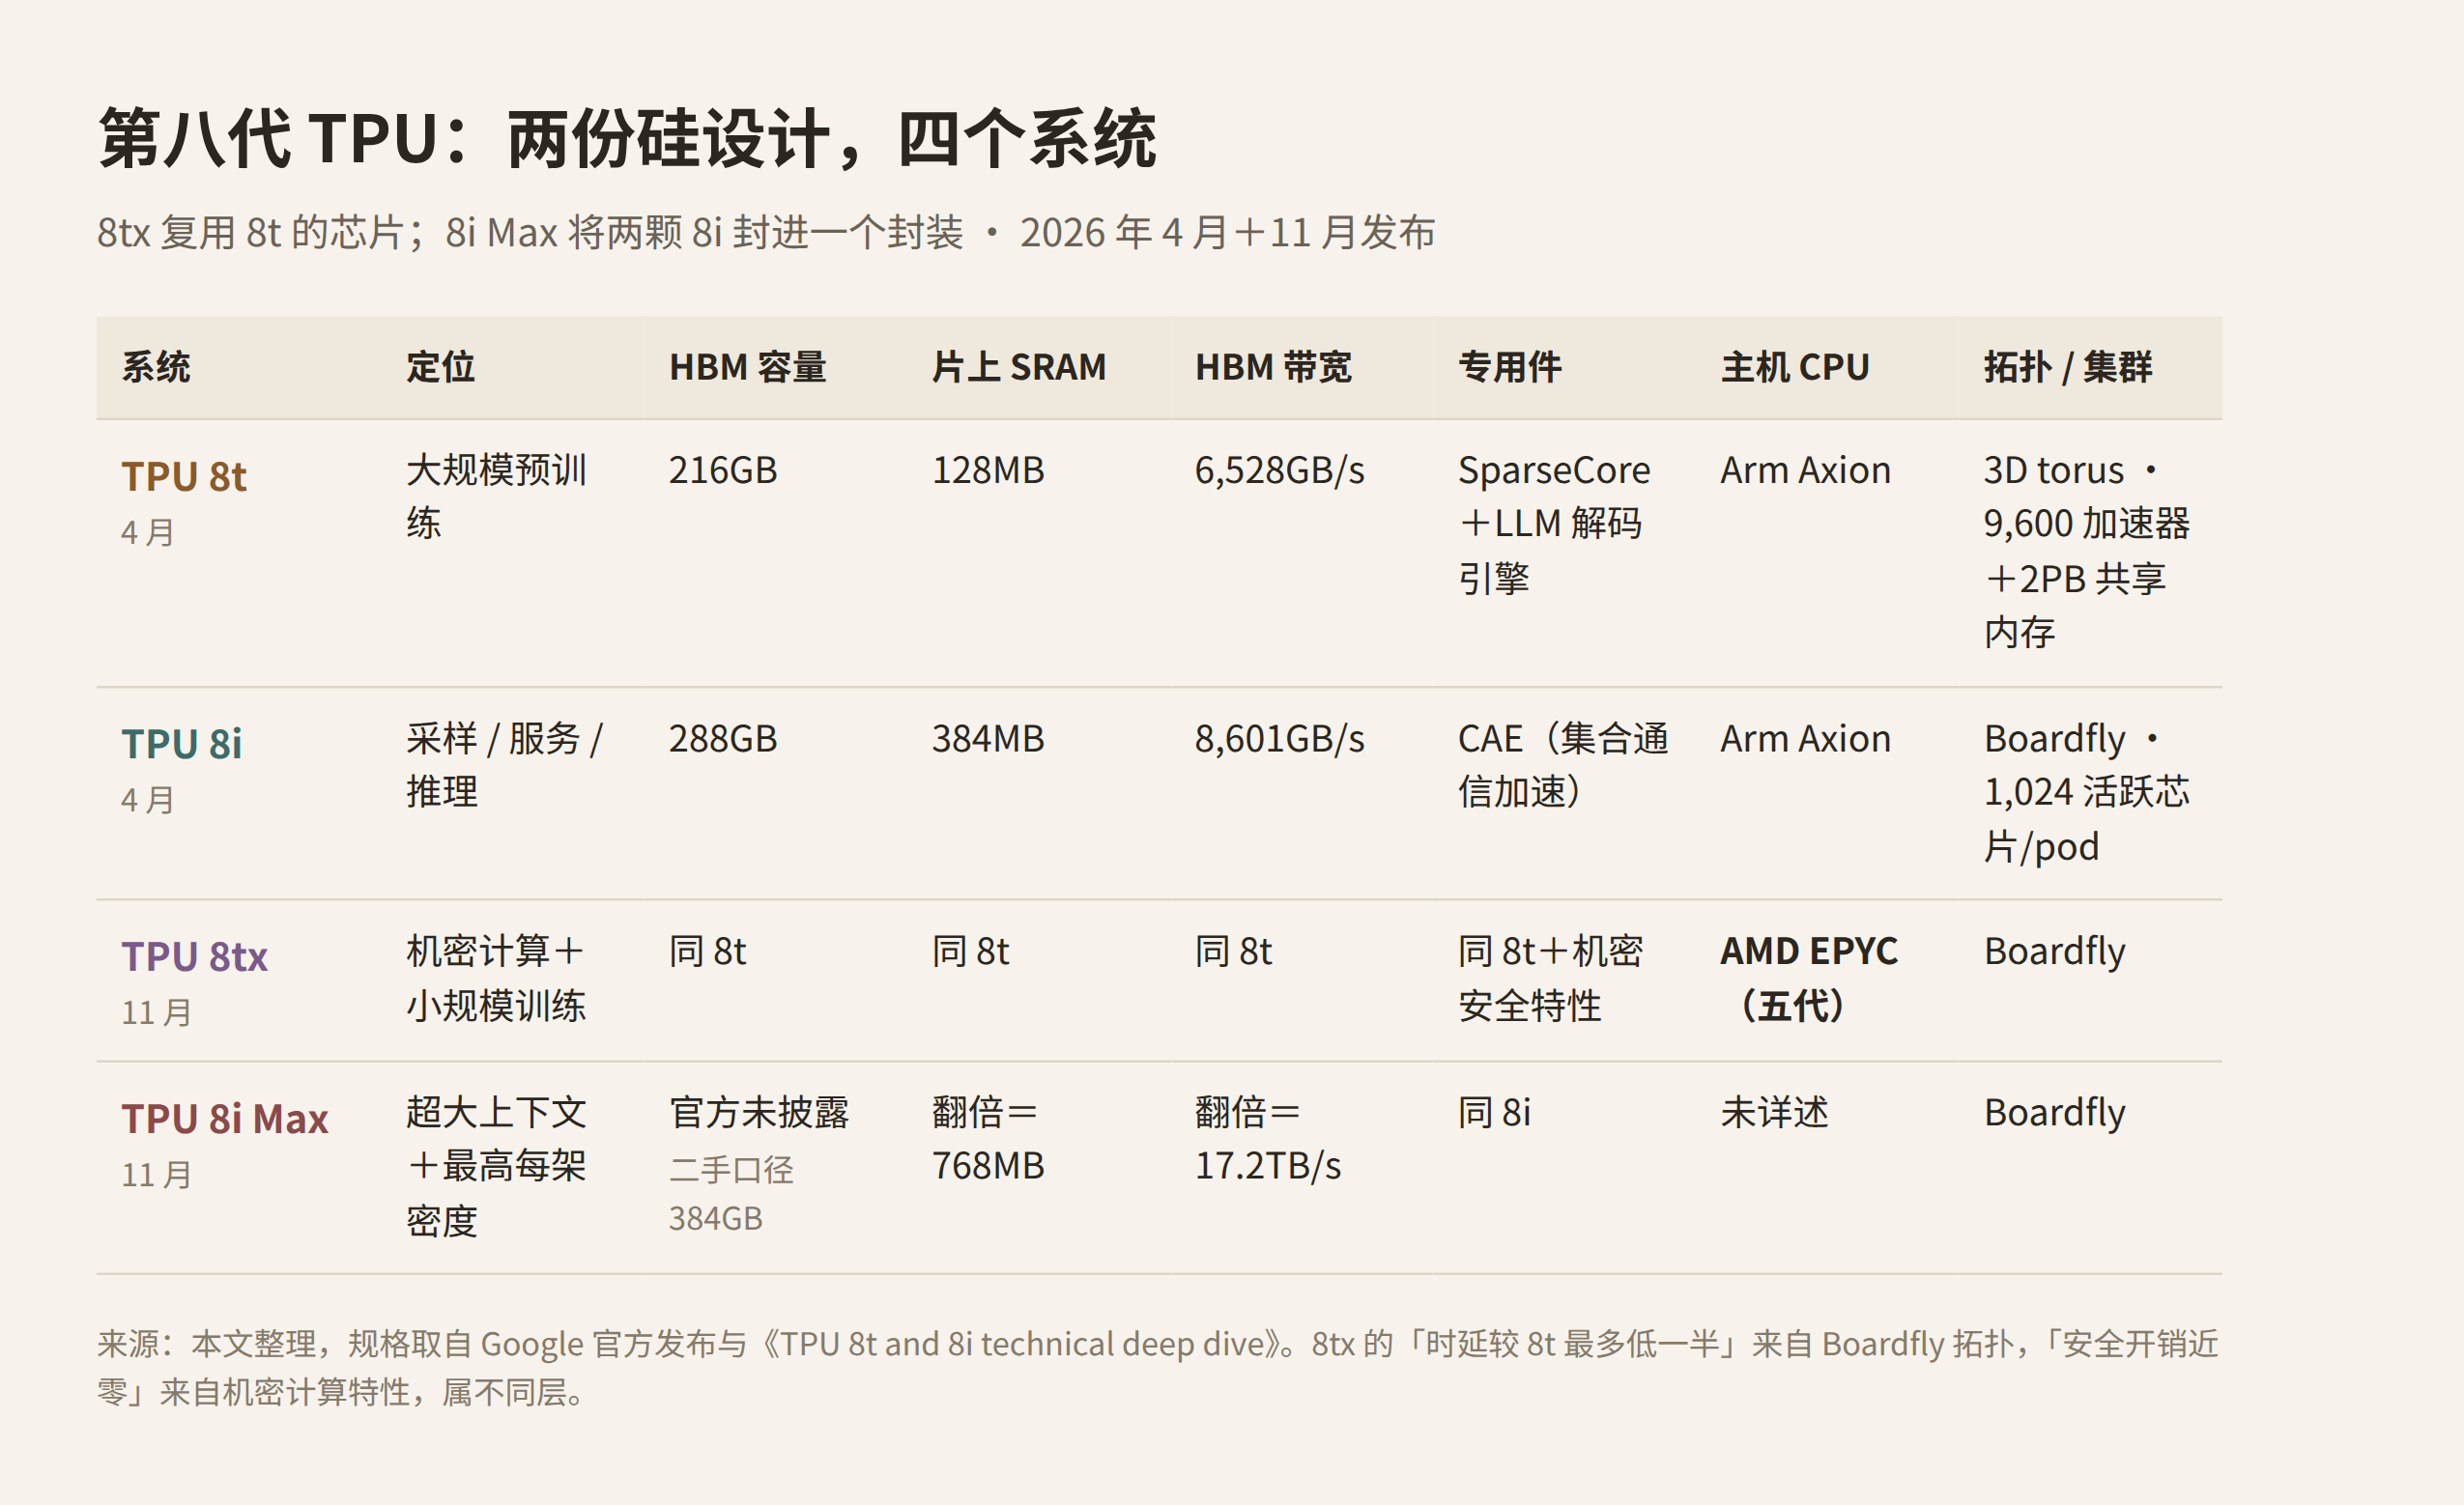
第八代 TPU 现在有四个系统,背后只有两份硅设计。
- TPU 8t(4 月发布)面向大规模预训练:216GB HBM,每颗芯片 128MB 片上 SRAM,内存带宽 6,528GB/s。单个 superpod 连接 9,600 颗加速器,共享 2PB 高带宽内存。
- TPU 8i(同月发布)面向推理:288GB HBM,384MB 片上 SRAM(是 8t 的三倍),带宽 8,601GB/s。一个 pod 最多有 1,024 颗活跃芯片,物理上安装了 1,152 颗,差额的用途官方没有说明。
11 月的两个新系统都建立在这两份设计上:8tx 复用 8t 的芯片,8i Max 把两颗 8i 封装在一起。
这种做法的价值在于响应快,而快的底气来自十年积累。
第一代 TPU 2015 年就进了数据中心。ISCA 2017 的论文把账摊得很清楚:65,536 个 8 位 MAC 组成脉动阵列,峰值吞吐 92 TOPS,片上有 28MiB 软件管理的内存。和同期的 CPU、GPU 相比,它的性能高 15 到 30 倍,能效比高 30 到 80 倍。这篇论文后来入选 ISCA 二十五年来最有影响力的论文之一。
第二代的经历则一波三折。TPU v2 的论文先被 ASPLOS 拒稿,加入 v3 内容后的修订版又被 ISCA 拒稿。评审意见是「没有新想法」,以及「它已经建成了,算不上研究」(据 Jouppi 在 ISCA 五十周年回顾中的自述)。论文最终发表在《美国计算机学会通讯》(CACM 2020)上。这次拒稿还直接促成 ISCA 后来设立了 industry track,TPU v4 的论文恰好就发表在那里。工程跑在学术评审前面,这件事本身就是专用芯片时代的一个注脚。
到了第八代,两份硅设计撑起四个系统,积累开始产生复利。机密计算的需求上来以后,Google 没有为它流片新芯片。它给 8t 的硅配上支持硬件级安全特性的主机 CPU,再把为训练优化的 torus 换成 8i 引入的 Boardfly 网络,8tx 就有了。
官方口径需要拆开来读。相比 8t,8tx 的时延最多低一半,这来自网络拓扑;机密计算本身的性能开销接近于零,这来自硬件安全特性。两个数字属于不同的层,官方发布把它们写在同一句话里,很容易读混。
8i Max 要解决的是另一个问题:内存墙。几十个 agent 同时处理一个代码库或几小时的视频时,内存带宽会比算力先到顶。Google 把两颗 8i 封进同一个封装,官方确认的提升有三项:算力、片上 SRAM、HBM 带宽,各自翻倍。
显存容量官方没有在发布中给出,第三方报道的数字是 384GB,约为 8i 的 1.33 倍。如果这个数字成立,就出现了一个值得注意的不对称:容量只乘 1.33,算力却乘 2,每单位算力能携带的 KV 缓存反而比 8i 少。官方还强调,把双倍的硅塞进现有机架空间,每平方英尺和每瓦的算力密度都会提高,但没有给出对应的功耗和散热数字。密度提升的隐含成本,目前只能确认存在,看不到有多大。
芯片的专用化也在加深。8t 有两个专用部件:处理 embedding 的 SparseCore,以及 LLM 解码引擎。8i 的 CAE(Collectives Acceleration Engine,集合通信加速引擎)专门加速自回归解码和思维链推理中的归约与同步操作。上一代 Ironwood 在这个位置放的是四个 SparseCore。训练和推理的分工已经刻进了 die 的结构里,不再是同一颗芯片跑不同负载。
还有一个指标能看出 Google 怎么定义「好」。8t 的官方指标里有一项 goodput per watt:它看的不是峰值算力,而是扣掉故障和恢复时间后的有效吞吐,再除以功耗。Google 拥有全球最大规模的自用 AI 负载,对它来说,这个指标比峰值 FLOPS 更接近真实成本。
二、网络层:二十年的演进,不是一次豪赌
网络是 Google 垂直整合得最深的一层,也是外界最容易误读的一层。流行的说法是「Google 用光路交换(OCS)取代了交换机」。实际情况是一条二十年的演化链:自研数据中心网络的第一代 Firehose 于 2005 年启动(Jupiter Rising,SIGCOMM 2015),Watchtower、Saturn、Jupiter 相继迭代,OCS 在这条链上的角色一直在变。
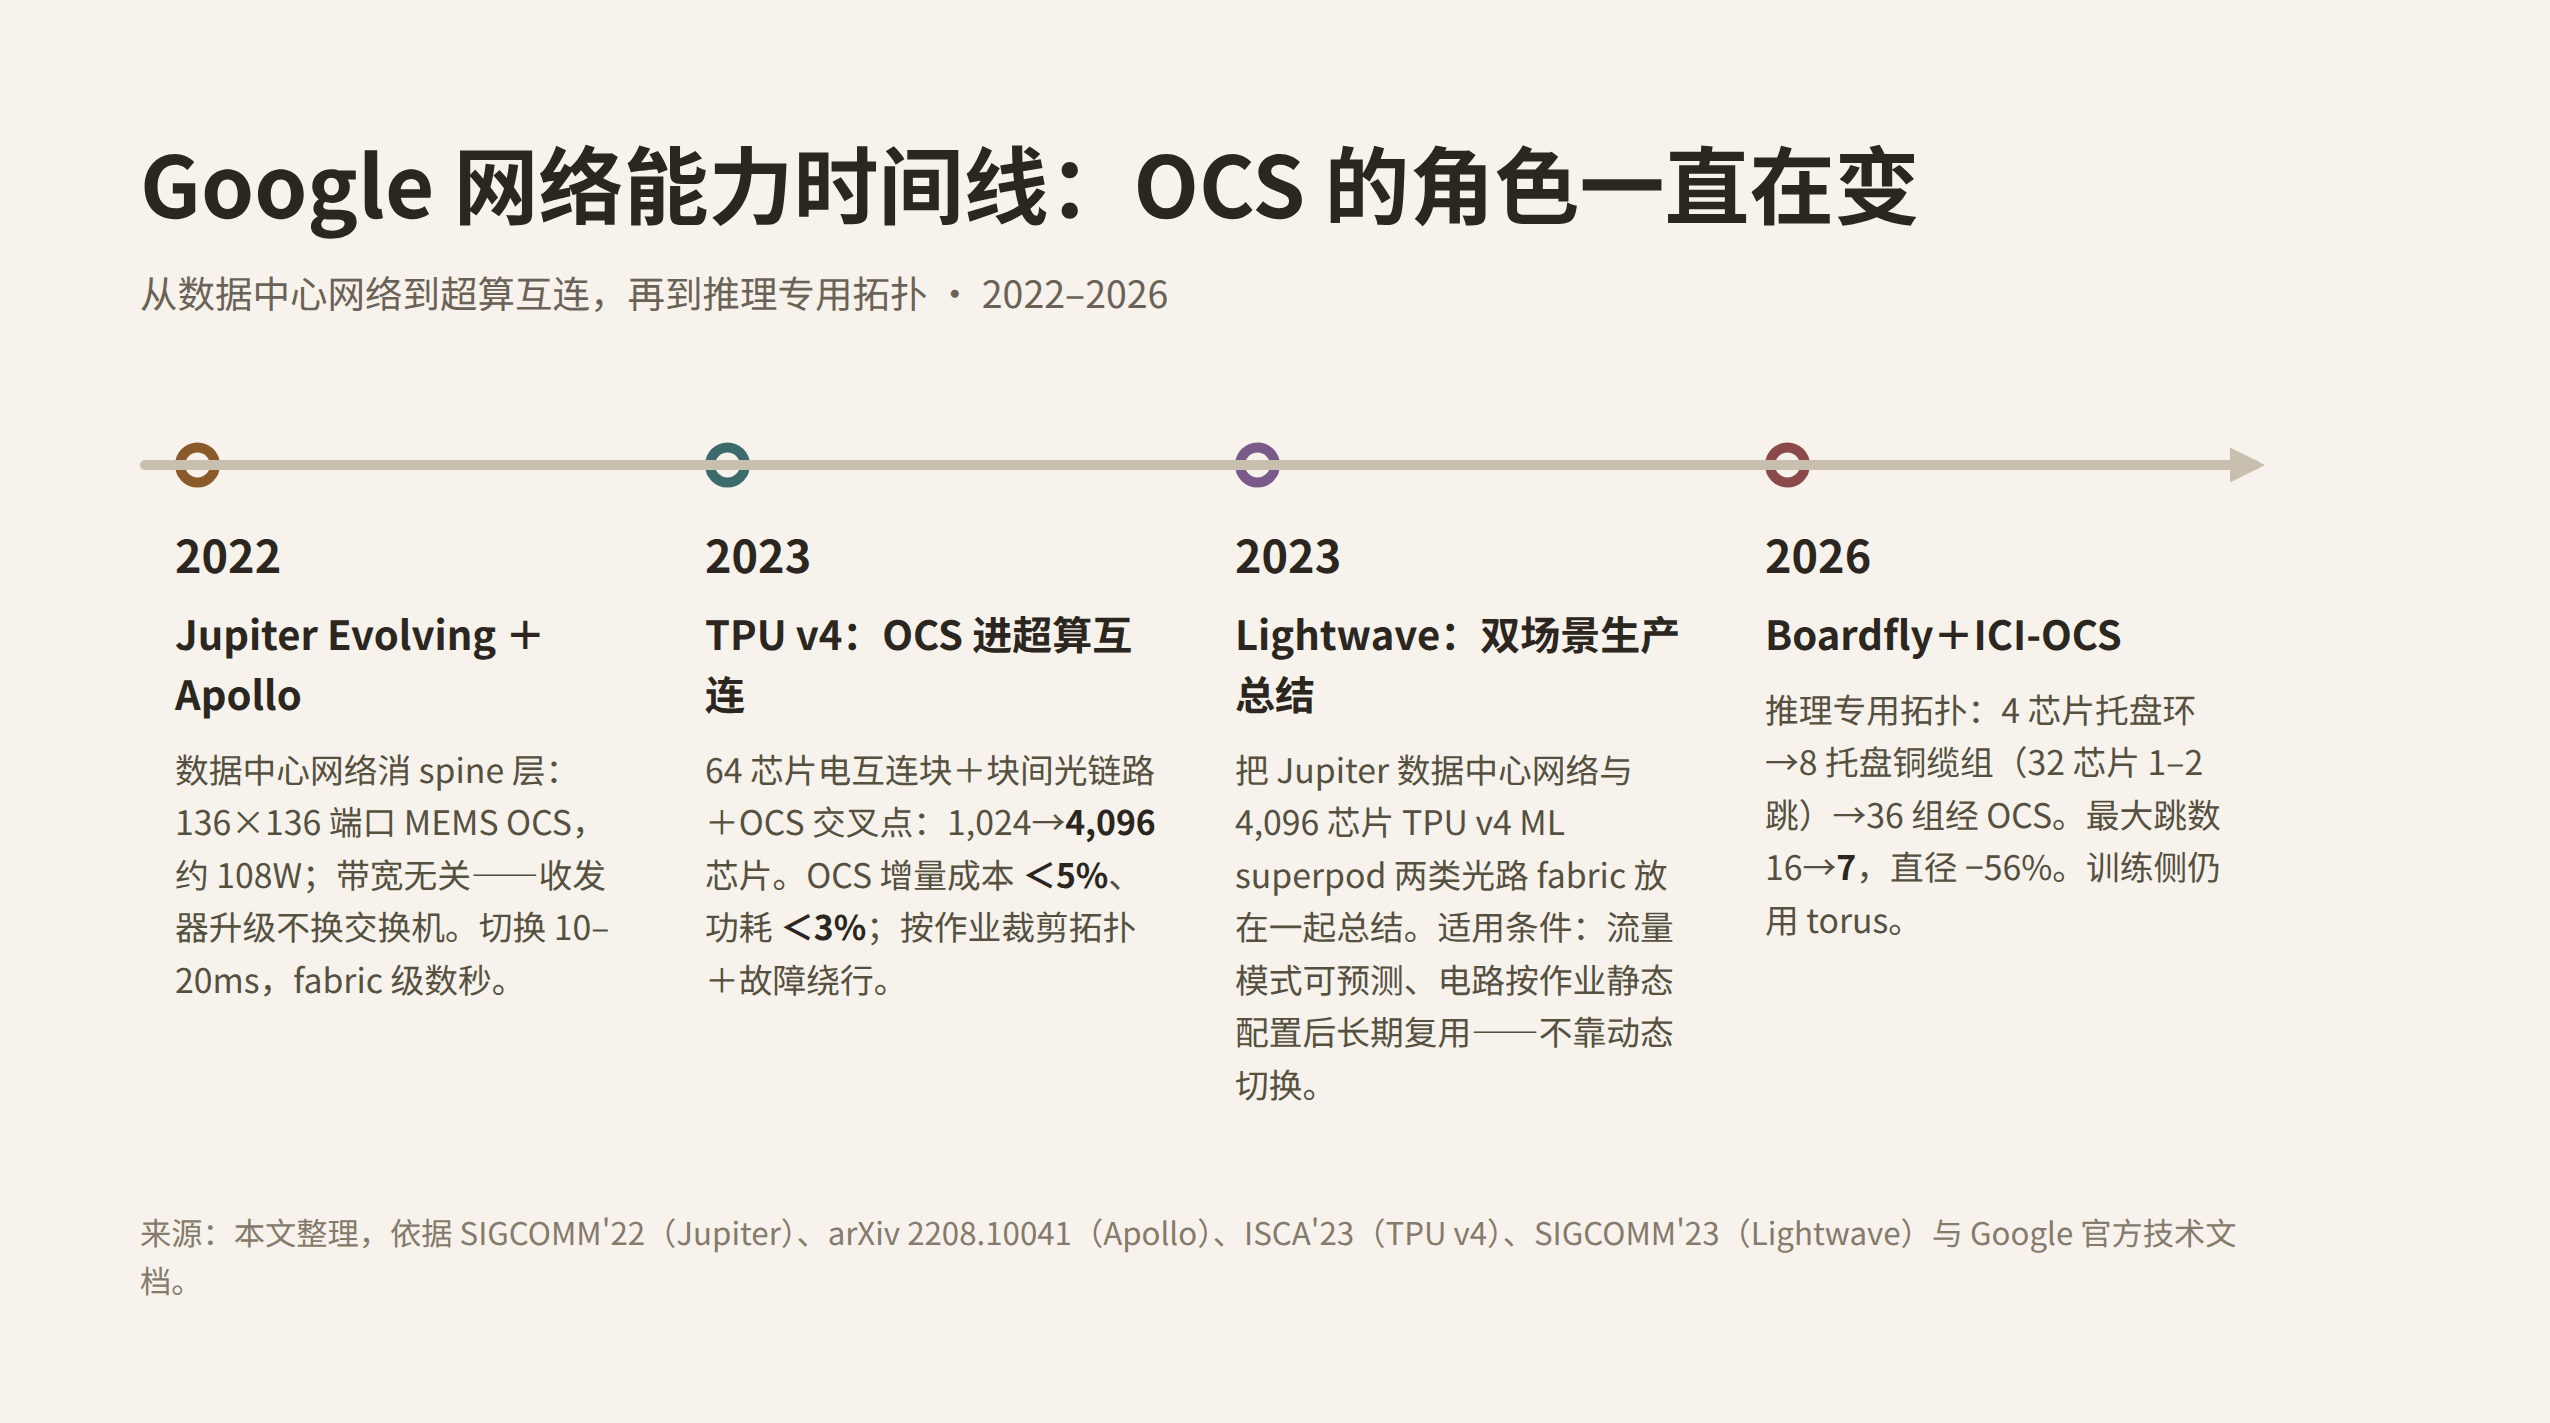
Apollo 与 Jupiter(2022 年论文,部署更早):OCS 进入数据中心网络。 Google 在 SIGCOMM 2022 上发表了 Jupiter 网络的演进历程,同年 8 月又在 arXiv 上公开了 Apollo 光路交换机的完整设计。Apollo 是自研的 136×136 端口非阻塞 OCS,基于 MEMS 微镜,功耗约 108W。端口数相同的电交换机,功耗在 3,000W 量级。Apollo 最反直觉的特性是「与带宽无关」:它交换的是光路而不是数据包,收发器升级到更高速率时,交换机本身不用换。代价是速度:商用 OCS 的切换时间在 10 到 20 毫秒,整个 fabric 换一次向要几秒。在 Jupiter 的架构里,传统 CLOS 网络的多层 spine 被压缩成了「块间直连 + 一层 OCS 重构」。
TPU v4(2023):OCS 进入超算互连。 ISCA 2023 的 TPU v4 论文给出了完整的数字。64 颗芯片用电互连组成一个 building block,块与块之间走光链路,OCS 在光链路的交叉点提供重构能力。靠这套设计,系统规模从上一代的 1,024 颗芯片扩展到 4,096 颗。OCS 部件的增量成本不到系统总成本的 5%,功耗不到 3%。可重构带来了两项能力:按作业裁剪拓扑,以及故障后快速绕行。这组数字是「便宜的弹性」的量化证据。
Lightwave(2023):两类场景的生产总结。 同年的 Lightwave Fabrics 论文把 Jupiter 数据中心网络和 TPU v4 ML superpod 两类光路 fabric 的生产部署放在一起总结,其中包括那个 4,096 颗芯片的 ML superpod。论文对适用条件说得很坦白:光路 fabric 的收益来自「长期存在的流量模式」和「紧耦合 ML 集群中可预测的流量模式」。换句话说,训练通信的模式在作业开始前基本已经知道,电路可以按作业配置一次、长期复用,不需要在毫秒级动态切换。
Boardfly 与 ICI-OCS(2026):为推理重新设计拓扑。 到第八代,训练和推理开始用不同的网络。8t 沿用为训练优化的 3D torus,8i 则引入了 Boardfly 拓扑。官方技术文档描述的结构分三层:
- 底层:每个 4 芯片托盘用片间互连(ICI)连成环,余出 16 条外部连接。其中 11 条用于组内铜缆互联,其余向上连到光层。
- 中间层:8 个托盘用铜缆全互联成一组,每组 32 颗芯片,组内任意两颗芯片之间只需一到两跳。
- 顶层:36 个组之间用 Apollo OCS 连接,构成一个 pod 内统一的内存与计算空间。
和同等容量的 3D torus 相比,最大跳数从 16 降到 7,网络直径缩短 56%。官方表示这直接压低了尾时延;按 Next Platform 转述的 Google 口径,推理负载的平均时延降低 50%。这个拓扑借鉴了超算界用了多年的 dragonfly 家族。读过网络墙那篇文章的读者也许记得,LBNL 的 Michelogiannakis 正是 Dragonfly+ 的作者,扁平拓扑是这个领域十几年来的学术主线。
把这几段放在一起看,Google 的组网思路是按场景选工具,而不是一种技术包打天下。训练侧的通信模式可以预测,OCS 就按作业静态配置。推理侧对时延敏感,近距离拓扑就压到一跳铜缆。Next Platform 的报道还提到一个容易被忽略的事实:OCS 比基于 Broadcom、Cisco 或 NVIDIA 芯片的以太网交换机更贵,也更稀缺,Google 在训练场景里能不用就不用。光路交换不是 Google 的信仰,只是它在特定位置使用的一类工具。
三、软件层:闭环的另一半
11 月 9 日的官方发布中,接近四成篇幅在讲软件。这部分的小节标题值得原样引用:"Building the computer around the chip",即围绕芯片构建计算机。硬件上的差异要靠软件兑现,这一层有三个构件值得展开。
TPU Sync。 它把 HBM、主机 DRAM、共享存储和数据中心网络统一成一个分层的 KV 缓存体系,官方称首 token 时延降低超过 90%。这和 8i 的硬件设计是配套的:384MB 片上 SRAM 存放最活跃的 KV(本文推断,官方未明说这一用途),放不下的逐层下沉到 HBM、主机内存和更远的存储。片上 SRAM 的配置和分层缓存,是同一件事的两面。
GKE 动态切片(dynamic slicing)。 它利用 OCS 的重构能力在拓扑层调度资源:把 TPU cube 按作业切成 super-slice 或 sub-slice,出故障时通过重构电路恢复。官方数字是作业启动最多快 5 倍,故障恢复最多快 4.5 倍。这正好兑现了前文的判断:OCS 的弹性用在拓扑层。切片和恢复都是秒级到分钟级的操作,电路交换 10 到 20 毫秒的切换时间完全够用。
Cloud Pathways。 这是支撑 Gemini 训练的 DeepMind 运行时,现在通过 GKE 向所有云客户开放。它采用单控制器架构,通过 pathwaysutils 把多个 TPU slice 编排得像一台本地机器。它支持跨 slice 的预训练、强化学习和多主机推理,硬件中断时任务不中断,还能做到亚分钟级的热替换和弹性重分片。8i Max 面向的超大上下文负载,就以这种跨 slice 编排为软件前提。
软件栈也在变得更开放。TorchTPU 已经开源,提供 vLLM 和 SGLang 后端,XLA Serving Engine 也同步开源。再加上下文会谈到的客户机房部署,Google 正在主动打破「TPU 只给自己用」的旧印象。
四、电力与土地:从租到买
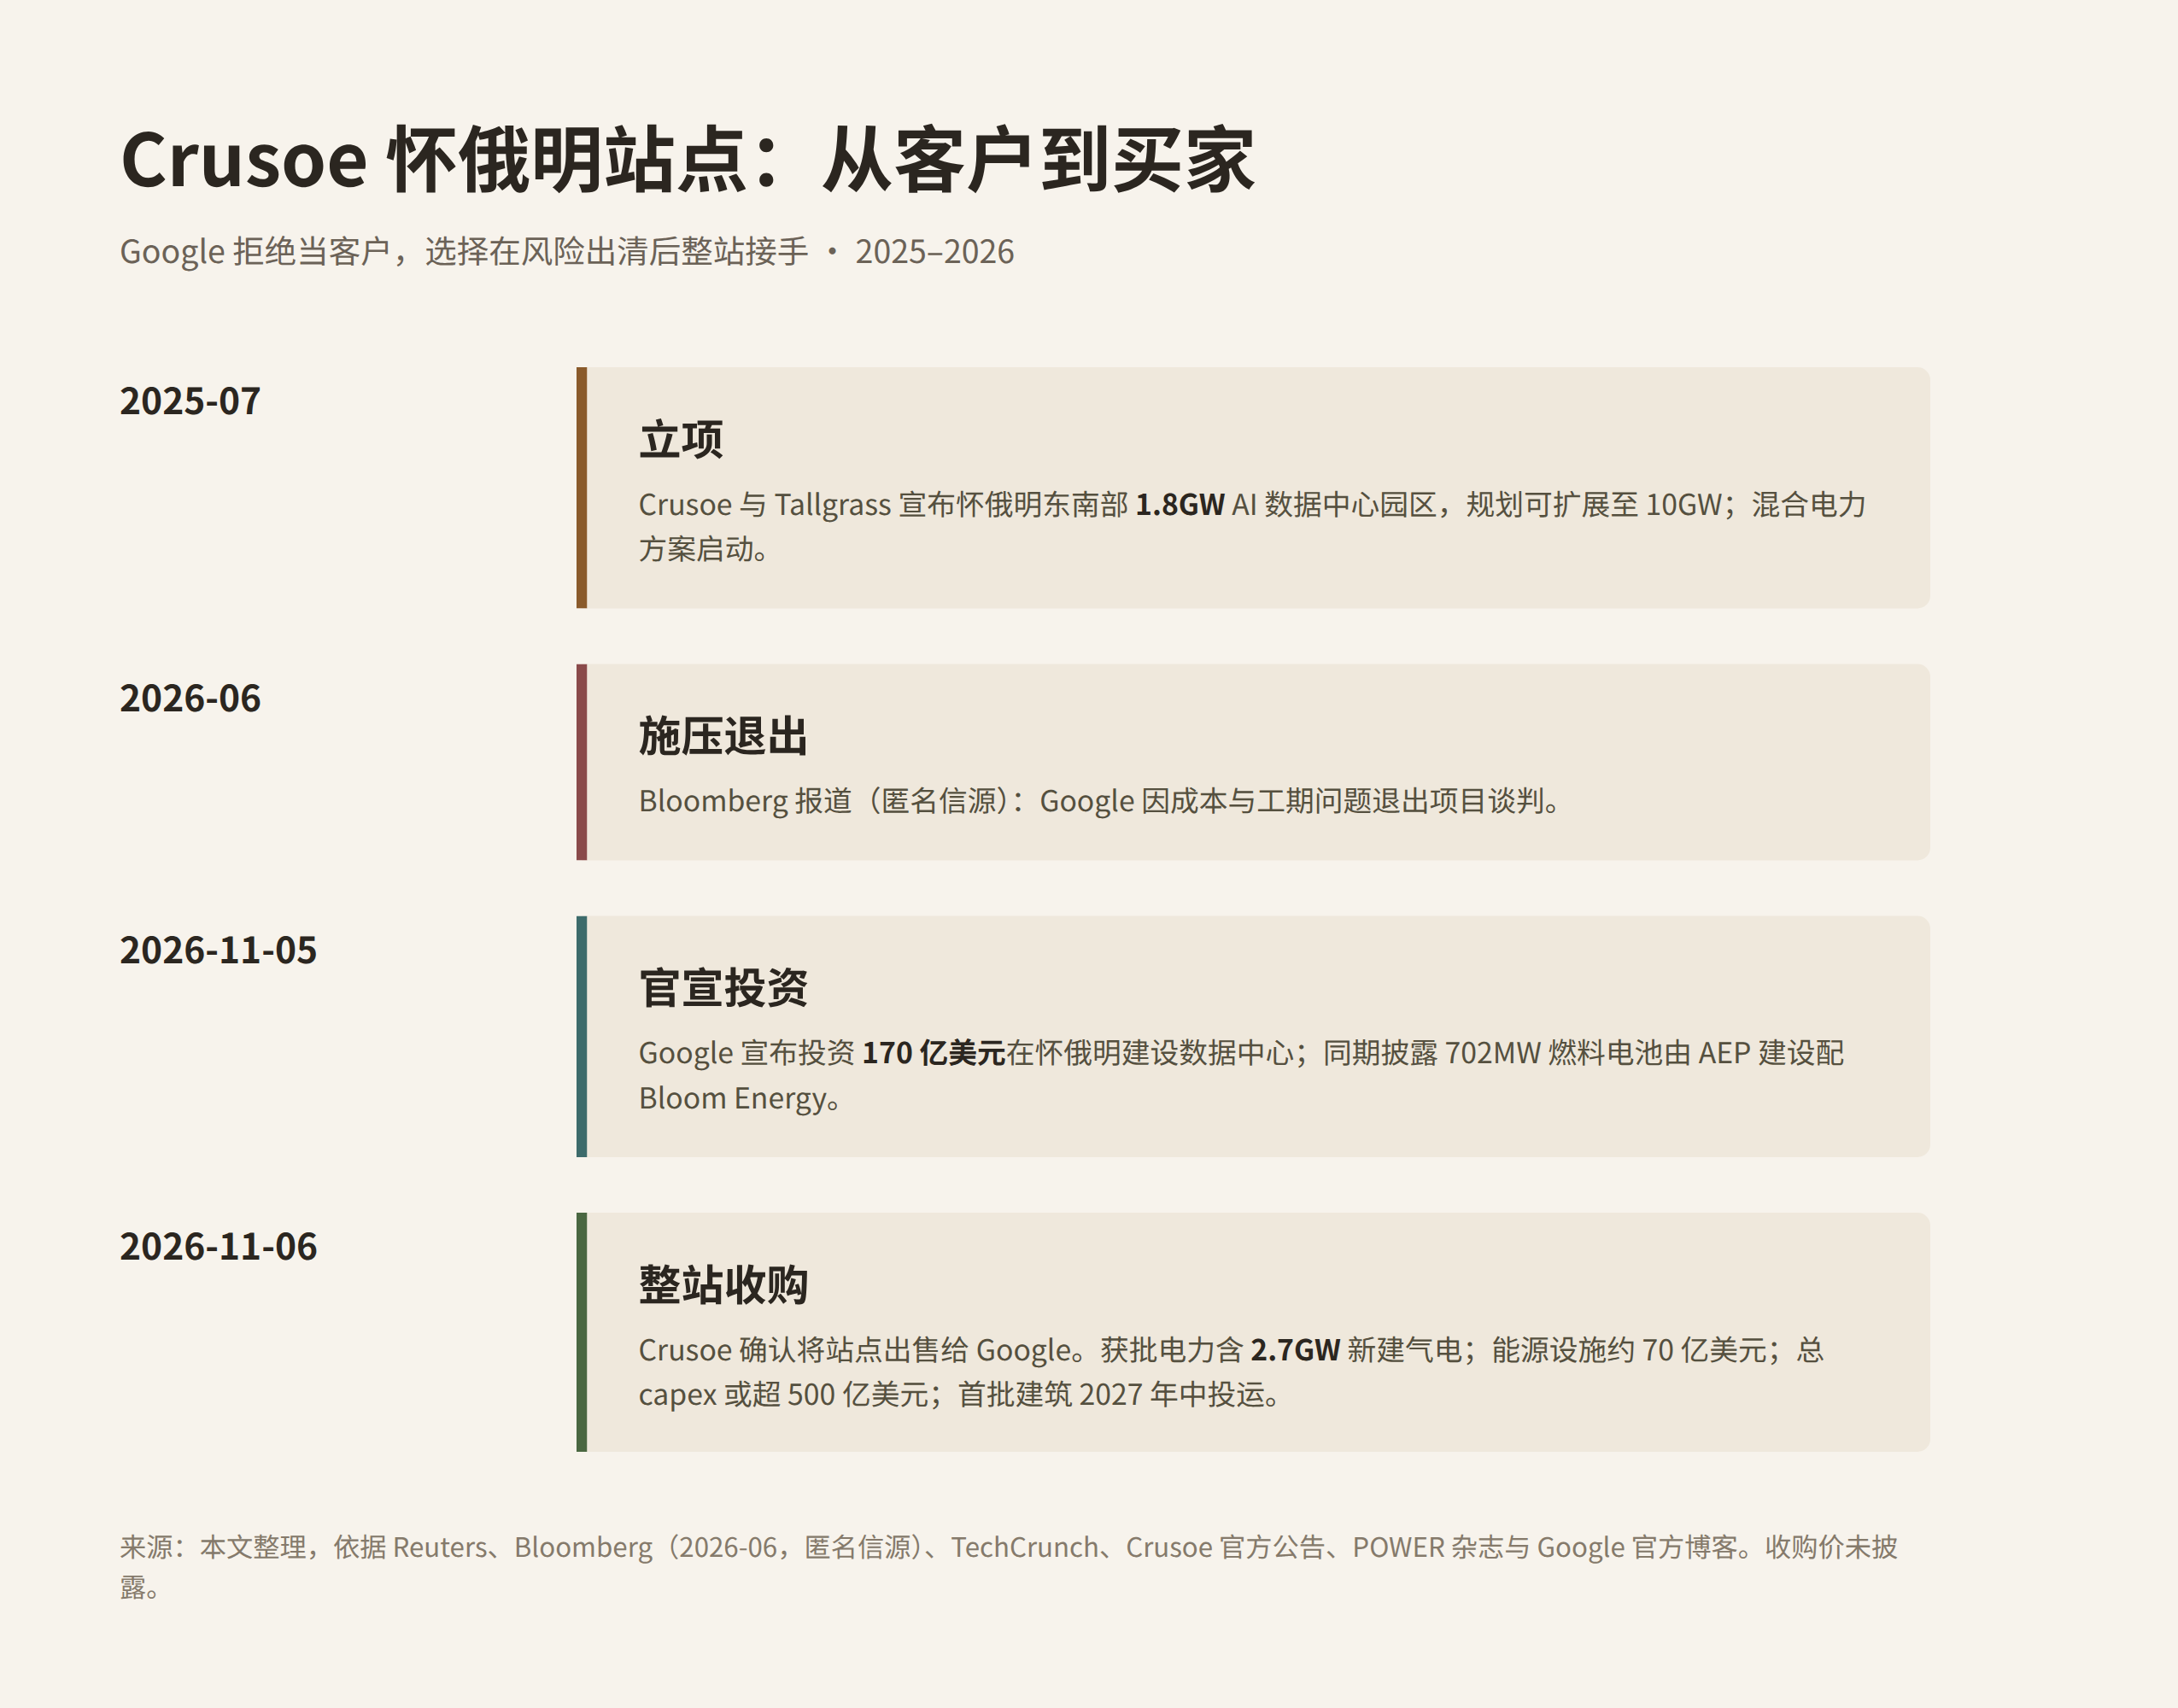
Crusoe 这笔交易的时间线值得完整复述一遍:
- 2025 年 7 月:Crusoe 与能源基础设施公司 Tallgrass 宣布,在怀俄明东南部开发 1.8GW 的 AI 数据中心园区,规划可扩展到 10GW。
- 2026 年 6 月:Bloomberg 援引匿名信源报道(TechCrunch 随后跟进),Google 因成本和工期问题向项目施压后退出。
- 11 月 5 日:Google 宣布投资 170 亿美元在怀俄明建设数据中心。
- 11 月 6 日:Crusoe 确认将整个站点出售给 Google。
这笔交易的结构比金额更能说明问题。Google 没有选择当客户,而是等开发商把前期风险最高的工作做完(选址、审批、电力方案),再整站接手。
电力方案是其中的核心资产。它采用混合架构,包括燃料电池、电网供电和燃气轮机,长期规划接入 Tallgrass 的区域碳捕集枢纽。据 POWER 杂志报道,园区获批的内容包括 2.7GW 新建燃气发电和约 70 亿美元的能源设施投资。Tallgrass 的项目总监估计,整个项目的总资本开支可能超过 500 亿美元,首批建筑计划在 2027 年年中投运。Google 同期的博客披露,702MW 燃料电池由 AEP 建设,设备来自 Bloom Energy。
需要说明的是,170 亿美元不应理解为这些电力设施的建设预算,这笔钱具体怎么构成并没有披露。可以确定的是,在这笔交易买下的东西里,电力和土地的分量不比机房本身轻。
Crusoe 也不是输家。它手上有超过 6GW 的已签约容量和 40GW 以上的储备项目,同时还在得州 Armstrong 为 Google 开发另一个园区。这单生意展示的分工方式,可能会成为今后的常态:开发商承担前期风险、赚取开发收益,超大规模厂商在风险出清后接手持有。当制约扩张的头号因素从芯片变成电力,垂直整合的范围就从机房延伸到了电厂门口。
五、对照:全栈、整机柜与单点自研
把 Google 放进行业里比较,三种模式的差别更加清楚。
- 整机柜方案(NVIDIA):提供 NVLink fabric、CUDA 生态和参考设计,但芯片制造依赖代工,数据中心和电力设施依赖合作伙伴和客户。
- 单点自研(Meta MTIA、微软 Maia、亚马逊 Trainium):在商用基础设施上,只替换加速器这一层。
- 全栈(Google):就公开信息来看,Google 是唯一一家在芯片、自研数据中心网络 fabric(含 OCS)、调度软件、自建机房和购电全链条上都有公开记录的公司。8t 和 8i 的主机 CPU 也是自家的 Axion,而不是 x86(8tx 是例外,见下文)。
供应链上的信号同样值得注意。据朝鲜日报报道,Google 的 HBM 采购规模已经和 NVIDIA 相当。每代 TPU 的单芯片 HBM 容量也在增加:Ironwood 是 192GB,8t 是 216GB,8i 是 288GB。自研芯片并不意味着退出供应链竞争,反而让 Google 成了和 NVIDIA 同一级别的大买家。
这个闭环也有清楚的边界。第一,8tx 的主机 CPU 用的是 AMD 第五代 EPYC,而不是自家的 Axion:机密计算需要成熟的安全硬件生态,Google 选择了买而不是造。第二,HBM 完全外购。第三,芯片制造交给代工厂。「全部自己造」从来就不是事实。更准确的说法是:生态里有成熟部件、能更快解决问题的地方,就用现成的;自研能带来足够大差异化收益的地方,就自己做。
六、边界与批判
OCS 的弹性在拓扑层,不在单步训练内的通信层。 网络墙那篇文章讨论过 MoE 训练每一步要做上百次 All-to-All 通信,这里直接沿用那个结论。光路交换的切换时间在 10 到 20 毫秒,fabric 级换向以秒计,而训练单步之内的流量矩阵在毫秒级变化。Google 自己的 Lightwave 论文也说得很明白:OCS 能服务 ML 集群,靠的是流量模式可以预测、电路按作业配置后长期复用,而不是实时跟踪流量。
所以两条路线的实际分工是这样的。Eridu 路线(Eridu 是网络墙一文介绍的高基数交换芯片公司)用包交换的单跳 fabric 吸收单步之内的通信波动。Google 路线让专用 ICI(torus 或 Boardfly)承担单步之内的通信,OCS 只在拓扑层提供弹性、切片能力和成本优势。OCS 并没有消除带宽墙,它只是用更便宜、更省电的方式撑起了这堵墙。8tx 官方说的「时延最多低一半」,也来自 Boardfly 拓扑缩短了路径,而不是 OCS 在做低时延交换。
产品路线图天然优先照顾自家需求。 官方称 TPU 业务有近百个客户,客户可以把 TPU 部署进自己的数据中心,TorchTPU 也已开源。「封闭」这个旧标签需要更新了。但另一种不对称依然存在:四个系统的推出节奏由 Gemini 的内部需求决定,外部客户能拿到的配置和供货优先级都排在内部之后;而且这类非通用的硅没有第三方 OEM 生态。这不是一堵墙,而是一组同心圆:离圆心越近,越早拿到新系统。
密度提升有隐含成本。 如果 384GB 的说法成立,8i Max 在容量和算力上的不对称就说明,密度提升不是免费的。一个封装里装进双倍的硅,功耗和散热数字官方都没有给。如果每瓦算力的提升是以每 FLOP 能分到的内存容量为代价,对 KV 密集型负载来说未必划算。这个判断目前只能停留在「问题存在、大小未知」。
电力已经先于芯片成为瓶颈。 这个判断的依据不是投资额怎么构成(这一点未披露),而是交易结构本身:Google 为一座还没开建的站点付出了整站收购的代价,而买下的主要是电力方案和土地。芯片可以追加订单,电力并网却要排队好几年。
观察点
- TPU 进入客户数据中心的实际进度。 官方已经开了这个口子。如果出现第一批公开的第三方机房部署案例,「自家优先」的同心圆就又向外扩了一圈。
- 8t 训练侧的 scale-out 网络方案。 这部分至今没有详细披露。如果下一代训练 pod 也引入 OCS 或新的扁平拓扑,就说明 Boardfly 这条路线从推理侧反过来影响了训练侧。
- Crusoe 模式会不会成为超大规模厂商的标准做法,也就是开发商先把风险做掉、超大规模厂商再接手。下一个可以检验的案例,是 Armstrong 园区会不会走怀俄明的老路。
- OCS 的成本曲线。 它今天是「又贵又稀缺」的部件,也是 Google 网络里唯一与带宽无关的一层。如果商用 OCS(nEye、Salience 等厂商)把价格打下来,这套架构的关键约束就会松动。
信源
- Google 官方博客:Introducing TPU 8tx and TPU 8i Max(2026-11-09);怀俄明数据中心投资公告(2026-11-05)
- Google Cloud:TPU 8t and TPU 8i technical deep dive;TPU 产品文档
- Jouppi et al., "In-Datacenter Performance Analysis of a Tensor Processing Unit", ISCA 2017
- Jouppi et al., "A Domain-Specific Supercomputer for Training Deep Neural Networks", CACM 2020
- Jouppi, ISCA 五十周年回顾(2023,拒稿轶事的一手出处)
- Jouppi et al., "TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings", ISCA 2023
- Singh et al., "Jupiter Rising: A Decade of Clos Topologies and Centralized Control in Google's Datacenter Network", SIGCOMM 2015
- Poutievski et al., "Jupiter Evolving: Transforming Google's Datacenter Network via Optical Circuit Switches and Software-Defined Networking", SIGCOMM 2022
- Urata et al., "Mission Apollo: Landing Optical Circuit Switching at Datacenter Scale", arXiv 2208.10041
- Liu et al., "Lightwave Fabrics: At-Scale Optical Circuit Switching for Datacenter and Machine Learning Systems", SIGCOMM 2023
- Reuters(2026-11-06,Crusoe 交易确认);Bloomberg(2026-06-11,匿名信源);TechCrunch(2026-11-06);Crusoe 官方新闻稿
- POWER Magazine(怀俄明园区电力方案);Next Platform(2026-04-28,Boardfly 与 ICI-OCS 结构)
- 朝鲜日报(Chosunbiz,2026-08-05,HBM 采购格局)
相关阅读:《AI 集群的网络墙》《网卡解体》《AI 数据中心网络演化》