
——从 DeepGEMM 看数据布局、矩阵形状与性能边界
摘要:API 兼容减少的是调用层的改造量。接入成本由数据布局决定,性能收益由真实的矩阵形状决定,这三件事要分开评估。昇腾上的 UE8M0 缩放因子两两打包进 int16,数学等价的计算因此要换一种存放方式。同一组 N、K 下,M=128 和 M=4096 的吞吐分别是 549 和 861 TFLOPS。本文还构造了一个反例:内核耗时降低 30%,整段路径反而慢了 5%。评估应该比较能直接交给下游的结果。
上一篇的结论是:迁移就是重新安排计算、数据和资源之间的关系。本篇再往下走一层,只讨论一个问题:一个矩阵乘法库声称「API 兼容」时,替换的真实成本在哪里?要回答它,得顺着接口一路往下看:数据在内存里怎样排列,矩阵以什么形状进入内核,内核又靠什么让硬件满负荷运转。
「API 兼容」当然有价值,但要先弄清兼容的是哪一层。函数名和参数位置相同,说明调用代码有可能保留下来。它并不保证张量内部的数据排列、量化缩放因子和执行成本也相同。DeepGEMM-Ascend 正好是一个能把这件事讲透的例子。
一、兼容的是哪一层:缩放因子在内存里的排布
DeepGEMM-Ascend 的 README 写明,昇腾上的缩放因子格式与 NVIDIA 版本不同:沿 K 维每两个 UE8M0 缩放因子打包进一个 int16,并按 MN-major 顺序存储,以获得最佳硬件效率。仓库同时提供了布局转换工具(DeepGEMM README)。
先约定记号。 本文把矩阵乘写作 A(M×K) × B(K×N) = C(M×N):
- M、N 是输出 C 的行数和列数。缩放因子正是按 MN 方向组织的:A 的因子按行,B 的因子按列。
- K 是相乘后沿其求和的收缩维度。沿 K 方向每 32 个元素对应一个缩放因子。
- UE8M0 是只用 8 位存储指数的因子格式。「两两打包」是指 K 维上相邻的两个 8 位因子共用一个 16 位字。
「MN-major」并不是「K 方向连续」,而是恰好相反。 以 A 的因子为例(B 同理,只是轴换成 N):设 MN=2(两行 a、b),K=128,每 32 个 K 元素一个因子,那么两行各有四个因子 a0…a3 和 b0…b3。两两打包后每行剩下两个 int16,排成 2×2 的布局,MN 轴步长为 1,K 对轴步长为 2:
| K 对 0(k0–63) | K 对 1(k64–127) | |
|---|---|---|
| 行 a | (a0, a1) | (a2, a3) |
| 行 b | (b0, b1) | (b2, b3) |
内存中的顺序是 (a0,a1)、(b0,b1)、(a2,a3)、(b2,b3)。也就是说,同一 K 位置上两行的因子对相邻存放。如果沿 K 方向读取同一行,比如 a 行从 (a0,a1) 读到 (a2,a3),每读下一对都要跳过中间其他行的因子对,同一行相邻的 K 因子对在内存里并不连续。这和「每行的因子对连续存放」的方式正好相反。数学对象是同一个,存放顺序有两种,各自适合按不同顺序读取数据的内核。
于是,接口兼容的背后多出了一个实实在在的步骤。 上游量化算子输出的布局,可能与内核要求的布局不一致。但转换并非每次都会发生:布局工具会先检查现有布局是否已满足要求,满足就直接复用。转换发生在什么时候,决定了这笔开销记在哪里:
- 固定权重只需在加载阶段转换一次,计入启动成本;
- 每层生成的激活如果需要转换,就计入每个请求的运行时间。
仓库提供 transform_sf_into_required_layout 工具,就是把这笔开销明确交给使用者来决定。
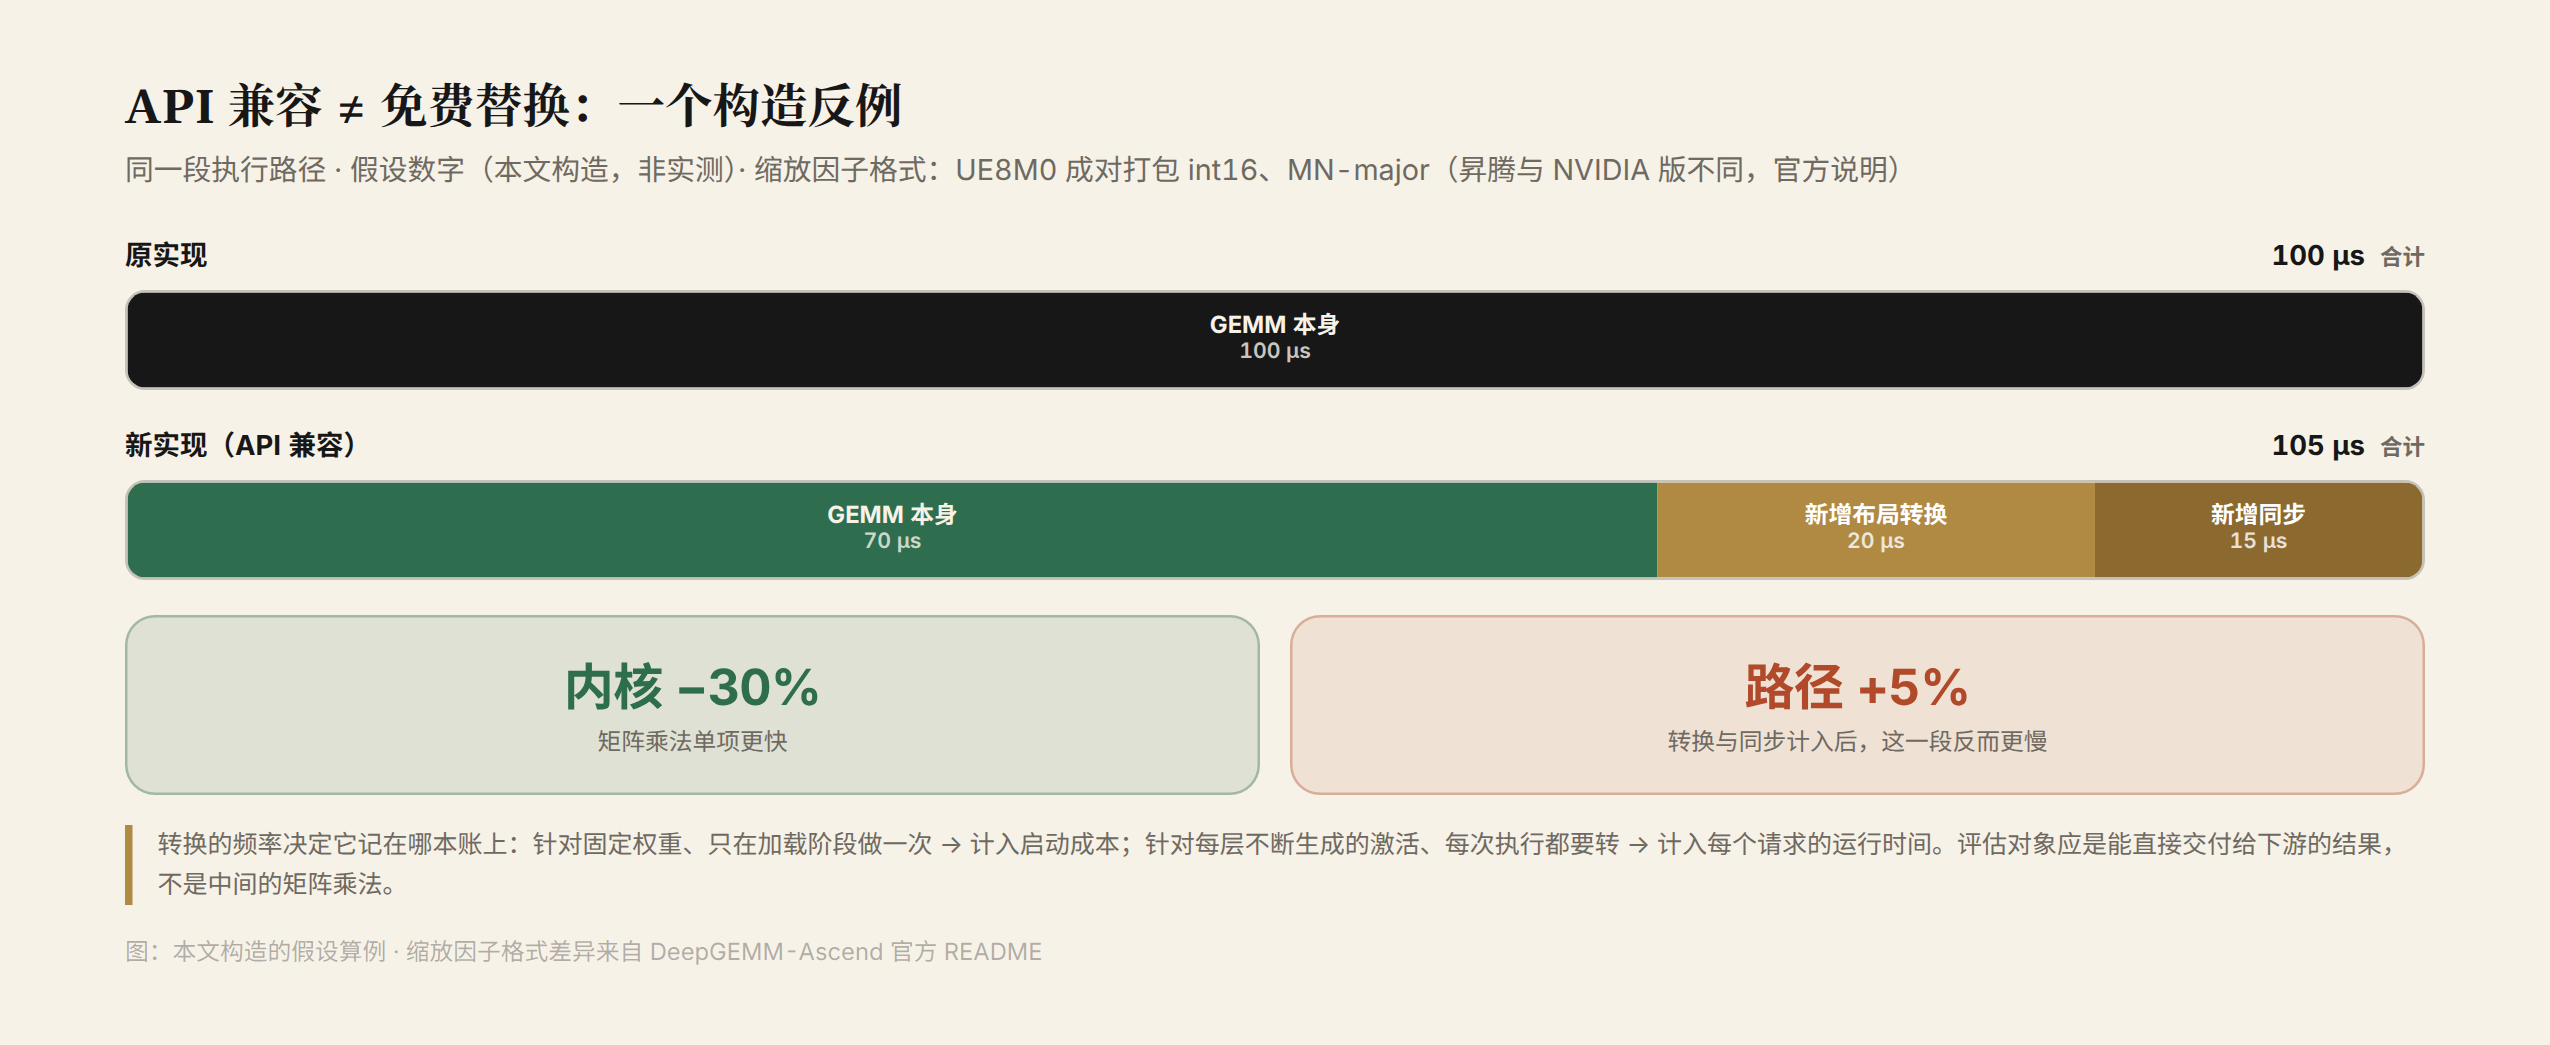
由此可以构造一个纯假设的替换算例,说明评估时容易踩的坑:
| 项目 | 原实现 | 新实现 |
|---|---|---|
| GEMM 本身 | 100 微秒 | 70 微秒 |
| 新增布局转换 | 0 | 20 微秒 |
| 新增同步 | 0 | 15 微秒 |
| 合计 | 100 微秒 | 105 微秒 |
新 GEMM 本身的耗时降低了 30%,但算上转换和同步,这段执行路径反而慢了 5%。这并不说明内核优化没有价值,而是说明评估对象选错了:应该比较能直接交给下游的结果,而不是只看中间那次矩阵乘法。 上表是本文构造的反例,不是任何实测数据,目的是把「兼容之后还要算哪些账」摆到台面上。
二、矩阵形状:从公式到一次真实计算
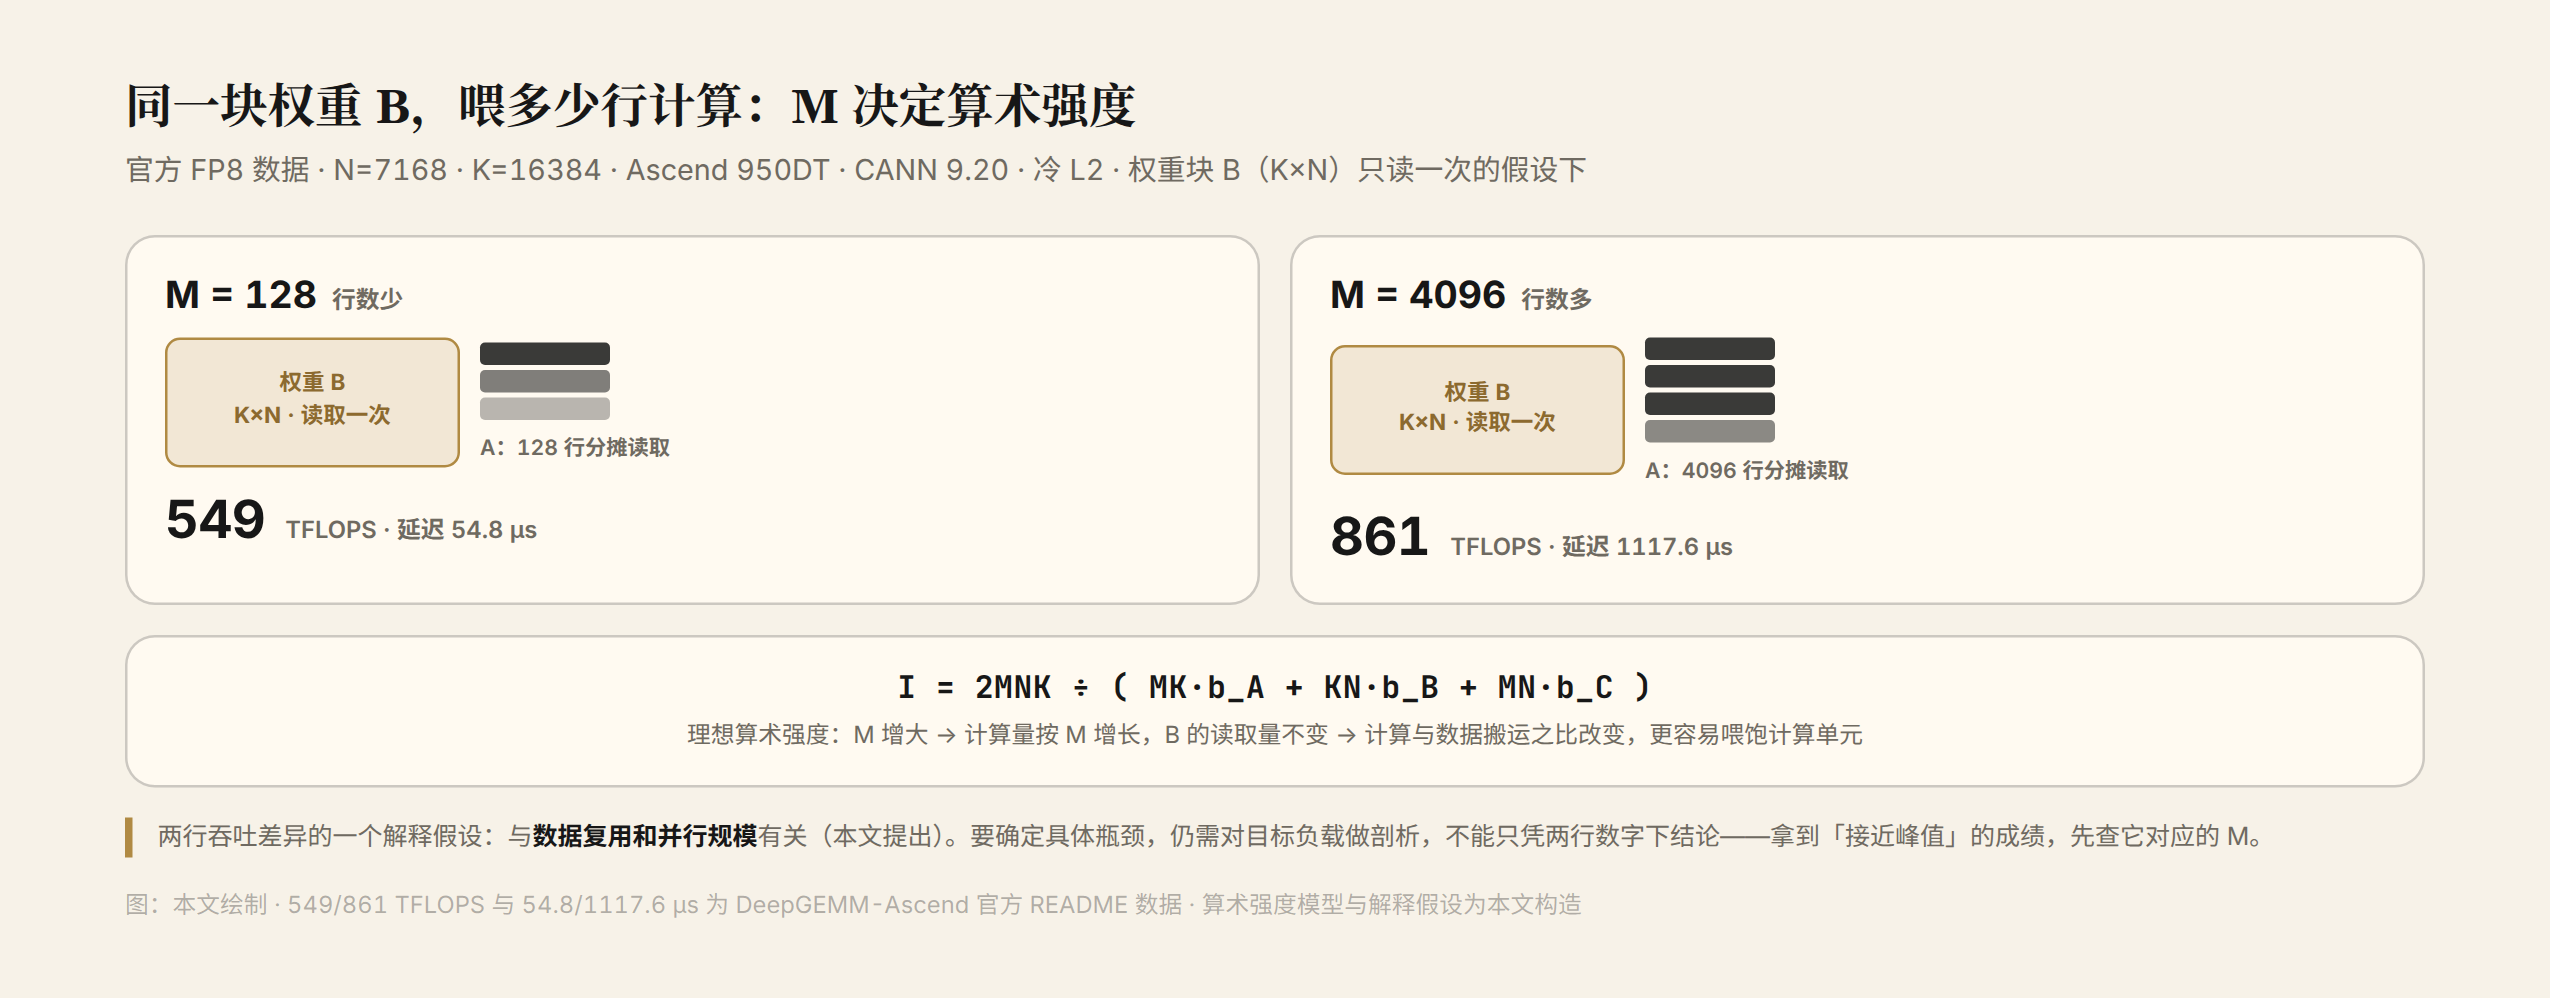
DeepGEMM-Ascend 公开的 FP8 推理基准覆盖七组 (N, K) 形状和两个 M 档位。测试条件为 Ascend 950DT、CANN 9.2.0、冷 L2,计时工具为 bench_msprof(DeepGEMM README)。以 N=7168、K=16384 这一档为例:
| M | 延迟 | 计算吞吐 | 访存带宽 |
|---|---|---|---|
| 128 | 54.8 微秒 | 549 TFLOPS | 2456 GB/s |
| 4096 | 1117.6 微秒 | 861 TFLOPS | 186 GB/s |
读这张表时,有两种直觉容易出错:
- 不能因为第二行耗时更长,就说它效率更低。它处理的矩阵更大。
- 也不能因为它吞吐更高,就以为所有请求都能拿到 861 TFLOPS。两行对应的是不同形状,服务中实际出现什么形状,由批量规模和路由决定。
表中最有信息量的是访存带宽一列:M=128 时高达 2456 GB/s,M=4096 时只有 186 GB/s。这不是实现退步,而是形状改变了计算量与数据搬运量之间的比例。
用一个理想模型可以把这件事算清楚。 先写下假设和公式。对于 C(M×N) = A(M×K) × B(K×N):
- 计算量约为 F = 2MNK;
- 假设每个输入元素只读一次、输出只写一次,FP8 输入每个元素 1 byte,BF16 输出每个元素 2 bytes,则最低数据量为 D = MK×1 + KN×1 + MN×2;
- 理想算术强度为 I = F/D。
代入 M=128: F ≈ 3.01 × 10¹⁰ FLOP,D ≈ 121.4 MB,I ≈ 248 FLOP/byte。权重 B 的 KN 个字节只由 128 行分摊,每搬运一个字节只能支撑约 250 次运算。按这个模型,要让该形状跑满官方 865 TFLOPS 的计算上限,需要约 3.5 TB/s 的持续带宽。
代入 M=4096: D ≈ 243.3 MB,I ≈ 3954 FLOP/byte。同一块权重由 4096 行分摊,跑满算力只需约 0.22 TB/s。官方实测为 861 TFLOPS,达到 865 TFLOPS 硬件上限的 99.5%。
两行数字的差距由此得到解释:M 变大,摊薄的是权重读取。
还有一条读表时的限制。 要判断 M=128 这一档实际受限于哪种资源,不能直接用表里的 2456 GB/s。它和吞吐出自同一次测量,官方的统计方式是用张量字节量除以同一个持续时间,因此不能反过来当作独立的带宽上限。顺带一个提醒:用本文的 D 除以官方延迟,会发现两个方向都有偏差——M=128 算出约 2215 GB/s、官方 2456;M=4096 算出约 218 GB/s、官方 186。官方的字节统计口径(是否计入缩放因子、按什么输出精度计)与本文 D 的假设不完全一致,README 未公开细节;官方 GB/s 只用来提示同源的统计量,模型 D 只用来解释形状趋势,两者不互换。性能数字从哪里来,和瓶颈依据什么判断,是两件不同的事。
这也是为什么看到「接近峰值」时,一定要连同形状一起问。拿到任何一个 TFLOPS 数字,先看它的 M 是多少,再看自己服务里的 M 怎样分布,才能知道实际能落在哪个区间。比较基准时,还要核对表中隐含的条件:
- 数据类型:表格分 FP4×FP4、FP8×FP4、FP8×FP8 和 BF16;
- 缓存状态:冷 L2;
- 工具与软件版本。
换成热缓存或不同精度,同一形状的带宽和吞吐都会变化。
三、分组矩阵乘:路由之后,形状由分布决定
到了 MoE 场景,矩阵形状的问题会被放大。设一个批次有 1024 个 token,每个 token 按路由规则选出 k 个专家,并向每个选中的专家发送一份副本。这样,专家侧收到的输入总行数是 token 数 × k,第 i 个专家分到的行数 m_i 就是它收到的副本数。
用分布 (m_1, m_2, …, m_E) 描述专家计算,比只记「总共 1024 个 token」更有信息量。其中 E 是专家数,在 top-k 路由下 Σm_i = token 总数 × k(等式假设没有 token 被丢弃或因容量不足被截断)。总量相同的两个批次,行数可能集中在少数几个专家,也可能均匀分布到所有专家。
分组矩阵乘(M-Grouped GEMM)就是为这类输入设计的:每个专家的输入矩阵算作一组,多组合并成一次内核调用。官方基准表给出的是平均每组行数很大的两档:
- 4 组,每组平均 8192 行;
- 8 组,每组平均 4096 行。
这两档的计算吞吐为 818–862 TFLOPS,访存带宽只有 98–180 GB/s。权重读取被大行数充分摊薄,最高一档已接近 865 TFLOPS 的计算上限。
读这张表时要严格按表头理解。README 写明「M per group」指平均每组收到的 token 数。所以:
- 平均行数很大,是基准配置的选择,不代表真实路由的分布;
- 平均值还会掩盖组与组之间的不均衡;
- 小而零碎的 m_i 会把形状推向算术强度低的一端。
要判断某种分布实际受限于哪种资源,应先用第二节的模型,按实际行数估算计算量和搬运量,再对照独立的资源上限和实测数据。表中的 GB/s 与吞吐出自同一次测量,不能作为独立的带宽证据。最忙专家的 m_i 和等待结构,则要按第三篇的方法单独分析。
分布还牵涉到对齐。 DeepEP 的 dispatch 有一个 expert_alignment 参数,README 的注释写明它要「匹配分组 GEMM 的 token 对齐」。DeepGEMM 一侧则提供了按连续布局设置组级 M/K 对齐的工具,同时给出理论上的最小对齐值。路由输出的分布、通信侧的填充对齐、内核的分组形状,是同一条执行路径上的三份契约。
行数分布变碎,不仅会压低算术强度,还会让更多组的行数落到对齐粒度以下,从而增加填充。是否增加、增加多少,要按实际行数和对齐粒度计算。低算术强度和高填充,常常源于同一个零碎的行数分布。
四、再往下一层:MAD 抽象与内核流水
「为什么替换不能只换函数名」,最后一层答案在内核实现本身。README 把这个库定位为「对昇腾 MAD(矩阵乘加)原语的轻量抽象」。它封装了分形矩阵布局、对齐约束、地址计算和底层参数转换,让 GEMM 内核保持简洁;同时「广泛采用稀疏数据加载和基于协程的流水线」,以接近硬件极限(DeepGEMM README)。
这三处表述各对应一件具体的事:
- 分形布局是昇腾矩阵单元要求的数据组织方式。上层代码按行和列理解矩阵,硬件则按分形块读取数据。中间的重组又是一个「数学等价、内存形态不同」的例子,与第一节的缩放因子一样,只是这次由库在接口之下完成。
- 稀疏数据加载(sparse data loading,README 原词)是 README 点名的优化方向,但公开说明没有展开实现细节。第四篇会讲到「只搬运选中的数据」这一目标在注意力内核中的完整形态。两者是否用了同一种手法,本文不作断言。
- 协程流水是指内核内部把搬运和计算组织成可以交错执行的阶段。哪个阶段在等数据、哪个阶段在出结果,由软件流水来调度。这与第三篇中 dispatch/combine 在流层面的重叠是同一种思想,只是应用在不同粒度上。
抽象层把这些复杂性都封装在库内部,带来两方面的结果:对内核作者来说,代码写得更少,调优更精确;对使用者来说,看不到布局重组,也就更容易误以为「API 相同就等于执行模型相同」。
因此,库附带的周边工具值得当作一份适配清单来读:
- 布局转换工具:处理第一节算的那笔账;
set_num_sms:控制内核可用的 AI Core 数(官方称 AI cores;接口名沿用了 NVIDIA 的 SM 说法);- 确定性算法开关:README 没有说明实现机制;
- 与 aclnn 参考实现的交叉验证测试:针对对应的 GEMM 接口,覆盖范围以测试代码为准,第五篇会展开。
所以,API 兼容减少的是调用层的改造量;数据布局决定接入成本;真实矩阵形状决定性能收益;内核抽象决定「兼容」二字的真实含义。 把这四件事分开评估,替换决策才有依据。
下一篇将离开单机视角,完整走一遍专家并行的往返:token 怎样分发,缓冲区怎样复用,等待藏在哪里。
资料与计算说明:本文依据 DeepGEMM-Ascend 的公开仓库撰写,资料核验截至 2026 年 10 月 7 日,并保存了固定版本的副本。正文引用的缩放因子格式、周边工具、MAD 抽象的表述和各张基准表均来自官方 README,属于官方成绩,测试条件为 Ascend 950DT、CANN 9.2.0、冷 L2、bench_msprof。第一节布局示例的参数与内存顺序,依据官方测试对输出实际 stride 的检查(提交 8491bbb4);「先检查布局能否复用」依据 csrc/apis/layout.hpp。第一节末尾的替换反例(100/70/20/15 微秒)由本文构造。第二节的 D、I,以及「跑满 865 TFLOPS 所需持续带宽(约 3.5 / 0.22 TB/s)」,是本文按 FP8 输入、BF16 输出、每个元素只读写一次的假设计算的;官方 GB/s 的字节统计口径与本文 D 不完全一致(正文已注明两个方向的偏差),不作为独立的带宽上限使用。expert_alignment 需「匹配分组 GEMM 的 token 对齐」,出自 DeepEP README 的注释。本文没有做硬件实测。本文是「DeepSeek 昇腾开源系列」的第二篇。