
训练大模型时,最先到极限的可能不是 GPU,而是互连网络。Hot Interconnects 2026 上的一项仿真研究,把「架内 NVLink+跨架 CLOS」的传统结构换成 72 台假想的 1 Pbps 大基数交换机。现实部署场景下作业完成时间缩短 17.3%,纯网络压力场景下缩短 27.5%,GPU 利用率从 56–64% 提升到 67–88%。本文对照会议幻灯片复述仿真设定与结果,逐项拆解数字背后的含义,并梳理这条路线的产业跟进,以及它对软硬件的后续影响。
训练大模型时,最先到极限的可能不是 GPU,而是互连网络。2026 年 8 月的 IEEE Hot Interconnects 会议上,Turbalance 与劳伦斯伯克利国家实验室(LBNL)发表了一项仿真研究,为这个判断提供了量化证据。模型是同一个 20T 参数、2304 个专家的混合专家模型,硬件同样是 2304 个 GPU,唯一的变化是互连网络:从「架内 NVLink+跨架两层 CLOS」的传统结构,换成由 72 台假想 1 Pbps 大基数交换机组成的扁平单跳网络。结果是:现实部署场景下作业完成时间缩短 17.3%,纯网络压力场景下缩短 27.5%,GPU 利用率从 56–64% 提高到 67–88%。
这项研究是纯仿真,1 Pbps 的单芯片交换机目前并不存在。但它把「网络拖慢了多少训练时间」量化到了可以支撑决策的精度。产业侧也已跟进:2026 年 10 月,高基数交换芯片公司 Eridu 结束隐身,累计融资 2.3 亿美元,产品方向与论文设想一致。
一、网络墙:算力涨 80 倍,带宽涨 14 倍
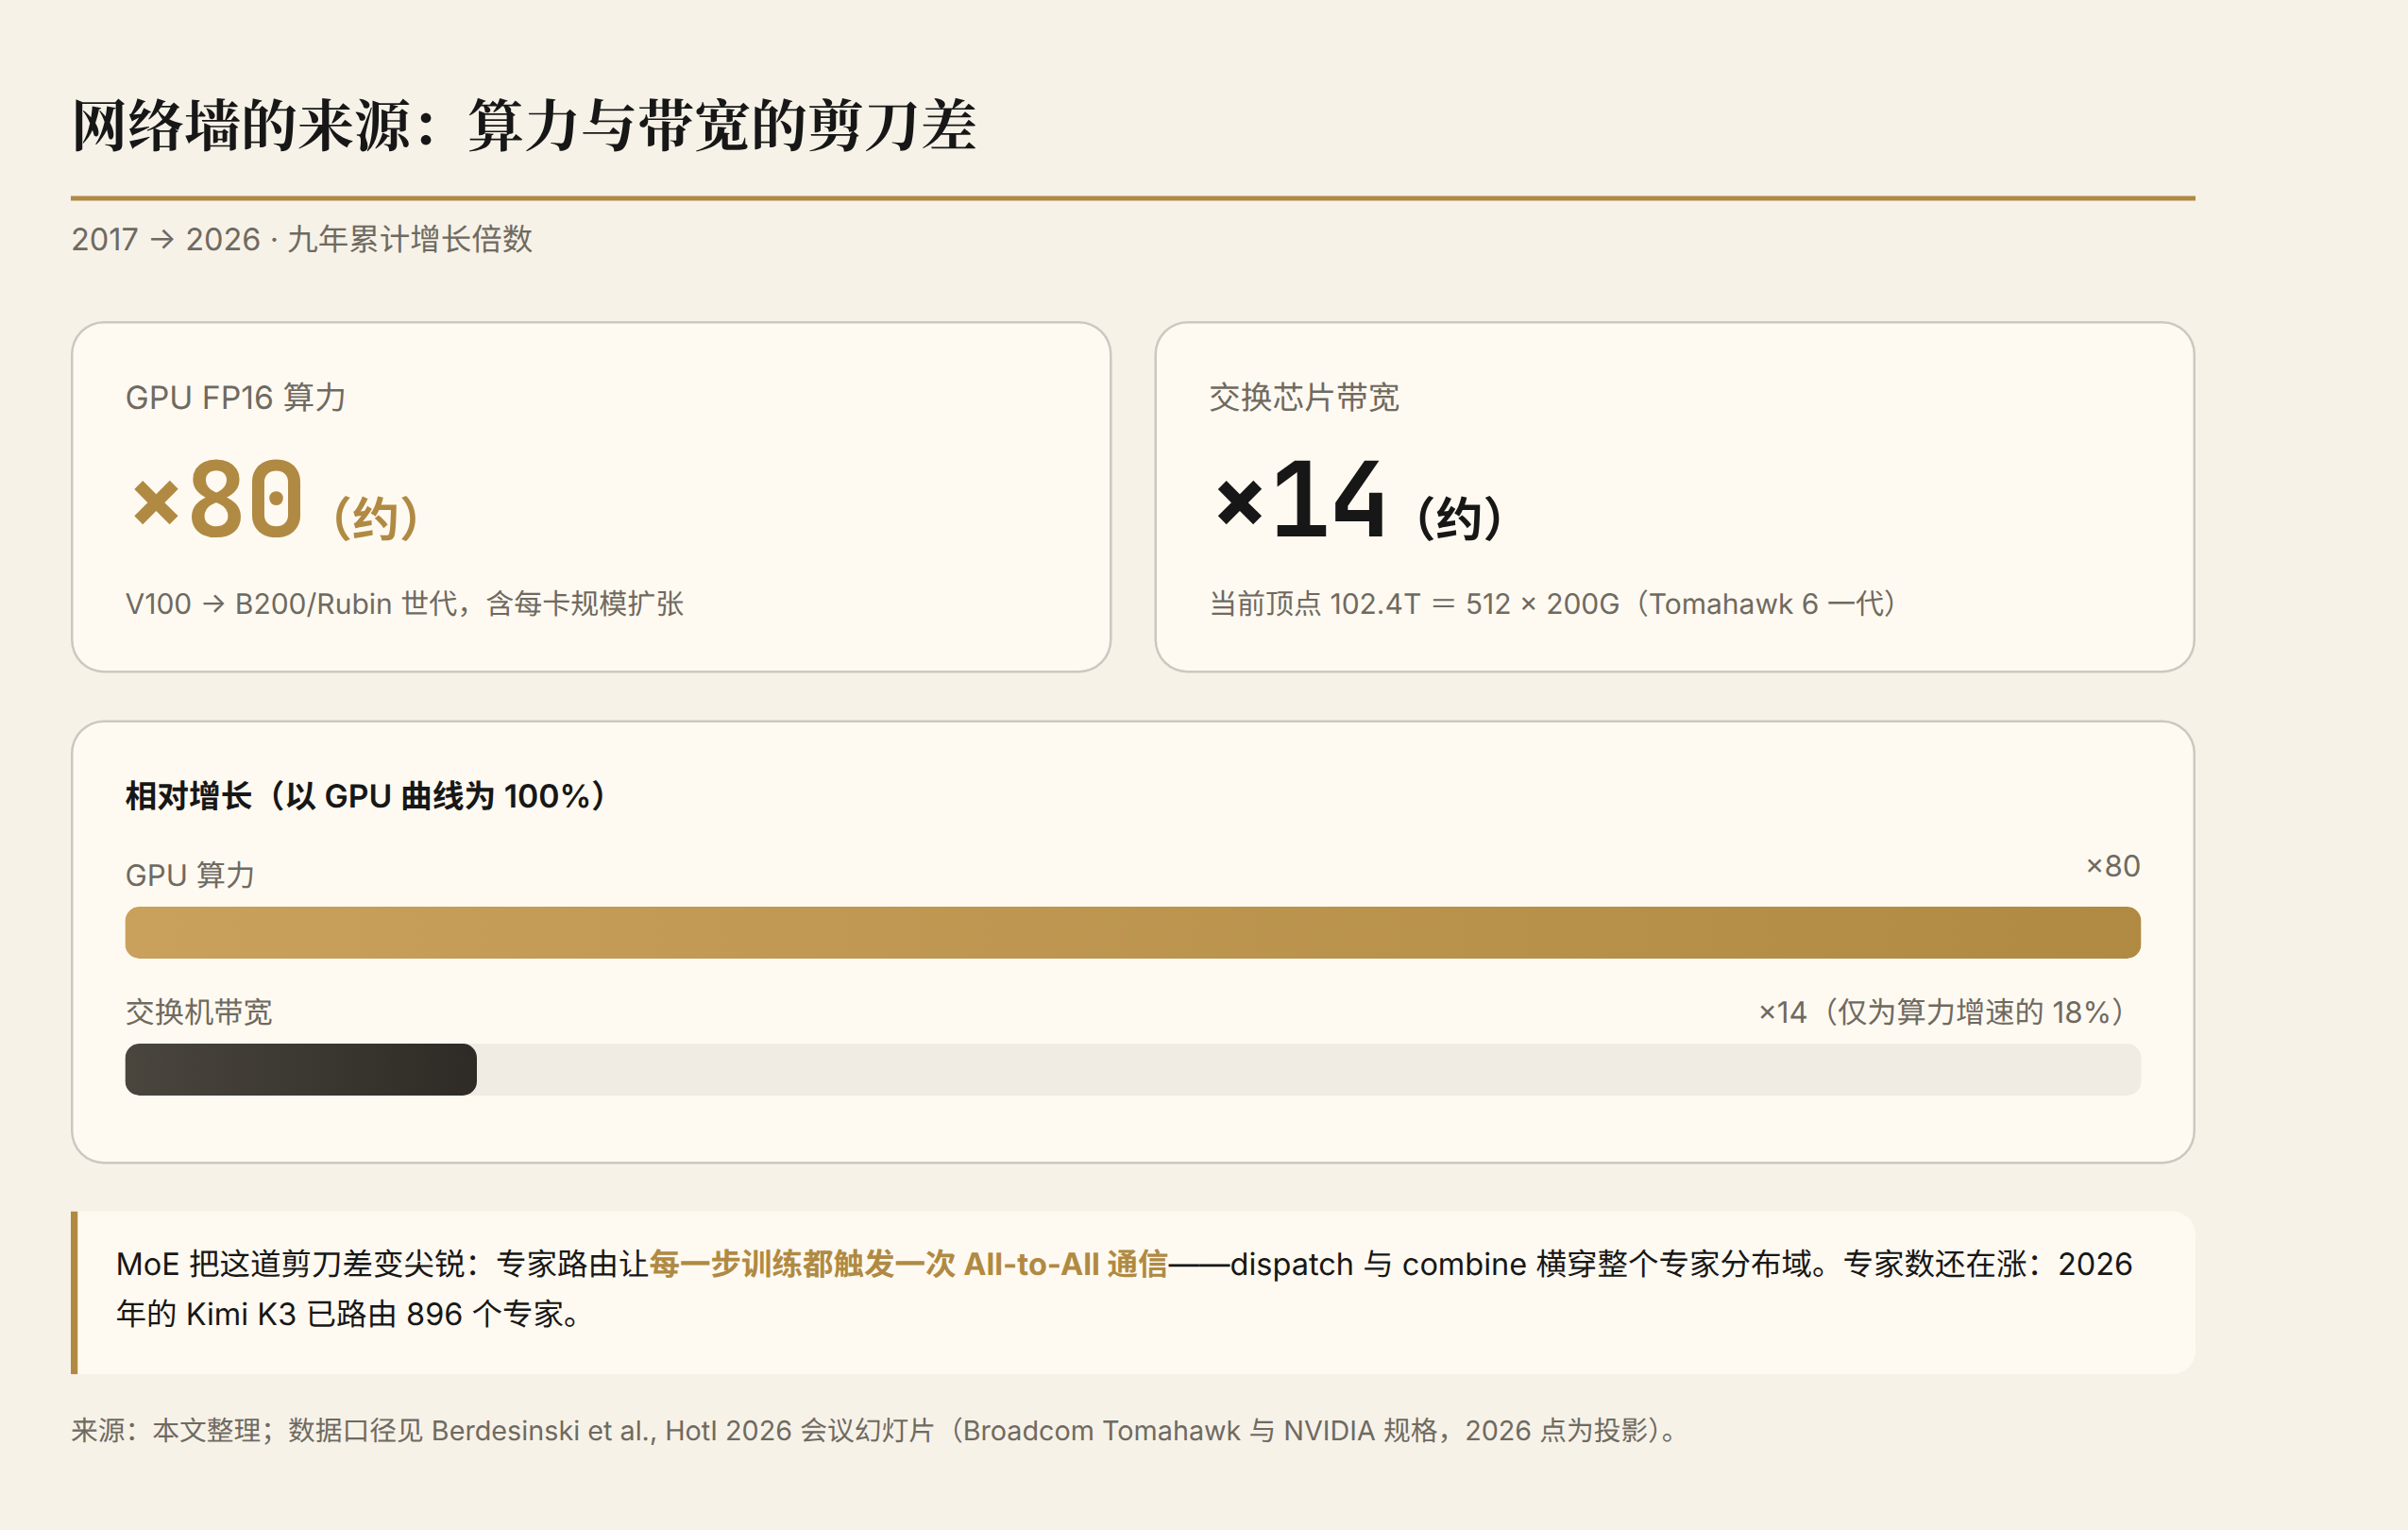
以 2017 年为基准,到 2026 年,GPU 的 FP16 算力增长约 80 倍,交换机带宽同期只增长约 14 倍。这组曲线的基准取自 NVIDIA GPU 与 Broadcom Tomahawk 系列交换芯片的公开规格,2026 年数据点为投影。论文把这两条曲线之间的剪刀差称为「网络墙」(network wall),结论很直接:如今制约大模型训练的是互连,而不是 GPU。
混合专家(MoE)架构进一步放大了网络压力。MoE 每一步训练都要把 token 发往路由选中的专家,计算完成后再收回。这个 dispatch/combine 过程在通信模式上就是一次 All-to-All。论文幻灯片的原话是「expert routing turns every training step into an All-to-All」,即专家路由让每一步训练都变成一次全交换。
更准确地说,All-to-All 不止一次:每个 MoE 层的前向传播有 dispatch 和 combine 两次,反向传播还要再走两次梯度的全交换。一个有几十个 MoE 层的模型,单步训练就要做上百次 All-to-All。而 All-to-All 是对网络最苛刻的通信模式:每张卡都要和几乎所有其他卡交换数据,最慢的那条流决定整次通信何时结束。因此它同时考验三件事:对分带宽、跳数和尾时延。
专家数量还在增长:2026 年的 Kimi K3 已路由 896 个专家,据 SemiAnalysis 报道,Moonshot 建议至少使用 64 卡的 scale-up 域来服务该模型。专家越多、分布越散,All-to-All 需要穿越的网络范围就越大。
二、基数墙:512 条通道的上限
网络为何跟不上?论文把原因归结为交换芯片的「基数」(radix),即单颗芯片能引出的通道数。当前最先进的交换芯片提供 512 条 200G 通道:2026 年下半年出货的 Tomahawk 6、Silicon One G300 和 Spectrum-6,容量都停留在 102.4 Tbps。按趋势外推,下一代 ASIC 只会翻约 2 倍,达到 204.8 或 230.4 Tbps。
NVIDIA 的 Spectrum-6 SN6800 在机箱内用四颗芯片拼出 409.6 Tbps,数字上翻了四倍,但网络看到的仍是每颗芯片 512 通道的基数。论文原话是「the fabric still sees the same 512 lane per-chip radix」。也就是说,机箱内聚合并不能提升基数。
为什么基数比总带宽更关键(本文推算):在单层多平面(multi-rail)网络里,每台交换机都要直连域内所有 GPU,所以单跳域能有多大,取决于「交换机通道数 ÷ 每个 GPU 占用的通道数」。
| 交换芯片 | 每 GPU 链路 | 单跳域上限 |
|---|---|---|
| 512 × 200G(当前) | 1 条 200G | 512 个 GPU |
| 512 × 200G(当前) | 1 条 400G(占 2 通道) | 256 个 GPU |
| 5120 × 200G(论文假设) | 1 条 400G(占 2 通道) | 2560 个 GPU |
这就是论文所说的,512 通道把单跳域限制在「几百个 XPU」。总带宽可以靠堆芯片补上,但单颗芯片能触达多少个端点,只能靠提升基数来解决。要连接更多加速卡,只能继续叠加网络层级,代价是更多交换机、更多线缆、更高功耗和更长的尾时延。今天的万卡集群正是这样搭建的:多层 CLOS、上千台交换机,跨机架路径至少三跳。
论文假设的 5120 通道是 512 的十倍,取整后恰好覆盖 2304 个 GPU 的需求:每个 GPU 占 2 条通道,2304 × 2 = 4608 条;4608 本身已等于 9 × 512,恰好够用,论文取 5120,留了约一成余量(本文推算)。
三、仿真设定:一个 20T 模型,两张网络
3.1 模型:Maverick 放大 50 倍
研究设定面向 2028–29 年。模型以 Llama 4 Maverick(约 400B 总参数、17B 激活参数、128 个专家)为基础推导,放大到约 20T 总参数、165B 激活参数,每个 MoE 层有 2304 个专家,每个 token 选 16 个(top-16)。
几个比例值得注意(本文推算):
- 总参数放大约 50 倍,激活参数只放大约 10 倍,模型更稀疏。每个 token 只激活 16/2304 ≈ 0.7% 的专家,激活参数占总参数的比例约 0.8%。
- 专家数与 GPU 数刚好相等(2304),也就是说,专家并行拉满时每张卡每层只放一个专家。
- top-16 意味着每个 token 在 dispatch 时要被复制发往 16 个目的地,All-to-All 的数据量随 top-k 成倍增加。
硬件平台为 2304 个 NVIDIA Rubin Ultra 封装,分布在 16 个机架中,每架 144 个。
3.2 两张网络
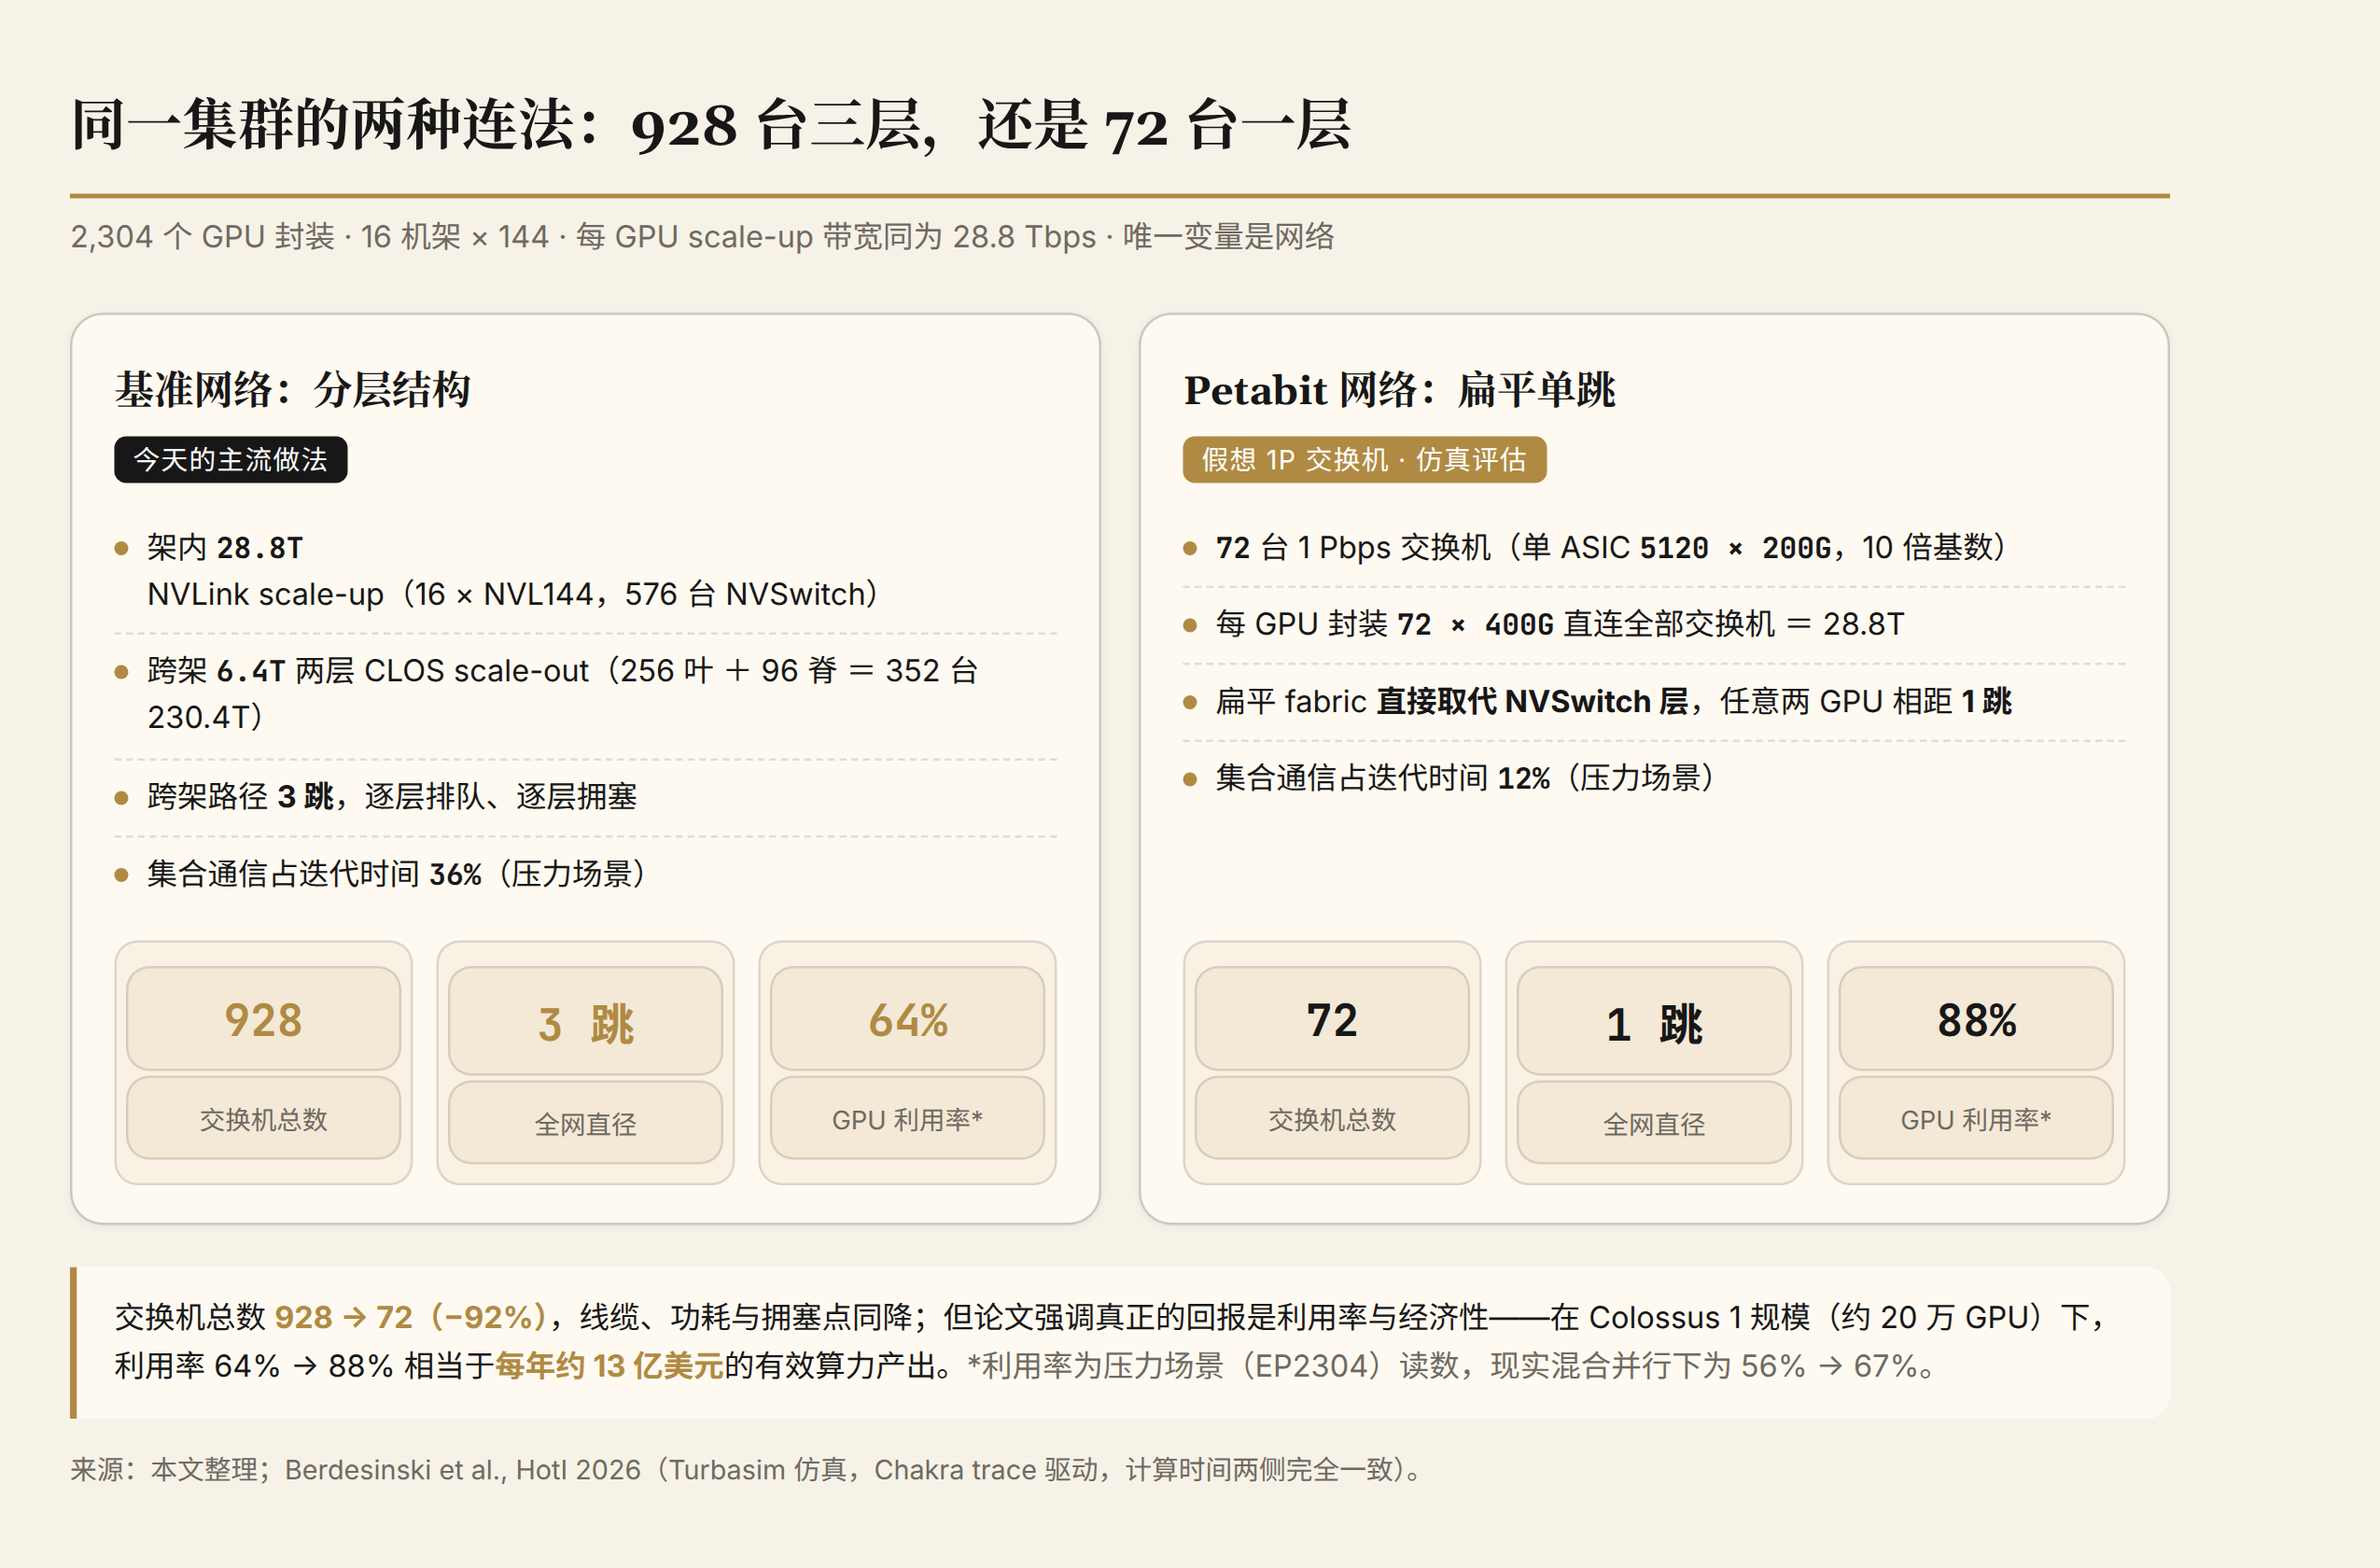
两张网络的每 GPU scale-up 带宽相同,均为 28.8 Tbps(即 3.6 TB/s):
- 基准网络:架内为 NVLink(16 个 NVL144 机架,共 576 台 NVSwitch,即每架 36 台),跨架为 6.4 Tbps 的两层 CLOS(256 台叶交换机+96 台脊交换机,全部为 230.4T,4 轨 16 平面)。全网共 928 台交换机,网络直径 3 跳。
- Petabit 网络:72 台假想的 1 Pbps 交换机,单颗 ASIC 提供 5120 条 200G 通道,基数是现有芯片的 10 倍。每个 GPU 封装通过 72 条 400G 链路直连全部 72 台交换机,同样凑足 28.8 Tbps,但全网直径只有 1 跳,而且这张扁平 fabric 直接取代了 NVSwitch 层。
这组设定的关键不在「28.8T 相同」,而在跨机架那一段(本文推算):
| 基准网络 | Petabit 网络 | |
|---|---|---|
| 架内每 GPU 带宽 | 28.8T(NVLink) | 28.8T |
| 跨架每 GPU 带宽 | 6.4T(CLOS) | 28.8T |
| 架内 / 跨架带宽比 | 4.5 : 1 | 1 : 1 |
| 跨架路径跳数 | 3 跳(叶—脊—叶) | 1 跳 |
| 交换机数量 | 928 台 | 72 台 |
基准网络是「两级带宽」:机架内 28.8T,一出机架就降到 6.4T,只有前者的 1/4.5。Petabit 网络则把全部 2304 个 GPU 拉平到同一个 28.8T、同一个 1 跳。换句话说,论文比较的并不是「更快的交换机」,而是「去掉机架边界」。
Petabit 网络的端口利用率(本文推算):每台交换机接 2304 个 GPU × 2 通道 = 4608 通道,占 5120 通道的 90%;剩余 512 通道的用途(如 scale-out 或存储上联),论文幻灯片中未见说明。72 台交换机的总容量约 73.7 Pbps,GPU 侧注入带宽合计 2304 × 28.8T ≈ 66.4 Pbps。
3.3 方法:只改网络这一个变量
研究使用 Turbalance 自研的离散事件仿真器 TurbaSim,以 Chakra 执行 trace 驱动,把同一份模型运行记录分别在两张网络上重放,两边的计算时间完全一致。论文原话是:「Compute time is identical — the entire improvement is network-driven」,即计算时间相同,全部差异都来自网络。这种做法把网络单独隔离为一个变量,是这项研究方法上最干净的地方。
TurbaSim 内部有 packet、flow、analytical 三种后端,这篇论文用的是 flow 级:不逐包模拟队列,而是把每条流近似为带宽分配问题,因此快到足以重放两千多个 GPU 的完整训练过程,代价是 incast 拥塞下的长尾时延只能近似刻画。驱动它的 Chakra 执行 trace 记录训练一步之内计算与通信如何交错;同一份 trace 在两张网上重放时,计算部分原样执行,通信部分按各自拓扑重新计时。这就是「计算时间完全相同」的实现方式。
局限同样来自仿真本身。flow 级仿真对多层网络拥塞和长尾时延的刻画未必精确,1 Pbps 交换机也只是建模出来的硬件。论文回答的是「如果有这样的芯片会怎样」,而不是一份工程承诺。论文团队自己列的下一步,是把仿真扩大到 5040 个封装的全域,比这次的 2304 再翻一倍多。这个数字的口径与本研究不同:若每个封装只占 1 条 200G 通道,单层 fabric 可挂 5120 个封装,5040 接近这个上限;本研究每封装占 2 条通道(400G),所以单层是 2304 个封装加约一成余量。
四、仿真结果:逐项拆解
研究跑了两个场景,两组数字需要分开解读。
4.1 场景 A:极限压力测试
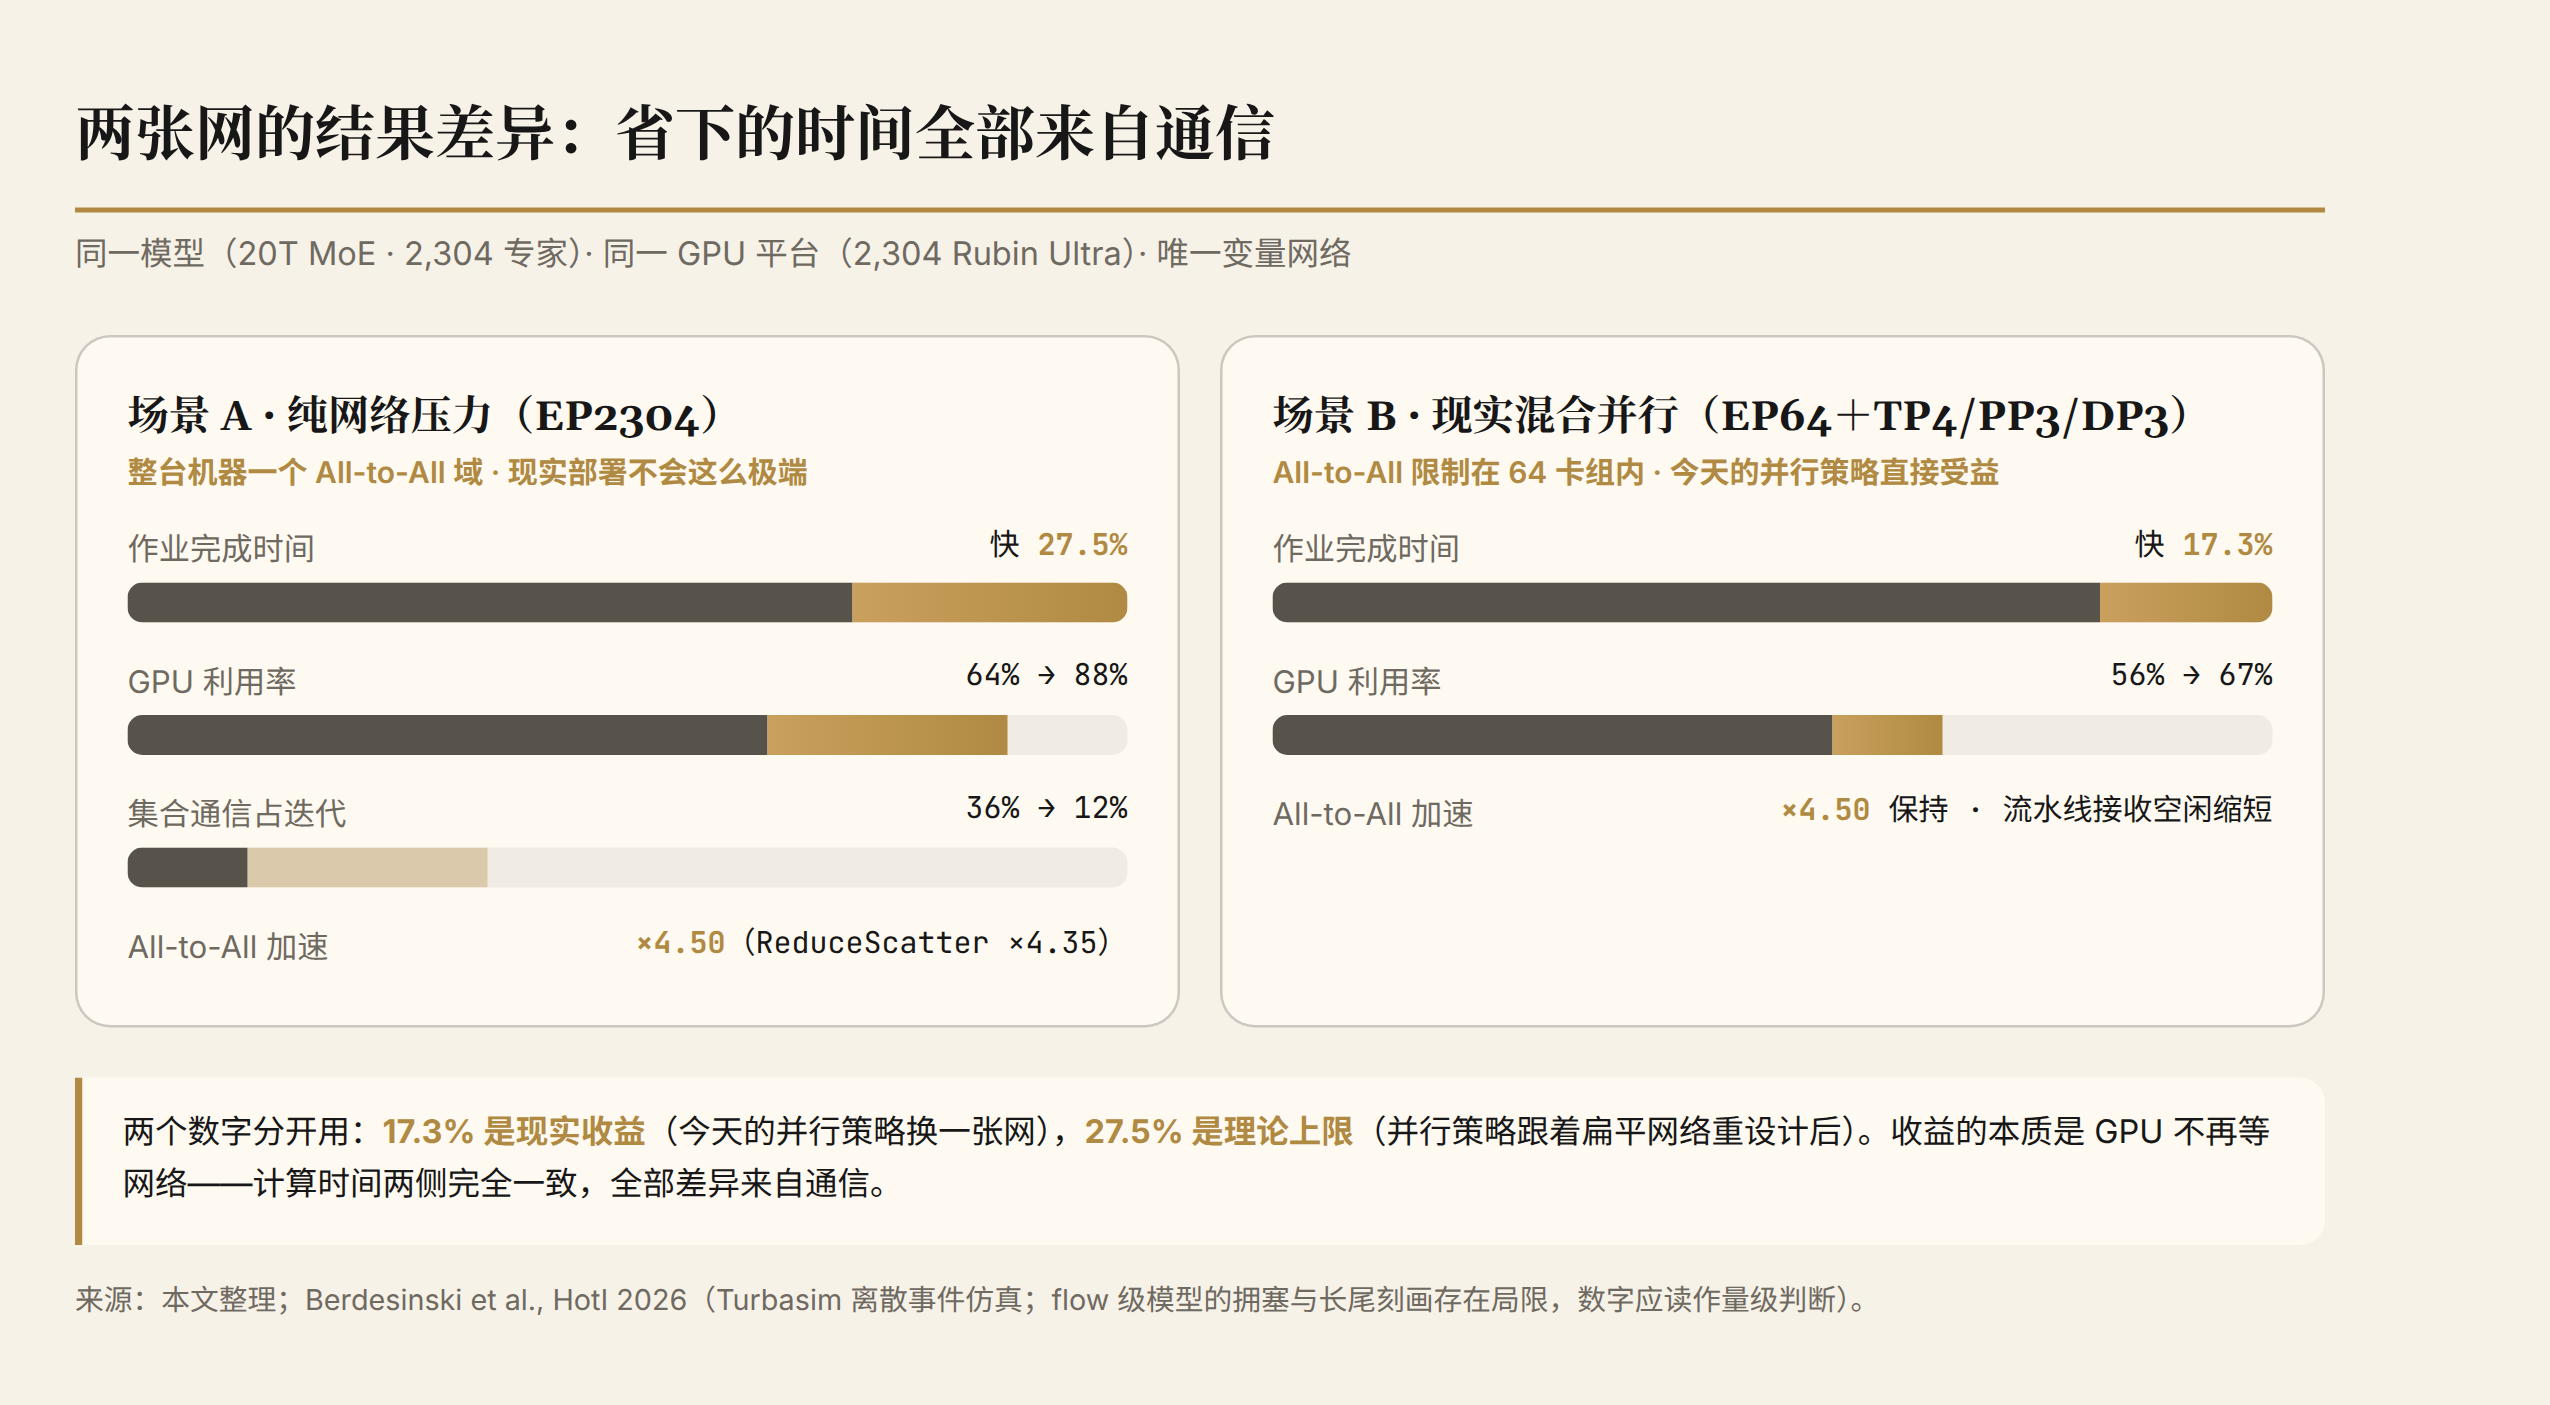
专家并行度拉满到 2304,整台机器构成一个 All-to-All 域,dispatch/combine 全部穿过 fabric。作业完成时间缩短 27.5%,每 GPU 平均运行时间从 32.66 秒降至 23.66 秒,GPU 利用率从 64% 升至 88%。All-to-All 加速 4.50 倍(ReduceScatter 加速 4.35 倍),集合通信占迭代时间的比例从 36% 降至 12%,其中 All-to-All 单项从约 27% 降到 10% 以下。
把百分比折算成秒,这组数字可以互相印证(本文推算):
| 基准网络 | Petabit 网络 | 变化 | |
|---|---|---|---|
| 每 GPU 运行时间 | 32.66 s | 23.66 s | −9.0 s(−27.5%) |
| 计算时间(运行时间 × 利用率) | ≈20.9 s | ≈20.8 s | 基本不变 |
| 集合通信时间(× 占比) | ≈11.8 s | ≈2.8 s | −9.0 s |
| 其中 All-to-All | ≈8.8 s | ≈2.0 s(按 4.5 倍) | −6.8 s |
| 其余集合通信 | ≈3.0 s | ≈0.8 s | −2.2 s |
从这张表可以读出三点:
- 「计算时间相同」在数字上成立。 两边折算出的计算时间都约 20.8–20.9 秒,节省的 9 秒几乎全部来自集合通信。
- 运行时间 = 计算 + 暴露的通信。 64% + 36% 和 88% + 12% 都正好等于 100%,说明这里统计的是没被计算掩盖的通信时间(推测)。如果实际系统做了更激进的计算—通信重叠,基准网络的损失会小一些,收益也会相应缩小。
- All-to-All 是主要矛盾,但不是全部。 节省的 9 秒中约 6.8 秒来自 All-to-All,其余约 2.2 秒来自 ReduceScatter 等集合通信。
4.2 为什么恰好是 4.50 倍
All-to-All 的加速比是 4.50 倍,恰好等于基准网络中架内与跨架带宽之比 28.8T ÷ 6.4T = 4.5。这很可能不是巧合(本文推算):
- 场景 A 中,2304 个专家均匀分布在 16 个机架上。在路由均衡的前提下,某个 token 选中的专家落在本机架的概率只有约 143/2303 ≈ 6%,约 94% 的 dispatch 流量必须跨机架。
- 这样一来,基准网络的 All-to-All 几乎完全受限于每个 GPU 6.4T 的跨架注入带宽;换成 Petabit 网络后,这个上限变成 28.8T,通信时间按带宽比缩短 4.5 倍。
加速比与带宽比完全吻合,说明在这个仿真里,All-to-All 的瓶颈是带宽,而跳数和时延的影响相对次要(推测)。这一点也提示了解读边界:如果真实网络里的拥塞和尾时延比 flow 级仿真刻画的更严重,扁平网络的实际收益可能比 4.5 倍更大;反之,如果基准网络通过拓扑感知的专家放置把更多流量留在机架内,收益则会变小。
4.3 场景 B:接近现实的部署
专家并行限制在 64 卡组内,采用 TP4/PP3/DP3 混合并行,All-to-All 不跨组。作业完成时间缩短 17.3%,每 GPU 平均运行时间从 48.04 秒降至 39.72 秒,利用率从 56% 升至 67%,All-to-All 同样加速 4.50 倍。
并行维度的乘积正好是 TP4 × PP3 × DP3 × EP64 = 2304,说明 EP64 是独立于其他三个维度的一维。一个 64 卡的 EP 组本来放得进 144 卡的机架,All-to-All 却同样加速了 4.50 倍。论文幻灯片标注了原因:TP 留在 NVLink 上,EP、PP、DP 都跨机架。按 TP4 占据相邻 GPU 推算,一个 EP 组会跨越 4 × 64 = 256 个 GPU 位置,超过单个机架的 144 个(GPU 具体映射论文未给出,此为本文推算)。
场景 B 没有在幻灯片中给出分项拆解,但可以从两个总数反推(本文推算,按基准运行时间 = 100 归一):
| 基准网络 | Petabit 网络 | |
|---|---|---|
| 运行时间 | 100 | ≈82.7 |
| 计算时间 | 56 | 56 |
| 非计算时间 | 44 | ≈26.7 |
| 非计算时间削减比例 | — | ≈39% |
(按 17.3% 推算,新利用率约 67.7%,与幻灯片的 67% 在四舍五入误差内一致。)
对比两个场景:场景 A 中非计算时间被削减了约 76%(11.8 秒 → 2.8 秒),场景 B 只削减了约 39%。这说明场景 B 剩下的开销里,有很大一块不是 All-to-All,扁平网络帮不上忙。可能的来源包括 PP3 带来的流水线气泡,以及原本就走 28.8T NVLink、换网后带宽不变的 TP 通信(推测)。
4.4 两个场景合起来看
- 17.3% 和 27.5% 含义不同。 17.3% 是沿用今天的并行策略、只更换网络所能获得的收益;27.5% 则是并行策略随之重新设计后的上限。
- 一个容易被忽略的细节: 即便在基准网络上,场景 A(64%)的利用率也高于场景 B(56%);换成扁平网络后,差距拉大到 88% 对 67%。两个场景的并行配置不止 EP 一处不同,利用率不能简单横比。但这至少提示,网络一旦拉平,「宽 EP、少流水线」的并行方式可能显著优于今天的主流配置。这也正是论文把「重新平衡 TP/EP/PP/DP」列为未来工作的原因之一。
- 收益的本质: GPU 等待通信的时间减少,集合通信占用的迭代时间从约三分之一降到约十分之一。
4.5 经济账与连带收益
论文还算了一笔经济账:在 Colossus 1 规模(约 20 万 GPU)的集群上,利用率从 64% 提高到 88%,按每有效 GPU 小时约 3 美元的隐含成本折算,相当于每年多出约 13 亿美元的有效算力。核算:20 万 × 8760 小时 × 24 个百分点 × 3 美元 ≈ 12.6 亿美元,与论文口径一致。需要注意,这笔账用的是场景 A 的利用率提升,而且把 2304 卡的仿真结果线性外推到了 20 万卡,应视为数量级估算。
此外还有连带收益:专家并行度提高后,每张卡驻留的专家参数减少,HBM 占用下降。场景 B 里 64 卡一组,每卡每层驻留 36 个专家的参数;专家并行开到 2304 后,每卡每层只驻留 1 个。每卡驻留的专家数与 All-to-All 通信量是一对直接挂钩的取舍:通信变便宜后,把专家放得更散就变得划算,省出的显存可以另作他用。
交换机数量也从 928 台降到 72 台。论文幻灯片的说法是「设备数量减少超过 80%」,按跨架 CLOS 的 352 台对 72 台计算约为 80%;把同时被取代的 576 台 NVSwitch 也算上,全网口径是 928 台对 72 台,减少 92%。公众号转述的「72 台取代 352 台」用的就是前一个口径,漏掉了被扁平 fabric 一并吃掉的 NVSwitch 层。不过交换机少了不等于成本同比下降:单台 1P 交换机的复杂度、光学封装和功耗都远高于今天的设备,论文没有给出整网成本或功耗的对比。
五、论文说明了什么,没说明什么
把上面的拆解收拢一下:
论文较有说服力地说明了:
- 在同等计算条件下,网络结构本身就能带来 17–28% 的作业完成时间差异,而且数字内部自洽(计算时间守恒、加速比与带宽比吻合)。
- 对 MoE 训练而言,基准网络的核心瓶颈是「机架边界」处的带宽断崖(28.8T → 6.4T),而不是总带宽不足。
- 扁平网络会打开并行策略的设计空间,单纯换网只能拿到收益的一部分。
论文没有回答、或回答得有限的:
- 对照组是否最强。 基准网络的跨架带宽是 6.4T。如果对照组换成跨架带宽更高的方案(例如更大的 scale-up 域、NVL576 一类的设计,或增加 scale-out 带宽),差距会缩小多少,仿真没有给出。
- 拥塞与尾时延。 flow 级仿真对多层网络中的 incast、拥塞扩散和长尾刻画有限,而这恰恰是多层网络最吃亏的地方。实际差距可能更大,也可能因为精细的拥塞控制而更小。
- 路由负载不均。 推算中假设专家路由均衡。真实 MoE 训练中的热点专家会产生不均匀流量,两张网络对它的承受能力可能不同。
- 成本、功耗与可靠性。 72 台 1P 交换机的整网功耗、单台故障的影响范围(每台交换机连着全部 2304 个 GPU),论文没有展开。
- 规模外推。 2304 卡是单个扁平域的规模;到 20 万卡时,扁平域之间仍需要 scale-out 网络,这部分如何连、收益还剩多少,不在本文范围内。
六、产业侧的跟进
这条路线并未止步于论文。2026 年 10 月,高基数交换芯片公司 Eridu 结束隐身,累计融资 2.3 亿美元。其超额认购的 A 轮由 Socratic Partners 领投,John Doerr、Hudson River Trading 和 Capricorn 跟投,产业资本包括 MediaTek、TDK Ventures 和 Bosch Ventures。创始团队出自光通信和芯片行业:CEO Drew Perkins 是 Infinera 联合创始人兼首任 CTO(Infinera 于 2025 年以 23 亿美元被诺基亚收购),此前还创办过后来被 Ciena 收购的光交换公司 Lightera;联合创始人、CMO Mike Capuano 同样来自 Infinera;另一位联合创始人 Omar Hassen 出身于 Broadcom 和 Marvell 的网络芯片设计团队。
Eridu 的产品方向与论文设想一致:采用全新设计(clean-sheet),基数与吞吐提升一个数量级,官方口径是「一台取代 30 台低基数交换机」。作个对照:论文里两张网的全网交换机比例是 928:72,约 13 倍;只看跨架 CLOS 是 352:72,约 5 倍。「30 台」是三个数字里最激进的说法,引用时注意分母。在 AI Infra Summit 的赞助材料中,Eridu 直接引用了 Turbalance 这项仿真的结果图。不过,营销材料把「利用率提高 24 个百分点」写成了「利用率提高 38%」,后者是 64% 到 88% 的相对增幅,引用时需要注意换算。
Turbalance 本身的业务是 AI 负载仿真与编排软件,这篇论文同时也是其仿真器的能力展示。LBNL 一方的作者中,John Shalf 是 LBNL 计算机科学部门负责人(Department Head),曾任美国能源部百亿亿次计算项目(ECP)硬件技术副主任;George Michelogiannakis 是扁平拓扑 Dragonfly+ 的共同作者,网络扁平化一直是两人的长期研究方向。围绕这一议题,OCP 基金会与 650 Group 联合举办了「network wall」研讨会;替代路线也在同期获得资金:光路交换(OCS)公司 nEye Systems 完成 5800 万美元 B 轮融资,Salience Labs 发布了 32 端口全光 OCS,光子互连公司 Lightmatter 则在同届 HotI 上给出了训练时间改善 3 倍的口径。
学术论证、创业公司和行业组织在同一个季度里集中出现,这在通常渐进演进的网络设备行业并不多见。
七、硬件约束:大概率绕不开 CPO
5120 条 200G 通道首先是一个物理封装问题。当前 102.4T 芯片的 512 条通道已逼近电接口可插拔光模块的密度极限,通道数再乘以十,交换机面板根本放不下这么多光口。因此,1P 级交换机大概率要采用共封装光学(CPO)或近封装光学(NPO),把光引擎和交换芯片封装在一起。这也解释了市场为何看好 Eridu 团队的光通信背景,以及 MediaTek、TDK、Bosch 等产业资本为何入局。
工程挑战不少。按每比特约 1 皮焦耳的 SerDes 能效计算,单台交换机仅 SerDes 一项功耗就接近 1 千瓦;72 台 1P 交换机所需的激光源总功率和可靠性设计,是一项全新的系统工程;约 5000 条通道的大裸片还需要靠冗余通道设计来对冲良率风险。乐观估计,这类芯片也要到 2028–2030 年才可能量产,与论文 2028–29 年的模型设定大体吻合。
这条路线之外还有其他走法。OCS 光路交换不追求全互联,而是按需重构拓扑,Google 已在 TPU 集群中使用多年,创业公司则有 nEye 和 Salience。另一条路是继续扩大 scale-up 域,NVL576、NVLink Fusion 和 UALink 正把单跳域从机柜扩展到整排机柜。再加上 Lightmatter 这类直接改变互连介质的光子 fabric,四条路线背后的判断是相同的:网络将是未来十年的瓶颈。
八、软件影响:并行策略的调整空间
更换网络不只影响通信速度,也会改变并行策略的选择。论文把「重新平衡 TP/EP/PP/DP」列为未来工作,第四节的拆解也说明了原因:场景 B 中约六成的非计算开销没有被扁平网络消除,要拿到剩下的收益,得靠并行策略本身的调整。当所有 GPU 封装彼此等距(1 跳、时延一致)时,张量并行不必再局限于 NVLink 域内,专家并行域可以开得更大,流水线并行的级数也可能减少,从而压缩气泡。场景 B 把 TP 留在 NVLink 上是基于今天网络的保守选择,到了扁平网络中未必仍是最优解。
一批针对多层拓扑的优化会因此简化。拓扑感知路由,以及 expert placement 与通信量最小化的联合优化(以 DeepEP 为代表的通信库就包含这类工作),在全网等距的 fabric 中失去了需要「感知」的对象。与此同时,另一些问题的分量会上升:72 个平面之间的负载均衡,以及拥塞控制与交换机 buffer 深度的协同设计,论文已明确列为下一步工作。推理侧还有一条平行的受益路径:prefill/decode 分离部署时,集群之间的 KV 缓存传输同样是 All-to-All 型负载,论文也将其列入未来工作,这方面的产业需求可能比训练侧来得更早。
观察点
- 网络墙已有隔离变量的证据,但具体数字受限于仿真模型。 在第一批实物验证(如 Eridu 样片或某家超大规模厂商的原型网络)出现之前,17% 应当被视为量级判断,而非性能承诺。
- 对照组的选择决定差距大小。 本研究的收益主要来自消除 28.8T → 6.4T 的跨架带宽断崖。更大 scale-up 域或更高 scale-out 带宽的方案能把这道断崖填平多少,是评估这条路线的关键对照。
- 高基数路线的时间表取决于光学封装。 CPO 的良率、激光器功耗和成本曲线将决定这条路线的推进速度。
- 后续可跟踪三个信号:Eridu 首款产品的实际基数规格;Broadcom 与思科的下一代 ASIC 能否突破「仅翻约 2 倍」的基数假设;MoE 专家数(从 896 迈向 2000 以上)与单跳域规模之间的相互追赶。
最后记一个脚注:这篇论文经公众号转述时,Colossus 1 的规模被从 20 万卡误写成 2 万卡,而「每年约 13 亿美元」的结论仍照原数出现,失去了计算依据。二手转述的数字,引用前值得回查一次原文。本文涉及论文的数字均已与会议幻灯片逐一核对,也是出于这个原因;标注为「本文推算」的部分是在这些数字基础上的推导,并非论文原文结论。
信源
- P. Berdesinski, L. Montigny(Turbalance),J. Shalf, G. Michelogiannakis(LBNL):Breaking Through the Network Wall: Petabit-Class Switching for Single-Hop MoE Training at Scale,IEEE Hot Interconnects 33(HotI 2026,2026-08);数据取自会议官方幻灯片(hoti.org)
- 光芯纪公众号《Turbalance:通过大基数交换机突破「网络墙」》(2026-11,转述稿;其中 Colossus 规模的笔误已在本文更正)
- Eridu 结束隐身新闻稿(Business Wire,2026-10)及 AI Infra Summit 2026 赞助材料;LinkedIn 公司页及 Mike Capuano 的 OCP EMEA 演讲页
- LBNL AMCR 官方人员页(John Shalf 职务与 ECP 履历)
- nEye Systems B 轮融资(GlobalData/Verdict);Salience Labs 32 端口 OCS 发布(Business Wire,2026-03);Lightmatter HotI 2026 演讲材料
- SemiAnalysis 关于 Kimi K3 服务域的报道(经论文幻灯片转引);Llama 4 Maverick 参数(Meta 公开材料)
相关阅读:《网卡解体》《AI 数据中心网络演化》《华为的一张网:HC 2026 网络全景》