
2026 年 11 月,两件事值得放在一起看。
第一件来自 Astera Labs 的三季度财报电话会。这家以高速连接器件起家的公司说:在负载最高的系统里,它的 fabric 交换与铜缆信号调理两类产品加起来,平均每颗 XPU(加速处理器)已能带来超过 1000 美元;下一代平台仅 AI fabric 产品一项,单颗 XPU 价值就"远超 1000 美元"。注意这笔钱的主人——scale-up 交换芯片和信号调理器:一家不卖网卡的公司,把网络硅生意做到了每颗加速器上千美元。
第二件来自 Broadcom:Thor Ultra——博通称之为业界第一张按 UEC(超以太网联盟,Ultra Ethernet Consortium)规格设计的 800G AI 网卡——自 2025 年 10 月发布并送样至今(商用供货时间未公布),与 Tomahawk 6 交换机、Arista 的 800G Etherlink 交换机组成了开放阵营的第一套完整网络栈。
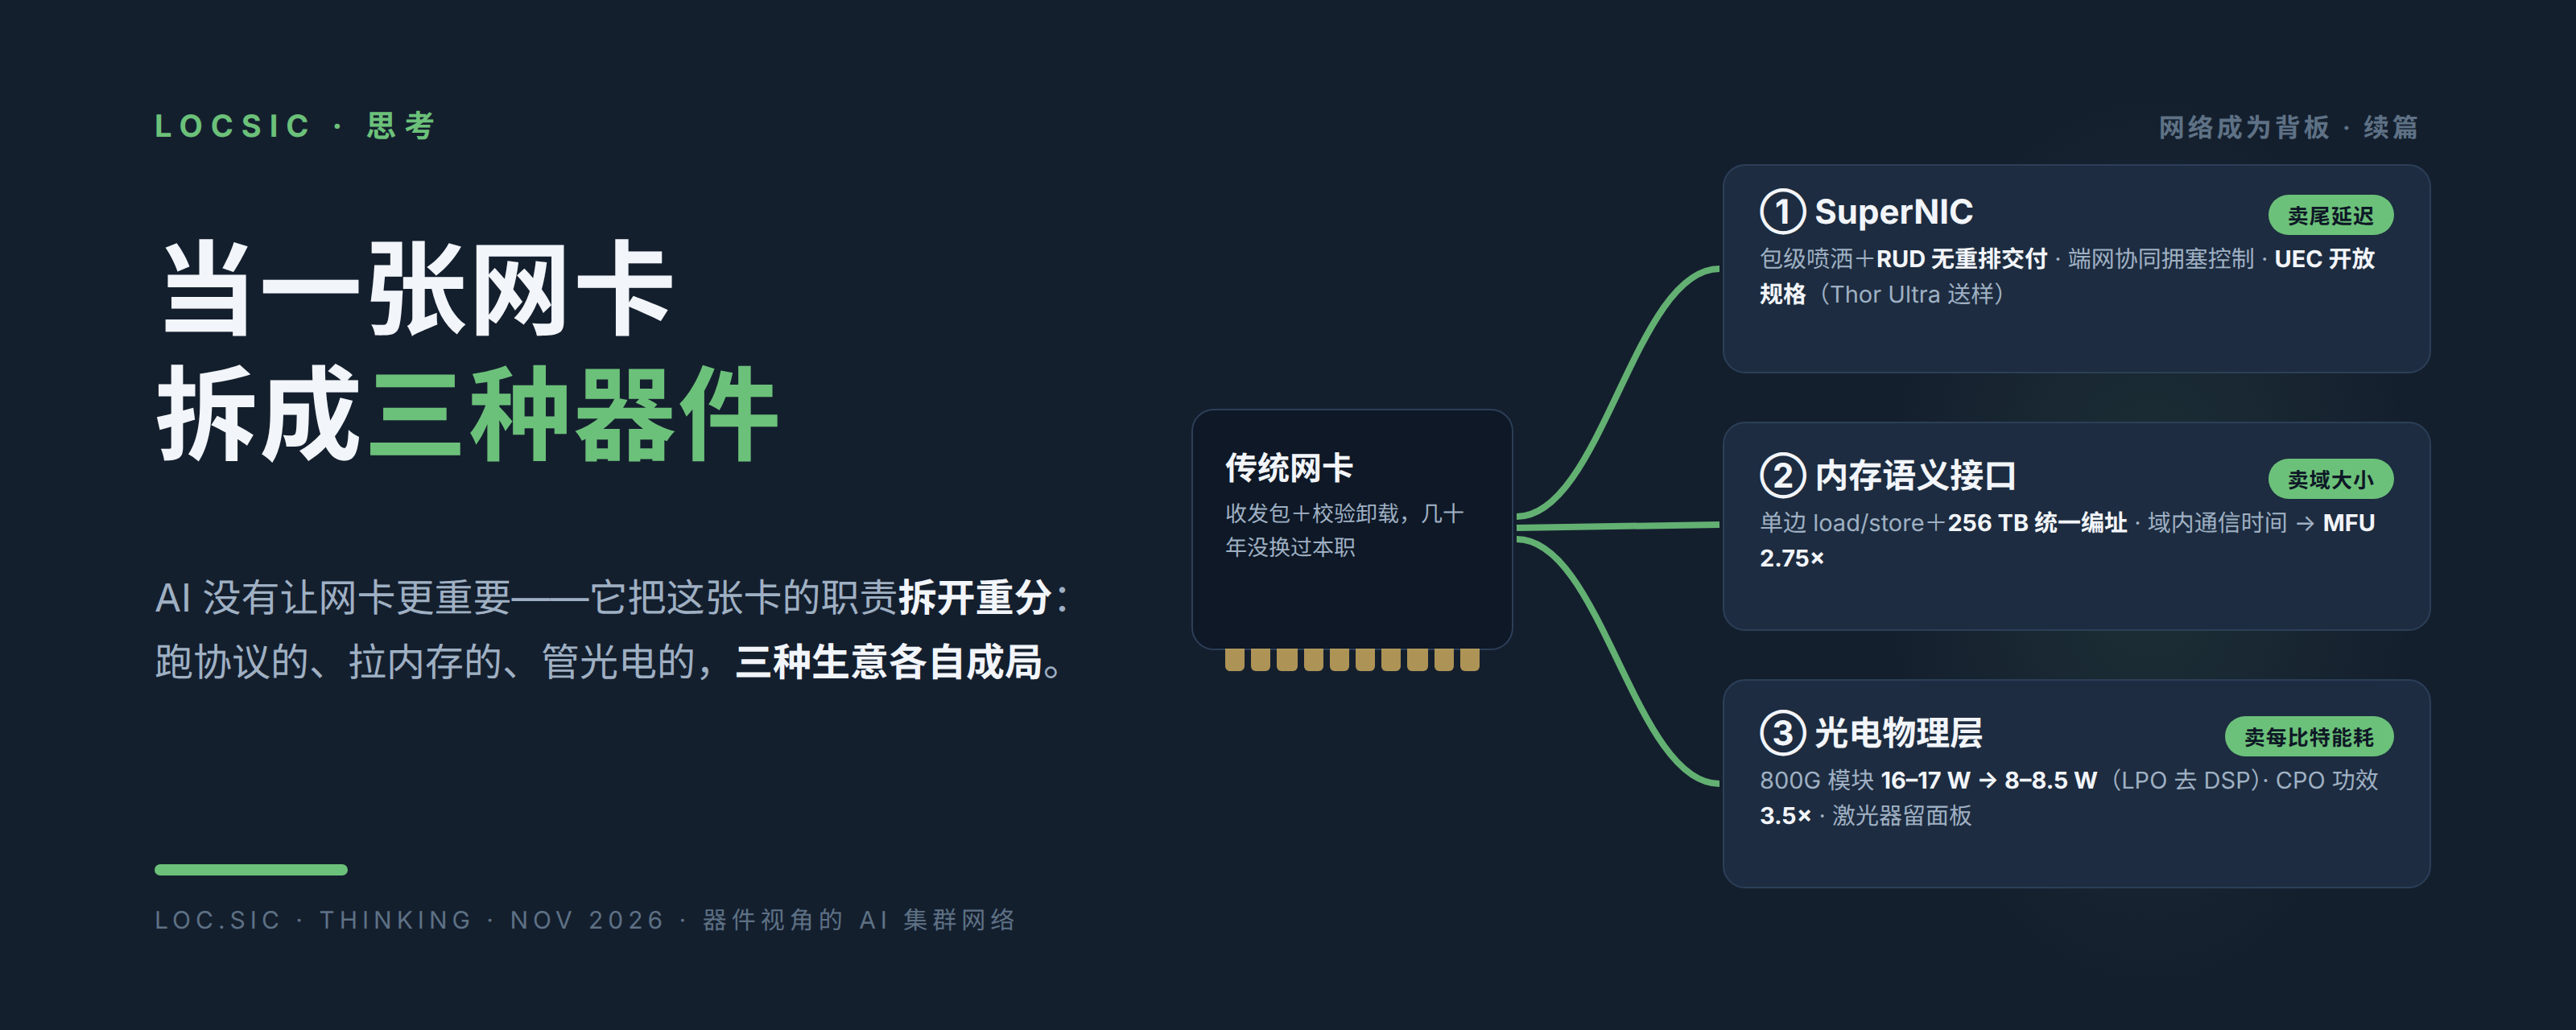
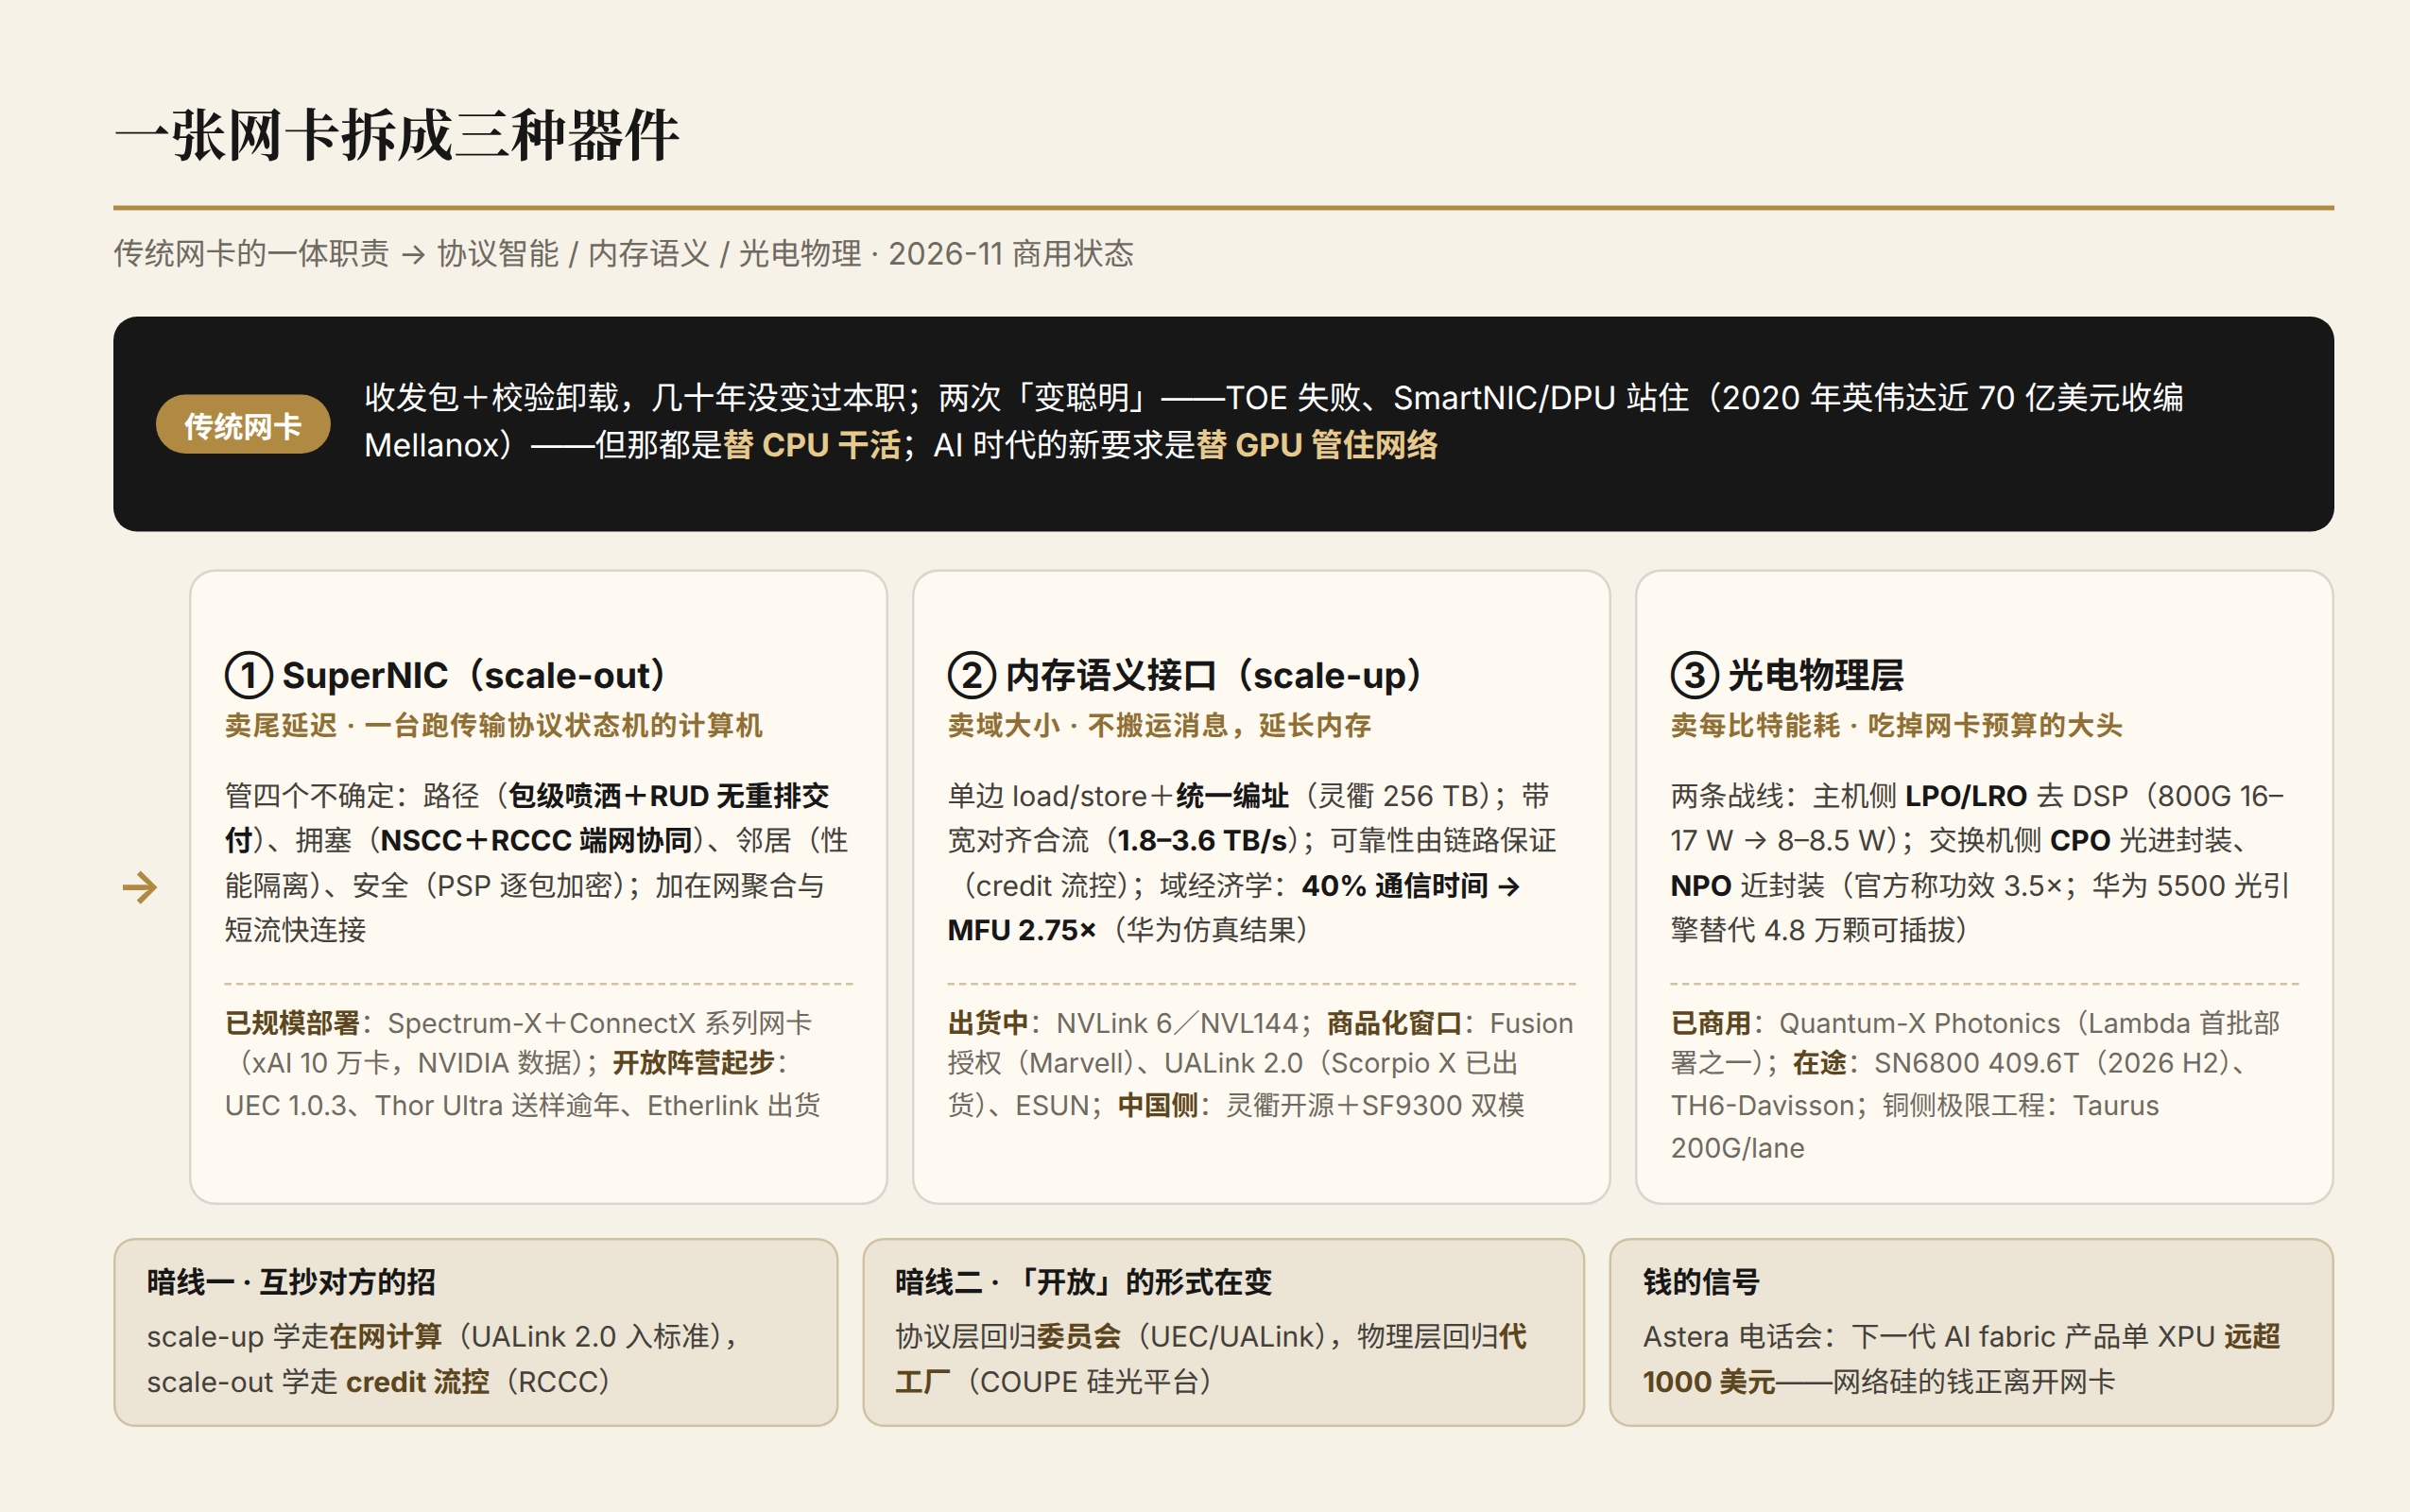
两件事指向同一件事:网络的功能和预算,正在三类器件之间重新分配。 这不是一张物理网卡被拆开——scale-up 接口从来长在加速器封装里,光模块一直是独立部件——而是"网卡"这个词原先覆盖的职责与价值,如今由三种各自演进的器件分担:跑传输协议状态机的 SuperNIC、暴露内存语义的 scale-up 接口、专管光电转换与信号完整性的物理层部件。三种功能、三种生意,竞争格局各自成局。
本文分四步:先讲背景——网卡这个部件几十年的惯性,以及 AI 负载怎么一步步改写它的功能清单;然后逐一拆解三种器件的机制原理和 2026 年 11 月的商用状态;最后给判断。其中几个战场我们此前单独深潜过——scale-up 互联的开放之战、博通与英伟达的网络芯片对标、华为 HC 2026 的网络全景——本文把镜头拉回器件本身:插在 XPU 旁边的那张卡,正在变成什么。
一、几十年搬运工,和 AI 逼出来的新功能清单
网卡长期是服务器里最没有故事的部件。从十兆以太网到 400G,它的职责几乎没变:把数据包搬进搬出,顺手替 CPU 做点校验和。它有过两次"变聪明"的尝试。第一次是 2000 年代初的 TOE(TCP 卸载引擎),把协议栈处理从 CPU 搬进网卡——当时的判断是通用 CPU 的性能快到头了。CPU 没有到头,TOE 失败了:通用处理器的迭代速度、生态兼容性和灵活性,让专用卸载逻辑的性价比再也没能追上。第二次是 2010 年代末的 SmartNIC/DPU:把存储、虚拟化、加密这类"基础设施的活"从主机 CPU 卸载到网卡上的可编程芯片。这一波站住了,标志性事件是英伟达在 2020 年以近 70 亿美元收编 Mellanox,同时拿到 InfiniBand 专网和 ConnectX 网卡两条产品线;AMD 收 Pensando、微软收 Fungible 跟进。
但 DPU 时代的"智能",本质是替 CPU 干基础设施的活。AI 时代对网卡的要求是另一回事:替 GPU 管住网络的病。这个转折由两波负载推动。
第一波是训练。大规模训练的通信主体是集合通信——成百上千张卡每一步都要互相同步梯度。网卡从附属件变成每颗 GPU 的标配:在主流参考设计里,一张 GPU 对应一张网卡(rail-optimized,轨道优化架构),网络必须"无损"——一次丢包重传意味着一次集体等待,延迟抖动直接吃掉有效算力。这个市场先是 InfiniBand 专网的天下;以太网阵营要把它夺回来,2023 年 Meta、AMD、微软、Broadcom、Arista 等发起 UEC,目标就是把 InfiniBand 级别的确定性做成以太网上的开放标准。
第二波是推理,它改写的是通信的模式。今天的前沿模型多是 MoE(混合专家)架构,专家并行让主要通信从 all-reduce 变成 all-to-all:每一层路由都要在全集群范围内把 token 发给分布在不同卡上的专家,短消息、全网状、微秒级完成,对尾延迟极其敏感。推理基础设施又普遍采用预填充/解码分离(prefill-decode disaggregation):处理提示词的算力池和逐 token 生成的池分开部署,两者之间每服务一个请求都要搬运一次 KV cache——海量短流直接压在"首 token 延迟"的关键路径上。网络学术圈已经开始为这件事单独立题:SIGCOMM 2026 的 NIAC(面向 AI 计算的网络)研讨会上,出现了专门研究 KV 传输路由碰撞的论文(ARK,仿真中 P95 流完成时间最多降 34%)。应用层的证据同样直接:vLLM 在今年 10 月引入 push 式 KV 传输,把传输前的调度准备从关键路径上拿掉后,首 token 延迟显著改善——AWS 在 P5en 上的实测是重载下最多降到约原来的三分之一(约三倍改善),轻载下两种模式接近——前提是网卡支持 GPUDirect RDMA(绕过 CPU 直写显存)。
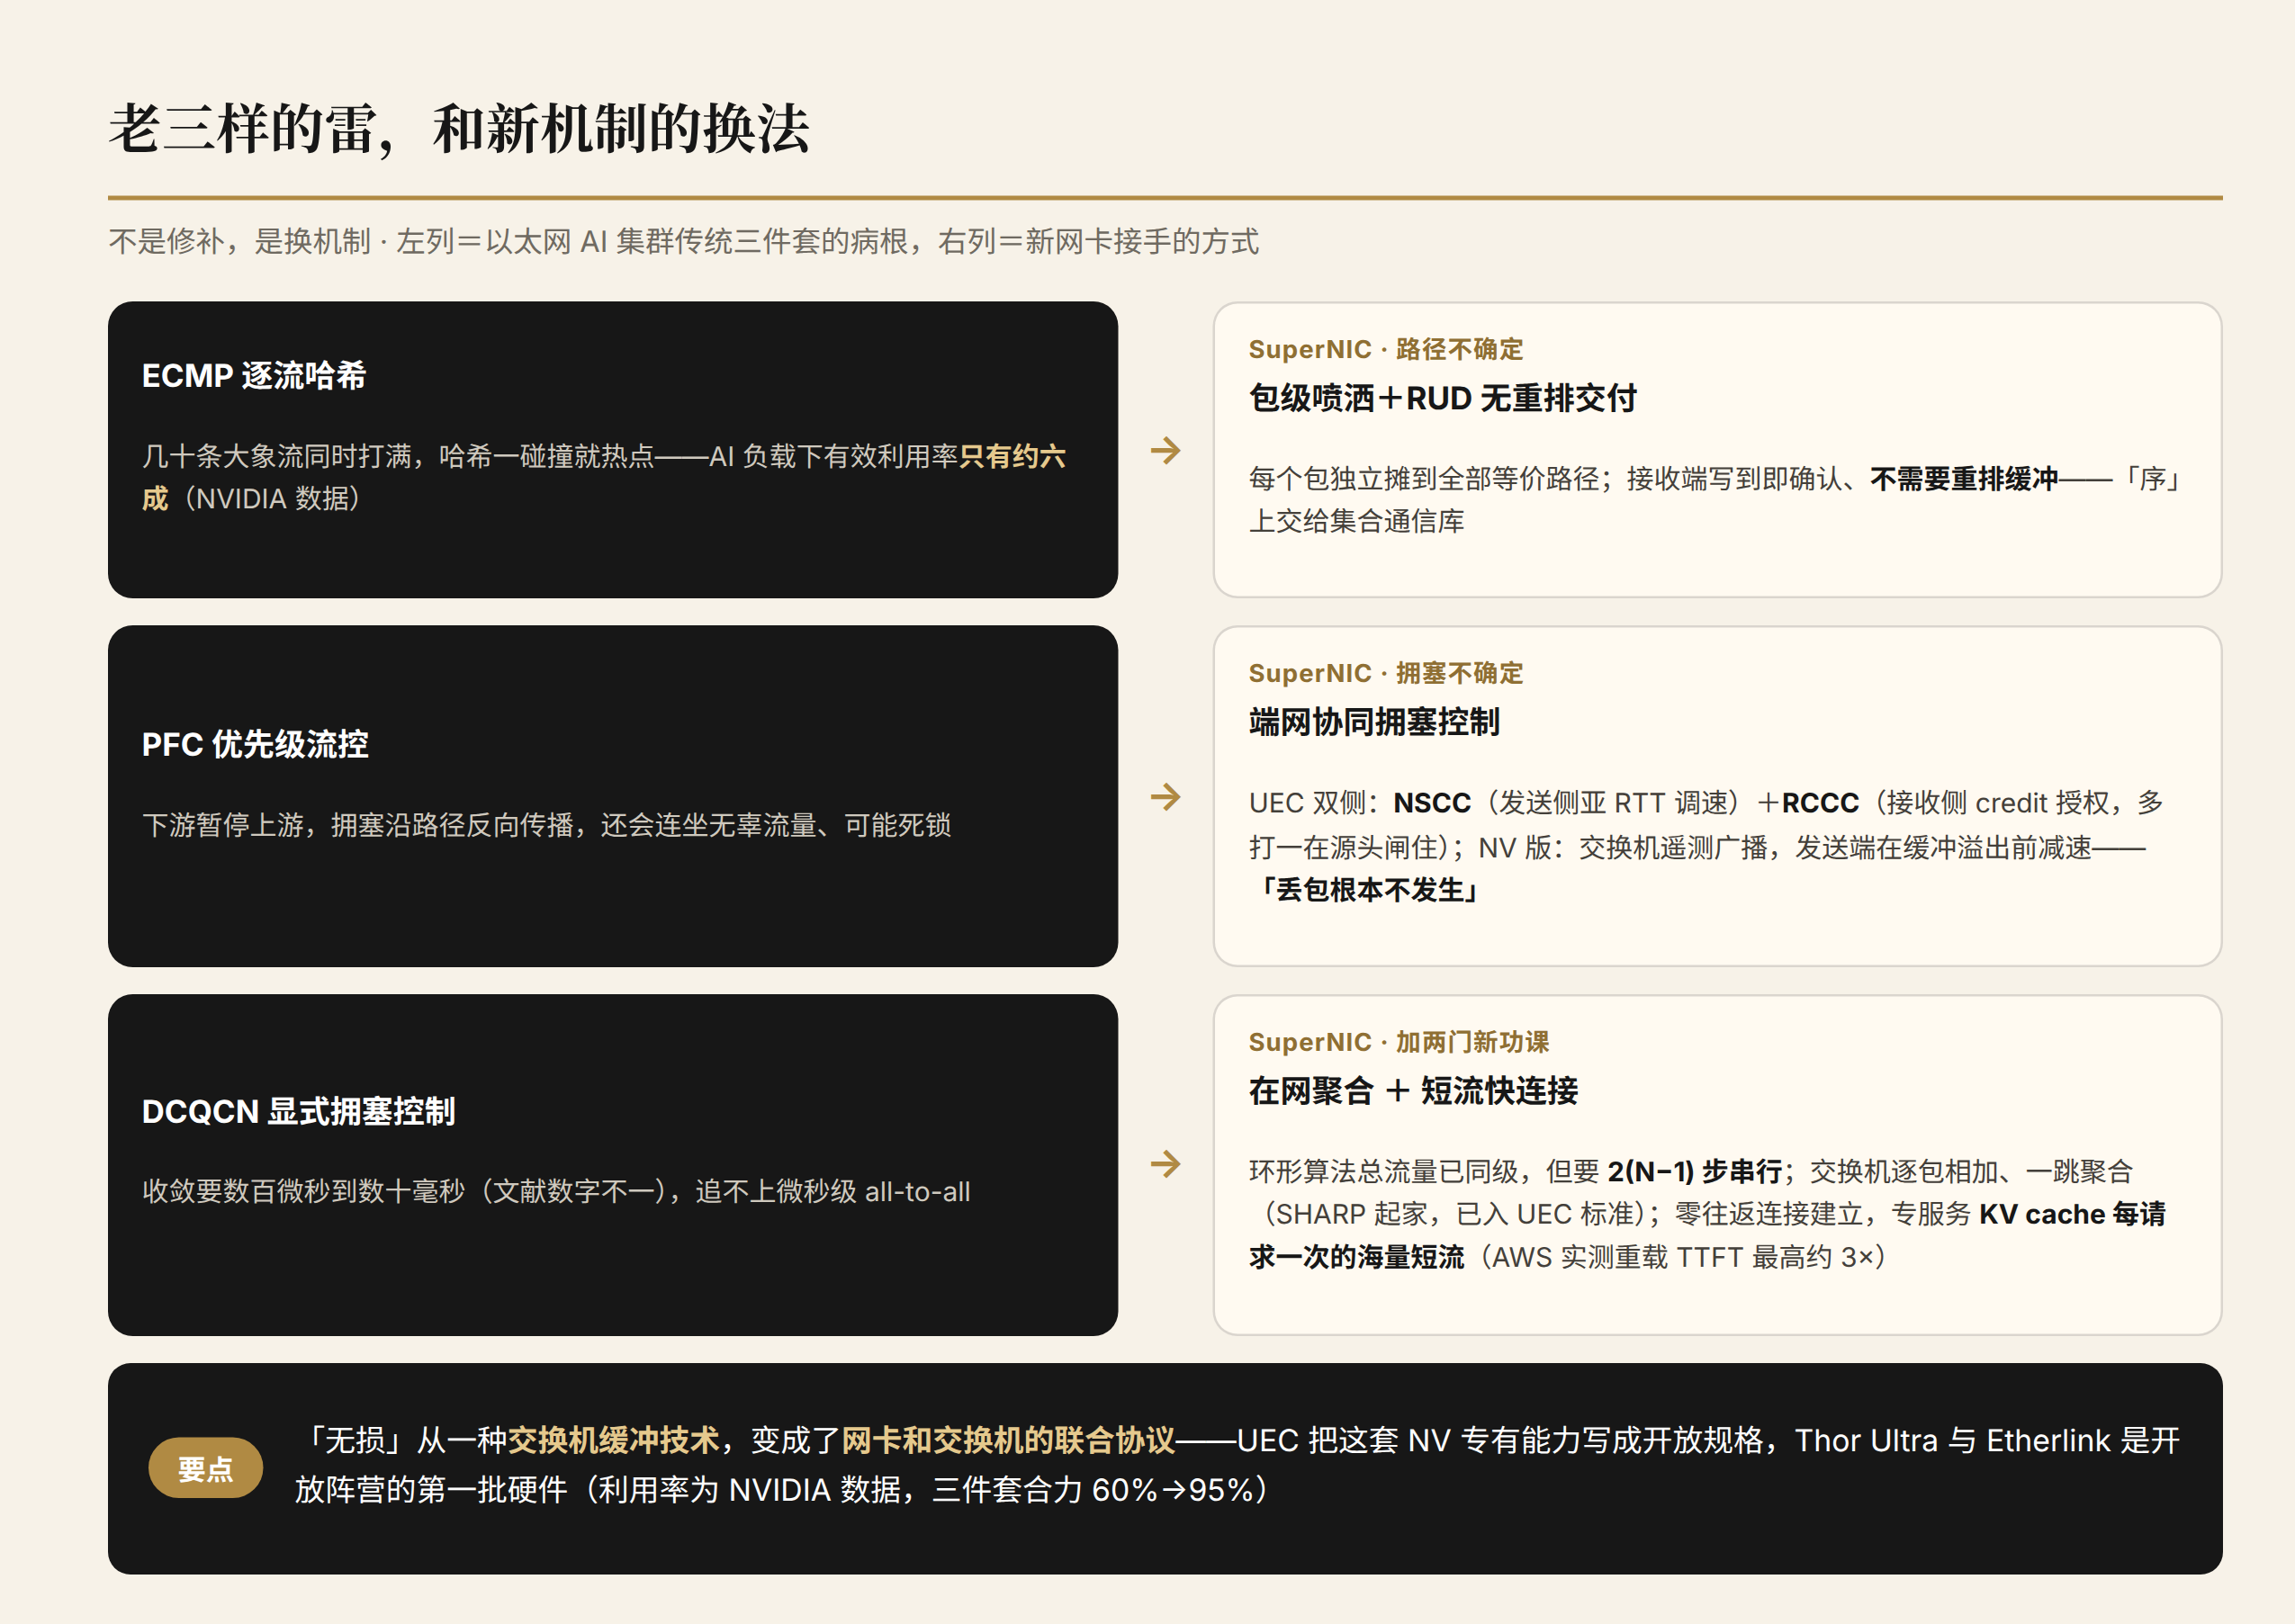
老网卡为什么接不住?以太网 AI 集群的传统三件套各有一颗雷。ECMP(等价多路径路由)按流哈希选路,而 AI 通信是几十条大象流同时打满,哈希碰撞就出热点——英伟达的口径是标准以太网在 AI 负载下有效利用率只有约六成。PFC(优先级流控)为了不丢包让下游暂停上游,拥塞沿路径反向传播,还会连坐无辜流量。DCQCN(基于显式拥塞通知的拥塞控制)收敛慢——文献口径从数百微秒到数十毫秒不等——追不上微秒级的 all-to-all。三颗雷决定了新功能的方向:不是修补,是换机制——连"无损"这个要求本身,都在被重新定义。
二、第一种器件:SuperNIC,管住四个不确定
Scale-out(跨机架、跨 Pod 的网络)侧的新网卡,业界已经给它起了新名字:SuperNIC。它可以概括为一台跑传输协议状态机的专用计算机,职责是替 GPU 管住网络里的四个不确定。
路径不确定——包级喷洒,加无重排交付:老 ECMP 按流选路,新机制按包选路:一个流的包摊到全部等价路径上,热点无处形成——前述六成到九成五的利用率差距,喷洒是最直接的贡献项(九成五是英伟达对 Spectrum-X 三件套合力的口径)。代价是接收端大量乱序,交付语义必须重做。UEC 规格里定义了一族交付语义,代表是 RUD(可靠无序交付):每个包自带偏移量,接收端写到即确认,不需要重排缓冲区。传统 RDMA(可靠连接模式)的交付语义要求保序落地,重排缓冲是延迟和内存的双重放大器;把"序"从传输层挪给上层(集合通信库天然不挑包序),这个放大器就消失了。
拥塞不确定——端网协同的拥塞控制:incast(多打一)是 all-to-all 的固有病。UEC 1.0 定义了双侧机制:发送侧拥塞控制(NSCC)基于往返时延和显式拥塞标记做亚往返时延的调速;接收侧(RCCC)本质是信用量授权——接收端把可用缓冲折算成信用反馈给发送端,有信用才发,拥塞在源头被闸住。两者可以单独或同时运行。英伟达的专有实现思路同向:交换机把拥塞遥测广播给网卡,发送端在缓冲区溢出之前减速,官方表述是"丢包根本不发生"。共同的要点是:"无损"从一种交换机缓冲技术,变成了网卡和交换机的联合协议。
邻居不确定——性能隔离:多租户之下,"邻居的训练吃掉你的推理带宽"要靠两级公平解决:网卡侧按租户整形,交换机侧按队列调度。这在推理云场景是购买理由,不是可选项。
安全假设不确定——逐包的传输层安全:UEC 把"安全作为与传输协同设计的一等公民"写进规格,落地形态是逐包认证加密(PSP 协议族):每个包独立验证,不依赖流级的路径状态,因此与喷洒兼容——每个包可以走不同的路。
再加两门新功课。一是在网聚合(in-network collectives)。实际部署的环形 AllReduce 总流量已经是 O(N)——每个节点上传、下收各一份——但要串行走 2(N−1) 跳;在网聚合让交换机逐包相加,每个节点上传一份、收回一份聚合结果,把多跳串行变成一跳聚合。流量同级,步数与时延大幅下降——在尾延迟敏感的负载里,这是主要收益。这个思路从 InfiniBand 的 SHARP 起家,现在写进了 UEC 规格和博通的 Tomahawk Ultra 交换芯片。二是面向短流的连接管理:类似 TLS 1.3 的零往返思路,握手没完成先传首包数据,空闲连接零代价拆除——专门服务 KV 搬运这种每请求一次的海量短流。
商用快照(2026 年 11 月):英伟达的专有栈最成熟——800G 的 ConnectX-8(InfiniBand/以太网双协议、PCIe Gen 6)是当前主力,Rubin 世代按英伟达口径将配 1.6T 的 ConnectX-9;网卡与 Spectrum-X 交换机构成"自适应路由+遥测拥塞控制+性能隔离"三件套,xAI 的十万卡 Colossus 是其标杆案例(以上均为英伟达口径)。开放阵营刚起步:UEC 1.0 于 2025 年 6 月发布,现行 1.0.3(2026 年 7 月),覆盖从软件到物理层的全栈——网卡、交换机、光模块、线缆都有规范,成员超过一百家;博通的 Thor Ultra 已送样一年(商用供货未公布),Arista 的 800G Etherlink 已出货;云厂商自研线(AWS 的 EFA 等)已有规模部署。结构性看点在于:UEC 把英伟达靠专有端网协同赚走的能力,变成了可采购的开放规格——以太网商品网卡第一次拿到与专有栈正面竞争的全套武器,上一次 RoCE 只拿到一半。
三、第二种器件:内存语义接口,把内存总线拉长
Scale-up(机架内、超节点内把多颗 XPU 拼成一台大机器)侧的"网卡"更彻底地不像网卡——它不搬运消息,它延长内存。三个机制定义了这种器件。
单边内存语义:消息语义(send/receive)是双边操作,两端软件都要参与;load/store 是单边操作,发起方直接读写远端地址,远端的 CPU 和 GPU 全程不参与。要做到这一点,前提是统一编址:华为的灵衢互联把 1024 卡的域编成一个 256 TB 的地址空间(含池化的统一编址口径,实装内存 147 TB),英伟达的 NVLink 构建一致性域——远端显存里的模型分片,访问起来像本地指针。
带宽对齐集合通信的量级:这种器件的每卡带宽是 1.8–3.6 TB/s——从在售 NVL72 到下一代 NVLink 6(每封装 3.6 TB/s),灵衢 950 每卡 2 TB/s——比当前 800G 的 scale-out 网卡(约 100 GB/s)大十几到三十几倍;即便对标 Rubin 世代 1.6T 网卡(约 200 GB/s),也仍高出一个量级。原因在经济学:集合通信每一步都在域内跑,域带宽直接乘出有效算力。这笔账分两层。一层是容量与时延:以 1024 卡超节点为例,域内实装内存 147 TB,可以放下几十份 V4 级、FP8 量化的 MoE 权重(约 2 TB/份,按 V4 级模型规格推算),专家并行的 all-to-all 全部圈在往返时延约 3 微秒的域内。另一层是组织方式的收益,用华为马尔科夫实验室的仿真口径:同样 10 万卡,按 4096 卡超节点组织相比按 8 卡服务器组织,MFU 提升 2.75 倍——参照系是传统架构里通信吃掉四成以上的训练时间。域的大小,直接换算成钱。
可靠性由链路保证,而不是端到端重传:信用量流控——接收方授权、发送方有信用才发——让包不在交换机里排队,链路时延收敛为传播加转发:博通口径,Tomahawk Ultra 在 51.2T 满吞吐下的转发延迟是 250 纳秒;链路级校验加重试兜底。链路短、误码可控,就不需要端到端的传输层重传状态机。
竞速快照:这个战场的格局此前深潜过(《NVLink 的护城河与裂缝》),这里更新三个时点。其一,英伟达在 2025 年 5 月把 NVLink 开放为 Fusion 授权生态——专有总线第一次对外发牌;Marvell 在 2026 年 3 月扩大合作,为 Fusion 做兼容的定制 XPU 和 scale-up 连接,英伟达并入股 Marvell 约 20 亿美元,双方合作延伸到硅光。其二,UALink(AMD 牵头发起、董事会九家共建的开放标准)从规格走到硅片:基于 1.0 规格的多厂商演示已经出现,2026 年 4 月又发布 2.0 与配套规格(在网计算、chiplet 接口、可管理性、200G 性能);Astera 的 320 通道 Scorpio X 交换芯片已向超大规模客户出货、2026 年下半年产能爬坡(官方口径,当前跑的是 Astera 自家的内存语义 fabric),Marvell 的原生 UALink 交换排在 2027 年。其三,以太网阵营的第三条路:博通把自家的 SUE-T 传输规格贡献给 OCP 的 ESUN(以太网 scale-up 网络)工作流,用以太网帧格式跑 scale-up,一套以太网生态同时吃两个市场。中国侧是独立的第四条:灵衢协议开源,HC 2026 发布的 SF9300 双模交换机支持 RoCE 与灵衢双路组网(华为口径:存量 RoCE 网卡可获得灵衢能力,价值主要在超节点边界内兑现)——与西方"必换智能网卡"的路子不同,它把兼容层放进了交换机。
新形态有三点值得记。scale-up 正从专有总线变成可采购生态,2026–2027 是商品化窗口,三条路线(授权、开放标准、以太网改造)全部在此窗口落地。UALink 2.0 把 chiplet 接口写进标准,同一套内存语义从机架级下探到封装之间。PCIe 阵营出现中间形态:Astera 的 Orion 用 PCIe 交换搭 8 到 160 卡的推理 pod(公司口径)——不换协议先要大域,是推理客户的务实选择。
四、第三种器件:光电物理层,DSP 的电费和铜的极限
第三类器件最不像"网卡",却正在吃掉网卡预算的大头:光电转换和信号完整性。
先算 DSP 的电费:可插拔光模块里,DSP(重定时芯片)是功耗最大的单项:800G 模块 16–17 瓦(三家器件商口径一致),英伟达口径的下一代模块要 20–25 瓦。一台 64 口的 51.2T 交换机,仅光模块就烧掉超过一千瓦,还没算交换芯片本身。AI 集群动辄几千条光链路,"光的电费"从网络预算变成了机架功率预算的一部分——光模块省下的每一瓦,都是可以拿去算力的每一瓦。
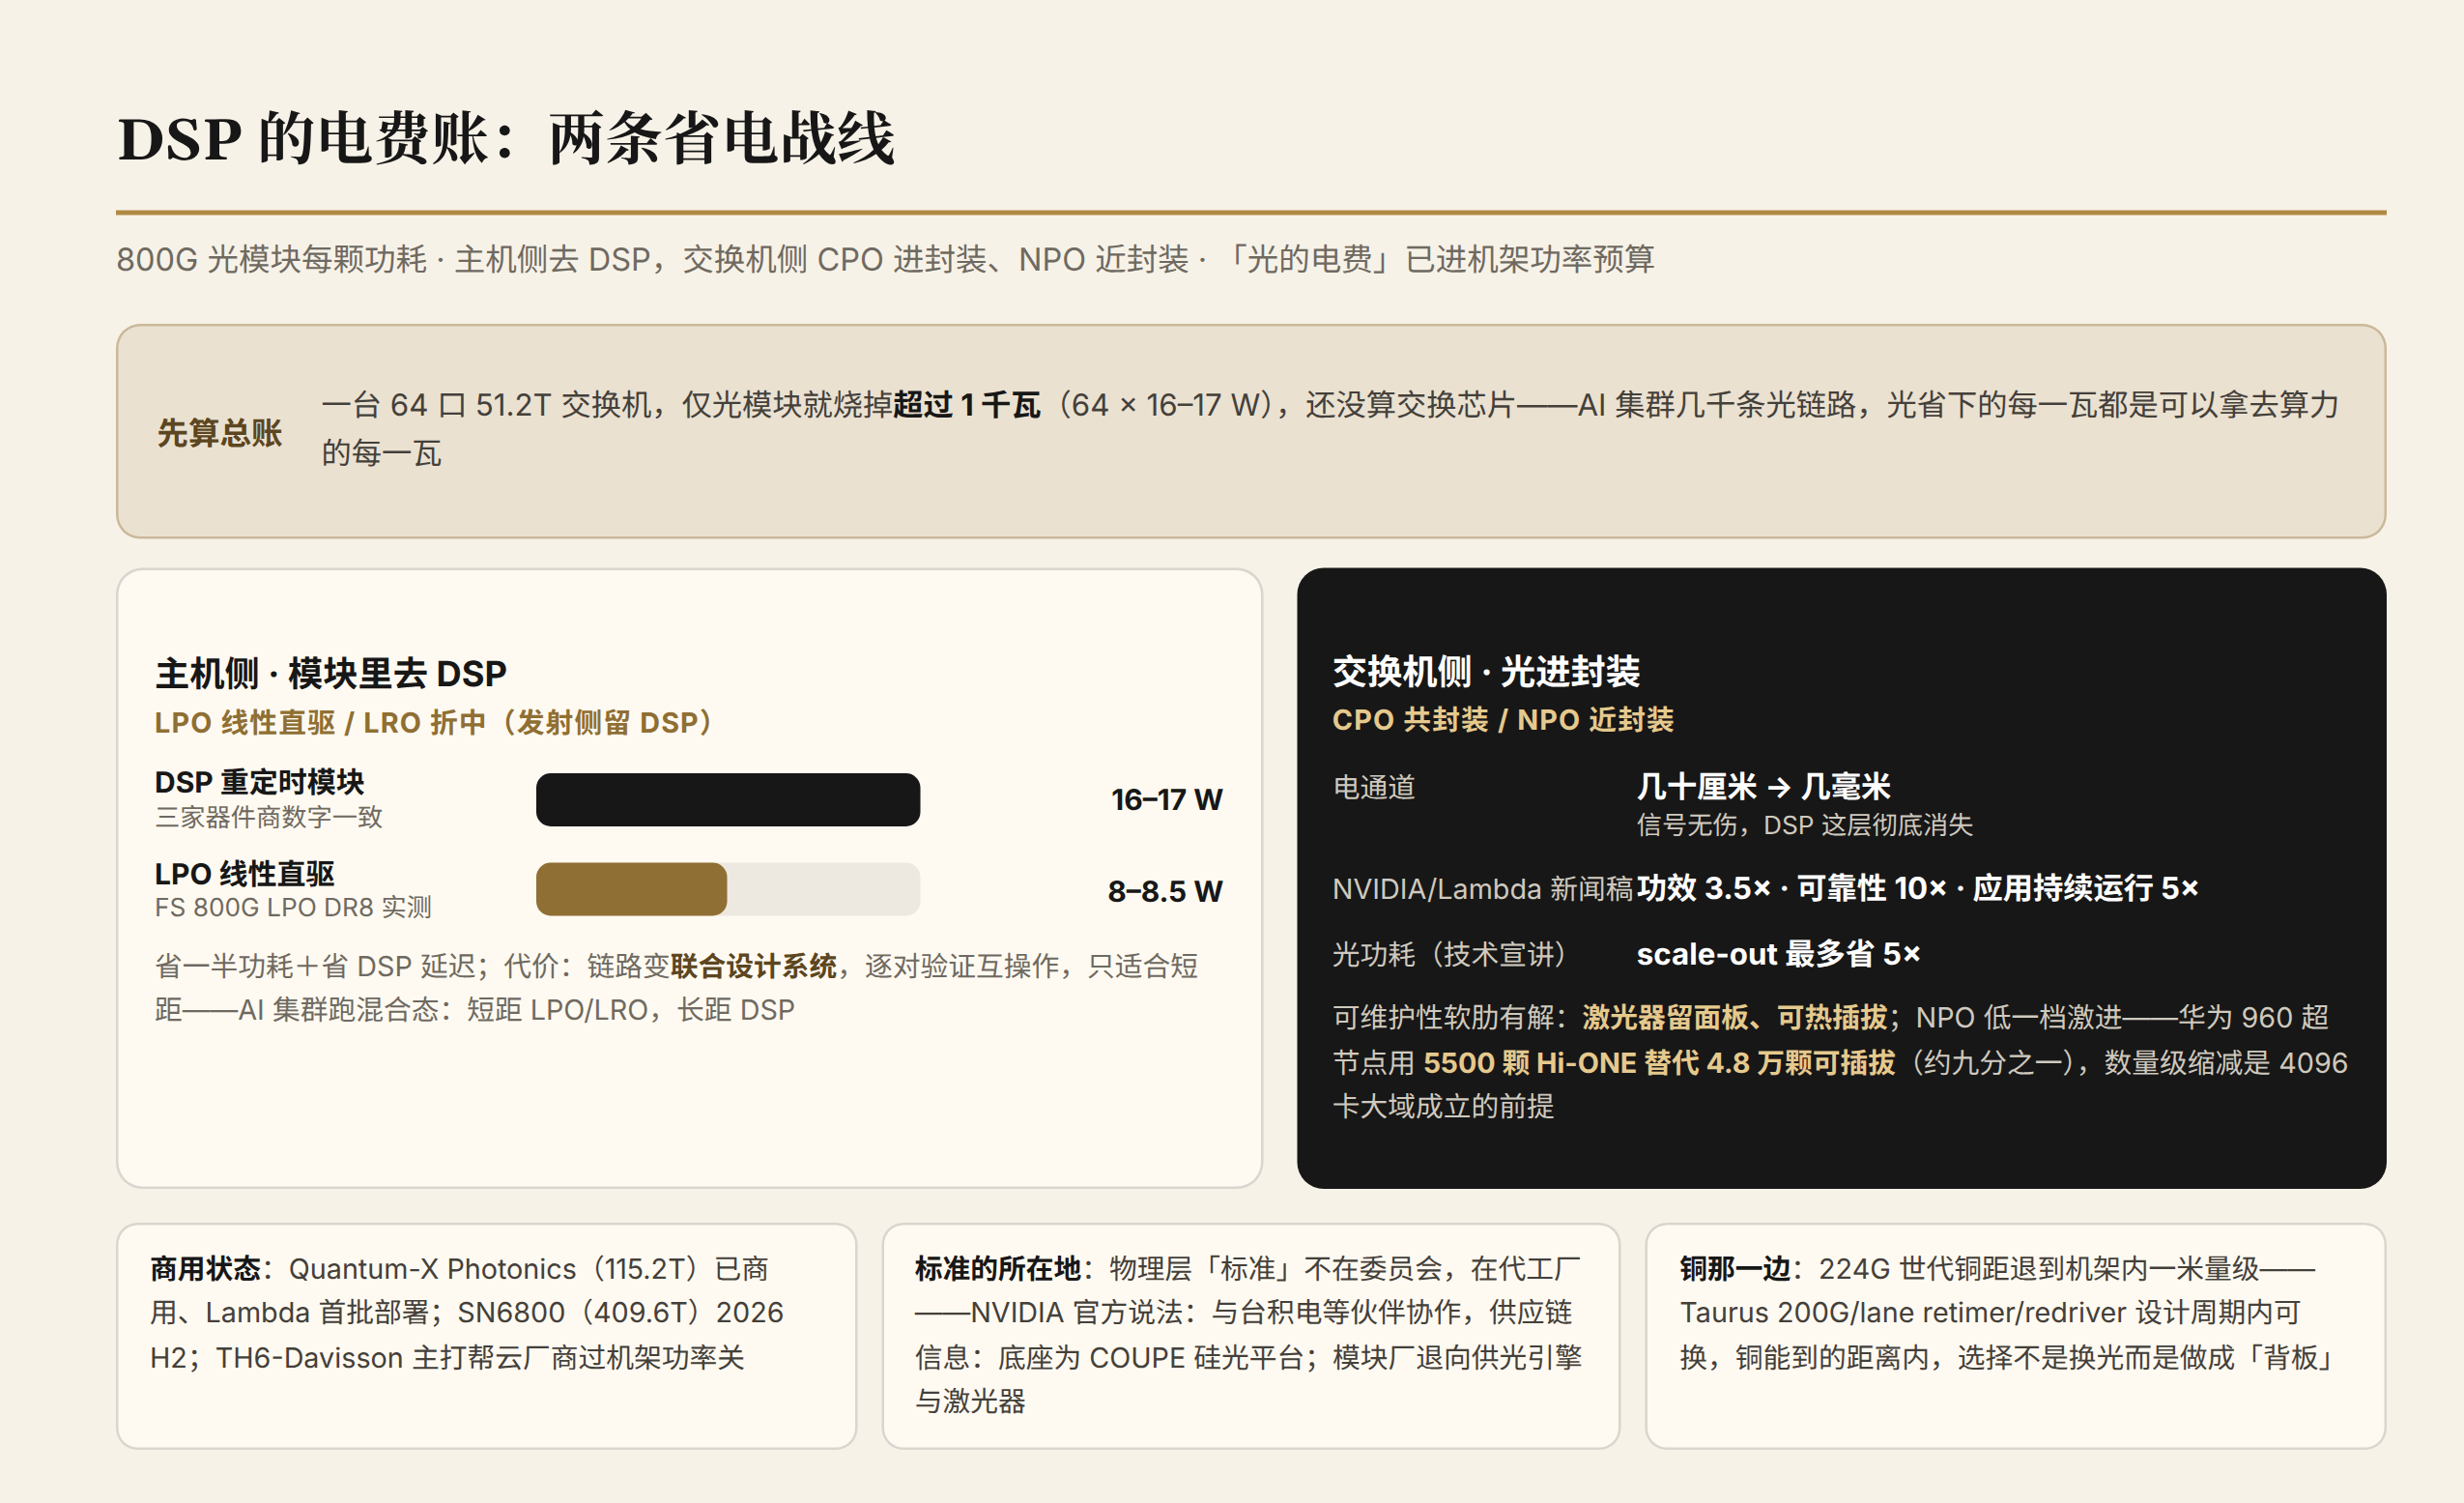
产业的回应分主机侧和交换机侧两条战线:主机侧是 LPO(线性直驱光模块):把模块里的 DSP 整个去掉,让主机侧的 SerDes 直接线性驱动光器件,功耗近乎减半(800G 从约 16 瓦到 8 瓦上下),还省掉处理延迟。代价是链路变成联合设计系统:主机、通道、模块必须整体落在信号预算内,互操作性要逐对验证,因此只适合短距;LRO 是折中——发射侧保留 DSP、接收侧线性。交换机侧是 CPO(共封装光学):光引擎与交换芯片同封装,电通道从几十厘米缩到几毫米,信号无伤,DSP 这一层彻底消失。英伟达口径(NVIDIA/Lambda 新闻稿)是功效 3.5 倍、可靠性 10 倍、应用持续运行时间 5 倍;对光功耗,英伟达技术宣讲的口径是 scale-out 最多省 5 倍。长期被诟病的可维护性问题有了工程解:激光器留在面板上可热插拔。同一战线上激进度低一档的形态是 NPO(近封装光学):光引擎贴在基板上而不进封装——华为的昇腾 960 超节点用 5500 颗 Hi-ONE 光引擎替代 4.8 万颗 800G 可插拔模块,数量缩减到约九分之一,这本身就是 4096 卡大域能成立的前提。
铜那一边也在逼近极限:信号速率每代翻倍,无重定时的铜传输距离就减半;在 224G 世代,铜能到的距离退到机架内一米量级。于是一个此前不存在的品类起来了:redriver(模拟放大均衡,便宜省电但不重建信号)与 retimer(时钟恢复重建,彻底修复但贵)之间的取舍,本是设计期的一次性决定;Astera 的 Taurus 系列让两种器件共用同一标准封装位(OCP 信号调理器标准),设计周期任意阶段可换、无需改板。它的存在本身是个宣言:在铜还能到达的距离内,业界面前的选择不是"换光",而是把 scale-up 做成"背板"。
商用快照:英伟达的 Quantum-X Photonics(InfiniBand,144×800G=115.2 Tb/s,发布口径;商用 SKU 为 72 口×1.6T,总量相同)已商用,Lambda 是首批部署客户;Spectrum-X Photonics SN6800(以太网,512×800G=409.6 Tb/s)原定 2026 年内交付,眼下正处兑现临界点。博通的第三代共封装交换芯片 TH6-Davisson 在 OCP 2026 展示,主打帮云厂商过机架功率关。LPO 阵营已有量产器件。这层的"标准"值得注意它发生在哪里:不在委员会,而在代工厂——英伟达官方口径是与台积电等伙伴协作开发,供应链侧的口径是底座为台积电 COUPE 硅光工艺平台。供应链随之重新分工:光模块厂从"卖整模块"退向"供光引擎和激光器",价值向交换芯片厂和代工厂转移。
五、判断
第一,"网卡"作为单一品类正在失效,网络价值分进三种生意。 卖尾延迟的(SuperNIC)、卖域大小的(内存语义接口)、卖每比特能耗的(光电物理层)——英伟达和博通固然三种器件都有产品,但三个市场里它们面对的是不同的对手、不同的记分牌。Astera 那笔"单 XPU 超千美元"的钱主要落在 scale-up 交换和信号调理上,几乎不经网卡——这正是网络硅含量离开网卡、流向三类器件的证据。采购语言、供应商格局、乃至"网卡"这个词本身,都会跟着改写。这个判断的失效条件同样清楚:如果平台厂把三种器件重新收进单一封装,或者 UEC 商用失败让开放规格退潮,"解体"就要改写成"重新收拢"。
第二,两条暗线比明线更值得盯。 一是两条网络在互抄对方的招:scale-up 学走了 scale-out 的在网计算(UALink 2.0 写进标准),scale-out 学走了 scale-up 的信用量流控(RCCC 本质就是信用量授权)——分化与融合同时发生,边界还会继续移动。二是"开放"的形式本身在变:协议层的标准化回归委员会(UEC、UALink),物理层的标准化回归代工厂(COUPE)——前者拆专有锁定的墙,后者把"开放"变成"谁都能去流片"。
第三,中西方的端网协同侧重不同,各有适用场景。 西方阵营同样把大量智能放进交换机(SHARP、Tomahawk Ultra 的在网聚合、Spectrum-X 的遥测),但其方案以每卡一张 SuperNIC 为必要端点——要吃满性能,网卡必换;华为把兼容层放进交换机(SF9300 双模组网,华为口径为存量 RoCE 卡升级获得灵衢能力、价值在超节点边界内兑现),网卡可不换,存量兼容成本更低。域规模的对撞更直接:西方在售旗舰是 72–144 卡的 NVL 域,Rubin Ultra 的 NVL576 排在 2027;昇腾的商用交付单元从 1024 卡起步(950,2026)、4096 卡在途(960,2027),完整 SuperPoD 规划上限 8192/15488 卡(HC 2025 路线图口径)——域经济学那笔"四成通信换 2.75 倍有效算力"的账,就是这场对撞的记分牌。
验证点立在这里:UEC 商用网卡 2027 年的实际出货量;UALink 原生交换落地后,开放生态的首个大客户是谁;Spectrum-X Photonics SN6800 在 2026 年底至 2027 年初的实际交付与部署进展;灵衢双模交换机会不会出现华为体系外的客户;CPO 在 2027 年新建 AI 端口中的占比。五个验证点任何一个兑现或证伪,本文的判断就要更新一次。
相关阅读
- 《NVLink 的护城河与裂缝:Scale-Up 互联的开放之战》
- 《博通 Tomahawk 6 vs NVIDIA 网络芯片:从硅片到 AI 工厂的全栈对标》
- 《华为的一张网:HC 2026 网络全景》
信源
- Ultra Ethernet Consortium:Specification 1.0 发布稿与规格页(2025-06 发布,现行 1.0.3,2026-07-16;联盟 2023-07-19 成立,创始成员九家);Inside Deep Tech《Ultra Ethernet: A Full Guide to AI Scale-Out Fabric》(NSCC/RCCC、Profile 分层,2026-09)
- Broadcom:Thor Ultra 发布稿(2025-10-14,送样中);公司新闻页(TH6-Davisson、SUE-T/ESUN,OCP Global Summit 2026)
- Astera Labs 2026Q3 财报电话会(原话 "next-generation AI fabric products alone … well beyond $1,000 per XPU";当前代 fabric 交换+铜缆信号调理合计已超千美元);Astera 官方 PR(2026-05-05,Scorpio X 出货、2H26 爬坡;2026-07-21,Taurus OCP 标准封装 Smart Swap);UALink 联盟 2026-04-07 发布 2.0 与配套四规格;NextGenInfra《2026 AI Infra Summit》实录(UALink 演示、2.0/3.0 进展)
- Marvell×NVIDIA:2026-03 扩大合作(Fusion 兼容定制 XPU、scale-up 连接)与约 $2B 入股(多源:StockTitan、Converge Digest、Yahoo Finance)
- NVIDIA/Lambda:Quantum-X Photonics 商用与首批部署新闻稿(3.5× 功效/10× 可靠性/5× 应用持续运行时间,厂商口径);ConnectX-9(1.6T)配对 Rubin 世代=NVIDIA GTC 2026 材料口径;NVIDIA 技术宣讲(scale-out 光功耗最多省 5×、SN6800 409.6 Tb/s、可插拔 20–25W)
- LPO/LRO 功耗:Vitex、Axiom、AscentOptics、FS 四家口径(800G DSP 16–17W,LPO 8–8.5W)
- vLLM《Push-Based KV Transfer》(2026-10-14)与 AWS ML 博客实测(P5en 重载 up to 3× TTFT;TechTimes 等为转述);TensorRT-LLM disaggregated serving 文档;ARK,arXiv:2610.41160(SIGCOMM 2026;P95 数字出自论文摘要)
- xAI Colossus 规模与 Spectrum-X 60%→95% 利用率为 NVIDIA 口径(2024-10-28 新闻稿)
- 域经济学与灵衢/昇腾数据:我方已核技术笔记(昇腾 960 超节点、HC 2026 网络、DeepSeek 昇腾集群分析);2.75× 为华为马尔科夫实验室仿真口径;华为 HC 2025 徐直军 keynote(Atlas 950 SuperPoD 全配 8192 卡、Atlas 960 SuperPoD 15488 卡)与 WAIC 2026(1024 卡商用单元)两套官方口径并存;NVLink 6 3.6 TB/s 出自我方已发布的 Rubin 系列核验稿